KI-Modell-Preisvergleich: Token-, Bild- und Videokosten in einem Dashboard
Ein KI-Modell-Preisvergleich ist nur dann nützlich, wenn er die Art und Weise widerspiegelt, wie Ihr Produkt tatsächlich Geld ausgibt. Eine statische Tabelle mit Token-Preisen ist ein Ausgangspunkt. Die tatsächlichen Inferenzkosten ändern sich mit Input-Tokens, gecachten Inputs, Output-Tokens, Bildausgabeeinheiten, Videosekunden, Tool-Aufrufen, Wiederholungen, Fallbacks, fehlgeschlagenen Jobs und dem Prozentsatz der generierten Ergebnisse, die Nutzer tatsächlich akzeptieren.
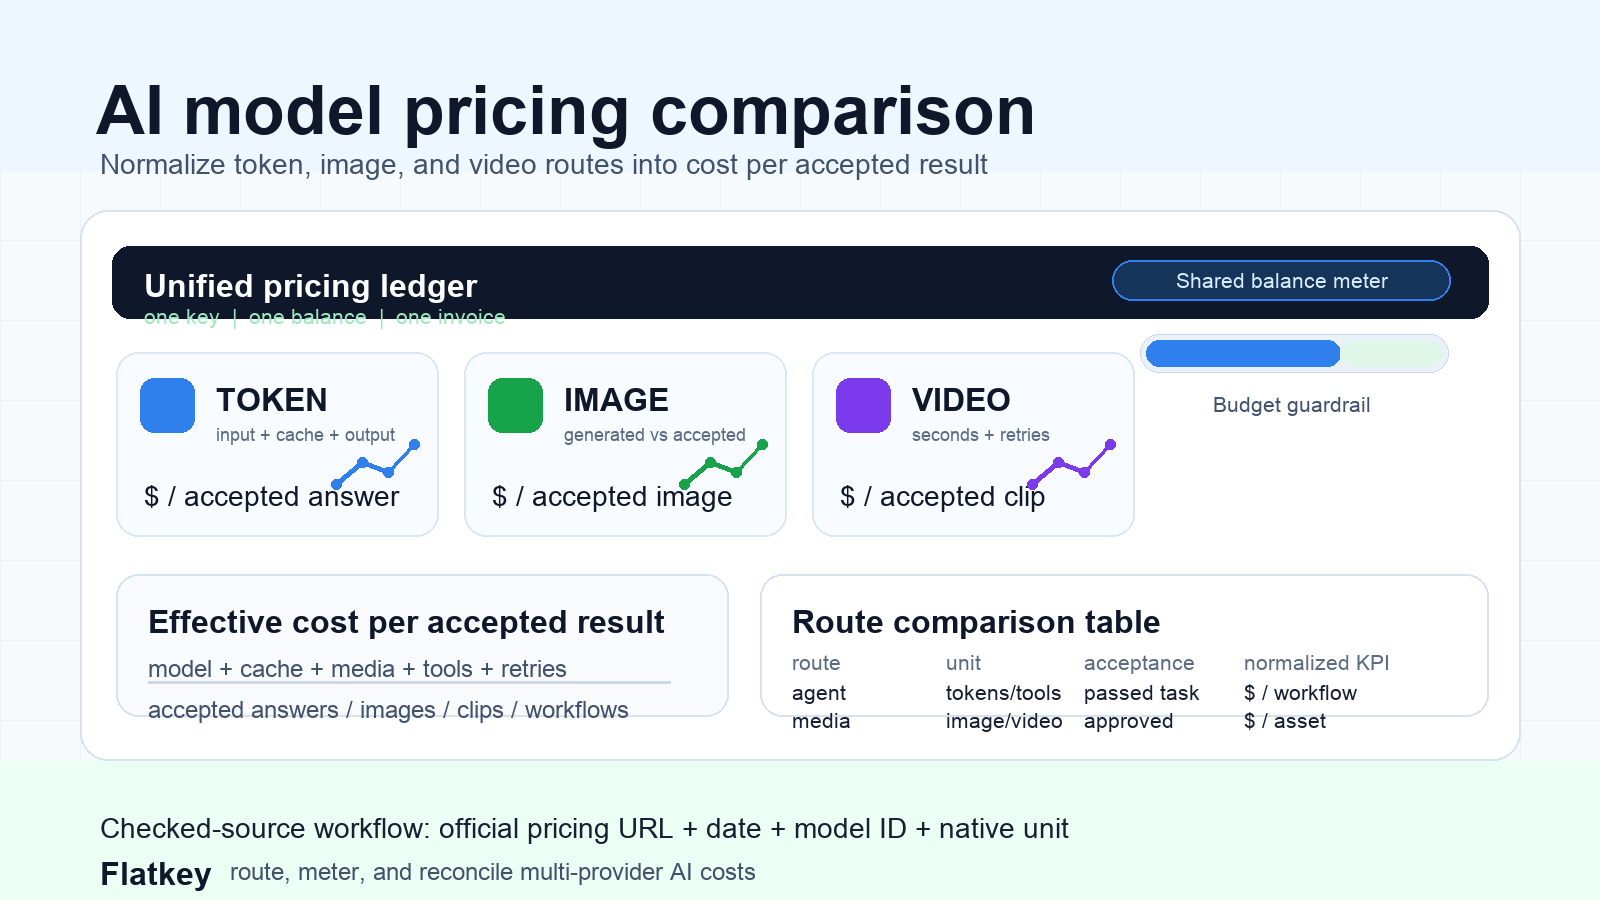
Dieser Leitfaden gibt Entwicklern, Produktteams und Beschaffungsteams ein praktisches Dashboard zum Vergleich von KI-Modellpreisen über Text-, Bild-, Video- und Multi-Provider-API-Routen hinweg. Die belastbare Kennzahl ist nicht die günstigste aufgeführte Anfrage. Es sind die Kosten pro akzeptiertem Ergebnis.
Flatkey passt zu diesem Workflow, weil es Teams einen API-Schlüssel, ein vorausbezahltes Guthaben, eine Rechnung und ein gemeinsames Nutzungsprotokoll über 300+ offizielle Modelle und 1.000+ Pay-per-Call-Tools hinweg bietet. Sie müssen weiterhin die offiziellen Anbieterpreise prüfen, aber Sie müssen nicht jedes Experiment aus separaten Anbieter-Konten abgleichen, bevor Sie sich für eine Route entscheiden.
Schnelles Framework für den KI-Modell-Preisvergleich
Nutzen Sie dieses Framework, bevor Sie den Anbieter wechseln, ein größeres Modellbudget freigeben oder Produktionsverkehr über ein neues Modell routen.
| Kostenebene | Native Preiseinheit | Normalisieren auf | Dashboard-Feld |
|---|---|---|---|
| Text- und Agent-Aufrufe | Input-Tokens, gecachter Input, Output-Tokens, Cache-Writes, Batch-Jobs, Tool-Aufrufe | Kosten pro akzeptierter Antwort oder abgeschlossenem Auftrag | accepted_task_cost_usd |
| Bildgenerierung | Prompt-Tokens, Bildeingabe, Bild-Output-Tokens, generierte Bilder, Auflösung, akzeptierte Bilder | Kosten pro akzeptiertem Bild | accepted_image_cost_usd |
| Videogenerierung | Sekunden, Clips, Auflösung, Warteschlangenversuche, fehlgeschlagene asynchrone Jobs | Kosten pro akzeptiertem Clip oder akzeptierter Clip-Sekunde | accepted_clip_cost_usd |
| Multimodale Workflows | Gemischte Texte, Dateien, Bilder, Video, Tools, Wiederholungen, Fallbacks | Kosten pro abgeschlossenem Workflow | workflow_cost_usd |
| Beschaffung und Governance | Schlüssel, Rechnungen, Exporte, Budgets, Allowlists, Audit-Anforderungen | Kosten für den sicheren Betrieb der Route | operating_cost_note |
Die Management-Kennzahl kann einfach sein: Kosten pro akzeptiertem Ergebnis. Das Engineering-Ledger sollte detailliert bleiben, denn der Grund für die Kostenänderung kann ein Cache-Miss, eine Änderung der Ausgabelänge, ein Anstieg der Wiederholungen, ein Modell-Fallback oder eine niedrigere Nutzerakzeptanzrate sein.
Warum der Listenpreis eine unvollständige Antwort ist
Die günstigste Token-Zeile kann nach dem Start zur teuren Route werden. Ein Modell mit einem niedrigen Input-Token-Preis kann trotzdem verlieren, wenn es längere Prompts benötigt, längere Antworten erzeugt, Cache-Chancen verpasst, häufiger wiederholt oder bei Überlastung auf eine teurere Route zurückfällt.
Medienkosten machen das Problem noch deutlicher:
- Ein Bildmodell kann pro Generierung günstig und pro akzeptiertem Bild teuer wirken, wenn Nutzer viele Ausgaben ablehnen.
- Ein Videomodell kann pro Sekunde erschwinglich und teuer wirken, wenn Nutzer mehrere Vorschauen anfordern, bevor sie einen Clip speichern.
- Ein Coding- oder Research-Agent kann ein günstiges Chat-Modell haben, aber teure Tool-, Browser-, Bild- oder Anreicherungs-Nebenaufrufe.
- Ein direktes Anbieter-Konto kann einen niedrigeren reinen Modellpreis haben, aber höhere Betriebskosten verursachen, wenn die Beschaffung separate Schlüssel, Rechnungen, Nutzungs-Exporte und Budgetkontrollen benötigt.
Deshalb sollte ein KI-Modell-Preisvergleich native Preiseinheiten beibehalten und dann jede Route auf die Ökonomie akzeptierter Ergebnisse normalisieren.
Aktuelle Preisquellen, die geprüft werden sollten
Anbieterpreise ändern sich häufig. Kopieren Sie eine Preistabelle nicht einmal und behandeln Sie sie dann als dauerhaft. Führen Sie eine Quellentabelle mit der offiziellen URL, dem Prüfdatum, der Modell- oder Routen-ID, der Einheit und Notizen.
| Anbieter oder Route | Offizielle Quelle zum Prüfen | Zu erfassende Preisdimensionen | Hinweis für das Dashboard |
|---|---|---|---|
| OpenAI API | OpenAI API-Preise | Eingabe, gecachte Eingabe, Ausgabe, Batch-Modus, Fine-Tuning, Bild, Audio, Video, regionale Verarbeitung | Bestätigen Sie die exakte Modell-ID, den Bereitstellungsmodus und ob Batch-Preise gelten. |
| Anthropic Claude API | Claude-Preise | Eingabe, Ausgabe, Prompt-Caching, Batch-Preise, Modellfamilie, Kontextfenster | Das Verhalten von Cache-Schreibvorgängen und Cache-Treffern kann die Wirtschaftlichkeit wiederholter Agenten erheblich verändern. |
| Google Gemini API | Gemini API-Preise | Kostenlose oder kostenpflichtige Stufe, Eingabe, Ausgabe, Caching, Batch-Modus, Priority-/Flex-Optionen, Search Grounding, Medien | Erfassen Sie Modellfamilie und Bereitstellungsmodus, insbesondere wenn Search oder Grounding aktiviert ist. |
| DeepSeek API | DeepSeek API-Preise | Input-Cache-Miss, Input-Cache-Hit, Ausgabe, Peak- oder Off-Peak-Zeit, Modellalias | Request-Logs benötigen Zeitstempel und Cache-Status, wenn die Preise je nach Zeitfenster oder Cache-Treffer variieren. |
| Alibaba Model Studio / Qwen | Alibaba Model Studio-Modelle | Modellfamilie, Modalität, Region, Token- oder Medieneinheit, Konsolenmodell-ID | Prüfen Sie die exakte Detailseite des Modells und die Region, bevor Sie Qwen-Routen in ein Budget aufnehmen. |
| Flatkey Multi-Provider API | Flatkey-Preise und Flatkey-Modelle | Einheitliche Modellrouten, ein Guthaben, Pro-Request-Ledger, Tool-Aufrufe, Rechnungen, Budgets für Sub-Keys | Für Routenverfügbarkeit, Multi-Provider-Governance und ledgerbasierte Vergleiche verwenden. |
Speichern Sie für jede Preiszeile drei Pflichtfelder: Prüfdatum, Modell- oder Routen-ID und Einheit. Ein Dollar-pro-Token-Wert ist nicht direkt mit einem Dollar-pro-Bild-, Dollar-pro-Video-Sekunde- oder Bezahlung-pro-Tool-Aufruf-Wert vergleichbar.
Das Dashboard-Schema
Beginnen Sie mit einem einzigen Request-Ledger. Trennen Sie Text-, Bild-, Video- und Tool-Nutzung nicht in voneinander losgelöste Finanzsysteme.
{
  "request_id": "req_01j...",
  "workspace_id": "wk_product",
  "environment": "production",
  "feature": "creative_generator",
  "customer_id": "cus_123",
  "provider": "flatkey",
  "model_or_route": "example-route",
  "route_type": "image",
  "billing_unit": "output_image",
  "input_tokens": 1240,
  "output_tokens": 0,
  "cache_read_tokens": 0,
  "cache_write_tokens": 0,
  "tool_calls": 0,
  "images_generated": 4,
  "images_accepted": 1,
  "video_seconds_generated": 0,
  "video_seconds_accepted": 0,
  "retry_count": 1,
  "fallback_count": 0,
  "provider_cost_usd": 0.16,
  "gateway_or_platform_cost_usd": 0.00,
  "total_cost_usd": 0.16,
  "accepted_result": true,
  "latency_ms": 11800,
  "pricing_source_url": "https://provider.example/pricing",
  "pricing_checked_at": "2026-10-12"
}
Dieses Schema gibt der Finanzabteilung eine Zahl, die sie abgleichen kann, und liefert der Technik die Felder, die nötig sind, um zu erklären, warum eine Modellroute günstiger oder teurer wurde.
Zu verwendende Kostenformeln
Text- und Agent-Aufrufe
Berechnen Sie für Text-Routen zuerst die reinen Request-Kosten:
raw_text_cost =
  input_tokens * input_rate
+ output_tokens * output_rate
+ cache_write_tokens * cache_write_rate
+ cache_read_tokens * cache_read_rate
+ tool_call_costs
+ retry_and_fallback_costs
Normalisieren Sie sie dann:
accepted_task_cost =
  sum(raw_text_cost for all attempts, retries, and fallbacks)
/ accepted_tasks
Wenn ein Request fehlschlägt und der Benutzer nie eine Antwort erhält, verschleiern Sie das nicht. Verfolgen Sie die Kosten fehlgeschlagener Aufrufe getrennt. Ein Pricing-Dashboard wird nützlich, wenn es fehlenden, erneut versuchten und per Fallback entstandenen Traffic sichtbar macht.
Bildgenerierung
Die Preisgestaltung von Bild-APIs ist keine einheitliche Einheit. Manche Modelle stellen Prompt-Tokens und Token für die Bildausgabe bereit. Andere arbeiten mit Preis pro Bild, Auflösung, Bearbeitung oder anbieterspezifischen Einheiten. Bewahren Sie die native Einheit und normalisieren Sie auf akzeptierte Bilder:
accepted_image_cost =
  (prompt_cost + input_image_cost + output_image_cost + retry_cost)
/ accepted_images
Verfolgen Sie images_generated und images_accepted getrennt. Eine Route, die für jedes akzeptierte Bild vier Bilder erzeugt, sollte nicht direkt mit einer Route verglichen werden, bei der Nutzer eins von eins akzeptieren.
Videogenerierung
Die Preisgestaltung für Video benötigt Dauer, Auflösung und den Status des Async-Jobs. Ein Video-Aufruf kann in der Warteschlange stehen, fehlschlagen, abgebrochen, neu generiert oder später akzeptiert werden.
accepted_clip_cost =
  sum(video_seconds_generated * per_second_rate by resolution)
+ retry_cost
+ fallback_cost
+ storage_or_tool_costs
Für Produktentscheidungen erfassen Sie außerdem:
accepted_clip_secondspreview_countregeneration_countfailed_job_counttime_to_first_preview_mstime_to_accepted_clip_ms
Ein Video-Modell kann pro aufgeführter Einheit günstiger sein und dennoch schlechter für das Produkt, wenn Nutzer doppelt so oft neu generieren.
Direkte Provider-Konten mit einer Multi-Provider-API vergleichen
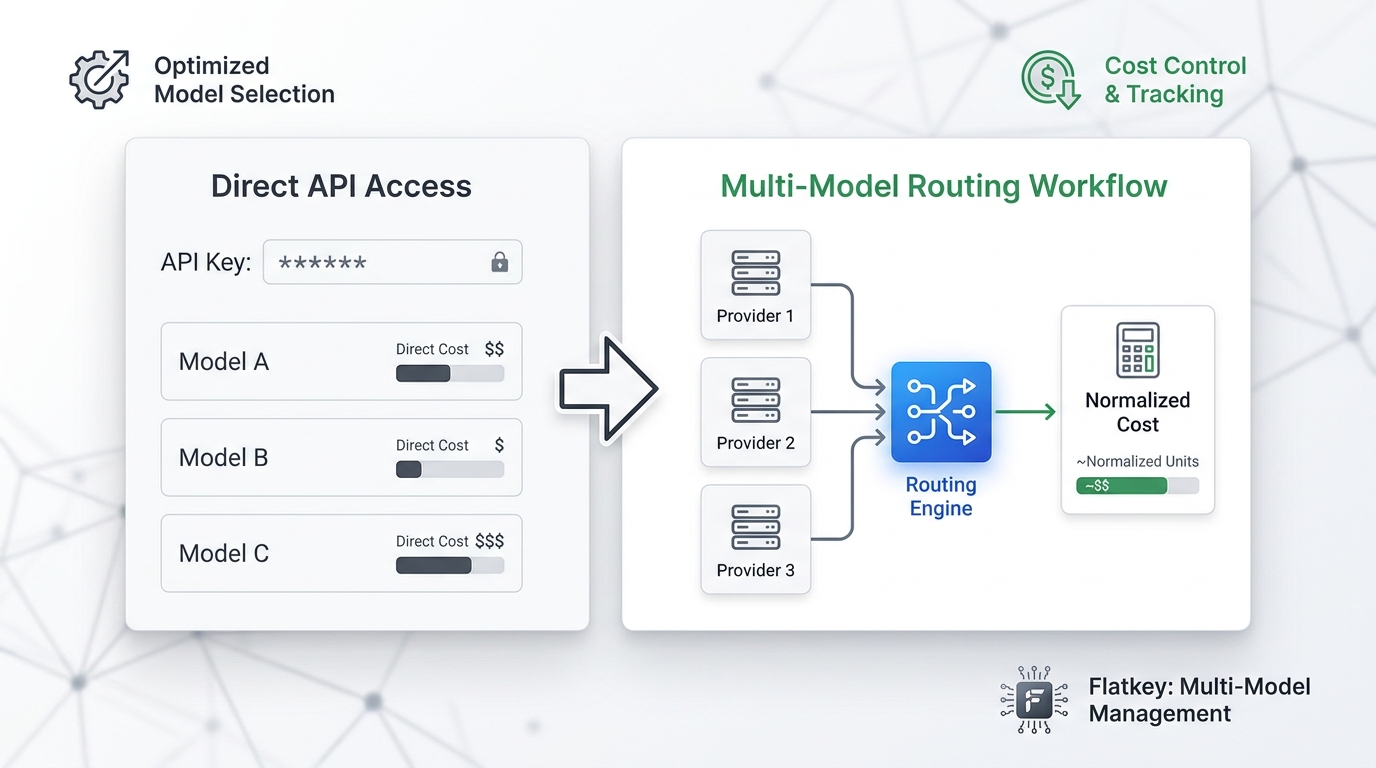
Direkte Provider-Konten reichen aus, wenn eine Modellfamilie den Großteil Ihrer Workload abdeckt und getrennte Abrechnung leicht zu verwalten ist. Eine Multi-Provider-API wird nützlicher, wenn Sie kontinuierlichen Modellvergleich, Fallback-Routing oder ein einheitliches Hauptbuch über viele Provider hinweg benötigen.
| Entscheidungspunkt | Direkte Provider-Konten können ausreichen, wenn... | Eine Multi-Provider-API hilft, wenn... |
|---|---|---|
| Modellauswahl | Ein Provider gewinnt die meisten Aufgaben. | Unterschiedliche Workloads benötigen OpenAI-, Claude-, Gemini-, DeepSeek-, Qwen-, Bild-, Video- und Tool-Routen. |
| Entwicklungsaufwand | Ihr Code ruft bereits einen Provider auf und ändert sich nur selten. | Sie möchten OpenAI-kompatibles Routing und weniger Integrations-Neuimplementierungen. |
| Kostenkontrolle | Eine Rechnung und ein Dashboard sind akzeptabel. | Sie benötigen Budgets pro Sub-Key, Modell-Whitelists und Exporte der Nutzung pro Anfrage. |
| Beschaffung | Separate Verträge sind handhabbar. | Doppelte Verträge, ungenutzte Lizenzen und verstreute Provider-Keys bremsen das Team aus. |
| Zuverlässigkeit | Gelegentliche Ausfälle von Providern sind akzeptabel. | Sie benötigen eine Fallback-Richtlinie und ein gemeinsames Hauptbuch für Retry- und Fallback-Kosten. |
| Agenten-Workflows | Die App ruft nur Textmodelle auf. | Agenten rufen Modelle, Websuche, Browser-Aktionen, Anreicherungstools, Bilder und Video auf. |
Flatkey ist für die zweite Spalte gebaut: ein API-Schlüssel, ein Guthaben, eine Rechnung und ein Anfrage-Hauptbuch über viele offizielle Modell- und Tool-Routen hinweg. Das ersetzt nicht die offizielle Provider-Preisgestaltung. Es gibt Ihrem Team einen einzigen Ort, um diese Kosten zu routen, zu messen, zu steuern und abzugleichen. Für den Blickwinkel auf Gateway-Gebühren und Betriebskosten siehe AI gateway pricing.
Fünf Workload-Beispiele
1. Support-Chat
Support-Chat hat in der Regel moderate Eingaben, kurze Ausgaben und hohes Volumen. Vergleichen Sie:
- Trefferquote des Prompt-Caches für System-Prompts und Richtlinientexte.
- Output-Token-Budget nach Antworttyp.
- Eskalationsrate zu einem stärkeren Modell.
- Kosten pro gelöstem Gespräch, nicht nur Kosten pro Nachricht.
Für diese Workload kann ein günstigeres, schnelles Modell gewinnen, wenn es die Lösungsqualität hoch hält. Wenn das günstigere Modell die Übergabe- oder Bearbeitungsrate erhöht, verschwinden die scheinbaren Token-Einsparungen.
2. Coding-Agent
Coding-Agents haben oft großen Kontext, Tool-Aufrufe, lange Ausgaben und mehrere Wiederholungen. Vergleichen Sie:
- Kontextgröße nach Repository-Suche oder Datei-Lesevorgängen.
- Zwischenspeicherbare Projektanweisungen.
- Anzahl der Tool-Aufrufe pro akzeptierter Aufgabe.
- Retry-Verlust durch überlastete Routen.
- Kosten pro gemergter Änderung oder akzeptiertem Patch.
Hier braucht ein ai model pricing comparison ein Hauptbuch. Ein einzelner Agentenlauf kann Modellaufrufe, Tool-Aufrufe, Fallback-Aufrufe und fehlgeschlagene Versuche enthalten.
3. RAG-Antwortgenerierung
RAG-Workloads werden von abgerufenem Kontext und Antwortlänge bestimmt. Vergleichen Sie:
- Durchschnittlich abgerufene Tokenanzahl.
- Anteil des stabilen Prompt-Präfixes.
- Cache-Verhalten bei wiederholten Dokumenten.
- Kosten für Zitation oder Grounding.
- Pass-Rate des Evaluators für Faktentreue.
Wählen Sie kein Modell nur deshalb, weil seine Input-Tokens günstig sind. Wenn es doppelt so viel Kontext benötigt oder Antworten erzeugt, die die Bewertung nicht bestehen, können die Kosten pro akzeptierter Antwort höher sein. Wenn dies die zentrale Migrationsfrage ist, verwenden Sie das ausführlichere Arbeitsblatt in how to compare AI model prices.
4. Batch-Klassifizierung
Batch-Klassifizierung kann oft verzögerte Ergebnisse tolerieren. Vergleichen Sie:
- Ob der Provider eine Batch-, Flex- oder verzögerte Verarbeitungsstufe hat.
- Maximale Batch-Größe und Abschlussfenster.
- Kosten für Fehlerwiederholung.
- Pass-Rate der Ausgabe-Schema-Validierung.
- Gesamtkosten pro akzeptierter Zeile.
Wenn ein Provider günstigere Batch-Preise bietet, gelten die Einsparungen nur, wenn Ihr Workflow warten kann und Ihr Retry-Prozess sauber ist.
5. Bild- und Videogenerierung
Bild- und Video-APIs passen selten in eine reine Token-Tabelle. Vergleichen Sie:
- Ausgabeeinheit: Bild, Sekunde, Clip, Auflösung, Token oder Credit.
- Abrechnungsregeln bei fehlgeschlagener Generierung.
- Rate für Bearbeitung und erneute Generierung.
- Rate der menschlichen Freigabe.
- Kosten pro akzeptiertem kreativen Asset.
Für Medien-Pipelines sollten Token-Modelle und Generierungsmodelle in separaten Tabellenblättern geführt werden und dann in die Kosten des akzeptierten Workflows zusammengeführt werden. Die Stückkosten sind zu unterschiedlich für eine einzige gemischte Zeile.
Siebenstufiger Workflow für den Preisvergleich
- Die Arbeitslast einfrieren. Wählen Sie eine reale Aufgabenkategorie, z. B. Support-Antworten, Patches für Coding-Agents, RAG-Antworten, Batch-Klassifizierung, Bildgenerierung oder Videogenerierung.
- Aktuelle offizielle Preise erfassen. Nutzen Sie die Preisseiten der Anbieter, Flatkey-Modellseiten und ein geprüftes Datum. Vermeiden Sie kopierte Preistabellen ohne Quell-URLs.
- Repräsentativen Traffic erneut ausführen. Verwenden Sie dieselben Prompts, Eingaben, Ausgabelimits, Tool-Richtlinien und Validatoren über alle Routen hinweg.
- Jede abrechenbare Einheit protokollieren. Erfassen Sie Eingabetokens, gecachte Tokens, Ausgabetokens, Medieneinheiten, Tool-Aufrufe, Wiederholungsversuche, Fehler und Status.
- Akzeptierte Ergebnisse bewerten. Verwenden Sie menschliche Prüfung, automatisierte Validatoren oder aufgabenbezogene Bestehen/Nichtbestehen-Prüfungen.
- Effektive Kosten berechnen. Teilen Sie die Gesamtkosten der Route durch die akzeptierten Ergebnisse, nicht durch die Gesamtzahl der Anfragen.
- Betriebliche Kontrollen hinzufügen. Entscheiden Sie, ob die gewinnende Route auch Budgetobergrenzen, Rechnungsanforderungen, Schlüsselgovernance, Datenaufbewahrung und Incident-Fallback erfüllt.
Das Ergebnis ist eine Preisentscheidung, die Engineering, Produkt und Einkauf gleichermaßen vertreten können.
Mindestens erforderliche Dashboard-Ansichten
Routenvergleich
Zeigen Sie Text-, Bild- und Videorouten in einer Tabelle an.
| Route | Nativ-Einheit | Natives Kostenfeld | Akzeptanzfeld | Normalisierte KPI |
|---|---|---|---|---|
| Textmodell | Tokens | Eingabe-, Ausgabe-, Cache-Tokens | Akzeptierte Antwort | Kosten pro akzeptierter Antwort |
| Coding-Agent | Tokens plus Tools | Token- und Tool-Kosten | Zusammengeführter PR, gelöstes Ticket, abgeschlossene Aufgabe | Kosten pro abgeschlossenem Workflow |
| Bildmodell | Bild- oder Token-Einheiten | Generierte Bilder, Ausgabe-Bildtokens | Akzeptiertes Bild | Kosten pro akzeptiertem Bild |
| Videomodell | Sekunden, Clips oder Anbieter-Einheiten | Generierte Sekunden nach Auflösung | Akzeptierter Clip | Kosten pro akzeptiertem Clip |
Feature-Budget
Gruppieren Sie nach Feature, nicht nur nach Anbieter. Für Produktteams ist das nützlicher als eine Anbieterrechnung, weil es zeigt, ob Onboarding, Chat, kreative Generierung, Suche oder Export die Ausgaben treiben.
Empfohlene Spalten:
featureroute_typerequestsaccepted_resultsacceptance_ratetotal_cost_usdcost_per_accepted_resultp95_latency_msfallback_rateretry_rate
Anbieter- und Modell-Drift
Jeder Anbieter ändert Modellverfügbarkeit, Preise und Lebenszyklusstatus. Speichern Sie:
- URL der Preisquelle.
- Datum der Preisprüfung.
- Modellversion oder Routen-ID.
- Einheitentyp.
- Cache-Richtlinie.
- Batch-Rabattregel, falls verwendet.
- Hinweise zur Abkündigung oder zum Lebenszyklus.
So bleibt ein ai model pricing comparison auch nach dem Start nützlich und nicht nur bei der ersten Modellauswahl.
Margen-Leitplanken
Fügen Sie jeder KI-Funktion eine einfache Margenregel hinzu:
max_ai_cost_per_customer_action =
  expected_revenue_per_action * target_ai_cost_percentage
Beispiel:
Wenn eine Kundenaktion 0,40 $ Bruttomarge einbringt
und die KI-Kosten unter 20 % bleiben sollen,
dann beträgt das Routenbudget 0,08 $ pro akzeptiertem Ergebnis.
So bleibt die Modellauswahl an das Geschäft gekoppelt statt an abstrakte Benchmark-Werte.
Häufige Fehler
| Fehler | Was stattdessen zu tun ist |
|---|---|
| Nur Eingabe-Token-Raten vergleichen | Vergleichen Sie Eingabe, gecachte Eingabe, Ausgabe, Medien, Tools, Wiederholungen und akzeptierte Ergebnisse. |
| Text, Bild, Video und Tools in eine Einheit mischen | Behalten Sie native Einheiten bei und normalisieren Sie dann jede Route auf Kosten pro akzeptiertem Ergebnis. |
| Prompt-Caching ignorieren | Messen Sie stabile Prompt-Präfixe und die Cache-Trefferquote. |
| Batch-Eignung ignorieren | Trennen Sie latenzsensitive und Offline-Workloads. |
| Veralteten kopierten Preistabellen vertrauen | Speichern Sie offizielle Quell-URLs und Prüfdaten. |
| Gateway-Kosten nur als Aufschlag betrachten | Berücksichtigen Sie Governance, Failover, Nutzungs-Exporte, Rechnungen und Engineering-Zeit. |
| Die günstigste Anfrage auswählen | Wählen Sie das günstigste akzeptierte Ergebnis, das Qualitäts- und Zuverlässigkeitsanforderungen erfüllt. |
Häufige Fragen
Was ist der beste Weg, um die Preisgestaltung von KI-Modellen zu vergleichen?
Der beste Weg, die Preisgestaltung von KI-Modellen zu vergleichen, besteht darin, die native Abrechnungseinheit jedes Anbieters beizubehalten und dann jede Route auf Kosten pro akzeptiertem Ergebnis zu normalisieren. Für Text kann das Kosten pro akzeptierter Antwort bedeuten. Für Bilder verwenden Sie Kosten pro akzeptiertem Bild. Für Video verwenden Sie Kosten pro akzeptiertem Clip oder pro akzeptierter Clip-Sekunde.
Was sollte ein Vergleichsdiagramm für KI-Modelle enthalten?
Ein Vergleichsdiagramm für KI-Modelle sollte Modell- oder Routen-ID, Anbieter, URL der Preisquelle, Prüfdaten, Eingabetokens, gecachte Eingabe, Ausgabetokens, Medieneinheiten, Tool-Aufrufe, Wiederholungsrate, Fallback-Rate, Akzeptanzrate, Latenz und Kosten pro akzeptiertem Ergebnis enthalten.
Sollten Preistabellen exakte Anbieterpreise enthalten?
Verwenden Sie exakte Preise in Ihrem internen Arbeitsblatt, aber speichern Sie die Quell-URL und das Prüfdatum neben jeder Zeile. Öffentliche statische Artikel sollten kopierte Preistabellen ohne Quellenangabe vermeiden, da sich Anbieterpreise, Modellnamen, Rabatte und der Lebenszyklusstatus schnell ändern können.
Wie vergleichen Sie Token-Kosten mit Bild- und Videokosten?
Zwingen Sie nicht jeden Pfad in Tokens. Halten Sie die nativen Einheiten im Ledger fest und fügen Sie dann normalisierte Felder wie accepted_task_cost_usd, accepted_image_cost_usd und accepted_clip_cost_usd hinzu.
Wo hilft Flatkey beim Preisvergleich von KI-Modellen?
Flatkey hilft, wenn Sie einen Schlüssel, ein Guthaben, eine Rechnung und ein Nutzungs-Ledger über viele Modell- und Tool-Pfade hinweg möchten. Das erleichtert den Vergleich von Text-, Bild-, Video- und Agentenkosten, ohne zunächst separate Anbieter-Konten abgleichen zu müssen.
Wie oft sollten Preise erneut geprüft werden?
Prüfen Sie Preise erneut vor jeder größeren Routing-Änderung, Vertragsprüfung oder Budgetprognose. Bei schnelllebigen Produktions-Workloads sollten Sie kritische Pfadpreise wöchentlich und unmittelbar nach dem Start, Umbenennen, der Abkündigung oder der Preisänderung eines von Ihnen genutzten Modells durch den Anbieter aktualisieren.
Fazit
Ein KI-Modell-Preisvergleich ist keine hübschere Preistabelle. Er ist ein Betriebssystem für die Modellauswahl.
Behalten Sie die Anbietereinheiten bei. Fügen Sie Acceptance-Tracking hinzu. Normalisieren Sie jeden Pfad auf Kosten pro akzeptiertem Ergebnis. Wählen Sie dann den Pfad, der Produktmarge, Zuverlässigkeit und Governance verbessert — nicht den Pfad, der isoliert betrachtet am günstigsten aussieht.
Mit Flatkey kann dieser Vergleich auf einem Schlüssel, einem Guthaben und einem Ledger basieren, sodass Entwickler, Produktteams und Einkaufsteams von verstreuten Anbieterrechnungen zu Kostenentscheidungen auf Pfad-Ebene wechseln können.