Die besten LLMs fürs Programmieren 2026: Ein Entscheidungsleitfaden für Entwickler
Zuletzt überprüft: 21. Oktober 2026. Modellverfügbarkeit, Aliasse, Limits und Preise ändern sich schnell. Betrachten Sie dies als Vorauswahl und führen Sie die unten beschriebenen Evaluierungsschritte vor einem Produktiv-Rollout erneut durch.
Es gibt keinen einzelnen Gewinner für jede Programmieraufgabe. Die besten LLMs fürs Programmieren hängen davon ab, ob Sie einen Agenten benötigen, der ein Repository bearbeitet, einen schnellen Implementierungspartner, ein Automatisierungsmodell mit niedriger Latenz oder ein Modell, das innerhalb Ihrer eigenen Infrastruktur betrieben werden kann.
Wenn Sie heute eine Auswahl treffen, beginnen Sie mit zwei oder drei Kandidaten, die zur Aufgabe passen, testen Sie sie anhand einer kleinen Gruppe repräsentativer Aufgaben und wählen Sie nur denjenigen aus, der Ihre Qualitäts-, Tool-Nutzungs-, Latenz- und Sicherheitsanforderungen erfüllt. Dieser Ansatz ist nachhaltiger, als eine Benchmark-Rangliste oder eine Liste aus dem Jahr 2025 zu kopieren.
Die besten LLMs fürs Programmieren: die Kurzantwort
Für die meisten Teams ist ein sinnvoller erster Durchlauf:
- Repository-Arbeit mit langem Horizont: Testen Sie einen aktuellen agentischen Kandidaten wie Claude Opus 5.5, GPT-5.1 Codex / GPT-5.1-Codex-Max oder Gemini 3.8 Flash.
- Alltägliche Implementierungs- und Review-Zyklen: Testen Sie das kleinere oder schnellere Modell derselben Familie erst, nachdem es Ihre Anforderungen an Code, Tests und strukturierte Ausgaben erfüllt.
- Private oder selbstverwaltete Bereitstellung: Nehmen Sie Qwen3-Coder in die Vorauswahl auf und validieren Sie dann Lizenzierung, Hardware-Eignung, Tool-Nutzung und Ihre tatsächlichen Repository-Aufgaben, bevor Sie es als produktionsreife Wahl betrachten.
- Budgetbewusste Automatisierung: Wählen Sie aus Ihren Kandidaten anhand der Kosten pro akzeptierter Änderung, nicht anhand des niedrigsten Token-Preises auf einer Seite.
Dies sind Ausgangspunkte, keine universelle Rangliste. Die besten LLMs fürs Programmieren sind die Modelle, die Ihre Aufgabe unter den für Ihr Team wichtigen Rahmenbedingungen zuverlässig erledigen.
Was Sie zuerst testen sollten – und warum
Die folgenden Modellnamen sind eine Evaluierung wert, weil ihre Betreiber oder das aktuelle Modellverzeichnis relevante Fähigkeiten für Programmierung oder agentische Workflows beschreiben. Das ist ein Beleg für eine Vorauswahl, aber kein Nachweis dafür, dass eines für Ihre Codebasis am besten geeignet sein wird.
| Kandidat | Bester erster Test | Warum er auf eine Vorauswahl gehört | Diesen Check nicht überspringen |
|---|---|---|---|
| Claude Opus 5.5 | Änderungen über mehrere Dateien, die Planung, Tool-Aufrufe und die Reparatur von Tests erfordern | Das aktuelle Modellverzeichnis von Flatkey beschreibt es als leistungsstarkes Modell für tiefes Schlussfolgern, ausdauernde Programmier-Sitzungen und agentische Tool-Nutzung. | Bitten Sie es, einen abgegrenzten Patch zu erstellen, Tests auszuführen, sich von einem Fehler zu erholen und verbleibende Unsicherheiten zu erläutern. |
| GPT-5.1 Codex / GPT-5.1-Codex-Max | Ein auf OpenAI ausgerichteter Workflow für Programmieragenten | OpenAI führt beide als für agentisches Programmieren optimierte Versionen auf, wobei Codex-Max für Arbeit mit langem Horizont positioniert wird. | Testen Sie Ihre tatsächlichen Tools, Sandbox, Patch-Größe und Review-Richtlinie – nicht nur einen Code-Prompt für eine einzelne Datei. |
| Gemini 3.8 Flash | Schnelle mehrstufige Entwicklungsarbeit und deterministische Tool-Ausführung | Googles aktuelle Modelldokumentation positioniert es für Softwareentwicklung mit langem Horizont, Refactorings über mehrere Dateien und agentische Workflows. | Messen Sie p95-Latenz und die Rate fehlgeschlagener Schleifen auf der Reasoning-Stufe, die Sie einsetzen möchten. |
| Qwen3-Coder | Ein Coding-Kandidat mit offenen Gewichten oder eine auf Code spezialisierte Alternative | Qwen beschreibt Qwen3-Coder als auf Code fokussiertes agentisches Modell mit nativer Unterstützung für langen Kontext und einer Coding-CLI. | Bestätigen Sie Modelllizenz, Bereitstellungspfad, GPU-Budget und die Qualität der Tool-Aufrufe bei Ihren eigenen Aufgaben. |
| DeepSeek-Coder-V2 | Eine Code-Baseline für viele Programmiersprachen in einer Evaluierung lokaler Modelle | Das offizielle Repository von DeepSeek dokumentiert ein Codemodell mit erweiterter Sprachunterstützung und einem langen Kontextfenster. | Behandeln Sie es als Evaluierungs-Baseline, nicht als aktuelle Ranglistenbehauptung; vergleichen Sie es direkt mit Ihren anderen Finalisten. |
Für aktuelle Verfügbarkeit, Kontext, Endpoint-Unterstützung und Modell-IDs verwenden Sie das aktuelle Flatkey-Modellverzeichnis, statt einen Namen aus einem Artikel fest zu codieren.
1. Agenten mit langem Horizont: Optimieren Sie auf Wiederherstellung, nicht auf Brillanz im ersten Entwurf
Änderungen auf Repository-Ebene legen Schwächen offen, die ein kleiner Coding-Prompt verbirgt. Ein nützlicher Agent muss Dateien untersuchen, Tools auswählen, einen minimalen Patch erstellen, Validierungen ausführen, Fehler interpretieren und vermeiden, nicht zusammenhängenden Code zu ändern. Hier unterscheiden sich die besten LLMs fürs Programmieren von Modellen, die nur eine plausible Funktion schreiben.
Beginnen Sie mit einer Aufgabe, die eine testbare Abnahmebedingung hat: einem fehlschlagenden Regressionstest, einem eng abgegrenzten Issue oder einem bekannten Refactoring mit geschützter API. Geben Sie jedem Kandidaten denselben Repository-Snapshot, dieselben Befehlsberechtigungen, Tool-Definitionen, das gleiche Timeout und dieselbe Aufgabenbeschreibung. Prüfen Sie anschließend den Patch, die ausgeführten Tests, die Wiederherstellung nach einem erwarteten Fehler und den Umfang der zusätzlich entstandenen Review-Nacharbeit.
Das aktuelle Modellverzeichnis von OpenAI bezeichnet GPT-5.1 Codex und GPT-5.1-Codex-Max als Varianten für agentisches Programmieren. Das Modellverzeichnis von Flatkey führt Claude Opus 5.5 als Option für lange, mehrstufige Programmier- und Tool-Nutzungsaufgaben auf. Das sind Gründe, sie zu testen; das Ergebnis in Ihrem Repository entscheidet.
2. Schnelle tägliche Arbeit: Optimieren Sie den gesamten Feedback-Zyklus
Autocomplete-nahe Unterstützung, kleine Korrekturen, Code-Erklärungen, das Erstellen von Tests und PR-Kommentare haben eine andere Erfolgsdefinition. Die beste Antwort ist oft diejenige, die schnell eintrifft, ein strenges Format einhält und keine zweite Anfrage benötigt.
Testen Sie für diesen Workflow neben einem hochwertigen agentischen Modell einen schnelleren Kandidaten aus derselben Anbieterfamilie. Halten Sie den Prompt kurz, verlangen Sie gegebenenfalls eine maschinenlesbare Antwort und messen Sie sowohl die Zeit bis zur ersten nützlichen Ausgabe als auch die Akzeptanzrate. Ein kostengünstigeres Modell ist nur dann ein guter Weg für die Produktion, wenn es dieselbe Qualitätsuntergrenze erfüllt.
Die Gemini-3.8-Flash-Dokumentation von Google behandelt ausdrücklich langfristiges Software Engineering, Refactoring über mehrere Dateien hinweg, deterministische Tool-Ausführung und konfigurierbare Denkstufen. Diese Eigenschaften machen es zu einem nützlichen Kandidaten, wenn sowohl Geschwindigkeit als auch Tool-Zuverlässigkeit wichtig sind; die richtige Einstellung hängt jedoch weiterhin von Ihrem Workload ab.
3. Die besten Open-Source-LLMs fürs Programmieren 2026: Beginnen Sie mit einer lizenzbewussten Vorauswahl
Suchen nach den besten Open-Source-LLMs fürs Programmieren 2026 verwischen häufig wichtige Unterschiede zwischen offenen Gewichten, quelloffenen und vollständig als Open Source veröffentlichten Modellen. Treffen Sie keine Deployment-Entscheidung allein anhand der Bezeichnung. Lesen Sie die offizielle Lizenz, prüfen Sie die Bedingungen für die kommerzielle Nutzung und messen Sie den Speicherbedarf, den Durchsatz und den operativen Aufwand, die in Ihrer Umgebung erforderlich sind.
Die Ankündigung zu Qwen3-Coder von Qwen beschreibt ein auf Coding fokussiertes Modell mit einem nativen Kontextfenster von 256K und einer extrapolierten Option mit 1 Million Tokens sowie einem Coding-CLI und Fokus auf Tool-Nutzung. Es ist ein starker erster Kandidat, wenn Sie ein codespezialisiertes Modell evaluieren möchten, das nicht an einen einzelnen gehosteten Anbieter gebunden ist.
Zwei nützliche Vergleichskontrollen sind:
- DeepSeek-Coder-V2, dessen offizielles Repository 338 unterstützte Programmiersprachen und ein Kontextfenster von 128K dokumentiert. Die Veröffentlichung ist älter; verwenden Sie es daher als gemessene Referenz statt als vermeintlichen Spitzenreiter von 2026.
- gpt-oss-120b, das OpenAI als Open-Weight-Modell unter Apache 2.0 aufführt, das auf eine H100-GPU passt. Es ist kein Ersatz für eine coding-spezifische Evaluierung; beziehen Sie es nur ein, wenn sein Deployment-Profil und das Verhalten als allgemeines Modell für Ihren Stack relevant sind.
Berücksichtigen Sie bei allen lokalen Kandidaten die Kaltstartzeit, Tokens pro Sekunde, die Gültigkeit von Tool-Aufrufen, die Test-Erfolgsquote, Speicherreserven und die Kosten für den Betrieb des Serving-Stacks. Ein Modell, das günstig aussieht, aber ständige Wiederholungen oder zusätzliche GPU-Kapazität erfordert, ist möglicherweise nicht die kostengünstigere Wahl für die Produktion.
Ein Entscheidungsbaum, der eine schlechte Modellwahl verhindert
Nutzen Sie diese Abfolge, bevor Sie Benchmark-Ergebnisse vergleichen:
- Darf der Code Ihre Umgebung verlassen? Falls nein, beginnen Sie mit Modellen, deren Lizenz und Deployment-Pfad die Anforderung erfüllen. Dokumentieren Sie die Datengrenze, bevor Evaluierungsdatenverkehr ausgeführt wird.
- Muss das Modell Tools über mehrere Schritte hinweg nutzen? Falls ja, priorisieren Sie agentische Kandidaten und testen Sie einen realen Ablauf: untersuchen, bearbeiten, ausführen, wiederherstellen und berichten.
- Ist die p95-Latenz Teil der Nutzererfahrung? Falls ja, testen Sie einen schnelleren Kandidaten separat. Gehen Sie nicht davon aus, dass die Geschwindigkeit eines Frontier-Modells bis zum ersten Token seine gesamte Abschlusszeit widerspiegelt.
- Wird die Ausgabe von nachgelagertem Code geparst? Falls ja, machen Sie eine gültige strukturierte Ausgabe zu einer harten Voraussetzung statt zu einer gewichteten Präferenz.
- Kann die Aufgabe automatisch geprüft werden? Falls ja, nutzen Sie Tests, Linter, Typprüfungen, Build-Ergebnisse oder exakte Schemas. Falls nein, verwenden Sie eine blinde menschliche Prüfung mit einem expliziten Bewertungsschema.
So vergleichen Sie die besten LLMs fürs Programmieren praktisch: Sie verwandeln das vage Wort „beste“ in explizite Einschränkungen und wiederholbare Evidenz.
Führen Sie eine Coding-Evaluierung mit 20 Fällen durch, bevor Sie sich festlegen
Öffentliche Benchmarks sind nützlich, um Kandidaten zu finden, aber sie kennen weder Ihre Frameworks, Tools, Coding-Konventionen, Datengrenzen noch den Prüfaufwand. Eine kleine, repräsentative Evaluierung ist in der Regel entscheidungsrelevanter als ein riesiger allgemeiner Score.
Erstellen Sie ein Paket mit 20 Fällen mit diesen Kategorien:
| Falltyp | Empfohlene Anzahl | So sieht ein Bestehen aus |
|---|---|---|
| Häufiges Feature oder Bugfix | 6 | Der Patch ist klar abgegrenzt, die Tests bestehen, und die Prüfung findet keine wesentliche Regression. |
| Navigation in der Codebasis | 3 | Das Modell identifiziert die richtigen Dateien und erfindet keine APIs oder Pfade. |
| Testgenerierung oder -reparatur | 3 | Der Test belegt das Verhalten, statt lediglich die Implementierung widerzuspiegeln. |
| Tool-Nutzung und Wiederherstellung | 3 | Das Modell ruft gültige Tools auf, nutzt die Ausgabe und erholt sich von einem kontrollierten Fehler. |
| Sicherheits- oder grenzsensibler Vorgang | 2 | Das Modell befolgt die Richtlinie und weist auf Unsicherheit hin, statt den Umfang stillschweigend auszuweiten. |
| Strukturierte Antwort oder Migrationsaufgabe | 3 | Die Ausgabe lässt sich parsen, bleibt innerhalb des Schemas und behandelt eine Randbedingung. |
Fixieren Sie für den ersten Durchlauf die Repository-Revision, den Prompt, die Modellparameter, die Tool-Definitionen und die Timeout-Richtlinie. Ändern Sie danach jeweils nur eine Variable. Andernfalls wissen Sie nicht, ob ein neuer Score auf eine Modelländerung, eine Überarbeitung des Prompts oder eine weniger strenge Wiederholungsrichtlinie zurückgeht.
Die Scorecard: Verwenden Sie Gates vor Gewichtungen
Schließen Sie zunächst jeden Kandidaten aus, der eine unverzichtbare Anforderung nicht erfüllt. Bewerten Sie anschließend die verbleibenden Modelle.
| Dimension | Gate oder Gewichtung | Beispielmessung |
|---|---|---|
| Test-/Build-/Sicherheitsprüfungen | Gate | Alle erforderlichen automatisierten Prüfungen bestehen. |
| Kontrolle des Umfangs | Gate | Keine Änderungen an nicht zusammenhängenden Dateien oder nicht genehmigte Abhängigkeitsänderungen. |
| Gültigkeit von Tools und Schemas | Gate | Tool-Aufrufe und strukturierte Ausgaben sind gültig. |
| Funktionale Korrektheit | 40 % | Akzeptierte Aufgabenergebnisse / versuchte Aufgaben. |
| Aufwand für Wiederherstellung und Review | 20 % | Korrekturen nach einem kontrollierten Fehlschlag; Änderungen durch Reviewer pro akzeptiertem Patch. |
| Zuverlässigkeit | 15 % | Rate für Timeouts, fehlerhaft formatierte Ausgaben und fehlgeschlagene Aufrufe. |
| Latenz | 15 % | Median- und p95-Zeit bis zu einem akzeptierten Ergebnis. |
| Kosteneffizienz | 10 % | Gesamte Evaluierungskosten / akzeptierte Aufgaben. |
Verwenden Sie diese Formel, statt einen einzelnen Tokenpreis zu vergleichen:
effective cost per accepted change = total model and tool cost ÷ accepted task results
Diese Formel berücksichtigt Wiederholungsversuche, übergroße Ausgaben, fehlgeschlagene Tool-Aufrufe und abgelehnte Patches ebenso wie den Preis. Deshalb können sich die besten LLMs fürs Programmieren für einen Produktionsservice von dem Modell unterscheiden, das einen öffentlichen Coding-Benchmark gewinnt.
Halten Sie die Integration konstant, während Sie Modelle vergleichen
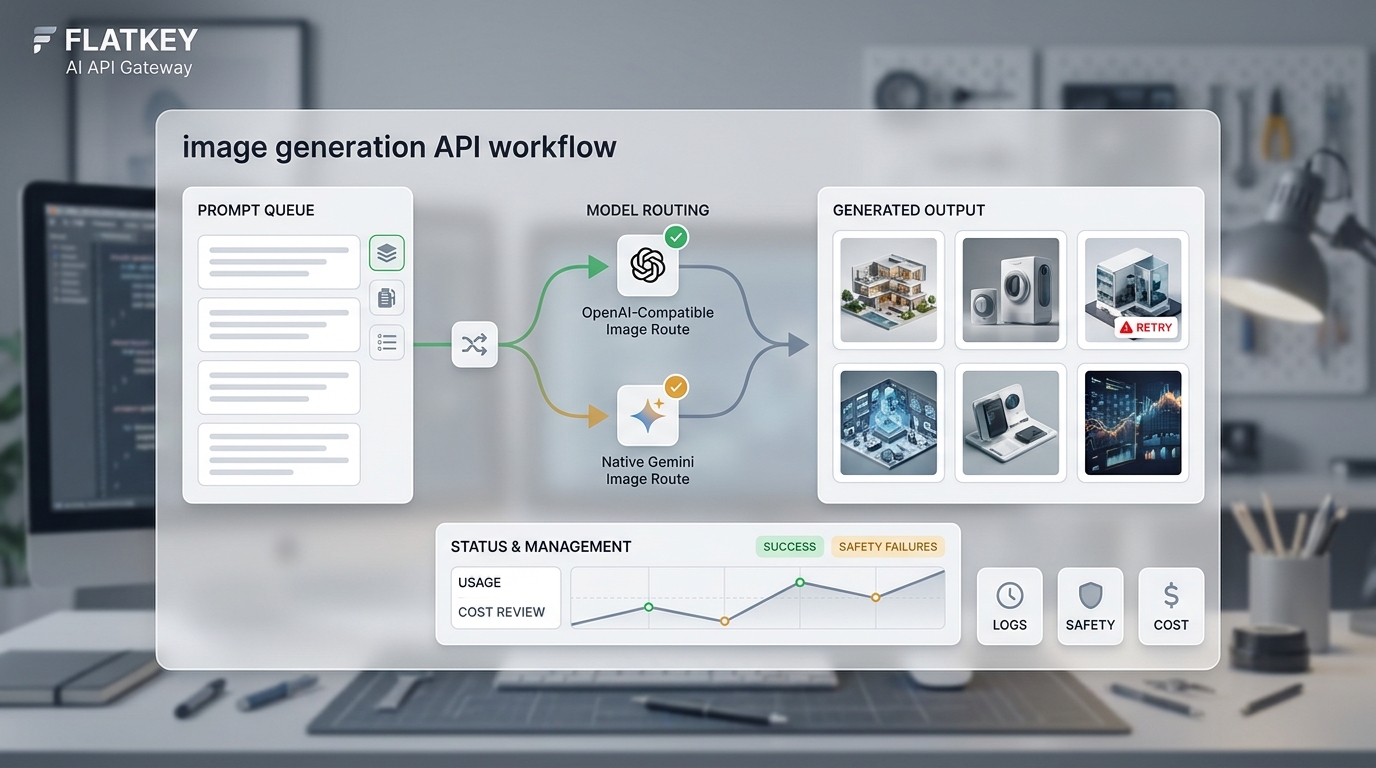
Der sauberste Vergleich hält Client, Datensatz, Bewertungsschema und Protokollierung stabil, während nur das Modell und seine erforderlichen Parameter geändert werden. Ein API-Gateway kann Integrationsabweichungen reduzieren, macht Modelle jedoch nicht austauschbar: Sie müssen weiterhin Tool-Verhalten, strukturierte Ausgabe, Streaming, Ratenlimits und anbieterspezifische Funktionen überprüfen.
Wenn Sie bereits einen OpenAI-kompatiblen Client verwenden, können Sie den Wrapper während eines schrittweisen Vergleichs stabil halten. Die aktuelle Route von Flatkey ist in seinem Leitfaden zum Prompt-Testing mit mehreren Modellen dokumentiert:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["FLATKEY_API_KEY"],
    base_url="https://router.flatkey.ai/v1",
)

candidates = [
    os.environ["AGENTIC_MODEL_ID"],
    os.environ["FAST_MODEL_ID"],
]
Wählen Sie aktuelle IDs aus dem Modellverzeichnis, senden Sie nur genehmigte Evaluierungsdaten und protokollieren Sie für jeden Fall Modell-ID, Request-ID, Nutzung, Ergebnis, Latenz und Reviewer-Ergebnis. Verwenden Sie für einen umfassenderen Rahmen den Workflow zum Vergleich von KI-Modellpreisen, um Cache-Verhalten, Wiederholungsversuche und effektive Kosten zusammen mit der Modellqualität zu verfolgen.
Auch die Gateway-Leitlinien von Anthropic verdeutlichen den operativen Zielkonflikt: Ein Gateway kann Anmeldedaten, Nutzungsnachverfolgung, Budgets, Audit-Protokollierung und Anbieterwechsel zentralisieren, muss jedoch mit der Weiterentwicklung von Coding-Tools kompatibel bleiben. Behandeln Sie diese Kompatibilität als expliziten Test, nicht als Annahme.
Ein 30-Minuten-Rolloutplan
- Wählen Sie einen realen Coding-Workflow und einen Verantwortlichen für die Evaluierung aus.
- Wählen Sie einen agentischen Kandidaten, einen schnellen Kandidaten und – falls Datenschutz oder Kontrolle dies erfordern – einen lokalen Kandidaten.
- Bereiten Sie 20 repräsentative Aufgaben vor und definieren Sie Bestehen-/Nichtbestehen-Regeln, bevor Sie Ausgaben ansehen.
- Führen Sie dasselbe Aufgabenpaket mit demselben Client und denselben Tool-Berechtigungen aus.
- Schließen Sie Kandidaten mit nicht bestandenen Gates aus und bewerten Sie dann die Finalisten anhand der obigen Tabelle.
- Testen Sie den Gewinner mit nicht kritischem Traffic, wobei Rollback und Review eingerichtet sind.
- Führen Sie das Paket nach einer Änderung der Modellversion, einer größeren Prompt-Änderung oder einer Änderung des Tool-Vertrags erneut aus.
Dieser Workflow macht die Suche nach den besten LLMs fürs Programmieren zu einer Engineering-Entscheidung, die ein anderes Teammitglied reproduzieren kann.
Häufig gestellte Fragen
Welches ist derzeit das beste LLM fürs Programmieren?
Es gibt keine belastbare allgemeingültige Antwort. Beginnen Sie für einen Coding-Agenten mit einem aktuellen agentischen Kandidaten wie Claude Opus 5.5, GPT-5.1 Codex / GPT-5.1-Codex-Max oder Gemini 3.8 Flash und vergleichen Sie diese bei einer Aufgabe in einem realen Repository. Ergänzen Sie für die lokale Bereitstellung Qwen3-Coder im Testset. Wählen Sie den Kandidaten, der Ihre Gates für Qualität, Tool-Nutzung, Latenz, Sicherheit und Betriebskosten erfüllt.
Welches sind die besten Open-Source-LLMs fürs Programmieren im Jahr 2026?
Betrachten Sie dies ebenso sehr als Lizenz- und Hardwarefrage wie als Frage der Fähigkeiten. Qwen3-Coder ist ein auf Code spezialisierter Kandidat, der zuerst getestet werden sollte; DeepSeek-Coder-V2 und gpt-oss-120b können je nach Ihren Anforderungen als nützliche Vergleichskandidaten dienen. Bestätigen Sie vor der Nutzung anhand der offiziellen Quelle die aktuelle Lizenz und Eignung für die Bereitstellung und messen Sie anschließend Ihre eigenen Coding-Aufgaben.
Sind Listen der besten LLMs fürs Programmieren aus dem Jahr 2025 noch nützlich?
Nur als historischer Kontext. Eine Suchanfrage wie „beste LLMs fürs Programmieren 2025“ kann nützliche Testmethoden liefern, aber Modellnamen, Aliase, Verfügbarkeit und Fähigkeiten ändern sich zu schnell, um eine alte Rangliste als Produktionsentscheidung zu behandeln. Nutzen Sie ein aktuelles Verzeichnis und eine neue Evaluierung.
Reichen Coding-Benchmarks aus, um ein Modell auszuwählen?
Nein. Benchmarks können dabei helfen, eine Vorauswahl zu treffen, doch Ihr Produkt kann von einer bestimmten Sprache, Repository-Struktur, einem Tool-Vertrag, Latenzziel, einer Datenrichtlinie oder einem Prüfstandard abhängen. Ein kleines kontrolliertes Aufgabenpaket bildet die Brücke vom Benchmark-Signal zu einer Engineering-Entscheidung.
Sollte ich ein Gateway verwenden, um Programmiermodelle zu vergleichen?
Ein Gateway kann Zugangsdaten, Nutzungsaufzeichnungen, Budgets und eine Client-Schnittstelle über Tests hinweg konsistenter halten. Es garantiert nicht, dass jedes Modell jede anbieterspezifische Funktion auf dieselbe Weise unterstützt. Prüfen Sie jede Fähigkeit vor dem Produktionseinsatz, insbesondere Tool-Aufrufe, strukturierte Ausgaben, Streaming und Fehlerbehandlung.
Das beste Modell ist das, das Ihre Test-Suite übersteht
Die besten LLMs fürs Programmieren sind nicht die Modelle mit dem lautesten Launch, dem schmeichelhaftesten öffentlichen Benchmark oder dem scheinbar günstigsten Preis. Es sind die Kandidaten, die Ihre repräsentativen Aufgaben erledigen, Grenzen respektieren, sich von Fehlern erholen und auch nach Wiederholungsversuchen und Prüfaufwand wirtschaftlich bleiben.
Beginnen Sie mit dem aktuellen Flatkey-Modellverzeichnis, halten Sie den Evaluierungs-Wrapper stabil und veröffentlichen Sie die Scorecard zusammen mit Ihrer Entscheidung. So erhält Ihr Team eine wiederholbare Methode, die Wahl erneut zu prüfen, wenn die nächste Modellversion erscheint.