API-Gateway-Architektur und wichtige Funktionen (Leitfaden 2026)
Ein API-Gateway ist ein zentraler Einstiegspunkt zwischen Clients und Ihren Backend-Diensten: Es nimmt jede Anfrage entgegen, wendet Sicherheits- und Traffic-Richtlinien an und leitet sie an den richtigen Dienst weiter. Seine Architektur besteht aus zwei Teilen: einer Data Plane, die den Live-Traffic verarbeitet (Routing, Authentifizierung, Rate Limiting, Transformation, Caching, Logging), und einer Control Plane, in der Sie diese Richtlinien konfigurieren. Die wichtigsten Funktionen sind Routing, Authentifizierung und Autorisierung, Rate Limiting, Request- und Response-Transformation, Caching, Observability sowie Resilienzmechanismen wie Timeouts, Retries und Circuit Breaker.
Dieser Leitfaden erklärt die API-Gateway-Architektur anhand eines Diagramms, beschreibt jede Komponente und Funktion, vergleicht gängige Deployment-Muster und Produkte und zeigt funktionierende Konfiguration und Code. Der letzte Abschnitt zeigt, wie dieselbe Architektur auf Gateways für APIs großer Sprachmodelle (LLM) übertragen wird. Die Produktangaben stammen aus der offiziellen Dokumentation, Stand 24. Oktober 2026.
Was ist ein API-Gateway?
In einem Microservice-System ohne Gateway müssten Clients Adresse, Protokoll und Authentifizierungsverfahren jedes einzelnen Dienstes kennen. Das API-Gateway-Muster stellt eine einzige Komponente davor. Clients rufen das Gateway auf, und das Gateway entscheidet, wohin jede Anfrage geht und welche Regeln gelten.
Ohne Gateway implementiert jeder Dienst Authentifizierung, Rate Limits und Logging neu, und jeder Client muss angepasst werden, wenn ein Dienst umzieht. Mit einem Gateway liegen diese Querschnittsaufgaben an einem Ort, und die Dienste können sich hinter einer stabilen öffentlichen API ändern.
Diagramm der API-Gateway-Architektur
 Clients (web, mobile, partners, internal jobs)
        |
        v
 [ DNS / CDN / WAF / Load balancer ]
        |
        v
 +--------------------- API GATEWAY (data plane) ---------------------+
 |  TLS termination -> AuthN/AuthZ -> Rate limit & quota ->           |
 |  Request validation & transform -> Cache lookup -> Router          |
 |  -> Timeouts / retries / circuit breaker -> Response transform     |
 |  -> Logs, metrics, traces                                          |
 +--------------------------------------------------------------------+
        |               |                 |
        v               v                 v
   Orders service   Users service   Payments service   (or Lambda, queues, LLM providers)

 Control plane: config store, admin API/UI, policy and key management, deploys config to data plane
Kernkomponenten
| Komponente | Aufgabe |
|---|---|
| Listener / TLS-Terminierung | Nimmt HTTP/1.1-, HTTP/2-, gRPC- oder WebSocket-Verbindungen an und entschlüsselt TLS |
| Authentifizierung und Autorisierung | Prüft API-Keys, OAuth-2.0-/JWT-Tokens oder mTLS-Zertifikate und anschließend die Berechtigungen |
| Rate Limiter und Kontingente | Begrenzt Anfragen pro Client, Key oder Route; liefert bei Überschreitung HTTP 429 |
| Request-Validierung und -Transformation | Prüft Schemas, schreibt Pfade und Header um, konvertiert Protokolle (z. B. REST zu gRPC) |
| Cache | Liefert wiederholte Antworten, ohne das Backend aufzurufen |
| Router | Ordnet Pfad, Methode, Host oder Header einem Upstream-Dienst zu und verteilt die Last auf Instanzen |
| Resilienzschicht | Timeouts, Retries mit Backoff, Circuit Breaker und Fallbacks |
| Observability | Access-Logs, Metriken (Latenz, Fehlerrate) und verteilte Traces |
| Control Plane | Speichert die Konfiguration und verteilt sie an die Gateway-Instanzen; bietet eine Admin-API oder UI |
Lebenszyklus einer Anfrage
- Der Client sendet
GET /orders/42mit einem Bearer-Token. - Das Gateway terminiert TLS und validiert das Token.
- Es prüft Rate Limit und Kontingent des Aufrufers.
- Es validiert die Anfrage und fügt Header wie eine Request-ID hinzu.
- Es prüft den Cache und routet bei einem Miss an eine gesunde
orders-Instanz. - Es wendet einen Timeout an, wiederholt die Anfrage bei einem Verbindungsfehler einmal und protokolliert das Ergebnis.
- Bei Bedarf transformiert es die Antwort und gibt sie zurück, wobei Status, Latenz und Aufrufer geloggt werden.
Wichtige Funktionen eines API-Gateways
Diese Funktionen brauchen die meisten Teams, grob nach Wichtigkeit geordnet:
- Request-Routing. Routing nach Pfad, Host, Methode und Header sowie Load Balancing und Canary- oder gewichtete Releases.
- Authentifizierung und Autorisierung. API-Keys, OAuth-2.0- und JWT-Validierung, mTLS und Zugriffsrichtlinien pro Route.
- Rate Limiting und Kontingente. Limits pro Consumer, die Backends schützen; HTTP 429 „Too Many Requests“ ist in RFC 6585 definiert.
- Request- und Response-Transformation. Header-Injektion, Payload-Mapping, Protokollübersetzung und API-Versionierung.
- Caching. Response-Caching mit TTL, um Latenz und Backend-Last zu senken.
- Sicherheit. TLS, IP-Allow- und Denylists, Größenbeschränkungen für Anfragen und Anbindung an eine Web Application Firewall.
- Observability. Strukturierte Access-Logs, Metriken und Trace-Propagation zu Tools wie Grafana Tempo oder Datadog.
- Resilienz. Timeouts, Retries, Circuit Breaker und Health Checks.
- Developer Experience. API-Keys und Tarife, ein Entwicklerportal und Nutzungsanalysen; oft unter „API Management“ zusammengefasst.
- Monetarisierung und Metering. Nutzungszählung pro Consumer für Abrechnung oder interne Kostenverrechnung.
Deployment-Muster
| Muster | Funktionsweise | Wann sinnvoll |
|---|---|---|
| Ein zentrales Gateway | Ein Gateway-Cluster bedient alle Dienste | Kleine bis mittlere Systeme, ein Team verantwortet den Edge |
| Backend for Frontend (BFF) | Ein eigenes Gateway pro Client-Typ (Web, Mobile, Partner) | Clients brauchen sehr unterschiedliche APIs |
| Gateway pro Domäne | Jede Fachdomäne betreibt ihr eigenes Gateway | Große Organisationen mit autonomen Teams |
| Kubernetes Ingress / Gateway API | Gateway wird über Kubernetes-Ressourcen konfiguriert | Dienste laufen bereits auf Kubernetes |
| Gateway plus Service Mesh | Gateway übernimmt Nord-Süd-Traffic (Clients), das Mesh Ost-West-Traffic (zwischen Diensten) | Viele interne Dienste, die mTLS und Traffic-Richtlinien benötigen |
Die Kubernetes Gateway API ist inzwischen der Standardweg, Gateways auf Kubernetes zu konfigurieren, und Implementierungen wie Envoy Gateway bauen darauf auf.
API-Gateway vs. Load Balancer vs. Service Mesh
- Ein Load Balancer verteilt Traffic auf die Instanzen eines Dienstes, meist auf Netzwerk- oder HTTP-Ebene, ohne API-bezogene Richtlinien.
- Ein API-Gateway versteht APIs: Es authentifiziert Consumer, setzt Kontingente pro Key durch, transformiert Payloads und routet über viele Dienste hinweg.
- Ein Service Mesh steuert den Traffic zwischen internen Diensten, meist über Sidecars oder Proxys pro Node.
Die meisten Produktivsysteme setzen einen Load Balancer vor das Gateway, manche ergänzen dahinter ein Mesh.
Beliebte API-Gateway-Produkte
| Produkt | Typ | Hinweise (Oktober 2026) |
|---|---|---|
| Amazon API Gateway | Managed (AWS) | REST-, HTTP- und WebSocket-APIs; das kostenlose Kontingent umfasst 12 Monate lang monatlich 1 Million REST-Aufrufe, 1 Million HTTP-Aufrufe und 1 Million WebSocket-Nachrichten sowie 750.000 Verbindungsminuten |
| Kong Gateway | Open Source und Enterprise | Plugin-basiert; läuft DB-less mit deklarativer Konfiguration oder mit Datenbank |
| Envoy Gateway | Open Source | Envoy-Proxy, verwaltet über die Kubernetes Gateway API |
| Azure API Management | Managed (Azure) | Verwaltete und selbst gehostete Gateways sowie ein Entwicklerportal |
Beispiel: deklarative Kong-Konfiguration
Diese DB-less-Konfiguration für Kong routet /orders an ein Backend, verlangt einen API-Key und begrenzt jeden Consumer auf 60 Anfragen pro Minute:
_format_version: "3.0"
services:
  - name: orders
    url: http://orders:8080
    routes:
      - name: orders-route
        paths: ["/orders"]
    plugins:
      - name: key-auth
      - name: rate-limiting
        config:
          minute: 60
          policy: local
consumers:
  - username: mobile-app
    keyauth_credentials:
      - key: replace-with-a-long-random-key
Beispiel: ein minimales Gateway in Python
Um die Architektur im Code zu sehen, hier ein kleines lauffähiges Gateway mit API-Key-Authentifizierung, Rate Limiting pro Key, Routing und Timeout. Es dient zum Lernen; für echten Traffic sollten Sie ein produktionsreifes Gateway verwenden.
# pip install fastapi uvicorn httpx ; run: uvicorn gateway:app --port 8080
import time, httpx
from collections import defaultdict
from fastapi import FastAPI, Request, Response, HTTPException

ROUTES = {"/orders": "http://localhost:9001", "/users": "http://localhost:9002"}
KEYS = {"key-mobile": "mobile-app"}
LIMIT_PER_MIN = 60
hits = defaultdict(list)
app = FastAPI()

@app.api_route("/{path:path}", methods=["GET", "POST", "PUT", "DELETE"])
async def gateway(path: str, request: Request):
    consumer = KEYS.get(request.headers.get("x-api-key", ""))
    if not consumer:
        raise HTTPException(401, "invalid API key")
    now = time.time()
    hits[consumer] = [t for t in hits[consumer] if now - t < 60]
    if len(hits[consumer]) >= LIMIT_PER_MIN:
        raise HTTPException(429, "rate limit exceeded", headers={"Retry-After": "60"})
    hits[consumer].append(now)
    prefix = next((p for p in ROUTES if f"/{path}".startswith(p)), None)
    if not prefix:
        raise HTTPException(404, "no route")
    async with httpx.AsyncClient(timeout=5.0) as client:
        upstream = await client.request(request.method, ROUTES[prefix] + f"/{path}"[len(prefix):],
                                        content=await request.body(),
                                        headers={"x-consumer": consumer})
    return Response(upstream.content, upstream.status_code,
                    media_type=upstream.headers.get("content-type"))
Vom API-Gateway zum LLM-Gateway
Wenn die Backends KI-Modellanbieter statt Microservices sind, gilt dieselbe Architektur, allerdings mit einigen zusätzlichen Aufgaben. Ein LLM-Gateway (oder AI-Gateway) ergänzt:
| Klassische Gateway-Funktion | Erweiterung im LLM-Gateway |
|---|---|
| Routing nach Pfad | Routing nach Modellname, Kosten, Latenz oder Zustand des Anbieters |
| Rate Limiting nach Anfragen | Limits nach Tokens pro Minute und Ausgaben pro Key |
| Request-Transformation | Übersetzung zwischen den Request-Formaten von OpenAI, Anthropic und Gemini |
| Response-Caching | Prompt Caching und semantisches Caching |
| Retries und Circuit Breaker | Fallback auf einen anderen Anbieter oder ein anderes Modell bei 429, 5xx oder Timeout |
| Access-Logs | Token-Anzahl, Kosten pro Anfrage und verwendetes Modell |
| API-Keys pro Consumer | Ein Key für viele Anbieter, mit Budgets pro Team |
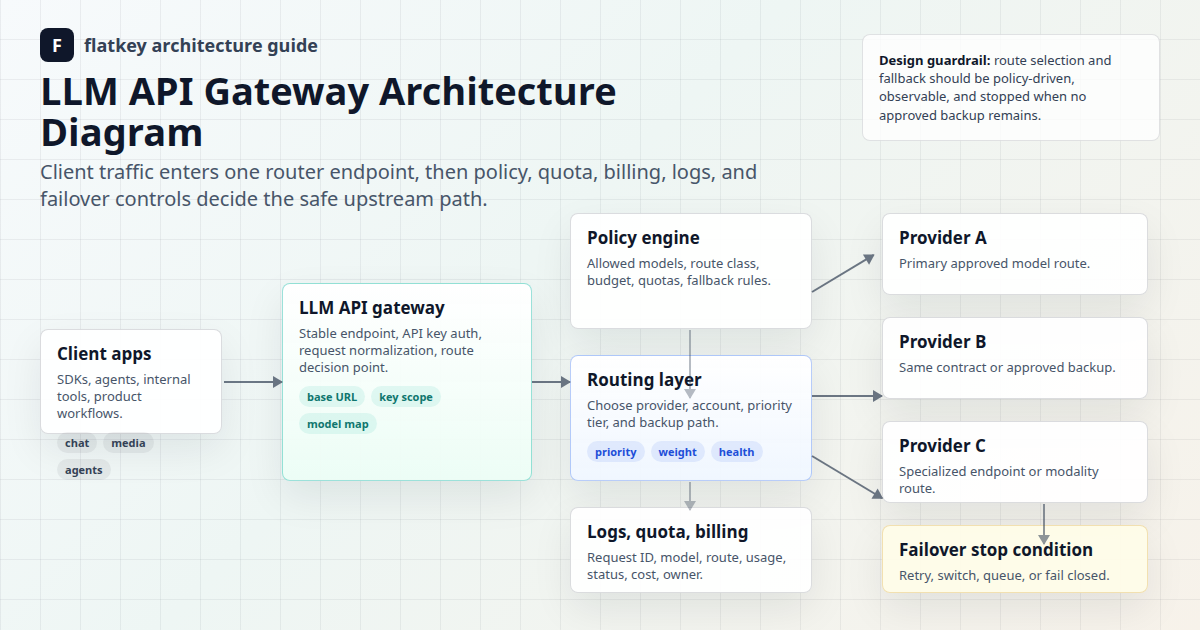
 App / agent  --OpenAI-format request-->  LLM gateway
   auth + budget check -> model map -> route (primary provider)
   -> on 429/5xx/timeout: fallback provider -> usage + cost log
   -> Anthropic / OpenAI / Google / DeepSeek / self-hosted vLLM
Sie können diese Schicht selbst betreiben (etwa mit LiteLLM oder den KI-Plugins von Kong) oder eine verwaltete Lösung nutzen. Flatkey ist eine verwaltete Option: ein OpenAI-kompatibler Endpoint unter https://router.flatkey.ai/v1, ein Key für über 300 Modelle, Nutzungslogs mit Tokens und Kosten pro Aufruf sowie Ausgabenlimits pro Key oder Gruppe, laut der Dokumentation mit Stand Oktober 2026. Da das OpenAI-Format verwendet wird, müssen bestehende Clients nur die Base-URL ändern:
curl https://router.flatkey.ai/v1/chat/completions \
  -H "Authorization: Bearer $FLATKEY_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model":"claude-sonnet-5-5","messages":[{"role":"user","content":"Summarize the API gateway pattern in one sentence."}]}'
Für tiefergehendes Design lesen Sie unsere Leitfäden zu AI-API-Gateway-Architektur und Modell-Routing, Circuit Breakern für LLM-Gateways, AI-Gateway vs. API Management und verwaltetem AI-Gateway vs. selbst gehostetem Proxy. Wenn das Thema neu für Sie ist, ist der Einsteigerleitfaden zu LLM-Gateways ein guter Start, und der Leitfaden zum Umgang mit Rate Limits behandelt Strategien für 429-Fehler.
Design-Checkliste
- Platzieren Sie TLS, Authentifizierung und Rate Limiting im Gateway, nicht in jedem Dienst.
- Setzen Sie für jede Upstream-Route einen Timeout; warten Sie nie unbegrenzt.
- Wiederholen Sie nur idempotente Anfragen (GET, PUT, DELETE gemäß RFC 9110), sofern das Backend keine Idempotency-Keys unterstützt.
- Reichen Sie eine Request-ID und den Trace-Kontext an jedes Backend weiter.
- Betreiben Sie mindestens zwei Gateway-Instanzen hinter einem Load Balancer, damit das Gateway kein Single Point of Failure ist.
- Halten Sie Geschäftslogik aus dem Gateway heraus; es soll Richtlinien durchsetzen, keine Funktionen implementieren.
- Versionieren Sie die Gateway-Konfiguration in Git und deployen Sie sie als Code.
Häufig gestellte Fragen
Was ist das API-Gateway-Muster bei Microservices?
Es ist ein Design, bei dem ein einziges Gateway der Einstiegspunkt für alle Client-Anfragen ist. Das Gateway routet jede Anfrage an den richtigen Microservice und übernimmt gemeinsame Aufgaben wie Authentifizierung, Rate Limiting und Logging, sodass Clients die Dienste nicht direkt aufrufen.
Was sind die wichtigsten Funktionen eines API-Gateways?
Die Kernfunktionen sind Request-Routing, Authentifizierung und Autorisierung, Rate Limiting und Kontingente, Request- und Response-Transformation, Caching, Sicherheitskontrollen, Observability sowie Resilienzfunktionen wie Timeouts, Retries und Circuit Breaker.
Aus welchen Hauptkomponenten besteht eine API-Gateway-Architektur?
Aus einer Data Plane, die den Traffic verarbeitet (Listener, Authentifizierung, Rate Limiter, Transformer, Cache, Router, Resilienzschicht und Telemetrie), und einer Control Plane, die die Konfiguration speichert und verteilt.
Ist ein API-Gateway dasselbe wie ein Load Balancer?
Nein. Ein Load Balancer verteilt Traffic auf die Instanzen eines Dienstes. Ein API-Gateway ergänzt API-bezogene Funktionen wie Authentifizierung pro Consumer, Kontingente, Payload-Transformation und Routing über viele Dienste. Die meisten Systeme nutzen beides.
Was ist ein LLM-Gateway?
Ein LLM-Gateway ist ein API-Gateway, das auf den Traffic von KI-Modellen spezialisiert ist. Es routet nach Modell und Anbieter, begrenzt nach Tokens und Ausgaben, übersetzt zwischen den API-Formaten der Anbieter, weicht bei Ausfällen eines Anbieters auf Alternativen aus und protokolliert Token-Verbrauch und Kosten.
Ist ein API-Gateway ein Single Point of Failure?
Das kann es sein, wenn nur eine Instanz läuft. Betreiben Sie mehrere Instanzen in verschiedenen Zonen hinter einem Load Balancer, halten Sie die Konfiguration in einem replizierten Speicher und überwachen Sie das Gateway selbst.