LLM Gateway Einsteigerleitfaden: Von der ersten Anfrage bis zur Produktion
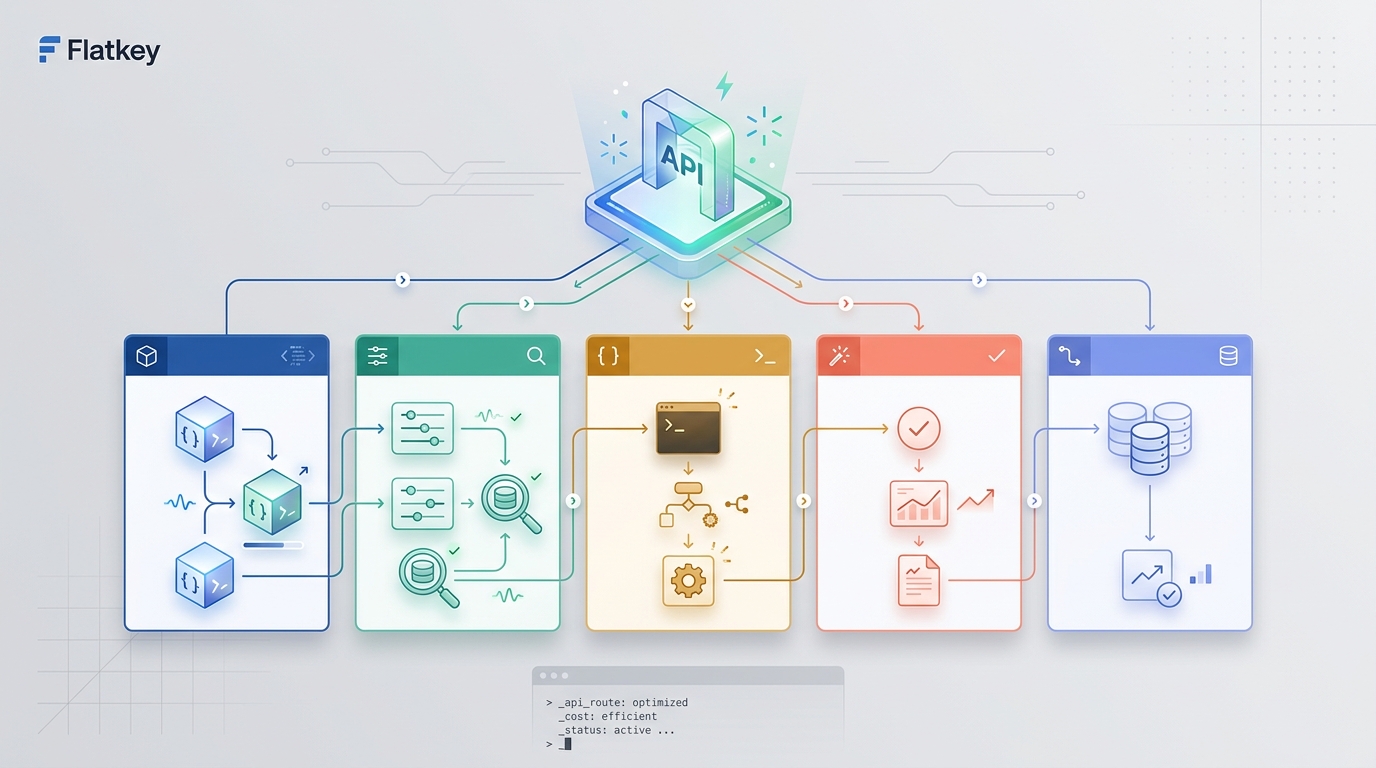
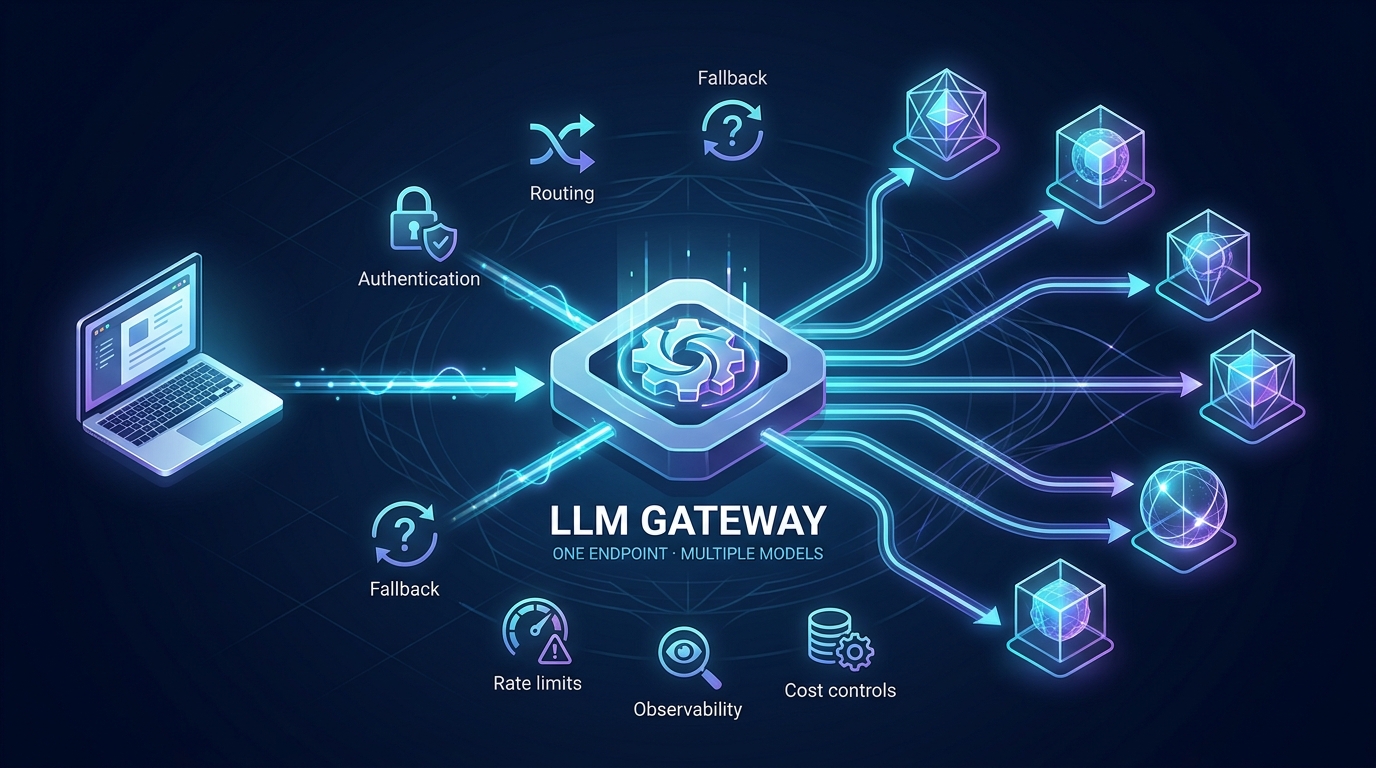
Ein LLM-Gateway ist eine Kontrollschicht zwischen Ihrer Anwendung und einem oder mehreren KI-Modellanbietern. Ihre App sendet Anfragen an das Gateway, statt sich separat mit jedem Anbieter zu verbinden. Das Gateway authentifiziert dann die Anfrage, wendet Richtlinien an, wählt ein Modell oder eine Upstream-Verbindung aus, leitet den Aufruf weiter und protokolliert das Ergebnis.
Das klingt nach gewöhnlichem API-Glue-Code, löst aber ein Problem, das in echten KI-Produkten schnell auftritt: Die erste Model-Integration ist einfach; die fünfte ist es nicht. Jeder Anbieter kann einen weiteren Schlüssel, ein SDK, ein Anfrageformat, eine Rate-Limit-Richtlinie, eine Fehlerform, eine Nutzungsseite und eine Rechnung mitbringen.
Dieser LLM-Gateway-Einsteigerleitfaden erklärt, was diese Schicht leistet, wie eine Anfrage sie durchläuft, wie sie sich von angrenzenden Tools unterscheidet, wann Sie eine benötigen und wie Sie eine erste Gateway-Integration umsetzen, ohne sie zu überarchitektieren. Außerdem erhalten Sie eine Build-vs.-Buy-Bewertung, einen gestaffelten Rollout-Plan und messbare Abnahmekriterien, um zu entscheiden, ob ein Gateway echten Geschäftswert schafft.
Aktualisiert am 4. August 2026: Dieser Leitfaden enthält jetzt zusätzlich zum 15-Minuten-Quickstart und der Rollout-Checkliste ein Labor für die ersten 100 Anfragen mit einem Request-Envelope, drei Testbatches, einem Abnahme-Register und Kriterien für den Übergang in die Produktion.
Die 60-Sekunden-Einsteigerentscheidung
Sie brauchen wahrscheinlich noch kein LLM-Gateway, wenn eine Anwendung einen Anbieter anspricht, die Arbeitslast noch experimentell ist und ein kurzer Ausfall oder eine manuelle Schlüsselrotation keine Auswirkungen auf Kunden hätte.
Sie sollten ein Gateway evaluieren, wenn zwei oder mehr dieser Aussagen zutreffen:
- Ihre Anwendung nutzt oder wird voraussichtlich mehr als einen Modellanbieter nutzen;
- mehrere Dienste benötigen KI-Zugangsdaten und Nutzungskontrollen;
- Rate Limits oder Vorfälle bei Anbietern können einen Kunden-Workflow unterbrechen;
- die Finanzabteilung kann Modellkosten keinem Team, Produkt oder Kunden zuordnen;
- das Wechseln von Modellen erfordert ein Anwendungs-Deployment;
- Sie benötigen eine gemeinsame Allowlist, ein Kontingent, einen Audit-Trail oder eine Fallback-Richtlinie;
- Entwickler bauen dieselben Provider-Adapter in mehreren Repositories immer wieder neu.
Der Anfängerfehler besteht darin, ein Gateway einzuführen, weil das Architekturdiagramm reif aussieht. Führen Sie es ein, wenn es wiederkehrende operative Arbeit reduziert oder eine Kontrolle schafft, die Sie messen können.
Was ist ein LLM-Gateway?
Ein LLM-Gateway, auch LLM-API-Gateway oder AI-Gateway genannt, bietet Anwendungen eine stabile Schnittstelle für den Zugriff auf KI-Modelle. In der einfachsten Form stellt es Folgendes bereit:
- einen Endpunkt für Modellanfragen;
- eine Authentifizierungsgrenze;
- einen konsistenten Anfrage- und Antwortvertrag;
- zentralisierte Nutzungsprotokolle;
- Routing-Regeln, die entscheiden, wohin eine Anfrage geleitet wird.
Ein leistungsfähigeres Gateway kann außerdem Budgets durchsetzen, zulässige Modelle einschränken, begrenzte Wiederholungsversuche behandeln, zwischen gleichwertigen Routen auf einen Ausweichpfad umschalten, Anfrage-IDs anhängen, Fehler normalisieren und Telemetrie zu Latenz, Tokens und Kosten ausgeben.
Die wichtige Idee in diesem Einsteigerleitfaden für LLM-Gateways ist die Trennung von Zuständigkeiten. Ihr Produktcode sollte die Aufgabe beschreiben, die erledigt werden muss. Das Gateway sollte den Zugriff auf Anbieter, Routing-Richtlinien und operative Kontrollen übernehmen.
Application
    │
    │ one authenticated request
    ▼
LLM gateway
    ├── policy and quota check
    ├── model or route selection
    ├── provider request
    ├── retry or safe fallback
    └── usage and error record
             │
             ├── Provider A / Model 1
             ├── Provider B / Model 2
             └── Provider C / Model 3
Warum nicht jeden Modelanbieter direkt aufrufen?
Die direkte Integration ist oft der richtige Ausgangspunkt. Wenn ein Prototyp ein Modell verwendet, wenig Traffic hat und keine gemeinsamen Kontrollen benötigt, kann ein Gateway mehr Komplexität als Nutzen schaffen.
Der Kompromiss ändert sich, wenn die Anwendung mehrere Anbieter benötigt oder in der Produktion zuverlässig betrieben werden muss.
| Concern | Direct provider integrations | LLM gateway |
|---|---|---|
| Credentials | Separate keys in each environment | One application-facing key or identity |
| Client code | Provider-specific clients and adapters | Stable client contract where supported |
| Model switching | Application change or configuration per provider | Central route or model policy change |
| Rate limits | Handled separately for each provider | Coordinated limits, queues, and retry policy |
| Usage tracking | Split across provider dashboards | Central request, token, latency, and cost records |
| Failover | Custom logic in each application | Shared, contract-aware fallback policy |
| Governance | Repeated in every service | Central model allowlists, quotas, and audit fields |
Das Gateway lässt die Unterschiede zwischen Anbietern nicht verschwinden. Modelle können weiterhin unterschiedliche Fähigkeiten, Kontextgrenzen, Tool-Schemas, Streaming-Verhalten, Sicherheitsrichtlinien und Preisgestaltung haben. Ein gutes Gateway macht diese Unterschiede explizit und handhabbar, statt so zu tun, als seien alle Modelle austauschbar.
Wie ein LLM-Gateway Schritt für Schritt funktioniert
1. Die Anwendung sendet eine Anfrage
Die Anwendung ruft eine stabile Basis-URL auf und verwendet eine Gateway-Anmeldeinformation. Bei einem OpenAI-kompatiblen Gateway muss ein vorhandener OpenAI-Client möglicherweise nur eine andere base_url, einen anderen API-Schlüssel und eine andere Modellkennung verwenden.
2. Das Gateway authentifiziert und autorisiert sie
Das Gateway überprüft das aufrufende Projekt, die Umgebung, den Benutzer oder die Workload. Anschließend kann es eine Allowlist, ein Kontingent, ein Budget oder eine Richtlinie für die maximale Tokenanzahl prüfen, bevor Kosten beim Upstream entstehen.
3. Eine Routing-Regel wählt das Ziel aus
Die Anfrage kann ein exaktes Modell angeben. Sie kann einen vom Team verwalteten Alias wie support-fast verwenden. Oder sie kann eine Routing-Richtlinie durchlaufen, die Fähigkeiten, Verfügbarkeit, Region, Latenz oder Kosten berücksichtigt.
Für eine erste Implementierung solltest du eine explizite Modellauswahl oder einen einfachen Alias bevorzugen. Dynamisches Routing ist nützlich, sollte aber erst dann kommen, wenn du Evaluierungsdaten und Observability hast.
4. Das Gateway übersetzt nur das, was es beibehalten kann
Einige Gateways stellen über mehrere Anbieter hinweg einen OpenAI-kompatiblen Vertrag bereit. Das Gateway ordnet Felder in die API des ausgewählten Anbieters ein und normalisiert die Antwort, wo immer das möglich ist.
Kompatibilität hat Grenzen. Teste vor dem Wechsel von Modellen strukturierte Ausgaben, Tool-Calling, Bilder, Streaming, Abschlussgründe, Token-Abrechnung und Fehlerverhalten. „Kompatibel“ sollte bedeuten, dass dein erforderlicher Vertrag die Tests bestanden hat, und nicht bloß, dass die Anfrage HTTP 200 zurückgegeben hat.
5. Das Gateway handhabt die Betriebsrichtlinien
Das Gateway kann ein Timeout anwenden, ein Retry-Budget einhalten, eine fehlerhafte Route pausieren oder einen Fallback wählen. Retries müssen begrenzt sein. Fallbacks müssen den Task-Vertrag beibehalten. Anfragen mit Tool-Nebenwirkungen oder teilweise gestreamter Ausgabe benötigen möglicherweise statt eines automatischen Replays einen Stop-and-Reconcile-Pfad.
Für ein tiefergehendes Produktionsdesign verwende das Playbook zur Model-Fallback-Strategie und den Leitfaden zu LLM-Rate-Limits.
6. Das Gateway zeichnet auf, was passiert ist
Nützliche Aufzeichnungen umfassen eine Request-ID, Anwendung, Umgebung, angefordertes Modell, aufgelösten Anbieter und Modell, Latenz, Status, Retry-Anzahl, Eingabe- und Ausgabe-Token sowie geschätzte Kosten.
Protokolliere Roh-Prompts und -Antworten standardmäßig nicht. Protokolliere Metadaten, die den Betrieb unterstützen, und behandle Content-Logging als separate Sicherheits- und Datenschutzentscheidung.
Ein 15-Minuten-LLM-Gateway-Quickstart
Der schnellste Weg, ein Gateway zu verstehen, besteht darin, eine nicht kritische Anfrage darüber zu routen. Verwende ein serverseitiges Testskript, ein explizites Modell und einen Prompt mit einem offensichtlichen erwarteten Ergebnis. Beginne nicht mit automatischem Routing oder einem Produktionsagenten.
Schritt 1: Den Direct-Provider-Baselinewert erfassen
Bevor du etwas änderst, speichere fünf Fakten aus dem aktuellen direkten Aufruf:
- ob die Antwort die Aufgabe erfüllt;
- Gesamtlatenz und Zeit bis zum ersten Token, falls gestreamt wird;
- Eingabe- und Ausgabe-Token-Anzahl;
- Request-ID des Anbieters und Fehlerform;
- geschätzte Kosten für das akzeptierte Ergebnis.
So hast du etwas Konkretes zum Vergleichen. Eine Gateway-Migration ist nicht allein deshalb erfolgreich, weil sie HTTP 200 zurückgibt.
Schritt 2: Die Verbindung ändern, nicht die Workload
Bei einem OpenAI-kompatiblen Gateway sind die für die Anwendung sichtbaren Änderungen normalerweise ein Gateway-API-Schlüssel, eine Gateway-Base-URL und eine unterstützte Modellkennung. Die genauen Namen der Umgebungsvariablen hängen vom Client und vom Gateway ab.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["LLM_GATEWAY_API_KEY"],
    base_url=os.environ["LLM_GATEWAY_BASE_URL"],
)

response = client.chat.completions.create(
    model=os.environ["LLM_GATEWAY_MODEL"],
    messages=[
        {"role": "system", "content": "Gib nur gültiges JSON zurück."},
        {"role": "user", "content": "Klassifiziere dieses Ticket als Billing, Bug oder Feature: Mir wurde zweimal etwas berechnet."},
    ],
    temperature=0,
)

print(response.choices[0].message.content)
Bewahren Sie Anmeldedaten auf dem Server auf. Platzieren Sie niemals einen Master-Key des Gateways in Browser-JavaScript, in einer mobilen Binärdatei, in einem öffentlichen Repository oder in einem gemeinsam genutzten Screenshot.
Schritt 3: Vergleichen Sie den Response-Vertrag
Prüfen Sie mehr als nur die Textqualität. Bestätigen Sie die Felder, die Ihre Anwendung tatsächlich verwendet:
- Response-ID und Modellname;
- Abschlussgrund;
- Token-Nutzung;
- Reihenfolge der Streaming-Ereignisse;
- Verhalten strukturierter Ausgaben;
- Bezeichner und Argumente von Tool-Calls;
- HTTP-Status und Fehlerkörper;
- Verhalten bei Abbruch und Timeout.
Die OpenAI-Kompatibilität reduziert den Migrationsaufwand, garantiert aber nicht, dass sich jede Provider-Funktion identisch verhält. Testen Sie den Vertrag, auf den Ihr Code angewiesen ist.
Schritt 4: Erzwingen Sie einen sicheren Fehler
Verwenden Sie eine Testumgebung, um einen vorhersagbaren Fehler auszulösen, z. B. einen ungültigen Modellnamen, ein absichtlich winziges Timeout oder ein Entwicklungskontingent. Verifizieren Sie, dass das Gateway eine nachvollziehbare Request-ID und einen Fehler zurückgibt, den Ihre Anwendung klassifizieren kann.
Testen Sie keinen Provider-Ausfall, indem Sie unkontrollierte Produktionslast erzeugen. Das Ziel ist zu beweisen, dass Ihre Anwendung zwischen Authentifizierungs-, Rate-Limit-, Timeout-, Upstream- und Validierungsfehlern unterscheiden kann.
Schritt 5: Treffen Sie eine Entscheidung mit einer Akzeptanztabelle
| Prüfung | Akzeptanzregel für Einsteiger |
|---|---|
| Ausgabe | Besteht die gleiche Aufgabenvalidierung wie der direkte Aufruf |
| Latenz | Liegt innerhalb des für die Arbeitslast angegebenen Budgets |
| Nutzung | Token-Felder sind vorhanden oder das Fehlen ist dokumentiert |
| Nachverfolgbarkeit | Eine Request-ID verbindet App, Gateway und Upstream-Datensatz |
| Fehler | Die App kann wiederholbare und nicht wiederholbare Fehler klassifizieren |
| Kosten | Gemessen pro akzeptiertem Ergebnis, nicht pro Rohanfrage |
| Rollback | Die Rückkehr zum direkten Pfad ist dokumentiert und getestet |
Wenn das Gateway eine erforderliche Zeile nicht erfüllt, halten Sie den Test aus der Produktion heraus, bis die Lücke behoben oder ausdrücklich akzeptiert wurde.
Ihre ersten 100 Gateway-Anfragen: Ein Einsteiger-Lab
Eine erfolgreiche erste Anfrage beweist die Konnektivität. Sie beweist nicht, dass das Gateway sicher für die Produktion ist. Der nächste sinnvolle Meilenstein ist ein kleiner, kontrollierter Satz von 100 repräsentativen Anfragen, der Kompatibilität, Nachverfolgbarkeit, Fehlerbehandlung und Betriebsdisziplin testet.
Dieses Labor ist absichtlich einfach gehalten. Es erfordert kein dynamisches Routing, keine komplexe Evaluierungsplattform und keine große Produktionsmigration. Es gibt einem Einsteiger genügend Hinweise, um zu entscheiden, ob er weitermachen, eine bestimmte Lücke beheben oder zum direkten Anbieterpfad zurückkehren sollte.
Beginnen Sie mit einem Request-Envelope
Bevor Sie Traffic senden, definieren Sie die Metadaten, die jede Anfrage begleiten oder im entsprechenden Gateway-Datensatz erscheinen. Ein minimaler Request-Envelope kann so aussehen:
{
  "request_id": "gw_test_0001",
  "environment": "staging",
  "workload": "support_ticket_classification",
  "requested_route": "ticket-classifier-v1",
  "customer_tier": "internal-test",
  "contains_sensitive_data": false,
  "timeout_ms": 12000,
  "max_attempts": 2,
  "evaluation_case_id": "ticket_014"
}
Ihr Gateway verwendet möglicherweise Header, Tags, Metadatenfelder oder serverseitigen Kontext anstelle genau dieses JSON. Der wichtige Punkt ist, dass Anwendung, Gateway und Evaluierungsdatensatz eine stabile Request-Identität gemeinsam verwenden.
Platzieren Sie keine Rohgeheimnisse, vollständigen Prompts, personenbezogenen Daten oder vertraulichen Kundentext in Routing-Tags. Halten Sie operative Metadaten von Inhalten getrennt. Wenn der Workload sensible Daten enthält, erfassen Sie die Klassifizierung und wenden Sie die passende Logging-Richtlinie an, anstatt den Inhalt in Observability-Felder zu kopieren.
Batch 1: 40 normale Anfragen
Verwenden Sie 40 repräsentative Eingaben, die auf dem primären Pfad erfolgreich sein sollten. Beziehen Sie einfache, typische und Grenzfälle ein, statt denselben Demo-Prompt zu wiederholen.
Für jede Anfrage erfassen Sie:
- ob die Ausgabe die aufgabenspezifische Validierung bestanden hat;
- Gateway- und Upstream-Request-IDs;
- angeforderter Alias und aufgelöster Anbieter/das aufgelöste Modell;
- Gesamtlatenz und gegebenenfalls Zeit bis zum ersten Token;
- Eingabe- und Ausgabetokens, sofern verfügbar;
- Retry- oder Fallback-Anzahl;
- geschätzte Kosten;
- die endgültige Einstufung: angenommen, abgelehnt oder manuelle Prüfung.
Das Ziel ist keine perfekte Punktzahl. Das Ziel ist herauszufinden, ob Fehler sichtbar und erklärbar sind. Eine abgelehnte Ausgabe mit vollständigem Trace ist nützlicher als eine plausible Ausgabe ohne Route- oder Nutzungsdatensatz.
Batch 2: 30 Contract-Edge-Anfragen
Verwenden Sie die nächsten 30 Anfragen, um genau die Funktionen zu testen, auf die Ihre Anwendung angewiesen ist. Wählen Sie aus:
- langen Kontext nahe Ihrem genehmigten Eingabelimit;
- strikte JSON- oder schemakonforme Ausgabe;
- Streaming-Start, Abbruch und Abschluss;
- Tool-Aufrufe mit gültigen und ungültigen Argumenten;
- Bild-, Audio- oder Dokumenteingaben, falls der Workload diese verwendet;
- mehrsprachige Prompts;
- leere, fehlerhafte oder übergroße Anfragen;
- Inhalte, die gemäß Anwendungsrichtlinie abgelehnt werden sollten.
Nehmen Sie nicht an, dass ein OpenAI-kompatibler Endpunkt jedes Edge-Verhalten identisch macht. Das Gateway besteht diesen Batch nur dann, wenn Ihre Anwendung die Antwort korrekt verarbeiten und nicht unterstütztes Verhalten klassifizieren kann, ohne den Workflow stillschweigend zu beschädigen.
Batch 3: 30 kontrollierte Fehleranfragen
Verwenden Sie eine Nicht-Produktionsumgebung, um das Verhalten bei begrenzten Fehlern zu testen. Schließen Sie sichere Fälle ein, wie zum Beispiel:
- einen ungültigen Modell- oder Routennamen;
- eine fehlende oder widerrufene Entwicklungsanmeldedaten;
- ein absichtlich kurzes Timeout;
- eine Entwicklungsquote oder eine Rate-Limit-Bedingung;
- einen simulierten, erneut versuchbaren Upstream-Fehler;
- eine Fallback-Kandidatin, die absichtlich mit dem Aufgabenvertrag inkompatibel ist.
Dieser letzte Fall ist wichtig. Ein Gateway sollte nicht allein deshalb umleiten, weil ein anderes Modell verfügbar ist. Wenn die alternative Route strukturierte Ausgabe, das Tool-Verhalten, die Datenrichtlinie oder Qualitätsanforderungen nicht einhalten kann, ist die richtige Aktion, zu stoppen und einen klassifizierten Fehler zurückzugeben.
Für eine tiefergehende Fehlerpolitik verwenden Sie das Workflow-Playbook zur Strategie für Modell-Fallbacks und den Leitfaden zu LLM-Rate-Limits.
Führen Sie ein Abnahmeprotokoll mit einer Zeile pro Anfrage
Sie können mit einer Tabelle oder einer Datenbanktabelle beginnen. Vermeiden Sie ein Dashboard, das die zugrunde liegenden Fälle verbirgt, bevor Sie sie verstanden haben.
| Feld | Was es Ihnen sagt |
|---|---|
| Anfrage-ID | Verknüpft Anwendungs-, Gateway- und Upstream-Nachweise |
| Bewertungsfall | Zeigt, welcher Input und welches erwartete Verhalten getestet wurden |
| Angeforderte Route | Erfasst, was die Anwendung angefordert hat |
| Aufgelöste Route | Zeigt den Anbieter und das Modell, das die Anfrage tatsächlich bedient hat |
| Validierungsergebnis | Unterscheidet nützliche Abschlüsse von Erfolg auf HTTP-Ebene |
| Fehlerklasse | Unterscheidet Fälle für Stopp, Wiederholung, Umleitung und Abgleich |
| Versuche | Deckt versteckte Verstärkung durch Wiederholungen auf |
| Latenz | Bestätigt, dass die Workload innerhalb ihres nutzerseitigen Budgets bleibt |
| Geschätzte Kosten | Unterstützt den Vergleich pro akzeptiertem Ergebnis |
| Rollback erforderlich | Identifiziert Fälle, die eine Erweiterung in die Produktion blockieren würden |
Berechnen Sie nach den 100 Anfragen mindestens vier Kennzahlen zusammengefasst:
Akzeptanzrate für Abschlüsse = akzeptierte Ergebnisse / Gesamtzahl der Anfragen

Trace-Abdeckung = Anfragen mit vollständiger Route und Anfrage-IDs / Gesamtzahl der Anfragen

Wiederholungsverstärkung = gesamte Upstream-Versuche / gesamte Gateway-Anfragen

Kosten pro akzeptiertem Ergebnis = gesamte geschätzte Kosten / akzeptierte Ergebnisse
Vergleichen Sie Gateways nicht allein anhand des reinen Anfragepreises. Eine günstige Anfrage, die bei der Validierung fehlschlägt, wiederholte Versuche auslöst oder eine manuelle Korrektur erfordert, kann teurer sein als eine höherpreisige Anfrage, die die Aufgabe korrekt abschließt.
Verwenden Sie explizite Produktions-Ausstiegskriterien
Markieren Sie vor Beginn des Labors jedes Kriterium als erforderlich, optional oder nicht zutreffend. Entscheiden Sie dann anhand von Belegen statt aus Begeisterung.
| Ausstiegskriterium | Beispielhafte Einsteigerregel |
|---|---|
| Vertragskompatibilität | Jedes erforderliche Antwortfeld und jede Funktion besteht den Test |
| Akzeptierte Fertigstellung | Keine wesentliche Regression gegenüber der Direktanbieter-Baseline |
| Nachvollziehbarkeit | Jede Anfrage hat eine Anwendungs- und eine Gateway-Request-ID |
| Routen-Transparenz | Der aufgelöste Anbieter/das aufgelöste Modell ist für jede abgeschlossene Anfrage verfügbar |
| Fehlerklassifizierung | Erwartete Fehler werden als Stop, Retry, Reroute oder Reconcile zugeordnet |
| Retry-Budget | Keine Anfrage überschreitet das deklarierte Versuchs- oder Latenzbudget |
| Sensibles Logging | Rohinhalte sind deaktiviert, sofern sie nicht separat genehmigt und geregelt sind |
| Kostentransparenz | Die Kosten pro akzeptiertem Ergebnis können berechnet werden |
| Rollback | Die Direktverbindung kann ohne Code-Umschreibung wiederhergestellt werden |
Verwenden Sie eines von drei Ergebnissen:
- Go: alle erforderlichen Kriterien sind erfüllt; verschieben Sie eine risikoarme Workload auf ein kleines Canary.
- Fix: das Gateway ist tragfähig, aber eine benannte Lücke bei Kompatibilität, Telemetrie, Sicherheit oder Fehlerpolitik blockiert die Produktion.
- Stop: die Schicht fügt Risiko oder Betriebsaufwand hinzu, ohne ein aktuelles, messbares Problem zu lösen.
Das Labor ist erst abgeschlossen, wenn jemand die Entscheidung verantwortet, die Nachweise gespeichert sind und der Rollback-Pfad weiterhin verfügbar bleibt. So wird aus „wir haben eine Verbindung zu einem LLM-Gateway hergestellt“ ein reproduzierbares Engineering-Ergebnis.
Die sieben Kernaufgaben eines LLM-Gateways
1. Anbieterabstraktion
Das Gateway schafft eine stabile Grenze zwischen Anwendungscode und Anbieter-APIs. Dadurch werden wiederholte Integrationen reduziert und Migrationen leichter testbar.
2. Authentifizierung und Schlüsselverwaltung
Anwendungen authentifizieren sich am Gateway, während die Anbieter-Anmeldedaten dahinter verbleiben. Dadurch kann die Anzahl der Upstream-Geheimnisse, die über Repositories und Bereitstellungsumgebungen verteilt sind, reduziert werden. Es entfällt jedoch nicht die Notwendigkeit von Rotation, Begrenzung des Geltungsbereichs, Schwärzung und Incident Response. Befolgen Sie einen speziellen Leitfaden zur sicheren API-Schlüsselverwaltung.
3. Modellrouting
Routing kann so einfach sein wie „sende diesen Alias an dieses Modell“. Fortgeschrittenere Richtlinien können Fähigkeiten, Zustand, Latenz, Region oder Kosten berücksichtigen. Halten Sie die Entscheidung nachvollziehbar: Jede Anfrage sollte festhalten, warum eine Route gewählt wurde.
4. Zuverlässigkeitssteuerung
Das Gateway kann Timeouts, Retry-Budgets, Circuit Breaker, Health Checks und sichere Fallbacks zentralisieren. Die Zentralisierung verhindert, dass jedes Anwendungsteam eine andere Fehlerpolitik erfindet.
5. Koordination von Ratenlimits
Anbieter beschränken Anfragen und Tokens häufig über die Zeit. Ein Gateway kann Parallelität, Warteschlangen, Backoff und Routenkapazität koordinieren, statt mehrere Dienste blind um dasselbe Upstream-Quota konkurrieren zu lassen.
6. Beobachtbarkeit und Kostenallokation
Das Gateway sieht jede Anfrage, daher ist es ein natürlicher Ort, um konsistente Telemetrie anzubinden. Messen Sie mehr als nur die reinen Tokenkosten. Verfolgen Sie die Akzeptanzrate von Aufgaben, Latenz, Wiederholungsversuche und die Kosten pro akzeptierter Aufgabe, damit ein billiger, aber unzuverlässiger Pfad nicht effizient erscheint.
Der Leitfaden zur Kostenoptimierung von KI-APIs erklärt, wie man Pfade anhand von Workload-Ergebnissen statt allein anhand des Listenpreises vergleicht.
7. Richtlinien und Governance
Teams können ein Gateway nutzen, um Modelle einzuschränken, Budgets festzulegen, die Token-Nutzung zu begrenzen, Entwicklungs- und Produktionsschlüssel zu trennen und prüfbare Nutzungsprotokolle zu erstellen. Diese Kontrollen werden immer nützlicher, je mehr Anwendungen und Agenten dieselbe Model-Access-Schicht gemeinsam nutzen.
LLM-Gateway vs. ähnliche Tools
Einsteiger verwenden „Gateway“, „Router“, „Orchestrierungs-Framework“ und „Reverse Proxy“ oft synonym. Sie überschneiden sich, sind aber nicht dasselbe.
| Tool | Primäre Aufgabe | Was es normalerweise nicht abdeckt |
|---|---|---|
| LLM-Gateway | Zugriff, Richtlinien, Routing, Zuverlässigkeit und Telemetrie über Modellaufrufe hinweg | Den gesamten Anwendungs-Workflow |
| Model-Router | Ein Modell oder einen Upstream-Pfad auswählen | Authentifizierung, Abrechnung, Governance oder vollständige Observability, sofern nicht gebündelt |
| Orchestrierungs-Framework | Prompts, Tools, Speicher, Agenten und mehrstufige Workflows koordinieren | Standardmäßig ein zentrales Provider-Konto und die Kontrolle über die Abrechnung |
| Reverse Proxy | Netzwerkverkehr weiterleiten, TLS beenden und generische HTTP-Kontrollen anwenden | Modellbewusste Token-Grenzen, Fallback-Verträge oder standardmäßige KI-Nutzungsabrechnung |
| Provider-SDK | Die API eines Anbieters mit anbieternativen Funktionen aufrufen | Cross-Provider-Routing und einheitliche Kontrollen |
Sie können diese Ebenen kombinieren. Ein Agent-Framework kann ein LLM-Gateway aufrufen. Das Gateway kann intern einen Router verwenden. Ein Reverse Proxy kann für Netzwerk-Kontrollen vor dem Gateway sitzen.
Wann benötigen Sie ein LLM-Gateway?
Nutzen Sie diesen Einsteigerleitfaden zum LLM-Gateway als Entscheidungstest. Ein Gateway lohnt sich zu evaluieren, wenn zwei oder mehr dieser Aussagen zutreffen:
- Sie unterstützen mehr als einen Modellanbieter.
- Mehrere Dienste oder Agenten benötigen Modellzugriff.
- Provider-Schlüssel werden über Umgebungen hinweg dupliziert.
- Teams können nicht beantworten, welche Anwendung eine Gebühr verursacht hat.
- Der Umgang mit Rate Limits unterscheidet sich zwischen Codebasen.
- Ein Provider-Ausfall oder ein degradierter Pfad unterbricht einen kritischen Workflow.
- Sie benötigen Modell-Allowlists, Kontingente oder Budgets auf Umgebungsebene.
- Das Wechseln von Modellen erfordert wiederholte SDK- oder Deployment-Änderungen.
- Der Betrieb benötigt eine gemeinsame Request-ID über Anwendungs- und Provider-Ebenen hinweg.
Sie benötigen möglicherweise noch kein Gateway, wenn Sie einen risikoarmen Prototypen, einen Anbieter, einen Verantwortlichen und keine Anforderung an Produktionszuverlässigkeit oder Governance haben. Beginnen Sie mit direktem Zugriff, aber halten Sie Provider-Aufrufe hinter einem kleinen Anwendungs-Adapter, damit eine zukünftige Migration kontrolliert erfolgt.
LLM-Gateway selbst bauen vs. kaufen: Eine praktische Bewertungsmatrix
Die wichtigste Frage für die Geschäftsbewertung ist nicht, ob ein Gateway nützlich ist. Es geht darum, welche Teile Ihr Team selbst verantworten sollte. Sie können ein Gateway entwickeln, einen gehosteten Dienst einsetzen, einen Open-Source-Proxy betreiben oder diese Ansätze kombinieren.
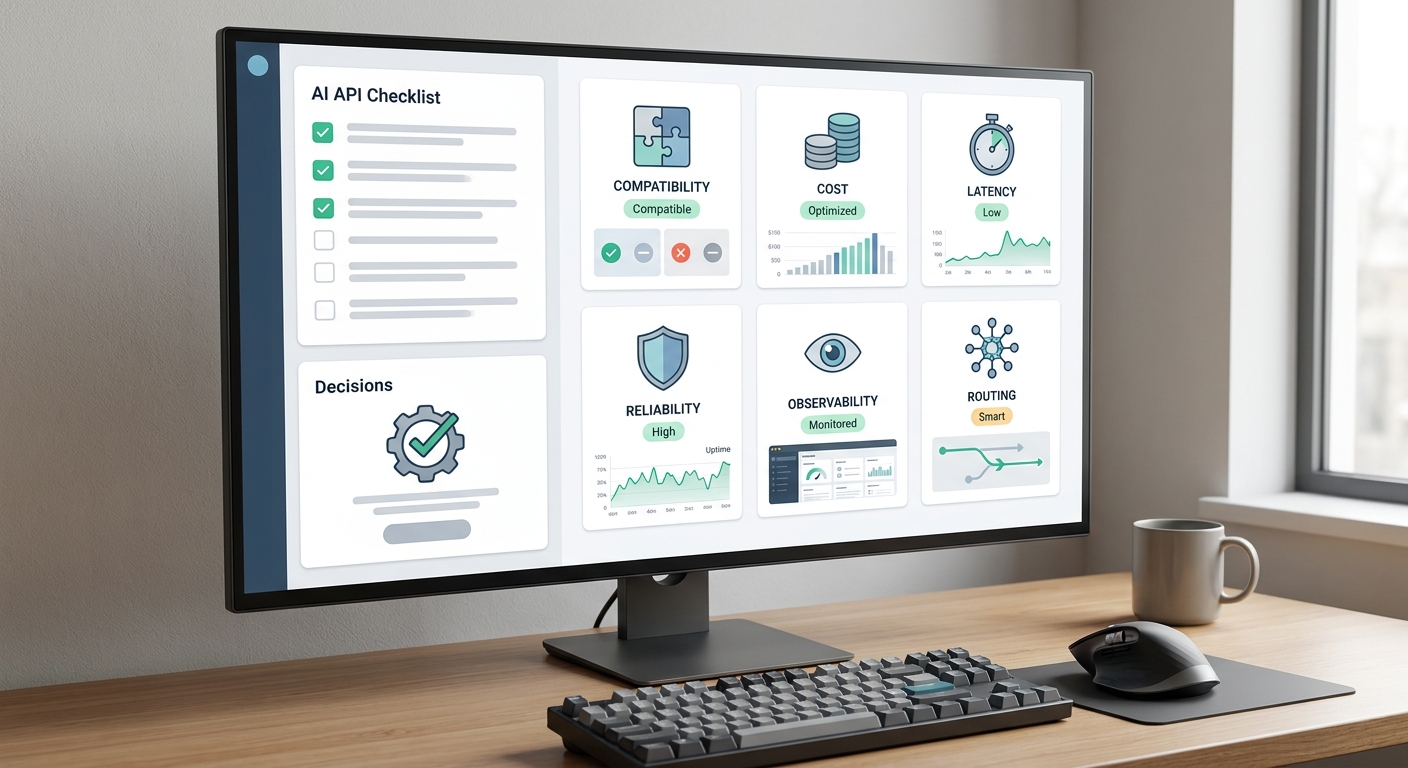
Verwenden Sie eine gewichtete Bewertungsmatrix statt einer Entscheidung anhand einer Feature-Checkliste. Bewerten Sie jede Option von 1 bis 5, multiplizieren Sie den Wert mit der Gewichtung und vergleichen Sie die Gesamtsummen. Die folgenden Gewichtungen sind Ausgangspunkte, keine universellen Regeln.
| Kriterium | Empfohlene Gewichtung | Zu stellende Fragen |
|---|---|---|
| Kompatibilität mit Workloads | 25% | Bleiben Streaming, strukturierte Ausgabe, Tools, Bilder, Fehlerdetails und Token-Abrechnung erhalten? |
| Zuverlässigkeit | 20% | Sind Timeouts, Wiederholungen, Health Checks, Fallback-Regeln und Sichtbarkeit bei Vorfällen klar definiert? |
| Sicherheit und Governance | 15% | Können Sie Mandanten isolieren, Modelle einschränken, Zugangsdaten rotieren, Inhalte redigieren und Zugriffe auditieren? |
| Beobachtbarkeit | 15% | Können Sie die angeforderte Route, die aufgelöste Route, Versuche, Latenz, Nutzung, Validierung und Kosten nachverfolgen? |
| Betrieblicher Aufwand | 10% | Wer übernimmt Upgrades, Provider-Wechsel, Skalierung, On-Call-Reaktion und Aufbewahrung von Daten? |
| Kommerzieller Fit | 10% | Ist die Abrechnung verständlich, exportierbar, zurechenbar und mit Ihrem erwarteten Nutzungsmuster kompatibel? |
| Ausstiegspfad | 5% | Können Sie Konfiguration und Telemetrie exportieren, Anwendungskontrakte beibehalten und ohne Neuentwicklung wechseln? |
Entwickeln, wenn Kontrolle das Produkt ist
Entwickeln kann sinnvoll sein, wenn das Routing-Verhalten ein zentraler Wettbewerbsvorteil ist, Vorschriften ein Bereitstellungsmodell verlangen, das verfügbare Dienste nicht erfüllen können, oder Ihr Traffic-Volumen ein dediziertes Plattformteam rechtfertigt. „Entwickeln“ bedeutet jedoch mehr als das Weiterleiten von HTTP-Anfragen. Es bedeutet, Authentifizierung, Provider-Adapter, Schema-Unterschiede, Streaming, Fehlernormalisierung, Kontingente, Beobachtbarkeit, Release-Management, Sicherheitsprüfungen und Incident Response selbst zu verantworten.
Kaufen, wenn Zugriff und Betrieb undifferenziert sind
Ein gehostetes Gateway ist in der Regel die bessere Wahl, wenn das Ziel ist, schneller mehrere Provider zu erreichen, Abrechnung und Zugangsdaten zu zentralisieren oder mehreren Anwendungen eine gemeinsame Steuerungsebene bereitzustellen. Die Bewertung sollte dennoch einen Ausstiegspfad umfassen. Platzieren Sie das Gateway hinter einem Anwendungsadapter, bewahren Sie Modellfähigkeits-Tests auf und vermeiden Sie es, provider-spezifische Annahmen durch den gesamten Produktcode zu verankern.
Open Source verwenden, wenn Sie es betreiben können
Ein Open-Source-Gateway oder -Proxy kann Flexibilität und Transparenz im Code bieten, aber Self-Hosting verlagert Verfügbarkeit, Skalierung, Upgrades, Telemetriespeicherung und Sicherheits-Patches auf Ihr Team. Vergleichen Sie den gesamten Betriebsaufwand, nicht nur die Softwarelizenz.
Der vierstufige Rollout des LLM-Gateways
Ein sicherer Rollout beweist eine Ebene nach der anderen. Beginnen Sie nicht mit dynamischem Cost Routing über alle Workloads hinweg.
Phase 1: Kompatibilitäts-Shadow-Test
Senden Sie einen repräsentativen Evaluierungsdatensatz über das Kandidaten-Gateway, ohne das Produktionsverhalten zu ändern. Prüfen Sie Anfragefelder, Antworten, Streaming, Tool-Aufrufe, strukturierte Ausgaben, Nutzungsfelder und Fehler. Erfassen Sie jede Abweichung. Eine erfolgreiche HTTP-Antwort reicht nicht aus, wenn sich der Anwendungskontrakt ändert.
Ausstiegsbedingung: Das Gateway erfüllt die erforderlichen Funktionen und Qualitätsprüfungen der Arbeitslast ohne unerklärlichen Verlust des Kontrakts.
Phase 2: Eine risikoarme Arbeitslast
Verlagern Sie eine reversible, nicht kritische Arbeitslast auf eine explizite Modellroute. Halten Sie den bisherigen direkten Provider-Pfad als Rollback-Option verfügbar. Fügen Sie Anforderungs-IDs und Telemetrie zur aufgelösten Route hinzu, bevor Sie Retries oder Fallback ergänzen.
Ausstiegsbedingung: Das Team kann jede fehlgeschlagene Anfrage erklären, die Nutzung abgleichen und ohne Code-Release zurückrollen.
Phase 3: Zuverlässigkeitsrichtlinie
Fügen Sie ein begrenztes Timeout, eine Retry-Klassifizierung und einen getesteten Fallback für einen Fehlermodus hinzu, den Sie tatsächlich beobachtet haben. Führen Sie keinen Fallback zwischen Modellen allein deshalb durch, weil beide ähnliches JSON akzeptieren. Die alternative Route muss denselben Arbeitslastkontrakt erfüllen.
Für ein tieferes Recovery-Design verwenden Sie das Model-Fallback-Strategie-Playbook und den LLM-Ratenlimit-Leitfaden.
Ausstiegsbedingung: Fehler-Drills zeigen, dass Retries und Fallback die akzeptierte Fertigstellung verbessern, ohne doppelte Seiteneffekte, außer Kontrolle geratene Latenz oder unkontrollierte Kosten zu verursachen.
Phase 4: Gemeinsame Produktions-Control-Plane
Erweitern Sie erst, wenn die erste Arbeitslast stabile Messwerte hat. Fügen Sie Mandantenkontingente, Modell-Allowlists, Trennung von Umgebungen, Budgetwarnungen und einen dokumentierten Prozess zum Ändern von Routen hinzu. Prüfen Sie, wer Richtlinien ändern kann und wie Änderungen geprüft werden.
Ausstiegsbedingung: Mehrere Anwendungen können das Gateway nutzen, ohne Kostenzuordnung, Incident-Nachvollziehbarkeit, Sicherheitsgrenzen oder Rollback-Kontrolle zu verlieren.
Fehlerkarte für Einsteiger: Wiederholen, umleiten oder stoppen?
Die Zuverlässigkeit des Gateways hängt weniger von der Anzahl der Fallback-Modelle ab als davon, für jeden Fehler die richtige Entscheidung zu treffen. Verwenden Sie diese vereinfachte Karte als Ausgangspunkt.
| Fehler | Typische Bedeutung | Aktion für Einsteiger |
|---|---|---|
| 400 oder Validierungsfehler | Der Request-Vertrag ist ungültig oder wird nicht unterstützt | Stopp, den Request korrigieren und nicht unverändert erneut versuchen |
| 401 oder 403 | Problem mit Anmeldedaten, Berechtigung, Model-Allowlist oder Konto | Stopp und alarmieren; niemals blind zwischen zufälligen Schlüsseln wechseln |
| 404 Modell oder Route | Die konfigurierte Kennung ist nicht verfügbar oder falsch | Stopp oder eine explizit genehmigte gleichwertige Route verwenden |
| 408 oder Client-Timeout | Das Latenzbudget des Aufrufers ist abgelaufen | Wenn möglich abbrechen; nur erneut versuchen, wenn die Aufgabe idempotent ist |
| 429 Rate Limit | Kapazität oder Kontingent wurde überschritten | Retry-Hinweise beachten, in die Warteschlange stellen oder eine getestete gleichwertige Route verwenden |
| 5xx vor der Ausgabe | Gateway oder Upstream ist fehlgeschlagen, bevor eine nutzbare Antwort vorlag | Begrenzten Retry oder getestetes Failover verwenden |
| Stream bricht mitten in der Ausgabe ab | Teilinhalt kann bereits vorhanden sein | Stopp und abgleichen; Side Effects nicht blind erneut ausführen |
| Tool-Aufruf könnte ausgeführt worden sein | Externer Zustand könnte sich geändert haben | Vor dem erneuten Versuch Idempotency-Key oder Tool-Status prüfen |
Das Wort begrenzt ist wichtig. Jeder Workflow braucht eine maximale Retry-Anzahl, ein gesamtes Zeitbudget und einen Endzustand. Andernfalls kann ein Gateway einen einzelnen Provider-Vorfall in doppelte Tool-Aktionen, ausufernde Kosten und einen größeren Ausfall verwandeln.
Für eine tiefergehende Implementierung verwenden Sie das Playbook zur Modell-Fallback-Strategie.
Wie man misst, ob das Gateway funktioniert
Der Erfolg des Gateways ist nicht die Anzahl der verbundenen Provider. Entscheidend ist die Verbesserung der akzeptierten Ergebnisse und der betrieblichen Kontrolle.
| Metrik | Was sie offenbart | Einsteigerfreundliche Berechnung |
|---|---|---|
| Akzeptierte Abschlussrate | Ob Nutzer nutzbare Ergebnisse erhalten | akzeptierte Ergebnisse ÷ Workflow-Starts |
| Dem Gateway zurechenbare Fehlerrate | Ob die neue Schicht Fehler verursacht | Gateway-Fehler ÷ Gateway-Requests |
| p95 End-to-End-Latenz | Ob Richtlinien und Failover die Nutzererfahrung beeinträchtigen | 95. Perzentil vom Anwendungsstart bis zum akzeptierten Ergebnis |
| Fallback-Wiederherstellungsrate | Ob Fallback reale Fehler behebt | akzeptierte Fallback-Ergebnisse ÷ Fallback-Versuche |
| Kosten pro akzeptiertem Ergebnis | Ob günstigere Aufrufe günstigere Ergebnisse liefern | gesamte Modell- und Retry-Kosten ÷ akzeptierte Ergebnisse |
| Routen-Erklärbarkeit | Ob Vorfälle und Rechnungen nachverfolgt werden können | Requests mit angeforderten und aufgelösten Routenfeldern ÷ Gesamtzahl der Requests |
| Genauigkeit von Policy-Ablehnungen | Ob Governance den vorgesehenen Traffic blockiert | korrekt abgelehnte Requests ÷ geprüfte Ablehnungen |
Legen Sie vor der Migration eine Baseline fest. Vergleichen Sie dann dieselbe Arbeitslast, denselben Evaluierungsdatensatz, dasselbe Traffic-Segment und dasselbe Zeitfenster. Wenn die Qualität sinkt, die Latenz steigt oder Kosten schwerer abzugleichen sind, ist ein niedrigerer beworbener Token-Preis kein erfolgreicher Gateway-Erfolg.
Für die Kostenanalyse fahren Sie mit dem Leitfaden zur Kostenoptimierung von AI-APIs fort. Für einen umfassenderen Telemetrieplan verwenden Sie die Implementierungs-Checkliste für AI-Observability.
Eine Einsteigerimplementierung: Fünf praktische Schritte
Schritt 1: Schreiben Sie den Task-Vertrag
Wählen Sie eine echte Arbeitslast, z. B. das Zusammenfassen von Support-Tickets oder das Extrahieren von Feldern aus Rechnungen. Definieren Sie:
- erforderliche Eingaben und Ausgaben;
- akzeptable Latenz;
- Validierungsregeln;
- ob Streaming erforderlich ist;
- ob Tools Nebenwirkungen erzeugen können;
- was als akzeptiertes Ergebnis gilt.
Dieser Vertrag bestimmt, ob ein Fallback sicher ist und ob ein anderes Modell tatsächlich gleichwertig ist.
Schritt 2: Wählen Sie eine stabile Client-Schnittstelle
Wenn Ihre Anwendung bereits ein OpenAI-kompatibles SDK verwendet, kann ein kompatibles Gateway den Migrationsaufwand reduzieren. Flatkey dokumentiert beispielsweise eine OpenAI-kompatible Basis-URL unter https://router.flatkey.ai/v1.
curl -X POST "https://router.flatkey.ai/v1/chat/completions" \
  -H "Authorization: Bearer $FLATKEY_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "your-model",
    "messages": [
      {"role": "user", "content": "Explain this error in plain English."}
    ]
  }'
Verwenden Sie für den Schlüssel einen Secret Manager oder eine serverseitige Umgebungsvariable. Liefern Sie ihn niemals im Browser- oder Mobile-Client-Code aus.
Schritt 3: Beginnen Sie mit explizitem Routing
Leiten Sie die Arbeitslast an ein getestetes Modell weiter. Wenn Sie Anwendungsunabhängigkeit wünschen, ordnen Sie diesem Modell in der Konfiguration einen internen Alias zu. Vermeiden Sie einen undurchsichtigen Router für das „günstigste Modell“ oder das „beste Modell“, bis Sie einen wiederholbaren Evaluationssatz haben.
Schritt 4: Fügen Sie eine minimal praktikable Telemetrie hinzu
Protokollieren Sie:
- Gateway-Request-ID;
- Arbeitslast und Umgebung;
- angeforderter Alias;
- aufgelöster Anbieter und aufgelöstes Modell;
- Status und Latenz;
- Anzahl der Wiederholungen und Fallbacks;
- Eingabe- und Ausgabetokens;
- geschätzte Kosten;
- Validierungsergebnis.
Das reicht aus, um die ersten Produktionsprobleme zu debuggen und später Alternativen zu vergleichen.
Schritt 5: Fügen Sie eine begrenzte Fehlerstrategie hinzu
Beginnen Sie mit einem Timeout und einem kleinen Retry-Budget für vorübergehende Fehler. Fügen Sie Fallbacks erst hinzu, nachdem Sie überprüft haben, dass der alternative Pfad denselben Task-Vertrag erfüllt. Definieren Sie bei Streaming- oder side-effecting Tool-Aufrufen, wie die Anwendung eine teilweise Fertigstellung erkennt und den Zustand abgleicht.
Ihre erste Woche mit einem LLM-Gateway
Verwenden Sie einen Sieben-Tage-Einführungsplan, anstatt alle Anwendungen auf einmal umzustellen.
Tag 1: Erfassen Sie eine Arbeitslast
Notieren Sie den aktuellen Anbieter, das Modell, das SDK, die Anmeldedaten, die erforderlichen Funktionen, den Traffic, das Latenzbudget, die Datensensibilität und den Verantwortlichen für den Rollback.
Tag 2: Führen Sie den Kompatibilitätstest aus
Senden Sie repräsentative Prompts über den Direktpfad und den Gateway-Pfad. Schließen Sie lange Eingaben, strukturierte Ausgaben, Streaming, Tools und erwartete Fehlerfälle ein, wenn der Workload diese verwendet.
Tag 3: Anforderungsidentität und Nutzungsdatensätze hinzufügen
Bestätigen Sie, dass die Anwendung eine Gateway-Request-ID speichert und sie mit Modell, Provider-Route, Latenz, Token, Wiederholungsanzahl und Validierungsergebnis verknüpfen kann, ohne standardmäßig sensible Inhalte zu protokollieren.
Tag 4: Fehlerstrategie definieren
Klassifizieren Sie Fehler in Stopp, Wiederholung, äquivalentes Failover, Cross-Model-Fallback und manuelle Abgleichung. Legen Sie ein Gesamtbudget für Wiederholungen und Latenz fest.
Tag 5: Einen kleinen Produktions-Canary senden
Verwenden Sie einen risikoarmen Workload und einen absichtlich kleinen Traffic-Anteil. Lassen Sie den Direktpfad verfügbar. Vergleichen Sie die akzeptierte Abschlussrate, die p95-Latenz und die Kosten pro akzeptiertem Ergebnis.
Tag 6: Sicherheits- und Ausgabenkontrollen überprüfen
Trennen Sie Entwicklungs- und Produktionsanmeldedaten, schränken Sie erlaubte Modelle ein, setzen Sie Quoten und prüfen Sie, wer die Routing-Richtlinie ansehen oder ändern kann. Nutzen Sie den Leitfaden zur sicheren API-Schlüsselverwaltung für eine umfassendere Kontroll-Checkliste.
Tag 7: Eine Go-, Fix- oder Stop-Entscheidung treffen
- Go: die erforderlichen Vertragsprüfungen bestehen, und der Canary erfüllt seine Akzeptanzschwellen.
- Fix: die Architektur ist solide, aber eine messbare Lücke blockiert die Ausweitung.
- Stop: das Gateway bringt ohne aktuellen Kontrollvorteil operatives Risiko oder Kosten mit sich.
Dokumentieren Sie die Entscheidung und das nächste Prüfdatum. Ein kontrollierter Stopp ist besser als eine ungemessene Migration.
Häufige Anfängerfehler
Jedes Modell als austauschbar behandeln
Selbst wenn die Anfragesyntax standardisiert ist, unterscheiden sich Fähigkeiten und Ausgabeverhalten. Testen Sie die genauen Funktionen, die Ihr Workload verwendet.
Vor dem Messen routen
Dynamisches Routing ohne Evaluierungsdaten verlagert die Entscheidungslogik in eine Blackbox. Legen Sie zuerst eine Baseline fest und führen Sie dann eine messbare Richtlinie ein.
Jeden Fehler erneut versuchen
Authentifizierungsfehler, ungültige Anfragen, aufgebrauchte Budgets und nicht unterstützte Funktionen sind nicht vorübergehend. Wiederholen Sie nur Fehler, die später erfolgreich sein können, und verwenden Sie bei Bedarf exponentielles Backoff mit Jitter.
Sensible Inhalte standardmäßig protokollieren
Prompts können Kunden-, Quellcode- oder Geschäftsdaten enthalten. Halten Sie Metadaten-Observability getrennt von der Aufbewahrung von Inhalten.
Die aufgelöste Route verbergen
Wenn die Anwendung ein Alias anfordert, zeichnen Sie den tatsächlich verwendeten Provider und das Modell auf. Andernfalls werden Vorfälle, Qualitätsverschlechterungen und Kostenänderungen schwer zu erklären.
Preis statt Ergebnisse messen
Niedrigere Token-Preise garantieren keine niedrigeren Workload-Kosten. Beziehen Sie Validierungsfehler und Wiederholungen in Ihre Kostenberechnung ein.
Wie Flatkey zum Gateway-Muster passt
Flatkey bietet eine einheitliche Ebene für Modell- und Tool-Zugriff mit einem Schlüssel, gemeinsamen Nutzungsaufzeichnungen und einem OpenAI-kompatiblen Modell-Endpunkt. Für einen bestehenden kompatiblen Client besteht der Migrationspfad darin, die Base URL zu ändern, einen Flatkey-Schlüssel zu verwenden, ein unterstütztes Modell auszuwählen und den Workload-Vertrag zu testen.
Damit ist Flatkey relevant, wenn Sie die Ausbreitung von Anbieter-Accounts reduzieren möchten, ohne die Aggregationsschicht selbst zu bauen und zu betreiben. Wenn Sie das Design evaluieren und nicht nach einem Einsteigerüberblick suchen, lesen Sie den detaillierten Leitfaden zur AI-API-Gateway-Architektur. Wenn Sie bereit sind, einen Client zu migrieren, verwenden Sie die Checkliste für ein OpenAI-kompatibles API-Gateway.
Flatkey-Modelle entdecken, die Dokumentation ansehen oder einen API-Schlüssel erstellen, wenn Sie bereit sind, einen realen Workload zu testen.
LLM-Gateway-Einsteigerleitfaden-Checkliste
Bevor Sie Produktivtraffic durch ein LLM-Gateway senden, bestätigen Sie:
- [ ] Ein Workload-Vertrag hat definierte Erfolgskriterien.
- [ ] Die Anwendung verwendet eine serverseitige Gateway-Anmeldeinformation.
- [ ] Das ausgewählte Modell hat repräsentative Tests bestanden.
- [ ] Strukturierte Ausgabe, Tools und Streaming wurden getestet, falls sie verwendet werden.
- [ ] Timeouts und wiederholbare Fehler sind explizit definiert.
- [ ] Fallback bewahrt den Workload-Vertrag.
- [ ] Jede Anfrage erhält eine nachverfolgbare Request-ID.
- [ ] Aufgelöster Provider und aufgelöstes Modell werden aufgezeichnet.
- [ ] Tokens, Latenz, Wiederholungen, Validierung und Kosten werden gemessen.
- [ ] Entwicklungs- und Produktionskontingente sind getrennt.
- [ ] Rohinhaltsprotokollierung ist deaktiviert oder bewusst gesteuert.
- [ ] Ein direkter Rollback-Pfad ist dokumentiert.
- [ ] Es gibt eine Baseline für akzeptierte Completion, Latenz und Kosten pro akzeptiertem Ergebnis.
- [ ] Build-, gehostete und selbst gehostete Optionen wurden hinsichtlich Betriebsaufwand und Ausstiegspfad verglichen.
- [ ] Die erste Rollout-Phase verwendet eine explizite Route, bevor dynamisches Routing eingeführt wird.
Häufig gestellte Fragen
Ist ein LLM-Gateway dasselbe wie ein API-Gateway?
Es ist ein spezialisiertes API-Gateway für KI-Modellverkehr. Es kann Standardfunktionen eines API-Gateways wie Authentifizierung und Ratenbegrenzung sowie modellbewusstes Routing, Token-Nutzung, KI-spezifische Fehlernormalisierung und vertragssensibles Fallback bereitstellen.
Hostet ein LLM-Gateway die Modelle?
Nicht unbedingt. Einige Gateways routen zu externen Anbietern, einige sind in Inferenz-Infrastrukturen integriert, und einige unterstützen beides. Fragen Sie nach, wo die Inferenz stattfindet, welcher Anbieter tatsächlich jedes Modell bereitstellt und wie dieser Pfad in den Nutzungsaufzeichnungen erscheint.
Senkt ein LLM-Gateway die Kosten?
Es kann helfen, indem es Nutzungsdaten zentralisiert, Kontingente anwendet, doppelte Integrationen reduziert und gemessene Routenänderungen ermöglicht. Einsparungen sind nicht automatisch. Vergleichen Sie die Kosten pro akzeptierter Aufgabe, einschließlich Wiederholungen und Qualitätsfehlern.
Kann ich ein LLM-Gateway mit dem OpenAI SDK verwenden?
Ja, wenn das Gateway einen OpenAI-kompatiblen Endpunkt bereitstellt und die von Ihrer Anwendung genutzten Funktionen unterstützt. Ändern Sie die Basis-URL und die Anmeldedaten und testen Sie dann den gesamten Workload-Vertrag, anstatt von perfekter Kompatibilität auszugehen.
Ist ein Gateway ein Single Point of Failure?
Das kann es sein. Bewerten Sie seine Bereitstellungsarchitektur, Health Checks, Failover der Upstream-Services, Timeout-Verhalten, Observability, Servicezusagen und den Rollback-Pfad. Die Zentralisierung der Steuerung erhöht den operativen Hebel, daher muss das Gateway selbst als Produktionsinfrastruktur behandelt werden.
Sollte ein Startup ein LLM-Gateway selbst bauen oder kaufen?
Selbst bauen, wenn das Gateway-Verhalten ein zentraler Differenzierungsfaktor ist, Sie ungewöhnliche Bereitstellungsanforderungen haben oder das Team es betreiben kann. Kaufen, wenn das Hauptziel schnellerer Zugang, weniger Provider-Integrationen, einheitliche Nutzung und gemeinsame Kontrollen sind. Ein kleines Team kann auch zunächst direkt starten und später migrieren, wenn Provider-Aufrufe bereits hinter einem Adapter isoliert sind.
Was sollte ich testen, bevor ich Produktionsverkehr umschalte?
Testen Sie den exakten Workload-Vertrag: Streaming, strukturierte Ausgabe, Tools, Medien-Inputs, Kontextgrenzen, Fehlerverhalten, Timeout-Behandlung, Usage-Felder und die Ausgabegüte. Führen Sie dann einen risikofreien Canary mit einem direkten Rollback-Pfad aus und vergleichen Sie akzeptierte Abschlüsse, p95-Latenz und Kosten pro akzeptiertem Ergebnis mit der Baseline vor dem Gateway.
Das einfache mentale Modell
Die kürzeste Version dieses LLM-Gateway-Einsteigerleitfadens lautet:
Ihre Anwendung fragt KI-Arbeit an. Das Gateway entscheidet, ob die Anfrage erlaubt ist, wohin sie gehen soll, wie mit Fehlern umgegangen werden soll und was aufgezeichnet werden sollte.
Beginnen Sie mit einem Workload, einer stabilen Schnittstelle, explizitem Routing, minimal tragfähiger Telemetrie und einer klar begrenzten Fehlerpolitik. Fügen Sie anspruchsvolles Routing erst hinzu, nachdem Sie Qualität, Latenz, Zuverlässigkeit und Kosten messen können.