
flatkey.ai Blog
Einblicke, Produktnotizen und Implementierungsleitfäden für Teams, die mit KI-APIs entwickeln.
Architektur von KI-Gateways
Neueste Artikel in Architektur von KI-Gateways.
WeiterlesenMigration von Basis-URL und SDK
Neueste Artikel in Migration von Basis-URL und SDK.
WeiterlesenKosten, Abrechnung und Betrieb
Neueste Artikel in Kosten, Abrechnung und Betrieb.
WeiterlesenUnternehmenskontrollen und Vertrauen
Neueste Artikel in Unternehmenskontrollen und Vertrauen.
WeiterlesenGateway-Vergleiche
Neueste Artikel in Gateway-Vergleiche.
WeiterlesenLeitfäden für Modelle und Modalitäten
Neueste Artikel in Leitfäden für Modelle und Modalitäten.
WeiterlesenZuverlässigkeit und Routing
Neueste Artikel in Zuverlässigkeit und Routing.
WeiterlesenWerkzeugintegrationen
Neueste Artikel in Werkzeugintegrationen.
Weiterlesen
Notes md-attr
Produktnotizen js-Link
Produktnotizen img onerror
Produktnotizen-iframe
Produktnotizen Daten HTML
Interne Konsolennotizen
Interne Notizen
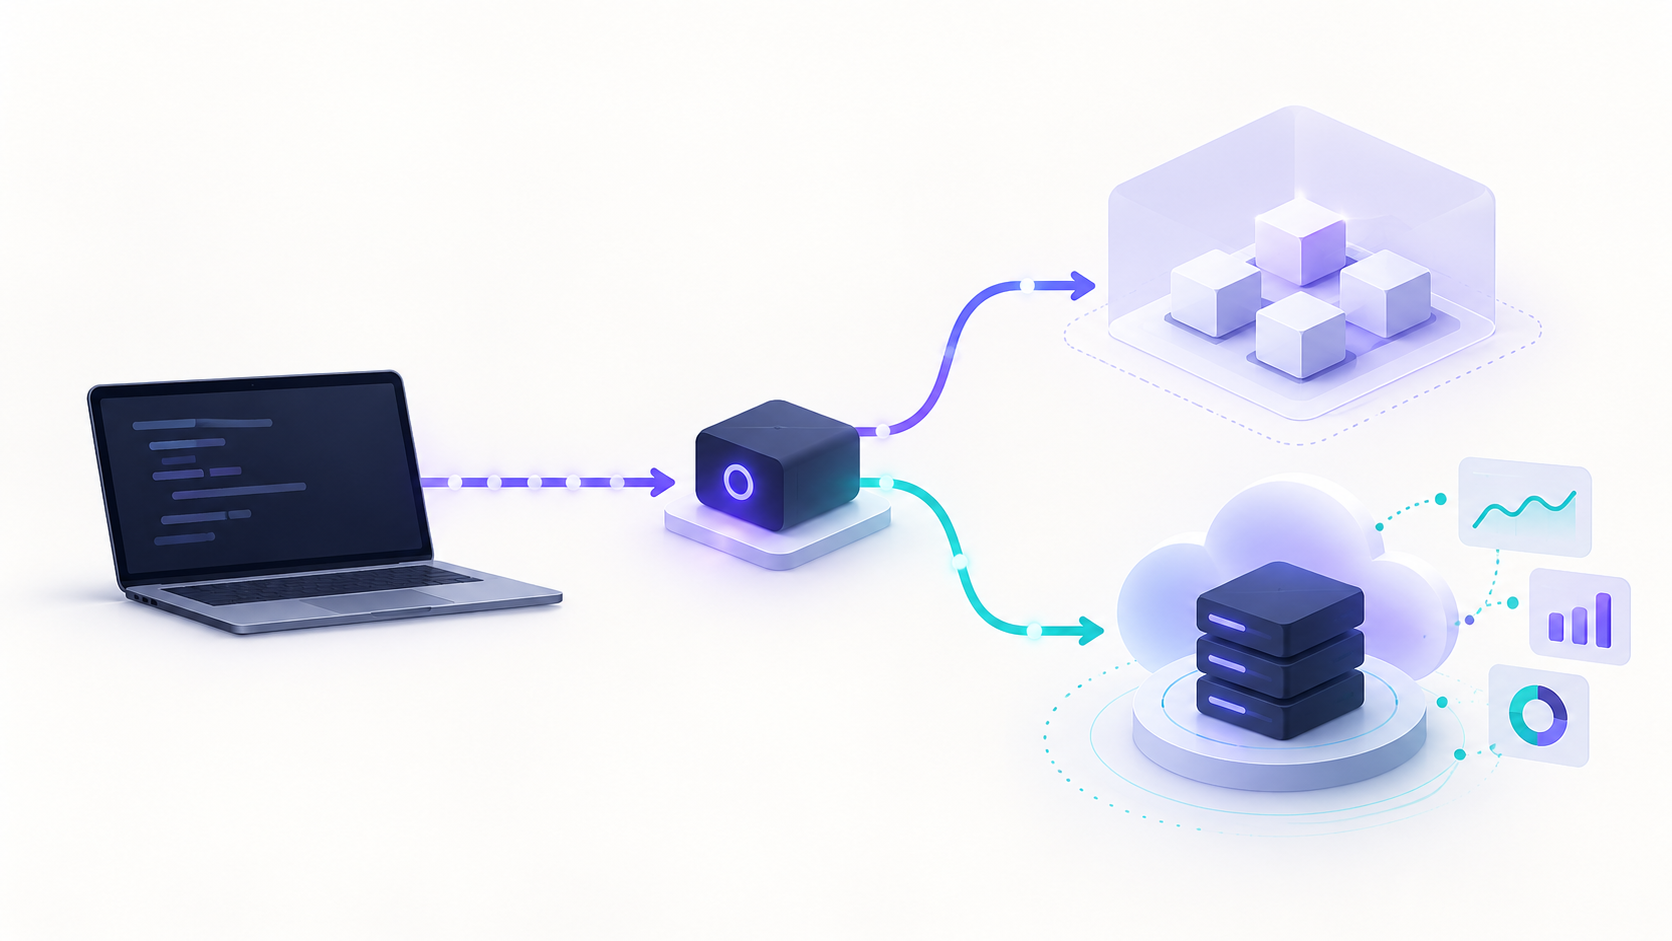
CLI-Proxy-API: Zugriff, Preise, Integration und Produktionsleitfaden
Erfahren Sie, was eine CLI-Proxy-API leistet, wie Zugriff und Kosten von CLIProxyAPI funktionieren, wie Sie sie sicher testen und wann ein verwaltetes Gateway für die Produktion geeignet ist.
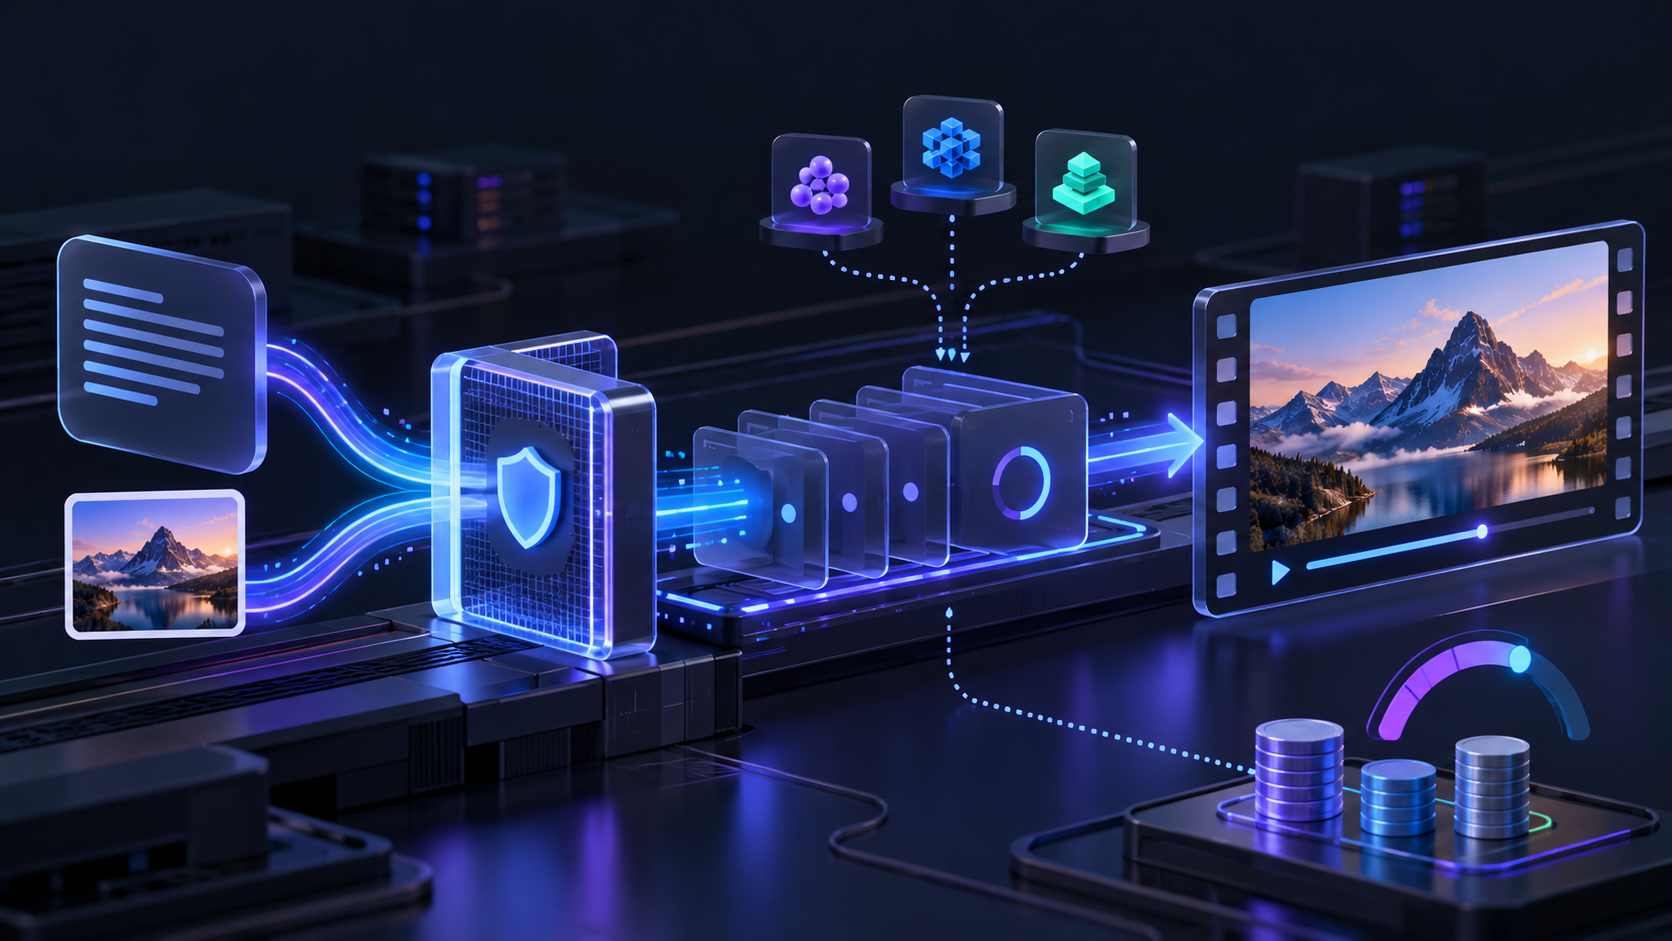
API für KI-Videogeneratoren: Zugang, Preise, Integration und Produktionsleitfaden
Ein praxisnaher Leitfaden zur Auswahl, Preisgestaltung, Integration und Nutzung einer API zur KI-Videogenerierung mit asynchronen Jobs und messbarer Kostenkontrolle.
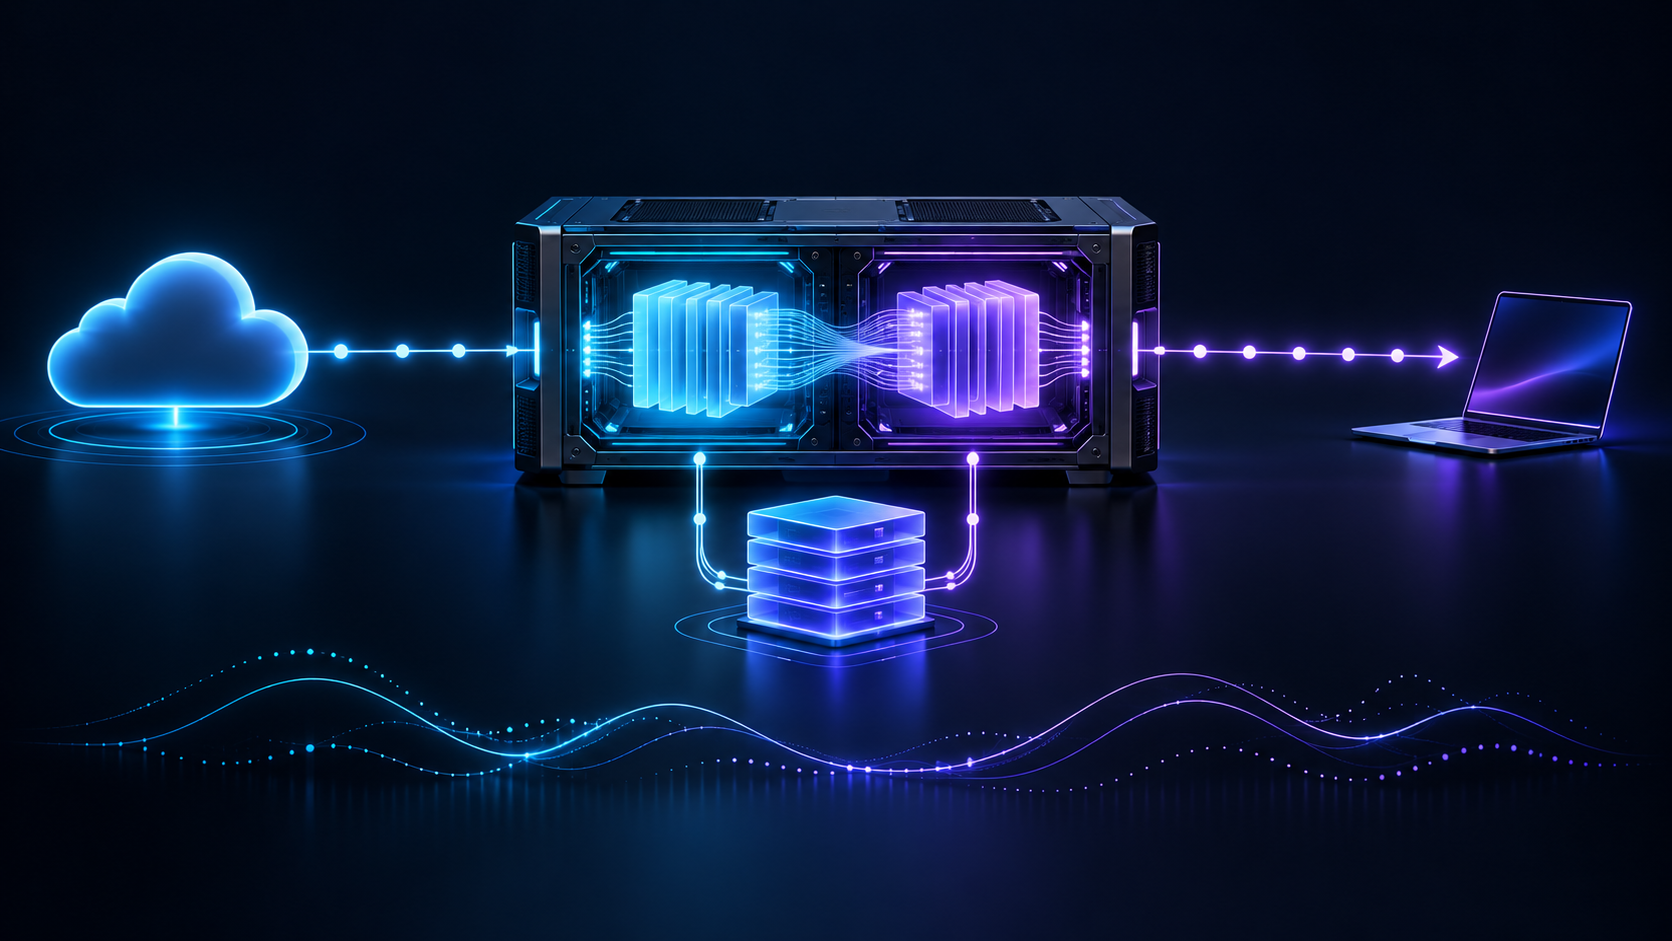
Bedeutung von KI-Inferenz: Architektur, Performance und Leitfaden für Cloud-Bereitstellung
Bedeutung von KI-Inferenz: Wie ein trainiertes Modell neue Eingaben in produktionsreife Antworten umwandelt – einschließlich wichtiger Metriken und Schritte zur Cloud-GPU-Bereitstellung.
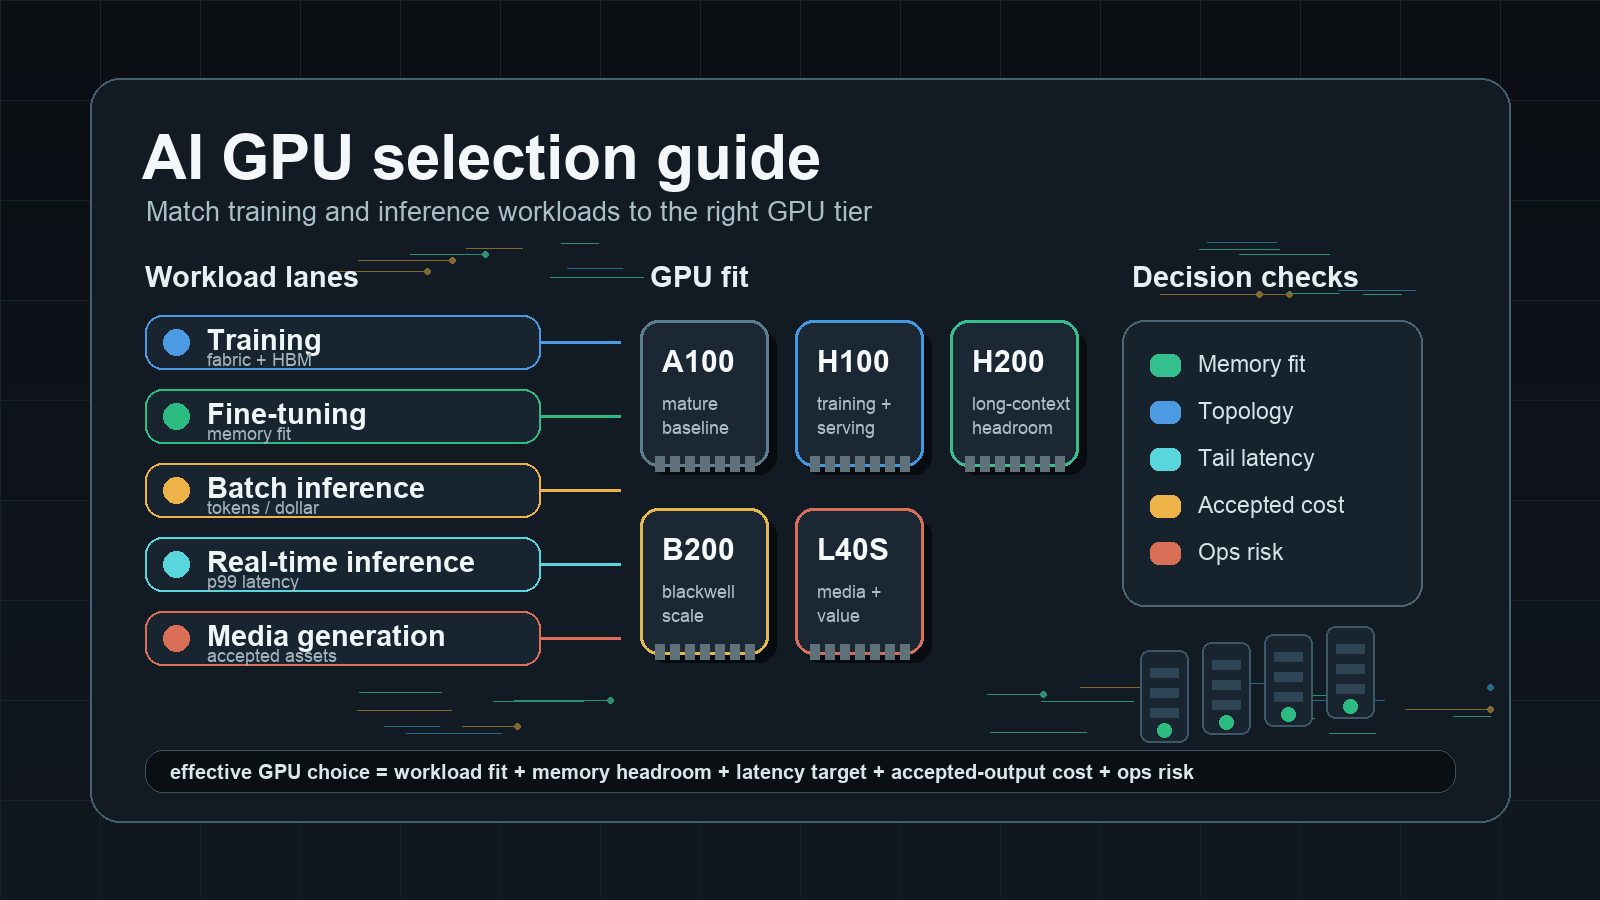
Leitfaden zur Auswahl von AI-GPUs: Die passende GPU für Training und Inferenz finden
Ein praxisorientierter Leitfaden zur Auswahl von AI-GPUs für Teams, die Trainings-, Fine-Tuning-, LLM-Inferenz-, Mediengenerierungs- und Evaluierungsaufgaben mit der passenden GPU und dem geeigneten Leistungsmodell abgleichen.
KI-Sicherheitsaudit: Praxisnaher Testplan, Nachweis-Checkliste und Berichtsvorlage für LLM-Anwendungen
Ein KI-Sicherheitsaudit prüft, was Ihre LLM-Anwendung tatsächlich tut, statt sich auf Anbieterangaben zu verlassen. Dieser Leitfaden bietet eine Vorlage für den Prüfumfang, 12 OWASP-zugeordnete Tests mit Eingabe, erwarteter Schutzmaßnahme, Nachweisen und Abhilfe, eine sichere Testumgebung, Regeln zur Bewertung des Schweregrads und eine Berichtsvorlage.
Grok vs. Gemini (Oktober 2026): Welche KI sollten Sie nutzen?
Wählen Sie Gemini für das beste Preis-Leistungs-Verhältnis, Google-Integration, Videotools und eine API mit 1 Mio. Tokens Kontext; wählen Sie Grok, wenn Sie viel auf X sind, Echtzeit-Posts von X wollen oder ohnehin X Premium zahlen würden. Vergleich von Abos, Aufgaben und APIs, Preise vom 25. Oktober 2026.
Kann man Kimi K3 lokal ausführen? Leitfaden zu Hardware, GGUF und vLLM (2026)
Kimi K3 läuft lokal, aber selbst das kleinste 1-Bit-GGUF braucht rund 610 GB RAM plus VRAM. Genaue Hardwareanforderungen, llama.cpp- und vLLM-Befehle, Lizenzbedingungen und ein Kostenvergleich mit Miet-GPUs und APIs.

Diese Woche mit der Flatkey API starten
Onboarding-Notizen von Northline Analytics
Häufige LiteLLM-Fehler: Timeouts, Budgetwarnungen und Provider-Ausfälle
Ein praxisnaher LiteLLM-Leitfaden zur Fehlerbehebung bei Timeouts, Budgetkontrollen, Warnungen, Modellkonfiguration, Provider-Ausfällen, Wiederholungsversuchen und Fallbacks.
KV-Cache-Offload und -Tiering für LLM-Serving mit langem Kontext
Leitfaden zu KV-Cache-Offload und -Tiering für LLM-Serving mit langem Kontext mit vLLM und TensorRT-LLM.
Kubernetes-GPU-Cluster für KI-Training und Inferenz aufbauen
Praxisleitfaden für Kubernetes-GPU-Cluster für KI-Training und Inferenz – mit GPU-Node-Pools, Device-Plugins, GPU Operator, Warteschlangen, Speicher, Observability, Sicherheit, Kostenkontrolle und Anbieterprüfung.
Kimi K3 vs. GPT 5.6 Sol: Preise, Kontext und welche API Sie testen sollten
Ein quellengeprüfter Vergleich von Kimi K3, GPT-5.6 Sol und GPT-5.6 Terra für Entwickler, die sich für eine Produktions-API entscheiden.
Schneller entwickeln mit einem KI-Gateway.
Nutze flatkey.ai, um Modelle, Schlüssel, Abrechnung und Observability über eine API-Plattform zu verwalten.
Loslegen