DeepSeek API Preise (Oktober 2026): Flash vs. V4 Pro, Spitzenzeiten und Cache-Rechnung
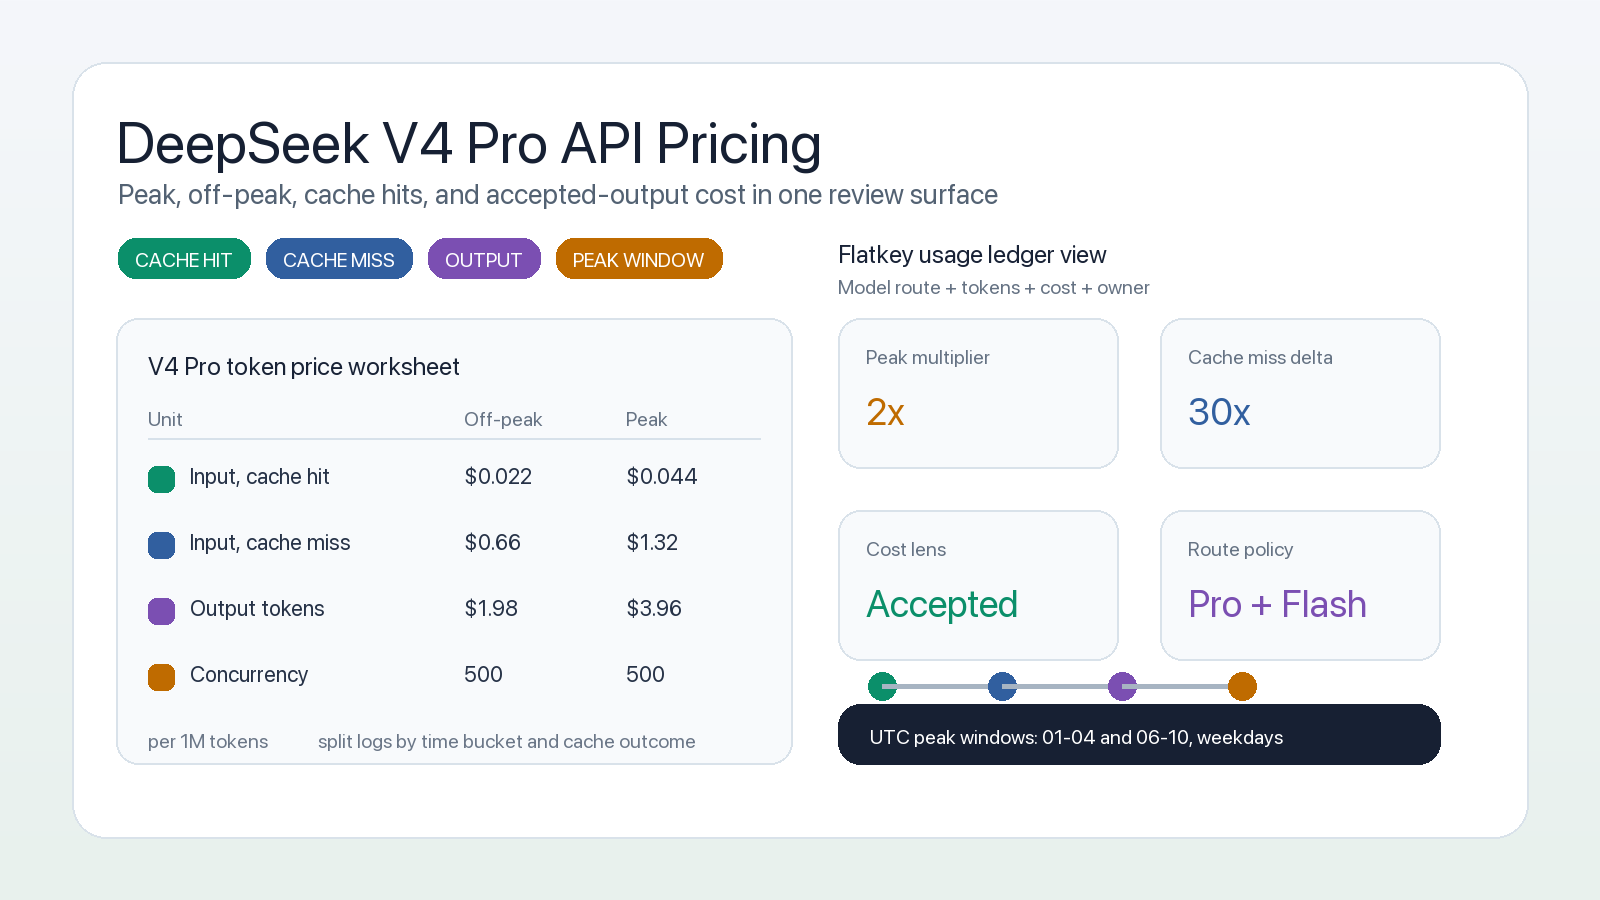
Im Oktober 2026 kostet die DeepSeek API 0,15 $ pro 1M Input-Tokens und 0,60 $ pro 1M Output-Tokens für deepseek-flash außerhalb der Spitzenzeit sowie 0,66 $ Input / 1,98 $ Output für deepseek-v4-pro; zu Spitzenzeiten gilt genau der doppelte Preis. Cache-Treffer senken den Input außerhalb der Spitzenzeit auf 0,003 $ (Flash) bzw. 0,022 $ (V4 Pro) pro 1M Tokens. Spitzenzeiten sind werktags 01:00–04:00 und 06:00–10:00 UTC, die US-Geschäftszeiten liegen also vollständig außerhalb. Alle Zahlen stammen von DeepSeeks offizieller Seite Models & Pricing, geprüft am 21. Oktober 2026.
Dieser Leitfaden richtet sich an Indie-Entwickler und kleine Teams, die DeepSeek wählen, um Inferenz günstig zu halten. Er enthält die vollständige Preistabelle pro Million Tokens, die Abrechnung von Spitzen- und Nebenzeiten in US-Zeitzonen, den Cache-Rabatt, die neuen Gebühren für Search und Fetch, alte Modellnamen, Kostenbeispiele, einen zeitabhängigen Kostenrechner und den Vergleich von DeepSeek mit OpenAI, Claude und Gemini.
DeepSeek API Preise auf einen Blick
| Frage | Antwort (Stand 21. Okt. 2026) |
|---|---|
| Modelle | deepseek-flash (DeepSeek-V4.1-Flash-1017) und deepseek-v4-pro (DeepSeek-V4-Pro-0813) |
| Günstigster Input | deepseek-flash, Cache-Treffer, Nebenzeit: 0,003 $ pro 1M Tokens |
| Flash, Nebenzeit | 0,15 $ Input (Cache-Miss) / 0,60 $ Output pro 1M Tokens |
| V4 Pro, Nebenzeit | 0,66 $ Input (Cache-Miss) / 1,98 $ Output pro 1M Tokens |
| Spitzenmultiplikator | 2x (Nebenzeit = halber Spitzenpreis) |
| Spitzenzeiten | 01:00–04:00 und 06:00–10:00 UTC, Montag–Freitag, ohne chinesische Feiertage |
| Kontext / max. Output | 1M Tokens / 384K Tokens |
| Search- und Fetch-APIs | je 0,75 $ pro 1.000 erfolgreiche Anfragen |
| Free Tier | Keins angegeben; geschenktes Guthaben (falls vorhanden) wird vor aufgeladenem verbraucht |
Quelle: DeepSeek Models & Pricing, 21. Oktober 2026.
DeepSeek API Preis pro Million Tokens
| Preis pro 1M Tokens | deepseek-flash Nebenzeit |
deepseek-flash Spitze |
deepseek-v4-pro Nebenzeit |
deepseek-v4-pro Spitze |
|---|---|---|---|---|
| Input, Cache-Treffer | 0,003 $ | 0,006 $ | 0,022 $ | 0,044 $ |
| Input, Cache-Miss | 0,15 $ | 0,30 $ | 0,66 $ | 1,32 $ |
| Output | 0,60 $ | 1,20 $ | 1,98 $ | 3,96 $ |
| Concurrency-Limit | 2.500 | 2.500 | 500 | 500 |
Quelle: DeepSeek Models & Pricing, 21. Oktober 2026.
Beide Modelle haben auf der Preisseite denselben Funktionsumfang: JSON-Output, Tool Calls, die Responses API, einen Endpunkt im Anthropic-Format, Chat-Prefix-Completion (Beta) und FIM-Completion nur im Nicht-Thinking-Modus. Der einzige Unterschied, der für Entwickler zählt: Vision wird von deepseek-flash unterstützt, aber nicht von deepseek-v4-pro. Beide laufen standardmäßig im Thinking-Modus und lassen sich auf Nicht-Thinking umstellen; siehe den Leitfaden zum Thinking-Modus. Da Reasoning-Tokens als Output abgerechnet werden, ist der Nicht-Thinking-Modus die einfachste Ersparnis bei simplen Routen.
Alte Modellnamen funktionieren weiter, zum Flash-Preis
DeepSeeks Fußnote empfiehlt deepseek-flash als Modellnamen. Die älteren Namen deepseek-v4-flash und deepseek-v4-flash-vision-exp werden noch akzeptiert, die Modelle sind aber abgeschaltet: Anfragen bedient DeepSeek-V4.1-Flash-1017, abgerechnet zum Flash-Preis. Wenn Sie einen alten Namen fixiert haben, um das Verhalten einzufrieren, nutzen Sie bereits das neue Modell; führen Sie Ihre Evals erneut aus. Unsere Migrations-Checkliste für DeepSeek V4 listet, was zu testen ist.
Spitze vs. Nebenzeit: was das in US-Zeit bedeutet
DeepSeek definiert Spitzenzeiten in UTC. Umgerechnet für US-Teams (die Eastern Daylight Time gilt bis 1. November 2026):
| Spitzenfenster (UTC, Mo–Fr) | US Eastern (EDT, bis 1. Nov.) | US Eastern (EST, ab 1. Nov.) | US Pacific (PDT, bis 1. Nov.) |
|---|---|---|---|
| 01:00–04:00 | 21:00–24:00 (Abende So–Do) | 20:00–23:00 | 18:00–21:00 |
| 06:00–10:00 | 2:00–6:00 | 1:00–5:00 | 23:00–3:00 |
Umgerechnet aus den Spitzenzeiten auf DeepSeeks Preisseite. Wochenenden und chinesische Feiertage sind komplett Nebenzeit.
Praktische Konsequenz: Ein US-Produkt, dessen Traffic dem US-Arbeitstag folgt, zahlt fast durchgehend Nebenzeitpreise. Die teuren Fenster fallen auf US-Abende und -Nächte, genau dann, wenn viele Teams Batch-Jobs einplanen. Verlegen Sie nächtliche Cron-Jobs, Evals und Backfills auf den US-Tag oder das Wochenende, und sie kosten die Hälfte. Sind Ihre Nutzer in Asien, gilt das Gegenteil: 06:00–10:00 UTC ist Nachmittag in Peking, und ein Großteil Ihres Tages-Traffics liegt in der Spitze.
So funktioniert der Cache-Rabatt
DeepSeek cached Prompt-Präfixe automatisch; Sie müssen nichts markieren. Das usage-Objekt der Antwort meldet prompt_cache_hit_tokens und prompt_cache_miss_tokens, laut Leitfaden zum Context Caching. Der Leitfaden sagt außerdem, dass Caching nach Best Effort ohne garantierte Trefferquote arbeitet, der Aufbau Sekunden dauert und ungenutzte Caches innerhalb weniger Stunden bis Tage gelöscht werden.
Bei Flash kostet ein Treffer 0,003 $ gegenüber 0,15 $ für einen Miss in der Nebenzeit, ein Rabatt von 98 %. Damit ist die Prompt-Struktur nach der Modellwahl der größte Hebel:
- Halten Sie System-Prompt, Tool-Schemas und Referenzdokumente identisch und am Anfang jeder Anfrage.
- Hängen Sie den nutzerspezifischen Teil ans Ende.
- Senden Sie bei Multi-Turn-Chats den gesamten Verlauf in derselben Reihenfolge, damit frühere Runden den Cache treffen.
Eine allgemeine Methode, um zu messen, ob sich Caching lohnt, finden Sie in unserem Leitfaden zu Kosten und ROI von Prompt Caching.
Gebühren für Search und Fetch
DeepSeek verkauft jetzt eigenständige Search- und Fetch-APIs für je 0,75 $ pro 1.000 erfolgreiche Anfragen. Laut Preisseite nutzen serverseitige Tool Calls über DeepSeek Harness, Claude Code oder Codex diese APIs bereits und sind vorerst kostenlos; die Abrechnung pro Anfrage beginnt am 1. November 2026 um 00:00 Uhr Pekinger Zeit (31. Oktober, 16:00 UTC). Wenn Sie DeepSeek in einem Coding-Agent nutzen, planen Sie vor diesem Datum einen Posten für Suchaufrufe ein.
Rechenbeispiel: DeepSeek API Kosten pro Monat
Angenommen werden 100.000 Anfragen pro Monat mit je 2.000 Input- und 500 Output-Tokens: 200M Input- und 50M Output-Tokens.
| Szenario | Input-Kosten | Output-Kosten | Monatssumme |
|---|---|---|---|
| Flash, Nebenzeit, keine Cache-Treffer | 200 x 0,15 $ = 30,00 $ | 50 x 0,60 $ = 30,00 $ | 60,00 $ |
| Flash, Spitze, keine Cache-Treffer | 200 x 0,30 $ = 60,00 $ | 50 x 1,20 $ = 60,00 $ | 120,00 $ |
| Flash, Nebenzeit, 70 % Cache-Treffer | 60 x 0,15 $ + 140 x 0,003 $ = 9,42 $ | 30,00 $ | 39,42 $ |
| V4 Pro, Nebenzeit, keine Cache-Treffer | 200 x 0,66 $ = 132,00 $ | 50 x 1,98 $ = 99,00 $ | 231,00 $ |
| V4 Pro, Spitze, keine Cache-Treffer | 200 x 1,32 $ = 264,00 $ | 50 x 3,96 $ = 198,00 $ | 462,00 $ |
Berechnet aus DeepSeeks veröffentlichten Preisen, 21. Oktober 2026.
Zwei Muster fallen auf. Erstens senkt Caching die Flash-Rechnung um etwa ein Drittel, obwohl der Output gleich bleibt, weil die Input-Seite fast verschwindet. Zweitens kostet V4 Pro zur selben Uhrzeit etwa das Vierfache von Flash; leiten Sie daher nur Anfragen an Pro weiter, die auf Flash scheitern (komplexes Reasoning, lange Agent-Schleifen). Unser Vergleich DeepSeek V4 Pro vs. Flash zeigt, wann sich das lohnt.
DeepSeek-Kostenrechner zum Kopieren (zeitabhängig)
Der Rechner unten liest die Cache-Felder aus einer echten Antwort und wendet je nach UTC-Zeit der Anfrage den Spitzen- oder Nebenzeitpreis an. Chinesische Feiertage kennt er nicht; an diesen Tagen überschätzt er die Kosten.
# pip install openai
import os
from datetime import datetime, timezone
from openai import OpenAI

# DeepSeek rates per 1M tokens, Models & Pricing page, Oct 21, 2026 (off-peak; peak = 2x)
OFF_PEAK = {
    "deepseek-flash":  {"hit": 0.003, "miss": 0.15, "out": 0.60},
    "deepseek-v4-pro": {"hit": 0.022, "miss": 0.66, "out": 1.98},
}

def is_peak(ts: datetime) -> bool:
    ts = ts.astimezone(timezone.utc)
    if ts.weekday() >= 5:  # Saturday, Sunday
        return False
    return 1 <= ts.hour < 4 or 6 <= ts.hour < 10

def cost(model: str, usage, ts: datetime) -> float:
    r = OFF_PEAK[model]
    k = 2 if is_peak(ts) else 1
    return k * (usage.prompt_cache_hit_tokens * r["hit"]
                + usage.prompt_cache_miss_tokens * r["miss"]
                + usage.completion_tokens * r["out"]) / 1_000_000

client = OpenAI(api_key=os.environ["DEEPSEEK_API_KEY"], base_url="https://api.deepseek.com")
now = datetime.now(timezone.utc)
resp = client.chat.completions.create(
    model="deepseek-flash",
    messages=[{"role": "system", "content": "You are a concise SQL assistant."},
              {"role": "user", "content": "Count orders per day for the last 7 days."}],
)
print(resp.choices[0].message.content)
print(f"peak={is_peak(now)} cost=${cost('deepseek-flash', resp.usage, now):.6f}")
Dieselbe Anfrage mit curl:
curl https://api.deepseek.com/chat/completions \
  -H "Authorization: Bearer $DEEPSEEK_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model":"deepseek-flash","messages":[{"role":"user","content":"Explain idempotency keys in one paragraph."}]}'
Und in Node.js:
import OpenAI from "openai";

const client = new OpenAI({ apiKey: process.env.DEEPSEEK_API_KEY, baseURL: "https://api.deepseek.com" });
const r = await client.chat.completions.create({
  model: "deepseek-v4-pro",
  messages: [{ role: "user", content: "Plan a zero-downtime Postgres migration." }],
});
console.log(r.choices[0].message.content);
console.log(r.usage.prompt_cache_hit_tokens, r.usage.prompt_cache_miss_tokens, r.usage.completion_tokens);
DeepSeek vs. OpenAI, Claude und Gemini
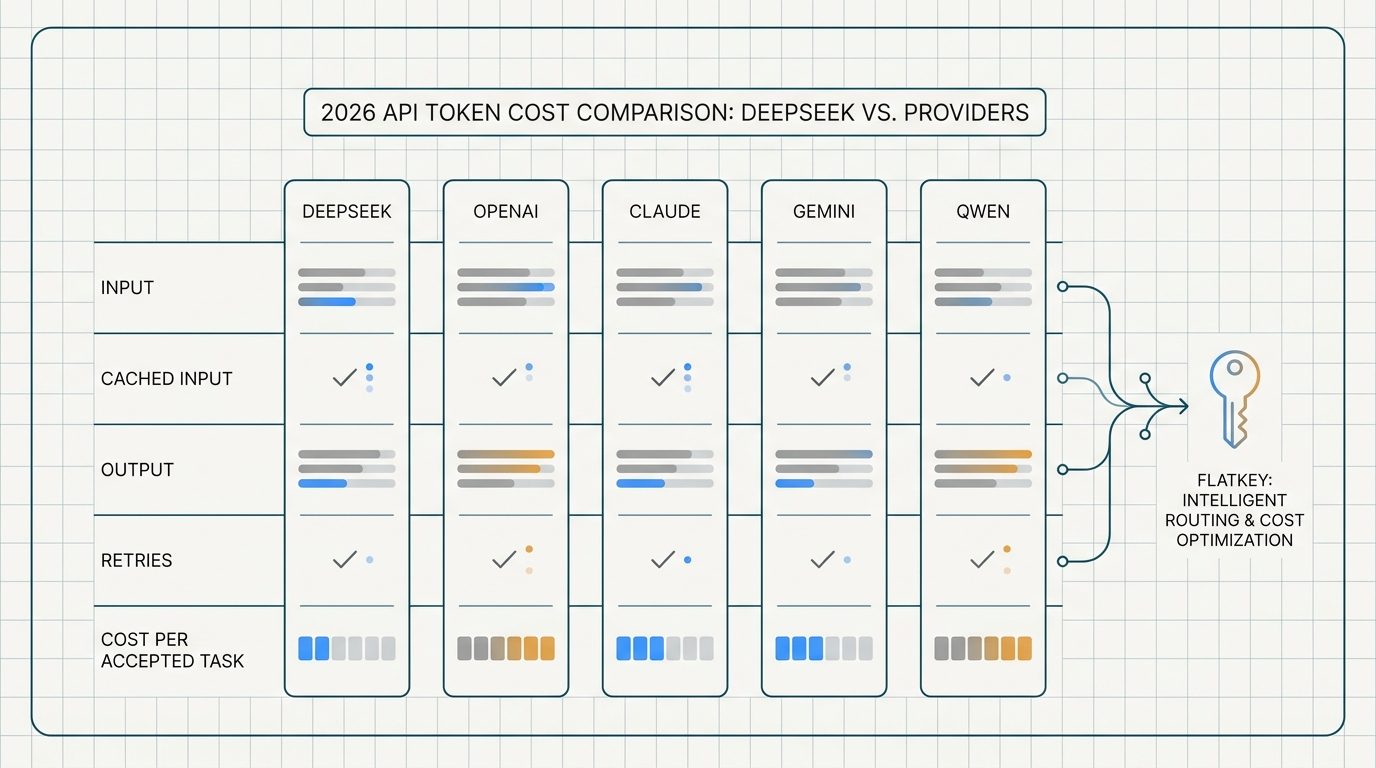
Gleiche Last wie oben (200M Input, 50M Output, kein Caching) zum offiziellen Standard-Listenpreis jedes Anbieters am 21. Oktober 2026:
| Modell | Input / Output pro 1M | Monatskosten |
|---|---|---|
| Gemini 2.5 Flash-Lite | 0,10 $ / 0,40 $ | 40,00 $ |
gpt-6-luna |
0,10 $ / 0,50 $ | 45,00 $ |
| Claude Haiku 5.5 (Prompts bis 100K) | 0,10 $ / 0,50 $ | 45,00 $ |
deepseek-flash, Nebenzeit |
0,15 $ / 0,60 $ | 60,00 $ |
deepseek-v4-pro, Nebenzeit |
0,66 $ / 1,98 $ | 231,00 $ |
| Gemini 3.8 Flash (Aktion 2026) | 0,75 $ / 3,75 $ | 337,50 $ |
gpt-6.1-sol |
2,00 $ / 10,00 $ | 900,00 $ |
| Claude Sonnet 5.5 | 2,00 $ / 10,00 $ | 900,00 $ |
Quellen: OpenAI-Preise, Anthropic-Preise, Gemini-Preise.
Ehrlich betrachtet: Zum Listenpreis ist DeepSeek Flash nicht mehr das günstigste Budgetmodell; Gemini 2.5 Flash-Lite, gpt-6-luna und Claude Haiku 5.5 liegen ohne Caching knapp darunter. DeepSeek gewinnt, wenn Ihr Traffic hohe Cache-Trefferquoten hat (der Trefferpreis von 0,003 $ ist der niedrigste der Tabelle), und im Mittelfeld, wo V4 Pro etwa ein Viertel von gpt-6.1-sol oder Sonnet 5.5 kostet. Vergleichen Sie vor dem Wechsel die Qualität auf Ihren eigenen Aufgaben. Für einen anbieterübergreifenden Blick siehe DeepSeek API vs. Qwen API für kostensensible Workflows und unseren Leitfaden zu OpenAI-API-Preisen.
Direkte DeepSeek API oder ein Gateway?
Direkter Zugang bietet DeepSeeks eigene Preise, neue Funktionen zuerst und den Endpunkt im Anthropic-Format unter https://api.deepseek.com/anthropic. Ein Gateway lohnt sich, wenn DeepSeek eines von mehreren Modellen in Ihrem Produkt ist und Sie einen Key, ein Guthaben und Failover wollen, falls DeepSeeks Concurrency-Limit oder ein Ausfall Anfragen blockiert.
Am 21. Oktober 2026 listeten Flatkeys Modellseiten deepseek-v4-1-flash ab 0,09 $ Input / 0,36 $ Output pro 1M Tokens und deepseek-v4-pro ab 0,396 $ / 1,188 $, 40 % unter DeepSeeks Nebenzeit-Listenpreisen. Flatkey nutzt ebenfalls zeitgestaffelte UTC-Preise, der „ab“-Preis ist also die Nebenzeitstufe; prüfen Sie auf der Modellseite, welche Stufe für Ihren Traffic gilt. Flatkey spricht das OpenAI-Format unter https://router.flatkey.ai/v1 und das Anthropic-Format, sodass der obige Code nach Änderung von Base-URL und Key funktioniert. Einrichtungsdetails stehen in unserem Leitfaden zum DeepSeek-API-Zugang.
Checkliste zu DeepSeek-Preisen
- Verwenden Sie
deepseek-flashals Modellnamen; alte V4-Flash-Namen landen jetzt bei V4.1-Flash-1017. - Planen Sie Batch-Jobs werktags außerhalb von 01:00–04:00 und 06:00–10:00 UTC.
- Loggen Sie
prompt_cache_hit_tokensundprompt_cache_miss_tokensund verfolgen Sie die Trefferquote. - Nutzen Sie den Nicht-Thinking-Modus, wo Reasoning keinen Mehrwert bringt.
- Schicken Sie Bild-Inputs an Flash; V4 Pro unterstützt kein Vision.
- Planen Sie ab dem 1. November 2026 Budget für Search- und Fetch-Aufrufe ein, wenn Sie DeepSeek in Coding-Agents nutzen.
- Prüfen Sie die Preisseite monatlich; DeepSeek weist darauf hin, dass sich Preise ändern können.
FAQ
Was kostet die DeepSeek API pro Million Tokens?
Stand 21. Oktober 2026 kostet deepseek-flash in der Nebenzeit 0,15 $ pro 1M Input-Tokens (Cache-Miss) und 0,60 $ pro 1M Output-Tokens, deepseek-v4-pro 0,66 $ und 1,98 $. Zur Spitze verdoppeln sich die Preise, und Input mit Cache-Treffer kostet in der Nebenzeit 0,003 $ (Flash) bzw. 0,022 $ (V4 Pro), laut offizieller Preisseite.
Ist die DeepSeek API kostenlos?
Nein. DeepSeek belastet jede Anfrage Ihrem Guthaben, und die Preisseite nennt kein Free Tier. Haben Sie Guthaben aus einer Aktion erhalten, verbraucht DeepSeek dieses vor Ihrem aufgeladenen Guthaben. Kostenlose Optionen finden Sie in unserer Liste kostenloser LLM-APIs.
Gibt es einen kostenlosen DeepSeek-API-Key?
Einen API-Key können Sie auf der DeepSeek-Plattform kostenlos erstellen, Anfragen benötigen aber trotzdem Guthaben. Drittanbieter mit „kostenlosen DeepSeek-Keys“ verkaufen entweder geteilte Keys weiter oder bieten eigene Testguthaben; senden Sie darüber keine privaten Daten.
Wann sind DeepSeeks Spitzenzeiten?
01:00–04:00 und 06:00–10:00 UTC, Montag bis Freitag, ohne chinesische Feiertage. In US-Eastern-Zeit vor dem 1. November 2026 sind das 21 Uhr bis Mitternacht und 2 bis 6 Uhr; Wochenenden sind Nebenzeit.
Warum variieren die DeepSeek-Kosten bei identischen Anfragen?
Drei Gründe: die Tageszeit (die Spitze verdoppelt den Preis), die Cache-Trefferquote (ein Treffer kostet bei Flash 98 % weniger) und Thinking-Tokens, die als Output abgerechnet werden. Loggen Sie alle drei pro Anfrage, um Ihre Rechnung zu erklären.
Ist DeepSeek günstiger als OpenAI?
Im Mittelfeld ja: deepseek-v4-pro kostet in der Nebenzeit 0,66/1,98 $ pro 1M Tokens gegenüber 2/10 $ für gpt-6.1-sol. Im Budgetsegment ist gpt-6-luna (0,10/0,50 $) etwas günstiger als deepseek-flash in der Nebenzeit (0,15/0,60 $), sofern Ihre Cache-Trefferquote nicht hoch ist.
Quellen
- DeepSeek Models & Pricing, geprüft am 21. Oktober 2026
- DeepSeek Leitfaden zum Context Caching, geprüft am 21. Oktober 2026
- DeepSeek Leitfaden zum Thinking-Modus, geprüft am 21. Oktober 2026
- OpenAI-Preise, Anthropic-Preise, Gemini-Preise, geprüft am 21. Oktober 2026
- Flatkey-Preise aus dem Flatkey-Modellverzeichnis, geprüft am 21. Oktober 2026