
Blog flatkey.ai
Analyses, notes produit et guides d'implémentation pour les équipes qui construisent avec des API d'IA.
Architecture des passerelles IA
Derniers articles dans Architecture des passerelles IA.
Lire la suiteMigration des URL de base et des SDK
Derniers articles dans Migration des URL de base et des SDK.
Lire la suiteCoûts, facturation et exploitation
Derniers articles dans Coûts, facturation et exploitation.
Lire la suiteContrôles d’entreprise et confiance
Derniers articles dans Contrôles d’entreprise et confiance.
Lire la suiteComparatifs de passerelles
Derniers articles dans Comparatifs de passerelles.
Lire la suiteGuides des modèles et des modalités
Derniers articles dans Guides des modèles et des modalités.
Lire la suiteFiabilité et routage
Derniers articles dans Fiabilité et routage.
Lire la suiteIntégrations d’outils
Derniers articles dans Intégrations d’outils.
Lire la suite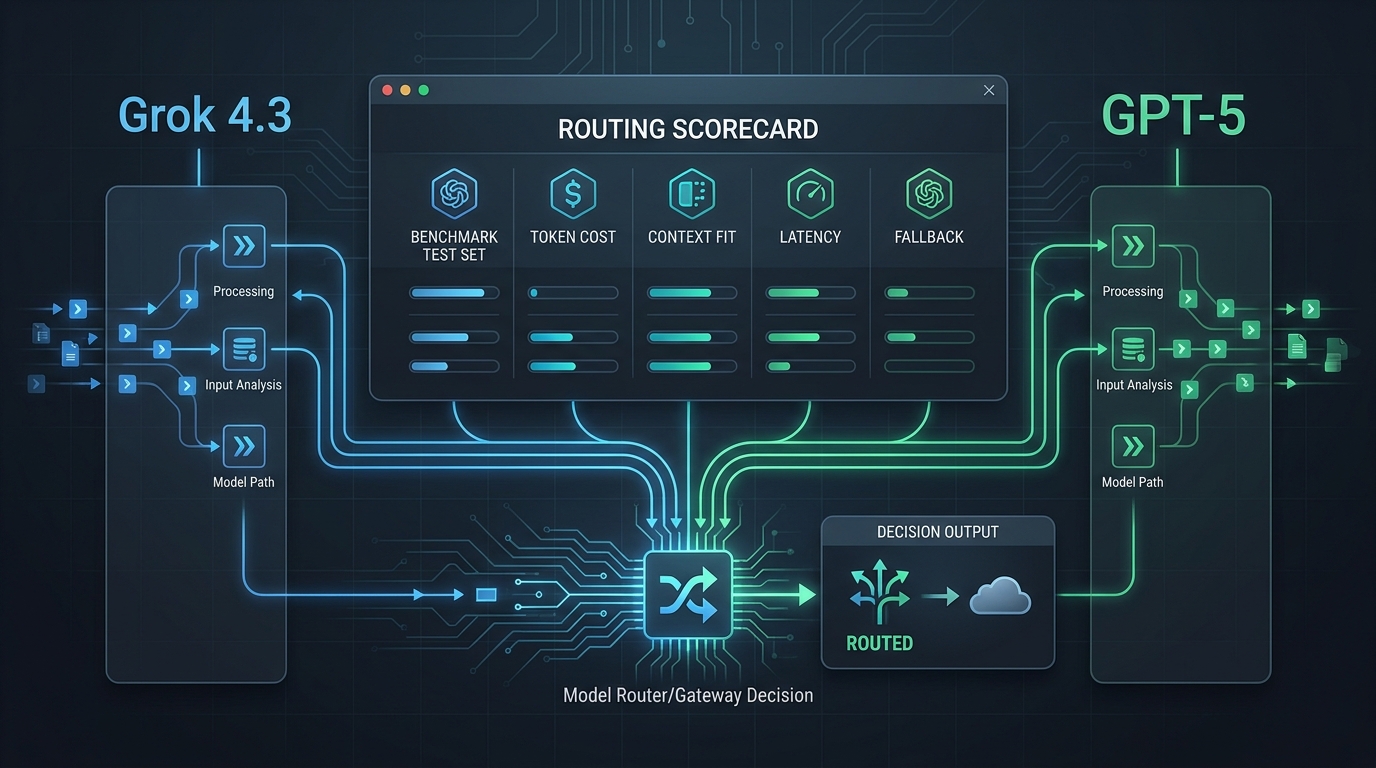
Grok 4.3 vs GPT-5 : benchmarks, tarifs et routage
Un guide de routage étayé par des sources pour les équipes qui comparent Grok 4.3 et GPT-5 en matière de tarifs, contexte, conception des benchmarks, calendrier de migration et usage d’une passerelle.

Louer un serveur GPU : architecture, performances et guide de déploiement cloud
Découvrez comment louer un serveur GPU avec la bonne allocation, des vérifications de topologie, des étapes de déploiement et des tests de réception avant de vous engager sur une capacité.

Baie de serveurs GPU : guide d’architecture, de performance et de déploiement cloud
Guide pratique pour dimensionner, valider et déployer une capacité GPU à l’échelle d’une baie pour les charges de travail d’IA.

Guide des API de masquage des données personnelles (2026) : comparatif AWS, Google Cloud, Azure et Presidio pour les applications LLM
Une API de masquage des données personnelles détecte et masque ces données dans un texte. Comparez Amazon Comprehend, Google Sensitive Data Protection, Azure Language PII et Presidio, avec du code, les unités de facturation, des résultats de détection réels et un pipeline de masquage pour LLM.
Décodage spéculatif pour l’inférence de LLM : gains de débit et compromis
Guide pratique du décodage spéculatif pour l’inférence de LLM : fonctionnement, cas d’usage, différences entre EAGLE et Medusa, et benchmarks à effectuer avant le déploiement.

Inférence IA vs entraînement : performances, coûts et compromis de déploiement
Inférence IA ou entraînement : comparez les indicateurs de performance, les facteurs de coût, les exigences de déploiement et les cas où affiner ou servir un modèle.

Qu’est-ce que le routage LLM ? Règles, pondérations et politiques tenant compte des coûts
Qu’est-ce que le routage LLM ? Découvrez comment les règles, scores pondérés, filtres de capacités, solutions de repli et évaluations rendent les API multi-modèles plus fiables.

Déploiement du parallélisme expert de vLLM pour DeepSeek et d’autres modèles MoE
Déployez le parallélisme expert de vLLM pour DeepSeek et d’autres modèles MoE avec les bons paramètres, la bonne topologie, des vérifications du backend et des tests de déploiement.

vLLM Docker : guide d’architecture, de performances et de déploiement cloud
Guide de déploiement de vLLM Docker sur GPU cloud : architecture, configuration compatible OpenAI, optimisation des performances, mise à l’échelle multi-GPU et vérifications de production.

API unifiée pour les modèles d’IA : une clé, un endpoint et une facturation
Guide pratique d’une API unifiée pour centraliser l’accès aux modèles, les clés, les endpoints, l’usage, la facturation, le routage et le fallback, sans perdre les options propres aux fournisseurs.
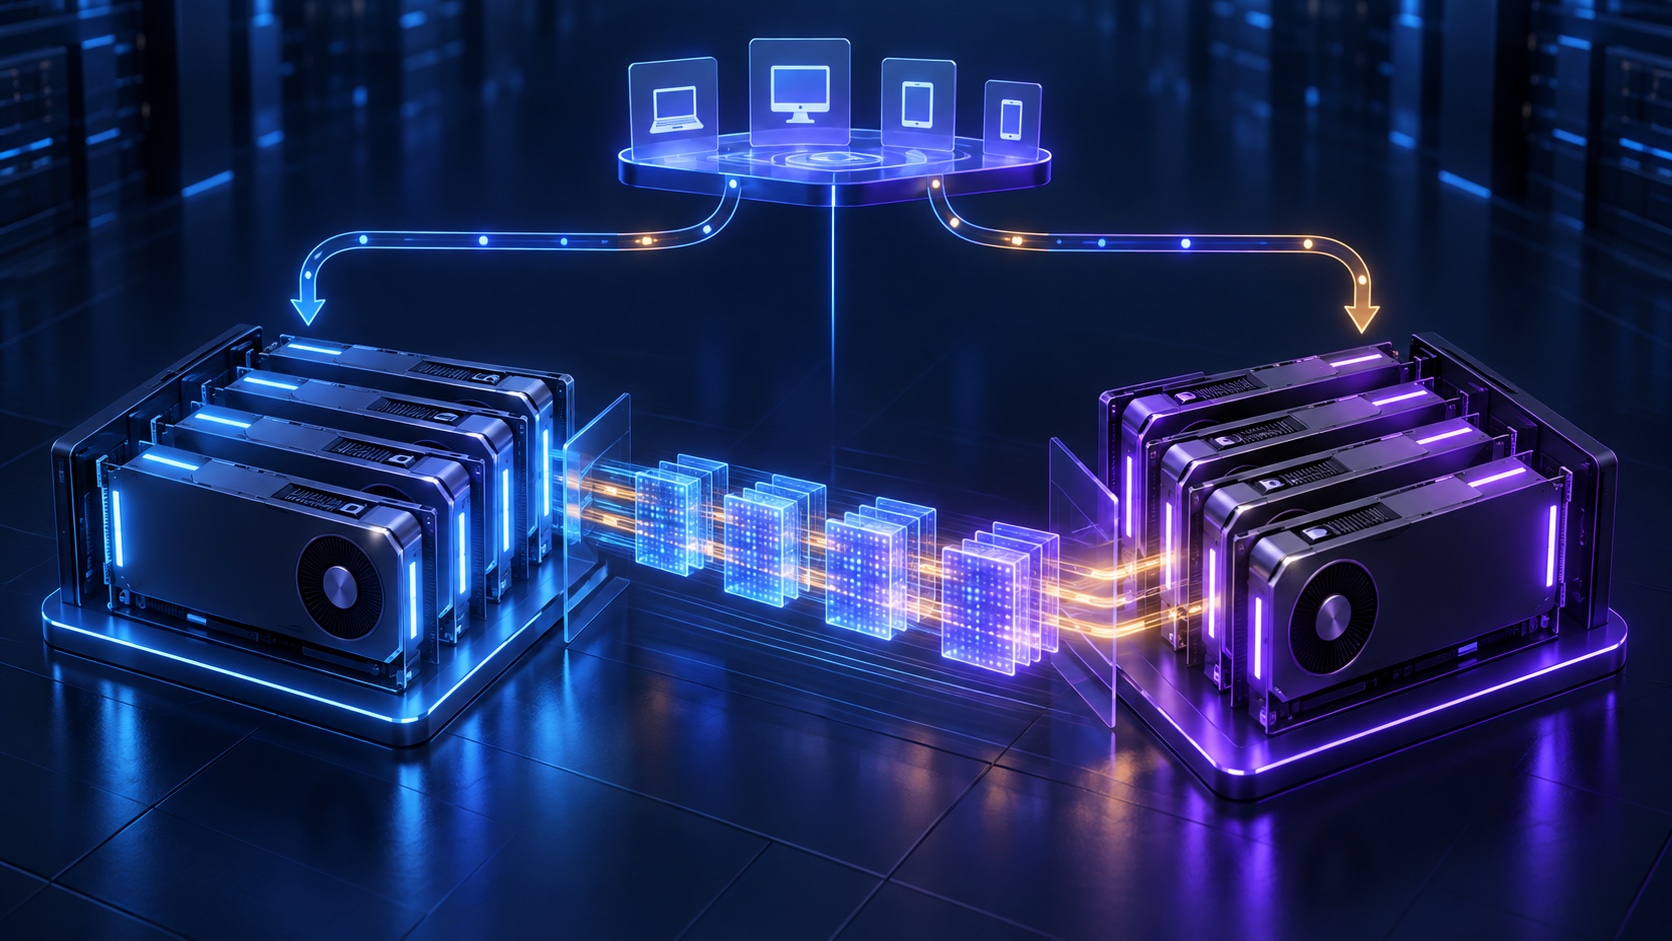
Désagrégation du préremplissage et du décodage SGLang : architecture et guide de déploiement
Déployez la désagrégation du préremplissage et du décodage SGLang avec des pools de GPU distincts, le transfert du cache KV, des métriques de validation, des choix de topologie et des vérifications de déploiement.

Notes d’architecture

Coût des LLM auto-hébergés par million de tokens : un modèle reproductible des coûts GPU
Un modèle reproductible pour calculer le coût de service des LLM auto-hébergés à partir de la capacité GPU entièrement chargée, du débit accepté, de l’utilisation et de la qualité.

API Perplexity AI : accès, tarifs, intégration et guide de production
Un guide étayé par des sources pour choisir la bonne interface API Perplexity, l’intégrer correctement, estimer les coûts et l’exploiter en toute sécurité en production.

URL de base de l’API OpenAI (2026) : endpoints directs et compatibles
L’URL de base officielle de l’API OpenAI, les chemins d’endpoints courants, la configuration compatible avec Flatkey, des exemples de code et les solutions aux doublons de /v1 et aux erreurs 404.

Coût de l’API OpenAI en 2026 : tableau des tarifs et calculateur
Un guide actualisé des coûts de l’API OpenAI avec les tableaux tarifaires de GPT-6, un calculateur à copier, des exemples détaillés, les frais cachés et des vérifications d’optimisation.

Comment obtenir une clé API OpenAI et corriger une erreur 401 « Clé API non valide »
Diagnostiquez en toute sécurité les erreurs OpenAI 401 de clé API non valide, notamment les mauvais points de terminaison, les secrets obsolètes, les clés révoquées, les contrôles de projet et les listes d’autorisation IP.
Clé API OpenAI gratuite ? Limites, coûts et compromis en production
Une clé API OpenAI est un identifiant, pas un budget de production gratuit garanti. Découvrez les critères d’éligibilité, crédits, limites, coûts et contrôles de dépenses à vérifier avant le lancement.
Construisez plus vite avec une seule passerelle IA.
Utilisez flatkey.ai pour gérer modèles, clés, facturation et observabilité depuis une plateforme API.
Commencer