Beste GPU für LLM-Training: Skalierung, Speicher, Netzwerk und Budget
Die beste GPU für das LLM-Training im Jahr 2026 ist keine einzelne SKU. Sie hängt vom Trainingsjob ab. Für einen LoRA- oder QLoRA-Adapter ist die beste GPU für das LLM-Training oft die günstigste Karte, die Modell, Data Loader und Batch Size bewältigt. Beim Full Fine-Tuning eines 70B-Modells verschiebt sich die Antwort in Richtung H100-, H200- oder B200-Systeme mit speicherbandbreiter High-Bandwidth Memory und schnellen Links innerhalb des Nodes. Für Pretraining oder Continued Pretraining über mehrere Nodes hinweg ist die GPU weniger wichtig als der gesamte Cluster: NVLink oder NVSwitch innerhalb des Nodes, InfiniBand oder gleichwertiges RDMA zwischen den Nodes, Checkpoint-Speicher, Reife des Schedulers und Kapazitätsgarantien.
Dieser Leitfaden gibt eine praktische Antwort auf die Frage „Welche GPU eignet sich am besten für das LLM-Training?“, indem er vier Entscheidungen trennt:
- Skalierung: Adapter-Tuning, Full Fine-Tuning, Continued Pretraining oder Foundation-Model-Pretraining.
- Speicher: ob Modell, Optimizer-States, Activations und Batch Size mit Spielraum passen.
- Netzwerk: ob Ihr Job Single-GPU, Single-Node-Multi-GPU oder Multi-Node ist.
- Budget: ob Ihr Engpass rohe $/GPU-Stunde, reservierter Cluster-Zugang, Warteschlangenzeit oder Engineering-Zeit ist.
Wenn Sie nur Anwendungsergebnisse benötigen und keine Checkpoints besitzen müssen, kann eine Modell-API eine bessere Basis als gemietete GPUs sein. Flatkey ist ein einheitliches, OpenAI-kompatibles Model Gateway für das Routing über viele KI-Modelle hinweg mit einem Schlüssel und einer Rechnung. Verwenden Sie das als Vergleichspunkt, bevor Sie teure Trainingsinfrastruktur reservieren.
Kurzantwort: Beste GPU für das LLM-Training nach Workload
| Workload | Praktisch beste GPU-Wahl | Warum sie passt | Was zu vermeiden ist |
|---|---|---|---|
| Prompt Tuning, LoRA, QLoRA auf 7B-13B-Modellen | RTX 4090, RTX 6000 Ada, L40S, A100 40GB/80GB, H100 PCIe, wenn günstig | Niedrige Kosten, genug VRAM für Adapter, schnelle Iteration | Für einen 8-GPU-H100-Node zahlen, wenn eine Karte ausreicht |
| LoRA oder QLoRA auf 32B-70B-Modellen | A100 80GB, H100 80GB, H200 141GB, B200 180GB | Mehr VRAM reduziert Sharding- und Offload-Komplexität | Consumer-Karten ohne ECC/Support für lange Jobs |
| Full Fine-Tuning 7B-34B | 4-8x H100 SXM/H200/B200, manchmal A100 80GB für Budget-Jobs | Speicher, Tensor Cores und NVLink/NVSwitch sind wichtig | PCIe-only-Multi-GPU-Nodes für kommunikationsintensives Training |
| Full Fine-Tuning 70B+ | 8x H100 SXM, 8x H200, 8x B200 oder verwaltete Cluster | Erfordert verteiltes Training, hohen Speicher, schnelle Collectives | Nur den Stundenpreis pro GPU vergleichen |
| Continued Pretraining oder Foundation-Model-Training | Große H100/H200/B200-Cluster mit bewährtem InfiniBand/RDMA, Checkpoint-Speicher, ausgereifter Slurm/Kubernetes/Ray | Cluster-Zuverlässigkeit und Netzwerke dominieren | Nur-Spot-Kapazität, sofern der Job nicht vollständig checkpoint-tolerant ist |
| Budget-Experimente vor dem Training | Modell-API-Basis über Flatkey, dann bei Bedarf kleiner LoRA-Run | Vermeidet GPU-Miete, bevor Modell-/Datenziel klar ist | Mit GPU-Miete beginnen, nur weil es flexibler wirkt |
Die Kurzregel: Wählen Sie H200 oder B200, wenn Speicherspielraum und weniger Shards Engineering-Zeit sparen; wählen Sie H100, wenn Verfügbarkeit und Preis-Leistung besser sind; wählen Sie A100 oder L40S nur dann, wenn der Workload passt und die Einsparungen relevant sind.
Warum es keine universell beste GPU für das Training von LLMs gibt
Suchergebnisse bewerten GPUs oft nach TFLOPS oder Speichergröße. Das ist nützlich, aber unvollständig. LLM-Training verbringt Zeit mit Matrix-Mathematik, Speicherbewegungen, Gradientensynchronisation, Optimizer-State-Verarbeitung, Checkpoint-I/O und Stalls in der Input-Pipeline. Eine GPU mit hervorragender Tensor-Performance kann unterperformen, wenn der Job durch PCIe-Topologie, langsamen Speicher, schwaches Netzwerk oder schlechtes Data Loading ausgebremst wird.
Für die beste GPU für das LLM-Training beginnen Sie mit der Trainingsmethode:
- LoRA/QLoRA: Sie aktualisieren eine kleine Anzahl von Adapter-Parametern. Der Speicherbedarf ist deutlich geringer als beim Full Fine-Tuning, daher kann eine günstigere GPU gewinnen.
- Full Fine-Tuning: Sie aktualisieren alle Modellgewichte. Optimizer-States, Gradienten, Activations und Checkpoint-Speicher machen GPU-Speicher zur ersten Einschränkung.
- Continued Pretraining: Sie trainieren über viele Tokens und viele Nodes hinweg. Netzwerk, Fehlerwiederherstellung, Datendurchsatz und Checkpoint-Strategie werden ebenso wichtig wie die GPU-Wahl.
- Pretraining from Scratch: Sie kaufen ein Trainingssystem, nicht nur eine GPU. Die beste Antwort ist ein validierter Cluster mit ausreichender Kapazität, Speicher, Betrieb und Support.
DeepSpeed ZeRO erklärt das Kernspeicherproblem klar: ZeRO partitioniert Optimizer-States, Gradienten und Parameter über Data-Parallel-Prozesse, statt sie zu replizieren. Das hilft, größere Modelle unterzubringen, erhöht aber auch die Kommunikation und die Systemkomplexität. NVIDIA NCCL-Collectives wie all-reduce, all-gather und reduce-scatter sind die Kommunikationsprimitive, die auftreten, sobald sich Ihr Trainingsjob über mehrere GPUs erstreckt.
GPU-Speicher: Der erste Filter
Der GPU-Speicher entscheidet, ob Training einfach, geshardet, ausgelagert oder unmöglich ist.
Für Inference ist der grobe Speicheranker Gewichte plus KV-Cache. Für Training fügen Sie hinzu:
- Trainierbare Gewichte
- Gradienten
- Optimizer-Zustände
- Aktivierungen
- Temporäre Puffer
- Framework-Overhead
- Spielraum für Checkpoint und Neustart
Die nützlichste Frage zur Dimensionierung lautet nicht: „Passt das Modellgewicht hinein?“ Sondern:
Passen Modell, Trainingsmethode, Sequenzlänge, Microbatch, Optimizer-Zustand und Aktivierungsstrategie mit genügend Spielraum hinein, um ständiges OOM-Debugging zu vermeiden?
Nutzen Sie diesen Entscheidungsweg:
- Schätzen Sie den Speicherbedarf der Modellgewichte: Parameter x Bytes pro Parameter.
- Addieren Sie den Optimizer- und Gradienten-Overhead für vollständiges Fine-Tuning.
- Addieren Sie den Aktivierungsspeicher basierend auf Sequenzlänge, Schichten, Batch-Größe und Checkpointing.
- Fügen Sie 15–30 % operativen Spielraum hinzu.
- Wenn das Ergebnis nur knapp passt, wechseln Sie zu einer höheren GPU-Klasse oder reduzieren Sie die Trainingsmethode auf Adapter.
NVIDIA gibt für H200 SXM 141 GB HBM3e und 4,8 TB/s Speicherbandbreite an, während H100 SXM üblicherweise mit 80 GB HBM3 und geringerer Bandbreite erscheint. NVIDIA-DGX-B200-Systeme bündeln 1.440 GB gesamten GPU-Speicher über acht Blackwell-GPUs hinweg, was in dieser Systemklasse 180 GB pro GPU bedeutet. Diese Zahlen sind wichtig, weil mehr Speicher-Spielraum Tensor Parallelism, CPU-/NVMe-Offload und Checkpoint-Akrobatik reduzieren kann.
GPU-Auswahl: H100, H200, B200, A100, L40S
| GPU-Familie | Am besten geeignet für LLM-Training | Stärke | Vorsicht |
|---|---|---|---|
| NVIDIA B200 / Blackwell-Systeme | Neue Trainingscluster mit großem Speicher, High-End-Fine-Tuning, Workloads, die Blackwell-Softwarepfade nutzen können | 180-GB-Klasse Speicher in DGX-B200-Systemen, hohe aggregierte Bandbreite, neuere Tensor-Formate | Verfügbarkeit, Reservierungsbedingungen und Software-Reife müssen je Anbieter geprüft werden |
| NVIDIA H200 | Speicherbegrenztes Fine-Tuning und Training, bei dem H100 funktioniert, Sharding aber schmerzhaft ist | 141 GB HBM3e und 4,8 TB/s Speicherbandbreite | Oft teurer als H100; nicht immer das bessere Preis-Leistungs-Verhältnis, wenn Speicher nicht der Engpass ist |
| NVIDIA H100 SXM | Standardwahl für seriöses LLM-Training, wenn Kapazität verfügbar ist | Starkes Ökosystem, FP8 Transformer Engine, NVLink/NVSwitch-Systeme, breite Cloud-Unterstützung | 80 GB Speicher können bei sehr großen Modellen mehr Shards erzwingen |
| NVIDIA H100 PCIe / H100 NVL | Kleinere Trainingsjobs, Adapter-Tuning oder eingeschränkte Rechenzentren | Bessere Verfügbarkeit in einigen Clouds; H100 NVL kann bei Speicherbedarf mit zwei GPUs helfen | Die PCIe-Topologie kann Multi-GPU-Training im Vergleich zu SXM-/NVSwitch-Knoten einschränken |
| NVIDIA A100 80GB | Budget-Fine-Tuning, ältere, aber stabile Stacks, Experimente jenseits der Frontlinie | Ausgereift, oft günstiger, genug Speicher für viele Jobs | Geringere Leistung und ältere Interconnect-Generation als H100/H200/B200 |
| NVIDIA L40S / RTX PRO / Workstation-GPUs | Adapter-Tuning, Experimente, Modell-Debugging, synthetische Daten-Pipelines | Niedrigere Stundenkosten, nützlich für Iterationen | Nicht ideal für großes verteiltes Training; ECC, Topologie und Support prüfen |
Für die Planung der besten GPU für LLM-Training 2026 sollten Sie nicht mit der neuesten Karte beginnen. Beginnen Sie mit dem kleinsten validierten System, das Ihren Speicher- und Skalierungszielen entspricht. Wenn es sich um Adapter-Tuning handelt, kann eine günstigere GPU bei den akzeptierten Ausgabe-Kosten eine Premium-GPU schlagen. Wenn es sich um Multi-Node-Full-Fine-Tuning handelt, kann eine günstige PCIe-Karte teuer werden, sobald Kommunikations-Overhead und fehlgeschlagene Läufe berücksichtigt werden.
Netzwerk: Wenn der Knoten wichtiger ist als die GPU
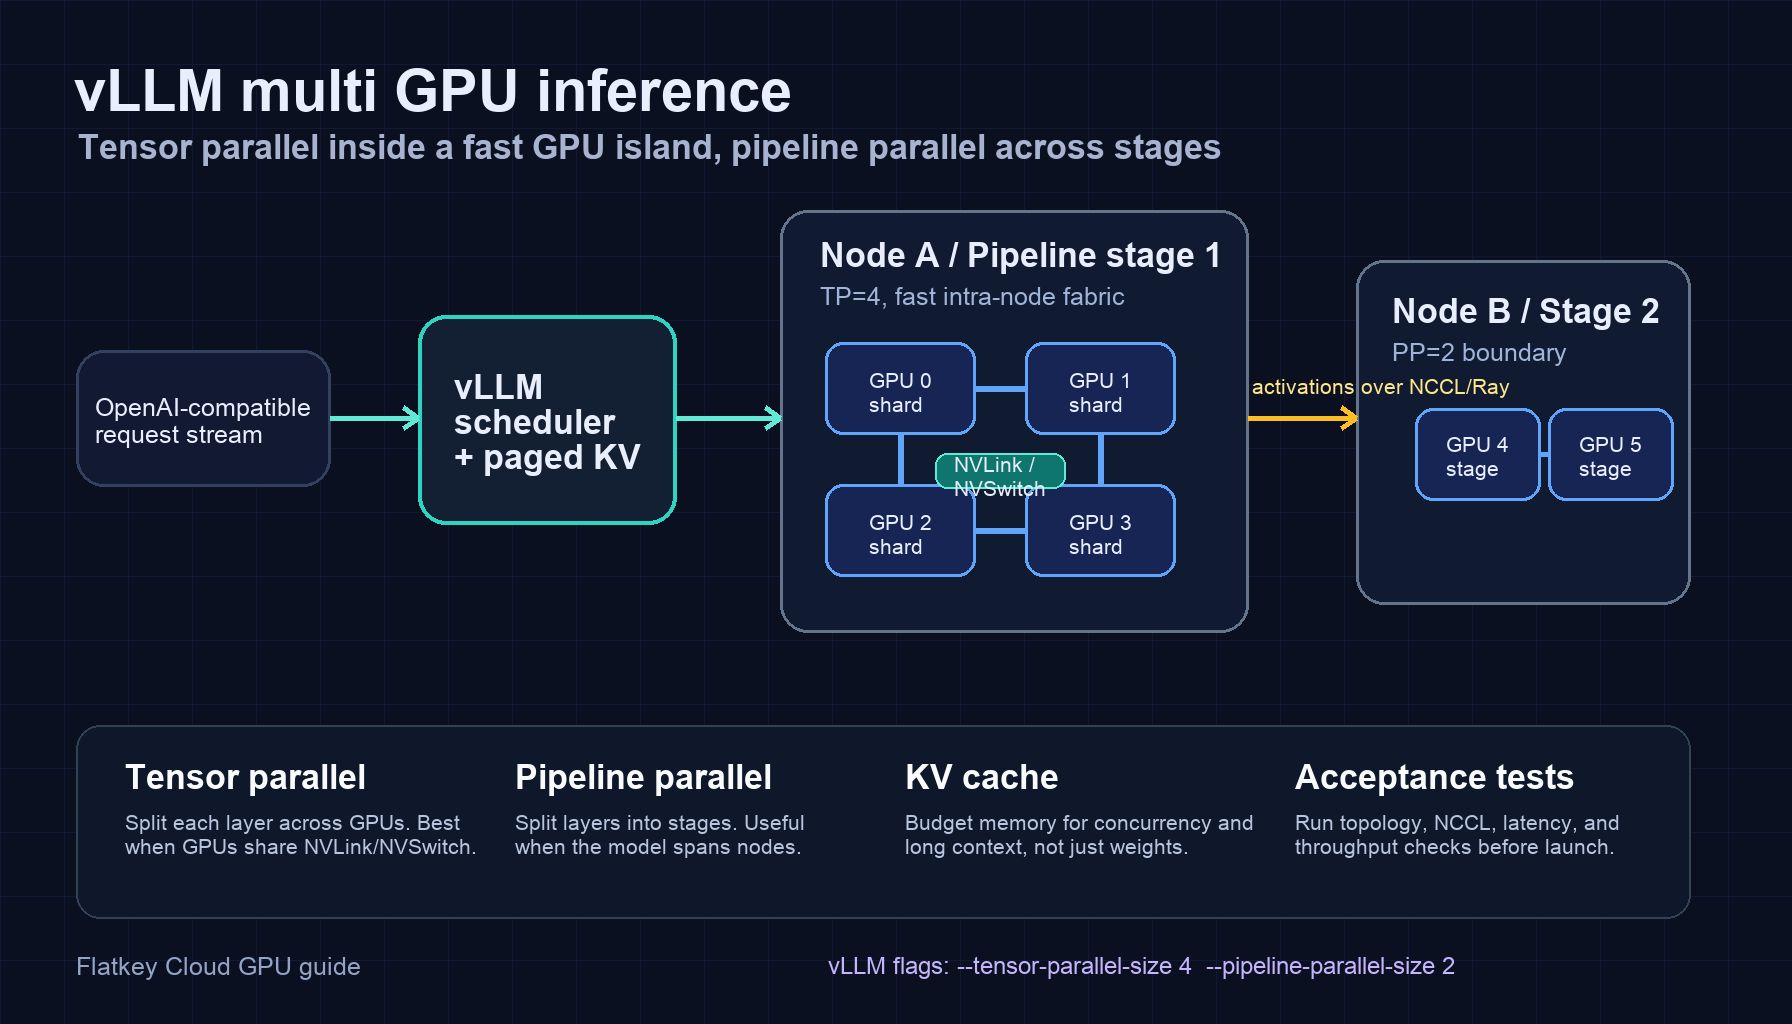
Ein einzelner GPU-Job achtet hauptsächlich auf VRAM, Speicherbandbreite und lokalen Speicher. Ein 8-GPU-Knoten achtet auf GPU-zu-GPU-Kommunikation. Ein Multi-Node-Job achtet auf das Netzwerk-Fabric.
Innerhalb des Knotens sollten Sie auf Folgendes achten:
- NVLink-Bandbreite pro GPU
- NVSwitch oder ein gleichwertiges All-to-All-Fabric
- Sichtbarkeit der GPU-Topologie
- NCCL-Leistung
- PCIe-Engpässe
- Lokales NVMe für Staging und Checkpoints
Über mehrere Knoten hinweg sollten Sie auf Folgendes achten:
- InfiniBand- oder Ethernet/RDMA-Design
- GPUDirect-RDMA-Unterstützung, wo relevant
- NCCL-Testergebnisse, nicht nur Herstellerangaben
- Garantien für Cluster-Platzierung
- Durchsatz des Checkpoint-Speichers
- Behandlung von Ausfällen und Preemption
AWS gibt an, dass P5-, P5e- und P5en-Instanzen bis zu 3.200 Gbps EFA-Netzwerk bereitstellen können und in EC2 UltraClusters eingesetzt werden. Microsoft beschreibt ND H100 v5 so, dass es mit acht H100-GPUs beginnt und mit 3,2 Tbps Interconnect-Bandbreite pro VM sowie 400 Gbps NVIDIA Quantum-2 CX7 InfiniBand pro GPU auf Tausende GPUs skaliert. Google Cloud listet in seiner Compute-Engine-GPU-Dokumentation GPU-Maschinenfamilien einschließlich A3, A3 Ultra, A4 und neuerer Blackwell-bezogener Familien auf.
Die Schlussfolgerung: Bei Multi-Node-Training wird „welche ist die beste GPU-Cloud für LLM-Training“ zu einer Frage der Cluster-Beschaffung. Fragen Sie nach NCCL-All-Reduce-Bandbreite, All-Gather-Bandbreite, Regeln für die Job-Platzierung, Speicher-Benchmark-Werten und der Reaktionszeit des Supports.
Budget: Vergleichen Sie die Kosten pro fertigem Checkpoint, nicht die GPU-Stunde
GPU-Stundenpreise sind leicht zu vergleichen und leicht falsch zu verwenden. Die richtige Budget-Einheit ist:
Kosten pro erfolgreichem Checkpoint =
  verbrauchte GPU-Stunden
  + Speicher- und Snapshot-Kosten
  + Kosten für Daten-Egress oder -Ingest
  + Orchestrierungs- und Observability-Kosten
  + vom Ingenieur aufgewendete Zeit zur Wiederherstellung fehlgeschlagener Läufe
  - Wert wiederverwendbarer Checkpoints und Evals
Verwenden Sie datierte Preisschnappschüsse, da sich öffentliche Preise ändern. Am 13. Oktober 2026 zeigten öffentliche GPU-Cloud-Preisseiten beispielsweise Runpod mit On-Demand-Tarifen für H100 PCIe, H100 SXM, H200, B200 und B300; Lambda mit H100- und B200-Instanz- und Cluster-Preisen; CoreWeave mit On-Demand-GPU-Preisen und mehreren High-End-NVIDIA-Optionen; Nebius mit einer NVIDIA-GPU-Preisseite; und Crusoe mit On-Demand-, Spot- und reservierten GPU-Preisoptionen. Betrachten Sie diese als Ausgangspunkte, nicht als dauerhafte Rangfolge.
| Budgetsituation | Besseres Kaufmuster |
|---|---|
| Einmaliges Adapter-Experiment | On-Demand-Einzel-GPU oder kleiner Pod |
| Wiederholte LoRA-Jobs | Reservierte, kostengünstigere GPUs, die in den Speicher passen |
| 70B Full-Fine-Tuning | Reservierte 8-GPU-Nodes mit Support und Checkpoint-Speicher |
| Fortlaufendes Multi-Node-Pretraining | Verbindlich zugesicherte Clusterkapazität mit strikter Platzierung und Netzwerkgarantien |
| Fehlertolerante Sweeps | Spot/Preemptible nur, wenn das Checkpointing nachgewiesen ist |
| Unklarer ROI | Model-API-Baseline über Flatkey, bevor GPUs gemietet werden |
Die besten GPU-Cloud-Anbieter für LLM-Training sind diejenigen, die Ihnen genügend nutzbare Kapazität mit der richtigen Topologie geben und nicht einfach die günstigste veröffentlichte Stundenzahl. Beim Training kann ein niedrigerer Stundenpreis nachteilig sein, wenn der Anbieter GPUs nicht gemeinsam platzieren kann, Speicher Checkpoints ausbremst oder der Support NCCL-Fehler nicht schnell beheben kann.
Eignung der Cloud-Anbieter: Wofür man welchen nutzt
| Anbietertyp | Gute Eignung | Käuferfragen |
|---|---|---|
| Hyperscaler wie AWS, Google Cloud und Azure | Enterprise-Beschaffung, verwaltete Sicherheit, großer Account-Support, regionale Compliance | Welche GPU-Familien sind in Ihrer Zielregion verfügbar? Können Sie einen vollständigen Cluster reservieren? Welche Nachweise zu Netzwerk- und Speicher-Benchmarks sind verfügbar? |
| GPU-Spezial-Clouds wie CoreWeave, Lambda, Crusoe, Nebius und ähnliche Anbieter | Schneller Zugriff auf H100/H200/B200-Kapazität, einfachere GPU-zentrierte Preisgestaltung, KI-fokussierter Support | Ist Kapazität tatsächlich jetzt verfügbar? Sind Nodes zusammen platziert? Wie lauten die Unterbrechungsrichtlinien? Sind die Support-Ingenieure mit NCCL, Slurm, Kubernetes, Ray und Trainings-Frameworks vertraut? |
| Marktplatz- und Pod-Anbieter wie Runpod | Experimente, Burst-Workloads, kleinere Teams, günstigerer Einzel-GPU-Zugang | Ist die Umgebung sicher genug für Ihre Daten? Ist das Netzwerk für Multi-Node-Training geeignet? Sind GPUs dediziert, Community oder Secure Cloud? |
| Modell-/API-Pfad über Flatkey | Wenn Sie Ergebnisse, Evals, Routing oder Produktions-App-Aufrufe benötigen, statt Checkpoint-Eigentum | Kann eine API-Baseline den Trainingslauf ersetzen? Welches Ziel bei Modellqualität und Kosten muss ein selbst trainiertes Modell schlagen? |
Für „was ist die beste GPU-Cloud für LLM-Training“ verwenden Sie eine zweistufige Antwort:
- Wählen Sie die Hardwareklasse, die zur Arbeitslast passt.
- Wählen Sie den Anbieter, der diese Hardware mit der richtigen Topologie, dem passenden Speicher, Support und den kommerziellen Bedingungen liefern kann.
Entscheidungsmatrix: Die beste GPU für LLM-Training auswählen
| Wenn Ihre Hauptbeschränkung ... ist | Bevorzugen Sie ... | Grund |
|---|---|---|
| Ein größeres Modell ohne extremes Sharding unterbringen | H200 oder B200 | Mehr HBM pro GPU kann den Job vereinfachen |
| Bewährtes Ökosystem und breite Verfügbarkeit | H100 SXM | Starke Software, breite Anbieterunterstützung, gute Trainings-Baseline |
| Niedrigste Kosten für Adapter-Tuning | A100, L40S, RTX-Karten oder rabattierte H100 PCIe | Adapter-Jobs benötigen oft keine Premium-Cluster-Topologie |
| Multi-Node-Skalierung | H100/H200/B200-Cluster mit validiertem RDMA/InfiniBand und NCCL-Ergebnissen | Das Netzwerk bestimmt die Skalierungseffizienz |
| Schnelles Experimentieren vor dem Commit | Flatkey-Model-API-Baseline plus kleine GPU-Läufe | Vermeidet das Reservieren von GPUs, bevor das Ziel validiert ist |
| Enterprise-Beschaffung | Hyperscaler oder vertraglich gebundene GPU-Cloud | Verpflichtungen, Compliance, Support und regionale Kontrollen sind wichtig |
Benchmark-Plan, bevor Sie sich verpflichten
Bevor Sie teure Kapazität reservieren, führen Sie diese Benchmark-Sequenz aus:
- Speicher-Fit-Test mit einer GPU: Laden Sie das Modell, den Tokenizer, den Dataset-Batch, den Optimizer und die Trainingsmethode.
- Microbatch-Sweep: Testen Sie Sequenzlänge, Gradient Accumulation, Activation Checkpointing und Mixed Precision.
- 8-GPU-Node-Test: Führen Sie NCCL-Tests und einen kurzen Trainingsschritt-Benchmark aus.
- Checkpoint-Test: Schreiben und stellen Sie Checkpoints unter echter Last wieder her.
- Multi-Node-Test: Messen Sie das All-Reduce-/All-Gather-Verhalten bei der geplanten Node-Anzahl.
- Fehlerübung: Beenden Sie einen Worker oder simulieren Sie Preemption und überprüfen Sie dann die Wiederherstellung.
- Kosten-pro-Checkpoint-Berechnung: Schätzen Sie die Kosten eines validierten Checkpoints, nicht einer ungenutzten GPU-Stunde.
Aufzeichnen:
- Tokens/Sek. oder Samples/Sek.
- MFU oder GPU-Auslastung
- Schrittzeit-Varianz
- NCCL-Bandbreite
- Zeit für das Schreiben und Wiederherstellen von Checkpoints
- Durchsatz des Data Loaders
- Wiederherstellungszeit nach einem fehlgeschlagenen Job
- Gesamtkosten bis zum erfolgreichen Checkpoint
Wenn ein Anbieter diesen Benchmark vor einer größeren Verpflichtung nicht unterstützen kann, sollte das als Beschaffungsrisiko betrachtet werden.
Häufige Fehler
Fehler 1: Die teuerste GPU kaufen, bevor der Speicherbedarf dimensioniert ist
Wenn LoRA auf einer günstigeren GPU passt, verbessert eine Premium-H200- oder B200-Kapazität möglicherweise nicht die entscheidende Kennzahl. Investieren Sie die Einsparungen lieber in mehr Experimente, bessere Evaluierungen oder sauberere Daten.
Fehler 2: H100 PCIe und H100 SXM zu vergleichen, als ob die Topologie keine Rolle spielte
Für Single-GPU-Läufe kann PCIe völlig ausreichen. Für Multi-GPU-Training kann die SXM-, NVLink- und NVSwitch-Topologie die Skalierungseffizienz verändern. Siehe den Leitfaden von Flatkey zu H100 SXM vs. PCIe für die Details.
Fehler 3: Speicher-Overhead ignorieren
Gewichte sind nur ein Teil des Trainingsspeichers. Optimizer-States, Gradienten, Aktivierungen und temporäre Puffer können dominieren. Verwenden Sie das Arbeitsblatt zu den LLM-GPU-Speicheranforderungen, bevor Sie eine GPU auswählen.
Fehler 4: Spot als kostenlose Ersparnis zu betrachten
Spot kann für checkpoint-intensive Sweeps funktionieren. Es ist jedoch riskant für lange vollständige Fine-Tunings ohne zuverlässiges Checkpointing und Automatisierung des Neustarts.
Fehler 5: Zu trainieren, wenn API-Routing ausreicht
Wenn Ihr Produkt zuverlässige Ausgaben benötigt und keine benutzerdefinierten Checkpoints, vergleichen Sie zuerst GPU-Miete mit einer Modell-API-Baseline. Flatkey ermöglicht Teams, einen einzigen OpenAI-kompatiblen Endpoint über viele Modelle hinweg zu nutzen, was schneller sein kann als der Betrieb eines eigenen Trainings-Stacks.
Quellen-Checkliste
Verwenden Sie diese Quellen, um die aktuellen Fakten vor dem Kauf zu verifizieren:
- NVIDIA H100 Tensor Core GPU
- NVIDIA H200 GPU
- NVIDIA DGX B200
- NVIDIA NCCL Kollektivoperationen
- DeepSpeed-ZeRO-Dokumentation
- AWS EC2 P5-Instanzen
- Google Cloud GPU-Maschinentypen
- Azure ND H100 v5-Serie
- CoreWeave Cloud-Preise
- Lambda GPU-Cloud-Preise
- Runpod-Preise
- Nebius GPU-Preise
- Crusoe Cloud-Preise
Häufig gestellte Fragen
Was ist die beste GPU für das LLM-Training?
Die beste GPU für das LLM-Training hängt von der Aufgabe ab. H100 SXM ist die sicherste Standardwahl für ernsthaftes Fine-Tuning, H200 ist besser, wenn mehr Speicherspielraum wichtig ist, B200 ist attraktiv für neue High-End-Cluster, und A100-/L40S-/RTX-Klasse-GPUs können die beste Budget-Wahl für Adapter-Tuning sein.
Welche GPU performt am besten für das LLM-Training?
Für großes vollständiges Fine-Tuning und Pretraining können Systeme der B200- und H200-Klasse ältere GPUs übertreffen, wenn der Software-Stack und der Cluster ausgereift sind. Für viele praktische Teams bleibt H100 das beste Verhältnis von Leistung und Risiko, weil Kapazität, Bibliotheken und Cloud-Support weithin verfügbar sind.
Welcher GPU-Cloud-Anbieter ist der beste für das LLM-Training?
Der beste GPU-Cloud-Anbieter für das LLM-Training ist derjenige, der die richtigen GPUs zusammen mit dem richtigen Netzwerk und Speicher bereitstellen kann. Hyperscaler passen zu Unternehmensbeschaffung und Compliance. GPU-spezialisierte Clouds passen oft besser, wenn ein schnellerer Zugriff auf H100/H200/B200-Kapazität benötigt wird. Pod-basierte Anbieter eignen sich für Experimente und kleinere Jobs.
Ist B200 immer besser als H100 für das LLM-Training?
Nein. B200 hat eine neuere Architektur und mehr Speicher in Systemen wie DGX B200, aber H100 kann weiterhin die bessere Wahl sein, wenn es günstiger, schneller verfügbar und bereits für Ihr Framework validiert ist.
Ist H200 besser als H100 für Fine-Tuning?
H200 ist besser, wenn der größere 141-GB-Speicherpool oder die höhere Speicherbandbreite Sharding-, Offload- oder Batchgrößen-Kompromisse reduziert. Wenn die Aufgabe bequem auf H100 passt, kann H100 eine bessere Budgeteffizienz liefern.
Kann ich ein LLM auf Consumer-GPUs trainieren?
Sie können kleine Modelle oder Adapter auf Consumer-GPUs feinabstimmen, insbesondere mit Quantisierung. Für langlebiges Produktions-Training sollten Sie ECC-Speicher, Treibersupport, Kühlung, Speicher und Fehlerwiederherstellung prüfen. Consumer-GPUs sind auf Cluster-Skalierung in der Regel nicht die beste GPU für das LLM-Training.
Sollte ich GPUs mieten oder eine Modell-API verwenden?
Mieten Sie GPUs, wenn Sie Checkpoint-Besitz, benutzerdefinierte Gewichte, proprietäre Trainingsdaten oder Offline-Kontrolle benötigen. Verwenden Sie eine Model-API, wenn das Ziel Produktausgabequalität, Routing, Evaluation oder Kostenkontrolle ist. Flatkey ist als API-Baseline nützlich, bevor Sie sich auf GPU-Training festlegen.
Fazit
Die beste GPU für das LLM-Training ist das kleinste zuverlässige System, das zu Ihrer Trainingsmethode passt und den Job planbar abschließt. Für die Planung 2026:
- Verwenden Sie H100 SXM als standardmäßige ernsthafte Trainings-Baseline.
- Wechseln Sie zu H200, wenn mehr Speicherspielraum die Komplexität reduziert.
- Ziehen Sie B200 für neue High-End-Cluster in Betracht, wenn Verfügbarkeit und Software-Reife stimmen.
- Verwenden Sie A100, L40S oder GPUs der RTX-Klasse für Budget-Adapter-Tuning und Experimente.
- Vergleichen Sie jeden Trainingsplan mit einer Flatkey-Model-API-Baseline, bevor Sie GPUs reservieren.
Dieser Ansatz beantwortet die eigentliche Kaufentscheidung: nicht „welche GPU sieht auf dem Papier am besten aus“, sondern „welches Setup erreicht einen erfolgreichen Checkpoint bei den niedrigsten risikoadjustierten Kosten?“