
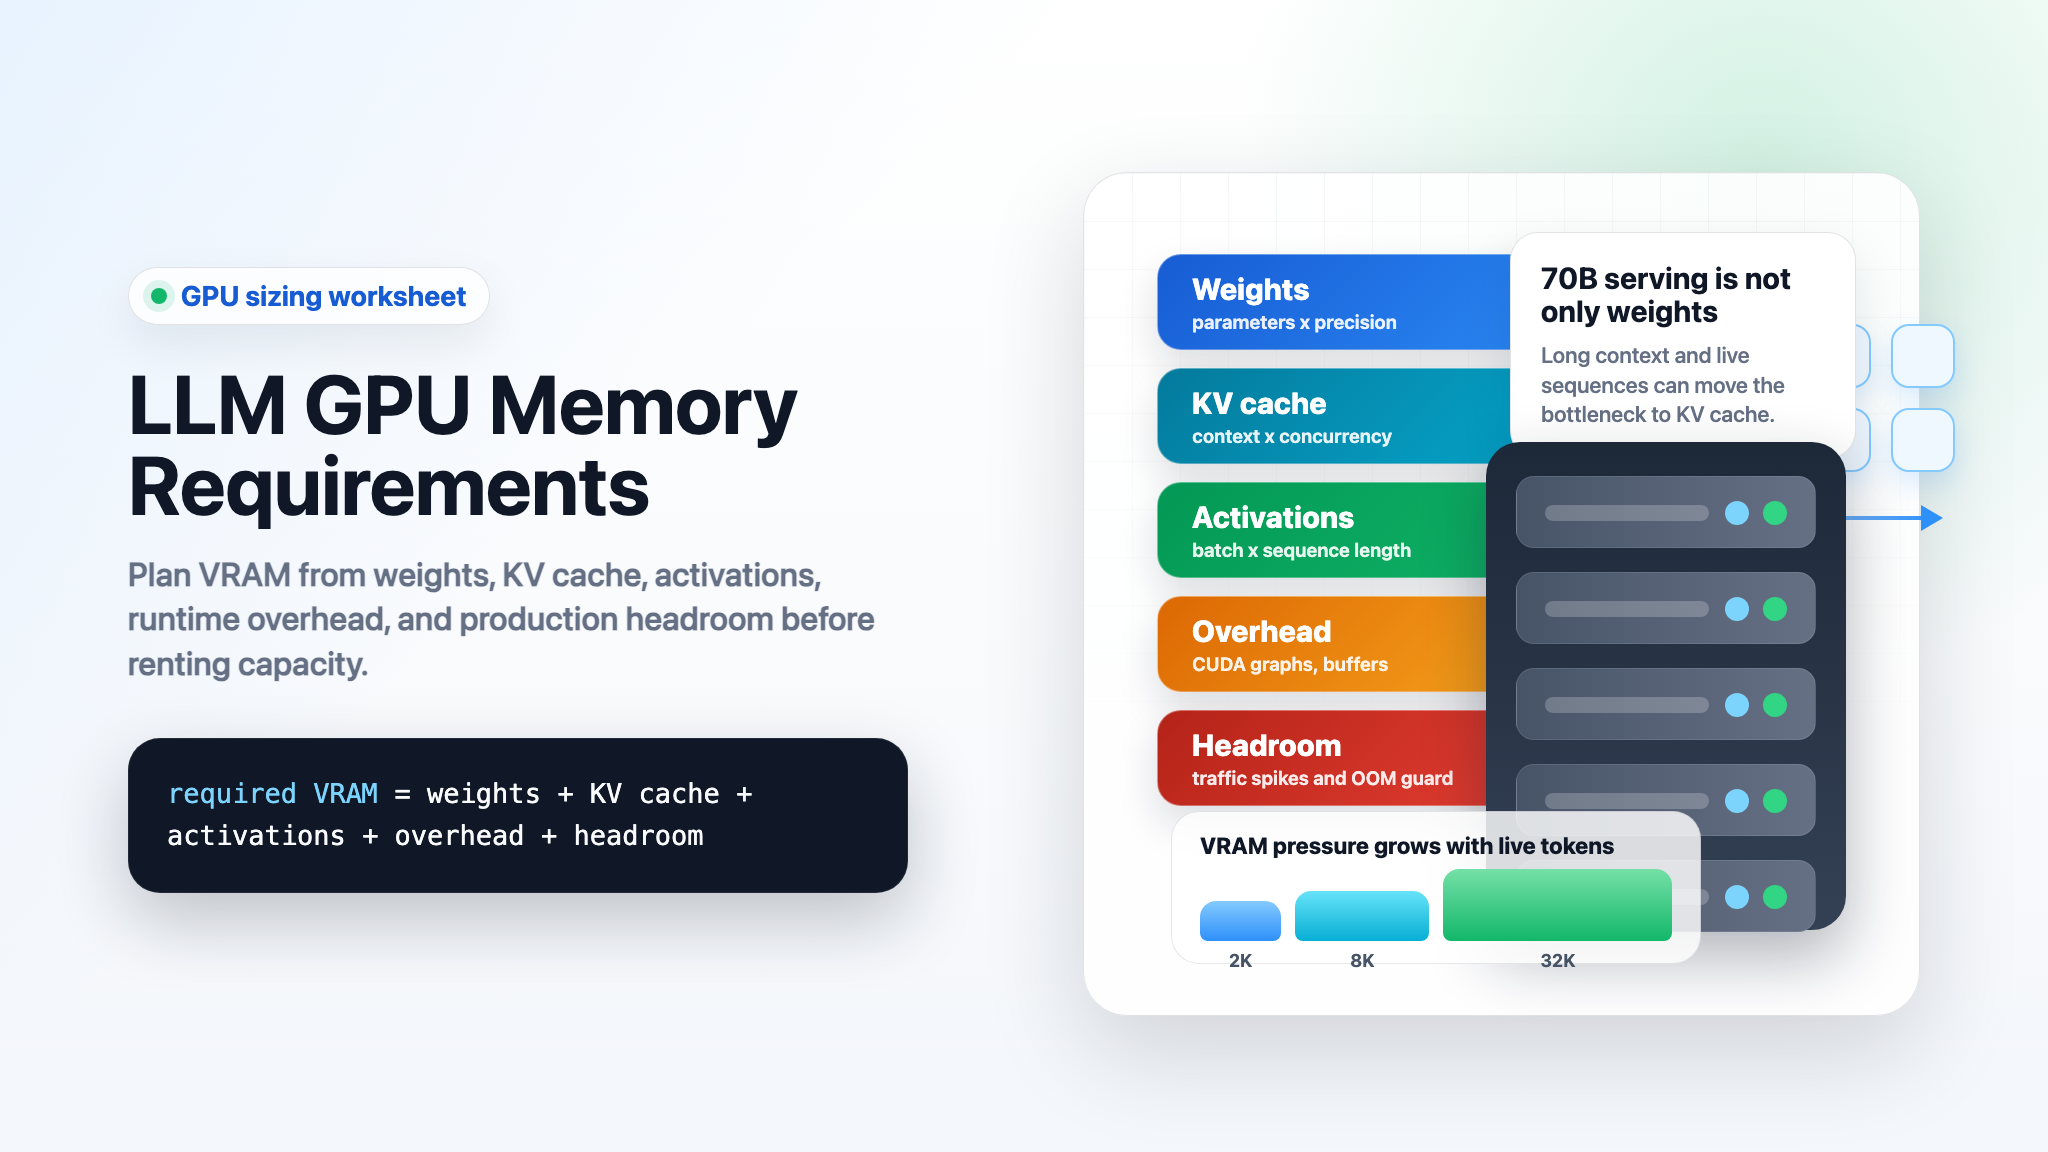
Die GPU-Speicheranforderungen für LLMs sind nicht einfach nur „Modellgröße plus ein wenig Spielraum“. Ein Serving- oder Training-Job hat mehrere getrennte Speicherblöcke: Modellgewichte, KV-Cache, Aktivierungen, Framework-Workspaces, CUDA Graphs, temporäre Puffer und operativen Pufferraum.
Die schnelle Planungsregel lautet:
erforderlicher VRAM =
  Modellgewichte
+ KV-Cache für aktive Tokens
+ Aktivierungs- und Workspace-Speicher
+ Trainingszustand, falls Training oder vollständiges Fine-Tuning
+ Allocator- und Sicherheits-Puffer
Deshalb können zwei Teams dasselbe 70B-Modell auf derselben GPU-Klasse betreiben und unterschiedliche Ergebnisse sehen. Das eine nutzt kurze Prompts, einen Stream, FP8-KV-Cache und konservatives Batching. Das andere verwendet langen Kontext, viele parallele Anfragen, CUDA-Graph-Capture und eine hohe Einstellung für gpu_memory_utilization. Der erste Job passt. Der zweite Job schlägt mit Out-of-Memory-Fehlern fehl oder verliert bei der Ausführung an Latenz, während Arbeit anderswo ausgelagert wird.
Dieser Leitfaden bietet ein praktisches Arbeitsblatt für llm gpu memory requirements für Inference, vLLM-Serving, Fine-Tuning und Training. Verwenden Sie es, bevor Sie eine GPU mieten, sich für H100 statt H200 statt B200-Kapazität entscheiden oder überlegen, ob eine Modell-API einfacher ist als der Betrieb eines eigenen GPU-Endpunkts.
Schnellantwort zu LLM-GPU-Speicheranforderungen
Für Inference beginnen Sie mit den Gewichten und dimensionieren dann den KV-Cache anhand von Kontextlänge und Parallelität. Beim Training sind Gewichte nur der Anfang; Optimizer-Zustände, Gradienten und gespeicherte Aktivierungen dominieren den Speicherplan.
| Workload | Was in der Regel den VRAM dominiert | Schnelle Planungsregel |
|---|---|---|
| Single-Request-Inference | Gewichte | parameters x bytes_per_weight, dann KV-Cache für Prompt und generierte Tokens hinzufügen. |
| High-Throughput-Inference | KV-Cache und Scheduler-Puffer | Nach concurrent sequences x tokens per sequence dimensionieren, nicht nur nach der Anzahl der Modellparameter. |
| Long-Context-Serving | KV-Cache | Eine Verdopplung der Kontextlänge verdoppelt ungefähr den KV-Cache-Speicher für dasselbe Modell und denselben Batch. |
| Full Fine-Tuning | Optimizer-Zustände, Gradienten, Aktivierungen | Mixed-Precision AdamW kann vor den Aktivierungen ein Vielfaches des Modellgewichts-Speichers erfordern. |
| LoRA- oder Adapter-Tuning | Basisgewichte plus Aktivierungen und Adapter-Zustand | Deutlich kleiner als Full Fine-Tuning, aber langer Kontext und Batch-Größe bleiben dennoch wichtig. |
| Pretraining | Trainingszustand plus Aktivierungen plus verteiltem Overhead | Planen Sie anhand eines gemessenen Framework-Laufs; Formeln sind nur der erste Schritt. |
Wenn Sie nur Modelloutputs benötigen, vergleichen Sie zunächst direktes GPU-Serving mit einer Model-API-Basislinie. Direkte GPUs sind sinnvoll, wenn Sie benutzerdefinierte Gewichte, Kontroll über die Platzierung, eine private Runtime-Policy oder eine Workload benötigen, die nach gemessener Auslastung günstiger ist. Wenn Sie vor allem zuverlässige API-Antworten brauchen, kann ein verwalteter Modellpfad Wochen an GPU-Dimensionierung, Warteschlangenmanagement und Betriebsaufwand vermeiden.
Arbeitsblatt fuer LLM-GPU-Speicheranforderungen
Verwenden Sie dieses Arbeitsblatt, bevor Sie eine Instanz auswählen.
| Bucket | Formel oder Prüfung | Hinweise |
|---|---|---|
| Weights | parameter_count x weight_bytes |
BF16/FP16 verwenden etwa 2 Bytes pro Parameter. INT8 verwendet etwa 1 Byte. 4-Bit verwendet etwa 0,5 Bytes vor den Quantisierungsmetadaten. |
| KV cache | active_tokens x layers x kv_heads x head_dim x 2 x kv_bytes |
Die 2 steht für Keys und Values. Grouped-Query-Attention reduziert kv_heads gegenüber voller Multi-Head-Attention. |
| Activations | Inference: meist moderat. Training: skaliert mit Batch, Sequenzlänge, Hidden Size, Layers und Checkpointing-Entscheidungen. | Die Modell-Speicheranatomie von Hugging Face nennt Gewichte, Optimizer-Zustände, Gradienten, gespeicherte Aktivierungen, temporäre Puffer und funktionsspezifischen Speicher für das Training. |
| Serving framework reserve | vLLM, TensorRT-LLM, SGLang, PyTorch, CUDA Graphs, Attention-Kernels, Scheduling-Queues | vLLM bietet Speichersteuerungen wie gpu_memory_utilization, kv_cache_memory_bytes, kv_cache_dtype, max_model_len und max_num_seqs. |
| Safety headroom | 10-20 % für die Produktion, mehr bei den ersten Benchmarks | Lassen Sie Raum für Allocator-Fragmentierung, Traffic-Spitzen, längere Prompts, Modell-Neuladevorgänge und Observability-Agenten. |
Der häufigste Fehler ist, die Gewichte unterzubringen und die aktiven Tokens zu vergessen. Für eine Schätzung der GPU-Speicheranforderungen für LLM-Inference kann der KV-Cache den Unterschied zwischen einem stabilen Endpunkt und einer OOM-Schleife ausmachen.
Schritt 1: Modellgewichts-Speicher berechnen
Gewichte sind der einfachste Teil der GPU-Speicheranforderungen für LLM-Workloads.
weight_memory_gib = parameters x bytes_per_parameter / 1024^3
| Model size | BF16 / FP16 weights | INT8 weights | 4-bit weights before metadata |
|---|---|---|---|
| 7B | ~13.0 GiB | ~6.5 GiB | ~3.3 GiB |
| 13B | ~24.2 GiB | ~12.1 GiB | ~6.1 GiB |
| 34B | ~63.3 GiB | ~31.7 GiB | ~15.8 GiB |
| 70B | ~130.4 GiB | ~65.2 GiB | ~32.6 GiB |
| 405B | ~754.4 GiB | ~377.2 GiB | ~188.6 GiB |
Diese Tabelle ist eine Untergrenze. Reale Deployments fügen Quantisierungs-Skalen, nicht-parametrische Puffer, Tokenizer-/Runtime-Zustand, temporäre Arbeitsbereiche und Serving-Overhead hinzu.
Für eine Schätzung des vLLM GPU memory requirements 70B model VRAM übersteigen die BF16/FP16-Gewichte allein bereits eine einzelne 80-GB-H100. Eine einzelne H200 hat laut NVIDIAs H200-Seite 141 GB HBM3e, sodass die Gewichte prinzipiell passen können, aber der verbleibende KV-Cache und der Runtime-Spielraum können trotzdem einen kleineren Kontext, geringere Parallelität, KV-Cache-Quantisierung oder Tensor Parallelism erzwingen. NVIDIA führt die H100 SXM mit 80 GB, die H200 mit 141 GB und die DGX B200 als acht Blackwell-GPUs mit insgesamt 1.440 GB HBM3e auf, was in diesem System effektiv 180 GB pro B200-GPU entspricht.
Schritt 2: KV-Cache-Speicher für LLM-GPU-Speicheranforderungen berechnen
Der KV-Cache ist der Speicher, der verwendet wird, um Attention-Keys und -Values für bereits verarbeitete Tokens zu speichern. Er ermöglicht es dem Modell, zu generieren, ohne das gesamte Präfix jedes Mal neu zu berechnen.
Für die Inferenz bei Decoder-only-Transformern:
kv_cache_bytes =
  active_tokens
x num_layers
x num_kv_heads
x head_dim
x 2
x bytes_per_kv_element
Wobei:
| Variable | Bedeutung |
|---|---|
active_tokens |
Summe der Prompt- und generierten Tokens, die aktuell über aktive Anfragen hinweg im Cache vorhanden sind. |
num_layers |
Anzahl der Transformer-Schichten. |
num_kv_heads |
KV-Heads, nicht immer Attention-Heads. Grouped-Query-Attention kann diesen Wert deutlich kleiner machen. |
head_dim |
Dimension pro Head. |
2 |
Key- und Value-Tensoren. |
bytes_per_kv_element |
2 für BF16/FP16, 1 für FP8, niedriger für unterstützte Cache-Modi mit geringerer Bit-Tiefe. |
Als Beispiel verwendet eine Llama-ähnliche 70B-Form mit 80 Schichten, 8 KV-Heads und 128 Head-Dimensionen:
80 x 8 x 128 x 2 x 2 bytes = 327,680 bytes per token
Das sind etwa 0,3125 MiB pro aktivem Token im BF16/FP16-KV-Cache.
| Aktiver Kontext pro Sequenz | Ungefährer KV-Cache für eine Sequenz | Ungefährer KV-Cache für 16 aktive Sequenzen |
|---|---|---|
| 2.048 Tokens | ~0,6 GiB | ~10,0 GiB |
| 4.096 Tokens | ~1,3 GiB | ~20,0 GiB |
| 8.192 Tokens | ~2,5 GiB | ~40,0 GiB |
| 16.384 Tokens | ~5,0 GiB | ~80,0 GiB |
| 32.768 Tokens | ~10,0 GiB | ~160,0 GiB |
Die exakte Zahl ändert sich je nach Modellarchitektur. Ein Modell mit mehr KV-Heads verwendet mehr KV-Speicher. Ein Modell mit Multi-Query- oder Grouped-Query-Attention kann deutlich weniger KV-Speicher verbrauchen als ein vollständiges Multi-Head-Attention-Design.
vLLM dokumentiert mehrere hier relevante Stellschrauben: --gpu-memory-utilization steuert den Anteil des GPU-Speichers, der vom Model-Executor genutzt wird, --kv-cache-memory-bytes kann den KV-Cache explizit dimensionieren, --kv-cache-dtype kann die Cache-Präzision auswählen, und der Leitfaden zur Speichereinsparung empfiehlt, max_model_len und max_num_seqs zu reduzieren, wenn der Speicher knapp ist. vLLM dokumentiert außerdem einen FP8-KV-Cache als Möglichkeit, den KV-Cache-Footprint zu reduzieren und längeren Kontext oder höheren Durchsatz zu unterstützen, wobei weiterhin eine Genauigkeitsvalidierung erforderlich ist.
Schritt 3: Aktivierungen und Runtime-Overhead hinzufügen
Bei der Inferenz ist der Aktivierungsspeicher normalerweise kleiner als Gewichte und KV-Cache, aber er ist nicht null. Prefill, CUDA Graphs, Attention-Kernels, temporäre Puffer, multimodale Prozessoren, speculative decoding und Batch-Scheduling können zusätzlichen Speicher reservieren.
Beim Training wird der Aktivierungsspeicher zu einem wesentlichen Faktor. Hugging Faces Modell-Speicheranatomie nennt als Trainingsspeicherbestandteile Modellgewichte, Optimizer-States, Gradienten, für die Gradientenberechnung gespeicherte Forward-Aktivierungen, temporäre Puffer und funktionsspezifischen Speicher. Außerdem wird darauf hingewiesen, dass der Aktivierungsspeicher von Sequenzlänge, Hidden Size und Batchgröße abhängt.
Eine nützliche Aufteilung für die Planung ist:
| Szenario | Haltung bei Aktivierungen und Overhead |
|---|---|
| Einfache Inferenz, Batch 1 | Mindestens 10 % Puffer nach Gewichten und KV-Cache lassen. |
| vLLM-Serving mit CUDA Graphs und Batching | Mit 15-20 % Puffer starten und dann gpu_memory_utilization, max_model_len und max_num_seqs feinjustieren. |
| Serving mit langem Kontext | Den KV-Cache als Hauptvariable behandeln und mehr Puffer für Prefill-Spitzen reservieren. |
| Fine-Tuning | Vor dem Hochskalieren einen kleinen Lauf mit der Ziel-Sequenzlänge messen; Aktivierungen können dominieren, sobald Batch und Kontext wachsen. |
| Multimodale Modelle | Cache des Prozessors und Speicher für Medieneingaben hinzufügen; der Leitfaden zur Speichereinsparung von vLLM weist auf Multimodal-Cache- und Eingabegrenzen-Steuerungen hin. |
Betreiben Sie Produktion nicht mit 99 % Speicherauslastung, nur weil eine Testanfrage passt. Dann bleibt kein Platz für längere Prompts, Hot Reloads, CUDA-Graph-Capture, Verhalten des Allokators oder einen Traffic-Mix, der sich vom Benchmark unterscheidet.
Schritt 4: Speicher für Training und Fine-Tuning abschätzen
Der Trainingsspeicher ist größer, weil die GPU mehr als nur die Gewichte des Forward-Passes vorhalten muss.
Für Full Fine-Tuning mit Mixed Precision und AdamW liefert Hugging Face's Memory Anatomy eine praktische Aufschlüsselung: Beim Mixed-Precision-Training können FP32- und FP16/BF16-Gewichtskopien, AdamW-Optimiererzustände, Gradienten, gespeicherte Aktivierungen, temporäre Puffer und funktionsspezifischer Speicher anfallen. Dieselbe Seite fasst ein typisches Mixed-Precision-AdamW-Setup als 18 Byte pro Modellparameter plus Aktivierungsspeicher zusammen.
Das bedeutet:
| Modellgröße | 18 Byte pro Parameter vor Aktivierungen |
|---|---|
| 7B | ~117 GiB |
| 13B | ~218 GiB |
| 34B | ~570 GiB |
| 70B | ~1,173 GiB |
Deshalb brauchen Anfragen zu gpu memory requirements LLM training eine andere Antwort als Inferenzanfragen. Ein 70B-Modell, das sich mit Tensor Parallelism und quantisiertem KV-Cache bereitstellen lässt, ist nicht automatisch praktikabel für Full Fine-Tuning auf einer kleinen Anzahl von GPUs.
Zu den Möglichkeiten zur Reduzierung des Trainingsspeichers gehören:
| Technik | Was sie reduziert | Kompromiss |
|---|---|---|
| LoRA / QLoRA | Trainierbare Parameter- und Optimizerspeicher | Nicht dasselbe wie Full Fine-Tuning; benötigt weiterhin Basismodellspeicher und Aktivierungen. |
| Activation Checkpointing | Gespeicherten Aktivierungsspeicher | Mehr Rekomputation und geringerer Trainingsthroughput. |
| ZeRO / FSDP / Tensor Parallelism | Pro-GPU-Optimierer-, Gradienten-, Parameter- oder Rechenspeicher | Mehr verteilte Komplexität und höhere Empfindlichkeit gegenüber Kommunikation. |
| Kürzere Sequenzlänge | Aktivierungs- und Attention-Speicher | Kann die Aufgabenqualität verringern, wenn der Workload langen Kontext benötigt. |
| Kleinerer Micro-Batch | Aktivierungsspeicher | Kann Gradient Accumulation erfordern, um die effektive Batch-Größe beizubehalten. |
Für Full Training führen Formeln zu einer ersten Cluster-Architektur. Sie ersetzen keinen gemessenen Framework-Run.
Schritt 5: LLM-GPU-Speicheranforderungen auf gängige GPU-Speichergrößen abbilden
Nutzen Sie die GPU-Speicherkapazität als Einschränkung, nicht als einziges Kaufkriterium. Speicherbandbreite, NVLink-Topologie, Netzwerk, Storage, Scheduling und Auslastung können ebenso wichtig sein wie der reine VRAM.
| GPU-Klasse | Öffentlicher Speicheranker | Was das typischerweise für LLM-GPU-Speicheranforderungen bedeutet |
|---|---|---|
| H100 SXM | 80 GB HBM3 | Starke Standardwahl für 7B-34B-Serving und viele Fine-Tuning-Jobs. 70B BF16 erfordert in der Regel Tensor Parallelism oder Quantisierung. |
| H100 NVL | 94 GB pro GPU, 188 GB Paar in NVIDIA's H100-Seite | Für größere LLM-Inferenz in strombegrenzten Enterprise-Racks ausgelegt; Topologie und Provider-SKU dennoch validieren. |
| H200 | 141 GB HBM3e | Deutlich komfortabler für große Modellgewichte und längeren Kontext als H100, aber 70B-Serving mit hoher Parallelität kann dennoch durch den KV-Cache begrenzt sein. |
| B200 in DGX B200 | 1.440 GB insgesamt über 8 GPUs | Großer Speicherpool für Enterprise-Trainings- und Inferenzsysteme, mit operativen Anforderungen, die über eine einzelne GPU-Spezifikation hinausgehen. |
Wenn Ihr Arbeitsblatt sagt, dass eine einzelne H200 ein 70B-Modell „gerade so“ unterbringt, ist das kein Deployment-Plan. Es ist ein Signal, diese Einstellungen zu benchmarken:
| Einstellung | Warum sie wichtig ist |
|---|---|
max_model_len |
Setzt eine Obergrenze für den Kontext und damit für den KV-Cache. |
max_num_seqs |
Setzt eine Obergrenze für parallele Sequenzen und Scheduler-Druck. |
kv_cache_dtype |
Kann den KV-Cache-Speicher reduzieren, erfordert aber Qualitätsprüfungen. |
| Tensor-Parallel-Größe | Teilt die Modellarbeit über GPUs auf; verändert auch die Kommunikationsanforderungen. |
| Quantisierungsformat | Verkleinert Gewichte und manchmal den KV-Cache; kann Qualität und Kernel-Support beeinflussen. |
| Ziel-p95-Latenz | Höhere Throughput-Einstellungen können die Latenz verschlechtern, selbst wenn der Speicher passt. |
Für Details zur Hardwareauswahl verwenden Sie dieses Arbeitsblatt zusammen mit Flatkeys Leitfäden beste GPU für LLM-Inferenz, H200 vs H100 und B200 vs H200.
Beispiel: Größenplanung für 70B-Inferenz in vLLM
Hier ist eine konservative Methode, um vor dem Mieten von Kapazität über vllm gpu memory requirements 70b model vram nachzudenken.
Annahme:
| Eingabe | Wert |
|---|---|
| Modellgewichte | 70B Parameter |
| Gewichtspräzision | BF16 / FP16 |
| Gewichtsspeicher | ~130,4 GiB |
| KV-Cache-Form | 80 Layer, 8 KV-Heads, 128 Head-Dimension |
| KV-Präzision | BF16 / FP16 |
| KV pro aktivem Token | ~0,3125 MiB |
Vergleichen Sie dann einige Bereitstellungsformen:
| Serving-Ziel | Ca. KV-Cache | Warum das wichtig ist |
|---|---|---|
| 1 Live-Sequenz, 4K Tokens | ~1,3 GiB | Gewichte dominieren. Eine einzelne GPU mit großem Speicher passt möglicherweise nur mit wenig Puffer. |
| 8 Live-Sequenzen, 4K Tokens | ~10,0 GiB | Erfordert echten Puffer über die Gewichte hinaus. |
| 16 Live-Sequenzen, 8K Tokens | ~40,0 GiB | Ein Single-GPU-Plan ist in der Regel fragil, sofern Gewichte oder KV-Cache nicht quantisiert sind. |
| 16 Live-Sequenzen, 16K Tokens | ~80,0 GiB | Der KV-Cache allein entspricht ungefähr einem H100-SXM an Speicher. |
In der Praxis fällt ein 70B-vLLM-Plan meist in einen dieser Wege:
| Pfad | Passend für |
|---|---|
| BF16-Gewichte, geringe Parallelität, kürzerer Kontext | Speicher der H200-Klasse kann nach Prüfung des Overheads funktionieren. |
| BF16-Gewichte, Produktionsparallelität | Tensor Parallelism verwenden und Netzwerk/Topologie verifizieren. |
| Quantisierte Gewichte, BF16/FP16-KV-Cache | Guter erster Benchmark, wenn die Qualität eine Gewichtsquantisierung zulässt. |
| Quantisierte Gewichte plus FP8-KV-Cache | Kann längeren Kontext oder mehr Parallelität freischalten, erfordert aber Validierung von Genauigkeit und Latenz. |
| Keine Anforderung an Hardware-Kontrolle | Vor einer GPU-Investition einen Modell-API-Pfad vergleichen. |
Das ist die praktische Antwort auf gpu memory requirements for LLM-Serving: Die Parameterzahl sagt dir, ob das Modell geladen werden kann; KV-Cache und Laufzeit-Reserve sagen dir, ob es nennenswerten Traffic bedienen kann.
Warum die Kontextlänge die Antwort verändert
Langer Kontext ist teuer, weil der Cache mit den live Tokens wächst. Wenn du den Kontext von 8K auf 16K verdoppelst, verdoppelt sich der KV-Cache für dasselbe Modell, dieselbe Präzision und dieselbe Parallelität ungefähr. Wenn du die Parallelität bei gleichem Kontext verdoppelst, verdoppelt sich der KV-Cache ungefähr erneut.
Für Teams, die llm hardware requirements gpu memory-Pläne vergleichen, ergibt sich daraus ein einfaches Dimensionierungsmuster:
mehr Nutzer x längere Prompts x mehr Ausgabe-Tokens = mehr KV-Cache
Bevor du eine größere GPU mietest, frage dich, ob das Produkt wirklich für jede Anfrage den maximalen Kontext braucht. Viele Systeme können routen:
| Anfragetyp | Speichersparende Policy |
|---|---|
| Kurzer Chat oder Extraktion | Kleineres Kontextlimit, höhere Parallelität. |
| Lange Dokumentenanalyse | Größeres Kontextlimit, kleinerer Parallelitätspool. |
| Batch-Jobs | Nach Token-Budget in die Warteschlange stellen, nicht nur nach Anzahl der Anfragen. |
| Premium-Workloads | Dedizierter Pool mit explizitem maximalem Kontext und p95-Ziel. |
Das ist oft günstiger und stabiler als ein einzelnes riesiges Endpoint mit einer globalen Speichereinstellung zu betreiben.
Was im ersten Benchmark gemessen werden sollte
Führe einen Benchmark aus, der sich wie Produktionsverkehr verhält, nicht wie ein einzelner Happy-Path-Prompt.
| Metrik | Warum sie in den ersten Benchmark gehört |
|---|---|
| Maximal zugewiesener und reservierter VRAM | Erfasst den Puffer des Allokators und des Frameworks, nicht nur die Tensor-Mathematik. |
| Prefill-Latenz | Lange Prompts belasten Speicherbandbreite und Attention-Kerne. |
| Decode-Tokens pro Sekunde | Zeigt den Durchsatz der Generierung im stationären Betrieb. |
| p95- und p99-Latenz | Verhindert, dass eine nur auf Durchsatz optimierte Konfiguration Nutzer beeinträchtigt. |
| OOM-Rate | Verfolgt Speicherfehler unter realem Traffic-Mix. |
| KV-Cache-Nutzung | Zeigt, ob Kontext/Parallelität oder Gewichte der Engpass sind. |
| Kosten pro akzeptierter Ausgabe | Verknüpft die GPU-Mietkosten mit nutzbaren Abschlüssen statt mit Roh-Tokens. |
Für Multi-Node-Deployments kombiniere dies mit den Checklisten für GPU-Cluster-Architektur und GPU-Cluster-TCO. Ein Modell, das in den Speicher passt, kann dennoch teuer sein, wenn Networking, Storage, Queueing oder Auslastung schlecht sind.
Häufige Fehler
| Fehler | Besserer Ansatz |
|---|---|
| Nur anhand der Parameterzahl dimensionieren | KV-Cache, Aktivierungen, Framework-Reserve und Puffer hinzufügen. |
| „Passt einmal“ als produktionsreif betrachten | Zielformat für Kontext, Parallelität, Ausgabelänge und Retry-Verhalten testen. |
| KV-Cache-Präzision ignorieren | FP8 oder andere Cache-Formate validieren, wenn Speicher der Engpass ist. |
| Den GPU-Namen des Anbieters ohne exakte SKU verwenden | Speicherkapazität, Interconnect, MIG-Richtlinie, Treiber-Stack und gemeinsame Nutzung der GPUs bestätigen. |
| Annehmen, dass Trainingsspeicher dem Inferenzspeicher entspricht | Training fügt Optimizer-States, Gradienten, gespeicherte Aktivierungen und verteilten Overhead hinzu. |
gpu_memory_utilization zu aggressiv einstellen |
Genügend Reserve für CUDA Graphs, Puffer, Traffic-Spitzen und das Verhalten des Allokators lassen. |
Entscheidungsleitfaden: GPUs mieten oder eine Modell-API nutzen?
Direkte GPU-Kapazität ist der richtige Weg, wenn du eines oder mehrere davon brauchst:
| Wählen Sie direkte GPUs, wenn... | Wählen Sie eine Modell-API-Basislinie, wenn... |
|---|---|
| Sie benutzerdefinierte Gewichte oder private Fine-Tunes bereitstellen. | Sie gängige gehostete Modelle verwenden und vor allem zuverlässige Ausgaben benötigen. |
| Sie Platzierung, Isolierung oder Laufzeitkontrolle benötigen. | Sie keine Queues, Autoscaling, Images, Treiber und GPU-Ausfälle betreiben möchten. |
| Ihre gemessene Auslastung hoch genug ist, um API-Ökonomie zu schlagen. | Der Traffic spiky, früh oder schwer vorherzusagen ist. |
| Sie Benchmarking und Incident Response selbst verantworten können. | Ihr Team seine Entwicklungszeit lieber in Produktlogik investiert. |
Flatkey ist als Basisweg nützlich, wenn Hardwarekontrolle nicht die Produktanforderung ist. Es gibt Teams eine einheitliche Basis über offizielle Modelle und Tools hinweg, sodass Sie GPU-Miete und Modell-API-Ausgabekosten vergleichen können, bevor Sie sich für einen langfristig laufenden Cluster entscheiden. Wenn der Benchmark zeigt, dass direkte GPUs gewinnen, verwenden Sie das Speicher-Arbeitsblatt oben, um die kleinste zuverlässige Konfiguration zu mieten, statt der größten beeindruckenden.
Häufig gestellte Fragen
Wie viel GPU-Speicher benötigt ein 70B-LLM?
BF16- oder FP16-Gewichte für ein 70B-Modell benötigen etwa 130 GiB vor KV-Cache und Laufzeit-Overhead. INT8-Gewichte liegen bei etwa 65 GiB vor Metadaten. 4-Bit-Gewichte liegen bei etwa 33 GiB vor Quantisierungsmetadaten. Für Produktionsinferenz fügen Sie KV-Cache für Kontext und Parallelität, Reserven des Serving-Frameworks und Sicherheits-Headroom hinzu.
Warum lädt ein Modell, scheitert aber unter Traffic?
Der Ladetest passt möglicherweise nur für die Gewichte. Echter Traffic fügt KV-Cache für aktive Prompts und generierte Tokens, Batching-Overhead, temporäre Puffer und Framework-Reserven hinzu. Längere Prompts und mehr gleichzeitige Sequenzen können dasselbe Modell in einen OOM treiben.
Was beeinflusst die GPU-Speicheranforderungen für LLM-Inferenz am meisten?
Die größten Variablen sind Modellgröße, Gewichtspräzision, Kontextlänge, gleichzeitige Sequenzen, KV-Cache-Präzision und die Einstellungen des Serving-Frameworks. Bei Long-Context-Serving wird oft der KV-Cache zum Engpass.
Was beeinflusst die GPU-Speicheranforderungen für LLM-Hardware beim Training?
Training fügt Optimizer-Zustände, Gradienten, gespeicherte Aktivierungen, temporäre Puffer und Overhead des verteilten Frameworks hinzu. Batch-Größe, Sequenzlänge, Activation Checkpointing, Wahl des Optimizers und Sharding-Strategie können die GPU-Anzahl dramatisch verändern.
Reduziert vLLM die GPU-Speicheranforderungen?
vLLM bietet nützliche Speichersteuerungen und effizientes KV-Cache-Management, entfernt aber nicht das zugrunde liegende Speicherbudget. Sie benötigen weiterhin genügend VRAM für Gewichte, KV-Cache, Aktivierungen, Laufzeit-Reserve und Headroom. Die Speichersteuerungen helfen Ihnen, den Kompromiss zwischen Kontextlänge, Parallelität, Präzision und Durchsatz zu wählen.
Kann ein FP8-KV-Cache den Speicherdruck bei langem Kontext lösen?
Er kann den KV-Cache-Footprint reduzieren, und vLLM dokumentiert FP8-KV-Cache-Unterstützung. Behandeln Sie ihn als Benchmark-Einstellung, nicht als freien Schalter: Validieren Sie Ausgabegüte, Latenz, unterstützte Hardware-/Software-Pfade und das Fehlverhalten, bevor Sie ihn in der Produktion einsetzen.
Abschließende Checkliste
Bevor Sie Kapazität mieten, beantworten Sie diese Fragen:
- Welche Modellgröße und Gewichtspräzision stellen Sie bereit?
- Wie lang ist die maximale Kontextlänge, die Nutzer tatsächlich senden können?
- Wie viele gleichzeitige Sequenzen müssen bei p95-Last hineinpassen?
- Welche Ausgabelänge reservieren Sie für die Generierung?
- Ist der KV-Cache BF16/FP16, FP8 oder ein anderes unterstütztes Format?
- Welcher Headroom bleibt nach Gewichten und KV-Cache?
- Verwenden Sie Tensor Parallelism, Quantisierung, LoRA, FSDP oder ZeRO?
- Welche genaue GPU-SKU, Speicherkapazität und Topologie wird der Anbieter zuweisen?
- Welche OOM-, Latenz- und Kosten-pro-akzeptierter-Ausgabe-Schwellen definieren den Erfolg?
- Wenn Sie keine Hardwarekontrolle benötigen, was kostet dann die Modell-API-Basislinie?
Die beste Schätzung für llm gpu memory requirements ist diejenige, die einen produktionsnahen Benchmark übersteht. Verwenden Sie das Arbeitsblatt, um unmögliche GPU-Konfigurationen schnell auszuschließen, und validieren Sie dann die engere Auswahl mit echten Kontextlängen, echter Parallelität und genügend Headroom, um online zu bleiben.
Quellen
- vLLM Engine-Argumente:
gpu_memory_utilization,kv_cache_memory_bytes,kv_cache_dtypeund zugehörige Cache-Steuerungen: https://docs.vllm.ai/en/latest/configuration/engine_args.html - vLLM-Leitfaden zum Speichersparen: Tensor Parallelism, Quantisierung, Kontextlänge, Batch-Größe, CUDA-Graph-Speicher und Multimodal-Speichersteuerungen: https://docs.vllm.ai/en/latest/configuration/conserving_memory/
- vLLM-Leitfaden für quantisierten KV-Cache: FP8-KV-Cache-Optionen und Kompromisse: https://docs.vllm.ai/en/latest/features/quantization/quantized_kvcache.html
- Hugging Face Transformers Modell-Speicheranatomie: Trainings-Speicherblöcke, Optimizer-Zustände, Gradienten, Aktivierungen und Hinweise zum Mixed-Precision-Speicher: https://huggingface.co/docs/transformers/v4.57.1/en/model_memory_anatomy
- NVIDIA H100 Produktseite: H100-Speicher, Bandbreite, H100 NVL und LLM-Positionierung: https://www.nvidia.com/en-us/data-center/h100/
- NVIDIA H200 Produktseite: 141 GB HBM3e und Speicherbandbreite: https://www.nvidia.com/en-us/data-center/h200/
- NVIDIA DGX B200 Produktseite: acht B200-GPUs und 1.440 GB gesamtes HBM3e: https://www.nvidia.com/en-us/data-center/dgx-b200/


