
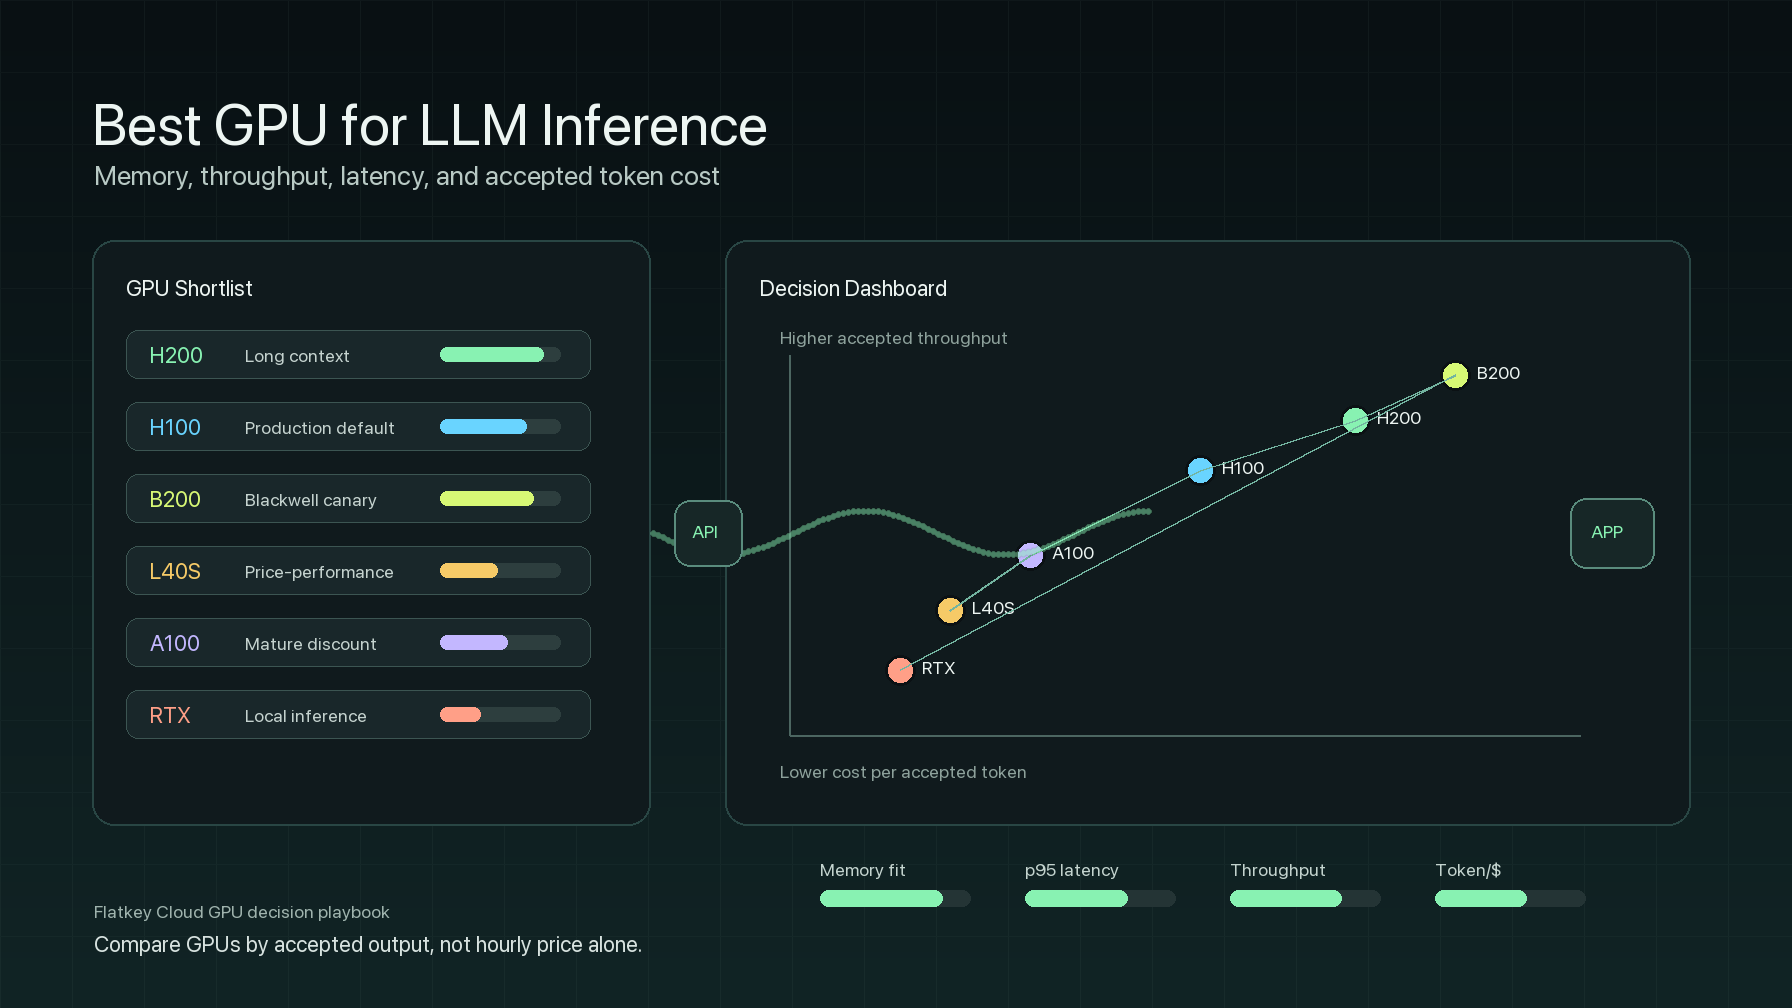
Die beste GPU für LLM-Inferenz ist die GPU, die Ihren tatsächlichen Prompt-Mix zu den niedrigsten akzeptierten Kosten erfüllt und dabei die Anforderungen an Speicher, Latenz und Zuverlässigkeit einhält. Es ist nicht immer die neueste GPU, das günstigste Stundenangebot oder die Karte mit dem höchsten Benchmark-Ergebnis.
Für die meisten Enterprise-KI-Teams lautet die Kurzantwort:
- Wählen Sie H200, wenn Speicher der Engpass ist: 70B-Klasse-Serving, langes Kontext-RAG, hohe Parallelität oder ein KV-Cache, der die H100 zu nah an die Grenze treibt.
- Wählen Sie H100, wenn Sie einen ausgereiften Produktionsstandard mit starkem Software-Support, breiter Cloud-Verfügbarkeit und gutem Durchsatz benötigen, ohne auf die neue Blackwell-Kapazität umzusteigen.
- Wählen Sie B200, GB200 oder neuere Blackwell-Systeme, wenn Ihr Stack die Präzision und Topologie der Blackwell-Ära nutzen kann und der Anbieter echte Verfügbarkeit, Preis und operativen Support nachweisen kann.
- Wählen Sie L40S oder A100, wenn das Preis-Leistungs-Verhältnis wichtiger ist als die Spitzenlatenz, das Modell problemlos passt und Ihre Workload batchorientiert, intern oder mit moderatem Kontext ist.
- Wählen Sie RTX 4090, RTX 5090 oder Workstation-GPUs für lokale LLM-Inferenz, Entwicklung, Demos und kleine private Workloads, nicht für Multi-Tenant-Enterprise-Serving.
- Nutzen Sie eine Modell-API oder einen Router statt GPUs zu mieten, wenn der Traffic in Wellen auftritt, die Modellauswahl sich häufig ändert oder der Betrieb des Serving-Stacks nicht Ihre Kernkompetenz ist.
Dieser Leitfaden erklärt, wie Sie die beste GPU für LLM-Inferenz nach Speicher, Durchsatz, Latenz und Kosten pro Token auswählen. Er enthält außerdem eine Entscheidungs-Matrix, einen Benchmark-Plan und eine Tokens-pro-Dollar-Tabelle, die Sie vor dem Mieten oder Kaufen von Kapazität wiederverwenden können.
Beste GPU für LLM-Inferenz: schnelle Entscheidungsmatrix
| Workload | Beste GPU für den Einstieg | Warum sie sich meist eignet | Worauf Sie achten sollten |
|---|---|---|---|
| Chat 7B-13B, interne Tools, Prototypen | L40S, RTX 4090, RTX 5090, A100 40GB oder Cloud-Kapazität der L4-Klasse | Ein niedrigerer Stundenpreis kann wichtiger sein als die Spitzenleistung des Accelerators, wenn das Modell klein und die Parallelität moderat ist. | Extrapolieren Sie nicht die Latenz einer lokalen Demo auf Produktionsverkehr p95/p99. |
| 30B-34B-Inferenz | L40S, A100 80GB, H100 PCIe/SXM | Genug Speicher für praktische Serving-Setups, bei niedrigeren Grundkosten als H200 oder B200. | Langer Kontext und hohe Parallelität können die Workload in das H100/H200-Territorium verschieben. |
| 70B-Klasse-Inferenz | H100, H200 oder A100/H100 mit mehreren GPUs | Die H100 ist der ausgereifte Standard; die H200 ist attraktiv, wenn Speicher und KV-Cache-Druck die benötigte GPU-Anzahl reduzieren. | Quantisierung, Tensor-Parallelität und Batch-Politik bestimmen die realen Kosten. |
| RAG mit langem Kontext | zuerst H200, dann H100 NVL/SXM oder B200, falls verfügbar | KV-Cache und Prompt-Prefill können Kapazität und Speicherbandbreite wichtiger machen als den reinen Stundenpreis. | Benchmarken Sie mit realistischen Kontextlängen, nicht nur mit kurzen Prompts. |
| Batch-Inferenz mit hohem Durchsatz | A100, L40S, H100 oder H100 Spot/Marketplace | Durchsatz pro Dollar übertrifft oft die niedrigste Latenz, wenn Jobs warten können. | Berücksichtigen Sie Retries, Unterbrechungen, Cold Starts und Speicherkosten. |
| Latenzsensitives Kunden-Chatten | H100, H200 oder B200, abhängig von der Modellgröße | Neuere Data-Center-GPUs bieten besseren Support für den Serving-Stack, mehr Bandbreite und mehr Spielraum für Parallelität. | p95- und p99-Latenz sind wichtiger als der Durchschnitt der Tokens/s. |
| Lokale LLM-Inferenz | RTX 4090, RTX 5090, RTX PRO Workstation-Karten / RTX-6000-Klasse | Lokale Karten sind nützlich für private Entwicklung, Offline-Tests und kleine Modelle. | Verbraucherkarten ersetzen nicht die verwaltete Zuverlässigkeit eines Multi-Tenant-Setups. |
| Regulierte oder Enterprise-Produktion | H100/H200/B200 bei einem Anbieter mit Support, Netzwerk, Isolation und Audit-Kontrollen | Die Betriebsschicht kann wichtiger sein als der GPU-Name. | Prüfen Sie SLA, Austauschpolitik, Netzwerk, Speicher und Observability. |
Die Faustregel: Die beste GPU für LLM-Inferenz ändert sich, wenn sich Modellgröße, Kontextlänge, Parallelität, Präzision, Serving-Framework und Preis ändern. Lassen Sie die GPU sich die Workload verdienen.
Warum Speicher oft die erste Shortlist bestimmt
LLM-Inferenz nutzt GPU-Speicher für mehr als nur die Modellgewichte. Ein Produktionsserver benötigt außerdem KV-Cache, Runtime-Overhead, Batching-Puffer, Adapter, Overhead für Tokenizer/Server und manchmal speculative decoding oder Puffer für strukturierte Ausgaben.
Verwenden Sie dieses einfache Speichermodell:
required_vram =
  model_weights
  + KV_cache_for_target_context_and_concurrency
  + runtime_overhead
  + safety_margin
Der KV-Cache ist der Grund, warum ein Modell, das in eine kurze Demo passt, in der Produktion scheitern kann. Lange Prompts, größere Batches, mehr gleichzeitige Anfragen und größere Ausgabegrenzen erhöhen den Speicherdruck. Die beste GPU für LLM-Inferenz nach Preis-Leistung ist oft die GPU, die einen zusätzlichen Shard vermeidet, einen erneuten Versuch nach einem Speichermangel verhindert oder es ermöglicht, einen größeren Batch beizubehalten, ohne die p95-Latenz zu beeinträchtigen.
Die Speicherkapazität verändert auch den Betrieb:
| Speicherzustand | Was das für das LLM-Serving bedeutet |
|---|---|
| Genügend Reserve | Sie können Batchgröße, Kontextlänge und Parallelität ohne unmittelbares OOM-Risiko anpassen. |
| Nahe am Limit | Quantisierung, kleinere Batches, kürzerer Kontext oder Tensor-Parallelismus werden zwingend erforderlich. |
| Über dem Limit | Sie brauchen mehr GPUs, eine GPU mit mehr Speicher, ein kleineres Modell, geringere Genauigkeit oder einen Weg über eine API. |
NVIDIA führt den H200 mit 141GB HBM3e-Speicher und 4.8TB/s Speicherbandbreite auf. Die NVIDIA-Seiten zum H100 positionieren den H100 als die ausgereifte Hopper-Basis, während die AWS-P5-Seiten H100- und H200-Instanzfamilien mit bis zu 8 GPUs pro Knoten und NVSwitch GPU-zu-GPU-Bandbreite zeigen. Für die Kaufentscheidung ist nicht eine einzelne Spezifikationszeile entscheidend. Entscheidend ist, ob zusätzlicher Speicher die Anzahl der GPUs reduziert, Sharding vereinfacht oder den akzeptierten Durchsatz verbessert.
Durchsatz: Tokens pro Sekunde reichen nicht aus
Rohe Tokens/Sekunde sind nützlich, aber nicht die Kennzahl des Käufers. Für einen Produktionsdienst messen Sie die akzeptierte Arbeit:
accepted_output_rendimento =
  accepted output tokens or accepted responses
  / wall-clock benchmark duration
Dann normalisieren Sie nach Kosten:
token_per_dollar =
  accepted output tokens per hour
  / effective hourly cost
Das ist die zentrale Kennzahl hinter Suchen nach beste GPU für LLM-Inferenz token/s/usd. Eine günstigere GPU kann gewinnen, wenn sie gut ausgelastet bleibt und das Latenzziel flexibler ist. Eine teurere GPU kann gewinnen, wenn sie die Batchgröße erhöht, Replikate reduziert, Speicherausfälle vermeidet oder die p95/p99-Latenz innerhalb des Service-Level-Ziels hält.
Teilen Sie den Durchsatz in zwei Phasen auf:
| Phase | Was die GPU belastet | Was gemessen werden sollte |
|---|---|---|
| Prefill | Prompt-Länge, Attention-Arbeit, Speicherbewegung, Cache-Wiederverwendung | Zeit bis zum ersten Token, Prompt-Tokens/Sek., Warteschlangenzeit |
| Decode | Ausgabelänge, Batch-Skalierung, Bandbreite des KV-Caches | Ausgabe-Tokens/Sek., Token-zu-Token-Latenz, p95/p99-Abschlusszeit |
Für Long-Context-RAG und Agenten-Traffic kann das Prefill dominieren. Für Streaming-Chat mit langen Antworten kann das Decode dominieren. Für Batch-Klassifizierung können pro Minute akzeptierte Anfragen wichtiger sein als die Streaming-Latenz.
Latenz: für p95 und p99 optimieren, nicht für Durchschnittsgeschwindigkeit
Die beste GPU für LLM-Inferenz unter einem auf den Nutzer ausgerichteten SLA ist die GPU, die die Tail-Latenz unter Last niedrig hält. Die durchschnittliche Latenz verdeckt Queueing, laute Nachbarn, Cache-Fehler, Cold Starts und erneute Versuche nach OOM.
Verfolgen Sie diese Kennzahlen bei jedem GPU-Test:
\table>| Metrik | Warum sie wichtig ist |
|---|---|
| Zeit bis zum ersten Token | Wahrgenommene Benutzerreaktionsfähigkeit und Effizienz des Prefill. |
| Token-zu-Token-Latenz | Streaming-Qualität und Geschwindigkeit des Decode. |
| Ende-zu-Ende-Latenz | Gesamtzeit bis zum Abschluss der Aufgabe. |
| p95- und p99-Latenz | Die tatsächliche Gesundheit des SLO in der Produktion. |
| Wartezeit in der Warteschlange | Ob der Server bereits überlastet ist, bevor die Generierung überhaupt beginnt. |
| OOM- und Retry-Rate | Ob der Benchmark stabil genug ist, um die Beschaffung zu steuern. |
| GPU-Auslastung und HBM-Bandbreitenauslastung | Ob die GPU der Engpass ist oder ob die Pipeline anderswo wartet. |
Wenn das Angebot für die H200 das 1,4-fache des Angebots für eine H100 beträgt und sie für Ihre Workload 1,8x den akzeptierten Ausgabedurchsatz liefert, kann die H200 gewinnen. Wenn sie 2,2x kostet und p95 nur um 10 % verbessert, gewinnt wahrscheinlich die H100. Wenn eine L40S deutlich günstiger ist und das Latenzziel für ein 13B-Modell erfüllt, kann die L40S für dieses Szenario die beste GPU für das Preis-Leistungs-Verhältnis der LLM-Inferenz sein.
Beste GPU für lokale LLM-Inferenz
Die beste GPU für lokale LLM-Inferenz ist eine andere Frage als die beste GPU für unternehmensweises Serving. Lokale Inferenz gewichtet in der Regel Kaufpreis, Stromverbrauch am Schreibtisch, VRAM, Datenschutz und Entwicklerkomfort höher. Production-Serving gewichtet Verfügbarkeit, Observability, Ersatzpolitik, Interconnect, Multi-Tenant-Isolation und Support höher.
Für den lokalen Einsatz:
- RTX 4090 und RTX 5090 sind starke Optionen für die lokale Entwicklung kleiner und quantisierter Modelle, da sie hohe Consumer-GPU-Leistung und ausreichend VRAM für viele Experimente bieten.
- Workstation-GPUs der RTX PRO / RTX 6000-Klasse sind besser, wenn Sie mehr VRAM, Workstation-Treiber oder professionellen Support benötigen.
- Unified Memory von Macs oder CPU-Inferenz kann für Tests nützlich sein, sollte aber nicht als Benchmark für GPU-Serving betrachtet werden.
- Lokale Multi-GPU-Rigs können für Forschung funktionieren, erreichen aber nur selten den Betrieb eines Cloud-Rechenzentrums, es sei denn, Ihr Team ist für Strom, Kühlung, Netzwerk, Monitoring und Fehlerbehebung verantwortlich.
Nutzen Sie lokale GPUs, um Prompts, Qualität, Quantisierung und Anwendungsverhalten zu validieren. Nutzen Sie Cloud- oder Rechenzentrums-GPUs, um Produktions-Parallelität, p95/p99-Latenz, Verfügbarkeit, Kosten pro akzeptiertem Token und Rollout-Prozesse zu validieren.
Empfohlene GPU nach Modell und Serving-Muster
| Serving-Muster | Kurze GPU-Liste | Warum |
|---|---|---|
| 7B/8B Support-Bot, moderater Kontext | L40S, A100 40GB/80GB, H100 PCIe, lokale RTX-Klasse für Entwicklung | Das Modell ist klein genug, sodass geringere Stundenkosten wichtiger sein können als Spitzenspeicher. |
| Privater Assistent 13B-34B | L40S, A100 80GB, H100 | Wählen Sie basierend auf Parallelität und Latenzziel; die H100 ist nützlich, wenn Tail-Latency wichtig ist. |
| 70B-Chat mit moderatem Kontext | H100, H200, 2x A100/H100 je nach Genauigkeit | Benchmarken Sie Quantisierung, Tensor-Parallelismus und Batch-Policy. |
| Langkontext-RAG 70B | H200, H100 NVL/SXM, B200 falls verfügbar | Speicher und Druck auf den KV-Cache können dominieren. |
| Multi-Tenant-Unternehmens-API | H100/H200/B200 bei einem Anbieter mit Support | Support, Observability, Isolation und Ersatzpolitik sind wichtig. |
| Offline-Batch-Inferenz | A100, L40S, H100 Spot oder Marketplace | Durchsatz pro Dollar kann geringere Latenz übertreffen. |
| Laptop oder Desktop des Entwicklers | RTX 4090, RTX 5090, RTX PRO/Workstation | Ideal für lokale LLM-Inferenz und Prompt-Entwicklung; keine vollständige Produktionslösung. |
Benchmark-Plan vor dem Mieten oder Kaufen
Wählen Sie nicht die beste GPU für LLM-Inferenz nur anhand eines generischen Benchmarks. Führen Sie eine Reproduktion aus, die Ihrem Produkt ähnelt.
- Frieren Sie die Workload ein. Protokollieren Sie Modell-ID, Quantisierung, Genauigkeit, Verteilung der Prompt-Längen, Verteilung der Ausgabe-Längen, Zielkontext, Parallelität und Qualitätsprüfungen.
- Frieren Sie den Serving-Stack ein. Verwenden Sie nach Möglichkeit in allen GPU-Tests dieselbe Version von vLLM, SGLang, TensorRT-LLM, NIM oder eines benutzerdefinierten Servers.
- Frieren Sie die Hardware-Konfiguration ein. Erfassen Sie GPU-SKU, Anzahl der GPUs, PCIe/SXM/NVL, CPU, RAM, Speicher, Treiber, CUDA-Version, Netzwerk und Platzierung.
- Führen Sie drei Verkehrstrajektorien aus. Kurzer Chat, Langkontext-RAG und Batch-/Offline-Prompts zeigen unterschiedliche Engpässe auf.
- Messen Sie p50, p95, p99. Die durchschnittliche Latenz reicht für clientseitige Inferenz nicht aus.
- Verfolgen Sie Fehler. Zählen Sie OOMs, Timeouts, Evictions, Cold-Start-Fehler und Retry-Verstärkung.
- Berechnen Sie die akzeptierten Kosten. Teilen Sie die effektiven Kosten durch akzeptierte Ausgabetokens, akzeptierte Antworten oder abgeschlossene Aufgaben.
- Führen Sie mindestens einen Tag Canary aus. Marketplace-Preise, Verfügbarkeit des Anbieters und Warteschlangenbildung können sich während echter Traffic-Fenster ändern.
Minimale Benchmark-Tabelle:
| Metrik | Kandidaten-GPU A | Kandidaten-GPU B | Kandidaten-GPU C |
|---|---|---|---|
| Stündlicher GPU-Preis | |||
| Effektive Stundenkosten | |||
| Akzeptierte Ausgabetokens/Stunde | |||
| Kosten pro 1 Mio. akzeptierter Ausgabetokens | |||
| Zeit bis zum ersten Token p95 | |||
| End-to-End-Latenz p95/p99 | |||
| OOM- oder Retry-Rate | |||
| Durchschnittliche GPU-Auslastung | |||
| Hinweise zum Betrieb |
Wann eine Modell-API das Mieten von GPUs übertrifft
Die beste GPU für die LLM-Inferenz kann in der Praxis auch bedeuten: gar keine GPU-Miete. Direkte GPU-Kontrolle ist wertvoll, wenn Sie proprietäre Gewichte, eine hohe und konstante Auslastung, benutzerdefinierte Kernel, starke Datenlokalität oder ein Serving-Team haben, das die GPUs ausgelastet halten kann.
Verwenden Sie eine Modell-API oder einen Router, wenn:
- Der Traffic unregelmäßig ist.
- Sie mehrere Modellanbieter benötigen, statt eines einzigen festen Open-Weight-Modells.
- Die Modellauswahl sich häufig ändert.
- Sie mehr Fallback als Bare-Metal-Kontrolle benötigen.
- Die GPU-Leerlaufzeit höher wäre als jeder API-Aufpreis pro Token.
- Ihr Team Nutzungsprotokolle, Budgetgrenzen, Rechnungen und Provider-Governance möchte, ohne einen Serving-Cluster zu betreiben.
Flatkey passt auf diese Seite der Entscheidung: ein Schlüssel, ein Guthaben, eine Rechnung, mehr als 300 offizielle Modelle, mehr als 1.000 Pay-per-Call-Tools und Nutzungsprotokolle auf Anfrageebene. Wenn ein Workload keine selbst gehosteten Gewichte erfordert, vergleichen Sie die GPU-Kosten pro akzeptiertem Token mit verwalteten Modellrouten, bevor Sie sich auf einen GPU-Cluster festlegen.
Für verwandte Kostenentscheidungen sehen Sie die Flatkey-Leitfäden zu GPU-Mietpreisen, H100 vs A100, H200 vs H100, GPU-Cluster-Miete, vLLM vs SGLang und KI-Modell-Preisvergleich.
Endgültige Empfehlung
Die beste GPU für die LLM-Inferenz hängt vom Workload ab:
- Verwenden Sie H200, wenn Speicher, langer Kontext und KV-Cache-Druck die Kosten bestimmen.
- Verwenden Sie H100, wenn Sie ein bewährtes Produktions-Setup benötigen und der Workload dazu passt.
- Verwenden Sie B200 oder GB200, wenn Blackwell-Kapazität verfügbar ist, der Serving-Stack bereit ist und Ihr Benchmark den Aufpreis belegt.
- Verwenden Sie L40S oder A100, wenn Preis-Leistung wichtiger ist als die absolute Latenz.
- Verwenden Sie lokale GPUs der RTX-Klasse für Entwicklung und lokale LLM-Inferenz, nicht für unternehmensweites Multi-Tenant-Serving.
- Verwenden Sie Flatkey oder eine andere Modell-API-Schicht, wenn der direkte Betrieb von GPUs kein Produktvorteil ist.
Die Kaufmetrik ist nicht „welche GPU ist die schnellste?“. Es ist Kosten pro akzeptiertem Token bei dem Latenz- und Zuverlässigkeitsniveau, das Ihr Produkt erfordert.
Häufig gestellte Fragen
Welche ist die beste GPU für die LLM-Inferenz?
Die beste GPU für die LLM-Inferenz hängt vom Workload ab. Die H200 ist oft der stärkste Ausgangspunkt für speicherbegrenztes Serving von 70B-Modellen und langem Kontext. Die H100 ist der ausgereifte Produktionsstandard. Die L40S, die A100, die RTX 4090 oder die RTX 5090 können für kleinere Modelle, Batch-Jobs oder lokale Inferenz besser sein, wenn sie das Latenzziel zu geringeren Kosten erreichen.
Welche ist die beste GPU für das Preis-Leistungs-Verhältnis bei der LLM-Inferenz?
Die beste GPU für das Preis-Leistungs-Verhältnis bei der LLM-Inferenz ist die GPU mit den niedrigsten Kosten pro akzeptiertem Token oder akzeptierter Antwort, nicht mit dem niedrigsten Preis pro Stunde. Berechnen Sie die effektiven Stundenkosten, akzeptierte Output-Tokens pro Stunde, p95/p99-Latenz und Fehlerrate, bevor Sie sich entscheiden.
Wie berechne ich die beste GPU für die LLM-Inferenz in Token/s/USD?
Verwenden Sie die akzeptierten Output-Tokens pro Stunde geteilt durch die effektiven Stundenkosten. Die effektiven Kosten sollten GPU-Miete, Speicher, Bandbreite, Leerlaufzeit, Retries, Support und Engineering-Overhead enthalten. Vergleichen Sie dann dasselbe Modell, dieselbe Genauigkeit, dieselbe Kontextlänge und denselben Serving-Stack über verschiedene GPUs hinweg.
H100 oder H200: Was ist besser für die LLM-Inferenz?
Die H200 ist in der Regel besser, wenn Speicherkapazität, Bandbreite, langer Kontext oder ein größerer KV-Cache die Serving-Form verändern. Die H100 ist in der Regel besser, wenn das Modell gut passt, Kapazität günstiger oder leichter verfügbar ist und der Benchmark die Ziele für Latenz und Durchsatz erfüllt.
Ist die B200 die beste GPU für die LLM-Inferenz?
B200- oder GB200-Systeme können für LLM-Inferenz in großem Maßstab hervorragend sein, wenn der Anbieter tatsächlich Kapazität hat, das Serving-Framework die von Ihnen geplante Genauigkeit und Topologie unterstützt und der Benchmark niedrigere akzeptierte Kosten belegt. Kaufen Sie Blackwell-Kapazität nicht nur auf Basis von Launch-Versprechen; testen Sie Ihren Traffic.
Welche ist die beste GPU für lokale LLM-Inferenz?
Für lokale LLM-Inferenz sind die RTX 4090 und die RTX 5090 gängige Hochleistungsoptionen für Entwickler, während RTX PRO- oder RTX-6000-Karten besser sind, wenn Sie mehr VRAM oder professionellen Workstation-Support benötigen. Lokale GPUs eignen sich besser für Entwicklung, Datenschutz und kleine Deployments, nicht für vollständige Zuverlässigkeit im Enterprise-Serving.
Verifizierte Quellen
- NVIDIA H200 GPU: https://www.nvidia.com/en-us/data-center/h200/
- NVIDIA H100 Tensor Core GPU: https://www.nvidia.com/en-us/data-center/h100/
- NVIDIA A100 Tensor Core GPU: https://www.nvidia.com/en-us/data-center/a100/
- NVIDIA DGX B200: https://www.nvidia.com/en-us/data-center/dgx-b200/
- NVIDIA L40S GPU: https://www.nvidia.com/en-us/data-center/l40s/
- NVIDIA GeForce RTX 5090: https://www.nvidia.com/en-us/geforce/graphics-cards/50-series/rtx-5090/
- RunPod GPU-Cloud-Preise: https://www.runpod.io/pricing
- Lambda GPU-Cloud-Preise: https://lambda.ai/pricing
- AWS EC2 P5-Instanzen: https://aws.amazon.com/ec2/instance-types/p5/
- GPU-Maschinentypen von Google Cloud: https://docs.cloud.google.com/docs/compute-area/gpus
- Dokumentation des OpenAI-kompatiblen vLLM-Servers: https://docs.vllm.ai/en/latest/serving/openai_compatible_server.html


