LLM-API-Observability ist die Praxis, jeden Modellaufruf in genügend strukturierte Nachweise zu verwandeln, um vier Produktionsfragen zu beantworten:
- War die Anfrage erfolgreich?
- Wie lange hat der Nutzer gewartet?
- Was hat die Anfrage verbraucht und gekostet?
- Warum hat das System dieses Modell, einen Retry oder einen Fallback gewählt?
Gewöhnliches HTTP-Monitoring ist notwendig, aber nicht ausreichend. Ein 200 OK kann dennoch ungültiges JSON, eine leere Antwort, eine abgelehnte Antwort, einen fehlerhaften Tool-Aufruf oder eine Ausgabe enthalten, die gegen den Anwendungskontrakt verstößt. Eine Anfrage kann außerdem nach drei Versuchen erfolgreich sein und dabei stillschweigend viermal mehr kosten als erwartet.
Das praktische Ziel ist nicht, jeden Prompt zu protokollieren. Es geht darum, einen kleinen, konsistenten Telemetrievertrag zu schaffen, der Anwendungsergebnisse mit Modell, Provider, Route, Latenz, Token-Nutzung, Retries und Kosten verknüpft — ohne Nutzerdaten preiszugeben.
Dieser Leitfaden zeigt, wie Sie diesen Vertrag mit Metriken, Traces, strukturierten Logs, Service-Level-Objectives, Dashboards und Alerts aufbauen.
Was LLM-API-Observability erklären muss
Ein nützliches Observability-System ermöglicht es einem Engineer im On-Call, schnell von einem Symptom zu einer Ursache zu gelangen.
| Produktionsfrage | Benötigte Nachweise |
|---|---|
| Warum ist die Latenz angestiegen? | End-to-End-Dauer, Provider-Dauer, Wartezeit in der Warteschlange, Zeit bis zum ersten Token, Modell, Region, Anzahl der Retries |
| Warum sind die Kosten gestiegen? | Eingabe-Token, Ausgabe-Token, gecachte Token, wenn verfügbar, Preis-Snapshot des Modells, Versuche, angenommene Task-Rate |
| Warum sehen Nutzer schlechte Ergebnisse? | Ergebnis des Output-Validators, Schema-Fehler, Ablehnungsstatus, Tool-Call-Ergebnis, Bewertungs-Score, Prompt-Version |
| Warum wurde Traffic auf ein anderes Modell verschoben? | Routing-Policy, ausgewähltes Ziel, Fallback-Grund, Zustand des Circuit Breakers, Provider-Fehler |
| Ist der Vorfall provider-spezifisch? | Provider, Modell, Konto oder Deployment, Region, Statuscode, Provider-Request-ID |
| Können wir eine Anfrage reproduzieren? | Interne Request-ID, Trace-ID, bereinigter Input-Fingerprint, Prompt-Version, Modellparameter |
Die erste Designregel ist einfach: Messen Sie den Anwendungskontrakt, nicht nur den Transportkontrakt.
Die fünf Telemetrie-Ebenen
LLM-API-Monitoring wird einfacher, wenn Sie fünf Ebenen trennen, statt jedes Signal in ein einziges Dashboard zu zwängen.
1. Request-Metriken
Metriken zeigen Trends und liefern die Grundlage für Alerts. Erfassen Sie Zähler und Histogramme für:
- Anzahl der Requests
- End-to-End-Latenz
- Zeit bis zum ersten Token bei Streaming-Antworten
- Latenz des Providers oder Modellaufrufs
- Erfolgreiche, fehlgeschlagene, abgebrochene und zeitüberschrittene Requests
- HTTP-429- und 5xx-Antworten
- Retry- und Fallback-Versuche
- Eingabe-, Ausgabe- und gecachte Token
- Geschätzte und abgeglichene Kosten
Metriken sollten begrenzte Labels haben. Gute Labels sind provider, model, route, environment, status und error_type. Vermeiden Sie Labels mit hoher Kardinalität wie User-IDs, Request-IDs, Prompt-Text oder vollständige URLs.
2. Verteilte Traces
Ein Trace erklärt den Weg einer einzelnen Anfrage durch Ihre API, die Queue, die Retrieval-Schicht, Tool-Aufrufe, das Gateway und den Modellanbieter.
Eine praktische Trace-Hierarchie sieht so aus:
POST /support/reply
├── retrieve_customer_context
├── llm.route
│   ├── llm.attempt provider_a/model_primary
│   └── llm.attempt provider_b/model_fallback
├── validate_structured_output
└── persist_draft
Jeder Modellversuch sollte sein eigener Span sein. Wenn zwei Anbieter ausprobiert werden, muss der Trace zwei Versuche zeigen, statt beide in einem undurchsichtigen llm.call-Span zu verbergen.
Die semantischen Konventionen für Generative AI von OpenTelemetry bieten einen nützlichen gemeinsamen Wortschatz für Gen-AI-Spans, Metriken und Events. Behandeln Sie die Version der Konvention als Teil Ihres Telemetrie-Schemas, damit Sie bei Änderungen der Attribute gezielt migrieren können.
3. Strukturierte Logs
Logs erfassen einzelne Entscheidungen und diagnostischen Kontext, der als Metrik-Label zu teuer oder zu detailliert wäre.
Nützliche Events sind unter anderem:
llm.request.startedllm.route.selectedllm.retry.scheduledllm.fallback.selectedllm.response.validatedllm.request.completedllm.request.failed
Jedes Event sollte dieselben Korrelationsfelder enthalten: request_id, trace_id, route, model, provider, prompt_version und attempt.
4. Qualitäts- und Vertrags-Signale
Qualität lässt sich nicht aus Statuscodes ableiten. Fügen Sie, wo immer möglich, deterministische Validatoren hinzu:
- JSON wurde erfolgreich geparst
- Erforderliche Schemafelder sind vorhanden
- Tool-Name und Argumente sind zulässig
- Die Zitatenliste ist vorhanden, wenn sie erforderlich ist
- Die Ausgabelänge liegt innerhalb der Produktgrenzen
- Abbruch- oder Sicherheitsstatus wird erkannt
- Geschäftsregelprüfungen bestehen
Für subjektive Aufgaben fügen Sie später Stichproben-Ergebnisse der Bewertung hinzu. Halten Sie Online-Anfrage-Telemetrie und Offline-Evaluation über eine stabile Request- oder Sample-ID zusammengeführt.
Bevor Sie ein Produktionsmodell ersetzen, verwenden Sie einen reproduzierbaren Workflow zur Bewertung von KI-Modellen, statt sich allein auf aggregierte Latenz und Tokenpreis zu verlassen.
5. Kosten und Geschäftsergebnisse
Token-Zahlen sind Nutzungssignale, keine Geschäftsergebnisse. Verbinden Sie die Modellnutzung mit der Einheit, die für Ihr Produkt relevant ist:
- Kosten pro akzeptierter Support-Antwort
- Kosten pro abgeschlossenem Coding-Task
- Kosten pro generiertem Produktbild, das von einem Reviewer freigegeben wurde
- Kosten pro angereichertem qualifizierten Lead
- Kosten pro erfolgreicher strukturierter Extraktion
Die nützlichste Formel ist:
effektive Kosten pro akzeptierter Aufgabe = Gesamtkosten des Modells / akzeptierte Aufgaben
Das macht falsche Einsparungen sichtbar. Ein günstigeres Modell, das mehr Retries, Validierungsfehler oder manuelle Nacharbeit verursacht, kann die effektiven Kosten erhöhen.
Ein minimales Telemetrie-Contract für jeden Modellaufruf
Beginnen Sie mit einem versionierten Ereignisschema. Die genauen Feldnamen können Ihrem Observability-Stack folgen, aber die Konzepte sollten stabil bleiben.
{
  "schema_version": "llm-observability.v1",
  "timestamp": "2026-07-30T09:00:00Z",
  "request_id": "req_internal_01",
  "trace_id": "7c4b...",
  "environment": "production",
  "feature": "support_reply",
  "route": "support-default",
  "provider": "provider-a",
  "model": "model-primary",
  "prompt_version": "support-reply-v12",
  "attempt": 1,
  "stream": true,
  "status": "success",
  "http_status": 200,
  "latency_ms": 1840,
  "time_to_first_token_ms": 410,
  "input_tokens": 1640,
  "output_tokens": 284,
  "cached_input_tokens": 900,
  "estimated_cost_usd": 0.0068,
  "validator": "bestanden",
  "fallback_reason": null,
  "provider_request_id": "redacted-or-scoped-value"
}
Machen Sie rohe Prompts und Antworten nicht zu erforderlichen Feldern. Speichern Sie sie nur, wenn ein klarer Bedarf, eine genehmigte Aufbewahrungsrichtlinie, angemessene Zugriffskontrollen und ein sicherer Redaktionspfad vorhanden sind.
Metriken, die auf das erste Dashboard gehören
Beginnen Sie nicht mit 40 Panels. Erstellen Sie ein operatives Dashboard, das beantwortet, ob Benutzer gültige Ergebnisse innerhalb des Latenz- und Kostenbudgets erhalten.
Traffic und Erfolg
- Anfragen pro Minute
- Transport-Erfolgsrate
- Validierte Erfolgsrate
- Abbruchrate
- Timeout-Rate
- Retry-Verstärkungsfaktor
- Fallback-Rate
Validated success rate sollte das primäre Verfügbarkeitsignal sein:
validierte Erfolgsrate = Anfragen, die den Anwendungskontrakt bestehen / berechtigte Anfragen
Das ist strenger und nützlicher als 2xx responses / requests.
Latenz
Verfolgen Sie Verteilungen statt Durchschnittswerte:
- End-to-End-p50-, p95- und p99-Latenz
- Provider-Call-p50-, p95- und p99-Latenz
- Zeit bis zum ersten Token p50 und p95
- Warteschlangen-Wartezeit p95
- Tool-Ausführungszeit p95
- Validierungsdauer p95
Trennen Sie Streaming- und Non-Streaming-Routen. Eine Streaming-Anfrage kann sich mit einer guten Zeit bis zum ersten Token reaktionsschnell anfühlen, selbst wenn die gesamte Abschlusszeit lang ist.
Zuverlässigkeit
- 429-Rate nach Provider und Modell
- 5xx-Rate nach Provider und Modell
- Netzwerkfehler-Rate
- Rate fehlerhafter oder schemaungültiger Antworten
- Rate von Tool-Call-Fehlern
- Offener Zustand des Circuit Breakers
- Rate ausgeschöpfter Retry-Budgets
Wenn Ratenlimits eine häufige Ursache sind, verwenden Sie eine begrenzte LLM-Retry-Strategie für RPM- und TPM-Limits statt unkoordinierter Retries in jedem Anwendungs-Worker.
Nutzung und Kosten
- Input- und Output-Tokens nach Feature
- Tokens pro akzeptierter Aufgabe
- Geschätzte Kosten pro Anfrage
- Kosten pro akzeptierter Aufgabe
- Retry-Kosten
- Fallback-Kostendifferenz
- Tägliche Ausgaben im Vergleich zum Budget
- Kostenschätzung im Vergleich zur Provider-Rechnung oder zum Usage-Export
Behalte sowohl estimated_cost als auch reconciled_cost bei. Der erste ermöglicht eine nahezu Echtzeit-Überwachung; der zweite korrigiert Schätzungen, nachdem autoritative Abrechnungsdaten eingetroffen sind.
Wie Retries und Fallback-Routing nachverfolgt werden
Retries und Fallbacks sind die Stellen, an denen grundlegendes Monitoring meist versagt. Wenn alle Versuche ein einziges Statusfeld teilen, kann eine teure und beeinträchtigte Anfrage gesund aussehen.
Erfasse für jeden Versuch diese Felder:
| Feld | Warum es wichtig ist |
|---|---|
attempt |
Zeigt die Verstärkung und die Reihenfolge der Entscheidungen |
target_id |
Identifiziert Anbieter, Deployment, Region und Modell ohne Geheimnisse |
reason |
Unterscheidet Timeout, 429, 5xx, Validierungsfehler und Policy-Routing |
remaining_budget_ms |
Beweist, dass der Router die dem Nutzer sichtbare Frist eingehalten hat |
safe_to_repeat |
Macht Idempotenzentscheidungen explizit |
output_started |
Verhindert unsicheres Fallback, nachdem Streaming-Ausgabe den Client erreicht hat |
contract_compatible |
Bestätigt, dass das nächste Ziel das erforderliche Schema, die Tools und die Modalität unterstützt |
Ein produktionsreifes LLM-API-Fallback-Routing-Playbook sollte die Entscheidungsrichtlinie definieren. Observability sollte dann belegen, dass der Router ihr gefolgt ist.
TypeScript-Instrumentierungsmuster
Das folgende Beispiel hält die Telemetrie unabhängig von einem bestimmten Modell-SDK. Es zeichnet einen übergeordneten Route-Span und für jeden Versuch einen untergeordneten Span auf.
import { context, SpanStatusCode, trace } from "@opentelemetry/api";

const tracer = trace.getTracer("ai-gateway");

type ModelAttempt = {
  provider: string;
  model: string;
  reason: "primary" | "retry" | "fallback";
};

export async function runModelRoute(
  attempts: ModelAttempt[],
  callModel: (attempt: ModelAttempt) => Promise<{
    text: string;
    usage?: { inputTokens?: number; outputTokens?: number };
    providerRequestId?: string;
  }>,
) {
  return tracer.startActiveSpan("llm.route", async (routeSpan) => {
    routeSpan.setAttribute("app.llm.route", "support-default");
    routeSpan.setAttribute("app.llm.attempt_limit", attempts.length);

    try {
      for (const [index, attempt] of attempts.entries()) {
        const result = await tracer.startActiveSpan(
          "llm.attempt",
          { attributes: {
            "gen_ai.system": attempt.provider,
            "gen_ai.request.model": attempt.model,
            "app.llm.attempt": index + 1,
            "app.llm.reason": attempt.reason,
          } },
          context.active(),
          async (attemptSpan) => {
            const startedAt = performance.now();

            try {
              const response = await callModel(attempt);
              const valid = response.text.trim().length > 0;

              attemptSpan.setAttribute("app.llm.validated", valid);
              attemptSpan.setAttribute(
                "gen_ai.usage.input_tokens",
                response.usage?.inputTokens ?? 0,
              );
              attemptSpan.setAttribute(
                "gen_ai.usage.output_tokens",
                response.usage?.outputTokens ?? 0,
              );
              attemptSpan.setAttribute(
                "app.llm.latency_ms",
                performance.now() - startedAt,
              );

              if (!valid) {
                throw new Error("response_validation_failed");
              }

              attemptSpan.setStatus({ code: SpanStatusCode.OK });
              return response;
            } catch (error) {
              attemptSpan.recordException(error as Error);
              attemptSpan.setStatus({
                code: SpanStatusCode.ERROR,
                message: (error as Error).message,
              });
              return null;
            } finally {
              attemptSpan.end();
            }
          },
        );

        if (result) {
          routeSpan.setAttribute("app.llm.selected_attempt", index + 1);
          routeSpan.setStatus({ code: SpanStatusCode.OK });
          return result;
        }
      }

      throw new Error("llm_route_exhausted");
    } catch (error) {
      routeSpan.recordException(error as Error);
      routeSpan.setStatus({
        code: SpanStatusCode.ERROR,
        message: (error as Error).message,
      });
      throw error;
    } finally {
      routeSpan.end();
    }
  });
}
In der Produktion fügen Sie Ihre Metrikzähler und strukturierten Log-Events zusammen mit den Spans hinzu. Erfassen Sie außerdem nach Möglichkeit die Request-IDs des Anbieters; sie sind oft unerlässlich, wenn ein Vorfall an einen Modellanbieter eskaliert wird. Halten Sie diese Kennungen aus öffentlichen Fehlermeldungen heraus.
Logs ohne Prompt-Leakage
Der sicherste Standard ist metadata-first Logging.
Standardmäßig protokollieren
- Interne Request- und Trace-IDs
- Provider-Request-ID
- Feature- und Routenname
- Provider, Modell und Deployment-Alias
- Version der Prompt-Vorlage
- Parameter wie Temperature und maximale Ausgabe-Tokens
- Token-Nutzung
- Latenz und Zeit bis zum ersten Token
- Fehlerklasse und Retry-Entscheidung
- Ergebnis des Validators
- Bereinigte Tool-Namen
Standardmäßig nicht protokollieren
- Roh-Prompts oder -Antworten
- API-Schlüssel oder Authorization-Header
- Kundengeheimnisse
- Abgerufene Dokumente
- Tool-Argumente, die personenbezogene oder regulierte Daten enthalten
- Vollständige Dateipfade oder Datenbankdatensätze
- Signierte URLs
Wenn die Erfassung von Inhalten für Debugging oder Evaluierung notwendig ist, erfassen Sie diese separat, schwärzen Sie sie vor der Speicherung, beschränken Sie den Zugriff, verschlüsseln Sie sie und setzen Sie eine kurze Aufbewahrungsfrist. Der Leitfaden zur sicheren Verwaltung von API-Schlüsseln behandelt die angrenzenden Kontrollen für Geheimnisse, Logging, Rotation und Incident Response.
SLOs für LLM-gestützte Funktionen
Ein Service-Level-Objective für ein LLM sollte die für den Nutzer sichtbare Funktion beschreiben, nicht das Provider-Konto.
Beispiel-SLOs für eine strukturierte Support-Antwortfunktion:
| SLO | Beispielziel |
|---|---|
| Validierte Verfügbarkeit | 99,5 % der berechtigten Requests liefern eine vertragskonforme Ausgabe |
| Interaktive Latenz | 95 % erzeugen das erste Token innerhalb von 1,5 Sekunden |
| Vervollständigungs-Latenz | 95 % sind innerhalb von 8 Sekunden abgeschlossen |
| Kostenleitplanke | 99 % bleiben unter der Kostenobergrenze pro Request |
| Fallback-Eindämmung | Weniger als 3 % benötigen während einer rollierenden Stunde ein Fallback |
Diese Zahlen sind Beispiele, keine universellen Zielwerte. Legen Sie sie anhand der Nutzererwartungen, der Aufgabenschwierigkeit, des Provider-Verhaltens und der Stückkosten fest.
Nutzen Sie Error Budgets, um zu entscheiden, wann Feature-Releases verlangsamt, die Routenrichtlinie verschärft oder Traffic verschoben werden soll. Ein Provider kann sein eigenes Verfügbarkeitsziel erreichen, während Ihr Produkt sein SLO verfehlt, weil Queueing, Tools, Validierung oder Fallback-Verhalten zusätzliche Fehler verursachen.
Auf Symptome alarmieren, Ursachen diagnostizieren
Alarmieren Sie einen Operator bei Auswirkungen auf Nutzer. Verwenden Sie Alarme mit niedrigerer Priorität oder Dashboard-Anmerkungen für wahrscheinliche Ursachen.
Alarmwürdige Symptome
- Die validierte Erfolgsrate unterschreitet das SLO
- Die p95-Zeit bis zum ersten Token überschreitet den nutzerseitigen Schwellenwert
- Die Rate erschöpfter Routen steigt stark an
- Die Kosten pro akzeptierter Aufgabe überschreiten die Leitplanke
- Eine kritische Funktion hat kein gesundes, vertragskompatibles Ziel
Diagnostische Signale
- Die 429-Rate eines Providers steigt
- Die Schema-Fehlerquote eines Modells ändert sich
- Die Retry-Verstärkung nimmt zu
- Die Warteschlangenwartezeit wächst
- Der Circuit Breaker öffnet
- Die Token-Nutzung verschiebt sich nach einem Prompt-Release
Vermeiden Sie es, bei jedem Provider-5xx zu alarmieren. Wenn das Fallback funktioniert und Nutzer weiterhin gültige Antworten innerhalb des Latenzbudgets erhalten, kann das Ereignis eine Untersuchung erfordern, ohne die Person im Bereitschaftsdienst zu wecken.
Ein Betriebsmodell mit drei Dashboards
Dashboard 1: Nutzererlebnis
Zeigen Sie validierte Verfügbarkeit, Latenz, Zeit bis zum ersten Token, Aufgabenerfüllung und nutzerseitige Fehler nach Funktion an.
Dashboard 2: Routing und Provider
Zeigen Sie Traffic-Anteil, Provider-Fehler, Wiederholungen, Fallbacks, Circuit Breaker, Route-Erschöpfung und Latenz nach Modell und Ziel an.
Dashboard 3: Nutzung und Wirtschaftlichkeit
Zeigen Sie Tokens, geschätzte Ausgaben, abgeglichene Ausgaben, Kosten pro akzeptierter Aufgabe, Budgetabweichung und die wichtigsten Features nach Kosten an.
Behalten Sie Deployment- und Prompt-Version-Anmerkungen in allen drei Dashboards bei. Andernfalls kann eine Regression, die unmittelbar nach einem Release beginnt, wie eine zufällige Provider-Varianz aussehen.
Rollout-Checkliste
- Definieren Sie ein versioniertes Event-Schema.
- Generieren Sie an der Produktgrenze eine interne Request-ID.
- Geben Sie den Trace-Kontext durch Queues, Tools und Modellaufrufe weiter.
- Erstellen Sie für jeden Modellversuch einen Child-Span.
- Protokollieren Sie Provider-Request-IDs, wenn sie zurückgegeben werden.
- Fügen Sie eine deterministische Validierung der Ausgabe hinzu.
- Verfolgen Sie Gründe für Wiederholungen und Fallbacks explizit.
- Berechnen Sie die geschätzten Kosten aus einer versionierten Preistabelle.
- Gleichen Sie Schätzungen mit maßgeblichen Nutzungs- oder Abrechnungs-Exports ab.
- Erstellen Sie zuerst ein Dashboard für ein Benutzerergebnis, bevor Sie Provider-Dashboards erstellen.
- Setzen Sie ein SLO für validierten Erfolg und Latenz.
- Schwärzen oder schließen Sie Prompts, Antworten, Geheimnisse und sensible Tool-Daten aus.
- Führen Sie Fehlertests für Timeout, 429, 5xx, fehlerhafte Ausgabe und Route-Erschöpfung aus.
- Prüfen Sie die Label-Cardinality, bevor Sie Metriken in der Produktion aktivieren.
- Samplen Sie Traces nach Risiko: Bewahren Sie Fehler und langsame Anfragen stärker auf als routinemäßige Erfolge.
Häufige Observability-Fehler
Jedes 200 als Erfolg behandeln
Fügen Sie Vertrags-Validatoren hinzu und berichten Sie validierten Erfolg separat.
Roh-Prompts für jede Anfrage protokollieren
Das verursacht Probleme bei Datenschutz, Sicherheit, Aufbewahrung und Kosten. Bevorzugen Sie Metadaten und kontrolliertes Sampling.
Wiederholungen in einer einzigen Dauer verstecken
Erstellen Sie einen Span und ein Event pro Versuch, damit Operatoren die Verstärkung sehen können.
Modellnamen als einzige Route-Identität verwenden
Verfolgen Sie Provider, Deployment- oder Konto-Alias, Region und Route-Policy. Dasselbe Modell kann sich je nach Ziel unterschiedlich verhalten.
Warnungen auf durchschnittliche Latenz auslösen
Durchschnitte verschleiern Probleme im Tail. Verwenden Sie p95 und p99 und trennen Sie die Zeit bis zum ersten Token von der gesamten Abschlusszeit.
Geschätzten Kosten ewig vertrauen
Preistabellen, Cache-Behandlung und Provider-Abrechnung können sich ändern. Gleichen Sie Schätzungen mit Abrechnungsdaten ab und erfassen Sie die Version der Preistabelle.
Telemetry-Labels unbegrenzt wachsen lassen
Request-IDs und Kundenkennungen gehören in Traces oder Logs, nicht in Metrik-Labels.
Wo ein AI-API-Gateway hilft
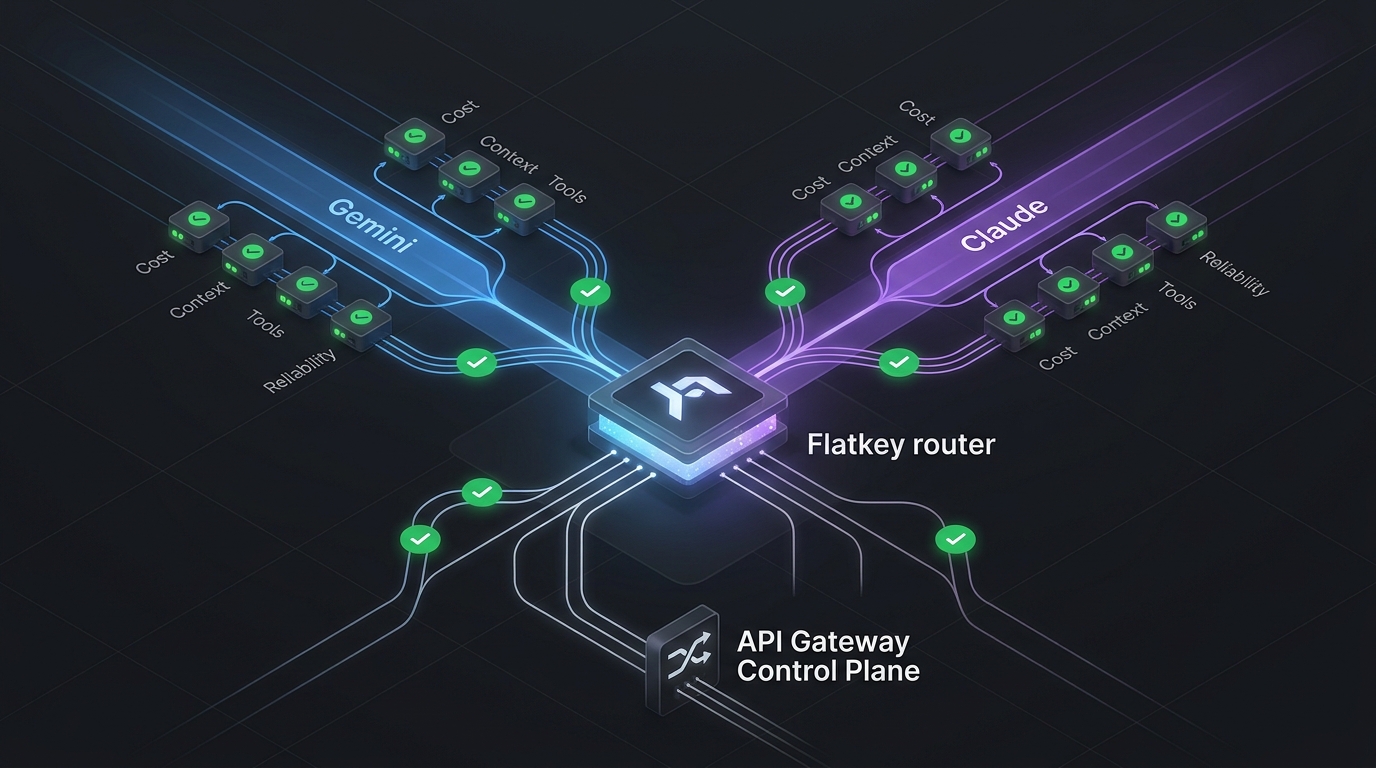
Multi-Provider-Anwendungen benötigen sonst separate Adapter für Authentifizierung, Modellbenennung, Wiederholungen, Nutzungsfelder, Fehler und Abrechnungs-Exports. Ein Gateway kann diese Integrationsfläche verringern, indem es der Anwendung eine stabile API-Grenze bietet und gleichzeitig Provider- und Modell-Details in der internen Telemetrie bewahrt.
Flatkey bietet einen API-Schlüssel, einen OpenAI-kompatiblen Endpunkt und Zugriff auf Modelle über große Provider hinweg. Dadurch ist es möglich, den Telemetrie-Vertrag auf Anwendungsebene zu zentralisieren, selbst wenn Workloads unterschiedliche Text-, Bild- oder Videomodelle verwenden. Das Gateway ersetzt nicht die Observability auf Produktebene: Ihre Anwendung muss weiterhin das Feature, die Prompt-Version, das Validierungsergebnis, die für den Nutzer sichtbare Latenz und das Ergebnis der akzeptierten Aufgabe erfassen.
Wenn Ihr Team Anbieter konsolidiert, beginnen Sie mit dem Leitfaden zur AI-API-Gateway-Architektur und ergänzen Sie dann das Telemetrie-Contract in diesem Artikel, bevor Sie produktiven Traffic umstellen.
Häufig gestellte Fragen
Was ist LLM-API-Observability?
LLM-API-Observability ist die Erfassung und Korrelation von Metriken, Traces, Logs, Qualitätsprüfungen, Nutzungs- und Kostendaten für modellgestützte Funktionen. Sie erklärt sowohl das Verhalten des Anbieters als auch, ob die Anwendung ein gültiges Benutzerergebnis zurückgegeben hat.
Was sollte ich für eine LLM-API überwachen?
Überwachen Sie die validierte Erfolgsrate, End-to-End-Latenz, Time-to-First-Token, Anbieter-Latenz, 429- und 5xx-Raten, Retries, Fallbacks, Token-Nutzung, geschätzte Kosten, Kosten pro akzeptierter Aufgabe und Fehler des Ausgabe-Contracts.
Sollten Prompts und Antworten in Traces gespeichert werden?
Nicht standardmäßig. Speichern Sie zuerst Metadaten. Erfassen Sie Inhalte nur für einen definierten Debugging- oder Evaluationszweck mit Maskierung, Zugriffskontrollen, Verschlüsselung, Sampling und einer Aufbewahrungsrichtlinie.
Was ist der Unterschied zwischen LLM-Monitoring und LLM-Observability?
Monitoring sagt Ihnen, dass eine bekannte Metrik einen Schwellenwert überschritten hat. Observability liefert Ihnen genügend korrelierte Belege, um neue Fehlermodi über die Anwendung, Route, den Anbieter, das Modell, die Tools und den Ausgabe-Contract hinweg zu untersuchen.
Wie berechne ich die LLM-Kosten pro Anfrage?
Multiplizieren Sie abrechenbare Einheiten für Input, Output, gecachten Input, Medien oder andere Nutzungsarten mit einer versionierten Preistabelle und addieren Sie dann die Kosten für Retries und Fallback-Versuche. Gleichen Sie die Schätzung mit Abrechnungsdaten des Anbieters oder Gateways ab.
Welche Request-ID sollte ich speichern?
Erstellen Sie Ihre eigene interne Request-ID und Trace-ID und speichern Sie außerdem die Provider-Request-ID, wenn die API eine zurückgibt. Die internen IDs verbinden Ihre Systeme; die Provider-ID hilft beim externen Support und bei der Eskalation von Vorfällen.
Erstellen Sie den Telemetrie-Contract vor dem Vorfall
Der beste Zeitpunkt, um festzulegen, was ein Modellaufruf erfassen soll, ist bevor produktiver Traffic eintrifft. Beginnen Sie mit validiertem Erfolg, Latenzverteilungen, einem Span pro Versuch, begrenzten Metrik-Labels, Metadaten-First-Logs und Kosten pro akzeptierter Aufgabe. Testen Sie das System dann, indem Sie die Fehler erzwingen, von denen Sie erwarten, dass der Router sie behandeln muss.
Dieses Fundament verwandelt eine vage Meldung – „die AI-Funktion ist langsam und teuer“ – in eine nachvollziehbare Entscheidung: welche Funktion, welche Route, welches Modell, welcher Versuch, welcher Fehler, wie viel Verzögerung und wie viel Kosten.
Informieren Sie sich über die Flatkey-Preisgestaltung, wenn Sie bereit sind, Multi-Model-Routen hinter einer OpenAI-kompatiblen API zu vergleichen.