LLM-Rate-Limits erklärt: RPM, TPM und Retries ist zuerst ein Thema der Produktionszuverlässigkeit und erst danach eine SDK-Einstellung. Rate Limits entscheiden, wie viele Requests, Tokens, Jobs oder gleichzeitige Generierungen Ihre Anwendung in einem Zeitfenster über einen Anbieter oder Gateway schicken kann. Retries entscheiden, was passiert, wenn ein Limit erreicht wird. Die falsche Retry-Policy kann aus einem kleinen Burst einen anhaltenden Ausfall machen.
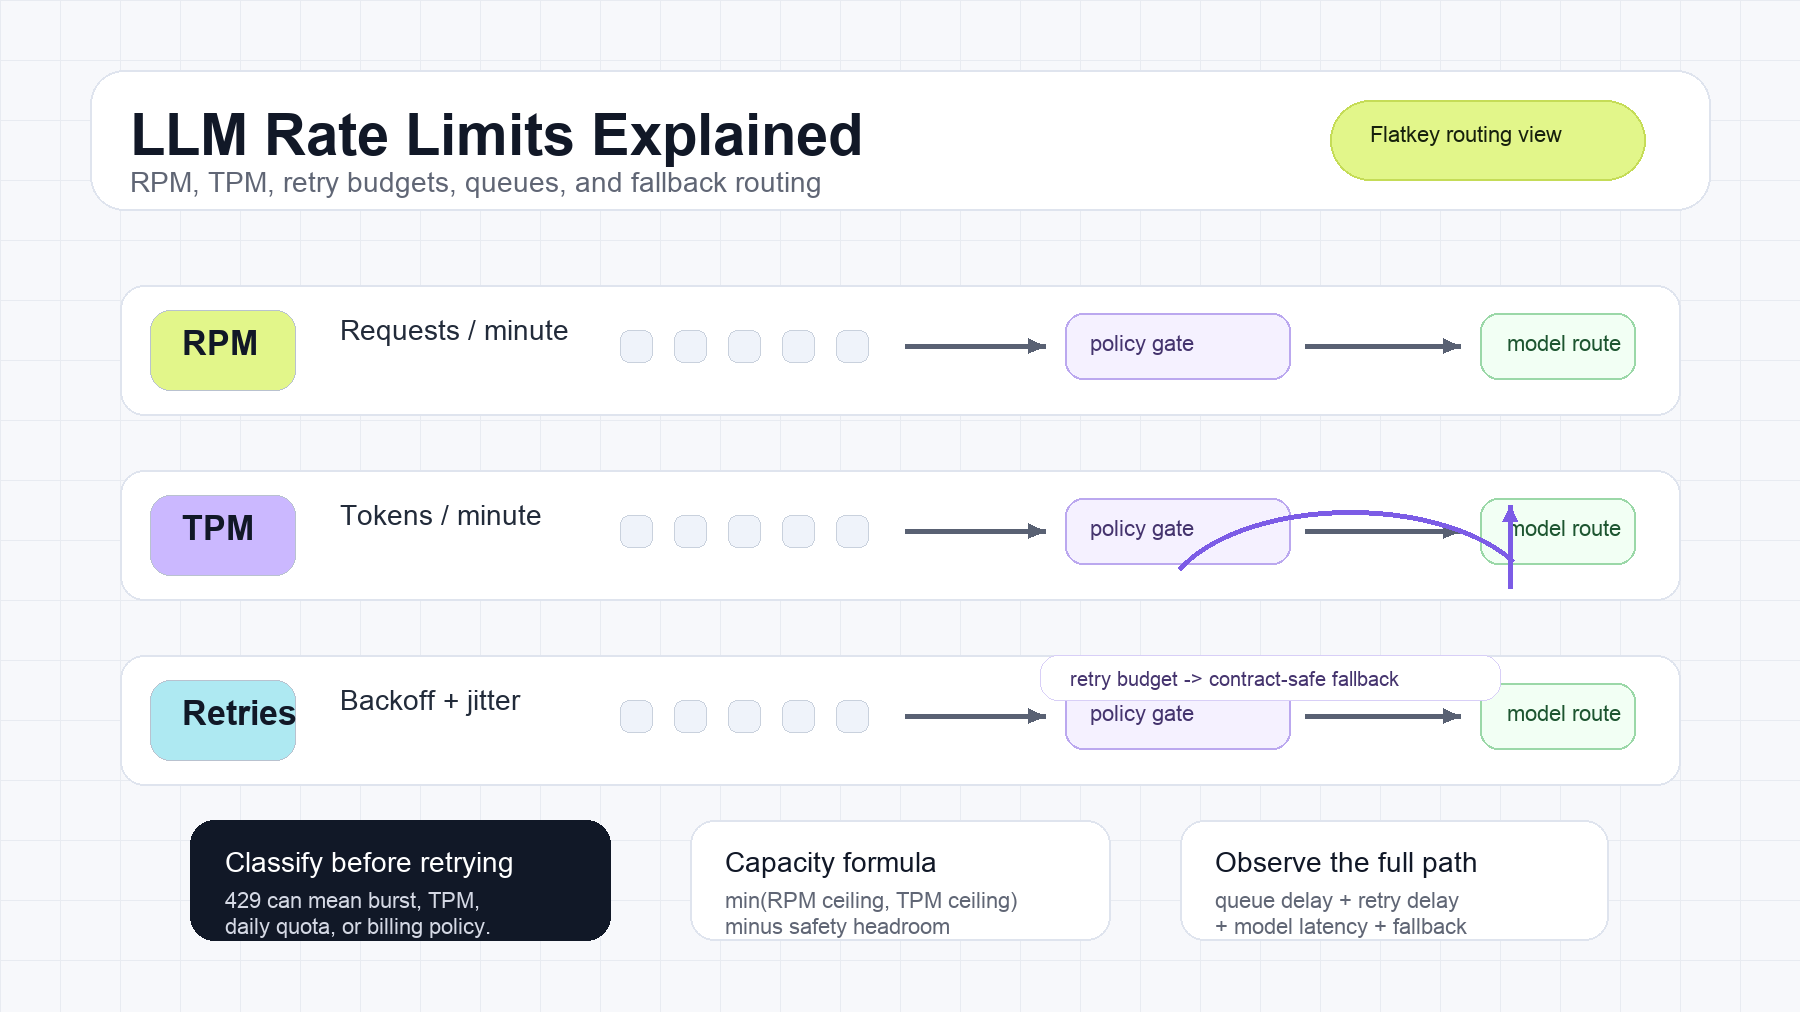
Die praktische Regel ist einfach: RPM steuert die Request-Frequenz, TPM steuert den Token-Durchsatz, Concurrency steuert laufende Arbeit, und Retries verbrauchen dieselbe knappe Kapazität, solange sie nicht begrenzt sind. Ein Produktionssystem sollte zuerst die eingeschränkte Ressource klassifizieren und dann zwischen Taktung, Queueing, Token-Reduzierung, kurzem Retry oder Routing zu einem anderen vertragskompatiblen Modell wählen.
Dieser Leitfaden behandelt LLM-Rate-Limits erklärt: RPM, TPM und Retries als Betriebs-Playbook für KI-Produkt- und Plattformteams. Er deckt die Begriffe, die Kapazitätsrechnung, die Retry-Policy, die Observability-Felder und die Flatkey-artigen Gateway-Steuerungen ab, die verhindern, dass LLM-API-Rate-Limits zu einem Kundenincident werden.
LLM-Rate-Limits erklärt: RPM, TPM und Retries – Kurzantwort
Verwenden Sie diese Tabelle, wenn Sie einen LLM-Rate-Limit-Incident triagieren.
| Signal | Was es misst | Typisches Symptom | Erste Steuerung |
|---|---|---|---|
| RPM | Anfragen, die pro Minute oder im vom Anbieter definierten Fenster zugelassen werden | Viele kleine Aufrufe schlagen mit 429 fehl |
Anfragen takten, Bursts in eine Queue stellen, kleine Aufgaben bündeln |
| TPM | Ein- und/oder Ausgabe-Tokens, die pro Minute oder Fenster zugelassen werden | Lange Prompts, lange Ausgaben oder Evaluierungs-Läufe werden gedrosselt | Tokens reservieren, Kontext verkürzen, Ausgabe begrenzen |
| RPD / TPD | Anfragen oder Tokens, die pro Tag zugelassen werden | Arbeit stoppt, bis das Kontingent zurückgesetzt wird | Retries stoppen, neu terminieren, höheren Tarif anfragen |
| Concurrency | Anfragen oder Jobs, die gleichzeitig in flight sind | Langsame Generierungen stauen sich selbst bei moderatem RPM | Worker begrenzen, Backpressure hinzufügen |
| Retry-Budget | Wie viel zusätzliche Arbeit ein Aufrufer nach einem Fehler ausgeben darf | Retry-Sturm, aufgeblähte Latenz, doppelte Side Effects | Versuche, verstrichene Zeit und retrybare Status begrenzen |
| Fallback-Route | Geeignetes alternatives Modell oder alternativer Anbieter | Primäre Route ist eingeschränkt, aber das Produkt braucht trotzdem Output | Nur routen, wenn Fähigkeit, Policy und Kosten passen |
LLM-Rate-Limits erklärt: RPM, TPM und Retries läuft auf eine operative Entscheidung hinaus: nicht blind retryn. Ein 429 ist kein Befehl, dieselbe Anfrage sofort erneut zu senden. Es ist ein Signal, dass ein Kapazitäts-Bucket, eine Quoten-Policy, ein Billing-Status oder ein Schutzmechanismus des Anbieters die Anfrage abgelehnt hat.
Warum Rate Limits existieren
Anbieter setzen LLM-API-Rate-Limits durch, um geteilte Kapazitäten zu schützen, außer Kontrolle geratene Accounts zu verhindern und Billing- oder Service-Tier-Richtlinien konsistent zu halten. OpenAI, Anthropic und Gemini dokumentieren alle Rate-Limit-Konzepte, aber sie verwenden unterschiedliche Bucket-Namen, Scopes, Header und Dashboards. OpenAI dokumentiert Rate Limits und empfiehlt Clients, Limit-Fehler mit Backoff zu behandeln. Anthropic dokumentiert Organisations- und Workspace-Ausgabenlimits sowie Modell-Rate-Limits auf Ebene einzelner Modelle, die Requests und Tokens einschließen können. Gemini dokumentiert Tiers mit Konzepten für Request-, Token- und Tageslimits.
Diese Anbietersteuerungen sind notwendig, aber keine vollständige Produkt-Policy. Sie beantworten meist die Frage auf Anbieterseite: „Kann dieses Projekt jetzt mehr Traffic senden?“ Ihre Anwendung muss weiterhin die produktseitigen Fragen beantworten:
- Welcher Kunde, welcher Workspace, welches Team oder welche Funktion hat den Burst verursacht?
- War die eingeschränkte Ressource Requests, Input-Tokens, Output-Tokens, Concurrency, Tageskontingent oder Spend?
- Soll diese Arbeitslast warten, degradiert werden, heruntergestuft werden oder sofort fehlschlagen?
- Ist eine Fallback-Route durch Fähigkeit, Datenrichtlinie, Preis und Kundenvertrag erlaubt?
- Verschlimmern Retries das Limit?
Für angrenzende Quotensteuerungen kombinieren Sie diesen Artikel mit AI API quota management und AI API spend management.
RPM, TPM und Concurrency sind unterschiedliche Limits
Teams behandeln Rate Limits oft als eine Zahl. Das verdeckt den eigentlichen Engpass.
RPM: Requests pro Minute
RPM begrenzt die Anzahl der Requests, die während eines vom Anbieter definierten Zeitfensters zugelassen werden. Kleine Prompts, Health Checks, Agent-Tool-Loops und Evaluierungsjobs mit hoher Verzweigung belasten meist zuerst RPM. Eine Workload kann deutlich unter TPM liegen und trotzdem RPM erreichen, wenn sie zu viele kleine Aufrufe sendet.
TPM: Tokens pro Minute
TPM begrenzt den Token-Durchsatz. Je nach Anbieter und Modell kann das Limit Input-Tokens, Output-Tokens, gecachte Tokens oder getrennte Input- und Output-Buckets berücksichtigen. Langkontext-Retrieval, Gesprächsverlauf, ausführliche Ausgaben, Generierung mehrerer Kandidaten und parallele Evals belasten meist TPM vor RPM.
Concurrency: Laufende Arbeit
Concurrency ist nicht RPM. Ein System kann nur 60 Requests pro Minute senden und trotzdem eine hohe Concurrency haben, wenn jede Generierung 20 Sekunden dauert. Streaming und langlaufende Tool-Calls machen das sichtbar. Begrenzte Worker-Pools und Queue-Depth sind meist bessere Steuerungen als mehr Retries.
Tägliche Limits und Spend-Limits
Einige Limits erholen sich nicht nach einem kurzen Schlaf. Tägliche Request-Limits, tägliche Token-Limits, monatliche Ausgabenlimits und Abrechnungsbeschränkungen sollten Wiederholungen in der Regel stoppen. Die richtige Maßnahme ist, neu zu terminieren, das Tier anzuheben, das Budget anzupassen oder dem Nutzer mitzuteilen, dass die Kapazität erschöpft ist.
Warum Sie 429 unterhalb des angegebenen Limits erhalten können
Ein veröffentlichtes Limit wie „1.000 RPM“ bedeutet selten, dass ein Client in der ersten Sekunde einer Minute 1.000 Requests senden kann. Anbieter können gleitende Zeitfenster, Token-Buckets, Modell-Pools, burstspezifische Regeln je Tier, Beschränkungen für Beschleunigung oder gemeinsam genutzte Projektkontingente durchsetzen.
Ein Request kann 429 Too Many Requests erhalten, selbst wenn ein lokaler Zähler unkritisch aussieht, weil:
- Mehrere Worker, Nutzer, Services oder Umgebungen dasselbe Account-Limit teilen.
- Ein- und Ausgabe-Token in unterschiedlichen Buckets gezählt werden.
- Ein Modell einen kleineren Pool hat als ein anderes Modell.
- Wiederholungen aus früheren Fehlern weiterhin Request-Kapazität verbrauchen.
- Die Verkehrszunahme für die Beschränkungen der Beschleunigung zu steil ist.
- Eine Regel für täglich, Ausgaben, Workspace oder Service-Tier aktiv ist.
- Der Anbieter ein generisches
429für mehrere Kapazitätsrichtlinien zurückgibt.
Deshalb sollte LLM-Rate-Limits erklärt: RPM, TPM und Retries mit der Klassifizierung beginnen, nicht mit Code. Protokollieren Sie den Statuscode, den Fehlertyp des Anbieters, Response-Header, Modell, Account oder Projekt, Token-Schätzung, tatsächliche Token, Versuchszahl, Warteschlangenverzögerung und die Request-ID des Anbieters, wenn verfügbar.
Kapazitätsplanungsformel
Beginnen Sie mit unabhängigen Obergrenzen für Requests und Token und arbeiten Sie dann unterhalb des Maximums.
request_ceiling = RPM * safety_factor

token_ceiling = (TPM * safety_factor) / average_total_tokens_per_request

safe_requests_per_minute = min(request_ceiling, token_ceiling)
Verwenden Sie einen Sicherheitsfaktor wie 0.70 bis 0.90, abhängig von der Token-Varianz, gemeinsam genutzten Verbrauchern, dem Wiederholungsverhalten und davon, wie teuer verfehlte Latenzziele sind.
Beispiel:
RPM = 1,000
TPM = 2,000,000
average_total_tokens_per_request = 4,000
safety_factor = 0.80

request_ceiling = 1,000 * 0.80 = 800 requests/minute

token_ceiling = (2,000,000 * 0.80) / 4,000 = 400 requests/minute

safe_requests_per_minute = min(800, 400) = 400 requests/minute
In diesem Beispiel ist TPM die bindende Einschränkung. Mehr Worker zu addieren, erhöht den nachhaltigen Durchsatz nicht. Es führt zu mehr Warteschlangenbildung, mehr Wiederholungen oder mehr 429-Fehlern.
Für Online-Systeme übersetzen Sie die sichere Request-Rate in einen Ausgangspunkt für die Parallelität:
target_concurrency ~= requests_per_second * average_request_seconds
Wenn die sichere Rate 400 Requests pro Minute beträgt, sind das etwa 6,67 Requests pro Sekunde. Wenn die durchschnittliche Modell-Latenz 3 Sekunden beträgt, liegt ein guter Startwert für die Parallelität bei etwa 20. Stimmen Sie gegen p95- und p99-Latenz ab, nicht nur gegen Durchschnittswerte.
Token-Reservierung für TPM-Sicherheit
TPM-Vorfälle entstehen oft durch optimistische Planung. Die Anwendung nimmt Arbeit auf Grundlage erwarteter Token an, aber das Modell erzeugt eine längere Ausgabe als geplant.
Ein sichererer Scheduler reserviert Token, bevor der Request gesendet wird:
reservation:
  workload: support_answer
  model_route: primary_chat_route
  request_id: req_8f3a
  estimated_input_tokens: 3200
  max_output_tokens: 900
  reserved_total_tokens: 4100
  reservation_expires_at: 2026-10-10T11:03:00Z
Nach der Antwort gleichen Sie reservierte Token mit den tatsächlichen Token ab:
actual_usage:
  input_tokens: 3014
  output_tokens: 622
  total_tokens: 3636
  retry_attempts: 0
  accepted_result: true
Reservieren Sie für die Produktion anhand von p95- oder workload-spezifischen Schätzungen. Verwenden Sie den tatsächlichen Verbrauch für die Kostenzuordnung und Prognosen. Diese Trennung macht LLM API rate limits leichter beherrschbar: Die Zugriffssteuerung verwendet eine sichere Schätzung, während Finanzen und Produkt den tatsächlichen Kostenbetrag pro akzeptiertem Ergebnis prüfen.
Ein Entscheidungsbaum für Rate-Limits
Wenn ein Request abgelehnt wird oder eine Warteschlange wächst, entscheiden Sie die Maßnahme anhand der Ursache.
Hat der Anbieter Retry-After oder einen Reset-Header zurückgegeben?
  yes -> auf den Hinweis warten, wenn er zum Latenzbudget des Aufrufers passt
  no  -> begrenztes exponentielles Backoff mit Jitter für transiente Klassen verwenden

Ist die Ursache ein tägliches Kontingent, Billing, Berechtigung oder ein hartes Ausgabenlimit?
  yes -> nicht erneut versuchen; fehlschlagen, neu terminieren oder Kapazität anfordern
  no  -> fortfahren

Ist RPM die bindende Einschränkung?
  yes -> Requests takten, kleine Arbeit bündeln oder Traffic mit niedriger Priorität in die Warteschlange stellen
  no  -> fortfahren

Ist TPM die bindende Einschränkung?
  yes -> Kontext verkürzen, Ausgabe begrenzen, Token reservieren oder lange Jobs verzögern
  no  -> fortfahren

Ist Parallelität die bindende Einschränkung?
  yes -> Worker reduzieren, Warteschlangen-Deadlines setzen und Backpressure anwenden
  no  -> fortfahren

Ist ein geeigneter Fallback-Pfad gesund und richtlinienseitig genehmigt?
  yes -> nach Verbrauch des Retry-Budgets umleiten
  no  -> einen kontrollierten Fehler zurückgeben
Dieser Entscheidungsbaum ist der Wertbaustein für LLM-Rate-Limits erklärt: RPM, TPM und Retries. Er verhindert, dass die Behandlung von 429 zu einer unbeschränkten Schleife wird, und macht aus LLM-Rate-Limits erklärt: RPM, TPM und Retries statt eines Definitionsthemas einen Incident-Response-Workflow.
Wie man Retry-After verwendet
HTTP Retry-After teilt dem Client mit, wie lange er warten soll, bevor er eine weitere Anfrage stellt. Der RFC definiert es entweder als Verzögerung in Sekunden oder als HTTP-Datum. Die MDN-Referenz zu 429 Too Many Requests beschreibt ebenfalls die Verwendung von Retry-After, um anzugeben, wann der Client erneut versuchen darf.
Praktische Regeln:
- Beachte ein gültiges
Retry-After, wenn es in das Latenzbudget des Aufrufers passt. - Begrenze sehr lange Werte bei interaktiven Aufrufen; lass keine Benutzeranfrage endlos offen.
- Behandle ungültige oder fehlende Werte als Anlass, ein clientseitiges Backoff zu verwenden.
- Versuche nicht, nicht wiederholbare Ursachen erneut anzufragen, nur weil
Retry-Afterfehlt. - Protokolliere den Hinweis des Providers und die tatsächlich verwendete Verzögerung.
Für interaktive Benutzerabläufe ist das Retry-Budget oft kleiner als der Hinweis des Providers. In diesem Fall solltest du schnell mit einer hilfreichen Meldung fehlschlagen oder den Vorgang anderswohin umleiten. Für Batch-Verarbeitung kann Queueing besser sein als eine Fehlermeldung.
Exponentielles Backoff mit Jitter
Exponentielles Backoff erhöht die Verzögerung nach jedem fehlgeschlagenen Versuch. Jitter macht diese Verzögerung zufällig, damit sich Worker nicht synchronisieren und gemeinsam erneut versuchen. Die AWS-Richtlinien zu Backoff und Jitter sind nützlich, weil sie erklären, warum simples begrenztes exponentielles Backoff auch ohne Zufälligkeit zu gebündelten Retries führen kann.
Eine gängige Full-Jitter-Formel:
delay_ms = random(0, min(cap_ms, base_ms * 2^attempt))
Eine produktive Retry-Strategie braucht mehr als nur die Verzögerungsformel:
| Policy Field | Empfohlene Steuerung |
|---|---|
| Retrybare Status | 429, ausgewählte 5xx und vorübergehende Netzwerkfehler |
| Nicht retrybare Status | Validierungsfehler, Authentifizierungsfehler, Berechtigungsfehler, Abrechnungsfehler, Erschöpfung des Tageskontingents |
| Maximale Versuche | Kleine Anzahl für interaktive Aufrufe; größer nur für Offline-Jobs |
| Maximale vergangene Zeit | Begrenzt durch das sichtbare Latenzbudget des Nutzers oder die Job-Deadline |
| Jitter | Erforderlich für Systeme mit mehreren Workern |
| Retry-After | Verwenden, wenn gültig und vertretbar |
| Abbruch | Sofort stoppen, wenn der Aufrufer abbricht |
| Beobachtbarkeit | Versuchszahl, Wartezeit, finaler Status, Request-ID, Queue-Verzögerung |
Erfolglosen Anfragen können dennoch Rate-Limit-Kapazität verbrauchen. Deshalb müssen Retries Teil der Rate-Limit-Planung sein und nicht nur ein nachträglicher Gedanke.
TypeScript-Retry-Helper für OpenAI-kompatible APIs
Dieser Helper verwendet Retry-After, wenn vorhanden, ansonsten Full Jitter. Er stoppt, wenn die Anzahl der Versuche oder die vergangene Zeit aufgebraucht ist.
type ChatRequest = {
  model: string;
  messages: Array<{ role: "system" | "user" | "assistant"; content: string }>;
  max_tokens?: number;
};

const sleep = (milliseconds: number) =>
  new Promise((resolve) => setTimeout(resolve, milliseconds));

function retryAfterMilliseconds(response: Response): number | null {
  const value = response.headers.get("retry-after");
  if (!value) return null;

  const seconds = Number(value);
  if (Number.isFinite(seconds)) return Math.max(0, seconds * 1_000);

  const date = Date.parse(value);
  return Number.isNaN(date) ? null : Math.max(0, date - Date.now());
}

export async function createChatCompletion(
  apiKey: string,
  request: ChatRequest,
  options: { maxAttempts?: number; maxElapsedMs?: number } = {},
) {
  const maxAttempts = options.maxAttempts ?? 4;
  const maxElapsedMs = options.maxElapsedMs ?? 30_000;
  const startedAt = Date.now();

  for (let attempt = 0; attempt < maxAttempts; attempt += 1) {
    const response = await fetch("https://router.flatkey.ai/v1/chat/completions", {
      method: "POST",
      headers: {
        Authorization: `Bearer ${apiKey}`,
        "Content-Type": "application/json",
      },
      body: JSON.stringify(request),
    });

    if (response.ok) return response.json();

    const retryable = response.status === 429 || response.status >= 500;
    const finalAttempt = attempt === maxAttempts - 1;
    if (!retryable || finalAttempt) {
      throw new Error(`LLM request failed with ${response.status}: ${await response.text()}`);
    }

    const serverDelay = retryAfterMilliseconds(response);
    const exponentialCap = Math.min(8_000, 500 * 2 ** attempt);
    const jitteredDelay = Math.random() * exponentialCap;
    const delayMs = serverDelay ?? jitteredDelay;

    if (Date.now() + delayMs - startedAt >= maxElapsedMs) {
      throw new Error("LLM retry budget exhausted");
    }

    await sleep(delayMs);
  }

  throw new Error("Unreachable retry state");
}
Füge vor dem produktiven Einsatz Request-Timeouts, strukturierte Fehlerklassen, Telemetrie und Abbruchunterstützung hinzu. Wenn der Aufruf externe Nebenwirkungen erzeugen kann, mache den Geschäftsvorgang vor dem erneuten Versuch idempotent.
Retry, Queue, Reduce oder Route?
Ein robustes System hat mehr als eine Reaktion auf Throttling.
| Situation | Retry | Queue | Tokens reduzieren | Anderswohin routen |
|---|---|---|---|---|
Ein einzelner kurzer vorübergehender 429 |
Ja, begrenzt | Optional | Nein | Meistens nein |
| Anhaltende RPM-Erschöpfung | Sehr begrenzt | Ja | Meistens nein | Manchmal |
| Anhaltende TPM-Erschöpfung | Sehr begrenzt | Ja | Ja | Manchmal |
| Tägliches Kontingent erschöpft | Nein | Nur wenn ein späterer Reset akzeptabel ist | Nein | Vielleicht |
| Abrechnungs- oder Berechtigungsfehler | Nein | Nein | Nein | Nein, zuerst den Zugriff beheben |
| Provider-Überlastung mit gesundem Fallback | Kurzzeitig | Optional | Nein | Ja, nach Policy-Prüfung |
| Teilweiser Stream bereits geliefert | In der Regel kein Replay | Vielleicht fortsetzen oder explizit neu starten | Vielleicht | Nur mit klarer Semantik |
Queueing schützt den Provider und die User Experience, wenn Arbeit warten kann. Token-Reduktion schützt TPM. Routing schützt die Verfügbarkeit nur dann, wenn der alternative Pfad denselben Produktvertrag erfüllt.
Für musterbezogene Überlastungsfälle verwenden Sie das API-Fehler-529-overloaded-Playbook. Für Kostenauswirkungen verbinden Sie Retry- und Fallback-Verhalten mit AI-Gateway-Preisen und wie man KI-Modellpreise vor einem Providerwechsel vergleicht.
Rate Limits in Modelbewertungen
Rate Limits können einen Modellvergleich ungültig machen.
Wenn Modell A mit 10 Workern getestet wird und Modell B mit 100 Workern, kann Modell B langsamer erscheinen, weil das Test-Setup Queueing und Retries verursacht hat. Diese Messung sagt mehr über die Testkonfiguration als über die Modelllatenz aus.
Für belastbare Bewertungen:
- Trennen Sie Modelllatenz, Queue-Verzögerung und Retry-Verzögerung.
- Verwenden Sie für jeden Pfad denselben Ankunftsprozess oder ein normalisiertes Auslastungsniveau.
- Fahren Sie Traffic bei Providern mit Beschleunigungssteuerungen schrittweise hoch.
- Erfassen Sie Tokens und Versuche pro abgeschlossenem Task.
- Berichten Sie First-Attempt-Erfolgsrate und letztendliche Erfolgsrate getrennt.
- Vergleichen Sie die Kosten pro akzeptiertem Task, nicht nur den Tokenpreis.
- Führen Sie Überlastungstests getrennt von Qualitätstests aus.
Das ist besonders wichtig für kostenlose oder niedrig gestaffelte Konten. Der Artikel kostenlose LLM-APIs ist ein hilfreicher Kontext, da kostenlose Limits oft für Exploration und nicht für Produktionslast ausgelegt sind.
Metriken, auf die Sie Alarme setzen sollten
Verfolgen Sie diese nach Provider, Modell, Route, Tenant, Workload und Umgebung:
- Anfragen pro Minute.
- Eingabetokens pro Minute und Ausgabetokens pro Minute.
- Geschätzte reservierte Tokens gegenüber tatsächlich verwendeten Tokens.
- Queue-Tiefe und Alter des ältesten wartenden Elements.
- Zeit, die auf Rate-Kapazität gewartet wird.
- First-Attempt-Erfolgsrate.
- Retry-Versuche pro erfolgreicher Anfrage.
429-Rate nach klassifizierter Ursache.- Retry-Verstärkung: Gesamtzahl der Versuche geteilt durch erfolgreiche Ergebnisse.
- Fallback-Rate und Fallback-Ergebnis.
- End-to-End-Latenz p50, p95 und p99.
- Kosten pro erfolgreichem oder akzeptiertem Task.
Die generativen KI-Semantic Conventions von OpenTelemetry können helfen, Modell-, Operations-, Token-, Response- und Error-Telemetrie zu standardisieren. Behalten Sie auch produktbezogene Dimensionen bei: Kunde, Workspace, Traffic-Klasse, Umgebung, Feature und Owner.
Ein Alarm nur auf die gesamte 429-Anzahl ist verrauscht. Ein besseres Signal kombiniert Throttling-Rate, Queue-Alter, Retry-Verstärkung und endgültige Fehlerquote.
Eine Produktionsarchitektur für Rate Limits
Ein robuster Request-Pfad hat in der Regel sieben Steuerungsebenen:
client
  -> admission control
  -> priority queue
  -> token reservation
  -> RPM + TPM limiter
  -> provider/model route
  -> bounded retry controller
  -> contract-safe fallback
  -> usage, cost, and latency ledger
Verwenden Sie Admission Control, wenn die Queue die Deadline des Aufrufers nicht einhalten kann. Verwenden Sie Prioritätsqueues, damit nicht-kritische Evaluierungen den Produktionsverkehr nicht verdrängen. Verwenden Sie Token-Reservierung, um TPM korrekt zu halten. Verwenden Sie einen zentralen Retry-Controller, damit SDK-, Queue-, Gateway- und Worker-Ebenen nicht alle unabhängig voneinander erneut versuchen.
Das Nutzungs-Ledger sollte Folgendes erfassen:
rate_limit_event:
  request_id: req_8f3a
  workspace_id: ws_42
  environment: production
  workflow: support_answer
  route_requested: primary_chat_route
  route_final: fallback_chat_route
  estimated_input_tokens: 3200
  max_output_tokens: 900
  actual_input_tokens: 3014
  actual_output_tokens: 622
  attempt_count: 2
  retry_delay_ms: 740
  queue_delay_ms: 1180
  final_status: success
  classified_limit: transient_rpm_burst
  accepted_result: true
Damit lassen sich LLM-API-Rate-Limits nach einem Vorfall nachvollziehen. Außerdem erhalten Finanz- und Produktteams die nötigen Belege, wenn Retries oder Fallbacks die Kosten pro akzeptiertem Ergebnis verändern.
Wie Flatkey hineinpasst
Flatkey gibt Teams einen API-Key und eine OpenAI-kompatible Base-URL für unterstützte Modellrouten. Das entfernt keine upstream LLM-Rate-Limits. Es bietet Teams jedoch eine einzige Integrationsoberfläche, auf der Routing, Nutzungsprüfung und Richtlinien über verschiedene Provider hinweg konsistent gemacht werden können.
Für den Workflow LLM Rate Limits Explained: RPM, TPM, and Retries hilft eine Gateway-Ebene, wenn:
- Ihre Anwendung benötigt eine einzelne Retry-, Queue- und Fallback-Policy statt pro Anbieter verteilter Logik über verschiedene Services hinweg.
- Produktteams müssen Route-Health, Latenz, Tokens und die Kosten akzeptierter Ergebnisse in einem einzigen Ledger vergleichen.
- Plattformteams benötigen Modell-Allowlists, Sub-Key-Budgets und Nutzungssteuerungen nach Umgebung oder Workflow.
- Die Finanzabteilung braucht einen einzigen Kontostand, eine Rechnung und Nachweise auf Anfrageebene statt voneinander getrennter Anbieter-Dashboards.
- Operatoren müssen berechtigten Traffic verschieben können, wenn eine Route eingeschränkt ist, ohne das Application-SDK neu zu schreiben.
Das Gateway sollte dennoch modelspezifische Verträge beibehalten. Routen Sie nicht von einem Modell zu einem anderen, außer Kontextfenster, Tool-Verhalten, strukturierte Ausgabe, Sicherheitsrichtlinien, Datenkontrollen, Latenz und Kosten für diesen Workload akzeptabel sind. Prüfen Sie die aktuelle Verfügbarkeit der Routen und die Preise im Flatkey model directory und in der Flatkey pricing vor dem Produktionsstart.
Häufige Fehler
RPM als Parallelität zu behandeln
RPM misst Aufnahmen über die Zeit. Parallelität misst laufende Arbeit. Langsame Generierungen können bei moderatem RPM eine hohe Parallelität erzeugen.
Jeden 429 sofort erneut zu versuchen
Sofortige Retries synchronisieren Worker und verbrauchen mehr Kapazität. Beachten Sie Retry-After, wenn er gültig ist, fügen Sie Jitter hinzu und begrenzen Sie das Retry-Budget.
Einen Limiter für jedes Modell zu verwenden
Anbieter können separate Modell-Pools oder gemeinsame Konto-Pools verwenden. Der Limiter sollte dem dokumentierten Umfang der Quote und den beobachteten Response-Headern folgen.
Gemeinsame Verbraucher zu ignorieren
Ein Dashboard, ein Evaluierungs-Runner, ein Coding-Agent und eine Produktions-API können sich ein Projekt teilen. Reservieren Sie Kapazität nach Workload und isolieren Sie kritischen Traffic, wo möglich.
Teilweise Streams erneut zu versuchen
Sobald Tokens den Nutzer erreicht haben oder eine Tool-Aktion ausgeführt wurde, kann eine stille Wiederholung Ausgabe oder Seiteneffekte duplizieren. Definieren Sie Semantik für Fortsetzen, Neustart oder Idempotenz ausdrücklich.
Nur die Latenz des Anbieters zu messen
Die Endnutzer-Latenz umfasst Queue-Verzögerung, Retry-Verzögerung, Fallback-Verzögerung und Modell-Latenz. Alarmieren Sie auf dem gesamten Pfad und halten Sie die Komponenten getrennt.
FAQ
Was ist der Unterschied zwischen RPM und TPM?
RPM begrenzt, wie viele Requests über die Zeit angenommen werden. TPM begrenzt, wie viele Input- und/oder Output-Tokens angenommen werden. Kurze Prompts stoßen normalerweise zuerst an RPM; Workloads mit langem Kontext oder hoher Ausgabe stoßen oft zuerst an TPM.
Warum erhalte ich 429-Fehler unter meinem RPM-Limit?
Der Anbieter kann Rolling Windows, Token Buckets, gemeinsame Konto-Quoten, separate Token-Limits, modelspezifische Pools, Tageslimits oder Beschleunigungskontrollen durchsetzen. Ihr lokaler Request-Zähler bildet den vollständigen Quotenbereich möglicherweise nicht ab.
Sollte ich jeden 429 erneut versuchen?
Nein. Wiederholen Sie kurzzeitiges Throttling mit kleinem Budget und Jitter. Versuchen Sie nicht wiederholt tägliche Quotenerschöpfung, Abrechnungsbeschränkungen, Berechtigungsfehler, Validierungsfehler oder anhaltende Überlast, bei der es kein realistisches Erholungsfenster gibt.
Garantiert exponentielles Backoff Erfolg?
Nein. Backoff reduziert Kollisionen und gibt vorübergehender Kapazität Zeit zur Erholung. Es kann keine Quote erzeugen. Anhaltende Erschöpfung erfordert geringere Nachfrage, mehr Kapazität, verzögerte Arbeit oder eine andere zulässige Route.
Zählen Retries gegen Rate Limits?
Das können sie. Anbieter können erfolglose Requests oder Versuche auf aktive Limits anrechnen, daher muss Retry-Verstärkung überwacht und begrenzt werden.
Wie viele Retries sollte ein LLM-Request verwenden?
Es gibt keine universelle Zahl. Legen Sie die Versuche anhand des für den Nutzer sichtbaren Latenzbudgets und des Fehlermodus fest. Interaktive Anwendungen benötigen normalerweise nur wenige kurze Versuche, bevor sie fehlschlagen oder routen; Offline-Jobs können längere Queues tolerieren.
Abschließende Checkliste
Verwenden Sie diese Checkliste, wenn Sie LLM-Rate-Limits erklärt: RPM, TPM und Retries in der Produktion implementieren:
- Modellieren Sie RPM, TPM, Tageslimits, Ausgabenlimits und Parallelität getrennt.
- Berechnen Sie die Kapazität aus dem Minimum von Request- und Token-Obergrenzen.
- Betreiben Sie das System unter dem veröffentlichten Maximum mit einem Sicherheitsfaktor.
- Reservieren Sie Tokens vor dem Senden von Requests mit hoher Varianz.
- Verwenden Sie Queues und Taktung für anhaltende Last.
- Beachten Sie
Retry-After, wenn er gültig und bezahlbar ist. - Verwenden Sie exponentielles Backoff mit Jitter, wenn kein gültiger Server-Hinweis existiert.
- Begrenzen Sie Versuche und die gesamte Retry-Zeit.
- Beenden Sie Retries bei Quoten-, Abrechnungs-, Berechtigungs- und Validierungsfehlern.
- Vermeiden Sie das erneute Abspielen partieller Streams oder nicht-idempotenter Seiteneffekte.
- Routen Sie nur zu Modellen, die den erforderlichen Produktvertrag einhalten.
- Trennen Sie Queue-Verzögerung und Retry-Verzögerung von der Modell-Latenz in Auswertungen.
- Alarmieren Sie auf Retry-Verstärkung und Queue-Alter, nicht nur auf die rohe
429-Anzahl. - Erfassen Sie Request-IDs, Token-Schätzungen, tatsächliche Tokens, Versuche, Fallback-Route und Endergebnis im Nutzungs-Ledger.
Rate Limits sind zuerst Kapazitätsplanungs-Kontrollen und erst danach Fehlermeldungen. Die nachhaltige Erkenntnis aus LLM-Rate-Limits erklärt: RPM, TPM und Retries ist, Request-Frequenz, Token-Durchsatz, Parallelität, Retries und Fallback-Ergebnisse unabhängig voneinander zu messen, damit 429 zu einem verwertbaren Signal statt zu Produktionsrauschen wird.
Quellen
- OpenAI-Dokumentation zu Rate Limits: https://platform.openai.com/docs/guides/rate-limits
- OpenAI Cookbook, Umgang mit Rate Limits: https://cookbook.openai.com/examples/how_to_handle_rate_limits
- Anthropic Rate Limits: https://docs.anthropic.com/en/api/rate-limits
- Gemini API Rate Limits: https://ai.google.dev/gemini-api/docs/rate-limits
- RFC 9110 Retry-After: https://www.rfc-editor.org/rfc/rfc9110.html#name-retry-after
- MDN 429 Too Many Requests: https://developer.mozilla.org/en-US/docs/Web/HTTP/Reference/Status/429
- AWS Architecture Blog, exponentielles Backoff und Jitter: https://aws.amazon.com/blogs/architecture/exponential-backoff-and-jitter/
- OpenTelemetry semantische Konventionen für generative KI: https://opentelemetry.io/docs/specs/semconv/gen-ai/
- Flatkey-Preisgestaltung: https://flatkey.ai/pricing
- Flatkey-Modellverzeichnis: https://flatkey.ai/models