Wenn Sie Gemini und Claude für einen API-Workflow vergleichen, bleiben Sie nicht bei „welches Modell ist besser“ stehen. In der Produktion ist die bessere Frage: Welcher Route sollte diese Anforderungsklasse zugewiesen werden, was soll passieren, wenn sie fehlschlägt, und wie weisen Sie Kosten und Ergebnisqualität nach dem Aufruf nach?
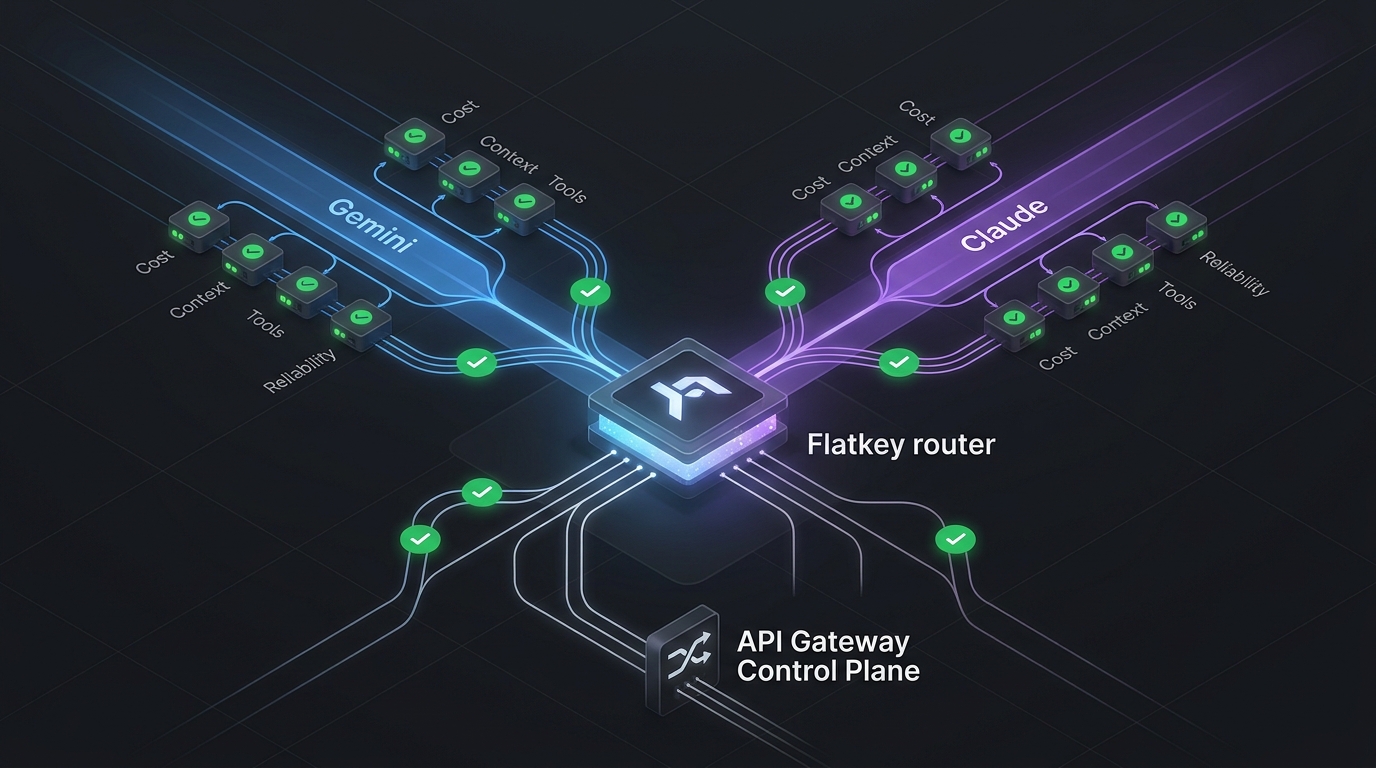
Das ist die praktische Aufgabe von Gemini vs Claude API Routing: Kosten, Kontext, Tools und Zuverlässigkeitsprüfungen. Gemini und Claude unterstützen beide anspruchsvolle Anwendungs-Workloads, aber sie treffen unterschiedliche Kompromisse bei Preiseinheiten, Kontextfenstern, Tool-Aufrufen, strukturiertem Output, Batch-Verarbeitung, Caching, Rate-Limits und operativer Verifikation. Eine Routing-Richtlinie sollte diese Kompromisse vor dem Traffic-Umzug explizit machen.
Dieser Leitfaden gibt Teams eine quellengestützte Checkliste an die Hand, um zu entscheiden, wann zu Gemini geroutet werden sollte, wann zu Claude, und wann beide hinter einem OpenAI-kompatiblen Gateway wie Flatkey platziert werden sollten. Nutzen Sie ihn vor einer Migration, einem Agenten-Launch, einer Prompt-Kostenprüfung oder einer Fallback-Einführung.
Wenn Sie noch das Gateway-Muster selbst auswählen, kombinieren Sie diesen Artikel mit Flatkeys Leitfäden zum Verwenden einer einheitlichen KI-API und zum Verwenden einer OpenAI-API-Alternative. Wenn die Hauptfrage die Messung ist, beginnen Sie zuerst mit dem Framework für AI-Routing-API-Metriken.
Die kurze Antwort für Gemini vs Claude API Routing
Verwenden Sie Gemini als erste Route, wenn der Workload preissensitiv, kontextreich, multimodal oder batchfreundlich ist und Ihr Evaluierungsset eine akzeptable Ausgabequalität bestätigt. Verwenden Sie Claude als erste Route, wenn der Workload starkes Long-Form-Reasoning, sorgfältiges Befolgen von Anweisungen, Tool-Nutzung mit hoher Zuverlässigkeit oder Anthropic-spezifische Agentenfunktionen benötigt. Verwenden Sie eine Gateway-Route, wenn die Anwendung Modelle wechseln soll, ohne SDK-Code neu zu schreiben, Nutzungsprotokolle an einem Ort zu vergleichen oder einen getesteten Fallback bereitzuhalten.
| Routing-Frage | Gemini-Route ist in der Regel attraktiv, wenn... | Claude-Route ist in der Regel attraktiv, wenn... | Vor der Produktion prüfen |
|---|---|---|---|
| Kosten | Die Aufgabe Flash-/Flash-Lite-Modelle, Batch-Rabatte oder günstigere multimodale Input-Einheiten nutzen kann. | Die Aufgabe höhere Kosten pro Token durch eine bessere Akzeptanzrate, weniger Wiederholungsversuche oder geringere Review-Kosten rechtfertigt. | Auf Kosten pro akzeptierter Ausgabe normalisieren, nicht auf den angegebenen Input-Preis. |
| Kontext | Sie benötigen breiten Kontext für Dokumente, Codebasen, Transkripte oder Retrieval-Pakete. | Sie benötigen Long-Context-Reasoning mit Claudes aktuellem Modellportfolio und den Ausgabegrenzen. | Recall, Zitationsdisziplin, Latenz und Fehlermodus bei realen Kontextgrößen testen. |
| Tools | Sie benötigen Function Calling plus Optionen aus dem Google-nativen Tool-Ökosystem. | Sie benötigen Claude-Tool-Use-Muster für Agents, Client-Tools, Server-Tools und strukturierte Tool-Aufrufe. | Dasselbe Tool-Schema ausführen und Argumente, Wiederholungen und ungültige Aufrufe verifizieren. |
| Strukturierte Ausgabe | Sie benötigen die Einhaltung von JSON Schema für typisierte App-Workflows. | Sie benötigen JSON-Output-Kontrollen oder strikte Tool-Use-Muster zur Einhaltung des Schemas. | Geparste Ausgabe gegen Ihr Schema validieren, nicht nur auf visuelle Korrektheit prüfen. |
| Zuverlässigkeit | Sie können die Variabilität der Provider-Rate-Limits mit Queueing oder Fallback auffangen. | Sie können Anthropic-Limits und Tool-Token-Overhead mit Rollout-Kontrollen auffangen. | Provider, Modell, Token-Zahlen, Latenz, Status und Fallback-Grund protokollieren. |
Kurz gesagt: Der Gewinner ist global nur selten „Gemini“ oder „Claude“. Der Gewinner ist die Route, die Ihre workload-spezifischen Prüfungen mit den niedrigsten Kosten pro akzeptierter Ausgabe und dem geringsten operativen Überraschungspotenzial besteht.
Kosten vor dem Vergleich der Modellpreise normalisieren
Der schwierigste Teil von Gemini vs Claude API Routing ist, dass die Preisseiten nicht auf dieselbe Weise aufgebaut sind. Google listet Gemini-Preise nach Modell, Modalität, Input-/Output-Einheit, Batch-Modus und manchmal nach Kontextstufe. Anthropic listet Claude-Preise nach Modellfamilie, Input-/Output-Tokens, Prompt-Caching, Batch-Verarbeitung und feature-spezifischem Token-Overhead.
Beginnen Sie mit einer Kosten-Worksheet statt mit einer Debatte:
| Kostenfeld | Warum es wichtig ist |
|---|---|
| Input-Tokens | Lange Prompts, abgerufene Dokumente, Tool-Schemas und Systemanweisungen können die Kosten pro Anfrage dominieren. |
| Output-Tokens | Agentenpläne, Code-Diffs, JSON-Payloads und Zusammenfassungen können die Kosten in Richtung Completion-Tokens verschieben. |
| Cache-Schreibvorgang und Cache-Lesevorgang | Claude Prompt Caching kann die Wirtschaftlichkeit bei wiederholtem Kontext verändern; Gemini Context Caching sollte geprüft werden, wenn wiederholter Kontext relevant ist. |
| Batch-Rabatt | Google und Anthropic dokumentieren beide Rabatte für Batch-Verarbeitung, aber Batch hilft nur, wenn verzögerte Antworten akzeptabel sind. |
| Tool-Overhead | Tool-Definitionen, Schemas und Zwischenaufrufe von Tools fügen Tokens hinzu. Anthropic dokumentiert die Token-Kosten rund um die Tool-Nutzung ausdrücklich; auch bei Gemini-Tool-Payloads muss der Tokenverbrauch gemessen werden. |
| Retry-Rate | Ein günstigeres Modell kann teuer werden, wenn die Validierung mehr Ausgaben ablehnt. |
| Kosten der menschlichen Prüfung | Für Support-, Rechts-, Finanz- oder Code-Review-Workflows kann die Akzeptanzrate wichtiger sein als der reine Tokenpreis. |
Für Gemini sollten Sie die Seite Gemini API pricing während des Erstellens des Arbeitsblatts geöffnet lassen. Zum Zeitpunkt dieser Quellenprüfung führt Google unterschiedliche Preise für Gemini Flash, Flash-Lite, Pro, Batch und kontextgestaffelte Fälle auf, einschließlich neuerer Gemini-3.x- und Gemini-2.5-Zeilen. Für Claude verwenden Sie die Seite Claude pricing von Anthropic und berücksichtigen Sie Modellstufen, Prompt Caching, Long-Context-Verhalten und Batch-Verarbeitung.
Für tiefergehende Preisanalysen verwenden Sie Flatkeys Gemini API pricing-Leitfaden und Claude API pricing-Leitfaden als Ergänzung und übertragen Sie die endgültigen Zahlen dann zurück in dieses Routing-Arbeitsblatt.
Die Routing-Kennzahl sollte lauten:
accepted_output_cost =
  (input_cost + output_cost + cache_write_cost + cache_read_cost + tool_overhead_cost + retry_cost)
  / accepted_outputs
Diese Formel verhindert einen häufigen Fehler: den niedrigeren angegebenen Input-Preis zu wählen und dabei längere Ausgaben, ungültiges JSON, Tool-Retries oder manuelle Nacharbeit zu ignorieren.
Prüfen Sie Kontextfenster mit echten Payloads
Angaben zum Kontextfenster sind nützlich, aber sie sind nicht dasselbe wie nutzbarer Kontext. Ein Modell kann einen großen Kontext akzeptieren und dennoch eine versteckte Anweisung übersehen, den Überblick über eine Entität verlieren, sich über Ihr SLA hinaus verlangsamen oder eine Antwort erzeugen, die nicht validiert werden kann.
Die Seite Gemini models von Google dokumentiert Modelle mit Langkontext-Optionen, darunter Gemini 2.5 Flash mit einem Kontextfenster von 1 Mio. Tokens. Die Claude models overview von Anthropic dokumentiert die aktuellen Kontext- und Ausgabelimits der Claude-Modelle, einschließlich 1 Mio. Tokens Kontext für mehrere aktuelle Modelle und eines kleineren Fensters für Routen der Haiku-Klasse. Diese Zahlen sind wichtig, aber die Routing-Entscheidung sollte aus Tests kommen.
Führen Sie dasselbe Kontextpaket über die in Frage kommenden Routen aus:
- Eine kurze Prompt-Eingabe ohne abgerufenen Kontext.
- Eine mittlere Prompt-Eingabe mit dem typischen Retrieval-Paket.
- Eine p90-Prompt-Eingabe mit realem Kunden- oder Codebasis-Kontext.
- Eine Worst-Case-Prompt-Eingabe nahe Ihrem Limit.
- Eine degradierte Prompt-Eingabe mit irrelevanten abgerufenen Chunks.
Für jeden Lauf erfassen Sie:
| Kontextmetrik | Was zu erfassen ist |
|---|---|
| Rate akzeptierter Antworten | Hat die Antwort Ihr Rubrik- oder Downstream-Validierungskriterium bestanden? |
| Latenz bei p50 / p90 / p99 | Ist die lange Prompt-Eingabe innerhalb des Produkt-SLA geblieben? |
| Lost-in-context-Fehler | Hat das Modell Fakten mit niedriger Position, Tool-Restriktionen oder letzte Anweisungen ignoriert? |
| Drift der Ausgabe-Länge | Hat langer Kontext zu unnötiger Ausschweifung oder abgeschnittener Ausgabe geführt? |
| Kosten pro akzeptierter Ausgabe | Hat sich die größere Prompt-Eingabe bezahlt gemacht? |
Wenn Gemini den vollständigen Kontext günstig verarbeitet, aber mehr Retries benötigt, leiten Sie engere Aufgaben dorthin und behalten Sie Claude für risikoreiche Schlussfolgerungen. Wenn Claude bei demselben Long-Context-Paket eine höhere Akzeptanz liefert, kann sein höherer roher Tokenpreis nach Review- und Retry-Kosten trotzdem günstiger sein.
Tool-Calling und strukturierte Ausgaben direkt vergleichen
Agenten-Workloads scheitern meist auf langweilige Weise: ein fehlerhaftes Argument, ein erfundener Enum-Wert, ein zusätzlicher Key in JSON, ein zum falschen Zeitpunkt ausgelöster Tool-Call oder eine Antwort, die gut aussieht, aber nicht geparst werden kann. Deshalb braucht Gemini vs Claude API Routing Tool- und Schema-Checks, nicht nur Benchmark-Scores.
Google dokumentiert Function Calling zum Verbinden von Gemini-Modellen mit Tools und zum Zurückgeben von Parametern sowie Structured Output für Antworten auf Basis von JSON Schema. Anthropic dokumentiert Claude Tool Use für Client- und Server-Tools sowie Structured Outputs für schemaorientierte Antworten.
Verwenden Sie ein gemeinsames Test-Harness:
| Test | Bestehendes Verhalten |
|---|---|
| Erforderlicher Tool-Call | Das Modell ruft das richtige Tool auf und antwortet nicht direkt. |
| Ohne-Tool-Fall | Das Modell verzichtet auf einen Tool-Call, wenn bereits genügend Informationen vorhanden sind. |
| Enum-Feld | Das Modell gibt nur erlaubte Enum-Werte zurück. |
| Verschachteltes Objekt | Das Modell füllt erforderliche verschachtelte Felder aus, ohne nicht unterstützte Felder hinzuzufügen. |
| Tool-Fehler | Das Modell versucht es erneut, fragt nach fehlenden Daten oder scheitert gemäß Richtlinie gracefully. |
| Streaming | Teilausgaben brechen Ihren Parser oder die User Experience nicht. |
| Injection-Versuch | Das Modell folgt der System- und Tool-Richtlinie statt feindlichem abgerufenem Text. |
Bewerten Sie nicht zuerst die natürlichsprachliche Antwort. Parsen Sie die Ausgabe, validieren Sie das JSON, prüfen Sie Tool-Argumente und bewerten Sie dann die Antwort. Die Route mit der attraktivsten Prosa kann für einen Agenten trotzdem die falsche Route sein, wenn sie mehr ungültige Aktionen verursacht.
Batching und Caching nur dort verwenden, wo der Workflow es zulässt
Beide Anbieter dokumentieren kostensparende Mechanismen, die eine Routing-Entscheidung verändern können.
Googles Batch API ist für asynchrone Anfragen mit hohem Volumen ausgelegt und nennt ein Standard-Kostenziel von 50 % für geeignete Batch-Workloads. Auch die Dokumentation zu Anthropic's Message Batches beschreibt eine Kostenreduktion von 50 % für die Batch-Verarbeitung, wobei die meisten Batches in weniger als einer Stunde abgeschlossen werden und dokumentierte Beschränkungen für die Anfragegröße gelten.
Batch eignet sich gut für:
- Offline-Klassifizierung.
- Backfills.
- Dataset-Labeling.
- Große Evaluierungsdurchläufe.
- Wöchentliche Berichtserstellung.
- Nicht dringende Zusammenfassungen.
Batch eignet sich weniger gut für:
- Chat-Turns.
- Support in Echtzeit.
- Innere Loops von Coding-Agents.
- Wiederholungsversuche mit Nutzerbezug.
- Jeden Workflow, bei dem veraltete Ausgaben teuer sind.
Caching hat eine andere Ausprägung. Wenn sich Ihre Prompts in einer großen Richtlinie, einer Codebasis-Karte, einem Produktkatalog oder einer Vertragsschablone wiederholen, können Cache-Lesevorgänge eine höherwertige Route wirtschaftlich sinnvoll machen. Wenn Prompts größtenteils einzigartig sind, hilft Caching möglicherweise nicht. Für Claude enthält die Preisseite von Anthropic Multiplikatoren für das Schreiben und Lesen von Prompt-Cache; für Gemini sollten Sie die aktuellen Doku zu Context Caching und die Preiszeile prüfen, bevor Sie davon ausgehen, dass die Einsparungen für Ihren Workload gelten.
Die Routing-Regel sollte einfach sein:
route_policy:
  realtime_user_request:
    primary: low_latency_model_that_passes_schema_tests
    fallback: safest_validated_model
    batch: false
  offline_backfill:
    primary: lowest_accepted_output_cost
    fallback: retry_later_or_second_provider
    batch: true
  repeated_context_agent:
    primary: best_cache_adjusted_acceptance_rate
    fallback: model_with_shorter_context_pack
    batch: false
Zuverlässigkeitsprüfungen, bevor eine Gemini- oder Claude-Route live geht
Der Status des Anbieters und veröffentlichte Limits sind nur Ausgangspunkte. Google dokumentiert Gemini Rate Limits nach Dimensionen wie Anfragen pro Minute, Eingabe-Token pro Minute, Anfragen pro Tag und spendbasierten Limits, wobei Limits pro Projekt angewendet werden und die tatsächliche Kapazität nicht garantiert ist. Die Dokumentation von Anthropic beschreibt Modellpreise, Kontext-, Tool-, Caching- und Batch-Beschränkungen, die beeinflussen, wie viele Aufrufe Ihr Workflow sicher ausführen kann.
Bevor produktiver Traffic umgestellt wird, führen Sie eine Route-Checkliste aus:
| Prüfung | Was zu verifizieren ist |
|---|---|
| Authentifizierung | Der direkte Provider-Schlüssel oder Gateway-Schlüssel ist dem richtigen Umfeld zugeordnet. |
| Modell-ID | Die genaue Modell-ID ist aktuell und wird vom Kontorouting unterstützt. |
| Anfrageformat | Nachrichten, Tools, JSON-Schema, Streaming und Modalitätsfelder stimmen mit der Route überein. |
| Ratenlimits | Die Traffic-Klasse bleibt innerhalb der RPM-, TPM-, Tages- und Ausgabenbeschränkungen. |
| Fehlermapping | 400-, 401-, 403-, 429-, 5xx-, Timeout- und Anbieter-überlastete Fälle werden auf umsetzbares App-Verhalten abgebildet. |
| Fallback-Richtlinie | Die App weiß, wann auf derselben Route erneut versucht, der Anbieter gewechselt, eine Warteschlange genutzt oder geschlossen fehlgeschlagen werden soll. |
| Kostenprotokoll | Jede Anfrage erfasst Modell, Token-Zahlen, Cache-Nutzung, Batch-Modus, Latenz, Status und Kosten. |
| Ausgabevalidierer | Das Produkt hat einen Validierer für JSON, Tool-Aufrufe, Zitate oder aufgabenspezifische Korrektheit. |
Flatkeys Quickstart zeigt das OpenAI-SDK-Muster: Behalten Sie das SDK bei und ändern Sie die base_url auf https://router.flatkey.ai/v1. Die Flatkey REST API-Übersicht dokumentiert dieselbe OpenAI-kompatible Basis-URL, und der Flatkey-Dokumentationsindex beschreibt einen Schlüssel, ein gemeinsames Guthaben, einen Modellkatalog und Dokumentationen für GPT, Claude, Gemini, DeepSeek und andere Modelle. Nach der ersten Anfrage fordert Flatkeys Quickstart die Nutzer dazu auf, in den Usage Logs Modell, Token-Anzahl, Latenz und Kosten zu prüfen.
Das macht Flatkey nützlich für eine Routing-Einführung: Sie können das Anfrageformat der App stabil halten, das Verhalten von Gemini- und Claude-Routen in den Usage Logs vergleichen und ein getestetes Fallback aktivieren, ohne Provider-Schlüssel über mehrere Services zu verteilen.
Für benachbarte Muster der Routenplanung vergleichen Sie diesen Workflow mit Flatkeys Gemini API for agents-Checkliste und dem Artikel DeepSeek vs Qwen API routing checks.
Eine praktische Routing-Scorecard
Verwenden Sie diese Scorecard für die endgültige Entscheidung. Geben Sie jeder Zeile für Gemini und Claude eine Bewertung von 1 bis 5 und gewichten Sie dann nach Workload.
| Kriterium | Gewichtung | Gemini-Score | Claude-Score | Hinweise |
|---|---|---|---|---|
| Akzeptierte Ausgabekosten | 25% | Wiederholungen, Cache, Batch und Tool-Overhead einbeziehen. | ||
| Schema-Validität | 15% | Parser-Fehler und ungültige Enum-Werte zählen. | ||
| Tool-Call-Präzision | 15% | Falsches Tool, fehlendes Feld und unnötige Tool-Nutzung zählen. | ||
| Kontextzuverlässigkeit | 15% | Bei p50-, p90- und Worst-Case-Prompt-Größen testen. | ||
| Latenz | 10% | Streaming- und Full-Response-Latenz messen. | ||
| Rate-Limit-Spielraum | 10% | Projekt-/Kontolimits vor dem Start prüfen. | ||
| Fehlerwiederherstellung | 10% | Retry-, Fallback- und Human-Review-Pfade verifizieren. |
Zum Beispiel:
- Eine Pipeline zur Hintergrund-Zusammenfassung könnte die akzeptierten Ausgabekosten und Batch-Unterstützung am höchsten gewichten.
- Ein Coding-Agent könnte Tool-Call-Präzision, Latenz und Kontextzuverlässigkeit am höchsten gewichten.
- Ein Kundenservice-Workflow könnte Schema-Validität, Eskalationsverhalten und Review-Kosten am höchsten gewichten.
Die Ausgabe von Gemini vs Claude API Routing sollte eine Policy-Datei sein, kein Besprechungsprotokoll.
routes:
  support_triage:
    primary: gemini-or-claude-route-that-wins-scorecard
    fallback: second-provider-route
    validator: support_ticket_schema_v3
    retry_limit: 1
    fail_closed_when:
      - missing_required_field
      - unsafe_escalation_label
  code_review_agent:
    primary: route-that-wins-tool-and-context-tests
    fallback: route-with-best-safe-summary
    validator: diff_comment_schema_v2
    retry_limit: 0
    fail_closed_when:
      - tool_argument_invalid
      - repository_path_not_in_context
Wie man einen sicheren Flatkey-Vergleich durchführt
Flatkey ist kein Ersatz für Evaluierung. Es ist die Steuerungsebene, die Evaluierung und Rollout erleichtert.
- Wähle einen einzelnen Workload, etwa Support-Triage, Code-Review-Kommentare, Berichtszusammenfassungen oder Extraktion.
- Erstelle einen eingefrorenen Satz aus 50-200 realen Prompts mit erwarteten Ausgaberegeln.
- Wähle einen Gemini-Route und einen Claude-Route aus dem aktuellen Modellkatalog.
- Sende beide nach Möglichkeit durch dasselbe OpenAI-kompatible Request-Format.
- Protokolliere Token-Zahlen, Latenz, Status, Anbieter, Modell, Kosten und Validator-Ergebnis.
- Vergleiche die Kosten pro akzeptierter Ausgabe, nicht den Preis pro Million Tokens.
- Rolle den Gewinner als primär aus und behalte den anderen als überwachte Fallback-Option.
- Führe den Test erneut aus, nachdem sich Anbieterpreise, Modell-IDs, Kontextlimits oder der Gesundheitszustand der Route geändert haben.
Hier zahlt sich ein Gateway aus. Wenn die Anwendung bereits einen OpenAI-kompatiblen Client verwendet, kann Flatkey den ersten Test so klein machen wie eine Änderung an base_url plus eine Änderung der Modellauswahl. Wenn die Route fehlschlägt, rollst du die Route-Policy zurück, statt Anwendungscode neu zu schreiben.
Häufige Fehler beim Gemini-vs-Claude-API-Routing
Fehler 1: Nur Flaggschiff-Modelle vergleichen.
Die meisten produktiven Workflows benötigen nicht für jede Anfrage das teuerste Modell. Vergleichen Sie Routenkategorien: schnell, günstig, langer Kontext, starkes Reasoning, Batch und Fallback.
Fehler 2: Tool-Schemas ignorieren.
Agenten-Prompts enthalten oft große Tool-Definitionen. Messen Sie diese Token und validieren Sie die Tool-Argumente.
Fehler 3: Das Kontextfenster mit Antwortqualität verwechseln.
Ein größeres Kontextfenster ist nur dann nützlich, wenn das Modell zuverlässig die richtigen Teile daraus verwendet.
Fehler 4: Fallback-Semantik vergessen.
Ein Fallback-Modell kann schlechter sein als kein Fallback, wenn es das Ausgabeformat ändert, erforderliche Tools überspringt oder gegen eine Produktrichtlinie verstößt.
Fehler 5: Eine Route ohne Prüfung der Nutzungsprotokolle veröffentlichen.
Ihre Logs sollten das tatsächliche Modell, Token-Zahlen, Latenz, Status, Kosten und den Fallback-Grund anzeigen. Wenn diese Felder fehlen, können Sie die Route unter Last nicht debuggen.
FAQ
Ist Gemini günstiger als Claude?
Manchmal, aber nicht immer nach der Validierung. Gemini hat oft attraktive Listenpreise für Flash-ähnliche Workloads, während Claude gewinnen kann, wenn höhere Akzeptanz, weniger Retries, besseres Tool-Verhalten oder geringere Review-Kosten höhere Token-Preise ausgleichen. Verwenden Sie die Preisseiten der Anbieter und berechnen Sie die Kosten pro akzeptierter Ausgabe.
Ist Claude besser als Gemini für Tool-Aufrufe?
Nicht universell. Claude verfügt über eine starke Dokumentation zur Tool-Nutzung und agentenorientierte Muster, während Gemini Function Calling und strukturierte Ausgaben unterstützt. Die richtige Antwort hängt von Ihrem Tool-Schema, dem Fehlerhandling, Streaming-Anforderungen und den Ergebnissen des Validators ab.
Sollte ich jede Anfrage zuerst über einen Anbieter routen?
Meistens nein. Teilen Sie den Traffic nach Workload-Klasse auf. Eine günstige Batch-Route, eine Realtime-Chat-Route, eine Route für langen Kontext und eine Fallback-Route können alle unterschiedliche Modelle verwenden.
Machen Batch-APIs Realtime-Routen günstiger?
Nein. Batch-Rabatte helfen bei verzögerten Workloads. Sie helfen nicht einem Nutzer, der auf eine Chat-, Support- oder Coding-Agent-Antwort wartet.
Warum Flatkey für Gemini vs Claude API Routing verwenden?
Verwenden Sie Flatkey, wenn Sie eine OpenAI-kompatible Control Plane für Modellauswahl, Nutzungslogs, Kostenprüfung und Fallback-Rollout möchten. Es ist besonders nützlich, wenn eine App bereits ein OpenAI-ähnliches SDK verwendet und Gemini und Claude vergleichen muss, ohne Provider-Keys und Billing-Ansichten über mehrere Services zu verteilen.
Fazit
Gemini vs Claude API Routing: Kosten, Kontext, Tools und Zuverlässigkeitsprüfungen ist kein einmaliger Anbieter-Vergleich. Es ist ein operativer Workflow. Beginnen Sie mit den offiziellen Preisen und Modelldokumentationen, testen Sie Kontext- und Tool-Verhalten mit realen Prompts, bewerten Sie die Kosten pro akzeptierter Ausgabe und halten Sie eine Fallback-Richtlinie bereit, bevor produktiver Traffic umgeschaltet wird.
Wenn Ihr Team Gemini und Claude hinter einem einzigen OpenAI-kompatiblen Gateway vergleichen möchte, beginnen Sie mit dem Flatkey-Quickstart, wählen Sie die Routenkandidaten aus dem aktuellen Modellkatalog aus und verifizieren Sie die ersten Aufrufe in den Nutzungsprotokollen, bevor Sie den Traffic erweitern.