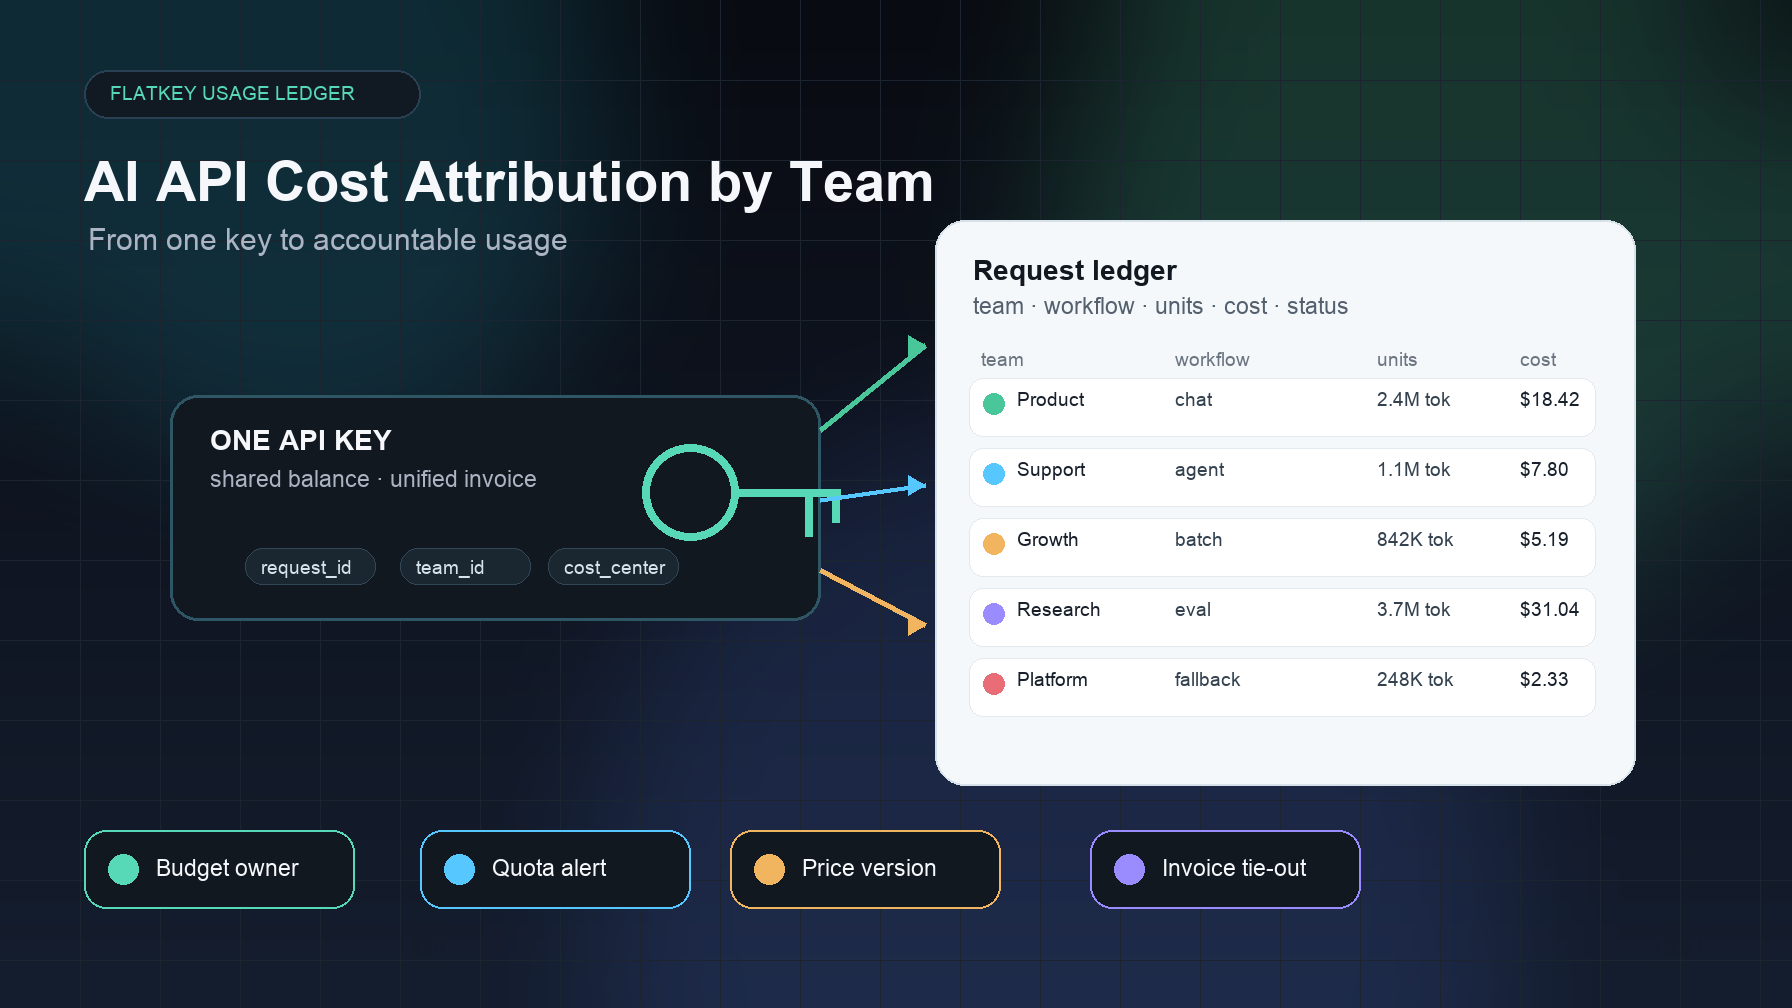
Die Zuordnung von KI-API-Kosten nach Team ist die operative Praxis, jede Modell- und Tool-Anfrage mit dem Team, dem Produktbereich, der Umgebung, dem Workflow und dem Budgetverantwortlichen zu verknüpfen, die bzw. der die Ausgaben verursacht hat. Dadurch wird aus „die KI-Rechnung ist gestiegen“ etwa „die Support-Automatisierung hat den Fallback-Traffic erhöht“, „die nächtliche Eval-Suite hat die Ausgabe-Token verdoppelt“ oder „ein Wachstums-Experiment wurde ohne Quotenprüfung von Staging in die Produktion verschoben“.
Dieser Unterschied ist wichtig, sobald die KI-Nutzung die Prototyp-Phase verlässt. Ein gemeinsamer API-Schlüssel kann die erste Integration einfach machen. Er kann auch die erste ernsthafte Finanzprüfung schmerzhaft machen, wenn das Nutzungsprotokoll nicht erklären kann, welches Team welches Modell verwendet hat, warum der Aufruf erfolgte und ob die Kosten zur Produktion, zu Experimenten, zu internen Tools oder zu kundenorientierter Nutzung gehören.
Dieser Leitfaden gibt KI-Produkt-, Plattform- und Finanzteams ein praxisnahes Modell für die Zuordnung von KI-API-Kosten nach Team: welche Felder erfasst werden sollten, wie sich Schlüssel- und Metadaten-Grenzen trennen lassen, wie gemeinsame Kosten überprüft werden und wie der Übergang von einem Schlüssel zu nachvollziehbarer Nutzung gelingt, ohne jeden Modellaufruf in eine manuelle Tabelle zu verwandeln.
Kurzantwort: Kostenzuordnung braucht Verantwortlichkeit, Nachweise und Prüfung
Die Zuordnung von KI-API-Kosten nach Team funktioniert, wenn sich drei Ebenen gegenseitig bestätigen:
| Ebene | Was sie beantwortet | Praktische Kontrolle |
|---|---|---|
| Verantwortung | Wer ist für diese Ausgaben verantwortlich? | Team, Kostenstelle, Produktbereich, Umgebung, Workflow und Eskalationsverantwortliche/r. |
| Nachweis | Was ist tatsächlich passiert? | Anfrage-ID, Schlüssel oder Route, Modell, Anbieter, Nutzungseinheiten, Status, Wiederholungen, Fallback-Route und Endkosten. |
| Prüfung | Was sollte sich im nächsten Monat ändern? | Showback, Chargeback, Quotenanpassung, Routenprüfung oder Budgetausnahme. |
Wenn eine Ebene fehlt, wird die Zuordnung zum Rätselraten. Wenn der Schlüssel keinen Eigentümer hat, hat die Rechnung kein verantwortliches Team. Wenn die Anfrage keine Metadaten hat, kann das Protokoll Produktion nicht von Testverkehr trennen. Wenn Preiseinheiten nicht mit Zeitstempel versehen sind, werden Kosten für Bilder, Videos, zwischengespeicherte Eingaben und Text-Token unter einer vagen Zeile „KI-Ausgaben“ zusammengefasst.
Das Ziel der Zuordnung von KI-API-Kosten nach Team ist nicht, die Nutzung zu bestrafen. Das Ziel ist, die nächste Budgetentscheidung offensichtlich zu machen: behalten, begrenzen, optimieren, umleiten oder den Workload einstellen.
Warum ein einzelner gemeinsamer Schlüssel die Kostenverantwortung zerstört
Ein einzelner Schlüssel kann weiterhin gesteuert werden, aber nur, wenn er mit Metadaten auf Teamebene und einem verlässlichen Nutzungsprotokoll gekoppelt ist. Die Probleme beginnen, wenn „ein Schlüssel“ so viel bedeutet wie „ein undifferenzierter Topf“.
Häufige Fehlermuster:
- Team-Ambiguität: Support, Growth, Data, Produkt und Engineering erscheinen alle unter derselben Berechtigung.
- Umgebungs-Ambiguität: Entwicklung, Staging, Lasttests, Evaluierungen und Produktionstraffic teilen sich ein Kontingent.
- Workflow-Ambiguität: Agents, Batch-Jobs, Chat, Bilderzeugung, Videoerzeugung und interne Tools werden als eine Kennzahl geprüft.
- Retry-Ambiguität: Fehlgeschlagene Aufrufe, automatische Wiederholungen und Fallback-Routen erzeugen Ausgaben, die niemand eingeplant hat.
- Einheiten-Ambiguität: Eingabetokens, Ausgabetokens, zwischengespeicherte Tokens, Bilder, Videosekunden und Tool-Aufrufe werden erst zu spät normalisiert.
Diese Lücken sind der Grund, warum die AI-API-Kostenverteilung nach Team am Request-Grenzpunkt entworfen werden sollte, nicht erst, wenn die monatliche Rechnung eintrifft.
Für verwandte Kontrollen verbinden Sie diesen Workflow mit AI API spend management, LLM cost tracking by environment, per-customer AI usage metering und AI API invoice reconciliation.
Die Team-Zuordnungsmatrix
Verwenden Sie diese Matrix als zentrales wertstiftendes Asset für Ihre Einführung. Jeder Traffic-Pfad mit hohem Volumen sollte einen verantwortlichen Owner, einen Nutzungsdatensatz und einen Pfad für die Rechnungsprüfung haben.
| Zuordnungsdimension | Wie man sie erfasst | Warum Finance oder Ops das interessiert | Beispielrichtlinie |
|---|---|---|---|
| Team oder Kostenstelle | Vom Team verwalteter Sub-Key, Routenlabel oder Metadaten-Tag. | Ausgaben können vom Budgetverantwortlichen geprüft werden, statt von der Plattform nur geschätzt zu werden. | Growth verantwortet Kampagnen-Agents; Support verantwortet Ticket-Automatisierung; Data verantwortet Evaluierungs-Jobs. |
| Umgebung | Separate Keys für Nicht-Produktivumgebungen oder Umgebungsmetadaten. | Testtraffic sollte nicht die Produktionsreserve verbrauchen. | Entwicklung und Staging erhalten niedrigere harte Obergrenzen; Produktion nutzt Alarme plus Zustimmung des Owners. |
| Workflow | Workflow-Tag für Chat, Eval, Batch, Agent, Bild, Video, Support oder interne Tools. | Unterschiedliche Workflows haben unterschiedliche Toleranzen für Kostenspitzen und Wiederholungen. | Batch-Wiederholungen erfordern eine Prüfung, wenn die Ausgaben das erwartete Laufzeitfenster überschreiten. |
| Kunde oder Workspace | Datenschutzsichere Kunden-ID, Workspace-ID, Tarifstufe oder Segment. | Teams können interne Ausgaben von kundengesteuerter Nutzung trennen. | Enterprise-Workspaces erhalten eine monatliche Nutzungsprüfung; kostenlose Testphasen bekommen strengere Limits. |
| Modell und Modalität | Modell-ID, Endpunktfamilie, Nutzungseinheit, Preisversion und finale Route. | Token-, Bild-, Video- und Tool-Kosten müssen unterschiedlich normalisiert werden. | Routen mit hohen Medienkosten erfordern vor einer Kontingenterhöhung eine explizite Zustimmung des Owners. |
| Retry- und Fallback-Verhalten | Statuscode, Retry-Anzahl, Fallback-Route, Endstatus und Endkosten. | Fehler und Fallbacks können ungeplante Ausgaben verursachen. | Stark fallback-lastige Routen werden wöchentlich geprüft, bis Fehlerrate und Kosten wieder auf dem Ausgangsniveau sind. |
Diese Matrix ist auch die Brücke zwischen Engineering-Telemetrie und Finanzberichterstattung. OpenTelemetry-Generative-AI-Semantic-Conventions können dabei helfen, Operationen, Modell-, Token- und Response-Felder zu standardisieren. FinOps FOCUS kann dem Finanzteam helfen, über Zuordnungsdimensionen nachzudenken. Aber weder das eine noch das andere ersetzt die produktspezifische Entscheidung, wem jeder KI-Workflow gehört und welches Budget die Kosten trägt.
Ein praktischer Workflow zur KI-API-Kostenverteilung
Eine belastbare KI-API-Kostenverteilung nach Team beginnt nicht mit einem Dashboard. Sie beginnt mit einem Request-Vertrag.
1. Definieren Sie das Hauptbuch, bevor Sie Traffic taggen
Notieren Sie die Felder, die Finance, Product und Platform tatsächlich verwenden werden:
| Feld | Beispiel | Zweck |
|---|---|---|
request_id |
req_8f3a2e91 |
Nachverfolgbares Ereignis für Audit und Debugging. |
team_id |
support, growth, platform |
Primärer Budgetverantwortlicher. |
cost_center |
Interner Finanzcode. | Ordnet KI-Ausgaben den Finanzsystemen zu. |
environment |
dev, staging, production, eval |
Trennt Tests vom kundenseitigen Traffic. |
workflow |
support-agent, nightly-eval, image-job |
Erklärt, warum die Anfrage ausgelöst wurde. |
customer_or_workspace_id |
Datenschutzsichere interne ID. | Unterstützt die Überprüfung der Nutzung auf Kundenebene, ohne Inhalte offenzulegen. |
model_id |
Aktuelle Modellroute. | Zeigt, welches Modell die Kosten verursacht hat. |
endpoint_family |
Text, Bild, Video, Tool, Response oder Embedding. | Verhindert, dass reine Token-Berichte Ausgaben ohne Tokens verschleiern. |
usage_units |
Input-Tokens, Output-Tokens, gecachte Tokens, Bilder, Sekunden, Tool-Aufrufe. | Macht die Preisberechnung reproduzierbar. |
pricing_version |
Snapshot-Datum oder Version der Preistabelle. | Macht den Monatsabgleich prüfbar. |
status |
Erfolg, Fehler, Fallback, Retry, abgebrochen. | Trennt beabsichtigte Nutzung von fehlerbedingter Nutzung. |
final_cost |
Normalisierte Gebühr für die Anfrage. | Treibt Showback-, Chargeback- und Kontingententscheidungen an. |
Wenn ein Feld keine Entscheidung verändert, fügen Sie es nicht hinzu. Wenn ein fehlendes Feld eine Rechnungsprüfung blockieren würde, ergänzen Sie es vor dem nächsten Release mit hohem Volumen.
2. Entscheiden Sie, welche Grenzen eigene Schlüssel verdienen
Teilen Sie nicht jede Anfrage in einen neuen Schlüssel auf. Teilen Sie dort auf, wo sich Verantwortlichkeit, Risiko, Kontingent oder Incident-Maßnahmen unterscheiden.
Eine einfache Ausgangsstruktur:
| Grenze | Warum sie eine Trennung verdient |
|---|---|
| Produktiver App-Traffic | Kundenorientierte Zuverlässigkeit und Budgetwarnungen brauchen einen klaren Verantwortlichen. |
| Entwicklung und Staging | Experimente sollten kein Produktionskontingent verbrauchen. |
| Evaluierungs- und Batch-Jobs | Geplante Läufe können große, vorhersehbare Spitzen erzeugen. |
| Support-Automatisierung | Ticketvolumen, Wiederholungsversuche und Eskalations-Workflows brauchen ihre eigene Prüfung. |
| Growth- oder Marketing-Agenten | Kampagnenexperimente brauchen Budgetablauf und Genehmigung. |
| Bild- und Videogenerierung | Nicht-Token-Einheiten brauchen separate Limits und eine Prüfung der Preisgestaltung. |
Hier überschneidet sich die KI-API-Kostenverteilung nach Team mit der Zugriffskontrolle. Wenn zwei Traffic-Klassen unterschiedliche Verantwortliche oder Budgets benötigen, sollten sie nicht hinter demselben ungetaggten gemeinsamen Schlüssel verschwinden.
3. Metadaten hinzufügen, ohne Geheimnisse zu protokollieren
Metadaten sollten Zuständigkeit und Betriebskontext erklären, nicht sensible Inhalte speichern.
Verwenden Sie stabile betriebliche Kennungen:
- Team oder Kostenstelle.
- Umgebung.
- Workflow.
- Interne Kunden- oder Workspace-ID.
- Produktoberfläche.
- Experiment-ID.
- Version der Routing-Richtlinie.
Vermeiden Sie:
- API-Geheimnisse.
- Rohe Prompts.
- Rohe Kundeninhalte.
- Personenbezogene Daten, die für die Rechnungsprüfung nicht erforderlich sind.
- Freitext-Labels, die nicht mit Finanzsystemen verknüpft werden können.
Die Dokumentation von Cloudflare AI Gateway ist hier ein nützliches Muster, da sie Anforderungsmetadaten und Protokollierung als Teil des AI-Gateway-Betriebs behandelt. Die übertragbare Lektion ist einfach: Machen Sie den Kostenkontext strukturiert und abfragbar, während sensible Inhalte aus dem Nachweisweg für die Abrechnung herausgehalten werden.
4. Preise nach Modell, Modalität und Datum normalisieren
Die KI-API-Kostenverteilung nach Team scheitert, wenn jede Kostenart auf "Token" reduziert wird. Textmodelle können Eingabe, Ausgabe, zwischengespeicherte Eingabe, Cache-Schreibvorgänge oder Reasoning-Einheiten abrechnen. Bildgenerierung kann pro Bild, Qualität, Größe oder Bearbeitung abgerechnet werden. Video kann pro Sekunde, Auflösung oder Job abgerechnet werden. Tool-Aufrufe können pro erfolgreicher Aktion abgerechnet werden.
Erfassen Sie:
- Modell-ID.
- Anbieter oder Route.
- Endpunktfamilie.
- Nutzungseinheit.
- Einheitsmenge.
- Datum des Preis-Snapshots.
- Endgültige normalisierte Kosten.
Für die Anbieterauswahl und Routenprüfung kombinieren Sie diesen Artikel mit how to compare AI model prices before switching providers und AI gateway pricing.
5. Kontingente festlegen, nachdem die Zuständigkeit klar ist
Das Kontingentmanagement sollte der Zuständigkeit folgen, nicht umgekehrt. Ein gemeinsames Kontingent sagt Ihnen, dass etwas die Obergrenze erreicht hat. Ein teamverantwortetes Kontingent sagt Ihnen, wer den nächsten Schritt genehmigen sollte.
Verwenden Sie praktische Kontingentstufen:
| Verkehrsklasse | Empfohlene Richtlinie |
|---|---|
| Entwicklung | Niedrige harte Obergrenze; häufig zurücksetzen; keine automatische Erhöhung. |
| Staging | Mittlere Obergrenze; Plattformverantwortlichen alarmieren; außer Kontrolle geratene Evals blockieren. |
| Produktion | Weiche Warnungen bei 50 %, 80 % und 100 %; der Eskalationsverantwortliche genehmigt Erhöhungen. |
| Batch und Eval | Budget nach Laufzeitfenster; vor dem Start eine Schätzung der erwarteten Kosten verlangen. |
| Bild und Video | Separate Medienobergrenze; Genehmigung des Verantwortlichen für höhere Auflösungen oder längere Jobs erforderlich. |
| Gemeinsam genutzte Plattformdienste | Nach Verbrauchsmetrik oder vereinbartem Split zuordnen; monatlich überprüfen. |
An diesem Punkt wird die KI-API-Kostenverteilung nach Team zu einer nachvollziehbaren Nutzung. Das Kontingent ist nicht nur eine technische Grenze. Es ist ein Budgetversprechen.
6. Den Kreislauf Mit Monatlichem Showback Schließen
Der letzte Schritt ist kein Dashboard. Es ist die operative Überprüfung.
Jedes Team sollte eine kompakte monatliche Übersicht erhalten:
- Gesamtausgaben für die KI-API.
- Ausgaben nach Modell, Modalität und Anbieterroute.
- Ausgaben nach Umgebung.
- Top-Workflows.
- Wichtigste Kunden- oder Workspace-Treiber, falls zutreffend.
- Kosten für fehlgeschlagene Aufrufe, Wiederholungen und Fallbacks.
- Kontingentereignisse und Genehmigungsänderungen.
- Nicht zugeordnete oder nicht getaggte Nutzung.
- Auswirkungen auf Verrechnung, Rechnung oder Budget.
Wenn ein Team einen Posten nicht erklären kann, verbergen Sie ihn nicht in einem Plattform-Topf. Beheben Sie den Tag, die Schlüsselschranke oder den Workflow-Datensatz vor dem nächsten Abschlusszyklus.
Wo Flatkey Passt
Flatkey ist als Ein-Schlüssel-Schicht für Teams positioniert, die ein gemeinsames Guthaben, einheitliche Abrechnung, offiziellen Modellerzugriff, Pay-per-Successful-Call-Tools, Nutzungsaufzeichnungen und Governance-Kontrollen über die Nutzung von KI-Modellen und -Tools hinweg wünschen. Die aktuellen öffentlichen Flatkey-Seiten beschreiben einen Schlüssel, ein Guthaben, eine Rechnung, über 100 offizielle Modelle, über 1.000 Pay-per-Call-Tools, Sub-Key-Governance, Budgets, Modell-Allowlists, ein Request-Ledger und Rechnungen innerhalb von 48 Stunden.
Diese Produktform ist für die KI-API-Kostenverteilung nach Team relevant, weil sie das Wuchern von Provider-Konten reduziert und gleichzeitig die Überprüfung der Nutzung ermöglicht. Die wichtige Designentscheidung ist nicht „ein Schlüssel oder viele Schlüssel“. Die wichtige Entscheidung ist, ob die Nutzung weiterhin zuordenbar bleibt, nachdem der Zugriff vereinheitlicht wurde.
Ein praktischer Flatkey-Rollout:
- Bestätigen Sie die aktuellen Modell- und Preisdaten auf Flatkey-Preise, bevor Sie Budgets zuweisen.
- Erstellen Sie Team- oder Workflow-Grenzen für Produktion, Evaluierung, Support-Automatisierung, Growth-Agents und Mediengenerierung.
- Verwenden Sie Owner-Metadaten oder Namenskonventionen, damit Nutzungsaufzeichnungen Ausgaben Teams und Kostenstellen zuordnen können.
- Setzen Sie die Kontingentrichtlinie nach Owner, Umgebung und Modalität.
- Überprüfen Sie monatlich Nutzung, Verrechnungsaufzeichnungen und Rechnungen gemeinsam mit Finance und dem verantwortlichen Team-Owner.
Für den Implementierungskontext beginnen Sie mit dem Flatkey API Quickstart und verbinden Sie dann die operative Überprüfung mit dem Token-Nutzungs-Dashboard für KI-APIs und der Abstimmung von KI-API-Rechnungen.
Was Zu Vermeiden Ist
Schlechte KI-API-Kostenverteilung nach Team wird meist durch übermäßiges Vertrauen in eine einzige Sicht verursacht:
- Verlassen Sie sich nicht nur auf Rechnungen. Die Rechnung belegt die Gesamtausgaben, nicht warum diese Ausgaben entstanden sind.
- Verlassen Sie sich nicht nur auf Dashboards. Ein Dashboard ohne Eigentümerfelder kann keine Budgetentscheidung freigeben.
- Speichern Sie Prompts nicht nur, um Ausgaben zu erklären. Verwenden Sie datenschutzfreundliche IDs und operative Metadaten.
- Vermischen Sie Staging- und Produktionskontingente nicht. Testläufe sollten nicht das Budget für kundenorientierte Nutzung aufbrauchen.
- Behandeln Sie Token-Ausgaben nicht als sämtliche KI-Ausgaben. Bilder, Video, zwischengespeicherte Eingaben, Wiederholungen und Tool-Aufrufe benötigen jeweils ihre eigene Einheitshandhabung.
- Weisen Sie standardmäßig nicht alle gemeinsamen Ausgaben der Plattform zu. Wenn das Plattformteam die Nachfrage nicht steuern kann, sollte es die Kosten nicht stillschweigend tragen.
FAQ
Was ist KI-API-Kostenverteilung nach Team?
KI-API-Kostenverteilung nach Team ist der Prozess, jede Anfrage an ein KI-Modell oder Tool dem Team, dem Workflow, der Umgebung, dem Kundensegment und dem Budgetverantwortlichen zuzuordnen, die die Ausgaben verursacht haben. Dadurch erhalten Produkt-, Plattform- und Finanzteams ein gemeinsames Ledger zur Überprüfung der Nutzung.
Ist ein einzelner API-Schlüssel schlecht für die Kostenverteilung?
Nicht automatisch. Ein einzelner Schlüssel kann funktionieren, wenn er mit Sub-Key-Governance, Routen-Labels, Metadaten, Kontingenten und einem Nutzungs-Ledger auf Anfrageebene kombiniert wird. Das Problem ist ein einzelner ungetaggter gemeinsamer Schlüssel.
Welche Felder sind für die KI-API-Kostenverteilung nach Team erforderlich?
Erfassen Sie mindestens Anfrage-ID, Team, Kostenstelle, Umgebung, Workflow, Modell, Endpunktfamilie, Nutzungseinheiten, Preisversion, Endkosten, Status, Wiederholungsanzahl und gegebenenfalls die Fallback-Route.
Wie sollten Teams gemeinsame KI-Kosten der Plattform zuweisen?
Verwenden Sie eine dokumentierte Regel, bevor der Monat beginnt. Übliche Methoden sind Nutzungsanteil, Anfrageanteil, Tokenanteil, Anteil angenommener Ausgaben oder eine vereinbarte feste Aufteilung für gemeinsame Infrastruktur. Überprüfen Sie nicht zuordenbare Ausgaben monatlich.
Wie hängt das mit dem Abgleich von KI-API-Rechnungen zusammen?
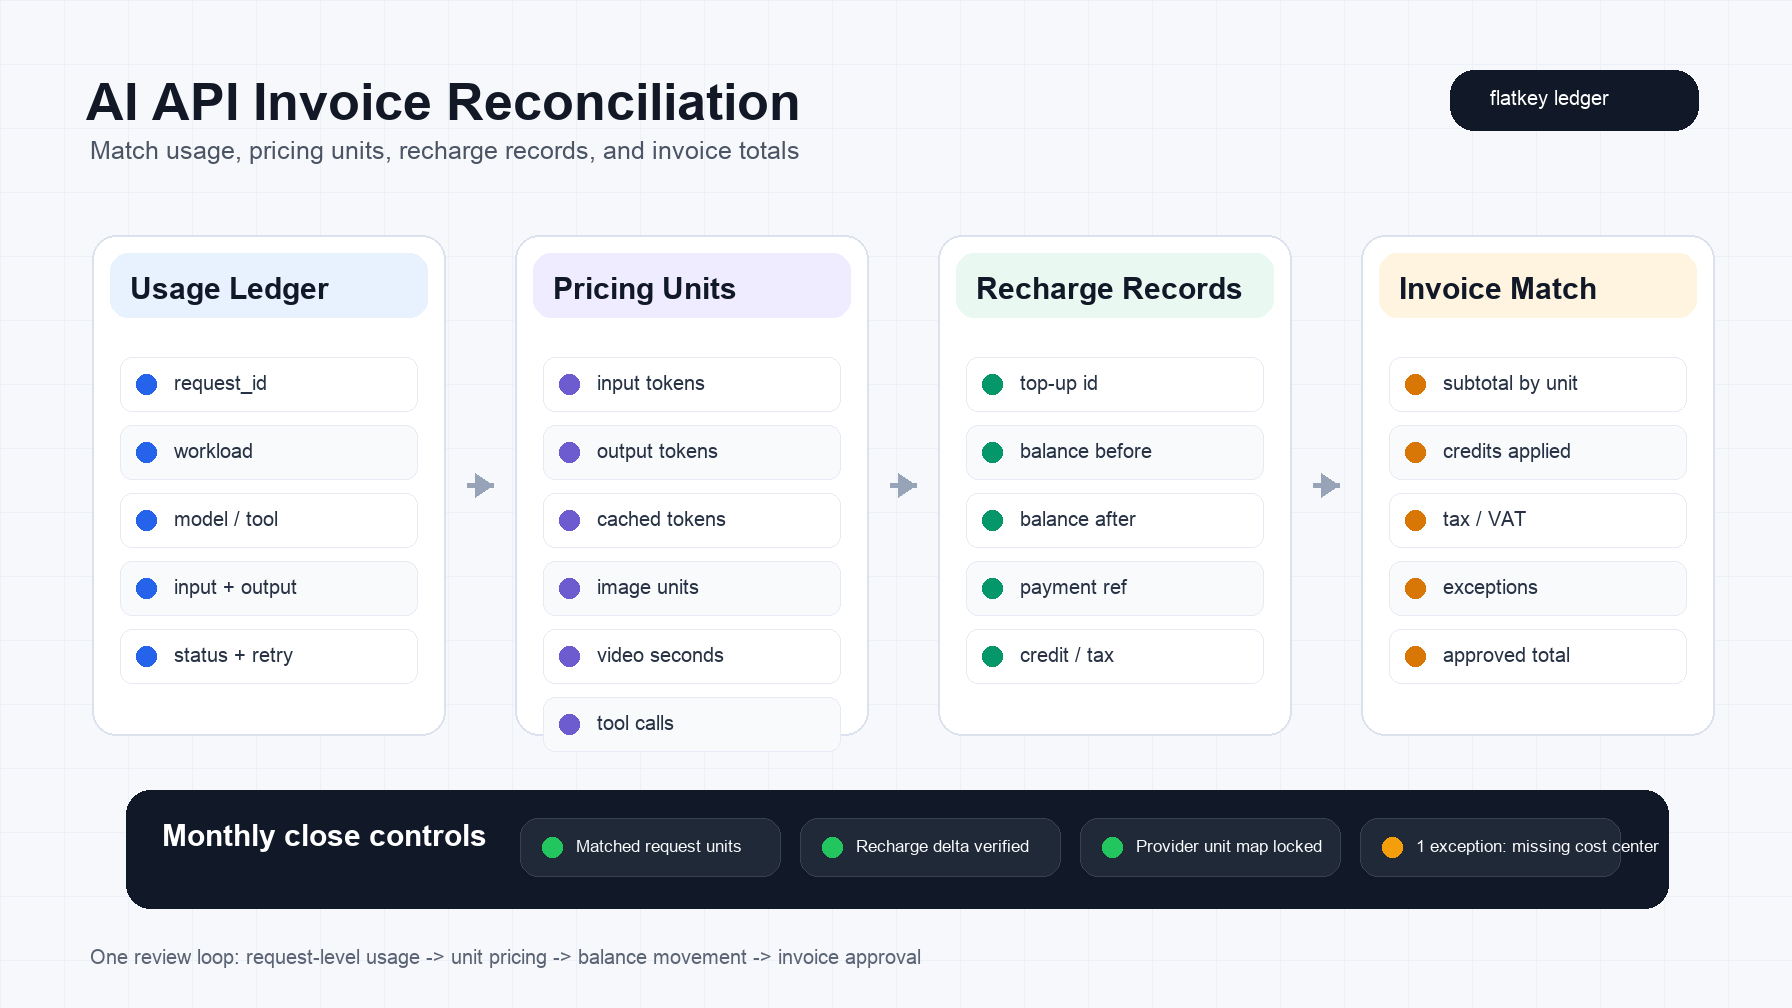
Die Kostenverteilung erklärt, wer die Nutzung verursacht hat. Der Rechnungsabgleich bestätigt, dass Nutzung, Aufladungsdatensätze, Preis-Einheiten, Gutschriften, Steuern und die endgültigen Rechnungssummen übereinstimmen. Sie brauchen beides, um KI-Ausgaben nachvollziehbar zu machen.
Kernaussage
KI-API-Kostenverteilung nach Team: Von einem Schlüssel zu nachvollziehbarer Nutzung bedeutet den Wandel von Zugriffskomfort zu operativer Disziplin. Halten Sie die Integration einfach, aber machen Sie jede relevante Anfrage einem Verantwortlichen, einer Umgebung, einem Workflow, einer Nutzungseinheit und einer Preisversion zuordenbar.
Wenn das Ledger sauber ist, können Teams über Entscheidungen statt über Zahlen streiten: welche Workflows mehr Budget verdienen, welche Routen optimiert werden müssen, welche Experimente beendet werden sollten und welche kundenorientierten Funktionen skalierungswürdig sind.