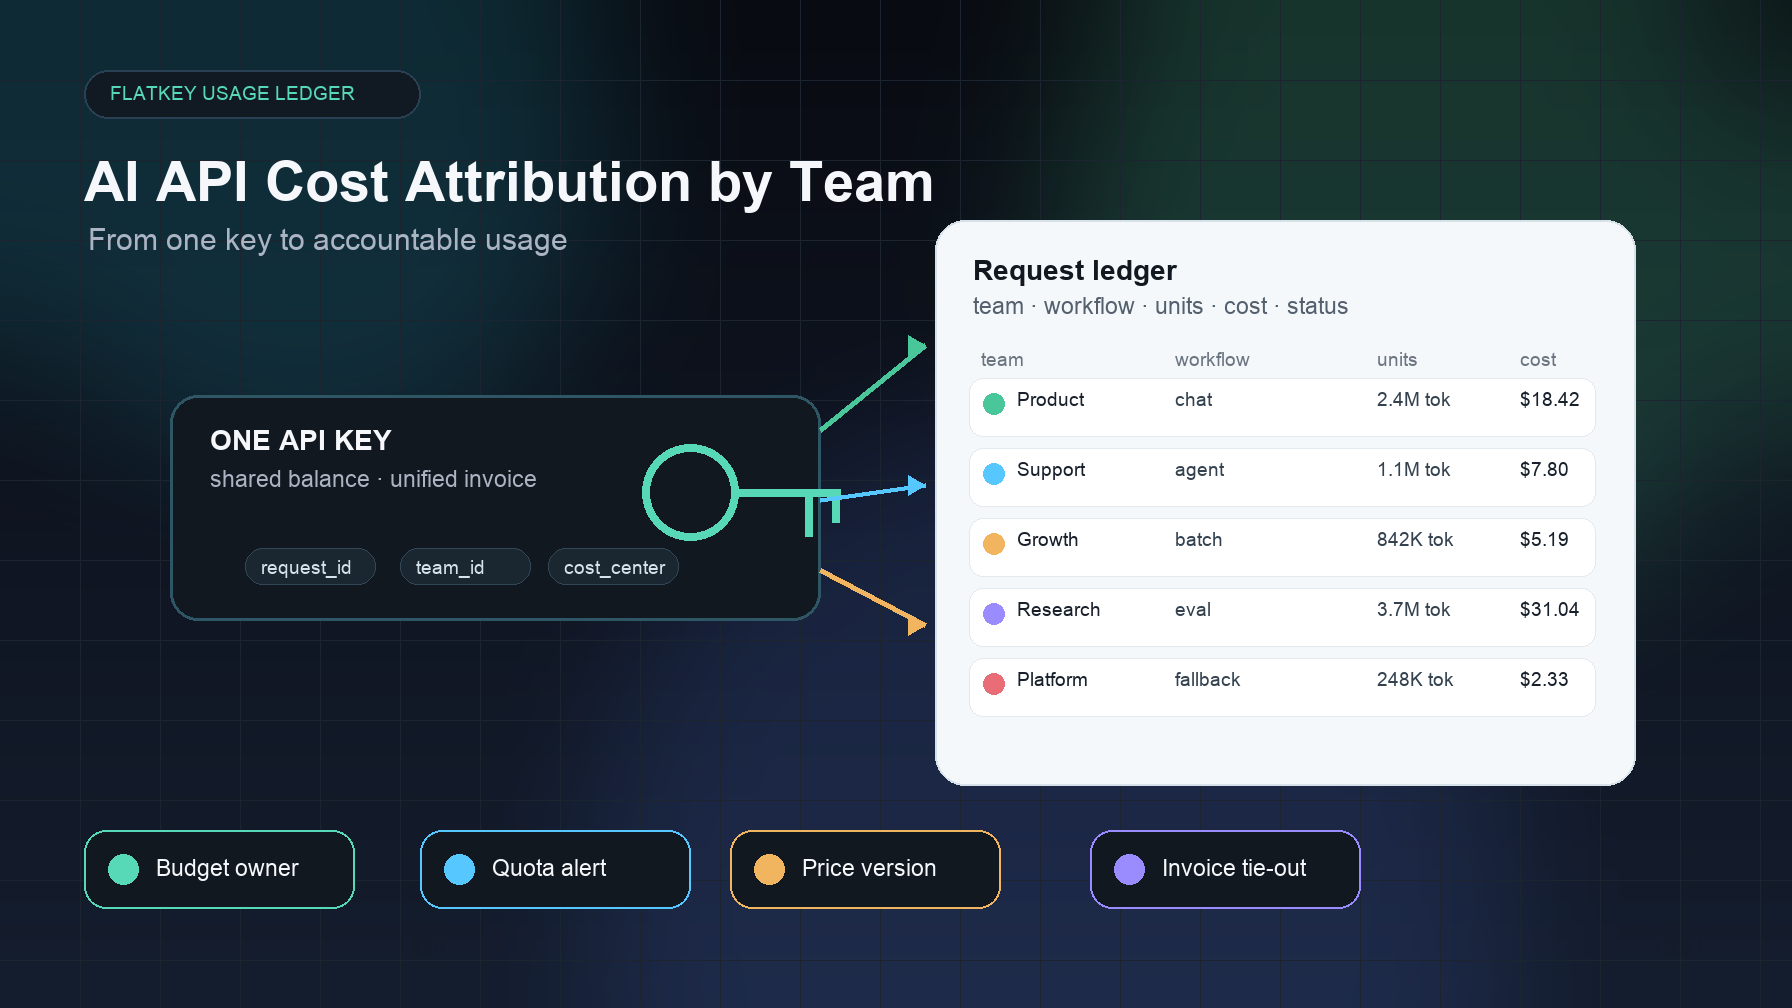
Атрибуция затрат на AI API по командам — это операционная практика, при которой каждый запрос к модели или инструменту связывается с командой, областью продукта, средой, рабочим процессом и владельцем бюджета, которые обусловили эти расходы. Это превращает «счет за AI вырос» в «автоматизация поддержки увеличила трафик на fallback», «ночной набор eval-тестов удвоил число выходных токенов» или «growth-эксперимент перешел из staging в production без проверки квоты».
Это различие становится важным, когда использование AI выходит за рамки стадии прототипа. Один общий API-ключ может упростить первую интеграцию. Но он же может сильно усложнить первую серьезную финансовую проверку, если в журнале использования нельзя понять, какая команда использовала какую модель, почему был выполнен вызов и относится ли стоимость к production, экспериментам, внутренним инструментам или клиентским сценариям.
Это руководство дает командам AI-продукта, платформы и финансов практическую модель для атрибуции затрат на AI API по командам: какие поля нужно собирать, как разделять границы между ключом и метаданными, как проверять общие расходы и как перейти от одного ключа к ответственному использованию, не превращая каждый вызов модели в ручную таблицу.
Краткий ответ: для атрибуции затрат нужны ответственность, подтверждение и проверка
Атрибуция затрат на AI API по командам работает, когда согласованы три уровня:
| Уровень | Что он отвечает | Практический контроль |
|---|---|---|
| Ответственность | Кто отвечает за эти расходы? | Команда, центр затрат, область продукта, среда, рабочий процесс и владелец эскалации. |
| Подтверждение | Что произошло на самом деле? | Идентификатор запроса, ключ или маршрут, модель, провайдер, единицы использования, статус, повторы, fallback-маршрут и итоговая стоимость. |
| Проверка | Что следует изменить в следующем месяце? | Showback, chargeback, корректировка квоты, пересмотр маршрута или исключение из бюджета. |
Если одного уровня не хватает, атрибуция превращается в догадки. Если у ключа нет владельца, у счета нет ответственной команды. Если у запроса нет метаданных, журнал не может отделить production-трафик от трафика оценки. Если единицы тарификации не привязаны ко времени, стоимость изображений, видео, cached-input и текстовых токенов смешивается в одной расплывчатой строке «AI-расходы».
Цель атрибуции затрат на AI API по командам — не наказывать за использование. Цель — сделать следующее бюджетное решение очевидным: сохранить, ограничить, оптимизировать, перенаправить или вывести рабочую нагрузку из эксплуатации.
Почему один общий ключ ломает учет затрат
Один ключ все еще можно контролировать, но только если он связан с метаданными на уровне команды и надежным журналом использования. Проблемы начинаются тогда, когда «один ключ» означает «один недифференцированный пул».
Типичные сбои:
- Неопределённость по командам: поддержка, growth, data, product и engineering выглядят как один и тот же учётный credential.
- Неопределённость по окружению: разработка, staging, нагрузочные тесты, оценки и production-трафик делят одну квоту.
- Неопределённость по рабочим процессам: агенты, batch jobs, чат, генерация изображений, генерация видео и внутренние инструменты рассматриваются как одна цифра.
- Неопределённость из-за повторов: неудачные вызовы, автоматические повторы и fallback-маршруты создают расходы, которые никто не планировал.
- Неопределённость по единицам: входные токены, выходные токены, кэшированные токены, изображения, секунды видео и вызовы инструментов нормализуются слишком поздно.
Именно из-за этих пробелов атрибуцию затрат на AI API по командам следует проектировать на границе запроса, а не после того, как придёт ежемесячный счёт.
Для связанных контролей свяжите этот процесс с управлением расходами на AI API, отслеживанием затрат LLM по окружениям, учётом использования AI по каждому клиенту и сверкой счетов AI API.
Матрица атрибуции по командам
Используйте эту матрицу как ключевой актив ценности для вашего развёртывания. У каждого высоконагруженного пути трафика должен быть один ответственный владелец, одна запись об использовании и один путь проверки биллинга.
| Измерение атрибуции | Как это фиксировать | Почему это важно для финансов или операций | Пример политики |
|---|---|---|---|
| Команда или центр затрат | Подключаемый к команде sub-key, метка маршрута или тег метаданных. | Расходы можно просматривать по владельцу бюджета, а не гадать по платформе. | Growth владеет campaign agents; support владеет автоматизацией тикетов; data владеет eval jobs. |
| Окружение | Отдельные ключи для не-production или метаданные окружения. | Тестовый трафик не должен расходовать запас production. | Разработка и staging получают более низкие жёсткие лимиты; production использует уведомления и одобрение владельца. |
| Рабочий процесс | Тег workflow для чата, eval, batch, agent, image, video, support или внутренних инструментов. | У разных рабочих процессов разная терпимость к скачкам затрат и повторам. | Повторы batch требуют проверки, когда расходы превышают ожидаемое окно выполнения. |
| Клиент или рабочее пространство | Безопасный с точки зрения конфиденциальности customer ID, workspace ID, тарифный план или сегмент. | Команды могут отделять внутренние расходы от использования, вызванного клиентами. | Enterprise workspace получают ежемесячный обзор использования; пробные бесплатные периоды получают более строгие лимиты. |
| Модель и модальность | Model ID, семейство endpoint, единица использования, версия цены и финальный маршрут. | Затраты на токены, изображения, видео и инструменты требуют разной нормализации. | Маршруты медиаконтента с высокой стоимостью требуют явного одобрения владельца до увеличения квоты. |
| Поведение повторов и fallback | Код статуса, число повторов, fallback-маршрут, финальный статус и финальная стоимость. | Ошибки и fallback могут создавать незапланированные расходы. | Маршруты с большим числом fallback рассматриваются еженедельно, пока уровень ошибок и затраты не вернутся к базовому уровню. |
Эта матрица также служит мостом между инженерной телеметрией и финансовой отчетностью. Семантические соглашения OpenTelemetry для генеративного ИИ могут помочь стандартизировать поля операции, модели, токенов и ответа. FinOps FOCUS может помочь финансам мыслить в терминах измерений распределения. Но ни один из них не заменяет специфическое для продукта решение о том, кто владеет каждым AI-рабочим процессом и какой бюджет покрывает затраты.
Практический рабочий процесс атрибуции затрат AI API
Устойчивая атрибуция затрат AI API по командам начинается не с дашборда. Она начинается с контракта на запрос.
1. Определите журнал учета, прежде чем помечать трафик
Зафиксируйте поля, которые действительно будут использовать финансы, продукт и платформа:
| Поле | Пример | Назначение |
|---|---|---|
request_id |
req_8f3a2e91 |
Прослеживаемое событие для аудита и отладки. |
team_id |
support, growth, platform |
Основной владелец бюджета. |
cost_center |
Внутренний финансовый код. | Сопоставляет расходы на AI с финансовыми системами. |
environment |
dev, staging, production, eval |
Отделяет тестирование от трафика, обслуживающего клиентов. |
workflow |
support-agent, nightly-eval, image-job |
Объясняет, почему был выполнен запрос. |
customer_or_workspace_id |
Внутренний ID с учетом конфиденциальности. | Поддерживает проверку использования на уровне клиента без раскрытия содержимого. |
model_id |
Текущий маршрут модели. | Показывает, какая модель определила стоимость. |
endpoint_family |
Text, image, video, tool, response или embedding. | Не позволяет отчетности только по токенам скрывать расходы, не связанные с токенами. |
usage_units |
Входные токены, выходные токены, кэшированные токены, изображения, секунды, вызовы инструментов. | Делает расчет цены воспроизводимым. |
pricing_version |
Дата снимка или версия таблицы цен. | Делает сверку на конец месяца проверяемой. |
status |
Success, error, fallback, retry, canceled. | Отделяет целевое использование от использования, вызванного сбоем. |
final_cost |
Нормализованная стоимость запроса. | Обеспечивает showback, chargeback и решения по квотам. |
Если поле не изменит решение, не добавляйте его. Если отсутствие поля помешает проверке счета, добавьте его до следующего выпуска с высоким объемом.
2. Решите, какие границы заслуживают отдельных ключей
Не разделяйте каждый запрос на новый ключ. Разделяйте там, где отличаются владение, риск, квота или реагирование на инцидент.
Простая стартовая структура:
| Граница | Почему это заслуживает разделения |
|---|---|
| Трафик production-приложения | Надежность для клиентов и оповещения о бюджете нуждаются в четком владельце. |
| Разработка и staging | Эксперименты не должны расходовать production-квоту. |
| Оценка и batch-джобы | Запуски по расписанию могут создавать большие предсказуемые всплески. |
| Автоматизация поддержки | Объем тикетов, повторные попытки и рабочие процессы эскалации нуждаются в отдельном анализе. |
| Агенты роста или маркетинга | Эксперименты кампаний требуют срока действия бюджета и одобрения. |
| Генерация изображений и видео | Не token-единицы нуждаются в отдельных лимитах и пересмотре ценообразования. |
Именно здесь атрибуция затрат на AI API по командам пересекается с контролем доступа. Если двум классам трафика нужны разные владельцы или бюджеты, они не должны исчезать за одним и тем же неотмеченным общим ключом.
3. Добавляйте метаданные, не записывая секреты
Метаданные должны объяснять владение и операционный контекст, а не хранить конфиденциальный контент.
Используйте стабильные операционные идентификаторы:
- Команда или центр затрат.
- Окружение.
- Рабочий процесс.
- Внутренний клиент или ID рабочей области.
- Продуктовая поверхность.
- ID эксперимента.
- Версия политики маршрутизации.
Избегайте:
- API-секретов.
- Сырых промптов.
- Сырого контента клиента.
- Персональных данных, которые не нужны для проверки биллинга.
- Свободных меток, которые нельзя связать с финансовыми системами.
Документация Cloudflare AI Gateway — полезный шаблон здесь, потому что она рассматривает метаданные запросов и логирование как часть операций AI gateway. Переносимый урок прост: делайте контекст затрат структурированным и пригодным для запросов, при этом не выводите конфиденциальный контент на путь подтверждения биллинга.
4. Нормализуйте цены по модели, модальности и дате
Атрибуция затрат на AI API по командам не работает, когда каждая стоимость сводится к «токенам». Текстовые модели могут тарифицировать вход, выход, кэшированный ввод, записи в кэш или единицы рассуждений. Генерация изображений может тарифицироваться по изображению, качеству, размеру или редактированию. Видео может тарифицироваться по секундам, разрешению или задаче. Вызовы инструментов могут тарифицироваться за успешное действие.
Записывайте:
- ID модели.
- Провайдера или маршрут.
- Семейство endpoint.
- Единицу использования.
- Количество единиц.
- Дату снимка цены.
- Итоговую нормализованную стоимость.
Для выбора провайдера и проверки маршрутов дополните эту статью материалами о том, как сравнивать цены AI-моделей перед сменой провайдера и о ценообразовании AI gateway.
5. Устанавливайте квоты после того, как ясна ответственность
Управление квотами должно следовать за ответственностью, а не наоборот. Общая квота говорит вам, что что-то уперлось в потолок. Квота, закрепленная за командой, говорит вам, кто должен одобрить следующий шаг.
Используйте практические уровни квот:
| Класс трафика | Рекомендуемая политика |
|---|---|
| Разработка | Низкий жесткий лимит; частый сброс; без автоматического увеличения. |
| Staging | Средний лимит; уведомлять владельца платформы; блокировать бесконтрольные eval-запуски. |
| Production | Мягкие оповещения на 50%, 80% и 100%; владелец эскалации утверждает увеличения. |
| Batch and eval | Бюджетировать по окну запуска; до старта требовать оценку ожидаемой стоимости. |
| Image and video | Отдельный лимит для медиа; требовать одобрения владельца для более высокого разрешения или более длительных задач. |
| Shared platform services | Распределять по метрике потребления или согласованной доле; пересматривать ежемесячно. |
Именно здесь атрибуция затрат на AI API по командам становится ответственным использованием. Квота — это не просто технический лимит. Это обещание бюджета.
6. Замкните цикл с ежемесячным showback
Последний шаг — не дашборд. Это операционный обзор.
Каждая команда должна получать компактный ежемесячный отчет:
- Общие расходы на AI API.
- Расходы по модели, модальности и маршруту поставщика.
- Расходы по среде.
- Основные рабочие процессы.
- Основные драйверы по клиентам или рабочим пространствам, где это применимо.
- Стоимость неудачных вызовов, повторных попыток и fallback.
- События по квотам и изменения в согласованиях.
- Несопоставленное или неразмеченное использование.
- Последствия для recharge, счетов или бюджета.
Если команда не может объяснить одну из строк, не прячьте ее в платформенный bucket. Исправьте тег, границу ключа или запись рабочего процесса до следующего цикла закрытия.
Где здесь подходит Flatkey
Flatkey позиционируется как одноключевой слой для команд, которым нужны общий баланс, единая биллинг-система, официальный доступ к моделям, инструменты pay-per-successful-call и записи об использовании, а также механизмы управления для использования AI-моделей и инструментов. На текущих публичных страницах Flatkey описываются один ключ, один баланс, один счет, более 100 официальных моделей, более 1 000 инструментов pay-per-call, управление sub-key, бюджеты, allowlists моделей, журнал запросов и счета в течение 48 часов.
Такая форма продукта важна для атрибуции затрат на AI API по командам, потому что она уменьшает расползание аккаунтов у провайдеров, сохраняя возможность анализа использования. Ключевое архитектурное решение — не «один ключ или много ключей». Важнее то, сохраняется ли атрибуция использования после объединения доступа.
Практическое внедрение Flatkey:
- Подтвердите текущие данные по моделям и ценам на странице Flatkey pricing перед распределением бюджетов.
- Создайте границы для команд или рабочих процессов: production, evaluation, автоматизация поддержки, growth-агенты и генерация медиа.
- Используйте метаданные владельца или соглашения об именовании, чтобы записи об использовании могли сопоставлять расходы с командами и центрами затрат.
- Настройте политику квот по владельцу, среде и модальности.
- Ежемесячно пересматривайте использование, записи recharge и счета вместе с финансами и ответственным владельцем команды.
Для контекста внедрения начните с Flatkey API quickstart, затем свяжите операционный обзор с дашбордом использования токенов для AI API и сверкой счетов AI API.
Чего следует избегать
Плохая атрибуция затрат на AI API по командам обычно вызвана чрезмерной уверенностью в одном слое:
- Не полагайтесь только на счета. Счет подтверждает общие расходы, но не объясняет, почему они возникли.
- Не полагайтесь только на дашборды. Дашборд без полей владельца не может одобрить бюджетное решение.
- Не храните промпты только для объяснения расходов. Используйте идентификаторы, безопасные с точки зрения конфиденциальности, и операционные метаданные.
- Не смешивайте квоты staging и production. Тестовые прогоны не должны исчерпывать бюджет, предназначенный для обслуживания клиентов.
- Не считайте расходы только на токены всеми AI-расходами. Изображения, видео, кэшированный ввод, повторные попытки и вызовы инструментов требуют собственной обработки по единицам учета.
- Не относите все общие расходы по умолчанию на платформу. Если команда платформы не может контролировать спрос, она не должна молча принимать на себя эту стоимость.
FAQ
Что такое атрибуция затрат на AI API по командам?
Атрибуция затрат на AI API по командам — это процесс отнесения каждого запроса к модели или инструменту к той команде, рабочему процессу, среде, сегменту клиентов и владельцу бюджета, которые вызвали эти расходы. Он дает продуктовым, платформенным и финансовым командам общий реестр для анализа использования.
Плохо ли использовать один API-ключ для атрибуции затрат?
Не обязательно. Один ключ может работать, если он дополнен управлением субключами, метками маршрутов, метаданными, квотами и реестром использования на уровне запросов. Проблема — это один общий ключ без тегов.
Какие поля нужны для атрибуции затрат на AI API по командам?
Минимально нужно фиксировать ID запроса, команду, центр затрат, среду, рабочий процесс, модель, семейство конечных точек, единицы использования, версию прайсинга, итоговую стоимость, статус, количество повторных попыток и запасной маршрут, если применимо.
Как командам следует распределять общие платформенные AI-расходы?
Используйте заранее документированное правило до начала месяца. Распространенные методы включают долю использования, долю запросов, долю токенов, долю принятых выходных данных или согласованное фиксированное распределение для общей инфраструктуры. Ежемесячно проверяйте нераспределенные расходы.
Как это связано со сверкой счетов AI API?
Атрибуция затрат объясняет, кто вызвал использование. Сверка счетов подтверждает, что использование, записи о пополнении, ценовые единицы, кредиты, налоги и итоговые суммы по счету совпадают. Для ответственного учета расходов на AI нужны оба процесса.
Итог
Атрибуция затрат на AI API по командам: от одного ключа к ответственному использованию — это переход от удобства доступа к дисциплине эксплуатации. Сохраняйте интеграцию простой, но делайте так, чтобы каждый значимый запрос можно было отнести к владельцу, среде, рабочему процессу, единице использования и версии цены.
Когда реестр в порядке, команды могут спорить о решениях, а не о цифрах: какие рабочие процессы заслуживают большего бюджета, какие маршруты нужно оптимизировать, какие эксперименты следует завершить и какие ориентированные на клиентов функции стоит масштабировать.