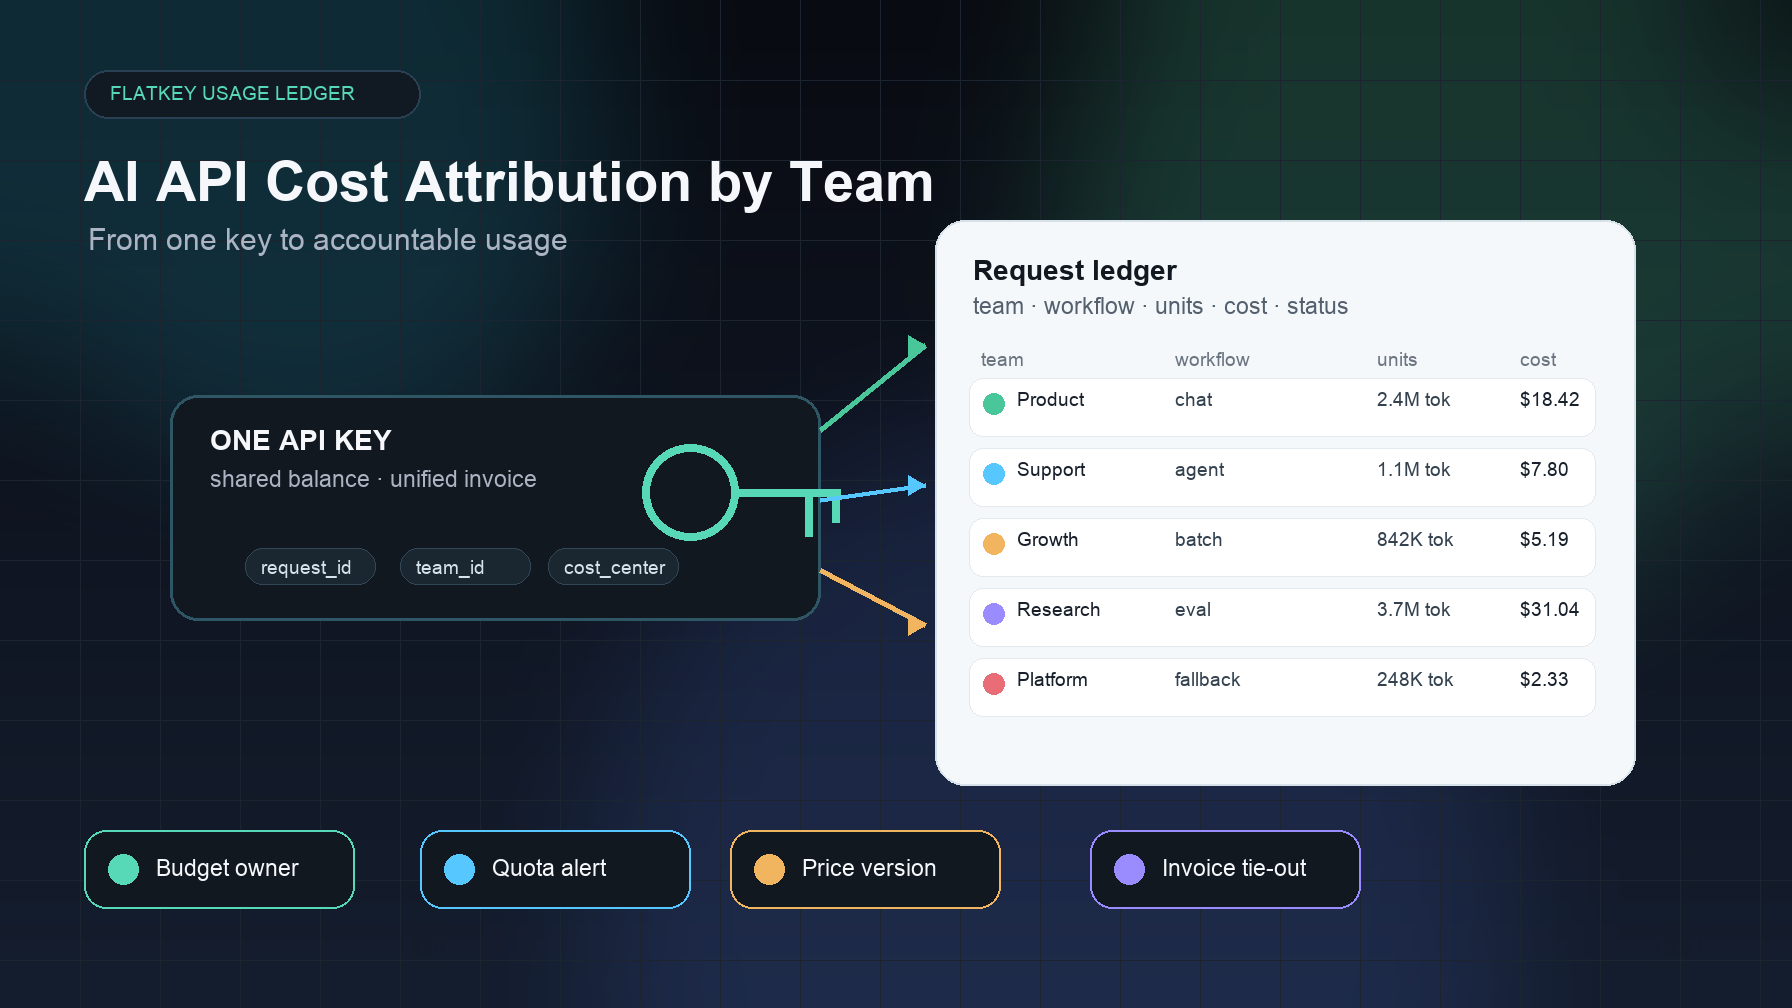
按团队分摊 AI API 成本,是将每一次模型和工具请求与导致这笔支出的团队、产品领域、环境、工作流和预算负责人关联起来的运营实践。它把“AI 账单上涨了”变成“客服自动化增加了回退流量”、“夜间评测套件让输出 token 翻了一倍”,或者“某个增长实验在未进行配额审查的情况下从预发布转到了生产环境”。
一旦 AI 使用超出原型阶段,这种区分就很重要。一个共享 API 密钥可以让第一次集成变得简单,但如果使用台账无法说明哪个团队使用了哪个模型、调用为何发生,以及这笔成本究竟属于生产、实验、内部工具还是面向客户的使用,那么第一次真正的财务审查也会变得很痛苦。
本指南为 AI 产品、平台和财务团队提供了一种实用模型,用于按团队分摊 AI API 成本:需要捕获哪些字段、如何区分密钥和元数据边界、如何审查共享成本,以及如何在不把每一次模型调用都变成手工表格的前提下,从一个密钥过渡到可追责的使用。
快速答案:成本分摊需要归属、证据和审查
当以下三层彼此一致时,按团队分摊 AI API 成本才有效:
| 层级 | 回答什么问题 | 实际控制 |
|---|---|---|
| 归属 | 谁对这笔支出负责? | 团队、成本中心、产品领域、环境、工作流和升级负责人。 |
| 证据 | 实际发生了什么? | 请求 ID、密钥或路由、模型、提供方、使用单位、状态、重试、回退路由和最终成本。 |
| 审查 | 下个月应该改变什么? | 展示分摊、成本转嫁、配额调整、路由审查或预算例外。 |
如果缺少任一层,归因就会变成猜测。如果密钥没有负责人,发票就没有可追责的团队。如果请求没有元数据,台账就无法区分生产流量和评测流量。如果定价单位没有时间戳,图像、视频、缓存输入和文本 token 的成本就会混在一个含糊的“AI 支出”条目下。
按团队分摊 AI API 成本的目标不是惩罚使用。目标是让下一次预算决策变得显而易见:保留、设限、优化、改道,还是终止该工作负载。
为什么单个共享密钥会破坏成本责任
单个密钥仍然可以被治理,但前提是它与团队级元数据和可靠的使用台账配套使用。当“一个密钥”意味着“一个没有区分度的桶”时,问题就开始出现了。
常见失效模式:
- 团队归属不明确:支持、增长、数据、产品和工程都使用同一凭证。
- 环境归属不明确:开发、预发布、压测、评估和生产流量共享同一额度。
- 工作流归属不明确:代理、批处理作业、聊天、图像生成、视频生成和内部工具被按一个数字来审查。
- 重试归属不明确:失败调用、自动重试和回退路径产生了没人计划过的支出。
- 计量单位归属不明确:输入 token、输出 token、缓存 token、图像、视频秒数和工具调用被归一化得太晚。
这些缺口正是为什么按团队分摊 AI API 成本应当在请求边界设计,而不是等到每月账单到来之后再处理。
如需相关控制,可将此工作流与 AI API 支出管理、按环境跟踪 LLM 成本、按客户计量 AI 使用量以及 AI API 发票核对连接起来。
团队归属矩阵
将此矩阵作为你推广实施的核心价值资产。每一条高流量路径都应有一个明确责任人、一条使用记录,以及一条计费审核路径。
| 归属维度 | 如何采集 | 财务或运营为何关心 | 策略示例 |
|---|---|---|---|
| 团队或成本中心 | 团队拥有的子密钥、路由标签或元数据标签。 | 支出可由预算负责人审查,而不是由平台猜测。 | 增长团队负责活动代理;支持团队负责工单自动化;数据团队负责评估作业。 |
| 环境 | 独立的非生产密钥或环境元数据。 | 测试流量不应消耗生产容量。 | 开发和预发布环境设置较低的硬上限;生产环境使用告警加负责人审批。 |
| 工作流 | 聊天、评估、批处理、代理、图像、视频、支持或内部工具的工作流标签。 | 不同工作流对成本突增和重试的容忍度不同。 | 当支出超过预期运行窗口时,批处理重试需要审核。 |
| 客户或工作区 | 隐私安全的客户 ID、工作区 ID、套餐层级或细分。 | 团队可以将内部支出与客户驱动的使用量分开。 | 企业工作区每月进行一次使用量审查;免费试用则采用更严格的限制。 |
| 模型和模态 | 模型 ID、端点系列、使用单位、价格版本和最终路由。 | token、图像、视频和工具成本需要不同的归一化方式。 | 高成本媒体路由在提升额度前需要明确的负责人审批。 |
| 重试与回退行为 | 状态码、重试次数、回退路由、最终状态和最终成本。 | 失败和回退会产生计划外支出。 | 回退占比较高的路由每周审查,直到错误率和成本回到基线。 |
这个矩阵也是工程遥测与财务报告之间的桥梁。OpenTelemetry 生成式 AI 语义约定可以帮助标准化操作、模型、token 和响应字段。FinOps FOCUS 可以帮助财务思考分配维度。但二者都不能替代产品层面的决策:谁拥有每个 AI 工作流,以及哪一个预算承担这笔成本。
实用的 AI API 成本分摊工作流
按团队实现可持续的 AI API 成本分摊,不能从仪表板开始,而要从请求契约开始。
1. 在标记流量之前先定义账本
把财务、产品和平台真正会用到的字段写下来:
| 字段 | 示例 | 用途 |
|---|---|---|
request_id |
req_8f3a2e91 |
可追踪的事件,便于审计和调试。 |
team_id |
support、growth、platform |
主要预算拥有者。 |
cost_center |
内部财务代码。 | 将 AI 支出映射到财务系统。 |
environment |
dev、staging、production、eval |
将测试流量与面向客户的流量分开。 |
workflow |
support-agent、nightly-eval、image-job |
说明请求为何发生。 |
customer_or_workspace_id |
隐私安全的内部 ID。 | 支持客户级使用情况审查,而不暴露内容。 |
model_id |
当前模型路由。 | 显示是哪一个模型驱动了成本。 |
endpoint_family |
文本、图像、视频、工具、响应或嵌入。 | 防止仅按 token 报告而隐藏非 token 支出。 |
usage_units |
输入 token、输出 token、缓存 token、图像、秒数、工具调用。 | 使计价计算可复现。 |
pricing_version |
快照日期或价格表版本。 | 使月末对账可审计。 |
status |
成功、错误、回退、重试、已取消。 | 将预期使用与故障驱动的使用区分开来。 |
final_cost |
该请求的归一化费用。 | 支持展示分摊、成本转嫁和配额决策。 |
如果某个字段不会改变决策,就不要添加它。如果缺少某个字段会阻碍发票审核,那就要在下一次高流量发布之前把它加上。
2. 决定哪些边界值得单独的密钥
不要把每个请求都拆成一个新密钥。应在所有权、风险、配额或事故处置不同的地方进行拆分。
一个简单的起始结构:
| 边界 | 为何值得单独拆分 |
|---|---|
| 生产应用流量 | 面向客户的可靠性和预算告警需要明确的负责人。 |
| 开发和预发布 | 实验不应消耗生产配额。 |
| 评估和批处理作业 | 计划运行可能带来大的、可预测的峰值。 |
| 支持自动化 | 工单量、重试和升级工作流需要单独审查。 |
| 增长或营销代理 | 活动实验需要预算到期和审批。 |
| 图像和视频生成 | 非 token 单位需要单独的上限和定价审查。 |
这就是按团队分摊 AI API 成本与访问控制相交的地方。如果两类流量需要不同的负责人或预算,它们就不应该被同一个未标记的共享密钥掩盖掉。
3. 添加元数据,但不要记录密钥
元数据应说明所有权和运行上下文,而不是存储敏感内容。
使用稳定的运行标识符:
- 团队或成本中心。
- 环境。
- 工作流。
- 内部客户或工作区 ID。
- 产品界面。
- 实验 ID。
- 路由策略版本。
避免:
- API 密钥。
- 原始提示词。
- 原始客户内容。
- 账单审查不需要的个人数据。
- 无法与财务系统关联的自由格式标签。
Cloudflare AI Gateway 文档在这里是一个有用的模式,因为它将请求元数据和日志记录视为 AI 网关运维的一部分。可迁移的经验很简单:让成本上下文结构化且可查询,同时将敏感内容排除在计费证据路径之外。
4. 按模型、模态和日期标准化定价
当所有成本都被简化为“token”时,按团队分摊 AI API 成本就会失效。文本模型可能按输入、输出、缓存输入、缓存写入或推理单元计费。图像生成可能按图像、质量、尺寸或编辑计费。视频可能按秒、分辨率或作业计费。工具调用可能按每次成功操作计费。
记录:
- 模型 ID。
- 提供方或路由。
- 端点系列。
- 使用单位。
- 单位数量。
- 定价快照日期。
- 最终归一化成本。
关于提供方选择和路由审查,可将本文与 切换提供方前如何比较 AI 模型价格 以及 AI 网关定价 搭配阅读。
5. 在所有权明确后再设置配额
配额管理应当跟随所有权,而不是反过来。共享配额只能告诉你某个东西已经触顶;团队所有的配额则会告诉你下一步该由谁来批准。
使用实用的配额层级:
| 流量类别 | 建议策略 |
|---|---|
| 开发 | 较低硬上限;频繁重置;不自动提升。 |
| 预发布 | 中等上限;提醒平台所有者;阻止失控的评估任务。 |
| 生产 | 在 50%、80% 和 100% 时发出软告警;升级审批人批准增加额度。 |
| 批处理和评估 | 按运行窗口预算;启动前要求提供预期成本估算。 |
| 图像和视频 | 单独设置媒体上限;更高分辨率或更长作业需要所有者批准。 |
| 共享平台服务 | 按消耗指标或约定分摊分配;每月审查。 |
这正是按团队分摊 AI API 成本转变为可追责使用的时刻。配额不仅仅是一个技术限制。它是一份预算承诺。
6. 通过每月回显闭环
最后一步不是仪表盘,而是运营评审。
每个团队都应收到一份简洁的月度视图:
- AI API 总支出。
- 按模型、模态和提供方路由划分的支出。
- 按环境划分的支出。
- 主要工作流。
- 适用时按客户或工作区划分的主要驱动因素。
- 失败调用、重试和回退成本。
- 配额事件和审批变更。
- 未匹配或未打标签的使用。
- 分摊、发票或预算影响。
如果一个团队无法解释某一项费用,就不要把它藏在平台桶里。在下一个结账周期之前,先修正标签、密钥边界或工作流记录。
Flatkey 的定位
Flatkey 被定位为一个密钥层,面向希望拥有共享余额、统一计费、官方模型访问、按成功调用付费工具、使用记录,以及跨 AI 模型和工具使用的治理控制的团队。Flatkey 当前公开页面描述了一个密钥、一个余额、一张发票、100+ 官方模型、1,000+ 按调用付费工具、子密钥治理、预算、模型白名单、请求账本,以及 48 小时内开具发票。
这种产品形态与按团队分摊 AI API 成本相关,因为它减少了提供商账户的蔓延,同时仍然保留了使用审查的可能性。关键的设计选择不是“一个密钥还是多个密钥”。真正重要的是,在访问统一之后,使用是否仍然可追踪。
一个实用的 Flatkey 推广流程:
- 在分配预算之前,先确认 Flatkey pricing 上当前的模型和定价细节。
- 为生产、评估、支持自动化、增长代理和媒体生成创建团队或工作流边界。
- 使用所有者元数据或命名约定,使使用记录能够将支出映射到团队和成本中心。
- 按所有者、环境和模态设置配额策略。
- 与财务和负责的团队所有者一起,每月审查使用情况、分摊记录和发票。
如需实施背景,请先查看 Flatkey API quickstart,然后将运营评审连接到 token usage dashboard for AI APIs 和 AI API invoice reconciliation。
要避免什么
按团队进行糟糕的 AI API 成本归因,通常是因为过度依赖某一个表面:
- 不要只依赖发票。 发票只能证明总支出,不能证明支出为何发生。
- 不要只依赖仪表盘。 没有负责人字段的仪表盘无法批准预算决策。
- 不要仅仅为了解释支出而存储提示词。 使用保护隐私的 ID 和运维元数据。
- 不要混用预发布和生产配额。 测试运行不应耗尽面向客户服务的预算。
- 不要把 token 支出当作全部 AI 支出。 图片、视频、缓存输入、重试和工具调用都需要各自的计量处理。
- 不要默认把所有共享支出都分摊给平台团队。 如果平台团队无法控制需求,就不应默默承担这部分成本。
常见问题
什么是按团队进行 AI API 成本归因?
按团队进行 AI API 成本归因,是将每一次 AI 模型或工具请求分配给导致该支出的团队、工作流、环境、客户细分和预算负责人的过程。它为产品、平台和财务团队提供了一份用于使用情况审查的共享账本。
一个 API 密钥不利于成本归因吗?
不一定。只要配合子密钥治理、路由标签、元数据、配额和请求级使用账本,一个密钥也可以工作。问题在于一个未标记的共享密钥。
按团队进行 AI API 成本归因需要哪些字段?
至少要捕获请求 ID、团队、成本中心、环境、工作流、模型、端点类别、使用单位、定价版本、最终成本、状态、重试次数,以及适用时的备用路由。
团队应如何分摊共享的平台 AI 成本?
应在每月开始前先制定好一套书面规则。常见方法包括按使用份额、请求份额、token 份额、已接受输出份额,或对共享基础设施采用约定好的固定分摊。每月审查无法匹配的支出。
这与 AI API 发票对账有什么关系?
成本归因说明是谁导致了使用量。发票对账确认使用量、充值记录、计费单位、抵扣、税费和最终发票总额彼此一致。要让 AI 支出可追责,这两者都需要。
结论
按团队分摊 AI API 成本:从一个密钥到可追责的使用,意味着从访问便利转向运营纪律。保持集成简单,但要让每一项有意义的请求都能按负责人、环境、工作流、使用单位和价格版本进行归因。
当账本清晰时,团队可以围绕决策而不是数字争论:哪些工作流值得更多预算,哪些路由需要优化,哪些实验应该结束,以及哪些面向客户的功能值得扩展。