Kosten selbstgehosteter LLMs pro Million Tokens: Ein reproduzierbares GPU-Kostenmodell
Die zuverlässige Methode zur Berechnung der Kosten selbstgehosteter LLMs pro Million Tokens besteht darin, die vollständig belasteten Bereitstellungskosten durch die Tokens zu teilen, die Ihr Workload tatsächlich akzeptiert – nicht durch den beworbenen Spitzendurchsatz einer GPU.
Dieser Unterschied ist wichtig. Eine GPU kann in Benchmarks gut abschneiden und in der Produktion dennoch teuer sein, wenn sie bezahlte Zeit im Leerlauf verbringt, ungewöhnlich lange Prompts verarbeitet, fehlgeschlagene Anfragen erneut versucht oder Ausgaben erzeugt, die Ihr Produkt ablehnt. Dieser Leitfaden bietet ein wiederholbares Modell für Kosten selbstgehosteter LLMs pro Million Tokens, eine Arbeitsvorlage, ein Rechenbeispiel und eine faire Methode zum Vergleich eines selbstverwalteten Endpunkts mit einer verwalteten API.
Aktualisiert am 16. Oktober 2026. Alle unten genannten Dollarbeträge und Durchsätze sind illustrative Eingaben, keine Anbieterangebote oder Leistungszusagen.
Die Formel für Kosten selbstgehosteter LLMs pro Million Tokens
Verwenden Sie für eine Betrachtung nach Output-Tokens:
Kosten pro 1 Mio. akzeptierter Output-Tokens =
  vollständig belastete stündliche Bereitstellungskosten
  / (Output-Tokens/Sekunde im aktiven Zeitfenster × 3.600 × Auslastung der bezahlten Zeit × Erfolgsrate × Akzeptanzrate)
  × 1.000.000
Dabei gilt:
| Eingabe | Definition | Verwendung |
|---|---|---|
| Vollständig belastete stündliche Bereitstellungskosten | Jeder Kostenfaktor, der erforderlich ist, um die Kapazität für eine bezahlte Stunde verfügbar zu halten | Schließen Sie GPU-Knoten, CPU/RAM, Speicher, Netzwerk, Control Plane, Observability, Support und einen zugewiesenen Anteil der Betriebsarbeit ein. |
| Output-Tokens/Sekunde im aktiven Zeitfenster | Generierter Output-Durchsatz, während der Endpunkt einen produktionsnahen Workload bedient | Messen Sie ihn mit Ihrem tatsächlichen Modell, Ihrer Präzision, Ihrer Verteilung der Kontextlängen, Parallelität und Ihrem Latenzziel. |
| Auslastung der bezahlten Zeit | Nützliche Bereitstellungssekunden geteilt durch bezahlte Kapazitätssekunden | Dies ist nicht dasselbe wie die momentane SM-Auslastungsanzeige einer GPU. |
| Erfolgsrate | Abgeschlossene Anfragen geteilt durch gestartete Anfragen | Zählen Sie Timeouts, OOMs, 5xx-Antworten und fehlgeschlagene Tool-/Schema-Ausführungen konsistent. |
| Akzeptanzrate | Output, der die Qualitäts-, Sicherheits-, Schema- und menschlichen Überprüfungen des Produkts besteht | Dadurch wird generierter Output in nutzbaren Output umgewandelt. |
Der Nenner ist entscheidend. Kosten selbstgehosteter LLMs pro Million Tokens sollten Kosten pro nutzbarer Einheit sein, nicht Kosten pro GPU-Benchmark.
Die Regel gegen Doppelzählung
Verwenden Sie einen dieser beiden Messpfade:
- Messen Sie den Durchsatz im aktiven Zeitfenster und multiplizieren Sie ihn anschließend mit der Auslastung der bezahlten Zeit.
- Messen Sie die akzeptierten Tokens über das gesamte bezahlte Intervall und setzen Sie dann die Auslastung auf
1, weil die Leerlaufzeit bereits in der Beobachtung enthalten ist.
Führen Sie nicht beides aus. Die Anwendung eines Auslastungsfaktors auf einen Wandzeitdurchsatz, der bereits Leerlaufzeit enthält, lässt die LLM-Inferenzkosten pro Token höher erscheinen, als sie sind. Wird die Auslastung bei einem Benchmark im aktiven Zeitfenster weggelassen, erscheinen sie niedriger, als sie sind.
Eine kopierbare Arbeitsvorlage für GPU-Kosten pro Million Tokens
Fügen Sie in Ihrer Tabellenkalkulation für jedes Modell, jede Hardware-Topologie, jede Region und jede Workload-Form eine Zeile ein. Vermischen Sie keinen Kurzchat-Benchmark mit einem Produktions-Workload mit langem Kontext.
Die Arbeitsvorlage macht die Berechnung der Kosten selbstgehosteter LLMs pro Million Tokens prüfbar: Ein anderer Betreiber sollte die Eingaben ersetzen, das Messfenster erneut ausführen und das Ergebnis reproduzieren können.
| Feld | Illustrativer Wert | Hinweis zur Erhebung |
|---|---|---|
| Modell und Präzision | your-model / FP8 |
Erfassen Sie das genaue Gewichtsformat und die Version der Serving-Engine. |
| GPU-Topologie | 1 GPU node |
Erfassen Sie SKU, Formfaktor, GPU-Anzahl und Interconnect. |
| Vollständig belastete stündliche Kosten | $4.07 |
Addieren Sie alle bezahlten Kosten für die in der Zeile verwendete Kapazität. |
| Output-Tokens/Sek. im aktiven Zeitfenster | 900 |
Messen Sie unter dem genehmigten p95-Latenzziel. |
| Auslastung der bezahlten Zeit | 55% |
Nützliche Bereitstellungszeit geteilt durch bezahlte Kapazitätszeit. |
| Erfolgsrate der Anfragen | 98% |
Anfragen, die ohne Infrastrukturfehler abgeschlossen werden. |
| Akzeptanzrate des Outputs | 92% |
Output, der Ihre vereinbarte Bewertungsregel besteht. |
| Akzeptierte Output-Tokens/Stunde | 1,606,176 |
900 × 3,600 × 0.55 × 0.98 × 0.92 |
| Kosten pro 1 Mio. akzeptierter Output-Tokens | $2.53 |
$4.07 ÷ 1,606,176 × 1,000,000 |
Dies ist eine illustrative Berechnung, keine Preisliste für eine GPU. Wenn Sie die fünf Eingaben durch gemessene Werte ersetzen, erhalten Sie Ihre eigenen GPU-Kosten pro Million Tokens.
Rechenbeispiel: Warum die Auslastung das Ergebnis verändert
Halten Sie die hypothetischen vollständig belasteten stündlichen Kosten des Endpunkts von 4,07 $ und 900 Output-Tokens/Sekunde im aktiven Zeitfenster konstant. Kleine Änderungen der Eingaben verändern die Stückkosten erheblich.
| Szenario | Auslastung der bezahlten Zeit | Erfolg × Akzeptanz | Kosten pro 1 Mio. akzeptierte Output-Tokens |
|---|---|---|---|
| Basiswert | 55% | 90.2% | $2.53 |
| Gleiche Kapazität, gleichmäßigere Nachfrage | 75% | 90.2% | $1.86 |
| Gleiche Kapazität, schwankende Nachfrage | 25% | 90.2% | $5.57 |
| Gleiche Kapazität, geringere Akzeptanz | 55% | 68.6% | $3.33 |
| Schnellere illustrative Konfiguration: $5.35/Stunde, 1,300 Tok./s, 60% Auslastung | 60% | 90.2% | $2.11 |
Die Erkenntnis lautet nicht, einen bestimmten Beschleuniger zu kaufen. Sie lautet vielmehr, dass die Preisgestaltung selbstgehosteter LLMs ein Betriebs- und Durchsatzmodell ist. Höhere stündliche Knotenkosten können zu niedrigeren Kosten pro akzeptiertem Output führen, wenn ausreichend Speicher, Spielraum für Batching und Nachfrage vorhanden sind, um mehr nützliche Arbeit aufrechtzuerhalten. Ein niedrigerer Stundensatz kann verlieren, sobald ungenutzte Kapazität und Wiederholungsversuche in den Nenner einfließen.
Prefill und Decode vor dem Benchmarking trennen
LLM-Serving ist keine einheitliche Arbeitslast. Die Inferenz umfasst eine Kontextverarbeitungsphase (Prefill) und eine Generierungsphase (Decode); der TensorRT-LLM-Leitfaden von NVIDIA behandelt sie ausdrücklich als getrennte Phasen und betont die arbeitslastspezifische Optimierung. Lesen Sie den Leitfaden zur Leistungsoptimierung von TensorRT-LLM, bevor Sie eine plakative Tokens-pro-Sekunde-Zahl als repräsentativ betrachten.
- Lange Prompts, Retrieval-Kontext und große Anhänge belasten Prefill und KV-Cache.
- Lange Antworten, Codegenerierung und agentisches Reasoning belasten die Decode-Kapazität und die Zeit pro Output-Token.
- Hohe Parallelität macht Scheduler-Verhalten, Batching, Cache-Residenz und Speicherreserven zu Bestandteilen des Preis-Modells.
Erfassen Sie Prompt- und Output-Verteilungen getrennt. Bei einem retrieval-intensiven Assistenten mit 20,000 Input-Tokens und 300 Output-Tokens kann eine reine Output-Ökonomie den tatsächlichen Engpass übersehen. Bei einem Coding-Workflow mit 2,000 Input-Tokens und 4,000 Output-Tokens kann Decode dominieren.
Für einen belastbaren Vergleich der Kosten selbstgehosteter LLMs pro Million Tokens sollten Sie mindestens diese drei Perspektiven pflegen:
| Perspektive | Beste Verwendung | Wichtiger Vorbehalt |
|---|---|---|
| Kosten pro 1 Mio. Input-Tokens | Kontextintensive Workloads, Embeddings, Reranking | Sie bilden die Decode-Kapazität nicht ab. |
| Kosten pro 1 Mio. Output-Tokens | Chat, Coding, Zusammenfassung, Generierung | Sie können eine kostspielige Prompt-Verarbeitung verschleiern. |
| Kosten pro akzeptierter Antwort oder Aufgabe | Produkt- und FinOps-Entscheidungen | Sie erfordern eine stabile Akzeptanzregel. |
Den Nenner anhand von Produktions-Telemetrie messen
Leiten Sie den akzeptierten Durchsatz nicht aus einer Hardwarespezifikation ab. Der Serving-Stack sollte die Eingaben exportieren, die die Berechnung reproduzierbar machen.
vLLM dokumentiert beispielsweise Prometheus-Metriken für Prompt-Tokens, generierte Tokens, Request-Abschlüsse, Zulassungsablehnungen, Wartezeit, Prefill-Zeit, Decode-Zeit, KV-Cache-Nutzung, Zeit bis zum ersten Token und Latenz pro Output-Token. Diese reichen aus, um statt einer Schätzung aus einem Benchmark einen Messdatensatz zu erstellen. Die Metrikreferenz von vLLM listet die aktuellen Metriknamen und ihre Bedeutungen auf.
Erfassen Sie diesen Datensatz für jeden Lauf:
measurement_window_start/end
model_id and weights_precision
serving_engine and version
gpu_sku, gpu_count, interconnect, region
input_tokens_p50/p95 and output_tokens_p50/p95
concurrency and request-rate distribution
prompt_tokens_total and generation_tokens_total
request_success_total and admission_rejections_total
time_to_first_token_p50/p95 and time_per_output_token_p50/p95
KV-cache usage and OOM/timeout counts
paid capacity hours and fully loaded hourly cost
acceptance-rule version and accepted-output count
Hardware-Telemetrie ist nützlich, aber sie ist ein Diagnoseinstrument – kein Nenner für Stückkosten. Die DCGM-Profiling-Dokumentation von NVIDIA weist darauf hin, dass Aktivität ein Intervallmittelwert ist und mit dem Durchsatz einer repräsentativen Arbeitslast korreliert werden sollte. Verwenden Sie DCGM-Profiling-Metriken, um zu untersuchen, ob Rechenleistung, Speicherbandbreite oder Interconnect-Verhalten den Lauf begrenzen; ersetzen Sie die Auslastung der bezahlten Zeit nicht durch einen einzelnen Prozentsatz der GPU-Auslastung.
Den vollständig belasteten Zähler ermitteln
Der GPU-Mietpreis ist eine Eingabe, nicht die Antwort. Um die Kosten für LLM-Serving fair zu berechnen, beziehen Sie die Kapazitäts- und Betriebskosten ein, die für dasselbe Messfenster erforderlich sind.
| Kostenbereich | Einbeziehen | Häufige Auslassung |
|---|---|---|
| Rechenkapazität | GPU, CPU, RAM, Host/VM, reservierte warme Replikate | Nur einen Beschleuniger zu zählen, obwohl für Failover-Kapazität bezahlt wird. |
| Daten und Netzwerk | Modellartefakte, Block-/Objektspeicher, Egress, Load Balancer, privates Networking | Kosten für Startvorgänge, zonenübergreifenden Verkehr oder Log-Transport. |
| Plattform | Kubernetes, Slurm, Ray, Queuing, Secrets, Autoscaling, Image-Registry | Geteilte Plattformkosten, die auf einer anderen Rechnung erscheinen. |
| Beobachtbarkeit und Sicherheit | Metriken, Traces, Logs, GPU-Telemetrie, Alarmierung, Patching, Audit-Kontrollen | Die Tools, die für den Betrieb eines kundenseitigen Endpunkts erforderlich sind. |
| Personal und Support | Rufbereitschaft, Incident Response, Benchmarking, Wartung von Deployments, Provider-Support | Engineering-Zeit nach dem Proof of Concept als null zu behandeln. |
Für einen Pilotversuch sollten Sie zwei Kennzahlen ausweisen:
Nur-GPU-Kosten pro 1 Mio. Tokens
Vollkosten pro 1 Mio. akzeptierter Tokens
Die Differenz ist kein Fehler; sie sind die Betriebskosten des selbstgehosteten Dienstes. Dadurch wird die Preisentscheidung für selbstgehostete LLMs prüfbar.
Wiederholungsversuche und verworfene Ausgabe einbeziehen
Generierte Tokens sind nicht automatisch nutzbare Tokens. Eine Anfrage kann Prefill- und partielle Decoding-Kapazität verbrauchen, bevor sie ein Timeout erreicht, ungültiges JSON erzeugt, ein Tool-Aufruf fehlschlägt, gegen eine Policy-Regel verstößt oder einen Qualitätsschwellenwert verfehlt.
Verwenden Sie eine Akzeptanzanpassung, die Ihr Produktteam reproduzieren kann:
akzeptierte Ausgabe-Tokens =
  generierte Ausgabe-Tokens
  × Ausführungs-Erfolgsrate
  × Produkt-Akzeptanzrate
Wenn die Akzeptanz auf Anfrageebene gemessen wird, dokumentieren Sie die genaue Regel: Evaluator-Version, Stichprobe, Schema-Validator, Protokoll für menschliche Überprüfung oder Ereignis für erfolgreichen Task-Abschluss. Eine Änderung der Regel ohne Versionierung macht einen Kostentrend bedeutungslos.
Deshalb können auch reine LLM-Inferenzkosten pro Token irreführend sein. Eine Konfiguration, die 30 % mehr Durchsatz erzielt, aber die Erfolgsrate akzeptierter Tasks senkt, kann auf Produktebene mehr kosten.
Self-Hosting und eine verwaltete API in derselben Einheit vergleichen
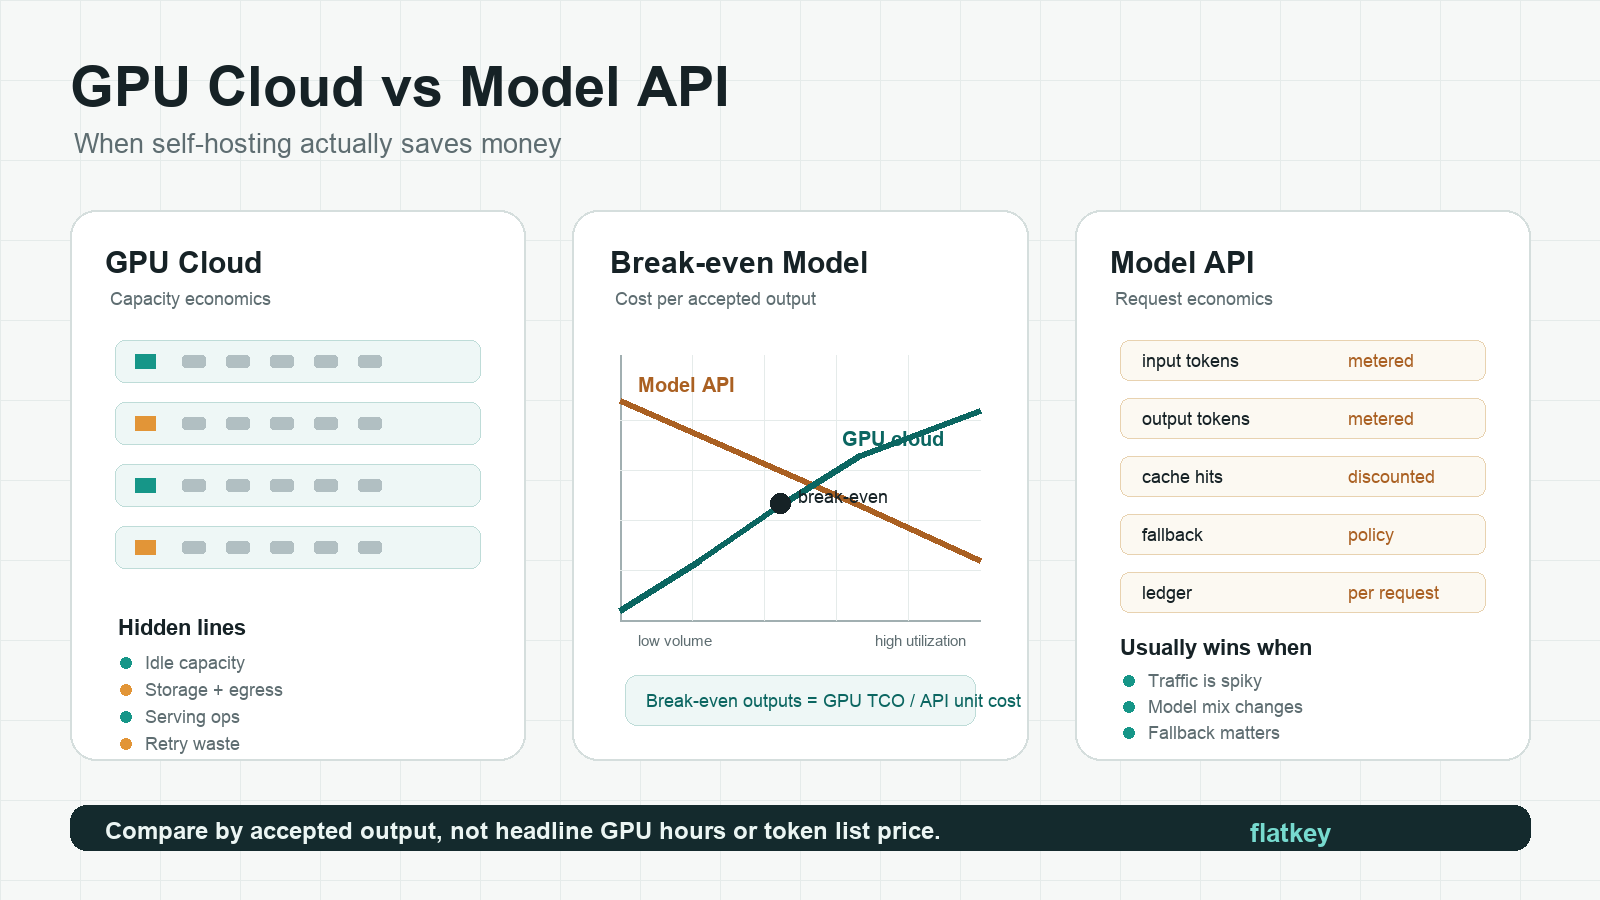
Self-Hosting kauft Kapazität. Eine verwaltete API kauft Nutzung. Sie werden erst vergleichbar, wenn Zähler und Nenner übereinstimmen.
Verwenden Sie diese Break-even-Durchsatzprüfung, wenn der API-Benchmark in derselben Einheit ausgedrückt wird:
erforderliche Ausgabe-Tokens/Sekunde im aktiven Zeitfenster =
  vollständig belastete stündliche Serving-Kosten × 1.000.000
  / (Kosten der verwalteten API pro 1 Mio. akzeptierter Ausgabe-Tokens × 3.600 × Auslastung × Erfolgsrate × Akzeptanzrate)
Richten Sie vor der Entscheidung diese Kontrollen über beide Wege hinweg aus:
- Dasselbe Modell oder ein explizit evaluierter, qualitätsäquivalenter Modell.
- Dieselbe Verteilung von Prompt- und Ausgabelängen.
- Dasselbe Latenz-SLO und dieselbe Parallelitätsstruktur.
- Dieselben Regeln für Wiederholungsversuche, Fallbacks und Akzeptanz.
- Dieselbe Behandlung von Cache-Treffern, Tool-Fehlern und abgebrochener Arbeit.
Wenn direkte GPU-Kontrolle, benutzerdefinierte Weights, feste Platzierung oder ein spezialisierter Kernel-Stack erforderlich sind, kann Self-Hosting auch oberhalb der verwalteten Baseline weiterhin die richtige Antwort sein. Bei niedrigem oder schwankendem Traffic, häufig wechselnden Modellen oder wenn das Team keine Inferenzinfrastruktur betreiben möchte, kann eine nutzungsbasierte API das Auslastungsrisiko übernehmen.
Für einen umfassenderen Einkaufsvergleich siehe Flatkeys Leitfaden zu GPU-Cloud vs. Modell-API und den Leitfaden zu GPU-Mietpreisen. Wenn direkte GPU-Kontrolle nicht erforderlich ist, ist ein verwalteter Weg ein nützlicher Benchmark: Flatkey bietet eine einheitliche Modell- und Tool-API mit einem Guthaben, sodass Teams einen verwalteten Weg mit ihrer Self-Hosting-Kalkulation vergleichen können, ohne separate Provider-Schlüssel zu verwalten. Starten Sie eine Flatkey-API-Baseline mit demselben Testsatz und derselben Akzeptanzregel.
Ein Beschaffungstest in sieben Schritten
Verwenden Sie dieses Framework für Self-Hosting-LLM-Kosten pro Million Tokens als Beschaffungsartefakt, nicht nur als Engineering-Benchmark. Es sollte genau zeigen, welche Annahmen zu Workload, Kapazität und Qualität das Ergebnis verändert haben.
- Definieren Sie die Einheit: Eingabe-Token, Ausgabe-Token, gemischtes Token, akzeptierte Antwort oder akzeptierter Task.
- Messen Sie den Durchsatz im aktiven Zeitfenster unter produktionsähnlichem Traffic, nicht mit einem einzelnen synthetischen Prompt.
- Messen Sie die Auslastung während der bezahlten Zeit über jedes bezahlte Replikat und jeden Warm-Reserve-Knoten hinweg.
- Fügen Sie alle Betriebskosten zum stündlichen Zähler hinzu.
- Versionieren Sie die Erfolgs- und Akzeptanzregeln und berechnen Sie dann die akzeptierte Ausgabe.
- Führen Sie denselben Workload über eine verwaltete API-Baseline aus.
- Prüfen Sie Kosten, p95-Latenz, Zuverlässigkeit, Qualität und Engineering-Aufwand gemeinsam, bevor Sie Kapazität reservieren.
Häufige Fehler in einem Kostenmodell für selbstgehostete LLMs
Spitzen-Benchmark-Durchsatz verwenden. Spitzenwerte sind nützlich, um ein kontrolliertes Setup zu vergleichen. Sie entsprechen nicht dem erwarteten Durchsatz Ihres Produktionsmixes.
GPU-Auslastung als Kapazitätsauslastung bezeichnen. Eine ausgelastete GPU kann dennoch an einen Endpunkt angebunden sein, der für die bezahlte Nachfrage überdimensioniert ist. Verwenden Sie die Auslastung während der bezahlten Zeit für die Stückkostenrechnung und Hardware-Telemetrie, um die Ursache zu diagnostizieren.
Auslastung zweimal anwenden. Wählen Sie entweder Durchsatz im aktiven Zeitfenster plus Auslastung oder Wall-Clock-Durchsatz, der Leerlaufzeit bereits einschließt.
Prompt-Tokens ignorieren. Langer Kontext erhöht den Prefill- und KV-Cache-Druck, selbst wenn das Produkt hauptsächlich für die Ausgabe abrechnet.
Jeden generierten Token als akzeptiert behandeln. Wiederholungsversuche, ungültige Tool-Argumente, Schemafehler und Qualitätsablehnungen sind bezahlte Arbeit.
Nur eine GPU-Rechnung mit dem API-Listenpreis vergleichen. Engineering, Support, Speicher, Netzwerk, Observability und vorgehaltene Kapazität gehören in dieselbe Berechnung.
Für die vollständige Entscheidung (wann sich Self-Hosting lohnt, GPU-Arbeitsspeicherdimensionierung, Tools und eine schrittweise Servereinrichtung) siehe unseren Leitfaden für selbstgehostete LLMs.
Häufig gestellte Fragen
Wie berechne ich die Kosten selbstgehosteter LLMs pro Million Tokens?
Teilen Sie die voll belasteten stündlichen Serving-Kosten durch die akzeptierten Tokens pro bezahlter Stunde und multiplizieren Sie dann mit 1.000.000. Verwenden Sie gemessenen, produktionsnahen Durchsatz, Auslastung während bezahlter Zeit, Erfolgsrate und Akzeptanzrate – nicht die theoretische GPU-Spitzenleistung.
Sind GPU-Kosten pro Million Tokens dasselbe wie LLM-Inferenzkosten pro Token?
GPU-Kosten pro Million Tokens können eine reine GPU-Infrastrukturkennzahl sein. LLM-Inferenzkosten pro Token sollten den relevanten operativen Zähler und einen klar definierten Nenner umfassen. Für eine Produktentscheidung sind Kosten pro akzeptierter Antwort oder Aufgabe oft die sicherere ergänzende Kennzahl.
Sollte ich Output-Tokens oder die Gesamtzahl der Tokens verwenden?
Verwenden Sie beides, wenn Prompt- und Output-Kosten unterschiedliche Engpässe haben. Output-Tokens sind für generative Workloads leicht vergleichbar; Gesamt- oder gewichtete Tokens bilden Retrieval-Workloads mit langem Kontext besser ab. Behalten Sie beim Vergleich von Self-Hosting mit einer API dieselbe Einheit bei.
Wann spart Self-Hosting Geld?
Es spart eher Geld, wenn die Nachfrage stabil ist, die Kapazität gut ausgelastet bleibt, Modell und Deployment stabil sind und direkte Kontrolle zusätzlichen Wert schafft. Es spart weniger wahrscheinlich Geld, wenn der Traffic sprunghaft ist, sich die Modellauswahl häufig ändert oder der operative Overhead die Kapazitätseinsparungen überwiegt.
Fazit
Die belastbare Kennzahl für Kosten selbstgehosteter LLMs pro Million Tokens ist die voll belastete bezahlte Kapazität geteilt durch den akzeptierten Durchsatz. Messen Sie Prefill und Decoding getrennt, berücksichtigen Sie Leerlaufzeit nur einmal, versionieren Sie Ihre Akzeptanzregel und vergleichen Sie eine gemanagte Referenz auf derselben Einheit. So wird aus einem GPU-Angebot ein entscheidungsreifes Kostenmodell.