Biaya LLM Self-Hosted per Juta Token: Model Biaya GPU yang Dapat Direproduksi
Cara andal untuk menghitung biaya LLM self-hosted per juta token adalah membagi biaya penyajian yang dimuat sepenuhnya dengan token yang benar-benar diterima oleh beban kerja Anda—bukan dengan throughput puncak GPU yang diiklankan.
Perbedaan tersebut penting. Sebuah GPU dapat memiliki hasil benchmark yang baik, tetapi mahal dalam produksi ketika menghabiskan waktu berbayar dalam keadaan menganggur, memproses prompt yang sangat panjang, mencoba ulang permintaan yang gagal, atau menghasilkan output yang ditolak oleh produk Anda. Panduan ini menyediakan model yang dapat diulang untuk biaya LLM self-hosted per juta token, lembar kerja, contoh perhitungan, dan cara yang adil untuk membandingkan endpoint yang dikelola sendiri dengan API terkelola.
Diperbarui pada 16 Oktober 2026. Semua nilai dolar dan throughput di bawah ini merupakan input ilustratif, bukan kutipan harga penyedia atau klaim performa.
Rumus biaya LLM self-hosted per juta token
Untuk perspektif token output, gunakan:
biaya per 1 juta token output yang diterima =
  biaya penyajian per jam yang dimuat sepenuhnya
  / (token output/detik pada jendela aktif × 3.600 × utilisasi waktu berbayar × tingkat keberhasilan × tingkat penerimaan)
  × 1.000.000
Dengan keterangan:
| Input | Definisi | Cara menggunakannya |
|---|---|---|
| Biaya penyajian per jam yang dimuat sepenuhnya | Setiap biaya yang diperlukan untuk menjaga kapasitas tetap tersedia selama satu jam berbayar | Sertakan node GPU, CPU/RAM, penyimpanan, jaringan, control plane, observabilitas, dukungan, dan porsi yang dialokasikan untuk pekerjaan operasional. |
| Token output/detik pada jendela aktif | Throughput output yang dihasilkan ketika endpoint melayani beban kerja dengan karakteristik produksi | Ukur dengan model, presisi, distribusi panjang konteks, konkurensi, dan target latensi aktual Anda. |
| Utilisasi waktu berbayar | Detik penyajian yang berguna dibagi dengan detik kapasitas berbayar | Ini tidak sama dengan pembacaan utilisasi SM sesaat pada GPU. |
| Tingkat keberhasilan | Permintaan yang selesai dibagi dengan permintaan yang dimulai | Hitung timeout, OOM, respons 5xx, dan eksekusi tool/skema yang gagal secara konsisten. |
| Tingkat penerimaan | Output yang lolos uji kualitas, keamanan, skema, dan peninjauan manusia produk | Ini mengonversi output yang dihasilkan menjadi output yang berguna. |
Penyebutnya adalah kuncinya. Biaya LLM self-hosted per juta token harus merupakan biaya per unit yang berguna, bukan biaya per benchmark GPU.
Aturan tanpa penghitungan ganda
Gunakan salah satu dari dua jalur pengukuran berikut:
- Ukur throughput pada jendela aktif, lalu kalikan dengan utilisasi waktu berbayar.
- Ukur token yang diterima di seluruh interval berbayar, lalu tetapkan utilisasi ke
1karena waktu menganggur sudah tercakup dalam observasi.
Jangan lakukan keduanya. Menerapkan faktor utilisasi pada throughput waktu nyata yang sudah mencakup waktu menganggur membuat biaya inferensi LLM per token terlihat lebih buruk daripada yang sebenarnya. Mengabaikan utilisasi dari benchmark jendela aktif membuatnya terlihat lebih baik daripada yang sebenarnya.
Lembar kerja biaya GPU per juta token yang dapat disalin
Masukkan satu baris dalam spreadsheet Anda untuk setiap model, topologi perangkat keras, wilayah, dan bentuk beban kerja. Jangan mencampurkan benchmark chat singkat dengan beban kerja produksi berkonteks panjang.
Lembar kerja ini membuat perhitungan biaya LLM self-hosted per juta token dapat diaudit: operator lain seharusnya dapat mengganti input, menjalankan ulang jendela pengukuran, dan mereproduksi hasilnya.
| Bidang | Nilai ilustratif | Catatan pengumpulan |
|---|---|---|
| Model dan presisi | your-model / FP8 |
Catat format bobot yang tepat dan versi mesin penyajian. |
| Topologi GPU | 1 GPU node |
Catat SKU, faktor bentuk, jumlah GPU, dan interkoneksi. |
| Biaya per jam yang dimuat sepenuhnya | $4.07 |
Jumlahkan setiap biaya berbayar untuk kapasitas yang digunakan dalam baris tersebut. |
| Token output/detik pada jendela aktif | 900 |
Ukur berdasarkan target latensi p95 yang disetujui. |
| Utilisasi waktu berbayar | 55% |
Waktu penyajian yang berguna dibagi dengan waktu kapasitas berbayar. |
| Tingkat keberhasilan permintaan | 98% |
Permintaan yang selesai tanpa kegagalan infrastruktur. |
| Tingkat penerimaan output | 92% |
Output yang lolos aturan evaluasi yang telah Anda sepakati. |
| Token output yang diterima/jam | 1,606,176 |
900 × 3,600 × 0.55 × 0.98 × 0.92 |
| Biaya per 1 juta token output yang diterima | $2.53 |
$4.07 ÷ 1,606,176 × 1,000,000 |
Ini adalah perhitungan ilustratif, bukan daftar harga untuk GPU apa pun. Mengganti lima input dengan nilai terukur akan menghasilkan biaya GPU per juta token Anda sendiri.
Contoh perhitungan: mengapa utilisasi mengubah jawabannya
Pertahankan biaya per jam yang dimuat sepenuhnya sebesar $4.07 dan 900 token output/detik pada jendela aktif untuk endpoint hipotetis tersebut. Perubahan kecil pada input dapat mengubah biaya unit secara tajam.
| Skenario | Utilisasi waktu berbayar | Keberhasilan × penerimaan | Biaya per 1 juta token output yang diterima |
|---|---|---|---|
| Baseline | 55% | 90.2% | $2.53 |
| Kapasitas sama, permintaan lebih stabil | 75% | 90.2% | $1.86 |
| Kapasitas sama, permintaan fluktuatif | 25% | 90.2% | $5.57 |
| Kapasitas sama, penerimaan lebih rendah | 55% | 68.6% | $3.33 |
| Konfigurasi ilustratif yang lebih cepat: $5.35/jam, 1,300 tok/dtk, utilisasi 60% | 60% | 90.2% | $2.11 |
Pelajarannya bukan untuk membeli akselerator tertentu. Pelajarannya adalah bahwa penetapan harga LLM self-hosted merupakan model operasi dan throughput. Biaya node per jam yang lebih tinggi dapat menghasilkan biaya per output yang diterima lebih rendah jika memiliki memori, ruang untuk batching, dan permintaan yang cukup untuk mempertahankan lebih banyak pekerjaan yang berguna. Tarif per jam yang lebih rendah dapat kalah begitu kapasitas menganggur dan percobaan ulang masuk ke penyebut.
Pisahkan prefill dari decode sebelum melakukan benchmark
Penyajian LLM bukanlah satu beban kerja yang homogen. Inferensi memiliki fase pemrosesan konteks (prefill) dan fase generasi (decode); panduan TensorRT-LLM NVIDIA secara eksplisit memperlakukannya sebagai fase terpisah dan menekankan penyetelan khusus beban kerja. Tinjau panduan penyetelan performa TensorRT-LLM sebelum menganggap angka token per detik utama sebagai representatif.
- Prompt panjang, konteks retrieval, dan lampiran besar memberi tekanan pada prefill dan cache KV.
- Jawaban panjang, pembuatan kode, dan penalaran agen memberi tekanan pada kapasitas decode dan waktu per token output.
- Konkurensi tinggi menjadikan perilaku scheduler, batching, residensi cache, dan ruang memori sebagai bagian dari model harga.
Catat distribusi prompt dan output secara terpisah. Untuk asisten yang banyak menggunakan retrieval dengan 20,000 token input dan 300 token output, ekonomi hanya-output dapat melewatkan hambatan sebenarnya. Untuk alur kerja coding dengan 2,000 token input dan 4,000 token output, decode mungkin mendominasi.
Untuk perbandingan biaya LLM self-hosted per juta token yang ketat, pertahankan setidaknya tiga perspektif berikut:
| Perspektif | Penggunaan terbaik | Peringatan penting |
|---|---|---|
| Biaya per 1 juta token input | Beban kerja dengan konteks berat, embedding, reranking | Ini tidak menggambarkan kapasitas decode. |
| Biaya per 1 juta token output | Chat, coding, peringkasan, generasi | Ini dapat menyembunyikan pemrosesan prompt yang mahal. |
| Biaya per respons atau tugas yang diterima | Pengambilan keputusan produk dan FinOps | Ini memerlukan aturan penerimaan yang stabil. |
Ukur penyebut dari telemetri produksi
Jangan menyimpulkan throughput yang diterima dari spesifikasi perangkat keras. Stack penyajian harus mengekspor input yang membuat perhitungan dapat direproduksi.
Contohnya, vLLM mendokumentasikan metrik Prometheus untuk token prompt, token yang dihasilkan, penyelesaian permintaan, penolakan penerimaan, waktu antrean, waktu prefill, waktu decode, penggunaan cache KV, waktu ke token pertama, dan latensi per token output. Semua itu cukup untuk membangun catatan pengukuran alih-alih menebak dari benchmark. Referensi metrik vLLM mencantumkan nama dan makna metrik saat ini.
Catat rekaman ini untuk setiap proses:
measurement_window_start/end
model_id and weights_precision
serving_engine and version
gpu_sku, gpu_count, interconnect, region
input_tokens_p50/p95 and output_tokens_p50/p95
concurrency and request-rate distribution
prompt_tokens_total and generation_tokens_total
request_success_total and admission_rejections_total
time_to_first_token_p50/p95 and time_per_output_token_p50/p95
KV-cache usage and OOM/timeout counts
paid capacity hours and fully loaded hourly cost
acceptance-rule version and accepted-output count
Telemetri perangkat keras berguna, tetapi merupakan alat diagnostik—bukan penyebut biaya per unit. Dokumentasi profiling DCGM NVIDIA mencatat bahwa aktivitas adalah rata-rata interval dan harus dikorelasikan dengan throughput beban kerja yang representatif. Gunakan metrik profiling DCGM untuk menyelidiki apakah komputasi, bandwidth memori, atau perilaku interkoneksi membatasi proses tersebut; jangan mengganti utilisasi waktu berbayar dengan satu persentase utilisasi GPU.
Bangun pembilang yang sepenuhnya dimuat
Harga sewa GPU adalah input, bukan jawabannya. Untuk menghitung biaya penyajian LLM secara adil, sertakan biaya kapasitas dan operasi yang diperlukan untuk jendela pengukuran yang sama.
| Area biaya | Sertakan | Kelalaian umum |
|---|---|---|
| Kapasitas komputasi | GPU, CPU, RAM, host/VM, replika hangat yang dicadangkan | Hanya menghitung satu akselerator ketika kapasitas failover dibayar. |
| Data dan jaringan | Artefak model, penyimpanan blok/objek, egress, penyeimbang beban, jaringan privat | Biaya startup, lintas-zona, atau pengangkutan log. |
| Platform | Kubernetes, Slurm, Ray, antrean, secret, penskalaan otomatis, registry image | Tagihan platform bersama yang muncul pada faktur lain. |
| Observabilitas dan keamanan | Metrik, trace, log, telemetri GPU, pemberitahuan, patching, kontrol audit | Alat yang diperlukan untuk mengoperasikan endpoint yang menghadap pelanggan. |
| Personel dan dukungan | On-call, respons insiden, benchmarking, pemeliharaan deployment, dukungan penyedia | Menganggap waktu engineering nol setelah proof of concept. |
Untuk pilot, laporkan dua angka:
Biaya khusus GPU per 1 juta token
Biaya total per 1 juta token yang diterima
Selisihnya bukan kesalahan; itu adalah biaya operasional layanan self-hosted. Hal ini membuat keputusan penetapan harga LLM self-hosted dapat diaudit.
Sertakan percobaan ulang dan output yang ditolak
Token yang dihasilkan tidak otomatis menjadi token yang berguna. Sebuah permintaan dapat mengonsumsi kapasitas prefill dan decode parsial sebelum mengalami time out, menghasilkan JSON yang tidak valid, gagal dalam panggilan tool, melanggar aturan kebijakan, atau tidak memenuhi ambang kualitas.
Gunakan penyesuaian penerimaan yang dapat direproduksi oleh tim produk Anda:
token output yang diterima =
  token output yang dihasilkan
  × tingkat keberhasilan eksekusi
  × tingkat penerimaan produk
Jika penerimaan diukur pada tingkat permintaan, catat aturan yang tepat: versi evaluator, set sampling, validator skema, protokol peninjauan manusia, atau peristiwa keberhasilan tugas. Mengubah aturan tanpa membuat versinya menjadikan tren biaya tidak bermakna.
Ini juga alasan mengapa biaya inferensi LLM per token mentah dapat menyesatkan. Konfigurasi yang meningkatkan throughput sebesar 30% tetapi menurunkan keberhasilan tugas yang diterima mungkin lebih mahal pada lapisan produk.
Bandingkan self-hosting dengan API terkelola dalam satuan yang sama
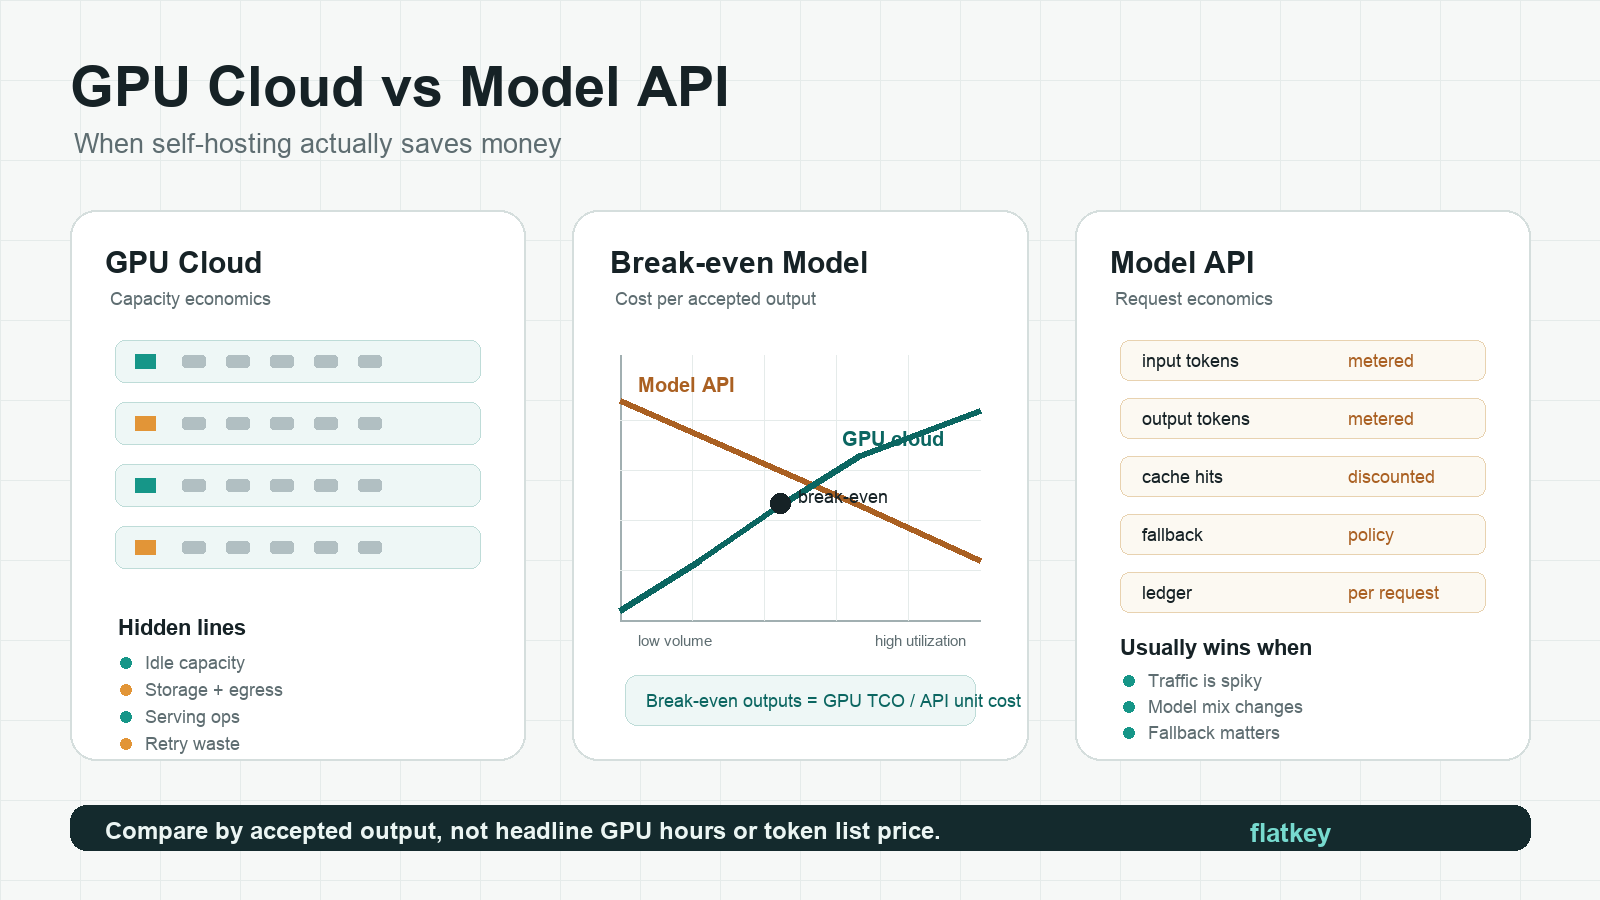
Self-hosting membeli kapasitas. API terkelola membeli penggunaan. Keduanya baru dapat dibandingkan ketika pembilang dan penyebutnya selaras.
Gunakan pemeriksaan throughput titik impas ini ketika benchmark API dinyatakan dalam satuan yang sama:
token output per detik pada jendela aktif yang diperlukan =
  biaya penyajian per jam yang sepenuhnya dibebankan × 1,000,000
  / (biaya API terkelola per 1 juta token output yang diterima × 3,600 × utilisasi × tingkat keberhasilan × tingkat penerimaan)
Sebelum memutuskan, selaraskan kontrol berikut di kedua jalur:
- Model yang sama atau model setara kualitas yang dievaluasi secara eksplisit.
- Distribusi panjang prompt dan output yang sama.
- SLO latensi dan pola konkurensi yang sama.
- Aturan percobaan ulang, fallback, dan penerimaan yang sama.
- Perlakuan yang sama terhadap cache hit, kegagalan tool, dan pekerjaan yang dibatalkan.
Jika kontrol GPU langsung, bobot kustom, penempatan ketat, atau stack kernel khusus merupakan persyaratan, self-hosting mungkin tetap menjadi jawaban yang tepat bahkan di atas baseline terkelola. Jika trafik rendah atau sangat fluktuatif, model sering berubah, atau tim tidak ingin menjalankan infrastruktur inferensi, API dengan harga berbasis penggunaan dapat menyerap risiko utilisasi.
Untuk perbandingan pembelian yang lebih luas, lihat panduan cloud GPU vs. API model dan panduan harga sewa GPU dari Flatkey. Ketika kontrol GPU langsung tidak diperlukan, jalur terkelola merupakan benchmark yang berguna: Flatkey menyediakan API model dan tool terpadu dengan satu saldo, sehingga tim dapat membandingkan jalur terkelola dengan perhitungan self-hosted mereka tanpa mengelola kunci penyedia terpisah. Mulai baseline API Flatkey dengan set pengujian dan aturan penerimaan yang sama.
Uji pengadaan tujuh langkah
Gunakan kerangka kerja biaya LLM self-hosted per juta token ini sebagai artefak pengadaan, bukan sekadar benchmark engineering. Kerangka ini harus menunjukkan secara tepat asumsi beban kerja, kapasitas, dan kualitas mana yang mengubah hasil.
- Tentukan satuannya: token input, token output, token gabungan, respons yang diterima, atau tugas yang diterima.
- Ukur throughput jendela aktif di bawah trafik yang menyerupai produksi, bukan satu prompt sintetis.
- Ukur utilisasi waktu berbayar di seluruh replika berbayar dan node cadangan hangat.
- Tambahkan semua biaya operasional ke pembilang per jam.
- Buat versi untuk aturan keberhasilan dan penerimaan, lalu hitung output yang diterima.
- Jalankan beban kerja yang sama melalui baseline API terkelola.
- Tinjau biaya, latensi p95, keandalan, kualitas, dan upaya engineering secara bersama-sama sebelum mencadangkan kapasitas.
Kesalahan umum dalam model biaya LLM self-hosted
Menggunakan throughput benchmark puncak. Puncak berguna untuk membandingkan penyiapan yang terkendali. Namun, itu bukan throughput yang diharapkan dari campuran produksi Anda.
Menyebut utilisasi GPU sebagai utilisasi kapasitas. GPU yang sibuk tetap dapat terhubung ke endpoint yang terlalu besar untuk permintaan berbayar. Gunakan utilisasi waktu berbayar untuk ekonomi unit dan gunakan telemetri perangkat keras untuk mendiagnosis penyebabnya.
Menerapkan utilisasi dua kali. Pilih throughput jendela aktif ditambah utilisasi, atau throughput waktu dinding yang sudah mencakup waktu idle.
Mengabaikan token prompt. Konteks panjang meningkatkan tekanan prefill dan cache KV bahkan ketika produk terutama menagih untuk output.
Menganggap setiap token yang dihasilkan sebagai diterima. Percobaan ulang, argumen alat yang tidak valid, kegagalan skema, dan penolakan kualitas adalah pekerjaan berbayar.
Membandingkan faktur GPU hanya dengan harga daftar API. Rekayasa, dukungan, penyimpanan, jaringan, observabilitas, dan kapasitas siaga harus dimasukkan dalam perhitungan yang sama.
Untuk keputusan lengkap (kapan self-hosting menguntungkan, penentuan ukuran memori GPU, alat, dan penyiapan server langkah demi langkah), lihat panduan LLM self-hosted kami.
Pertanyaan yang sering diajukan
Bagaimana cara menghitung biaya LLM self-hosted per juta token?
Bagi biaya serving per jam yang sepenuhnya dibebankan dengan token yang diterima per jam berbayar, lalu kalikan dengan 1.000.000. Gunakan throughput terukur yang mencerminkan produksi, utilisasi waktu berbayar, tingkat keberhasilan, dan tingkat penerimaan—bukan puncak GPU teoretis.
Apakah biaya GPU per juta token sama dengan biaya inferensi LLM per token?
Biaya GPU per juta token dapat menjadi metrik infrastruktur khusus GPU. Biaya inferensi LLM per token harus mencakup pembilang operasional yang relevan dan penyebut yang didefinisikan dengan jelas. Untuk keputusan produk, biaya per respons atau tugas yang diterima sering kali merupakan metrik pendamping yang lebih aman.
Haruskah saya menggunakan token output atau total token?
Gunakan keduanya ketika biaya prompt dan output memiliki bottleneck yang berbeda. Token output mudah dibandingkan untuk beban kerja generatif; total token atau token berbobot lebih baik merepresentasikan beban kerja pengambilan dengan konteks panjang. Pertahankan unit yang identik saat membandingkan self-hosting dengan API.
Kapan self-hosting menghemat biaya?
Self-hosting lebih mungkin menghemat biaya ketika permintaan stabil, kapasitas tetap dimanfaatkan dengan baik, model dan deployment stabil, serta kontrol langsung memberikan nilai tambah. Self-hosting lebih kecil kemungkinannya menghemat biaya ketika lalu lintas tidak menentu, pemilihan model sering berubah, atau overhead operasional melebihi penghematan kapasitas.
Kesimpulan
Angka biaya LLM self-hosted per juta token yang dapat dipertanggungjawabkan adalah kapasitas berbayar yang sepenuhnya dibebankan dibagi throughput yang diterima. Ukur prefill dan decode secara terpisah, perhitungkan waktu idle satu kali, buat versi aturan penerimaan Anda, dan bandingkan baseline terkelola dalam unit yang sama. Hal itu mengubah penawaran harga GPU menjadi model biaya yang siap digunakan untuk pengambilan keputusan.