
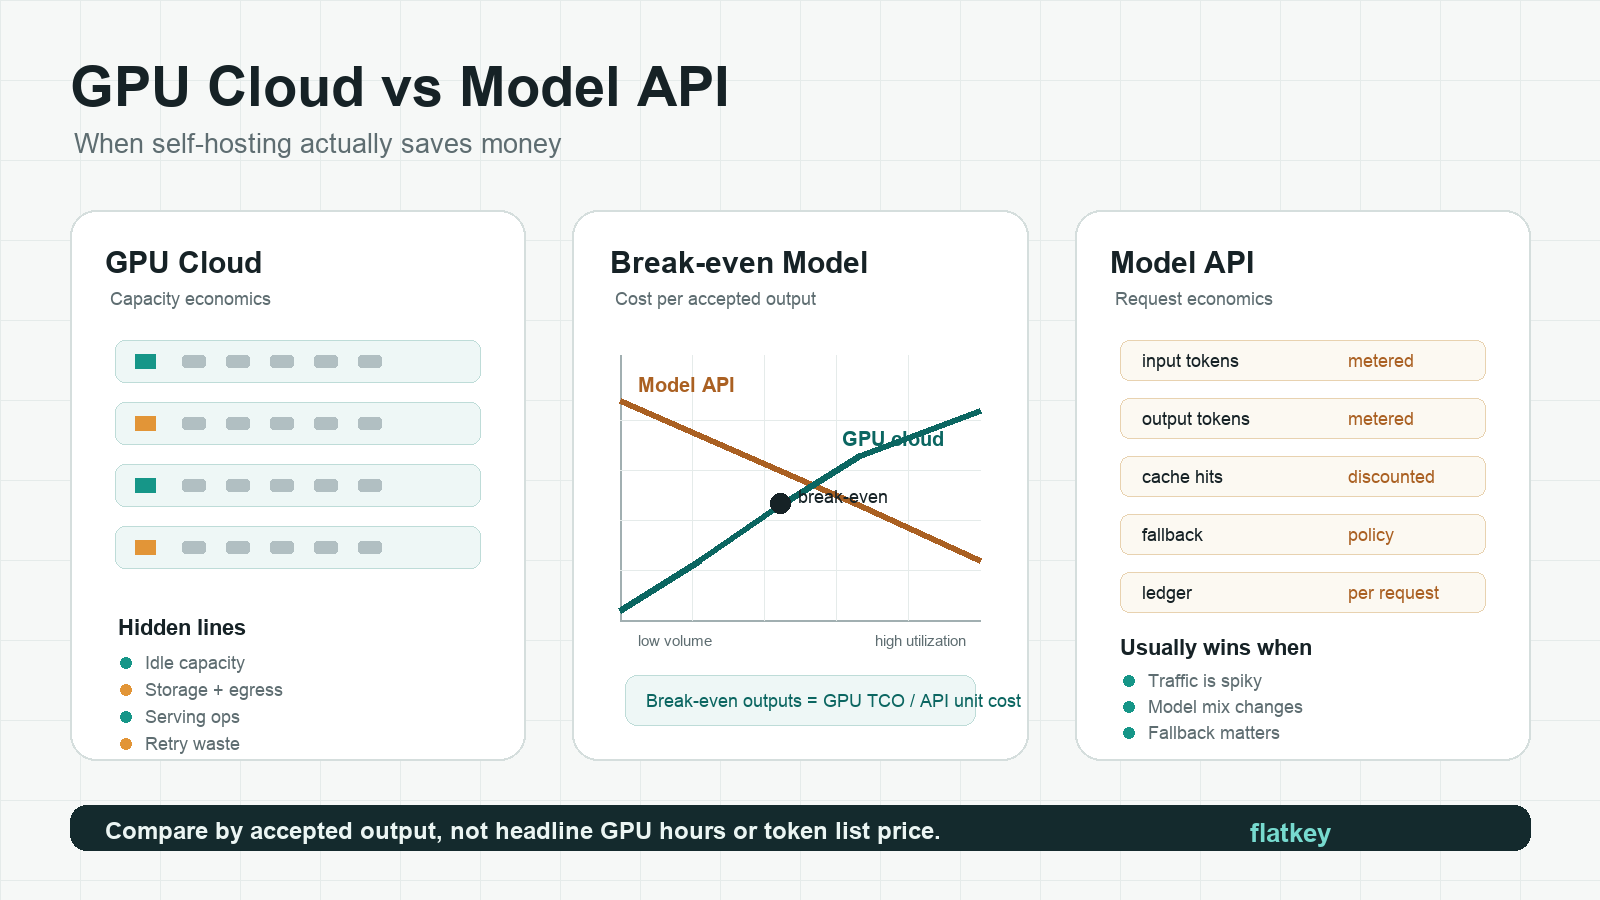
Die meisten Teams stellen die Frage GPU-Cloud vs. Model-API zu spät. Sie mieten GPUs, implementieren einen Serving-Stack, optimieren Batching, stellen Plattform-Support ein und vergleichen erst dann die Rechnung mit einer verwalteten Model-API. Zu diesem Zeitpunkt ist der Vergleich bereits zugunsten des Wegs verzerrt, in den sie bereits Aufwand investiert haben.
Die bessere Frage ist einfacher: Benötigen Sie Kontrolle über die GPU-Ebene, oder benötigen Sie zuverlässige Modellausgaben zu den niedrigsten akzeptierten Kosten?
Für Enterprise-AI-Teams beginnt die GPU-Cloud dann, Geld zu sparen, wenn Sie eine anhaltende Nachfrage, eine stabile Modellwahl, eine hohe sinnvolle Auslastung und das Engineering-Team haben, um Inference zu betreiben. Eine Model-API ist in der Regel günstiger, wenn der Traffic unregelmäßig ist, die Modellwahl häufig wechselt, Retries und Failover wichtiger sind als Hardwarekontrolle oder Sie Frontier-Modelle benötigen, die nicht selbst gehostet werden können.
Die praktische Regel von Flatkey: Vergleichen Sie GPU-Cloud vs. Model-API anhand der Kosten pro akzeptierter Ausgabe, nicht nur anhand des GPU-Stundensatzes oder des Listenpreises pro Token.
GPU-Cloud vs. Model-API: Kurzantwort
Nutzen Sie diese Tabelle, bevor Sie eine Kalkulationstabelle erstellen.
| Situation | Beginnen Sie normalerweise mit | Warum |
|---|---|---|
| Frühes Produkt, wechselnde Prompts, unklare Nachfrage | Model-API | Sie vermeiden ungenutzte GPUs, während Sie Traffic, Qualität und Modell-Fit kennenlernen. |
| Batch-Inference mit hohem Volumen auf einem stabilen Open-Model | GPU-Cloud | Anhaltende Auslastung kann den Serving-Stack amortisieren. |
| Customer-facing Chat mit unvorhersehbaren Spitzen | Model-API oder Hybrid | Autoscaling, Fallback und keine ungenutzte Kapazität sind oft wichtiger als der reine Stückpreis. |
| Proprietäre Gewichte, benutzerdefinierte Kernel, strikte Datenlokalität | GPU-Cloud | Die geschäftliche Anforderung ist Kontrolle, nicht nur Kosten. |
| Multi-Provider-Model-Routing, Frontier-Modelle oder häufige Modellwechsel | Model-API | Sie vermeiden es, die Serving-Infrastruktur bei jeder Modelländerung neu aufzubauen. |
| Langfristige, stabile Workload mit nachgewiesener Auslastung | Reservierte GPU-Cloud, dedizierter GPU-Cluster oder colocated GPUs | Eine Bindung kann die effektiven Kapazitätskosten senken, nachdem die Nachfrage belegt ist. |
Der Rest dieses Leitfadens liefert ein kopierbares Modell zum Vergleichen von GPU-Cloud vs. Model-API, ohne Leerlaufzeit, Retries, Betrieb oder Qualitätsfilter zu verschleiern.
Die Kostenbasis, die tatsächlich zählt
Vergleichen Sie nicht:
- GPU-Stundensatz vs. Token-Preis.
- Cloud-Angebot vs. ein Best-Case-Benchmark.
- Listenpreis der Model-API vs. ein vollständig ausgelasteter Self-Hosted-Cluster.
Vergleichen Sie stattdessen einen dieser Nenner:
| Workload | Bester Nenner |
|---|---|
| LLM-Chat oder Agents | Kosten pro akzeptierter Antwort, akzeptierter Aufgabe oder akzeptiertem Ausgabetoken |
| Batch-Klassifizierung oder Extraktion | Kosten pro akzeptiertem Datensatz |
| Codegenerierung | Kosten pro akzeptiertem Patch oder abgeschlossener Coding-Aufgabe |
| Bildgenerierung | Kosten pro akzeptiertem Bild nach Qualitätsfiltern |
| Videogenerierung | Kosten pro akzeptierter Sekunde oder akzeptiertem Clip |
| Fine-Tuning oder Training | Kosten pro abgeschlossenem Lauf |
Für die meisten Inference-Teams:
effective_unit_cost =
  all_in_monthly_cost
  / accepted_outputs_after_retries_quality_filters_and_failures
Hier kippen viele Vergleiche zwischen GPU-Cloud und Model-API. Ein selbst gehosteter Endpunkt kann großartige Benchmark-Throughput-Werte zeigen und trotzdem verlieren, wenn die Auslastung niedrig ist, das Modell Qualitätsprüfungen nicht besteht oder Ingenieure zu viel Zeit damit verbringen, den Stack gesund zu halten.
Kostenmodell der Model-API
Eine Model-API wirkt einfach, weil die Rechnung meist nach Anfrage, Token, Bild, Videosekunde oder Tool-Aufruf abgerechnet wird. Aber ein faires Model-API-Modell braucht trotzdem mehr als den veröffentlichten Stückpreis.
Verwenden Sie dieses Modell:
monthly_model_api_cost =
  input_token_cost
  + cached_input_or_context_cost
  + output_token_cost
  + tool_or_media_cost
  + retry_and_fallback_cost
  + gateway_or_router_cost
  + observability_and_finops_cost
Dann normalisieren:
model_api_cost_per_accepted_output =
  monthly_model_api_cost
  / accepted_outputs
Was zu erfassen ist:
| Kostenposition | Worauf zu achten ist |
|---|---|
| Input- und Output-Tokens | Offizielle Pricing-Seite des Anbieters, Modell-ID, Context Window, Output-Limit und geprüftes Datum. |
| Zwischengespeicherter Input | Ob der Anbieter Prompt Caching oder Cache-Hit-Rabatte unterstützt und ob Ihre Workload Kontext tatsächlich wiederverwendet. |
| Batch-Preise | Ob Batch- oder Async-Verarbeitung zu Ihren Latenzanforderungen passt. |
| Retries | Rate-Limit-Retries, vorübergehende Fehler, fehlgeschlagene Qualitätsprüfungen und Fallback-Anfragen. |
| Router-/Gateway-Schicht | Gebühren für das Gateway, Usage Ledger, Model-Allowlist, Sub-Key-Budget oder Invoice-Workflow. |
| Betrieb | Integration, Monitoring, Behandlung des Provider-Status und finanzielle Abstimmung. |
Verwenden Sie aktuelle Zahlen von den offiziellen Quellseiten, nicht kopierte Preistabellen. Beginnen Sie mit OpenAI API pricing, Anthropic pricing, Google Gemini API pricing und der aktuellen Preisseite Ihres Gateways oder Routers.
Für Flatkey geht es auf der Model-API-Seite um einen Schlüssel, ein Guthaben und ein Nutzungsprotokoll über offizielle Modelle und Tools hinweg. Das ist wichtig, wenn das eigentliche Kostenproblem nicht ein einzelner Modellaufruf ist, sondern verstreute Schlüssel, mehrere Rechnungen, teamweite Budgetkontrollen und Fallbacks über Anbieter hinweg.
GPU-Cloud-Kostenmodell
GPU-Cloud ist nicht nur der stündliche GPU-Preis. Eine produktive selbst gehostete Model-API hat Kapitalkosten für Kapazität, Serving-Software, Speicher, Netzwerk, Monitoring, Aufwand für Verfügbarkeit und ungenutzte Kapazität.
Verwenden Sie dieses Modell:
monthly_gpu_cloud_cost =
  gpu_compute_hours
  + storage_and_snapshot_cost
  + bandwidth_and_egress_cost
  + load_balancing_and_network_cost
  + serving_stack_cost
  + observability_and_logging_cost
  + platform_engineering_cost
  + support_plan_or_managed_service_cost
  + idle_capacity_cost
  + retry_failure_and_redeployment_waste
Dann normalisieren Sie:
self_hosted_cost_per_accepted_output =
  monthly_gpu_cloud_cost
  / accepted_outputs
Was erfasst werden sollte:
| Kostenposition | Warum sie die Antwort verändert |
|---|---|
| GPU-Modell und Speicher | H100-, H200-, B200-, A100-, L40S- und RTX-Klasse-GPUs haben unterschiedliche Speicher-, Durchsatz-, Verfügbarkeits- und Preiskurven. |
| Produktmodus | On-Demand, Spot, Reserved, Marketplace, serverless GPU, dedizierter Cluster und Bare Metal haben unterschiedliche Zuverlässigkeitsprofile. |
| Auslastung | Ein günstigerer selbst gehosteter Endpunkt verliert schnell an Vorteil, wenn die GPU ungenutzt bleibt. |
| Serving-Stack | vLLM, SGLang, TensorRT-LLM, NIM oder benutzerdefinierte Server benötigen echten Operations-Support. |
| Speicher und Modellladen | Große Gewichte, Snapshots, Volumes und wiederholte Pulls können relevant werden. |
| Netzwerk | Egress, private Verbindungen, öffentliche IPs und Load Balancing können die Stückkosten verändern. |
| Fehler | Out-of-memory-Fehler, Preemptions, fehlerhafte Container und Cold Starts erhöhen die Kosten pro akzeptierter Ausgabe. |
Nutzen Sie aktuelle Anbieterseiten als Prüfsteine: AWS EC2 pricing, AWS P5 instances, Google Cloud GPU pricing, RunPod pricing, Lambda GPU Cloud und Vast.ai pricing.
Behandeln Sie jeden GPU-Preis als mit Zeitstempel versehen. Marktverfügbarkeit, regionale Verfügbarkeit und verbindliche Angebote können sich schneller ändern als der Artikel, den Sie gerade lesen.
Die Break-even-Formel
Hier wird die Entscheidung zwischen GPU-Cloud und Model-API zu einer finanzwirtschaftlichen statt einer meinungsgetriebenen Frage.
Das einfachste Break-even-Modell lautet:
break_even_outputs =
  monthly_gpu_cloud_cost
  / model_api_cost_per_accepted_output
Wenn Ihr Workload mehr akzeptierte Ausgaben erzeugt als break_even_outputs, kann Self-Hosting Geld sparen. Wenn er weniger erzeugt, ist eine Model-API wahrscheinlich günstiger.
Sie können dieselbe Idee auch als Auslastung ausdrücken:
required_utilization =
  monthly_gpu_cloud_cost
  / equivalent_model_api_cost_at_expected_volume
Diese Formel ist nur dann nützlich, wenn der Workload stabil ist. Wenn Volumen, Modell, Kontextlänge oder Qualitätsziel sich jeden Monat ändern, hat die Model-API-Seite einen Optionswert, den eine Auslastungsformel nicht erfasst.
Rechenbeispiel: Warum der stündliche GPU-Preis in die Irre führen kann
Angenommen, ein Team entscheidet, ob es ein stabiles Open Model selbst hosten soll.
| Eingabe | Beispielwert |
|---|---|
| All-in-GPU-Cloud-Kosten | 24.000 $ pro Monat |
| Volumen akzeptierter Ausgaben | 30 Millionen akzeptierte Ausgaben pro Monat |
| Kosten pro akzeptierter Ausgabe beim Self-Hosting | 0,0008 $ |
| Kosten pro akzeptierter Ausgabe über die Model-API | 0,0012 $ |
| Monatliche Model-API-Kosten bei gleichem Volumen | 36.000 $ |
| Offensichtliche Einsparung durch Self-Hosting | 12.000 $ pro Monat |
In diesem Basisszenario scheint GPU-Cloud Geld zu sparen.
Nun die Annahmen auf die Probe stellen.
| Änderung | Auswirkung |
|---|---|
| Die nutzbare Auslastung sinkt um 35 % | Die Stückkosten beim Self-Hosting steigen, weil der feste GPU-Pool weniger akzeptierte Arbeit erledigt. |
| Die Retry- oder Qualitätsfehlerquote verdoppelt sich | Beide Wege werden teurer, aber Self-Hosting trägt zusätzlich Kapazitätsverschwendung. |
| Das Produkt wechselt zu einem größeren Modell | Vorhandene GPUs benötigen möglicherweise Sharding, mehr Speicher oder einen neuen Serving-Stack. |
| Die Nachfrage wird sprunghaft | Die Model-API kann mit der Nachfrage skalieren; der GPU-Pool muss für Peaks dimensioniert sein oder Warteschlangen akzeptieren. |
Wenn das Negativszenario die Einsparungen zunichte macht, ist Self-Hosting nicht wirklich günstiger. Es ist eine Kapazitätswette.
Wann GPU-Cloud tatsächlich Geld spart
GPU-Cloud kann Geld sparen, wenn die meisten dieser Punkte zutreffen:
- Sie haben eine anhaltende Nachfrage, nicht nur gelegentliche Spitzen.
- Die Modellfamilie ist über Monate stabil, nicht nur über Tage.
- Das Modell ist Open-Weight oder anderweitig zum Self-Hosting verfügbar.
- Die Workload hat eine hohe nutzbare Auslastung auch nach Warteschlangenlücken und Ausfällen.
- Die Latenzanforderungen lassen sich mit Ihrem Serving-Stack einhalten.
- Sie können vLLM, SGLang, TensorRT-LLM, NIM oder einen anderen Stack zuverlässig betreiben.
- Das Team kann GPU-Auslastung, Speicherdruck, p95/p99-Latenz, Fehlerrate und Retry-Verstärkung überwachen.
- Sie haben einen Plan für Model-Loading, Cache-Warming, Shutdown-Automatisierung und sichere Rollouts.
- Das Angebot umfasst Speicher, Egress, Support und Annahmen zur Verfügbarkeit.
- Die Finanzabteilung ist damit einverstanden, Kapazität zu finanzieren, bevor jede Anfrage eintrifft.
Das ist typisch für Batch-Inference mit hohem Volumen, interne Extraktionspipelines, stabile Support-Bots, domänenspezifische Open-Modelle und Workloads, bei denen kundenspezifische Gewichte oder Datenlokalität wichtig sind.
Für eine tiefere GPU-seitige Planung nutzen Sie die Anleitungen von Flatkey zu GPU-Mietpreisen, der besten GPU für LLM-Inference, GPU-Cluster-Miete und TCO von GPU-Clustern.
Wann Model-APIs günstiger bleiben
Model-APIs bleiben normalerweise günstiger, wenn Folgendes zutrifft:
- Der Traffic ist sprunghaft, saisonal oder noch unbekannt.
- Die App benötigt mehrere Frontier-Modelle.
- Das Modell verändert sich schneller als Ihr Infrastrukturplan.
- Das Team braucht eher Fallback, Rate-Limit-Behandlung, Rechnungen, Nutzungsprotokolle und Budgetkontrollen als Hardware-Kontrolle.
- Sie können GPUs nicht ausreichend auslasten, um Leerlaufzeiten auszugleichen.
- Sie haben kein Platform-Team, das bereit ist, die Serving-Schicht zu betreiben.
- Die Workload umfasst geschlossene Modelle, multimodale Generierung, proprietäre Provider-Funktionen oder schnell erscheinende Modell-Launches.
- Der Einkauf möchte eine Zuordnung pro Anfrage statt einer gebündelten Infrastrukturechnung.
Hier geht es beim Vergleich GPU-Cloud vs. Model-API nicht nur um den Preis. Eine Model-API kann Integrationszeit, Beschaffungskomplexität und die Angriffsfläche für Incidents reduzieren.
Flatkey passt zu dieser Seite der Entscheidung, wenn Teams einen OpenAI-kompatiblen Weg für viele offizielle Modelle, ein einziges Prepaid-Guthaben, eine einzige Rechnung, Budgets pro Sub-Key, Allowlists für Modelle, Nutzungsdaten auf Anfrageebene und Failover über Upstream-Kanäle hinweg wollen. Siehe die passenden Leitfäden zu Preisvergleich von KI-Modellen, Preisvergleich von KI-APIs, Preisgestaltung von KI-Gateways und KI-API-Ausgabenmanagement.
Hybrid ist oft die eigentliche Antwort
Viele Enterprise-KI-Teams sollten nicht eine einzige universelle Antwort erzwingen. Ein hybrides Modell ist oft besser vertretbar:
| Workload-Teil | Bessere Standardoption |
|---|---|
| Stabile Open-Weight-Inference mit hohem Volumen | GPU-Cloud |
| Reasoning oder Coding mit Frontier-Modellen | Model-API |
| Batch-Jobs, die warten können | GPU-Cloud, Spot oder reservierte Kapazität |
| Kundennahe Spitzenlasten | Model-API oder hybrider Overflow |
| Proprietäre Gewichte | GPU-Cloud |
| Modellerkundung | Model-API |
| Regulierter Betrieb mit Infrastrukturkontrolle | Dedizierte GPU-Cloud, private GPU-Cloud, Colocation oder On-Premises |
Das Hybridmuster ist:
- Leiten Sie unbekannte und variable Workloads über Model-APIs.
- Benchmarken Sie stabile Workloads auf der GPU-Cloud.
- Verschieben Sie nur die Workloads mit nachgewiesenem Volumen und stabilen Modellen ins Self-Hosting.
- Behalten Sie ein Model-API-Fallback für Overflow, Modell-Upgrades und Provider-Diversität bei.
Dieser Weg vermeidet den teuersten Fehler: GPU-Kapazität für eine Workload zu kaufen, die später eine andere Form annimmt.
Benchmark-Plan vor dem Wechsel
Führen Sie denselben Traffic durch beide Wege für mindestens ein repräsentatives Zeitfenster aus.
| Metrik | GPU-Cloud-Pfad | Model-API-Pfad |
|---|---|---|
| Akzeptierte Ausgaben | ||
| Input-Tokens oder Datensätze | ||
| Output-Tokens oder Ergebnisse | ||
| p50 / p95 / p99-Latenz | ||
| Zeit bis zum ersten Token | ||
| Fehlerrate | ||
| Retry-Rate | ||
| Qualitäts-Ablehnungsrate | ||
| Leerkapazität | N/A | |
| Arbeitsstunden | ||
| Speicher und Egress | ||
| Gesamtkosten | ||
| Kosten pro akzeptierter Ausgabe |
Dann fragen Sie:
- Gewinnt die GPU-Cloud immer noch trotz Leerlaufzeit?
- Gewinnt sie immer noch unter Einrechnung der Arbeitszeit?
- Gewinnt sie immer noch nach Retries und Qualitätsfiltern?
- Gewinnt sie immer noch, wenn sich das Modell ändert?
- Gewinnt sie immer noch, wenn der Traffic um 30 % sinkt?
- Gewinnt sie immer noch, wenn die p95-Latenz besser werden muss?
Wenn die Antwort im Negativszenario Ja lautet, verdient Self-Hosting einen ernsthaften Beschaffungsprozess.
Beschaffungs-Checkliste
Für GPU-Cloud:
- Welche genaue GPU, welcher Speichergröße, CPU, RAM, welche Festplatte, Interconnect und welche Netzwerkbandbreite sind enthalten?
- Ist die Kapazität On-Demand, Spot, Marketplace, Secure Cloud, reserviert, dediziert oder Bare Metal?
- Welche Kosten für Storage, Snapshots, Egress, öffentliche IP, Load Balancer, Support und Observability sind ausgeschlossen?
- Was passiert bei Host-Ausfall, Preemption, Wartung oder Kapazitätsengpässen?
- Kann der Anbieter Ihren tatsächlichen Benchmark vor der Bindung ausführen?
- Wie lange ist die Mindestlaufzeit, wie sieht der Ramp-up-Pfad aus und welche Ausstiegskosten fallen an?
Für Model-APIs:
- Welche genauen Modell-IDs, Kontextfenster, Ausgabeobergrenzen und Preiseinheiten werden verwendet?
- Werden Cache-Treffer, Batch-Jobs, Bild-/Video-Einheiten und Tool-Aufrufe separat berechnet?
- Wie sehen die Rate Limits und Fallback-Optionen aus?
- Wie werden Retries, fehlgeschlagene Provider-Aufrufe und Qualitätsablehnungen gezählt?
- Kann Finance die Nutzung nach Team, Schlüssel, Modell, Umgebung und Kunde exportieren?
- Welche Datenaufbewahrungs-, Compliance- und SLA-Bedingungen gelten?
Quellen-Checkliste
Nutzen Sie diese offiziellen Seiten als Ausgangspunkt für aktuelle Eingaben:
| Quellentyp | Zu prüfende Seiten |
|---|---|
| Model-API-Preise | OpenAI API pricing, Anthropic pricing, Google Gemini API pricing |
| GPU-Cloud-Preise | AWS EC2 pricing, AWS P5 instances, Google Cloud GPU pricing, RunPod pricing, Lambda GPU Cloud, Vast.ai pricing |
| Serving-Frameworks | vLLM OpenAI-compatible server, SGLang documentation |
| GPU-Spezifikationen | NVIDIA H100, NVIDIA H200, NVIDIA DGX B200 |
| FinOps-Struktur | FinOps FOCUS |
| Flatkey-Kostenkontext | Flatkey pricing, Flatkey Compute, Flatkey Compute price index |
Häufig gestellte Fragen
Ist GPU-Cloud immer günstiger als eine Model-API?
Nein. GPU-Cloud ist nur dann günstiger, wenn die nutzbare Auslastung hoch genug ist, um ungenutzte Kapazität, Storage, Egress, Serving-Operationen, Retry-Verschwendung und Mitarbeiterzeit auszugleichen. Eine Model-API kann für schwankende oder sich ändernde Workloads günstiger sein, selbst wenn der Tokenpreis höher aussieht.
Wann spart das Self-Hosting eines LLM Geld?
Self-Hosting spart Geld, wenn das Modell stabil ist, das Volumen hoch ist, die Auslastung vorhersehbar ist, das Team den Serving-Stack betreiben kann und die All-in-GPU-Cloud-Kosten pro akzeptierter Ausgabe unter den Model-API-Kosten unter ungünstigen Annahmen liegen.
Wie sollte ich GPU-Cloud- und Model-API-Preise vergleichen?
Vergleichen Sie die Kosten pro akzeptierter Ausgabe. Berücksichtigen Sie Tokens, GPU-Stunden, Storage, Bandbreite, Leerlaufzeit, Retries, Fehlerrate, Qualitätsfilter, Engineering-Zeit, Support und Finance-Operations. Vergleichen Sie nicht nur den stündlichen GPU-Preis mit dem Listenpreis pro Token.
Was ist die größte versteckte Kostenposition bei GPU-Cloud-Inferenz?
Die größten versteckten Kosten sind meist ungenutzte Kapazität, Engineering-Operations, Storage und Egress, fehlgeschlagene Deployments, Out-of-Memory-Retries und unzureichend getestete Änderungen am Serving. Diese Kosten erscheinen nicht im offensichtlichen stündlichen GPU-Tarif.
Was ist die größte versteckte Kostenposition bei Model-APIs?
Die größten versteckten Kosten sind meist Retries, Fallback-Aufrufe, lange Prompts, ungecachter Kontext, ausgabeintensive Antworten, Tool- oder Media-Aufrufe, verstreute Provider-Konten und eine schwache Nutzungszuordnung. Ein Request-Level-Ledger hilft, diese Kosten sichtbar zu machen.
Sollten Enterprise-AI-Teams eine hybride Architektur verwenden?
Oft ja. Verwenden Sie Model-APIs für Exploration, Frontier-Modelle, Lastspitzen und Fallback. Verlagern Sie nur stabile Workloads mit hohem Volumen in die GPU-Cloud, nachdem ein Benchmark belegt hat, dass die akzeptierten Kosten niedriger sind. Halten Sie den API-Pfad für Überlauf und Modelländerungen verfügbar.
Fazit
GPU-Cloud vs. Model-API ist keine philosophische Entscheidung. GPU-Cloud vs. Model-API ist eine Entscheidung über die Wirtschaftlichkeit von Workloads.
Wählen Sie GPU-Cloud, wenn Sie die Kapazität auslasten können, das Modell stabil ist und Hardwarekontrolle einen echten Vorteil schafft. Wählen Sie eine Model-API, wenn Flexibilität, Multi-Provider-Zugriff, schnellere Modellwechsel und Governance pro Anfrage mehr wert sind als theoretische Hardwareeinsparungen.
Der sicherste Weg ist gestaffelt: Starten Sie mit der Model-API, benchmarken Sie den Workload, verschieben Sie stabile Teilmengen erst dann in die GPU-Cloud, wenn die Break-even-Rechnung auch in Negativszenarien standhält, und behalten Sie einen API-Pfad für Fallback und zukünftige Modelländerungen bei.
Wenn Sie für eine produktive KI-Workload GPU-Cloud mit Model-API vergleichen, kann Flatkey auf der API-Seite mit einem Schlüssel, einem Guthaben, offiziellen Modellrouten, Nutzungsprotokollen, Budgets und Rechnungen helfen, während Ihr Team nachweist, welche Workloads tatsächlich dedizierte GPU-Kapazitäten verdienen.


