Wenn Sie bereits über GPU-Kapazität verfügen, ermöglicht ein OpenAI-kompatibler Inference-Server Ihrer Anwendung, die gleiche Client-Struktur beizubehalten, während Sie das Backend von einer gehosteten Modell-API auf Ihre eigene Infrastruktur umstellen. Der übliche Weg ist konzeptionell einfach: vLLM oder LocalAI auf einem GPU-Knoten ausführen, eine /v1-API bereitstellen, den base_url Ihres SDK auf diesen Endpunkt setzen und den Dienst dann für Authentifizierung, Routing, Monitoring und Kapazität absichern.
Dieser Leitfaden konzentriert sich auf den praktischen Aufbau: wie Sie einen vllm inference server openai compatible api bereitstellen, was Sie testen sollten, bevor Sie ihn hinter Produktionsverkehr schalten, und wann es sinnvoller ist, Self-Hosting als Benchmark beizubehalten, während Sie die meisten Workloads über eine verwaltete Modell-API wie Flatkey routen.
Die kurze Antwort
Für die meisten textbasierten LLM-Workloads sollten Sie mit vLLM beginnen. Es bietet einen OpenAI-kompatiblen HTTP-Server, unterstützt gängige OpenAI-ähnliche Endpunkte wie Chat Completions, Completions, Embeddings und die Modellauflistung, abhängig vom geladenen Modelltyp, und liefert offizielle Docker-Images für die Bereitstellung.
Ein minimaler selbst gehosteter Stack sieht so aus:
| Ebene | Produktionswahl | Warum das wichtig ist |
|---|---|---|
| GPU-Host | H100, H200, B200, A100, L40S oder ein anderer unterstützter Beschleuniger | Bestimmt Modellgröße, Parallelität, Kontextlänge und die Latenzgrenze. |
| Container-Laufzeit | NVIDIA-Treiber plus NVIDIA Container Toolkit | Ermöglicht Docker-Containern den Zugriff auf GPUs über --gpus all. |
| Inference-Engine | vLLM für textbasiertes Serving mit hohem Durchsatz; LocalAI für breitere lokal gehostete OpenAI-kompatible Anwendungsfälle | vLLM ist der Standard-Startpunkt für das Serving von Transformer-LLMs auf GPUs. |
| API-Oberfläche | /v1/chat/completions, /v1/completions, /v1/models und nur die zusätzlichen Endpunkte, die Ihr Modell unterstützt |
Hält die Client-Migration klein und verhindert falsche Annahmen zur Kompatibilität. |
| Edge | Nginx, Envoy, Caddy oder ein Cloud-Load-Balancer | Übernimmt TLS, Authentifizierung, Anfragegrenzen und Routing. |
| Ops | Metriken, Logs, GPU-Telemetrie, Canaries und Fallback-Routing | Verhindert, dass der Server zu einer unsichtbaren Ausfallquelle wird. |
Verwenden Sie eine vllm inference server openai compatible api, wenn Sie direkte Hardwarekontrolle, Datenlokalität, benutzerdefinierte Modellgewichte oder vorhersehbare Serving-Ökonomie bei hohem Volumen benötigen. Verwenden Sie eine Gateway-/Modell-API-Basis, wenn Sie hauptsächlich zuverlässige Ausgaben benötigen und sich nicht um GPU-Auslastung, Treiber-Drift, Laden von Modellen und Failover kümmern möchten.
Bevor Sie bauen: Entscheiden Sie, ob Self-Hosting sich lohnt
Der Betrieb eines eigenen OpenAI-kompatiblen Inference-Servers ist nicht automatisch günstiger. Er kann hervorragend sein, wenn Ihre GPUs ausgelastet sind und Ihr Workload zum gehosteten Modell passt. Er kann teuer werden, wenn die Auslastung sprunghaft ist, Prompts stark variieren, sich die Modellqualität häufig ändert oder das Team mehr Zeit mit dem Debuggen der Infrastruktur als mit dem Ausliefern des Produkts verbringt.
Nutzen Sie diese Entscheidungstabelle, bevor Sie Hardware mieten oder kaufen:
| Frage | Self-Hosten, wenn die Antwort ja ist | Verwaltete API oder Gateway bevorzugen, wenn die Antwort ja ist |
|---|---|---|
| Haben Sie konstanten Traffic? | GPUs können warm bleiben und stark ausgelastet sein. | Der Traffic ist spiky, saisonal oder experimentell. |
| Benötigen Sie benutzerdefinierte Gewichte? | Sie stellen ein fein abgestimmtes, quantisiertes oder privates Modell bereit. | Öffentliche Frontier- oder Open-Weight-gehostete Modelle reichen aus. |
| Ist Datenlokalität erforderlich? | Anfragen müssen innerhalb Ihres VPC- oder On-Prem-Netzwerks bleiben. | Die üblichen Sicherheitskontrollen der API erfüllen die Anforderung. |
| Können Sie GPU-Infrastruktur betreiben? | Sie überwachen bereits Treiber, CUDA, Container, Speicher, Queues und Rollout-Risiken. | Sie möchten nicht, dass GPU-Betrieb zur Produkt-Roadmap wird. |
| Ist die Ausgabequalität stabil? | Eine Modellfamilie reicht für den Workflow aus. | Sie müssen zwischen vielen Modellen vergleichen, routen oder Failover betreiben. |
Flatkey passt als Basis in die letzte Spalte: ein OpenAI-kompatibler Endpunkt, ein Guthaben und Zugriff auf viele offizielle Modelle. Selbst wenn Sie eine vllm inference server openai compatible api aufbauen, sollten Sie in Ihrem Benchmark eine Modell-API-Basis beibehalten, damit Sie Latenz, Qualität und Kosten pro akzeptierter Ausgabe vergleichen können und nicht nur die Kosten pro GPU-Stunde.
Referenzarchitektur
Ein produktiver OpenAI-kompatibler Inference-Server sollte die Modell-Engine nicht direkt dem öffentlichen Internet aussetzen. Setzen Sie davor eine dünne Steuerungsschicht.
flowchart LR
  A[OpenAI SDK / app workers] --> B[API edge: TLS, auth, rate limits]
  B --> C[OpenAI-compatible /v1 route]
  C --> D[vLLM inference server]
  D --> E[GPU node or GPU pool]
  D --> F[Metrics and logs]
  B --> G[Fallback route: Flatkey or another model API]
Die wichtige Designentscheidung besteht darin, Kompatibilität von Betrieb zu trennen. vLLM kann die OpenAI-ähnliche API sprechen. Ihr Edge sollte Authentifizierung, Kontingente, Anfragegrößenlimits, TLS, Audit-Logs und Fallback-Verhalten übernehmen.
Schritt 1: Bereiten Sie den GPU-Host vor
Beginnen Sie mit einer sauberen Linux-GPU-Maschine. Stellen Sie sicher, dass der Host Folgendes hat:
- Einen kompatiblen NVIDIA-Treiber für die GPU und den CUDA-Stack, den Sie ausführen möchten.
- Docker oder eine andere unterstützte Container-Laufzeit.
- Das NVIDIA Container Toolkit so konfiguriert, dass Container auf GPUs zugreifen können.
- Ausreichend lokalen oder Netzwerk-Speicher für Modellgewichte.
- Einen Netzwerkpfad, der den Inference-Port nicht freigibt, bis Authentifizierung und TLS eingerichtet sind.
NVIDIAs Container-Toolkit-Installationsablauf konfiguriert Docker mit nvidia-ctk runtime configure --runtime=docker und startet dann Docker neu. Danach kann ein Container mit GPU-Zugriff mithilfe der GPU-Flags von Docker ausgeführt werden.
Führen Sie diese Prüfungen vor der Installation des Modellservers aus:
nvidia-smi
docker run --rm --gpus all nvidia/cuda:12.6.0-base-ubuntu22.04 nvidia-smi
Wenn einer der Befehle fehlschlägt, beheben Sie zuerst die Treiber-/Runtime-Schicht. Ein vllm inference server openai compatible api kann nicht stabil sein, wenn die grundlegende GPU-Runtime instabil ist.
Schritt 2: Starten Sie eine vLLM Inference Server OpenAI Compatible API
Die offiziellen Docker-Bereitstellungsdokumente von vLLM nennen vllm/vllm-openai als Image zum Ausführen eines OpenAI-kompatiblen Servers. Ein praktischer erster Start sieht so aus:
docker run --rm --gpus all \
  --ipc=host \
  -p 8000:8000 \
  -e HUGGING_FACE_HUB_TOKEN="$HUGGING_FACE_HUB_TOKEN" \
  vllm/vllm-openai:latest \
  --model meta-llama/Llama-3.1-8B-Instruct \
  --host 0.0.0.0 \
  --port 8000 \
  --served-model-name llama-3.1-8b-instruct
Für ein privates Modell ersetzen Sie die Modell-ID durch Ihr eigenes Repository oder Ihren lokalen Pfad. In der Produktion sollten Sie Image-Tags und Modellrevisionen fest angeben, anstatt latest bereitzustellen.
Testen Sie dann die Modellauflistung:
curl http://localhost:8000/v1/models
Und testen Sie Chat-Vervollständigungen:
curl http://localhost:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "llama-3.1-8b-instruct",
    "messages": [
      {"role": "system", "content": "You are a concise assistant."},
      {"role": "user", "content": "Reply with one sentence about self-hosted inference."}
    ],
    "temperature": 0.2
  }'
Das ist der erste funktionierende Meilenstein: eine lokale vllm inference server openai compatible api, die Ihre Anwendung mit derselben Anfrageform aufrufen kann, die sie bereits für OpenAI-ähnliche Chats verwendet.
Schritt 3: Richten Sie Ihr bestehendes SDK auf den lokalen Endpunkt aus
Der Großteil der OpenAI-kompatiblen Migration sollte in der Konfiguration erfolgen, nicht in der Anwendungslogik. Beim Python-SDK-Muster setzen Sie eine benutzerdefinierte base_url und einen API-Schlüssel:
from openai import OpenAI

client = OpenAI(
    base_url="http://localhost:8000/v1",
    api_key="local-dev-key",
)

response = client.chat.completions.create(
    model="llama-3.1-8b-instruct",
    messages=[
        {"role": "user", "content": "Give me a deployment checklist."}
    ],
)

print(response.choices[0].message.content)
In der Produktion sollten Sie Anwendungs-Worker nicht direkt auf einen rohen vLLM-Prozess zeigen lassen. Zeigen Sie sie stattdessen auf Ihr eigenes internes Gateway oder Ihren Load Balancer:
OPENAI_BASE_URL=https://inference.example.com/v1
OPENAI_API_KEY=<your-internal-service-token>
Dieses Gateway kann zu vLLM weiterleiten, nicht unterstützte Anfragefelder blockieren, Modell-Aliase normalisieren und bei Überlast des selbst gehosteten Pools auf Flatkey oder eine andere Modell-API ausweichen.
Schritt 4: Verstehen Sie, was "OpenAI-Compatible" nicht bedeutet
OpenAI-kompatibel bedeutet nicht, dass jeder Endpunkt, jedes Modellverhalten, jeder Tool-Call, jedes Streaming-Ereignis oder jede anbieterspezifische Option exakt wie bei OpenAI funktioniert. Es bedeutet, dass der Server für ausgewählte Endpunkte eine vertraute Struktur akzeptiert.
Bevor Sie die Migration als abgeschlossen betrachten, testen Sie:
| Kompatibilitätsbereich | Was zu überprüfen ist |
|---|---|
| Chat-Nachrichten | Rollenverarbeitung, Systemnachrichten, langer Kontext, Multimodal-Payloads, falls verwendet. |
| Streaming | Ereignisformat, Verhalten bei Verbindungsabbruch, Client-Timeouts, Umgang mit unvollständiger Ausgabe. |
| Tools/Funktionsaufrufe | Ob das geladene Modell und der Server Ihr Tool-Call-Muster unterstützen. |
| Embeddings | Ob das geladene Modell tatsächlich ein Embedding-Modell ist. |
| Fehlercodes | Verhalten von 400, 401, 404, 408, 429, 500, 503 an Edge und Engine. |
| Anfrageparameter | Temperature, max tokens, top-p, Stop-Sequenzen, zusätzliche Anbieterparameter. |
| Token-Berechnung | Prompt-/Ausgabe-Tokenanzahlen und Kostenzuordnung. |
Das sicherste Muster ist, eine Kompatibilitätstest-Suite zu pflegen. Senden Sie eine feste Menge realer Anwendungs-Prompts an OpenAI, Flatkey und Ihre vllm inference server openai compatible api. Vergleichen Sie Latenz, Schema-Gültigkeit, Ablehnungsverhalten, Ausgabequalität und die Rate akzeptierter Ausgaben.
Schritt 5: Dimensionieren Sie den GPU-Speicher für das Modell und den Traffic
Der hauptsächliche Ausfallmodus im Serving ist nicht „der Server startet langsam“. Es ist „der Server startet und stürzt dann unter realer Kontextlänge und gleichzeitigen Anfragen ab“.
Planen Sie den Speicher um:
- Modellgewichte.
- KV-Cache für Kontext und parallele Sequenzen.
- Runtime-Overhead.
- Fragmentierung und Reserve.
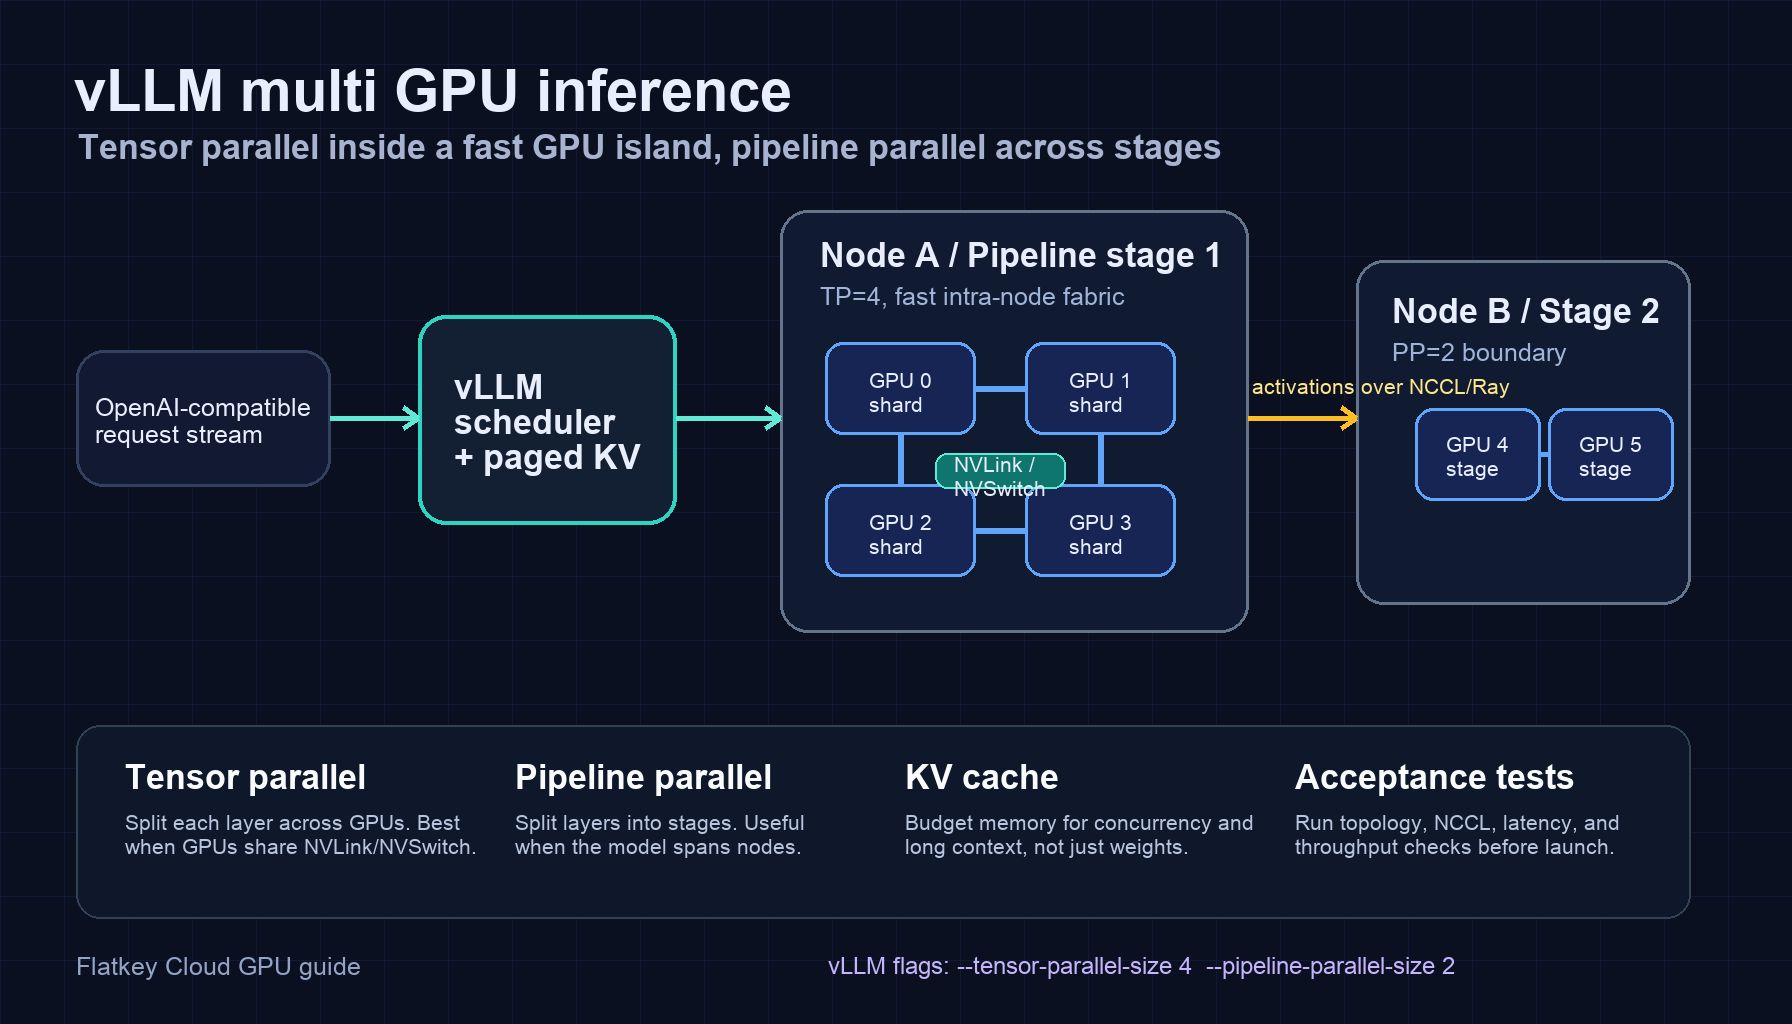
- Tensor Parallelism, wenn ein Modell nicht auf eine GPU passt.
- Quantisierungsabstriche, wenn Sie eine niedrigere Präzision verwenden.
Für ein tiefergehendes Arbeitsblatt verwenden Sie den Flatkey-Leitfaden zu LLM-GPU-Speicheranforderungen. Für die Planung auf Clusterebene kombinieren Sie dies mit einer Analyse im Stil von GPU-Cluster-Architektur und GPU-Cluster-TCO.
Eine grobe Akzeptanzregel:
usable_capacity = model_fit + target_context + target_concurrency + 20-30% headroom
Wenn Sie den Puffer nicht aufrechterhalten können, reduzieren Sie die Kontextlänge, verringern Sie die Parallelität, verwenden Sie ein kleineres Modell, verteilen Sie es auf mehrere GPUs oder leiten Sie überschüssigen Traffic vom selbst gehosteten Pool weg.
Schritt 6: Fügen Sie vor der Produktion eine API-Edge hinzu
Der rohe vLLM-Server ist nicht Ihre vollständige Produktions-Control-Plane. Setzen Sie eine Edge davor und machen Sie die Edge verantwortlich für:
- TLS-Beendigung.
- Authentifizierung zwischen Diensten.
- Grenzwerte für Request-Body-Größen.
- Rate Limits pro Team oder pro App.
- Mapping von Modell-Aliasen.
- Strukturierte Request-Logs.
- Timeout- und Retry-Budgets.
- Canary-Routing.
- Fallback-Routing.
Beispielhafte Nginx-Struktur:
server {
  listen 443 ssl;
  server_name inference.example.com;

  client_max_body_size 4m;

  location /v1/ {
    proxy_pass http://vllm_backend:8000/v1/;
    proxy_http_version 1.1;
    proxy_set_header Host $host;
    proxy_set_header X-Request-Id $request_id;
    proxy_read_timeout 120s;
  }
}
Das ist nur ein Ausgangspunkt. Produktionsteams sollten Authentifizierung, mTLS oder privates Networking, Richtlinien für Request-Logging sowie explizite Grenzen für Prompt-Größe und Ausgabelänge hinzufügen.
Schritt 7: Messen Sie akzeptierte Ausgaben, nicht nur Tokens pro Sekunde
Dashboards für GPU-Serving überbetonen oft den Durchsatz. Tokens pro Sekunde sind wichtig, aber Produktteams kümmern sich normalerweise um akzeptierte Ausgaben: Antworten, die schnell genug, gültig genug und gut genug sind, um an den Benutzer oder einen nachgelagerten Workflow ausgeliefert zu werden.
Verfolgen Sie:
| Metrik | Warum sie wichtig ist |
|---|---|
| Zeit bis zum ersten Token | Vom Benutzer wahrgenommene Latenz für Streaming-Apps. |
| End-to-End-Latenz | Wartezeit plus Generierungszeit. |
| Warteschlangentiefe | Frühwarnung, dass der GPU-Pool ausgelastet ist. |
| GPU-Speicherauslastung | Ob Annahmen zu Kontext/Parallelität realistisch sind. |
| Fehlerrate nach Modell-Alias | Erkennt modellspezifische Fehler. |
| Erfolgsrate des Ausgabeschemas | Kritisch für Agents, Extraktion und Tool-Workflows. |
| Akzeptierte-Ausgaben-Rate | Kombiniert Qualität, Latenz und Gültigkeit. |
| Fallback-Rate | Zeigt, wann der selbst gehostete Pool nicht ausreicht. |
Berechnen Sie dann die Kosten pro akzeptierter Ausgabe:
cost_per_accepted_output =
  (gpu_cost + storage + network + ops_time + fallback_api_cost)
  / accepted_outputs
Hier erhält ein vllm inference server openai compatible api den ehrlichen Vergleich mit verwalteten APIs. Wenn die lokale GPU pro rohem Token günstiger ist, aber bei Retries, Fehlern oder dem Zeitaufwand für den Betrieb schlechter abschneidet, können die Kosten pro akzeptierter Ausgabe höher sein als erwartet.
Schritt 8: Fügen Sie Fallback hinzu, statt die GPU-Box als Single Point of Failure zu behandeln
Ihre Anwendung sollte nicht wissen müssen, ob die Antwort von selbst gehostetem vLLM, Flatkey oder einem anderen Modellpfad kommt. Sie sollte einen Modell-Alias anfordern und eine Antwort oder einen kontrollierten Fehler erhalten.
Verwenden Sie Routing-Regeln wie:
| Bedingung | Route |
|---|---|
| Normaler Traffic, GPU gesund | Selbst gehostetes vLLM. |
| GPU-Warteschlange über Schwellenwert | Überschuss an Flatkey-Model-API weiterleiten. |
| Modell lädt oder startet neu | Allen Traffic an Flatkey leiten, bis es warm ist. |
| Anstieg von Schema-Fehlern | Per Canary zurück zur verwalteten API. |
| Experimenteller Prompt-Eval | Gegen lokales und verwaltetes Modell zur Vergleichbarkeit ausführen. |
Dieses Design ermöglicht es dem Team, die Wirtschaftlichkeit und Kontrolle des Self-Hostings zu behalten, ohne die Produktverfügbarkeit an einen einzelnen Inference-Server zu binden.
vLLM vs. LocalAI für lokal kompatible OpenAI-Inferenz
vLLM und LocalAI tauchen beide in Suchanfragen nach einem OpenAI-kompatiblen Inference-Server auf, aber sie eignen sich für unterschiedliche Aufgaben.
| Option | Beste Eignung | Worauf achten |
|---|---|---|
| vLLM | LLM-Serving mit hohem Durchsatz auf GPU, insbesondere Transformer-Textmodelle. | Die Kompatibilität hängt vom Modelltyp und Endpoint ab; die Produktionshärtung liegt weiterhin darum herum. |
| LocalAI | Lokale OpenAI-kompatible API über mehrere lokale Modell-Backends und Modalitäten hinweg. | Durchsatz und GPU-Verhalten hängen stark von Backend, Modell und Hardware ab. |
| Flatkey | Verwaltete OpenAI-kompatible Modell-API als Basis über viele offizielle Modelle hinweg. | Sie geben die direkte Kontrolle über die Serving-Engine auf, vermeiden aber den Betrieb eigener GPUs. |
Für den Ziel-Workload dieses Artikels beginnen Sie mit einer vllm inference server openai compatible api. Bewerten Sie LocalAI, wenn Ihr Ziel breitere lokale Experimente oder eine einzige lokale API über mehrere Backends hinweg ist, statt maximalen GPU-Serving-Durchsatz für eine LLM-Familie.
Produktions-Checkliste
Verwenden Sie dies, bevor Sie echte Benutzer routen:
- [ ] GPU-Treiber und Container-Runtime im Container mit
nvidia-smiverifiziert. - [ ] vLLM-Image-Tag und Modell-Revision fest gepinnt.
- [ ] Modell-Alias stabil und dokumentiert.
- [ ]
/v1/modelsund/v1/chat/completionsüber die finale Edge-URL getestet. - [ ] Streaming mit Client-Verbindungsabbrüchen getestet.
- [ ] Langkontext- und Parallelitätstests in erwarteter Produktionsgröße ausgeführt.
- [ ] Authentifizierung am Edge hinzugefügt; roher vLLM-Port nicht öffentlich.
- [ ] Größe des Request-Bodys, maximale Ausgabetokens und Timeouts erzwungen.
- [ ] Logs schließen sensible Prompt-Daten aus, sofern nicht ausdrücklich genehmigt.
- [ ] Metriken erfassen Latenz, Queueing, GPU-Speicher, Fehlerraten und die Rate akzeptierter Ausgaben.
- [ ] Fallback-Route für Auslastung und Vorfälle konfiguriert.
- [ ] Baseline der Managed API anhand derselben Prompts gemessen.
- [ ] Rollback-Plan getestet.
Häufige Fehler
Der größte Fehler besteht darin, den ersten erfolgreichen curl als Ende der Arbeit zu betrachten. Es ist nur der Anfang.
Weitere häufige Fehler:
latest-Images in Produktion ohne fest gepinnte Versionen auszuführen.- Den rohen Inference-Port dem Internet preiszugeben.
- Anzunehmen, dass jeder OpenAI-Request-Parameter unterstützt wird.
- Einen einzelnen kurzen Prompt zu benchmarken und das Ergebnis als „produktionsreif“ zu bezeichnen.
- Das Wachstum des KV-Caches durch echte Kontextlänge zu ignorieren.
- Zu vergessen, dass die Modell-Ladezeit Deployments und Wiederherstellung beeinflusst.
- GPU-Stundenkosten zu messen, ohne Operatorzeit, Retries und Qualitätsfehler einzubeziehen.
- Auf Fallback zu verzichten, weil der lokale Endpunkt „OpenAI-kompatibel“ ist.
Ein produktionsreifer vllm inference server openai compatible api ist nützliche Infrastruktur. Es ist keine magische Kompatibilität und kein Ersatz für operative Disziplin.
Wann Sie Flatkey zusätzlich zu Ihren eigenen GPUs verwenden sollten
Flatkey ist in dieser Architektur am nützlichsten als verwaltete Modell-/API-Baseline und als Fallback-Pfad. Halten Sie Ihre Anwendung in einer OpenAI-kompatiblen Client-Form und leiten Sie dann einen Teil des Traffics an Ihren lokalen GPU-Pool und einen Teil an Flatkey weiter.
Das gibt Ihnen:
- Eine Möglichkeit, die Ausgabequalität des Self-Hosting mit gehosteten Modellen zu vergleichen.
- Zusätzliche Kapazität, wenn lokale GPUs ausgelastet sind.
- Einen Fallback-Pfad bei Treiber-, Modell- oder Deployment-Vorfällen.
- Zugriff auf andere Modellfamilien, ohne weitere Provider-Keys hinzuzufügen.
- Einen saubereren Weg zurück zu verwalteten APIs, wenn ein selbst gehostetes Modell unterdurchschnittlich abschneidet.
Die Entscheidung lautet nicht „eigene GPUs oder APIs verwenden“. Für viele Teams ist das dauerhafte Setup beides: den GPU-Pfad dort selbst betreiben, wo er Kontrolle oder Kostenvorteile bietet, und einen verwalteten Pfad für Resilienz und Modellauswahl beibehalten.
FAQ
Was ist ein OpenAI-kompatibler Inference-Server?
Ein OpenAI-kompatibler Inference-Server stellt HTTP-Endpunkte mit OpenAI-ähnlichen Request- und Response-Formaten bereit, meist unter /v1. Dadurch können Anwendungen vertraute SDK-Konfigurationen wie eine benutzerdefinierte base_url verwenden und den Traffic dennoch an ein anderes Backend senden.
Ist vLLM ein OpenAI-kompatibler Inference-Server?
Ja. vLLM stellt einen OpenAI-kompatiblen Server bereit und dokumentiert Unterstützung für gängige OpenAI-ähnliche Endpunkte wie Chat Completions, Completions, Embeddings und Model-Listing, abhängig vom Modelltyp und der Funktion.
Kann ich einen vLLM-OpenAI-kompatiblen Server lokal ausführen?
Ja. Sie können vLLM lokal auf einer GPU-Workstation oder einem Server betreiben und dann den /v1-Endpunkt für Ihre Anwendung bereitstellen. Für die Produktion setzen Sie ein authentifiziertes Edge- oder internes Gateway davor.
Welche Hardware brauche ich?
Das hängt von Modellgröße, Präzision, Kontextlänge und Parallelitätsziel ab. Beginnen Sie mit der Dimensionierung für Modellgewichte plus KV-Cache und Reserven und testen Sie dann mit realen Prompts. Ein kleines Instruct-Modell passt möglicherweise auf eine GPU; ein 70B-Modell oder eine Arbeitslast mit hoher Parallelität kann GPUs mit größerem Speicher oder Tensor Parallelism erfordern.
Sollte ich vLLM oder LocalAI verwenden?
Verwenden Sie zuerst vLLM, wenn es um hochdurchsatzfähige LLM-Inferenz auf GPUs geht. Bewerten Sie LocalAI, wenn Sie einen breiteren lokalen OpenAI-kompatiblen Server über mehrere lokale Backends oder Modalitäten hinweg wünschen.
Bedeutet OpenAI-kompatibel identisch per Drop-in?
Nein. Das Endpunkt-Format mag übereinstimmen, aber Modellverhalten, unterstützte Parameter, Tools, Streaming, Embeddings, Fehler und Token-Abrechnung können sich unterscheiden. Führen Sie Kompatibilitätstests durch, bevor Sie Produktionsverkehr umstellen.
Fazit
Der Aufbau einer vllm inference server openai compatible api ist der schnellste praktische Weg, um Ihre eigenen GPUs in einen OpenAI-ähnlichen Endpunkt zu verwandeln. Der Kernaufbau ist einfach: Bereiten Sie die GPU-Runtime vor, starten Sie vLLM, verweisen Sie das SDK auf /v1 und fügen Sie dann Edge, Monitoring, Kompatibilitätstests und Fallback-Routen hinzu, die das Ganze produktionsreif machen.
Die besten Teams hören nicht bei „es läuft“ auf. Sie vergleichen Self-Hosted-Inferenz mit einer verwalteten Modell-API-Baseline, messen akzeptierte Ausgaben und halten eine Fallback-Route bereit. So erhalten Sie die Kontrolle über Ihre eigenen GPUs, ohne dass jede Produktanfrage von einem fragilen Inference-Server abhängt.
Offizielle Referenzen
- vLLM OpenAI-kompatible Server-Dokumentation: https://docs.vllm.ai/en/latest/serving/online_serving/
- vLLM Docker-Bereitstellungsdokumentation: https://docs.vllm.ai/en/latest/deployment/docker/
- NVIDIA Container Toolkit Installationsanleitung: https://docs.nvidia.com/datacenter/cloud-native/container-toolkit/latest/install-guide.html
- OpenAI Python SDK README: https://github.com/openai/openai-python
- Dokumentation des LocalAI-Projekts: https://localai.io/