
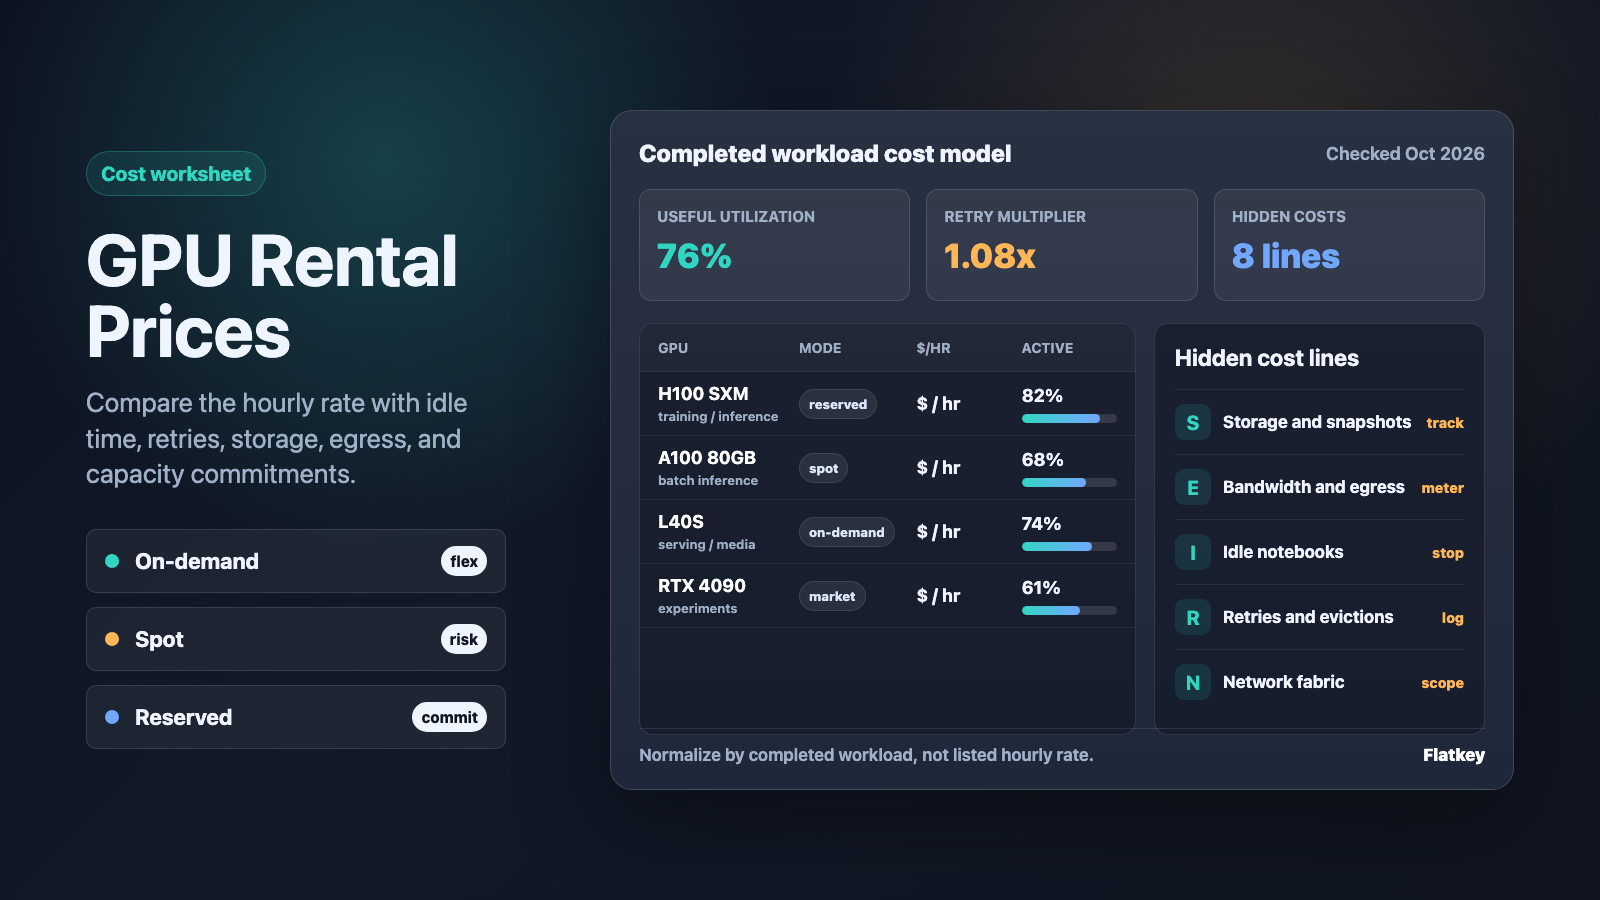
GPU-Mietpreise erklärt: On-Demand, Spot, Reserved und versteckte Kosten
GPU-Mietpreise wirken einfach, bis Sie versuchen, einen echten Trainingslauf, einen Inferenz-Launch oder einen Bildgenerierungs-Batch zu prognostizieren. Der ausgewiesene Stundenpreis ist nur eine Kostenposition. Ihre Endrechnung hängt außerdem davon ab, ob die GPU on-demand, spot oder unterbrechbar, reserved, serverless oder dediziert ist; wie lange die Maschine im Leerlauf steht; wo der Speicher liegt; wie viele Daten die Region verlassen; und wie viel Zuverlässigkeitsarbeit Ihr Team zusätzlich auffangen muss.
Dieser Leitfaden gibt Entwicklern, AI-Foundern, Plattform-Teams und Beschaffungsverantwortlichen eine praktische Möglichkeit, GPU-Mietpreise zu vergleichen, ohne in einer einzigen attraktiven Stundenrate stecken zu bleiben.
Die Kurzfassung: Vergleichen Sie Kosten pro abgeschlossener Workload-Stunde und nicht nur den GPU-Preis pro Stundenzeiteinheit.
Das schnelle Framework für GPU-Mietpreise
Beginnen Sie jeden Vergleich von GPU-Mietpreisen mit einer normalisierten Formel:
effektive GPU-Kosten pro abgeschlossenem Workload =
  (GPU-Compute + Speicher + Snapshots + Bandbreite + Leerlaufzeit + Wiederholungen + Support + Engineering-Overhead)
  / abgeschlossene Trainings-, Inferenz-, Batch- oder Medien-Job-Einheiten
Teilen Sie die Entscheidung dann in vier Fragen auf:
| Frage | Warum sie GPU-Mietpreise verändert |
|---|---|
| Welche GPU-Klasse benötigen Sie? | H100-, H200-, B200-, A100-, L40S-, RTX-4090- und RTX-6000-Klassen haben unterschiedliche Speicher-, Netzwerk-, Verfügbarkeits- und Preiskurven. |
| Wie vorhersehbar ist der Workload? | Stabile Produktions-Inferenz kann reservierte oder zugesicherte Kapazität rechtfertigen; Experimente und burstige Jobs passen oft besser zu on-demand oder spot. |
| Wie unterbrechbar ist der Job? | Spot- und Community-Marktplatz-Kapazität kann günstiger sein, aber Wiederholungen und Checkpointing entscheiden darüber, ob sie tatsächlich günstiger ist. |
| Was liegt außerhalb der GPU-Stunde? | Speicher, Snapshots, Egress, Leerlauf-Notebooks, Container-Pulls, Support-Pläne und Cluster-Netzwerk können die realen Kosten verändern. |
Für die meisten Teams ist die richtige Antwort nicht „die günstigste GPU finden“. Die richtige Antwort lautet: „die günstigste zuverlässige Kapazität mieten, die den Job mit akzeptabler Warteschlangenzeit, Restart-Risiko und Betriebsaufwand abschließt.“
Aktuelle Preisquellentabelle
GPU-Mietpreise ändern sich häufig, und Marketplace-Seiten können sich schneller bewegen als Beschaffungsprüfungen. Betrachten Sie die folgende Tabelle als Quellen-Checkliste, nicht als eingefrorene Preisliste. Erfassen Sie das Prüfdatum, das GPU-Modell, die Region, die Speichergröße, die Abrechnungseinheit und ob der Preis on-demand, spot, reserved, community, secure cloud, serverless oder dediziert ist.
| Anbieter oder Markt | Offizielle Preisquelle zum Prüfen | Was erfasst werden soll | Hinweise für den Vergleich |
|---|---|---|---|
| Vast.ai | Vast.ai pricing und Vast.ai FAQ | GPU-Modell, Host-Zuverlässigkeit, unterbrechbarer Status, Speicher, Bandbreite, Verifizierungsebene, Rechenzentrum oder Community-Host | Die GPU-Mietpreise von Vast.ai werden vom Marktplatz bestimmt, daher können sich zwei RTX-4090- oder H100-Angebote in Standort, Host, Zuverlässigkeit, Speicher und Netzwerk unterscheiden. |
| RunPod | RunPod pricing und RunPod storage and network volume docs | Secure Cloud vs. Community Cloud, GPU-Modell, Pod-Speicher, Netzwerk-Volume, Serverless-Worker-Preise, Leerlaufzeit | RunPod-GPU-Mietpreise variieren je nach Cloud-Typ und Produktmodus. Vergleichen Sie Pods, Serverless und Speicher getrennt. |
| Massed Compute | Massed Compute pricing | On-demand-Stundensatz für GPUs, langfristige Reservierung oder Cluster-Angebot, GPU-Speicher, Region, Support-Umfang | Die GPU-Mietpreise von Massed Compute sind nützlich, um dedizierte AI-Cloud-Kapazität zu benchmarken, aber private oder reservierte Cluster benötigen möglicherweise ein Angebot. |
| Lambda Cloud | Lambda Cloud pricing | On-demand-GPU-Instanz, Anzahl der GPUs, lokaler Speicher, regionale Verfügbarkeit, Konditionen für reservierte Cluster | Lambda veröffentlicht einfache stündliche GPU-Cloud-Raten für gängige NVIDIA-Instanzen; bestätigen Sie die aktuelle Verfügbarkeit, bevor Sie einen zeitkritischen Lauf planen. |
| AWS EC2 | Amazon EC2 pricing und EC2 Spot Instances | Instanzfamilie, Region, On-Demand, Spot, Savings Plans, Reserved Instances, EBS, Datenübertragung, Support | AWS ist oft das Referenzmodell für On-Demand-, Spot- und Commit-to-Use-Ökonomie, aber GPU-Instanzfamilien und regionale Verfügbarkeit sind wichtig. |
| Google Cloud | Compute Engine GPU pricing und Spot VMs | GPU-Typ, Maschinenfamilie, Region, Spot-VM-Status, Rabatt für zugesagte Nutzung, Persistent Disk, Netzwerk-Egress | Google Cloud trennt GPU-, Maschinen-, Disk-, Netzwerk- und Rabattmechaniken. Normalisieren Sie all das, bevor Sie es mit spezialisierten GPU-Clouds vergleichen. |
Fügen Sie jeder Quellenzeile eine Zeile hinzu: geprüft am 12. Oktober 2026. Wenn Sie das Arbeitsblatt später erneut verwenden, aktualisieren Sie das Prüfdatum, bevor Sie irgendeinen Wert wiederverwenden.
On-demand-GPU-Mietpreise
On-Demand-GPU-Mietpreise sind der sauberste Ausgangspunkt: Sie zahlen für die GPU-Kapazität, während die Instanz, der Pod oder der Server läuft, in der Regel ohne langfristige Bindung. Dies ist der Modus, den die meisten Teams für erste Benchmarks nutzen sollten, weil er technische Variablen einfach hält.
On-Demand ist normalerweise die richtige Standardwahl, wenn:
- Sie ein neues Modell, Framework, Dataset oder eine Prompt-Pipeline testen.
- Der Job dringend ist und nicht auf Spot-Kapazität warten kann.
- Sie einen stabilen Endpoint für Demos, QA oder ersten Kundenverkehr benötigen.
- Sie die Auslastung noch nicht gut genug kennen, um Kapazität zu reservieren.
- Sie Anbietersupport und vorhersehbares Networking wichtiger finden als den niedrigsten Stundensatz.
Das Risiko ist Leerlaufzeit. Ein GPU-Notebook, das pro Stunde weniger kostet, kann trotzdem teuer werden, wenn es das ganze Wochenende ohne Jobs läuft. Messen Sie bei On-Demand die abrechnungsfähige Laufzeit im Verhältnis zur nützlichen Rechenzeit.
on-demand waste rate =
  1 - useful GPU-active minutes / billable instance minutes
Wenn die Verschwendungsrate hoch ist, verhandeln Sie nicht zuerst den GPU-Preis. Beheben Sie die Automatisierung zum Herunterfahren, die Warteschlangenplanung, Autoscaling und das Job-Packing.
Spot-, unterbrechbare und Marketplace-GPU-Preise
Spot-GPU-Preise nutzen ungenutzte Kapazität und können im Vergleich zu On-Demand deutliche Rabatte bieten, aber die Kapazität kann verschwinden. AWS beschreibt EC2 Spot Instances als freie EC2-Kapazität, die mit Rabatten von bis zu 90 % im Vergleich zu On-Demand-Preisen verfügbar ist. Google Cloud Spot VMs sind ebenfalls rabattiert, können aber vorzeitig beendet werden. Community-Marktplätze wie Vast.ai bringen eine weitere Variante ins Spiel: Der Preis wird durch Angebot und Nachfrage der Hosts bestimmt, und das Zuverlässigkeitsprofil ist nicht dasselbe wie bei einer On-Demand-Instanz eines Hyperscalers.
Spot- oder unterbrechbare GPU-Mietpreise können sich lohnen, wenn:
- Trainingsjobs häufig Checkpoints schreiben.
- Batch-Inferenz ohne für Nutzer sichtbaren Fehler erneut versucht werden kann.
- Warteschlangen für Bild- oder Videoerzeugung Verzögerungen tolerieren.
- Sie Arbeit auf viele Worker aufteilen können.
- Sie Orchestrierung haben, die eine Eviction erkennt, Jobs neu startet und doppelte Abrechnung vermeidet.
Spot kann nachteilig sein, wenn:
- Ein einzelner mehrtägiger Trainingslauf von einem alten Checkpoint neu startet.
- Das Laden von Daten so lange dauert, dass jede Unterbrechung Stunden verschwendet.
- Das Modell Multi-Node-Networking benötigt und ein verlorener Worker den Job beendet.
- Ingenieure Tage damit verbringen, Retry- und Checkpoint-Logik zu pflegen.
- Sie kundennahe Latenz auf Kapazität versprechen, die Sie nicht kontrollieren.
Für Spot berechnen Sie die effektive Rate mit Neustart-Verschwendung:
spot effective hourly rate =
  spot hourly rate / (1 - interruption waste share)
Wenn ein Spot-H100 45 % günstiger ist, aber Unterbrechungen 35 % der verstrichenen Jobzeit verschwenden, ist der tatsächliche Vorteil viel kleiner als der beworbene Rabatt.
Reservierte, zugesagte und dedizierte GPU-Kapazität
Reservierte Kapazität tauscht Flexibilität gegen Planbarkeit. Sie verpflichten sich zu einer Laufzeit, einem Ausgabenniveau oder einem dedizierten Cluster, damit der Anbieter Hardware zuweisen kann und Sie den effektiven Stundensatz senken oder knappe GPUs sichern können.
Reservierte GPU-Mietpreise sind sinnvoll, wenn:
- Produktions-Inferenz eine stabile Grundauslastung hat.
- Trainingspläne über Monate hinweg vorhersehbar sind.
- Die Beschaffung ein bekanntes Monatsbudget benötigt.
- Sie für ein Launch-Fenster garantierte Kapazität brauchen.
- Multi-Node-Networking, Speicherortnähe und Support Teil der Anforderung sind.
Reservierte Kapazität kann nach hinten losgehen, wenn:
- Sich das Modell vor Ende der Laufzeit ändert.
- Die Nachfrage stark schwankt und die Grundauslastung niedrig bleibt.
- Eine neuere GPU-Klasse die Performance-pro-Dollar-Kurve verändert.
- Der Vertrag nicht die Speicher-, Support- oder Netzwerkstufe umfasst, die Sie tatsächlich benötigen.
Bevor Sie reservieren, berechnen Sie den Break-even bei der Auslastung:
reserved break-even utilization =
  reserved monthly cost / (on-demand hourly rate * hours in month)
Wenn der Break-even bei 58 % Auslastung liegt und Ihre reale Grundauslastung 30 % beträgt, reservieren Sie weniger Kapazität und skalieren den Rest On-Demand oder Spot.
Vast.ai GPU-Mietpreise
Menschen suchen nach Vast.ai GPU-Mietpreisen, weil Vast ein Marketplace und kein einzelner fester Cloud-Preiskatalog ist. Das ist der Reiz und das Risiko. Sie finden möglicherweise aggressive Angebote für RTX 4090, A100 oder H100, aber jeder Eintrag braucht eine Qualitätsprüfung.
Wenn Sie Vast.ai GPU-Mietpreise vergleichen, erfassen Sie:
- GPU-Modell und VRAM.
- Anzahl der GPUs im Rechner.
- Zuverlässigkeit des Hosts und Verifizierungsstatus.
- Kontext: Rechenzentrum vs. Community-Host.
- Unterbrechbar oder nicht unterbrechbar.
- Lokale Festplattengröße und Festplattenbandbreite.
- Upload-/Download-Bandbreite und Bedarf an öffentlicher IP.
- Startzeit des Container-Images.
- Ob Ihr Job Checkpoints schreiben und fortsetzen kann.
Bei vast.ai gpu rental prices rtx 4090 sollten Sie nicht nur den stündlichen RTX-4090-Preis vergleichen. Vergleichen Sie auch VRAM, Host-Historie, Festplattengröße, Speicherkosten und ob der Job Training, Inferenz, ComfyUI, Datenannotation oder einmaliges Experimentieren ist. Eine sehr günstige RTX 4090 kann die richtige Wahl für kurze Experimente und die falsche für Produktions-Inferenz sein.
RunPod GPU-Mietpreise
RunPod GPU-Mietpreise erfordern eine Aufteilung nach Produktmodi. Ein RunPod-Pod ist nicht dieselbe wirtschaftliche Einheit wie ein serverloser Endpoint, und Secure Cloud hat nicht dasselbe Risikoprofil wie Community Cloud.
Wenn Sie RunPod GPU-Mietpreise vergleichen, erfassen Sie:
- Secure Cloud oder Community Cloud.
- Stündlicher Pod-GPU-Tarif.
- Serverless-Worker-Preise, wenn Sie Endpoints statt Pods verwenden.
- Kosten für Persistent Volume und Network Volume.
- Verhalten bei Cold Starts und Mindestanzahl an Workern.
- Verhalten bei inaktiven Pods.
- Data Locality und ob der Workload große Modelle wiederholt lädt.
RunPod kann für Teams mit KI-Apps kosteneffektiv sein, die schnellen GPU-Zugriff ohne den Betrieb eines vollständigen Clusters wünschen. Der Blick auf die versteckten Kosten gilt Start und Speicher: Wenn jeder Worker wiederholt große Gewichte herunterlädt oder Volumes nach Experimenten angeschlossen lässt, unterschätzt die stündliche GPU-Position die Rechnung.
Massed Compute GPU-Mietpreise
Massed Compute GPU-Mietpreise sind ein nützlicher Referenzpunkt für Käufer, die spezialisierte GPU-Cloud-Anbieter vergleichen, insbesondere wenn es nicht mehr um einen einzelnen Dev-Pod geht, sondern um dedizierte KI-Kapazität. Vergleichen Sie für ein einfaches Experiment den veröffentlichten Stundensatz. Für Inferenz in der Produktion oder Multi-Node-Training fragen Sie nach, was im Clusterpreis enthalten ist.
Erfassen Sie:
- GPU-Modell und Speicher.
- Stündlicher On-Demand-Preis versus Reservierungsangebot.
- Mindestverpflichtung.
- Netzwerk-Fabric.
- Speicherstufe.
- Support- und SLA-Bedingungen.
- Region und Compliance-Anforderungen.
- Ob das Angebot Einrichtung, Migration oder Managed Services enthält.
Hier ist Beschaffungssprache wichtig. "Reserved GPU cluster" kann einen niedrigeren Tarif, garantierte Hardware, privates Networking, Support-Zugang oder alles zusammen bedeuten. Fragen Sie jede Position separat an.
GPU-Mietpreise im Zeitverlauf
GPU-Mietpreise im Zeitverlauf bewegen sich nicht geradlinig. Drei Kräfte ziehen typischerweise in unterschiedliche Richtungen:
| Kraft | Auswirkung auf den Preis |
|---|---|
| Neues Hardware-Angebot | Ältere GPUs können günstiger werden, wenn H200-, B200-, B300- oder neuere Klassen verfügbar werden. |
| Spitzen bei der KI-Nachfrage | Kapazitäten der H100/H200-Klasse können während Modellstarts, Training oder Inferenzspitzen teuer oder knapp bleiben. |
| Effizienzgewinne | Bessere Quantisierung, Batching, Serving-Engines und Modell-Routing können die Kosten pro Aufgabe senken, selbst wenn der stündliche GPU-Preis unverändert bleibt. |
Verlassen Sie sich nicht auf eine einzelne Geschichte à la "GPU-Preise fallen" oder "GPU-Preise steigen". Verfolgen Sie die genaue GPU-Familie, die Sie verwenden, die Region, die vereinbarten Konditionen und die Effizienz Ihres Workloads. Ihre Kosten pro Token, Bild, Fine-Tune oder Trainingsbeispiel können sinken, selbst wenn die stündlichen GPU-Mietpreise gleich bleiben.
Versteckte Kosten bei Cloud-GPU-Mieten
Die versteckten Kosten sind nicht immer böswillig. Oft handelt es sich um normale Cloud-Primitives, die groß werden, weil GPU-Workloads große Dateien bewegen und während des Debuggings Leerlauf haben.
| Versteckte Kosten | Wie sie auftreten | Wie man sie kontrolliert |
|---|---|---|
| Leerlaufzeit | Laufende Pods, Notebooks oder Instanzen ohne aktiven Job | Leerlaufende Ressourcen automatisch stoppen; Experimente taggen; Warnungen für langfristig laufende GPUs einrichten. |
| Persistenter Speicher | Volumes, Disks, Snapshots, Modell-Caches, Datensätze | Wiederverwendbare Modellgewichte von temporären Ausgaben trennen; verwaiste Volumes bereinigen. |
| Netzwerk-Egress | Verschieben von Datensätzen, Checkpoints, Ausgaben oder Modellartefakten über Regionen hinweg oder ins Internet | Daten, GPU und Object Storage möglichst in derselben Region halten. |
| Cold Starts | Container und Modellgewichte laden, bevor die eigentliche Arbeit beginnt | Images vorbauen; lokale Caches verwenden; Startzeit als abrechenbare Zeit messen. |
| Wiederholungen und fehlgeschlagene Jobs | Out-of-Memory-Fehler, Evictions, fehlerhafte Treiber, instabile Hosts | Kleine Canaries ausführen; Checkpointing nutzen; bekannte gute Images pinnen; Fehlerkosten protokollieren. |
| Multi-Node-Networking | InfiniBand-, RoCE-, Placement- oder Cluster-Fabric-Aufschläge | Nur reservieren, wenn der Workload wirklich verteiltes Training benötigt. |
| Support und Compliance | Kostenpflichtige Support-Pläne, private Cluster, Audit-Anforderungen, Managed Services | Entscheiden, welche Workloads Enterprise-Bedingungen brauchen und welche experimentell bleiben können. |
| Engineering-Overhead | Zeitaufwand für die Pflege von Skripten, Schedulern und cloud-spezifischem Setup | Einrichtungs- und Incident-Stunden in das TCO-Worksheet aufnehmen. |
Bei GPU-Mietpreisen sind Speicher und Leerlaufzeit die beiden versteckten Kosten, die kleine Teams am ehesten überraschen. Bei größeren Teams werden Support, Networking und ungenutzte reservierte Kapazitäten meist zu den größeren Budgetrisiken.
GPU-Mietpreis-Arbeitsblatt
Verwenden Sie dieses Arbeitsblatt, bevor Sie einen Anbieter freigeben, einen Cluster reservieren oder einen Workload migrieren.
| Feld | Beispiel | Warum es wichtig ist |
|---|---|---|
| Anbieter | RunPod, Vast.ai, Massed Compute, AWS, Google Cloud, Lambda | Hält Marktplatz-, Spezial-Cloud- und Hyperscaler-Ökonomie getrennt. |
| Produktmodus | On-Demand-Pod, Spot-Instance, reservierter Cluster, serverloser Endpunkt | Die Abrechnungseinheit und das Zuverlässigkeitsprofil ändern sich je nach Modus. |
| GPU-Modell | H100 SXM, H100 PCIe, A100 80GB, L40S, RTX 4090 | Speicher und Interconnect sind oft wichtiger als der Markenname. |
| Region oder Host | US-East, EU, Community-Host, Rechenzentrums-Host | Verfügbarkeit, Datenregeln, Latenz und Bandbreite unterscheiden sich je nach Standort. |
| Stündlicher GPU-Preis | $x.xx/hour |
Nur Ausgangspunkt. |
| Minimale Abrechnungseinheit | Sekunde, Minute, Stunde, Monat | Kurze Jobs reagieren empfindlich auf Rundung und Cold Starts. |
| Speicherkosten | Volume, Disk, Snapshot, Objektspeicher | Modellgewichte und Checkpoints können zu dauerhaften monatlichen Kosten werden. |
| Bandbreite oder Egress | Eingehend, ausgehend, öffentliche IP, regionsübergreifend | Große Datensätze und erzeugte Medien verändern die Gesamtkosten. |
| Leerlaufanteil | 22% |
Direktes Maß für verschwendete Mietzeit. |
| Fehler-/Retry-Rate | 1.08x |
Erfasst Evictions, OOMs, fehlerhafte Images und Neustarts. |
| Nützliche Ausgabeeinheit | trainierte Epoche, akzeptiertes Bild, 1 Mio. Tokens, abgeschlossener Job | Verwandelt den Stundenpreis in geschäftlichen Wert. |
| Support und Betrieb | selbst verwaltet, verwaltet, SLA, privater Cluster | Beschaffungs- und Zuverlässigkeitskosten gehören in dasselbe Modell. |
Für ein tiefergehendes Kosten-Arbeitsblatt auf Modellebene, nachdem die Workload über APIs bereitgestellt wird, vergleichen Sie dies mit AI model pricing comparison und how to compare AI model prices.
Wann eine Modell-API günstiger ist als das Mieten von GPUs
Das Mieten von GPUs ist nicht automatisch günstiger als die Nutzung einer Modell-API. GPU-Miete zahlt sich aus, wenn Sie eine hohe Auslastung, klare Anforderungen an Modelleigentum, benutzerdefinierte Inference-Stacks, Datenschutzanforderungen oder Trainings-Workloads haben, die nicht an eine API ausgelagert werden können.
Eine Modell-API kann günstiger sein, wenn:
- Die Auslastung niedrig oder sprunghaft ist.
- Das Team häufig die Modelle wechselt.
- Zuverlässigkeit, Skalierung und Upgrades vom Produktgeschäft ablenken würden.
- Die Workload viele Modellfamilien statt nur eines selbst gehosteten Modells benötigt.
- Die Finanzabteilung eher ein Nutzungsprotokoll als ein Cluster-Betriebsprojekt braucht.
Flatkey sitzt auf der API-Seite dieser Entscheidung. Es gibt Teams einen API-Schlüssel, ein Guthaben, eine Rechnung und ein Nutzungsprotokoll über viele offizielle Modelle und Tools hinweg. Wenn Ihr Arbeitsblatt zeigt, dass selbst gehostete GPUs noch nicht der eigentliche Engpass sind, starten Sie mit einer Multi-Provider-API und vergleichen Sie die Kosten pro akzeptiertem Ergebnis, bevor Sie sich auf Clusterbetrieb festlegen. Für die Governance-Schicht der API sehen Sie AI gateway pricing, AI API spend management und AI API quota controls.
Entscheidungsleitfaden: On-Demand, Spot, Reserved oder API
| Workload | Besserer Ausgangspunkt | Warum |
|---|---|---|
| Erster Modell-Benchmark | On-Demand-GPU | Sauberste Messung, weniger Variablen durch Unterbrechungen. |
| Einmaliger ComfyUI- oder Bild-Workflow | On-Demand- oder Marketplace-GPU | Schnelle Einrichtung; Kapazität der RTX-4090-Klasse kann ausreichen. |
| Batch-Inferenz mit Retries | Spot- oder unterbrechbare GPU | Rabatte können gewinnen, wenn die Retry-Logik stark ist. |
| Produktions-Inferenz-Baseline | Reservierte oder zugesagte GPU | Stabile Auslastung kann eine Verpflichtung rechtfertigen. |
| Multi-Node-Training | Dedizierter Cluster oder reservierte Kapazität | Netzwerk und Platzierung sind ebenso wichtig wie der Stundensatz. |
| KI-Feature mit geringem Volumen | Modell-API über ein Gateway | Vermeidet ungenutzte GPU-Kapazität und Betriebsaufwand. |
| Multi-Modell-Agent-Workflow | Modell-API über Flatkey | Ein Schlüssel und ein Protokoll können den Betrieb vieler GPU-Endpunkte übertreffen. |
Häufige Fehler bei der Preisgestaltung von GPU-Mieten
| Fehler | Was stattdessen zu tun ist |
|---|---|
| Nur den angegebenen stündlichen GPU-Preis vergleichen | Die Kosten für die abgeschlossene Workload nach Speicher, Bandbreite, Leerlaufzeit und Retries vergleichen. |
| Spot-Rabatte als garantierte Einsparungen behandeln | Unterbrechungsverluste und Checkpoint-Overhead hinzurechnen. |
| Kapazität reservieren, bevor die Auslastung gemessen wurde | On-Demand lange genug laufen lassen, um die Basisnachfrage zu kennen. |
| Speicherbereinigung ignorieren | Warnungen für nicht zugeordnete Volumes, Snapshots und alte Checkpoints einrichten. |
| RTX 4090, L40S, A100, H100 und H200 so mischen, als wären sie austauschbar | VRAM, Tensor-Leistung, Interconnect und Software-Stack an die Workload anpassen. |
| Daten-Gravitation vergessen | Datensätze, Objektspeicher und GPUs nahe beieinander platzieren. |
| GPU-Miete für jede KI-Workload verwenden | Bei dominierendem Betriebsaufwand mit Modell-APIs vergleichen. |
FAQ
Was ist der beste Weg, GPU-Mietpreise zu vergleichen?
Der beste Weg, GPU-Mietpreise zu vergleichen, besteht darin, die Kosten pro abgeschlossener Workload zu berechnen. Beziehen Sie den stündlichen GPU-Preis, Speicher, Egress, Leerlaufzeit, Wiederholungen, fehlgeschlagene Jobs, Support und technischen Overhead ein. Ein niedrigerer Stundenpreis kann sich als schlechter erweisen, wenn er zu mehr Neustarts oder Leerlaufzeit führt.
Sind die GPU-Mietpreise von Vast.ai günstiger als die von Cloud-Anbietern?
Die GPU-Mietpreise von Vast.ai können für einige GPUs niedriger sein, weil es sich um einen Marktplatz handelt, aber der Vergleich hängt von der Zuverlässigkeit des Hosts, Unterbrechbarkeit, Datenträger, Bandbreite, Verifizierungsstufe und Workload-Toleranz ab. Betrachten Sie jedes Angebot als ein spezifisches Angebot, nicht als einen universellen Preis.
Sind die GPU-Mietpreise von RunPod On-Demand oder Spot?
Die GPU-Mietpreise von RunPod hängen vom gewählten Produkt und Cloud-Typ ab. Vergleichen Sie Secure Cloud, Community Cloud, Pods, serverlose Endpunkte, Speicher, Netzwerkvolumes und Leerlaufverhalten separat.
Wann sollte ich reservierte GPU-Kapazität verwenden?
Verwenden Sie reservierte GPU-Kapazität, wenn die Auslastung vorhersehbar ist, der GPU-Typ für den Verpflichtungszeitraum weiterhin nützlich sein wird und garantierte Kapazität wichtig ist. Wenn Ihre Basisauslastung niedrig ist, reservieren Sie nur die Basis und skalieren Sie den Rest über On-Demand oder Spot.
Warum ändern sich GPU-Mietpreise im Laufe der Zeit so stark?
GPU-Mietpreise ändern sich im Laufe der Zeit, weil Hardwareangebot, KI-Nachfrage, regionale Kapazitäten, Wettbewerb zwischen Anbietern und Bereitstellungseffizienz sich alle gleichzeitig verändern. Verfolgen Sie die genaue GPU-Familie und die Effizienz Ihrer Workload, nicht nur Markt-Durchschnittswerte.
Welche versteckten Kosten sind bei GPU-Cloud-Services am wichtigsten?
Die wichtigsten versteckten Kosten sind Leerlaufzeit, persistenter Speicher, Snapshots, Egress, Kaltstarts, Wiederholungen, fehlgeschlagene Jobs, Netzwerk-Fabric, Support und technischer Overhead. Kleine Teams spüren meist zuerst Leerlauf und Speicher; größere Teams spüren meist Netzwerke, Support und ungenutzte reservierte Kapazität.
Abschließende Checkliste
Bevor Sie sich für einen GPU-Mietanbieter entscheiden, bestätigen Sie:
- Das GPU-Modell, die Speicherkapazität, die Region und die Abrechnungseinheit sind dokumentiert.
- Das Preismodell ist On-Demand, Spot, Reserved, serverless, Marketplace oder Dedicated.
- Speicher, Bandbreite, Snapshots und Leerlaufzeit sind enthalten.
- Spot-Unterbrechungen und Wiederholungsverluste sind modelliert.
- Reservierte Kapazität hat einen Break-even bei der Auslastung.
- Die Quell-URL und das Prüfdatum sind an jedem Preis angegeben.
- Die endgültige Entscheidung basiert auf den Kosten der abgeschlossenen Workload, nicht nur auf den stündlichen GPU-Mietpreisen.
Das ist der praktische Weg, GPU-Mietpreise zu bewerten: aktuelle Quellseiten, ein an die Workload angepasstes Arbeitsblatt und eine klare Entscheidung darüber, wann das Mieten von Hardware die betriebliche Komplexität wert ist.


