Preços da API DeepSeek (outubro de 2026): Flash vs V4 Pro, horário de pico e cache
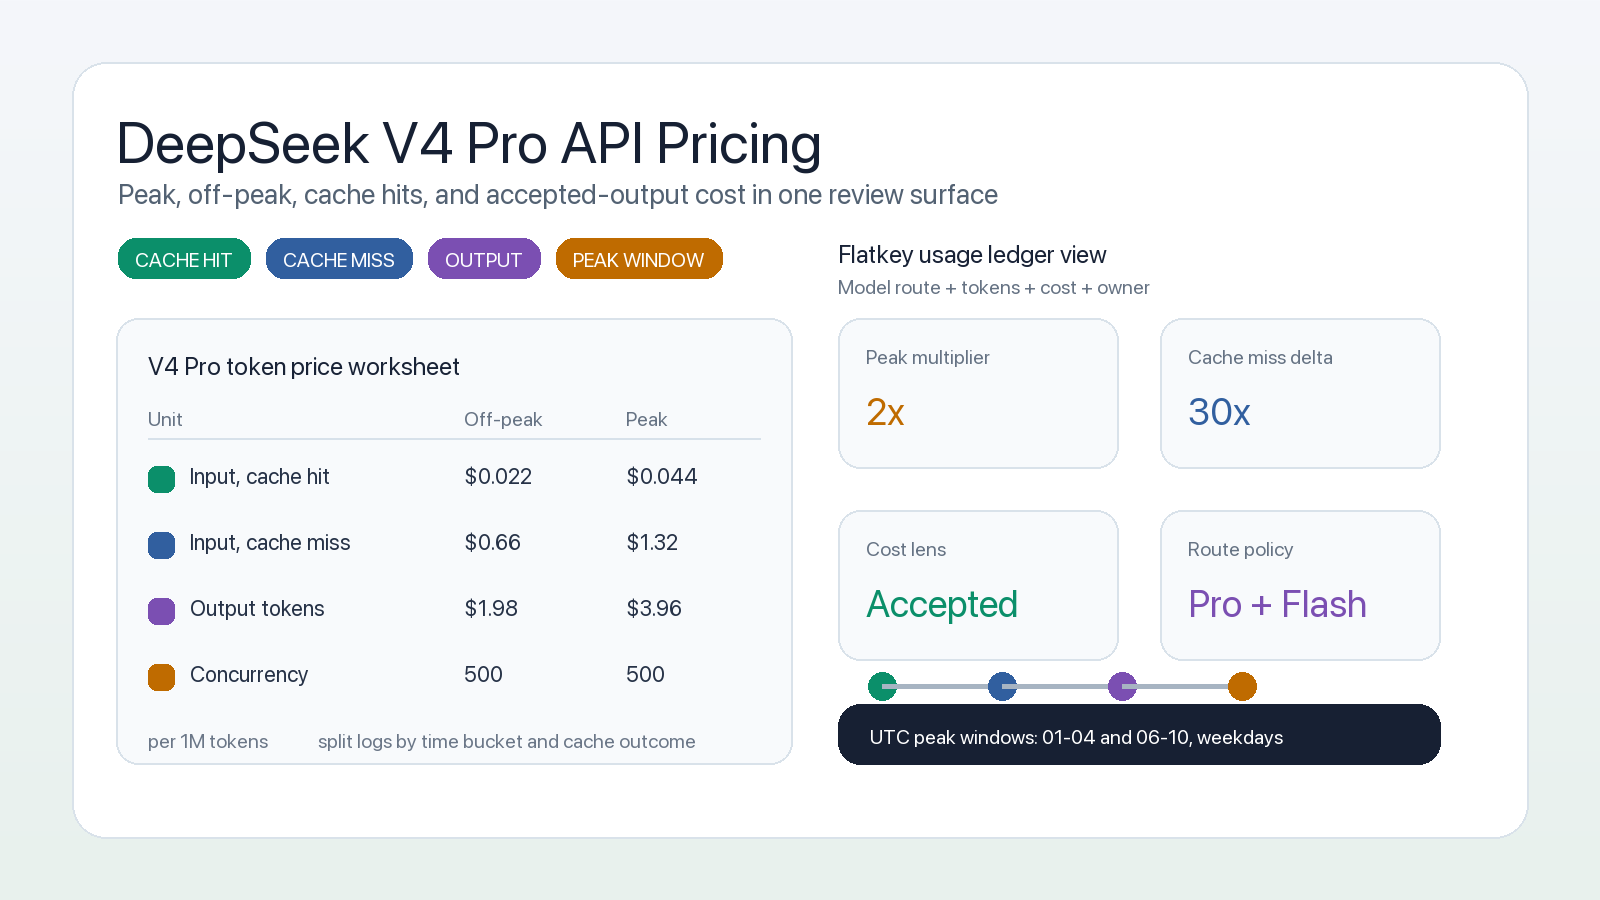
Em outubro de 2026, a API DeepSeek custa US$ 0,15 por 1M de tokens de entrada e US$ 0,60 por 1M de tokens de saída no deepseek-flash fora do pico, e US$ 0,66 de entrada / US$ 1,98 de saída no deepseek-v4-pro; no horário de pico as tarifas dobram exatamente. Acertos de cache reduzem a entrada para US$ 0,003 (Flash) ou US$ 0,022 (V4 Pro) por 1M de tokens fora do pico. O pico vai das 01:00 às 04:00 e das 06:00 às 10:00 UTC em dias úteis, o que significa que o horário comercial dos EUA é inteiramente fora de pico. Todos os números vêm da página oficial de modelos e preços da DeepSeek, verificada em 21 de outubro de 2026.
Este guia é para desenvolvedores independentes e pequenas equipes que escolhem a DeepSeek para manter a inferência barata. Ele cobre a tabela completa de preços por milhão de tokens, como funciona a cobrança de pico e fora de pico nos fusos dos EUA, o desconto de cache, as novas tarifas de Search e Fetch, os nomes de modelos legados, exemplos de custo, uma calculadora que considera o horário e a comparação da DeepSeek com OpenAI, Claude e Gemini.
Preços da API DeepSeek em resumo
| Pergunta | Resposta (em 21 out 2026) |
|---|---|
| Modelos | deepseek-flash (DeepSeek-V4.1-Flash-1017) e deepseek-v4-pro (DeepSeek-V4-Pro-0813) |
| Entrada mais barata | deepseek-flash, acerto de cache, fora de pico: US$ 0,003 por 1M tokens |
| Flash, fora de pico | US$ 0,15 entrada (falha de cache) / US$ 0,60 saída por 1M tokens |
| V4 Pro, fora de pico | US$ 0,66 entrada (falha de cache) / US$ 1,98 saída por 1M tokens |
| Multiplicador de pico | 2x (fora de pico é metade do pico) |
| Horário de pico | 01:00–04:00 e 06:00–10:00 UTC, segunda a sexta, exceto feriados chineses |
| Contexto / saída máx. | 1M tokens / 384K tokens |
| APIs Search e Fetch | US$ 0,75 por 1.000 requisições bem-sucedidas, cada |
| Nível gratuito | Nenhum listado; saldo concedido (se houver) é gasto antes do saldo recarregado |
Fonte: DeepSeek Modelos e preços, 21 de outubro de 2026.
Preço da API DeepSeek por milhão de tokens
| Preço por 1M tokens | deepseek-flash fora de pico |
deepseek-flash pico |
deepseek-v4-pro fora de pico |
deepseek-v4-pro pico |
|---|---|---|---|---|
| Entrada, acerto de cache | US$ 0,003 | US$ 0,006 | US$ 0,022 | US$ 0,044 |
| Entrada, falha de cache | US$ 0,15 | US$ 0,30 | US$ 0,66 | US$ 1,32 |
| Saída | US$ 0,60 | US$ 1,20 | US$ 1,98 | US$ 3,96 |
| Limite de concorrência | 2.500 | 2.500 | 500 | 500 |
Fonte: DeepSeek Modelos e preços, 21 de outubro de 2026.
Na página de preços, os dois modelos têm os mesmos recursos: saída JSON, chamadas de ferramentas, a Responses API, um endpoint no formato Anthropic, conclusão por prefixo de chat (beta) e conclusão FIM apenas no modo sem raciocínio. A única diferença que importa para quem desenvolve: visão é suportada no deepseek-flash, mas não no deepseek-v4-pro. Ambos usam o modo de raciocínio por padrão e podem ser trocados para o modo sem raciocínio; veja o guia do modo thinking. Como tokens de raciocínio são cobrados como saída, o modo sem raciocínio é a economia mais fácil em rotas simples.
Nomes de modelos legados ainda funcionam, pelo preço do Flash
A nota de rodapé da DeepSeek orienta usar deepseek-flash como nome do modelo. Os nomes antigos deepseek-v4-flash e deepseek-v4-flash-vision-exp ainda são aceitos, mas esses modelos foram aposentados: as requisições são atendidas pelo DeepSeek-V4.1-Flash-1017 e cobradas pelo preço do Flash. Se você fixou um nome legado para congelar o comportamento, já está no modelo novo; execute suas avaliações novamente. Nosso checklist de migração para DeepSeek V4 lista o que testar.
Pico vs fora de pico: o que significa no horário dos EUA
A DeepSeek define o pico em UTC. Convertido para equipes nos EUA (o horário de verão do Leste vai até 1º de novembro de 2026):
| Janela de pico (UTC, seg–sex) | Leste dos EUA (EDT, até 1º nov) | Leste dos EUA (EST, a partir de 1º nov) | Pacífico (PDT, até 1º nov) |
|---|---|---|---|
| 01:00–04:00 | 21h–0h (noites de dom a qui) | 20h–23h | 18h–21h |
| 06:00–10:00 | 2h–6h | 1h–5h | 23h–3h |
Convertido a partir do horário de pico na página de preços da DeepSeek. Fins de semana e feriados chineses são totalmente fora de pico.
Conclusão prática: um produto americano cujo tráfego acompanha o dia útil dos EUA paga tarifa fora de pico em quase tudo. As janelas caras caem à noite e de madrugada nos EUA, justamente quando muitas equipes agendam jobs em lote. Mova crons noturnos, avaliações e backfills para o dia ou para o fim de semana e eles custarão metade. Se seus usuários estão na Ásia, é o contrário: 06:00–10:00 UTC é meio da tarde em Pequim, e boa parte do seu tráfego diurno é pico.
Como funciona o desconto de cache
A DeepSeek armazena prefixos de prompt em cache automaticamente; você não precisa marcar nada. O objeto usage da resposta informa prompt_cache_hit_tokens e prompt_cache_miss_tokens, conforme o guia de cache de contexto. O guia também diz que o cache é de melhor esforço, sem taxa de acerto garantida, que a construção leva segundos e que caches sem uso são apagados em algumas horas ou alguns dias.
No Flash, um acerto custa US$ 0,003 contra US$ 0,15 de uma falha fora do pico, um desconto de 98%. Isso torna a estrutura do prompt a maior alavanca depois da escolha do modelo:
- Mantenha o prompt de sistema, os schemas de ferramentas e os documentos de referência idênticos e no início de cada requisição.
- Acrescente a parte específica do usuário no final.
- Em conversas com vários turnos, reenvie o histórico completo na mesma ordem para que os turnos anteriores acertem o cache.
Para um método geral de medir se o cache compensa, veja nosso guia de custo e ROI do prompt caching.
Tarifas de Search e Fetch
A DeepSeek agora vende APIs independentes de Search e Fetch a US$ 0,75 por 1.000 requisições bem-sucedidas cada. A página de preços acrescenta que chamadas de ferramentas do lado do servidor feitas via DeepSeek Harness, Claude Code ou Codex já usam essas APIs e são gratuitas por enquanto, com cobrança por requisição a partir de 00:00 no horário de Pequim em 1º de novembro de 2026 (16:00 UTC de 31 de outubro). Se você usa a DeepSeek dentro de um agente de programação, inclua uma linha de orçamento para buscas antes dessa data.
Exemplo: custo mensal da API DeepSeek
Suponha 100.000 requisições por mês, cada uma com 2.000 tokens de entrada e 500 de saída: 200M de entrada e 50M de saída.
| Cenário | Custo de entrada | Custo de saída | Total mensal |
|---|---|---|---|
| Flash, fora de pico, sem acertos de cache | 200 x US$ 0,15 = US$ 30,00 | 50 x US$ 0,60 = US$ 30,00 | US$ 60,00 |
| Flash, pico, sem acertos de cache | 200 x US$ 0,30 = US$ 60,00 | 50 x US$ 1,20 = US$ 60,00 | US$ 120,00 |
| Flash, fora de pico, 70% de acertos | 60 x US$ 0,15 + 140 x US$ 0,003 = US$ 9,42 | US$ 30,00 | US$ 39,42 |
| V4 Pro, fora de pico, sem acertos de cache | 200 x US$ 0,66 = US$ 132,00 | 50 x US$ 1,98 = US$ 99,00 | US$ 231,00 |
| V4 Pro, pico, sem acertos de cache | 200 x US$ 1,32 = US$ 264,00 | 50 x US$ 3,96 = US$ 198,00 | US$ 462,00 |
Calculado com as tarifas publicadas pela DeepSeek, 21 de outubro de 2026.
Dois padrões se destacam. Primeiro, o cache reduz a conta do Flash em cerca de um terço mesmo com a saída inalterada, porque o lado da entrada quase desaparece. Segundo, o V4 Pro custa cerca de 4x o Flash no mesmo horário, então encaminhe ao Pro apenas as requisições que falham no Flash (raciocínio complexo, loops longos de agentes). Nossa comparação DeepSeek V4 Pro vs Flash explica quando essa troca vale a pena.
Calculadora de custos da DeepSeek para copiar (considera o horário)
A calculadora abaixo lê os campos de cache de uma resposta real e aplica a tarifa de pico ou fora de pico conforme o horário UTC da requisição. Ela não conhece os feriados chineses, então superestima nesses dias.
# pip install openai
import os
from datetime import datetime, timezone
from openai import OpenAI

# DeepSeek rates per 1M tokens, Models & Pricing page, Oct 21, 2026 (off-peak; peak = 2x)
OFF_PEAK = {
    "deepseek-flash":  {"hit": 0.003, "miss": 0.15, "out": 0.60},
    "deepseek-v4-pro": {"hit": 0.022, "miss": 0.66, "out": 1.98},
}

def is_peak(ts: datetime) -> bool:
    ts = ts.astimezone(timezone.utc)
    if ts.weekday() >= 5:  # Saturday, Sunday
        return False
    return 1 <= ts.hour < 4 or 6 <= ts.hour < 10

def cost(model: str, usage, ts: datetime) -> float:
    r = OFF_PEAK[model]
    k = 2 if is_peak(ts) else 1
    return k * (usage.prompt_cache_hit_tokens * r["hit"]
                + usage.prompt_cache_miss_tokens * r["miss"]
                + usage.completion_tokens * r["out"]) / 1_000_000

client = OpenAI(api_key=os.environ["DEEPSEEK_API_KEY"], base_url="https://api.deepseek.com")
now = datetime.now(timezone.utc)
resp = client.chat.completions.create(
    model="deepseek-flash",
    messages=[{"role": "system", "content": "You are a concise SQL assistant."},
              {"role": "user", "content": "Count orders per day for the last 7 days."}],
)
print(resp.choices[0].message.content)
print(f"peak={is_peak(now)} cost=${cost('deepseek-flash', resp.usage, now):.6f}")
A mesma requisição com curl:
curl https://api.deepseek.com/chat/completions \
  -H "Authorization: Bearer $DEEPSEEK_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model":"deepseek-flash","messages":[{"role":"user","content":"Explain idempotency keys in one paragraph."}]}'
E em Node.js:
import OpenAI from "openai";

const client = new OpenAI({ apiKey: process.env.DEEPSEEK_API_KEY, baseURL: "https://api.deepseek.com" });
const r = await client.chat.completions.create({
  model: "deepseek-v4-pro",
  messages: [{ role: "user", content: "Plan a zero-downtime Postgres migration." }],
});
console.log(r.choices[0].message.content);
console.log(r.usage.prompt_cache_hit_tokens, r.usage.prompt_cache_miss_tokens, r.usage.completion_tokens);
DeepSeek vs OpenAI, Claude e Gemini
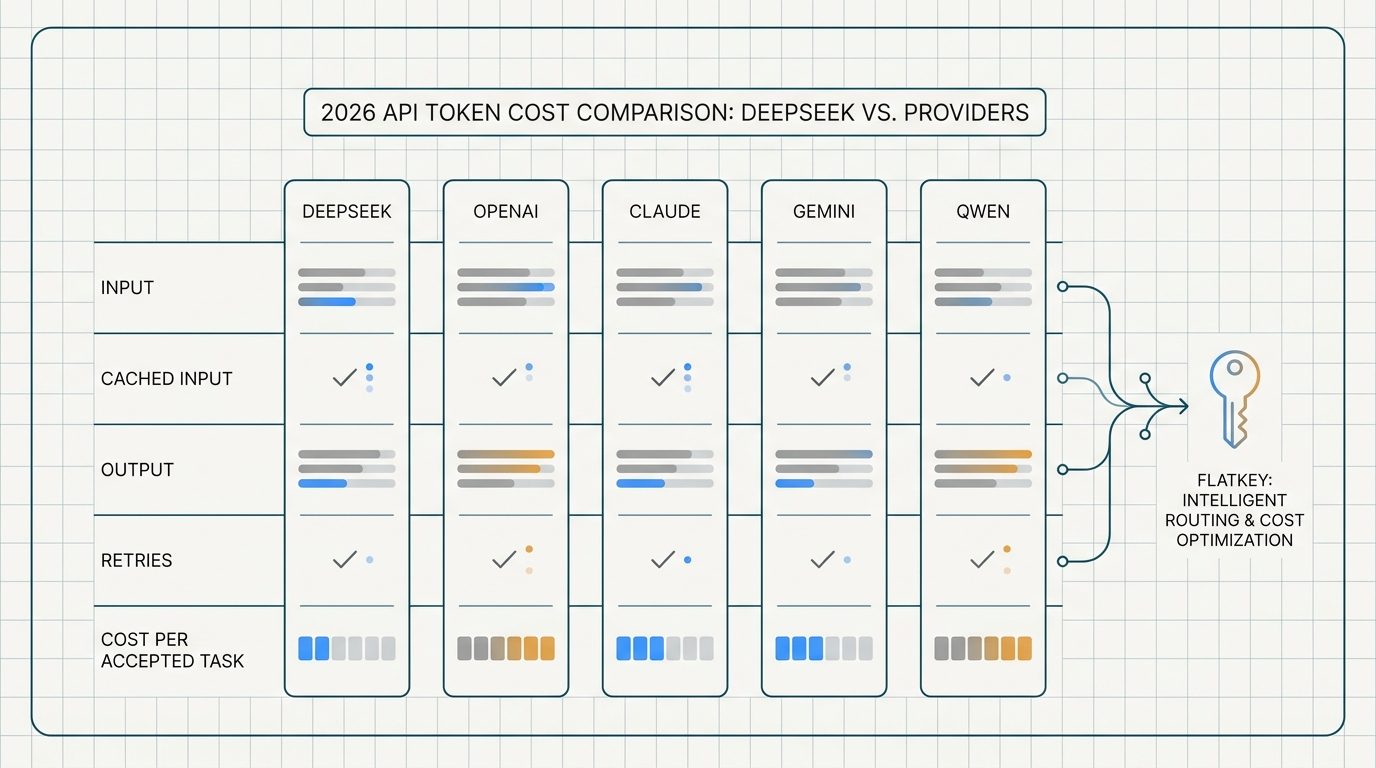
Mesma carga de trabalho acima (200M de entrada, 50M de saída, sem cache), usando o preço de tabela Standard oficial de cada provedor em 21 de outubro de 2026:
| Modelo | Entrada / saída por 1M | Custo mensal |
|---|---|---|
| Gemini 2.5 Flash-Lite | US$ 0,10 / US$ 0,40 | US$ 40,00 |
gpt-6-luna |
US$ 0,10 / US$ 0,50 | US$ 45,00 |
| Claude Haiku 5.5 (prompts até 100K) | US$ 0,10 / US$ 0,50 | US$ 45,00 |
deepseek-flash, fora de pico |
US$ 0,15 / US$ 0,60 | US$ 60,00 |
deepseek-v4-pro, fora de pico |
US$ 0,66 / US$ 1,98 | US$ 231,00 |
| Gemini 3.8 Flash (promoção 2026) | US$ 0,75 / US$ 3,75 | US$ 337,50 |
gpt-6.1-sol |
US$ 2,00 / US$ 10,00 | US$ 900,00 |
| Claude Sonnet 5.5 | US$ 2,00 / US$ 10,00 | US$ 900,00 |
Fontes: preços da OpenAI, preços da Anthropic, preços do Gemini.
Leitura honesta: pelo preço de tabela, o DeepSeek Flash não é mais o modelo econômico mais barato; Gemini 2.5 Flash-Lite, gpt-6-luna e Claude Haiku 5.5 ficam um pouco abaixo sem cache. A DeepSeek vence quando seu tráfego tem alta taxa de acerto de cache (o preço de US$ 0,003 é o menor da tabela) e na faixa intermediária, onde o V4 Pro custa cerca de um quarto do gpt-6.1-sol ou do Sonnet 5.5. Compare a qualidade nas suas próprias tarefas antes de trocar. Para uma visão entre fornecedores, veja DeepSeek API vs Qwen API para fluxos sensíveis a custo e nosso guia de preços da API da OpenAI.
API DeepSeek direta ou um gateway?
O acesso direto oferece as tarifas da própria DeepSeek, os recursos mais novos primeiro e o endpoint no formato Anthropic em https://api.deepseek.com/anthropic. Um gateway é útil quando a DeepSeek é um entre vários modelos do seu produto e você quer uma chave, um saldo e failover caso o limite de concorrência da DeepSeek ou uma indisponibilidade bloqueie requisições.
Em 21 de outubro de 2026, as páginas de modelos da Flatkey listavam o deepseek-v4-1-flash a partir de US$ 0,09 de entrada / US$ 0,36 de saída por 1M tokens e o deepseek-v4-pro a partir de US$ 0,396 / US$ 1,188, 40% abaixo dos preços fora de pico da DeepSeek. A Flatkey também usa tarifas por faixa de horário UTC, então o preço "a partir de" é a faixa fora de pico; confira na página do modelo a faixa que se aplica ao seu tráfego. A Flatkey fala o formato OpenAI em https://router.flatkey.ai/v1 e o formato Anthropic, então o código acima funciona trocando a URL base e a chave. Os detalhes de configuração estão no nosso guia de acesso à API DeepSeek.
Checklist de preços da DeepSeek
- Use
deepseek-flashcomo nome do modelo; os nomes legados do V4 Flash agora vão para o V4.1-Flash-1017. - Agende trabalhos em lote fora de 01:00–04:00 e 06:00–10:00 UTC em dias úteis.
- Registre
prompt_cache_hit_tokenseprompt_cache_miss_tokense acompanhe a taxa de acerto. - Use o modo sem raciocínio onde o raciocínio não agrega valor.
- Envie imagens ao Flash; o V4 Pro não suporta visão.
- Orce chamadas de Search e Fetch a partir de 1º de novembro de 2026 se usar a DeepSeek em agentes de programação.
- Reveja a página de preços todo mês; a DeepSeek avisa que os preços podem mudar.
Perguntas frequentes
Quanto custa a API DeepSeek por milhão de tokens?
Em 21 de outubro de 2026, o deepseek-flash custa US$ 0,15 por 1M de tokens de entrada (falha de cache) e US$ 0,60 por 1M de saída fora de pico, e o deepseek-v4-pro custa US$ 0,66 e US$ 1,98. No pico, o preço dobra, e a entrada com acerto de cache custa US$ 0,003 (Flash) ou US$ 0,022 (V4 Pro) fora de pico, segundo a página oficial de preços.
A API DeepSeek é gratuita?
Não. A DeepSeek cobra cada requisição do seu saldo, e a página de preços não lista nível gratuito. Se você tem saldo concedido em uma promoção, a DeepSeek o usa antes do saldo recarregado. Para opções sem custo, veja nossa lista de APIs de LLM gratuitas.
Existe chave de API DeepSeek gratuita?
Você pode criar uma chave de API gratuitamente na plataforma DeepSeek, mas as requisições ainda precisam de saldo. Sites de terceiros que oferecem "chaves DeepSeek grátis" revendem chaves compartilhadas ou oferecem seus próprios créditos de teste; evite enviar dados privados por eles.
Quando é o horário de pico da DeepSeek?
Das 01:00 às 04:00 e das 06:00 às 10:00 UTC, de segunda a sexta, exceto feriados chineses. No horário do Leste dos EUA antes de 1º de novembro de 2026, isso equivale a 21h–0h e 2h–6h; fins de semana são fora de pico.
Por que o custo da DeepSeek varia entre requisições idênticas?
Três motivos: o horário (o pico dobra o preço), a taxa de acerto de cache (um acerto custa 98% menos no Flash) e os tokens de raciocínio, cobrados como saída. Registre os três por requisição para explicar sua fatura.
A DeepSeek é mais barata que a OpenAI?
Na faixa intermediária, sim: o deepseek-v4-pro fora de pico custa US$ 0,66/1,98 por 1M tokens contra US$ 2/10 do gpt-6.1-sol. Na faixa econômica, o gpt-6-luna (US$ 0,10/0,50) é um pouco mais barato que o deepseek-flash fora de pico (US$ 0,15/0,60), a menos que sua taxa de acerto de cache seja alta.
Fontes
- DeepSeek Modelos e preços, verificado em 21 de outubro de 2026
- Guia de cache de contexto da DeepSeek, verificado em 21 de outubro de 2026
- Guia do modo thinking da DeepSeek, verificado em 21 de outubro de 2026
- Preços da OpenAI, preços da Anthropic, preços do Gemini, verificados em 21 de outubro de 2026
- Preços da Flatkey do diretório de modelos da Flatkey, verificado em 21 de outubro de 2026