Tarifs de l'API DeepSeek (octobre 2026) : Flash vs V4 Pro, heures de pointe et cache
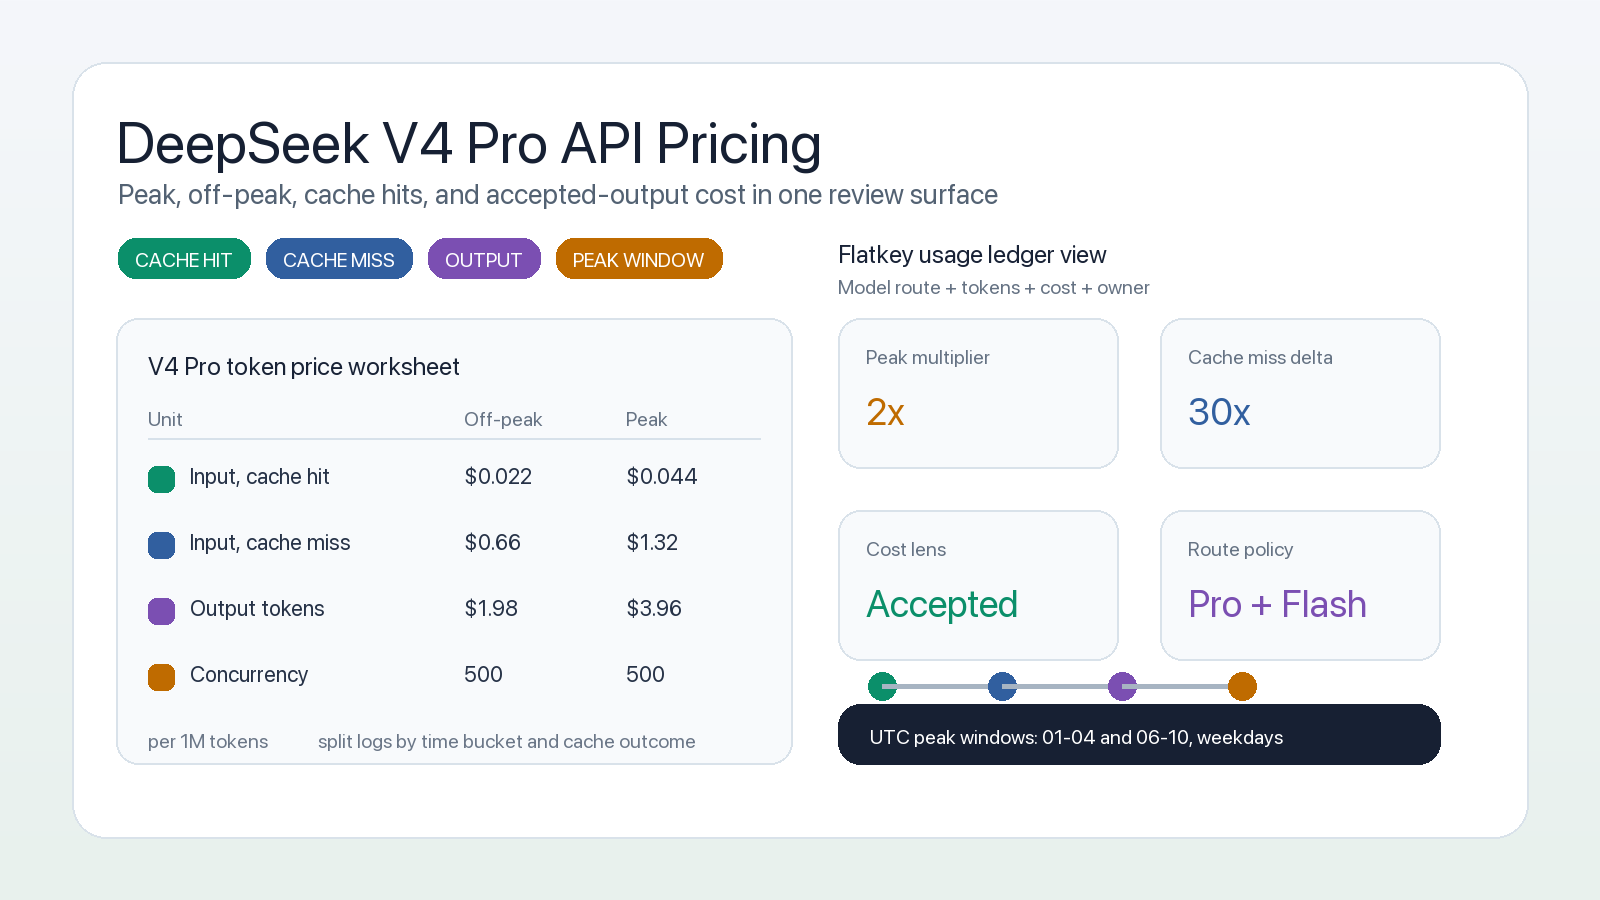
En octobre 2026, l'API DeepSeek coûte 0,15 $ par million de tokens d'entrée et 0,60 $ par million de tokens de sortie pour deepseek-flash en heures creuses, et 0,66 $ en entrée / 1,98 $ en sortie pour deepseek-v4-pro ; les tarifs en heures de pointe sont exactement doublés. Les hits de cache font tomber l'entrée à 0,003 $ (Flash) ou 0,022 $ (V4 Pro) par million de tokens en heures creuses. Les heures de pointe vont de 01:00 à 04:00 et de 06:00 à 10:00 UTC en semaine, si bien que les heures de bureau américaines sont entièrement en heures creuses. Tous les chiffres proviennent de la page officielle Modèles et tarifs de DeepSeek, consultée le 21 octobre 2026.
Ce guide s'adresse aux développeurs indépendants et aux petites équipes qui choisissent DeepSeek pour réduire le coût d'inférence. Il couvre le tableau complet des prix par million de tokens, la facturation pointe/creuse selon les fuseaux américains, la remise de cache, les nouveaux frais Search et Fetch, les anciens noms de modèles, des exemples de coûts chiffrés, un calculateur tenant compte de l'heure et la comparaison de DeepSeek avec OpenAI, Claude et Gemini.
Tarifs de l'API DeepSeek en un coup d'œil
| Question | Réponse (au 21 oct. 2026) |
|---|---|
| Modèles | deepseek-flash (DeepSeek-V4.1-Flash-1017) et deepseek-v4-pro (DeepSeek-V4-Pro-0813) |
| Entrée la moins chère | deepseek-flash, hit de cache, heures creuses : 0,003 $ par 1M tokens |
| Flash, heures creuses | 0,15 $ entrée (miss de cache) / 0,60 $ sortie par 1M tokens |
| V4 Pro, heures creuses | 0,66 $ entrée (miss de cache) / 1,98 $ sortie par 1M tokens |
| Multiplicateur de pointe | 2x (heures creuses = moitié du prix de pointe) |
| Heures de pointe | 01:00–04:00 et 06:00–10:00 UTC, du lundi au vendredi, hors jours fériés chinois |
| Contexte / sortie max. | 1M tokens / 384K tokens |
| API Search et Fetch | 0,75 $ par 1 000 requêtes réussies, chacune |
| Offre gratuite | Aucune indiquée ; le solde offert (le cas échéant) est consommé avant le solde rechargé |
Source : DeepSeek Modèles et tarifs, 21 octobre 2026.
Prix de l'API DeepSeek par million de tokens
| Prix par 1M tokens | deepseek-flash creuses |
deepseek-flash pointe |
deepseek-v4-pro creuses |
deepseek-v4-pro pointe |
|---|---|---|---|---|
| Entrée, hit de cache | 0,003 $ | 0,006 $ | 0,022 $ | 0,044 $ |
| Entrée, miss de cache | 0,15 $ | 0,30 $ | 0,66 $ | 1,32 $ |
| Sortie | 0,60 $ | 1,20 $ | 1,98 $ | 3,96 $ |
| Limite de concurrence | 2 500 | 2 500 | 500 | 500 |
Source : DeepSeek Modèles et tarifs, 21 octobre 2026.
Les deux modèles partagent les mêmes fonctionnalités sur la page de tarifs : sortie JSON, appels d'outils, Responses API, un endpoint au format Anthropic, complétion par préfixe de chat (bêta) et complétion FIM en mode sans réflexion uniquement. La seule différence qui compte pour les développeurs : la vision est prise en charge par deepseek-flash mais pas par deepseek-v4-pro. Les deux sont en mode réflexion par défaut et peuvent passer en mode sans réflexion ; voir le guide du mode thinking. Comme les tokens de raisonnement sont facturés en sortie, le mode sans réflexion est l'économie la plus simple sur les routes simples.
Les anciens noms de modèles fonctionnent toujours, au prix de Flash
La note de bas de page de DeepSeek recommande d'utiliser deepseek-flash comme nom de modèle. Les anciens noms deepseek-v4-flash et deepseek-v4-flash-vision-exp sont encore acceptés, mais ces modèles sont retirés : les requêtes sont servies par DeepSeek-V4.1-Flash-1017 et facturées au prix de Flash. Si vous aviez figé un ancien nom pour stabiliser le comportement, vous êtes déjà sur le nouveau modèle : relancez vos évaluations. Notre checklist de migration DeepSeek V4 liste ce qu'il faut tester.
Pointe vs creuses : ce que cela donne en heure américaine
DeepSeek définit les heures de pointe en UTC. Conversion pour les équipes américaines (l'heure d'été de l'Est s'applique jusqu'au 1er novembre 2026) :
| Créneau de pointe (UTC, lun–ven) | Est US (EDT, jusqu'au 1er nov.) | Est US (EST, à partir du 1er nov.) | Pacifique US (PDT, jusqu'au 1er nov.) |
|---|---|---|---|
| 01:00–04:00 | 21h00–minuit (soirs du dim. au jeu.) | 20h00–23h00 | 18h00–21h00 |
| 06:00–10:00 | 2h00–6h00 | 1h00–5h00 | 23h00–3h00 |
Converti à partir des heures de pointe de la page de tarifs de DeepSeek. Les week-ends et jours fériés chinois sont entièrement en heures creuses.
À retenir : un produit américain dont le trafic suit la journée de travail américaine paie le tarif creux sur presque tout son volume. Les créneaux coûteux tombent le soir et la nuit aux États-Unis, précisément quand de nombreuses équipes planifient leurs traitements par lots. Déplacez les cron nocturnes, évaluations et backfills en journée américaine ou le week-end et ils coûteront deux fois moins. Si vos utilisateurs sont en Asie, c'est l'inverse : 06:00–10:00 UTC correspond à l'après-midi à Pékin, et une grande partie de votre trafic diurne est en pointe.
Comment fonctionne la remise de cache
DeepSeek met automatiquement en cache les préfixes de prompts ; vous n'avez rien à marquer. L'objet usage de la réponse indique prompt_cache_hit_tokens et prompt_cache_miss_tokens, selon le guide du cache de contexte. Le guide précise aussi que le cache fonctionne au mieux sans taux de hit garanti, que sa construction prend quelques secondes et que les caches inutilisés sont supprimés en quelques heures à quelques jours.
Sur Flash, un hit coûte 0,003 $ contre 0,15 $ pour un miss en heures creuses, soit une remise de 98 %. La structure du prompt devient donc le premier levier après le choix du modèle :
- Gardez le prompt système, les schémas d'outils et les documents de référence identiques et au début de chaque requête.
- Ajoutez la partie propre à l'utilisateur à la fin.
- Pour les conversations multi-tours, renvoyez l'historique complet dans le même ordre afin que les tours précédents touchent le cache.
Pour une méthode générale permettant de mesurer si le cache est rentable, voir notre guide coût et ROI du prompt caching.
Frais Search et Fetch
DeepSeek vend désormais des API Search et Fetch autonomes à 0,75 $ par 1 000 requêtes réussies chacune. La page de tarifs ajoute que les appels d'outils côté serveur effectués via DeepSeek Harness, Claude Code ou Codex utilisent déjà ces API et sont gratuits pour l'instant, la facturation à la requête démarrant à 00:00 heure de Pékin le 1er novembre 2026 (16:00 UTC le 31 octobre). Si vous utilisez DeepSeek dans un agent de code, prévoyez une ligne budgétaire pour les recherches avant cette date.
Exemple chiffré : coût mensuel de l'API DeepSeek
Hypothèse : 100 000 requêtes par mois, chacune avec 2 000 tokens d'entrée et 500 tokens de sortie, soit 200M de tokens d'entrée et 50M de sortie.
| Scénario | Coût d'entrée | Coût de sortie | Total mensuel |
|---|---|---|---|
| Flash, creuses, aucun hit de cache | 200 x 0,15 $ = 30,00 $ | 50 x 0,60 $ = 30,00 $ | 60,00 $ |
| Flash, pointe, aucun hit de cache | 200 x 0,30 $ = 60,00 $ | 50 x 1,20 $ = 60,00 $ | 120,00 $ |
| Flash, creuses, 70 % de hits | 60 x 0,15 $ + 140 x 0,003 $ = 9,42 $ | 30,00 $ | 39,42 $ |
| V4 Pro, creuses, aucun hit de cache | 200 x 0,66 $ = 132,00 $ | 50 x 1,98 $ = 99,00 $ | 231,00 $ |
| V4 Pro, pointe, aucun hit de cache | 200 x 1,32 $ = 264,00 $ | 50 x 3,96 $ = 198,00 $ | 462,00 $ |
Calculé à partir des tarifs publiés par DeepSeek, 21 octobre 2026.
Deux tendances ressortent. D'abord, le cache réduit la facture Flash d'environ un tiers alors que la sortie ne change pas, car le côté entrée disparaît presque. Ensuite, V4 Pro coûte environ 4 fois Flash à la même heure : n'envoyez vers Pro que les requêtes qui échouent sur Flash (raisonnement complexe, longues boucles d'agents). Notre comparatif DeepSeek V4 Pro vs Flash explique quand ce compromis vaut la peine.
Calculateur de coûts DeepSeek à copier (selon l'heure)
Le calculateur ci-dessous lit les champs de cache d'une vraie réponse et applique le tarif de pointe ou creux selon l'heure UTC de la requête. Il ne connaît pas les jours fériés chinois et surestime donc ces jours-là.
# pip install openai
import os
from datetime import datetime, timezone
from openai import OpenAI

# DeepSeek rates per 1M tokens, Models & Pricing page, Oct 21, 2026 (off-peak; peak = 2x)
OFF_PEAK = {
    "deepseek-flash":  {"hit": 0.003, "miss": 0.15, "out": 0.60},
    "deepseek-v4-pro": {"hit": 0.022, "miss": 0.66, "out": 1.98},
}

def is_peak(ts: datetime) -> bool:
    ts = ts.astimezone(timezone.utc)
    if ts.weekday() >= 5:  # Saturday, Sunday
        return False
    return 1 <= ts.hour < 4 or 6 <= ts.hour < 10

def cost(model: str, usage, ts: datetime) -> float:
    r = OFF_PEAK[model]
    k = 2 if is_peak(ts) else 1
    return k * (usage.prompt_cache_hit_tokens * r["hit"]
                + usage.prompt_cache_miss_tokens * r["miss"]
                + usage.completion_tokens * r["out"]) / 1_000_000

client = OpenAI(api_key=os.environ["DEEPSEEK_API_KEY"], base_url="https://api.deepseek.com")
now = datetime.now(timezone.utc)
resp = client.chat.completions.create(
    model="deepseek-flash",
    messages=[{"role": "system", "content": "You are a concise SQL assistant."},
              {"role": "user", "content": "Count orders per day for the last 7 days."}],
)
print(resp.choices[0].message.content)
print(f"peak={is_peak(now)} cost=${cost('deepseek-flash', resp.usage, now):.6f}")
La même requête avec curl :
curl https://api.deepseek.com/chat/completions \
  -H "Authorization: Bearer $DEEPSEEK_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model":"deepseek-flash","messages":[{"role":"user","content":"Explain idempotency keys in one paragraph."}]}'
Et en Node.js :
import OpenAI from "openai";

const client = new OpenAI({ apiKey: process.env.DEEPSEEK_API_KEY, baseURL: "https://api.deepseek.com" });
const r = await client.chat.completions.create({
  model: "deepseek-v4-pro",
  messages: [{ role: "user", content: "Plan a zero-downtime Postgres migration." }],
});
console.log(r.choices[0].message.content);
console.log(r.usage.prompt_cache_hit_tokens, r.usage.prompt_cache_miss_tokens, r.usage.completion_tokens);
DeepSeek vs OpenAI, Claude et Gemini
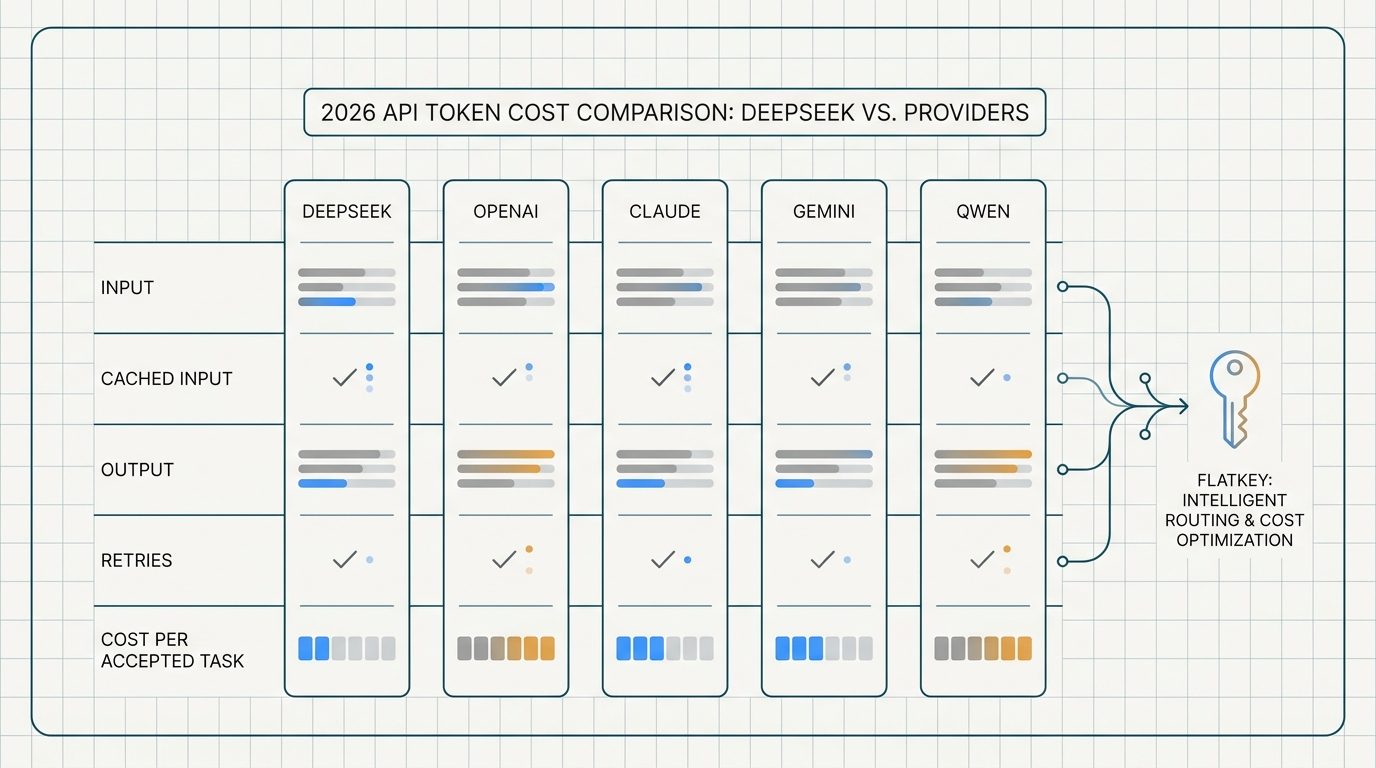
Même charge que ci-dessus (200M en entrée, 50M en sortie, sans cache), au prix catalogue Standard officiel de chaque fournisseur le 21 octobre 2026 :
| Modèle | Entrée / sortie par 1M | Coût mensuel |
|---|---|---|
| Gemini 2.5 Flash-Lite | 0,10 $ / 0,40 $ | 40,00 $ |
gpt-6-luna |
0,10 $ / 0,50 $ | 45,00 $ |
| Claude Haiku 5.5 (prompts jusqu'à 100K) | 0,10 $ / 0,50 $ | 45,00 $ |
deepseek-flash, creuses |
0,15 $ / 0,60 $ | 60,00 $ |
deepseek-v4-pro, creuses |
0,66 $ / 1,98 $ | 231,00 $ |
| Gemini 3.8 Flash (promo 2026) | 0,75 $ / 3,75 $ | 337,50 $ |
gpt-6.1-sol |
2,00 $ / 10,00 $ | 900,00 $ |
| Claude Sonnet 5.5 | 2,00 $ / 10,00 $ | 900,00 $ |
Sources : tarifs OpenAI, tarifs Anthropic, tarifs Gemini.
Lecture honnête : au prix catalogue, DeepSeek Flash n'est plus le modèle économique le moins cher ; Gemini 2.5 Flash-Lite, gpt-6-luna et Claude Haiku 5.5 le battent légèrement sans cache. DeepSeek l'emporte quand votre trafic a un taux de hit de cache élevé (son prix de 0,003 $ est le plus bas du tableau) et dans le milieu de gamme, où V4 Pro coûte environ le quart de gpt-6.1-sol ou Sonnet 5.5. Comparez la qualité sur vos propres tâches avant de changer. Pour une vue multi-fournisseurs, voir DeepSeek API vs Qwen API pour les workflows sensibles au coût et notre guide des tarifs de l'API OpenAI.
API DeepSeek en direct ou via une passerelle ?
L'accès direct vous donne les tarifs propres à DeepSeek, les nouveautés en premier et l'endpoint au format Anthropic sur https://api.deepseek.com/anthropic. Une passerelle est utile quand DeepSeek n'est qu'un des modèles de votre produit et que vous voulez une seule clé, un seul solde et un basculement si la limite de concurrence de DeepSeek ou une panne bloque les requêtes.
Le 21 octobre 2026, les pages modèles de Flatkey affichaient deepseek-v4-1-flash à partir de 0,09 $ en entrée / 0,36 $ en sortie par 1M tokens et deepseek-v4-pro à partir de 0,396 $ / 1,188 $, soit 40 % sous les prix creux de DeepSeek. Flatkey applique aussi des tarifs par tranches horaires UTC : le prix « à partir de » correspond à la tranche creuse ; vérifiez sur la page du modèle la tranche applicable à votre trafic. Flatkey parle le format OpenAI sur https://router.flatkey.ai/v1 ainsi que le format Anthropic, donc le code ci-dessus fonctionne en changeant l'URL de base et la clé. La configuration est détaillée dans notre guide d'accès à l'API DeepSeek.
Checklist tarifaire DeepSeek
- Utilisez
deepseek-flashcomme nom de modèle ; les anciens noms V4 Flash pointent désormais vers V4.1-Flash-1017. - Planifiez les lots en dehors de 01:00–04:00 et 06:00–10:00 UTC en semaine.
- Journalisez
prompt_cache_hit_tokensetprompt_cache_miss_tokenset suivez le taux de hit. - Utilisez le mode sans réflexion quand le raisonnement n'apporte rien.
- Envoyez les images à Flash ; V4 Pro ne prend pas en charge la vision.
- Budgétisez les appels Search et Fetch à partir du 1er novembre 2026 si vous utilisez DeepSeek dans des agents de code.
- Revérifiez la page de tarifs chaque mois ; DeepSeek indique que les prix peuvent changer.
FAQ
Combien coûte l'API DeepSeek par million de tokens ?
Au 21 octobre 2026, deepseek-flash coûte 0,15 $ par million de tokens d'entrée (miss de cache) et 0,60 $ par million de tokens de sortie en heures creuses, et deepseek-v4-pro coûte 0,66 $ et 1,98 $. Les tarifs de pointe sont doublés, et l'entrée en hit de cache coûte 0,003 $ (Flash) ou 0,022 $ (V4 Pro) en heures creuses, selon la page officielle des tarifs.
L'API DeepSeek est-elle gratuite ?
Non. DeepSeek facture chaque requête sur votre solde et la page de tarifs n'indique aucune offre gratuite. Si vous disposez d'un solde offert par une promotion, DeepSeek le consomme avant votre solde rechargé. Pour des options sans coût, voir notre liste d'API LLM gratuites.
Existe-t-il une clé API DeepSeek gratuite ?
Vous pouvez créer une clé API gratuitement sur la plateforme DeepSeek, mais les requêtes nécessitent toujours un solde. Les sites tiers proposant des « clés DeepSeek gratuites » revendent des clés partagées ou offrent leurs propres crédits d'essai ; évitez d'y faire transiter des données privées.
Quand sont les heures de pointe de DeepSeek ?
De 01:00 à 04:00 et de 06:00 à 10:00 UTC, du lundi au vendredi, hors jours fériés chinois. En heure de l'Est américaine avant le 1er novembre 2026, cela correspond à 21h–minuit et 2h–6h ; les week-ends sont en heures creuses.
Pourquoi le coût DeepSeek varie-t-il entre des requêtes identiques ?
Trois raisons : l'heure (la pointe double le prix), le taux de hit de cache (un hit coûte 98 % de moins sur Flash) et les tokens de réflexion, facturés en sortie. Journalisez ces trois éléments par requête pour expliquer votre facture.
DeepSeek est-il moins cher qu'OpenAI ?
En milieu de gamme, oui : deepseek-v4-pro en heures creuses coûte 0,66/1,98 $ par million de tokens contre 2/10 $ pour gpt-6.1-sol. En entrée de gamme, gpt-6-luna (0,10/0,50 $) est légèrement moins cher que deepseek-flash en heures creuses (0,15/0,60 $), sauf si votre taux de hit de cache est élevé.
Sources
- DeepSeek Modèles et tarifs, consulté le 21 octobre 2026
- Guide du cache de contexte DeepSeek, consulté le 21 octobre 2026
- Guide du mode thinking DeepSeek, consulté le 21 octobre 2026
- Tarifs OpenAI, tarifs Anthropic, tarifs Gemini, consultés le 21 octobre 2026
- Prix Flatkey issus du répertoire des modèles Flatkey, consulté le 21 octobre 2026