DeepSeek API 价格(2026 年 10 月):Flash 与 V4 Pro、高峰时段与缓存计算
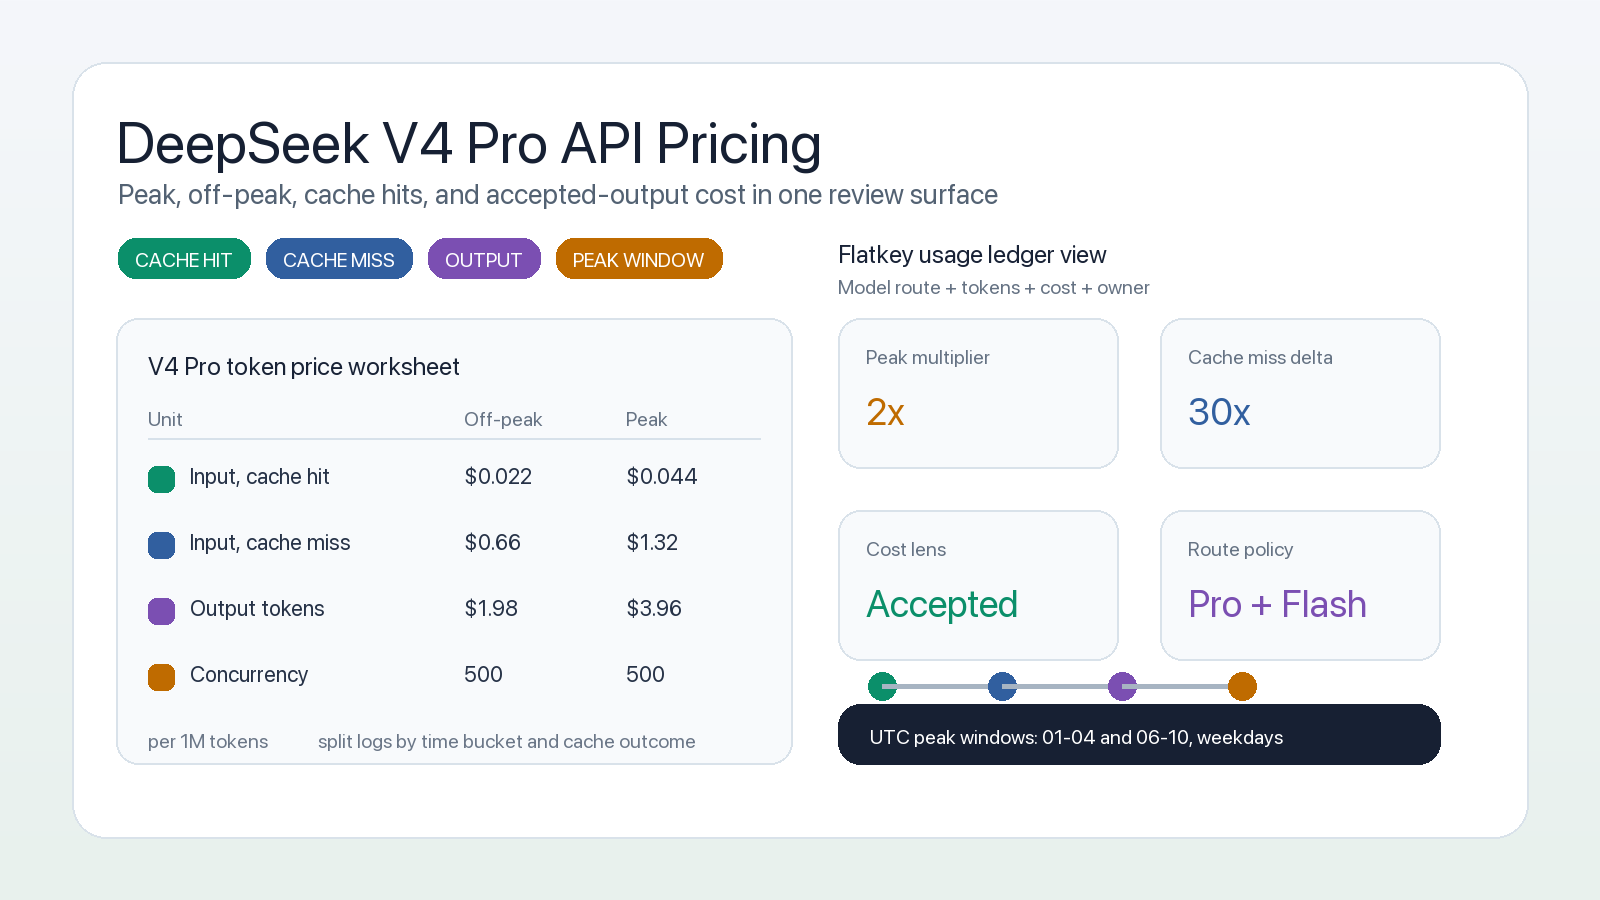
2026 年 10 月,deepseek-flash 在闲时的 DeepSeek API 价格为每百万输入 Token $0.15、每百万输出 Token $0.60;deepseek-v4-pro 为输入 $0.66 / 输出 $1.98;高峰时段价格正好翻倍。 闲时缓存命中可将输入降至每百万 Token $0.003(Flash)或 $0.022(V4 Pro)。高峰时段为工作日 UTC 01:00–04:00 和 06:00–10:00,这意味着美国工作时间全部处于闲时。所有数字均来自 DeepSeek 官方 模型与价格页面,核对日期为 2026 年 10 月 21 日。
本文面向希望用 DeepSeek 压低推理成本的独立开发者和小团队,内容包括:完整的每百万 Token 价格表、美国时区下的高峰与闲时计费方式、缓存折扣、新的 Search 和 Fetch 费用、旧模型名称、成本计算示例、按时间计费的成本计算器,以及 DeepSeek 与 OpenAI、Claude、Gemini 的对比。
DeepSeek API 价格速览
| 问题 | 答案(截至 2026 年 10 月 21 日) |
|---|---|
| 模型 | deepseek-flash(DeepSeek-V4.1-Flash-1017)和 deepseek-v4-pro(DeepSeek-V4-Pro-0813) |
| 最便宜的输入 | deepseek-flash,缓存命中,闲时:每百万 Token $0.003 |
| Flash,闲时 | 输入 $0.15(缓存未命中)/ 输出 $0.60,每百万 Token |
| V4 Pro,闲时 | 输入 $0.66(缓存未命中)/ 输出 $1.98,每百万 Token |
| 高峰倍数 | 2 倍(闲时为高峰的一半) |
| 高峰时段 | UTC 01:00–04:00 和 06:00–10:00,周一至周五,中国法定节假日除外 |
| 上下文 / 最大输出 | 100 万 Token / 38.4 万 Token |
| Search 和 Fetch API | 各为每 1,000 次成功请求 $0.75 |
| 免费额度 | 未列出;赠送余额(如有)先于充值余额扣除 |
来源:DeepSeek 模型与价格,2026 年 10 月 21 日。
DeepSeek API 每百万 Token 价格
| 每百万 Token 价格 | deepseek-flash 闲时 |
deepseek-flash 高峰 |
deepseek-v4-pro 闲时 |
deepseek-v4-pro 高峰 |
|---|---|---|---|---|
| 输入,缓存命中 | $0.003 | $0.006 | $0.022 | $0.044 |
| 输入,缓存未命中 | $0.15 | $0.30 | $0.66 | $1.32 |
| 输出 | $0.60 | $1.20 | $1.98 | $3.96 |
| 并发上限 | 2,500 | 2,500 | 500 | 500 |
来源:DeepSeek 模型与价格,2026 年 10 月 21 日。
价格页面上两款模型功能相同:JSON 输出、工具调用、Responses API、Anthropic 格式端点、对话前缀续写(beta),以及仅在非思考模式下可用的 FIM 补全。对开发者真正重要的区别只有一个:deepseek-flash 支持视觉输入,deepseek-v4-pro 不支持。两者默认都是思考模式,可切换为非思考模式,详见 思考模式指南。由于推理 Token 按输出计费,在简单路由上使用非思考模式是最容易的省钱方式。
旧模型名称仍可使用,按 Flash 价格计费
DeepSeek 的脚注建议使用 deepseek-flash 作为模型名。旧名称 deepseek-v4-flash 和 deepseek-v4-flash-vision-exp 仍被接受,但这些模型已下线:请求由 DeepSeek-V4.1-Flash-1017 处理,并按 Flash 价格计费。如果你曾固定旧名称以锁定模型行为,那么你其实已经在用新模型了,请重新跑一遍评测。我们的 DeepSeek V4 迁移清单 列出了需要测试的内容。
高峰与闲时:换算成美国时间
DeepSeek 以 UTC 定义高峰时段。为美国团队换算如下(美国东部夏令时持续到 2026 年 11 月 1 日):
| 高峰时段(UTC,周一至周五) | 美国东部(EDT,至 11 月 1 日) | 美国东部(EST,自 11 月 1 日) | 美国太平洋(PDT,至 11 月 1 日) |
|---|---|---|---|
| 01:00–04:00 | 晚 9:00–午夜 12:00(周日至周四晚) | 晚 8:00–11:00 | 晚 6:00–9:00 |
| 06:00–10:00 | 凌晨 2:00–6:00 | 凌晨 1:00–5:00 | 晚 11:00–凌晨 3:00 |
根据 DeepSeek 价格页面 上的高峰时段换算。周末和中国法定节假日全天为闲时。
实际结论:流量跟随美国工作日的美国产品,几乎全部按闲时价格计费。贵的时段落在美国晚间和夜里,而这恰恰是很多团队安排批处理任务的时间。把夜间定时任务、评测和数据回填挪到美国白天或周末,成本就能减半。如果你的用户在亚洲,情况相反:UTC 06:00–10:00 是北京时间下午,你白天的大部分流量都处于高峰。
缓存折扣如何生效
DeepSeek 会自动缓存提示词前缀,无需做任何标记。根据 上下文缓存指南,响应中的 usage 对象会返回 prompt_cache_hit_tokens 和 prompt_cache_miss_tokens。该指南还说明,缓存是尽力而为,不保证命中率;缓存构建需要几秒;未使用的缓存会在几小时到几天内清除。
在 Flash 上,闲时缓存命中价格为 $0.003,未命中为 $0.15,折扣达 98%。因此除了模型选择之外,提示词结构是最大的杠杆:
- 让系统提示词、工具 schema 和参考文档在每次请求开头保持完全一致。
- 把用户相关的部分追加在末尾。
- 多轮对话时,按相同顺序重发完整历史,让前面的轮次命中缓存。
如需衡量缓存是否划算的通用方法,请参阅我们的 提示词缓存成本与 ROI 指南。
Search 和 Fetch 费用
DeepSeek 现已单独提供 Search 和 Fetch API,各为 每 1,000 次成功请求 $0.75。价格页面补充说明:通过 DeepSeek Harness、Claude Code 或 Codex 发起的服务端工具调用已经在调用这些 API,目前免费,将从 北京时间 2026 年 11 月 1 日 00:00(UTC 10 月 31 日 16:00)开始按次计费。如果你在编程 Agent 中使用 DeepSeek,请在此之前把搜索调用纳入预算。
计算示例:DeepSeek API 每月成本
假设 每月 100,000 次请求,每次 2,000 输入 Token、500 输出 Token:即 2 亿输入 Token 和 5,000 万输出 Token。
| 场景 | 输入成本 | 输出成本 | 月度合计 |
|---|---|---|---|
| Flash,闲时,无缓存命中 | 200 x $0.15 = $30.00 | 50 x $0.60 = $30.00 | $60.00 |
| Flash,高峰,无缓存命中 | 200 x $0.30 = $60.00 | 50 x $1.20 = $60.00 | $120.00 |
| Flash,闲时,70% 缓存命中 | 60 x $0.15 + 140 x $0.003 = $9.42 | $30.00 | $39.42 |
| V4 Pro,闲时,无缓存命中 | 200 x $0.66 = $132.00 | 50 x $1.98 = $99.00 | $231.00 |
| V4 Pro,高峰,无缓存命中 | 200 x $1.32 = $264.00 | 50 x $3.96 = $198.00 | $462.00 |
根据 DeepSeek 公布的价格 计算,2026 年 10 月 21 日。
有两点很明显。第一,即使输出不变,缓存也能让 Flash 账单下降约三分之一,因为输入成本几乎消失。第二,同一时段 V4 Pro 大约是 Flash 的 4 倍,所以只把 Flash 处理不了的请求(复杂推理、长 Agent 循环)路由到 Pro。我们的 DeepSeek V4 Pro 与 Flash 对比 讨论了这种取舍何时值得。
可复制的 DeepSeek 成本计算器(按时间计费)
下面的计算器从真实响应中读取缓存字段,并根据请求的 UTC 时间套用高峰或闲时价格。它不识别中国法定节假日,所以在节假日会高估成本。
# pip install openai
import os
from datetime import datetime, timezone
from openai import OpenAI

# DeepSeek rates per 1M tokens, Models & Pricing page, Oct 21, 2026 (off-peak; peak = 2x)
OFF_PEAK = {
    "deepseek-flash":  {"hit": 0.003, "miss": 0.15, "out": 0.60},
    "deepseek-v4-pro": {"hit": 0.022, "miss": 0.66, "out": 1.98},
}

def is_peak(ts: datetime) -> bool:
    ts = ts.astimezone(timezone.utc)
    if ts.weekday() >= 5:  # Saturday, Sunday
        return False
    return 1 <= ts.hour < 4 or 6 <= ts.hour < 10

def cost(model: str, usage, ts: datetime) -> float:
    r = OFF_PEAK[model]
    k = 2 if is_peak(ts) else 1
    return k * (usage.prompt_cache_hit_tokens * r["hit"]
                + usage.prompt_cache_miss_tokens * r["miss"]
                + usage.completion_tokens * r["out"]) / 1_000_000

client = OpenAI(api_key=os.environ["DEEPSEEK_API_KEY"], base_url="https://api.deepseek.com")
now = datetime.now(timezone.utc)
resp = client.chat.completions.create(
    model="deepseek-flash",
    messages=[{"role": "system", "content": "You are a concise SQL assistant."},
              {"role": "user", "content": "Count orders per day for the last 7 days."}],
)
print(resp.choices[0].message.content)
print(f"peak={is_peak(now)} cost=${cost('deepseek-flash', resp.usage, now):.6f}")
用 curl 发送同样的请求:
curl https://api.deepseek.com/chat/completions \
  -H "Authorization: Bearer $DEEPSEEK_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model":"deepseek-flash","messages":[{"role":"user","content":"Explain idempotency keys in one paragraph."}]}'
Node.js 版本:
import OpenAI from "openai";

const client = new OpenAI({ apiKey: process.env.DEEPSEEK_API_KEY, baseURL: "https://api.deepseek.com" });
const r = await client.chat.completions.create({
  model: "deepseek-v4-pro",
  messages: [{ role: "user", content: "Plan a zero-downtime Postgres migration." }],
});
console.log(r.choices[0].message.content);
console.log(r.usage.prompt_cache_hit_tokens, r.usage.prompt_cache_miss_tokens, r.usage.completion_tokens);
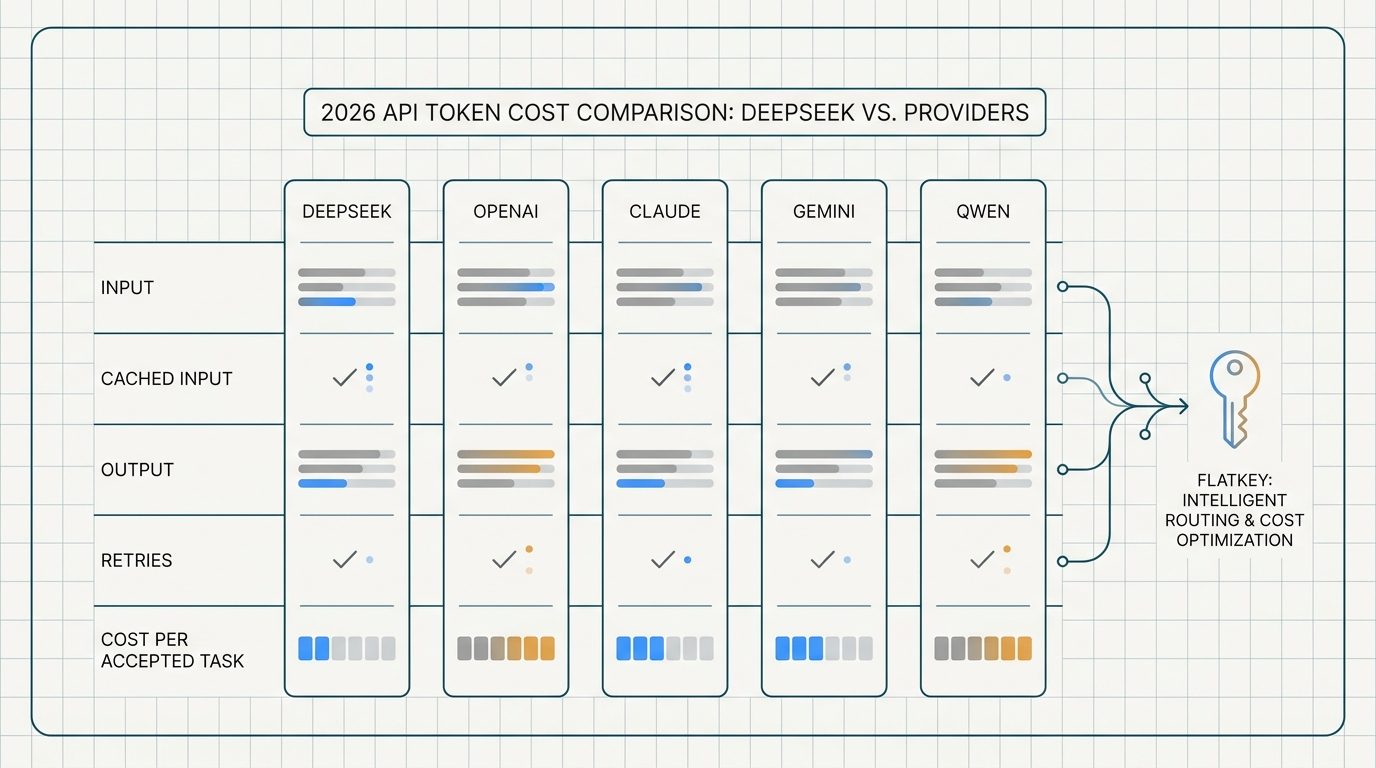
DeepSeek 与 OpenAI、Claude、Gemini 对比
与上文相同的工作负载(2 亿输入、5,000 万输出、无缓存),使用各家 2026 年 10 月 21 日的官方 Standard 标价:
| 模型 | 每百万输入 / 输出 | 月成本 |
|---|---|---|
| Gemini 2.5 Flash-Lite | $0.10 / $0.40 | $40.00 |
gpt-6-luna |
$0.10 / $0.50 | $45.00 |
| Claude Haiku 5.5(提示词不超过 10 万) | $0.10 / $0.50 | $45.00 |
deepseek-flash,闲时 |
$0.15 / $0.60 | $60.00 |
deepseek-v4-pro,闲时 |
$0.66 / $1.98 | $231.00 |
| Gemini 3.8 Flash(2026 促销价) | $0.75 / $3.75 | $337.50 |
gpt-6.1-sol |
$2.00 / $10.00 | $900.00 |
| Claude Sonnet 5.5 | $2.00 / $10.00 | $900.00 |
来源:OpenAI 价格、Anthropic 价格、Gemini 价格。
客观来看:按标价计算,DeepSeek Flash 已不再是最便宜的低价模型;在不使用缓存的情况下,Gemini 2.5 Flash-Lite、gpt-6-luna 和 Claude Haiku 5.5 都略低于它。DeepSeek 的优势在于缓存命中率高的流量($0.003 的命中价是表中最低),以及中端档位:V4 Pro 的成本约为 gpt-6.1-sol 或 Sonnet 5.5 的四分之一。切换前请在你自己的任务上比较质量。跨厂商视角请参阅 DeepSeek API 与 Qwen API 在成本敏感场景下的对比 和我们的 OpenAI API 价格指南。
直连 DeepSeek API 还是用网关?
直连可以拿到 DeepSeek 自己的价格、第一时间用上新功能,以及 https://api.deepseek.com/anthropic 的 Anthropic 格式端点。当 DeepSeek 只是你产品中的多个模型之一,且你希望用一个 Key、一份余额,并在 DeepSeek 并发上限或故障阻塞请求时自动故障转移,网关就很有用。
2026 年 10 月 21 日,Flatkey 的模型页面列出 deepseek-v4-1-flash 起价为每百万 Token 输入 $0.09 / 输出 $0.36,deepseek-v4-pro 起价为 $0.396 / $1.188,比 DeepSeek 闲时标价低 40%。Flatkey 同样采用按 UTC 时间分档的价格,所以“起价”是闲时档;请在模型页面查看适用于你流量的档位。Flatkey 支持 https://router.flatkey.ai/v1 的 OpenAI 格式和 Anthropic 格式,因此上面的代码只需更换 base URL 和 Key 即可使用。配置细节见我们的 DeepSeek API 接入指南。
DeepSeek 价格检查清单
- 使用
deepseek-flash作为模型名;旧的 V4 Flash 名称现在会调用 V4.1-Flash-1017。 - 把批处理任务安排在工作日 UTC 01:00–04:00 和 06:00–10:00 之外。
- 记录
prompt_cache_hit_tokens和prompt_cache_miss_tokens,跟踪命中率。 - 在推理没有价值的地方使用非思考模式。
- 图片输入发给 Flash;V4 Pro 不支持视觉。
- 如果在编程 Agent 中使用 DeepSeek,从 2026 年 11 月 1 日起为 Search 和 Fetch 调用做预算。
- 每月重新查看价格页面;DeepSeek 表示价格可能调整。
常见问题
DeepSeek API 每百万 Token 多少钱?
截至 2026 年 10 月 21 日,deepseek-flash 闲时每百万输入 Token(缓存未命中)$0.15、每百万输出 Token $0.60;deepseek-v4-pro 为 $0.66 和 $1.98。高峰时段价格翻倍;闲时缓存命中的输入价格为 $0.003(Flash)或 $0.022(V4 Pro),见 官方价格页面。
DeepSeek API 可以免费使用吗?
不可以。DeepSeek 每次请求都从余额中扣费,价格页面没有列出免费额度。如果你有活动赠送的余额,DeepSeek 会先扣赠送余额再扣充值余额。零成本选项请看我们的 免费 LLM API 清单。
有免费的 DeepSeek API Key 吗?
你可以在 DeepSeek 平台免费创建 API Key,但请求仍需要余额。提供“免费 DeepSeek Key”的第三方网站,要么在转售共享 Key,要么提供自己的试用额度;不要通过它们发送私密数据。
DeepSeek 高峰时段是什么时候?
周一至周五 UTC 01:00–04:00 和 06:00–10:00,中国法定节假日除外。换算成 2026 年 11 月 1 日前的美国东部时间,是晚 9 点到午夜和凌晨 2 点到 6 点;周末为闲时。
为什么相同请求的 DeepSeek 费用会不同?
三个原因:时间段(高峰价格翻倍)、缓存命中率(Flash 上命中便宜 98%)、以及按输出计费的思考 Token。按请求记录这三项,就能解释你的账单。
DeepSeek 比 OpenAI 便宜吗?
中端档位是的:deepseek-v4-pro 闲时为每百万 Token $0.66/$1.98,而 gpt-6.1-sol 为 $2/$10。在低价档,gpt-6-luna($0.10/$0.50)比闲时的 deepseek-flash($0.15/$0.60)略便宜,除非你的缓存命中率很高。
资料来源
- DeepSeek 模型与价格,核对于 2026 年 10 月 21 日
- DeepSeek 上下文缓存指南,核对于 2026 年 10 月 21 日
- DeepSeek 思考模式指南,核对于 2026 年 10 月 21 日
- OpenAI 价格、Anthropic 价格、Gemini 价格,核对于 2026 年 10 月 21 日
- Flatkey 价格来自 Flatkey 模型目录,核对于 2026 年 10 月 21 日