Precios de la API de DeepSeek (octubre 2026): Flash vs V4 Pro, horas pico y caché
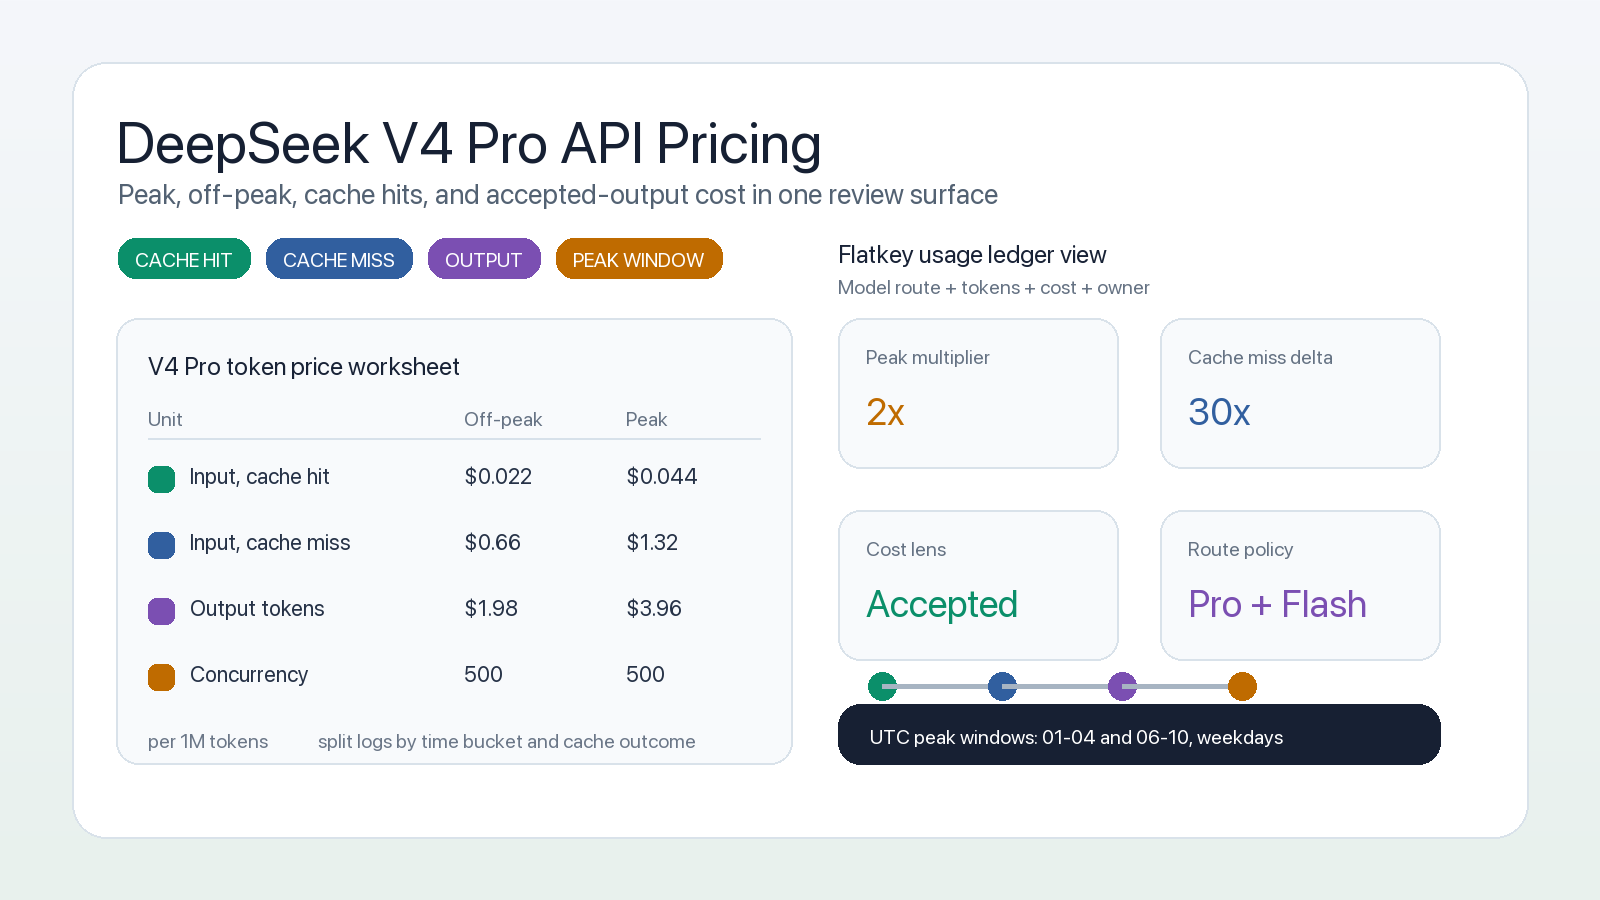
En octubre de 2026, la API de DeepSeek cuesta $0.15 por 1M de tokens de entrada y $0.60 por 1M de tokens de salida con deepseek-flash en horario valle, y $0.66 de entrada / $1.98 de salida con deepseek-v4-pro; en horas pico las tarifas son exactamente el doble. Los aciertos de caché bajan la entrada a $0.003 (Flash) o $0.022 (V4 Pro) por 1M de tokens en horario valle. Las horas pico son de 01:00 a 04:00 y de 06:00 a 10:00 UTC en días laborables, así que el horario laboral de EE. UU. es íntegramente valle. Todas las cifras proceden de la página oficial de modelos y precios de DeepSeek, consultada el 21 de octubre de 2026.
Esta guía es para desarrolladores independientes y equipos pequeños que eligen DeepSeek para abaratar la inferencia. Incluye la tabla completa de precios por millón de tokens, cómo funciona la facturación pico/valle en zonas horarias de EE. UU., el descuento por caché, las nuevas tarifas de Search y Fetch, los nombres de modelo heredados, ejemplos de coste, una calculadora sensible a la hora y la comparación de DeepSeek con OpenAI, Claude y Gemini.
Precios de la API de DeepSeek de un vistazo
| Pregunta | Respuesta (a 21 oct 2026) |
|---|---|
| Modelos | deepseek-flash (DeepSeek-V4.1-Flash-1017) y deepseek-v4-pro (DeepSeek-V4-Pro-0813) |
| Entrada más barata | deepseek-flash, acierto de caché, valle: $0.003 por 1M tokens |
| Flash, valle | $0.15 entrada (fallo de caché) / $0.60 salida por 1M tokens |
| V4 Pro, valle | $0.66 entrada (fallo de caché) / $1.98 salida por 1M tokens |
| Multiplicador pico | 2x (valle es la mitad de pico) |
| Horas pico | 01:00–04:00 y 06:00–10:00 UTC, lunes a viernes, excepto festivos chinos |
| Contexto / salida máx. | 1M tokens / 384K tokens |
| APIs Search y Fetch | $0.75 por cada 1.000 solicitudes correctas, cada una |
| Nivel gratuito | No figura; el saldo regalado (si lo hay) se gasta antes que el recargado |
Fuente: DeepSeek Modelos y precios, 21 de octubre de 2026.
Precio de la API de DeepSeek por millón de tokens
| Precio por 1M tokens | deepseek-flash valle |
deepseek-flash pico |
deepseek-v4-pro valle |
deepseek-v4-pro pico |
|---|---|---|---|---|
| Entrada, acierto de caché | $0.003 | $0.006 | $0.022 | $0.044 |
| Entrada, fallo de caché | $0.15 | $0.30 | $0.66 | $1.32 |
| Salida | $0.60 | $1.20 | $1.98 | $3.96 |
| Límite de concurrencia | 2.500 | 2.500 | 500 | 500 |
Fuente: DeepSeek Modelos y precios, 21 de octubre de 2026.
Ambos modelos comparten funciones en la página de precios: salida JSON, llamadas a herramientas, la Responses API, un endpoint con formato Anthropic, completado por prefijo de chat (beta) y completado FIM solo en modo sin razonamiento. La única diferencia relevante para quien construye: la visión está disponible en deepseek-flash pero no en deepseek-v4-pro. Ambos usan por defecto el modo de razonamiento y se pueden cambiar a modo sin razonamiento; consulta la guía del modo thinking. Como los tokens de razonamiento se facturan como salida, el modo sin razonamiento es el ahorro más fácil en rutas simples.
Los nombres de modelo heredados siguen funcionando, al precio de Flash
La nota al pie de DeepSeek indica usar deepseek-flash como nombre de modelo. Los nombres antiguos deepseek-v4-flash y deepseek-v4-flash-vision-exp siguen aceptándose, pero esos modelos están retirados: las solicitudes las atiende DeepSeek-V4.1-Flash-1017 y se facturan al precio de Flash. Si fijaste un nombre heredado para congelar el comportamiento, ya estás en el modelo nuevo, así que vuelve a ejecutar tus evaluaciones. Nuestra lista de migración a DeepSeek V4 detalla qué probar.
Pico vs valle: qué significa en hora de EE. UU.
DeepSeek define las horas pico en UTC. Convertidas para equipos en EE. UU. (el horario de verano del Este dura hasta el 1 de noviembre de 2026):
| Franja pico (UTC, lun–vie) | Este de EE. UU. (EDT, hasta 1 nov) | Este de EE. UU. (EST, desde 1 nov) | Pacífico (PDT, hasta 1 nov) |
|---|---|---|---|
| 01:00–04:00 | 9:00 pm–12:00 am (noches de dom a jue) | 8:00 pm–11:00 pm | 6:00 pm–9:00 pm |
| 06:00–10:00 | 2:00 am–6:00 am | 1:00 am–5:00 am | 11:00 pm–3:00 am |
Convertido a partir de las horas pico de la página de precios de DeepSeek. Los fines de semana y los festivos chinos son valle completo.
Conclusión práctica: un producto estadounidense cuyo tráfico sigue la jornada laboral de EE. UU. paga tarifa valle en casi todo. Las franjas caras caen en las noches y madrugadas de EE. UU., justo cuando muchos equipos programan trabajos por lotes. Mueve los cron nocturnos, evaluaciones y backfills al día o al fin de semana y costarán la mitad. Si tus usuarios están en Asia, ocurre lo contrario: 06:00–10:00 UTC es media tarde en Pekín y gran parte de tu tráfico diurno es pico.
Cómo funciona el descuento por caché
DeepSeek almacena en caché los prefijos de los prompts automáticamente; no hay que marcar nada. El objeto usage de la respuesta informa prompt_cache_hit_tokens y prompt_cache_miss_tokens, según la guía de caché de contexto. La guía añade que la caché es de mejor esfuerzo sin tasa de acierto garantizada, que construirla tarda segundos y que las cachés sin uso se eliminan en unas horas o unos días.
En Flash, un acierto cuesta $0.003 frente a $0.15 de un fallo en valle, un descuento del 98%. Eso convierte la estructura del prompt en la mayor palanca después de la elección de modelo:
- Mantén el prompt de sistema, los esquemas de herramientas y los documentos de referencia idénticos y al inicio de cada solicitud.
- Añade al final la parte específica del usuario.
- En chats multiturno, reenvía el historial completo en el mismo orden para que los turnos anteriores acierten en caché.
Para un método general de medir si la caché compensa, consulta nuestra guía de coste y ROI del prompt caching.
Tarifas de Search y Fetch
DeepSeek vende ahora APIs independientes de Search y Fetch a $0.75 por cada 1.000 solicitudes correctas cada una. La página de precios añade que las llamadas a herramientas del lado del servidor hechas mediante DeepSeek Harness, Claude Code o Codex ya usan estas APIs y por ahora son gratuitas; la facturación por solicitud empieza a las 00:00 hora de Pekín del 1 de noviembre de 2026 (16:00 UTC del 31 de octubre). Si usas DeepSeek dentro de un agente de programación, añade una partida para las búsquedas antes de esa fecha.
Ejemplo: coste mensual de la API de DeepSeek
Supongamos 100.000 solicitudes al mes, cada una con 2.000 tokens de entrada y 500 de salida: 200M de entrada y 50M de salida.
| Escenario | Coste de entrada | Coste de salida | Total mensual |
|---|---|---|---|
| Flash, valle, sin aciertos de caché | 200 x $0.15 = $30.00 | 50 x $0.60 = $30.00 | $60.00 |
| Flash, pico, sin aciertos de caché | 200 x $0.30 = $60.00 | 50 x $1.20 = $60.00 | $120.00 |
| Flash, valle, 70% aciertos de caché | 60 x $0.15 + 140 x $0.003 = $9.42 | $30.00 | $39.42 |
| V4 Pro, valle, sin aciertos de caché | 200 x $0.66 = $132.00 | 50 x $1.98 = $99.00 | $231.00 |
| V4 Pro, pico, sin aciertos de caché | 200 x $1.32 = $264.00 | 50 x $3.96 = $198.00 | $462.00 |
Calculado con las tarifas publicadas por DeepSeek, 21 de octubre de 2026.
Destacan dos patrones. Primero, la caché reduce la factura de Flash en aproximadamente un tercio aunque la salida no cambie, porque la entrada casi desaparece. Segundo, V4 Pro cuesta unas 4 veces Flash a la misma hora, así que enruta a Pro solo las solicitudes que fallan en Flash (razonamiento complejo, bucles largos de agentes). Nuestra comparativa DeepSeek V4 Pro vs Flash explica cuándo compensa.
Calculadora de costes de DeepSeek lista para copiar (según la hora)
La calculadora lee los campos de caché de una respuesta real y aplica la tarifa pico o valle según la hora UTC de la solicitud. No conoce los festivos chinos, así que esos días sobrestima.
# pip install openai
import os
from datetime import datetime, timezone
from openai import OpenAI

# DeepSeek rates per 1M tokens, Models & Pricing page, Oct 21, 2026 (off-peak; peak = 2x)
OFF_PEAK = {
    "deepseek-flash":  {"hit": 0.003, "miss": 0.15, "out": 0.60},
    "deepseek-v4-pro": {"hit": 0.022, "miss": 0.66, "out": 1.98},
}

def is_peak(ts: datetime) -> bool:
    ts = ts.astimezone(timezone.utc)
    if ts.weekday() >= 5:  # Saturday, Sunday
        return False
    return 1 <= ts.hour < 4 or 6 <= ts.hour < 10

def cost(model: str, usage, ts: datetime) -> float:
    r = OFF_PEAK[model]
    k = 2 if is_peak(ts) else 1
    return k * (usage.prompt_cache_hit_tokens * r["hit"]
                + usage.prompt_cache_miss_tokens * r["miss"]
                + usage.completion_tokens * r["out"]) / 1_000_000

client = OpenAI(api_key=os.environ["DEEPSEEK_API_KEY"], base_url="https://api.deepseek.com")
now = datetime.now(timezone.utc)
resp = client.chat.completions.create(
    model="deepseek-flash",
    messages=[{"role": "system", "content": "You are a concise SQL assistant."},
              {"role": "user", "content": "Count orders per day for the last 7 days."}],
)
print(resp.choices[0].message.content)
print(f"peak={is_peak(now)} cost=${cost('deepseek-flash', resp.usage, now):.6f}")
La misma solicitud con curl:
curl https://api.deepseek.com/chat/completions \
  -H "Authorization: Bearer $DEEPSEEK_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model":"deepseek-flash","messages":[{"role":"user","content":"Explain idempotency keys in one paragraph."}]}'
Y en Node.js:
import OpenAI from "openai";

const client = new OpenAI({ apiKey: process.env.DEEPSEEK_API_KEY, baseURL: "https://api.deepseek.com" });
const r = await client.chat.completions.create({
  model: "deepseek-v4-pro",
  messages: [{ role: "user", content: "Plan a zero-downtime Postgres migration." }],
});
console.log(r.choices[0].message.content);
console.log(r.usage.prompt_cache_hit_tokens, r.usage.prompt_cache_miss_tokens, r.usage.completion_tokens);
DeepSeek vs OpenAI, Claude y Gemini
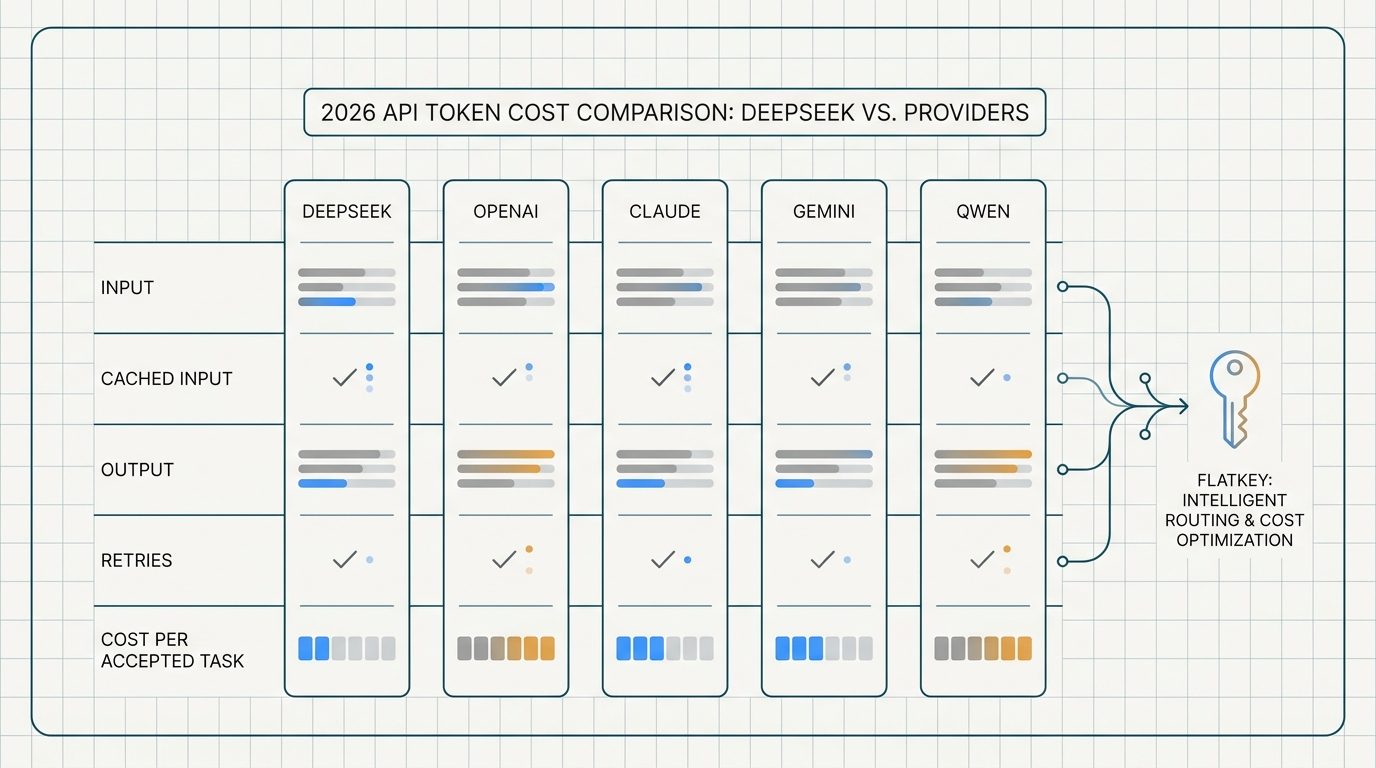
Misma carga que arriba (200M de entrada, 50M de salida, sin caché), con el precio de lista Standard oficial de cada proveedor el 21 de octubre de 2026:
| Modelo | Entrada / salida por 1M | Coste mensual |
|---|---|---|
| Gemini 2.5 Flash-Lite | $0.10 / $0.40 | $40.00 |
gpt-6-luna |
$0.10 / $0.50 | $45.00 |
| Claude Haiku 5.5 (prompts de hasta 100K) | $0.10 / $0.50 | $45.00 |
deepseek-flash, valle |
$0.15 / $0.60 | $60.00 |
deepseek-v4-pro, valle |
$0.66 / $1.98 | $231.00 |
| Gemini 3.8 Flash (promo 2026) | $0.75 / $3.75 | $337.50 |
gpt-6.1-sol |
$2.00 / $10.00 | $900.00 |
| Claude Sonnet 5.5 | $2.00 / $10.00 | $900.00 |
Fuentes: precios de OpenAI, precios de Anthropic, precios de Gemini.
Lectura honesta: a precio de lista, DeepSeek Flash ya no es el modelo económico más barato; Gemini 2.5 Flash-Lite, gpt-6-luna y Claude Haiku 5.5 lo superan ligeramente sin caché. DeepSeek gana cuando tu tráfico tiene altas tasas de acierto de caché (su precio de $0.003 es el más bajo de la tabla) y en la gama media, donde V4 Pro cuesta alrededor de una cuarta parte de gpt-6.1-sol o Sonnet 5.5. Compara la calidad en tus propias tareas antes de cambiar. Para una visión entre proveedores, consulta DeepSeek API vs Qwen API para flujos sensibles al coste y nuestra guía de precios de la API de OpenAI.
¿API de DeepSeek directa o un gateway?
El acceso directo te da las tarifas propias de DeepSeek, las novedades primero y el endpoint con formato Anthropic en https://api.deepseek.com/anthropic. Un gateway resulta útil cuando DeepSeek es uno de varios modelos de tu producto y quieres una clave, un saldo y failover si el límite de concurrencia de DeepSeek o una caída bloquean solicitudes.
El 21 de octubre de 2026, las páginas de modelos de Flatkey listaban deepseek-v4-1-flash desde $0.09 de entrada / $0.36 de salida por 1M tokens y deepseek-v4-pro desde $0.396 / $1.188, un 40% por debajo de los precios valle de DeepSeek. Flatkey también usa tarifas por franjas UTC, así que el precio "desde" es el tramo valle; consulta en la página del modelo el tramo que aplica a tu tráfico. Flatkey habla el formato OpenAI en https://router.flatkey.ai/v1 y el formato Anthropic, de modo que el código anterior funciona cambiando la URL base y la clave. Los detalles de configuración están en nuestra guía de acceso a la API de DeepSeek.
Checklist de precios de DeepSeek
- Usa
deepseek-flashcomo nombre de modelo; los nombres heredados de V4 Flash ya llegan a V4.1-Flash-1017. - Programa los lotes fuera de 01:00–04:00 y 06:00–10:00 UTC en días laborables.
- Registra
prompt_cache_hit_tokensyprompt_cache_miss_tokensy sigue la tasa de acierto. - Usa el modo sin razonamiento donde el razonamiento no aporte valor.
- Envía las imágenes a Flash; V4 Pro no admite visión.
- Presupuesta las llamadas a Search y Fetch desde el 1 de noviembre de 2026 si usas DeepSeek en agentes de programación.
- Revisa la página de precios cada mes; DeepSeek advierte que los precios pueden cambiar.
Preguntas frecuentes
¿Cuánto cuesta la API de DeepSeek por millón de tokens?
A 21 de octubre de 2026, deepseek-flash cuesta $0.15 por 1M de tokens de entrada (fallo de caché) y $0.60 por 1M de salida en valle, y deepseek-v4-pro cuesta $0.66 y $1.98. En pico se duplica, y la entrada con acierto de caché cuesta $0.003 (Flash) o $0.022 (V4 Pro) en valle, según la página oficial de precios.
¿Es gratis usar la API de DeepSeek?
No. DeepSeek cobra cada solicitud de tu saldo y la página de precios no lista nivel gratuito. Si tienes saldo regalado de una promoción, DeepSeek lo gasta antes que tu saldo recargado. Para opciones sin coste, consulta nuestra lista de APIs de LLM gratis.
¿Hay una clave de API de DeepSeek gratis?
Puedes crear una clave de API gratis en la plataforma de DeepSeek, pero las solicitudes siguen necesitando saldo. Los sitios de terceros que ofrecen "claves gratis de DeepSeek" revenden claves compartidas o dan sus propios créditos de prueba; evita enviar datos privados a través de ellos.
¿Cuándo son las horas pico de DeepSeek?
De 01:00 a 04:00 y de 06:00 a 10:00 UTC, de lunes a viernes, excepto festivos chinos. En hora del Este de EE. UU. antes del 1 de noviembre de 2026 equivale a 9 pm a medianoche y 2 am a 6 am; los fines de semana son valle.
¿Por qué varía el coste de DeepSeek entre solicitudes idénticas?
Por tres motivos: la hora del día (el pico duplica el precio), la tasa de acierto de caché (un acierto cuesta un 98% menos en Flash) y los tokens de razonamiento, que se facturan como salida. Registra los tres por solicitud para explicar tu factura.
¿DeepSeek es más barato que OpenAI?
En la gama media, sí: deepseek-v4-pro en valle cuesta $0.66/$1.98 por 1M tokens frente a $2/$10 de gpt-6.1-sol. En la gama económica, gpt-6-luna ($0.10/$0.50) es algo más barato que deepseek-flash en valle ($0.15/$0.60), salvo que tu tasa de acierto de caché sea alta.
Fuentes
- DeepSeek Modelos y precios, consultado el 21 de octubre de 2026
- Guía de caché de contexto de DeepSeek, consultada el 21 de octubre de 2026
- Guía del modo thinking de DeepSeek, consultada el 21 de octubre de 2026
- Precios de OpenAI, precios de Anthropic, precios de Gemini, consultados el 21 de octubre de 2026
- Precios de Flatkey del directorio de modelos de Flatkey, consultado el 21 de octubre de 2026