SGLang Prefill-Decode-Disaggregation: Architektur- und Bereitstellungsleitfaden
Zuletzt überprüft: 16. Oktober 2026. SGLang-Flags und unterstützte Funktionskombinationen ändern sich schnell; pinnen Sie ein getestetes SGLang-Image oder einen Commit, bevor Sie diesen Leitfaden in der Produktion anwenden.
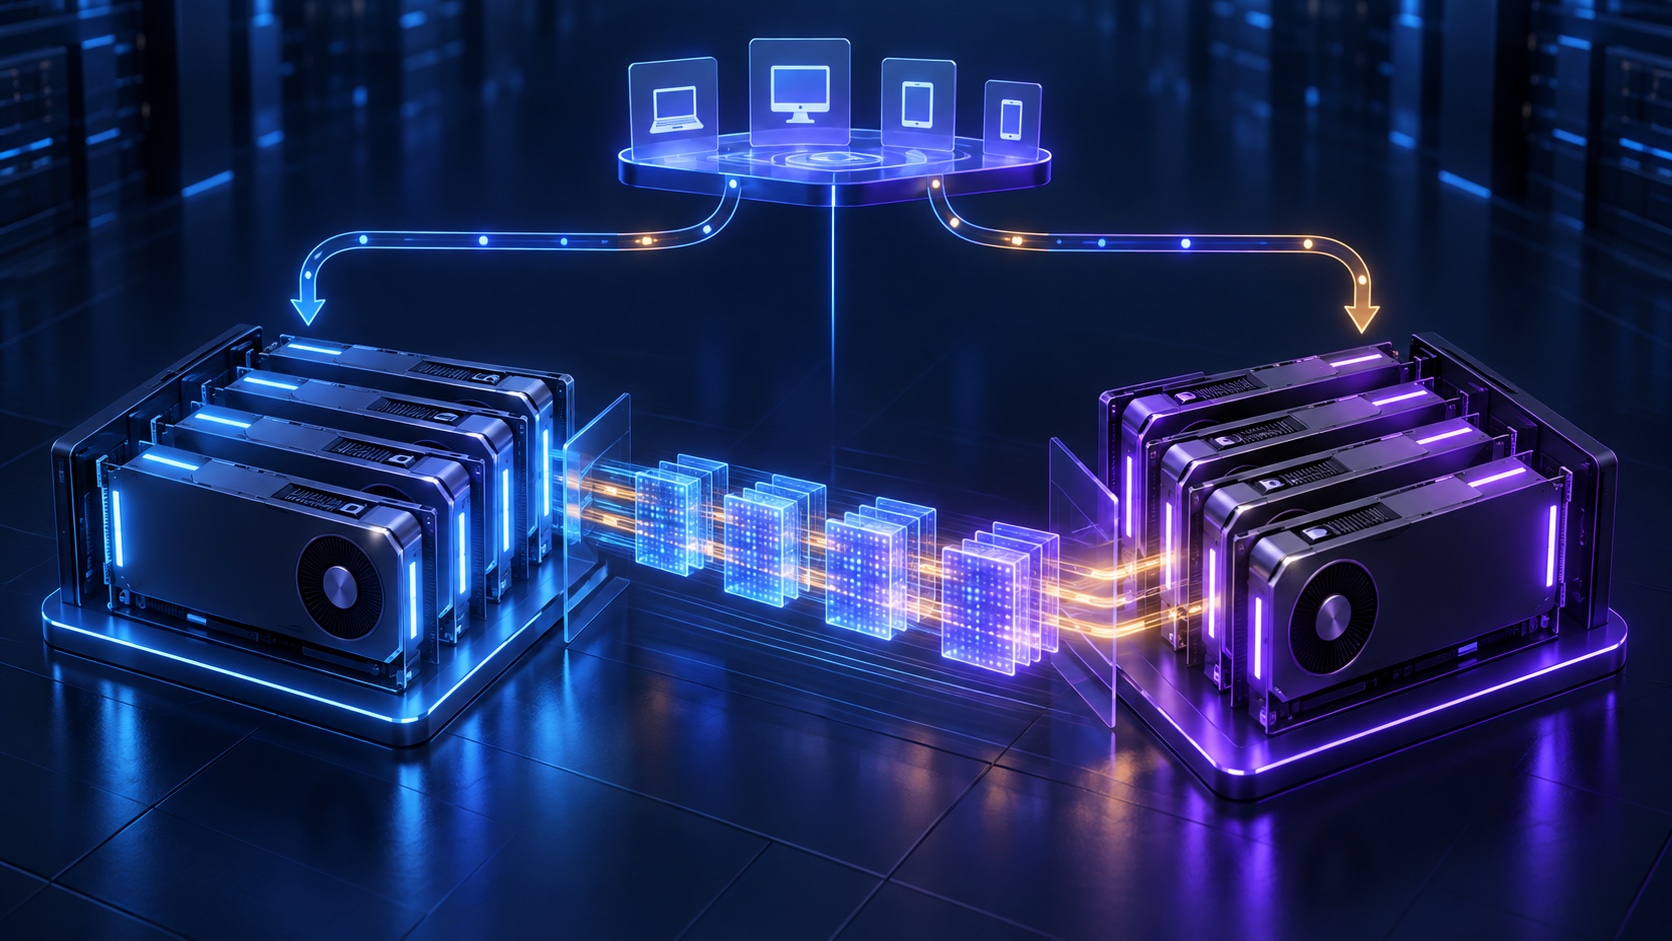
SGLang Prefill-Decode-Disaggregation trennt die zwei sehr unterschiedlichen Aufgaben innerhalb der LLM-Bereitstellung: Die Prompt-Verarbeitung läuft auf einem Prefill-Pool, während die Token-Generierung auf einem Decode-Pool läuft. Die Pools tauschen den KV-Cache der Anfrage aus, und ein Router stellt dem Client einen einzigen Inferenzendpunkt bereit.
Diese Trennung kann die Inter-Token-Latenz schützen, wenn lange Prompts eintreffen, und ermöglicht es Ihnen, rechenintensive Prefill-Kapazität anders zu skalieren als speichergebundene Decode-Kapazität. Sie fügt jedoch auch einen Übertragungspfad, eine weitere Scheduler-Grenze und eine größere Kompatibilitätsfläche hinzu. Betrachten Sie sie als gemessene Serving-Architektur – nicht als Schalter, der jede Arbeitslast automatisch beschleunigt.
Dieser Leitfaden erläutert die SGLang-Architektur für Prefill-Decode-Disaggregation, eine minimale Bereitstellungstopologie, die zu messenden Werte und die Bedingungen, die einen Rollout stoppen sollten.
Die Kurzantwort: Wann PD-Disaggregation ihre Komplexität rechtfertigt
Die Upstream-Dokumentation von SGLang beschreibt Prefill als rechenintensiv und Decode als KV-Cache- und speicherintensiv. In einem einheitlichen Scheduler kann eingehende Prefill-Arbeit Decode-Arbeit unterbrechen; bei datenparalleler Attention können verschiedene Worker zudem zwischen den beiden Phasen unausgewogen belastet sein. PD-Disaggregation trennt diese Phasen, sodass jede unabhängig geplant und bereitgestellt werden kann. Die PD-Dokumentation von SGLang ist die maßgebliche Quelle für die aktuell unterstützten Kombinationen.
| Signal der Arbeitslast | Ist SGLang Prefill-Decode-Disaggregation ein guter Kandidat? | Warum |
|---|---|---|
| Lange oder stark variable Prompts, bei denen Nutzern eine gleichmäßige Streaming-Ausgabe wichtig ist | Oft | Lange Prefills unterbrechen mit geringerer Wahrscheinlichkeit einen aktiven Decode-Pool. |
| Der Speicherbedarf beim Decode unterscheidet sich wesentlich vom Rechenbedarf der Prompts | Oft | Sie können Pools und Parallelitätslimits anhand ihres tatsächlichen Engpasses dimensionieren. |
| Eine Multi-Node-GPU-Bereitstellung verfügt bereits über ein validiertes KV-Transfer-Fabric mit geringer Latenz | Oft | Die zusätzliche Übertragungsgrenze ist betrieblich realistisch. |
| Ein einzelner kleiner GPU-Server, kurze einheitliche Prompts oder geringer Traffic | In der Regel nicht zuerst | Ein einheitlicher Server ist einfacher und kann Übertragungs-Overhead vermeiden. |
| Eine Arbeitslast, die von prozesslokalem Antwortverlauf oder integrierten Server-Tools abhängt | Nein, bis zur Validierung | Die aktuelle Upstream-PD-Dokumentation führt zustandsbehaftete Response-API-Workflows und integrierte Tools als nicht unterstützte Workflows auf. |
Die Entscheidung lautet nicht „Prefill schnell, Decode langsam“. Entscheidend ist, ob die Isolierung ihrer Warteschlangen und Hardwaregrenzen das für Sie relevante nutzersichtbare Ziel verbessert – üblicherweise Time to First Token (TTFT), Inter-Token-Latenz (ITL), Tail-Latenz oder abgeschlossene Anfragen bei einem festen Kapazitätsbudget.
So funktioniert Prefill-Decode-Disaggregation in SGLang
Die SGLang-PD-Topologie hat drei logische Rollen:
- Router: empfängt die Client-Anfrage, wählt einen Prefill- und Decode-Pfad aus und streamt die zusammengeführte Antwort zurück an den Client.
- Prefill-Worker: tokenisieren und verarbeiten den vollständigen Prompt und erzeugen dann den KV-Cache-Zustand, der für die Fortsetzung der Generierung erforderlich ist.
- Decode-Worker: empfangen diesen KV-Zustand und generieren Ausgabe-Tokens, bis die Anfrage abgeschlossen ist.
Die Übergabe ist der wichtige Teil. Der Prefill-Worker sendet keinen Text an einen neuen Decoder, damit dieser den Prompt wiederholt. Er überträgt den KV-Cache-Zustand, sodass Decode im selben Attention-Kontext fortfahren kann. SGLang dokumentiert derzeit Mooncake und NIXL als PD-Transfer-Engines; wählen Sie den Transport- und Netzwerkpfad, den Ihre gepinnte Version und Hardware tatsächlich unterstützen.
client
  │
  ▼
PD router ──► prefill pool ──► KV-cache transfer ──► decode pool ──► streamed tokens
                 compute-heavy          fabric            memory-sensitive
In einem Multi-Node-Cluster kann jede Rolle eine eigene Replikatanzahl, GPU-Konfiguration, Warteschlangenbegrenzung, Autoscaling-Richtlinie und ein eigenes Fehlerbudget haben. Das ist nur nützlich, wenn Router und KV-Transfer-Fabric als Produktionsabhängigkeiten und nicht als unsichtbarer Klebstoff behandelt werden.
Vor der Bereitstellung: Die fünf Prüfungen, die irreführende Ergebnisse verhindern
1. Pinnen Sie das genaue SGLang-Release und die Modellkonfiguration
Verwenden Sie für Router, Prefill-Worker und Decode-Worker dasselbe getestete SGLang-Image oder denselben Commit. Halten Sie Modellrevision, Tokenizer, Quantisierung, Attention-Backend, Parallelisierungsstrategie und modellspezifische Flags in Ihren Manifests explizit fest. Ein Befehl, der mit einer Version funktioniert hat, kann in einer anderen ungültig sein oder eine andere Semantik haben.
2. Validieren Sie den KV-Transfer-Pfad, bevor Sie den Traffic skalieren
PD ist eine Data-Plane-Architektur. Validieren Sie die NIC- oder Interconnect-Zuordnung, die Gerätebereitstellung im Container, Host-Limits und das Transfer-Backend, bevor Sie die Modelllatenz interpretieren. Mooncake-spezifische Bereitstellungen können eine InfiniBand/RDMA-Konfiguration erfordern; die SGLang-Dokumentation beschreibt außerdem die Auswahl des NIXL-Backends für kompatible Infrastruktur. Schließen Sie nicht daraus, dass ein schneller Pfad für kollektive Kommunikation automatisch einen funktionierenden KV-Transferpfad belegt.
3. Eine Baseline für einen einheitlichen Server erstellen
Verwenden Sie für die Baseline und den PD-Test dasselbe Modell, dieselben Prompts, Generierungslängen, Parallelitätsmischung, Sampling-Einstellungen und dasselbe Hardwarebudget. Messen Sie mindestens p50/p95 TTFT, p50/p95 ITL, Request-Durchsatz, Abbruchverhalten und Fehlerrate. Eine höhere GPU-Auslastung allein ist kein Serving-Ergebnis.
4. Die Rollengrenze in Ihrem Scheduler definieren
Halten Sie Prefill- und Decode-Pods, -Services, -Logs und -Warnungen separat adressierbar. Wenn Sie nicht erkennen können, welche Rolle eine Warteschlange bildet, keine KV-Kapazität mehr hat oder auf die Übertragung wartet, wird die Architektur schwieriger zu betreiben sein als eine einheitliche Flotte.
5. Die aktuellen Kompatibilitätseinschränkungen lesen – nicht nur den Schnellstartblock
Die SGLang-Dokumentation zur Prefill-Decode-Disaggregation enthält Einschränkungen für bestimmte Richtlinien und zustandsbehaftete Workflows. Beispielsweise hat die dokumentierte Decode-Zuweisungsrichtlinie prefill_complete einen engeren Unterstützungsumfang als die Standardrichtlinie. Validieren Sie jede erweiterte Funktionskombination in einem Staging-Lauf, bevor Sie sie zu einem Teil einer Verfügbarkeitszusage machen.
Eine minimale Bereitstellung der SGLang Prefill-Decode-Disaggregation
Beginnen Sie mit einem Prefill-Worker, einem Decode-Worker und einem Router auf einem Host mit zwei GPUs. Dies ist ein funktionaler Abnahmetest und keine Behauptung, dass zwei GPUs eine Produktionskonfiguration darstellen. Das folgende NIXL-Beispiel folgt dem aktuellen Upstream-Muster für einen einzelnen Node; verwenden Sie die exakte Befehlssyntax aus der Dokumentation für Ihre festgelegte SGLang-Version.
# GPU 0: Prefill-Rolle
python -m sglang.launch_server \
  --model-path meta-llama/Llama-3.1-8B-Instruct \
  --disaggregation-mode prefill \
  --disaggregation-transfer-backend nixl \
  --port 30000

# GPU 1: Decode-Rolle
python -m sglang.launch_server \
  --model-path meta-llama/Llama-3.1-8B-Instruct \
  --disaggregation-mode decode \
  --disaggregation-transfer-backend nixl \
  --base-gpu-id 1 \
  --port 30001

# Client-seitiger PD-Router
python -m sglang_router.launch_router \
  --pd-disaggregation \
  --prefill http://127.0.0.1:30000 \
  --decode http://127.0.0.1:30001 \
  --host 0.0.0.0 \
  --port 8000
Senden Sie eine kurze Anfrage über den Router und nicht direkt an einen der beiden Worker:
curl http://127.0.0.1:8000/v1/completions \
  -H 'Content-Type: application/json' \
  -d '{
    "model": "meta-llama/Llama-3.1-8B-Instruct",
    "prompt": "Explain why KV-cache handoff matters in one sentence.",
    "max_tokens": 64
  }'
Erfolg bedeutet mehr als nur Text zu erhalten. Bestätigen Sie, dass der Router beide Rollen ausgewählt hat, die KV-Übertragung abgeschlossen wurde, das Streaming-Verhalten intakt ist und jeder Prozess die erwarteten Modell- und Kompatibilitätseinstellungen meldet. Behalten Sie diese kleine SGLang Prefill-Decode-Disaggregation-Bereitstellung in CI oder einer Vorproduktionsumgebung bei, damit ein Upgrade nicht unbemerkt den PD-Pfad beschädigt.
Verwenden Sie für eine Mooncake-Bereitstellung den aktuellen SGLang-PD-Leitfaden für die erforderliche Installation der Transfer-Engine und die Konfiguration des IB-Geräts. Kopieren Sie Mooncake-Umgebungsvariablen nicht aus einem anderen Transport, einer anderen Cloud oder einem anderen SGLang-Release.
Von einem Paar zu einer Produktionstopologie wechseln
Wenn das grundlegende Paar fehlerfrei funktioniert, skalieren Sie jede Rolle auf Grundlage von Warteschlangen- und Ressourcendaten statt eines angenommenen 1:1-Verhältnisses.
| Ebene | Skalierung anhand dieser Beobachtung | Praktische Steuerung |
|---|---|---|
| Prefill-Pool | Die Prompt-Warteschlange wächst, die Prefill-Berechnung sättigt sich oder die TTFT-Tails steigen | Fügen Sie Prefill-Replikate hinzu oder ändern Sie nach einem kontrollierten Test die Prefill-GPU-Konfiguration. |
| Decode-Pool | Aktive Sequenzen erschöpfen die KV-Kapazität, die ITL-Tails steigen oder die Decode-Zulassung wartet | Fügen Sie Decode-Replikate hinzu, verringern Sie die Parallelität oder erhöhen Sie den Speicher pro Worker erst, nachdem Sie den Modell-Footprint validiert haben. |
| KV-Transfer-Fabric | Übertragungszeit oder Übertragungsfehler dominieren die Request-Zeitachse | Validieren Sie Gerätezuordnung, Backend, Fabric-Zustand und Topologielokalität, bevor Sie Modellreplikate hinzufügen. |
| Router | Fluktuation nicht fehlerfreier Worker, ungleichmäßige Warteschlangen oder Routing-Verzögerungen treten auf | Verwenden Sie eine Produktionstopologie und Richtlinie für Router, die von Ihrem SGLang-Release unterstützt werden. |
Für Multi-Node-Muster veröffentlicht SGLang separate Startbeispiele für Prefill und Decode für Bereitstellungen der DeepSeek-Klasse, einschließlich rollenspezifischer Argumente für verteilte Initialisierung und Parallelität. Diese Beispiele sind eine nützliche Vorlage, doch Modell, Hardware und SGLang-Version benötigen weiterhin jeweils einen eigenen Abnahmetest. Lesen Sie die Upstream-PD-Beispiele für mehrere Nodes, bevor Sie ein Cluster-Manifest anpassen.
Wenn Kubernetes den Lebenszyklus verwaltet, geben Sie Prefill und Decode separate Labels, Services, Disruption Budgets, Dashboards und Readiness-Probes. Die übergeordneten Cluster-Voraussetzungen – GPU-Bereitstellung, Queuing, Speicher, Netzwerk und Observability – werden in unserem Leitfaden für Kubernetes-GPU-Cluster behandelt.
Metriken für die SGLang-Prefill-Decode-Disaggregation
SGLang prefill decode disaggregation sollte ein ausgewähltes Workload-Ergebnis verbessern und nicht lediglich ein anderes Ressourcendiagramm erzeugen. Instrumentieren Sie die Request-Zeitleiste mit separaten Intervallen für Prefill, Transfer, Decode-Zulassung und Generierung.
| Metrik | Was sie aufzeigt | Zusammen betrachten mit |
|---|---|---|
| TTFT, p50 und p95 | Prompt-Queuing sowie Prefill-Ausführung und Übergabe | Prompt-Längen-Buckets und Prefill-Queue-Tiefe |
| ITL, p50 und p95 | Token-Taktung nach Beginn der Generierung | Aktive Decode-Sequenzen und Decode-KV-Belegung |
| KV-Transfer-Dauer und Fehler | Ob die Übergabe ein Engpass oder eine Fehlerquelle ist | Fabric-Durchsatz, Wiederholungsversuche, NIC-Zustand und Backend-Logs |
| Alter der Prefill-/Decode-Queue | Ob das Pool-Verhältnis falsch ist | Rollenspezifische Replikate und Parallelitätslimits |
| Abgeschlossene Requests pro Sekunde | Nutzbare Kapazität unter dem tatsächlichen Mix | Fehlerrate, Abbruchrate und Latenz-SLOs |
| GPU-Compute-, HBM- und Host-CPU-Auslastung | Unterstützende Diagnose, nicht das Ergebnis | Die vier oben genannten Zeitmessungen der Request-Phasen |
Führen Sie zwei Testsets aus. Eines sollte den Traffic-Mix verwenden, den Sie heute erwarten; das andere sollte gezielt lange Prompts, variable Generierungslängen, Abbrüche und Bursts enthalten. PD kann bei einem durchschnittlichen synthetischen Prompt hervorragend aussehen, während es seinen eigentlichen Zweck unter einem verzerrten Produktionsmix verfehlt.
Decode-Allokierungsrichtlinie: eine gezielte Steuerung, kein Standard-Tuning-Trick
Standardmäßig dokumentiert SGLang ein early-Verhalten bei der Decode-Allokierung: Ziel-KV-Slots werden reserviert, bevor Prefill abgeschlossen ist. Lange Prefills können dadurch Decode-Kapazität belegen, während die Decode-Seite auf KV-Daten wartet.
Die dokumentierte Alternative lautet:
--disaggregation-decode-allocation-policy prefill_complete
Mit prefill_complete verzögert SGLang die Zielallokierung, bis Prefill bereit ist. Das kann helfen, wenn lange Prompts mit aktivem Decode-Traffic um Ziel-KV-Kapazität konkurrieren, verändert aber auch die Überlappung und den Supportumfang. Die Upstream-Dokumentation besagt, dass die Richtlinie sowohl für Prefill als auch für Decode gesetzt werden muss, und führt mehrere inkompatible Kombinationen auf. Behandeln Sie dies als kontrolliertes Experiment mit Rollback-Kriterien, nicht als universelle Optimierung.
Häufige Fehlermodi und die schnellste nächste Prüfung
| Symptom | Wahrscheinliche zu prüfende Grenze | Schnellste nächste Prüfung |
|---|---|---|
| Der Router akzeptiert Requests, aber es werden keine Tokens zurückgegeben | Worker-Erreichbarkeit oder eine fehlgeschlagene Rollenübergabe | Prüfen Sie Router-Logs, Worker-Zustand und einen Trace, der Prefill bis Decode abdeckt. |
| Die Decode-Wartezeit steigt, während Prefill gesund ist | Decode-Zulassung oder Druck auf Ziel-KV | Prüfen Sie aktive Sequenzen, KV-Belegung und die Allokierungsrichtlinie, bevor Sie willkürlich Prefill-Kapazität hinzufügen. |
| TTFT verbessert sich, aber ITL verschlechtert sich | Engpass im Decode-Pool oder beim KV-Transfer | Vergleichen Sie Decode-Queue-Alter, Transferdauer und Anzahl aktiver Sequenzen mit der einheitlichen Baseline. |
| Multi-Node-Traffic hängt intermittierend oder versucht es erneut | Netzwerk-Fabric, Gerätemapping oder inkonsistente Worker-Konfiguration | Verifizieren Sie auf jedem Node den exakten SGLang-Build, das Transfer-Backend, das NIC-Mapping und die Rollenmanifeste. |
| Eine erweiterte Funktion funktioniert im einheitlichen Modus, schlägt aber bei PD fehl | Nicht unterstützte Funktionskombination | Lesen Sie den aktuellen Abschnitt zur PD-Kompatibilität und reproduzieren Sie das Problem mit der kleinsten unterstützten Topologie. |
| Die GPU-Auslastung steigt, aber die Nutzerlatenz verbessert sich nicht | Die Optimierung zielte auf die falsche Phase | Kehren Sie zu TTFT, ITL, Queue-Alter, Fehlern und Durchsatz abgeschlossener Arbeit zurück. |
Der Rollout von SGLang prefill decode disaggregation sollte reversibel sein. Behalten Sie eine einheitliche Serving-Route oder eine bekanntermaßen funktionierende Deployment-Revision bei, bis die PD-Konfiguration ihre definierten Latenz- und Zuverlässigkeitsschwellen über den relevanten Workload-Mix hinweg erfüllt.
Eine sichere Rollout-Sequenz
- Baseline: Erfassen Sie einen Unified-SGLang-Benchmark mit produktionsähnlichen Prompts, Ausgaben, Parallelität und Fehlerfällen.
- Ein Paar: Starten Sie einen Prefill-Worker, einen Decode-Worker und einen Router; bestehen Sie Funktions-, Streaming-, Abbruch- und Neustartprüfungen.
- Rollensichtbarkeit: Teilen Sie Logs, Dashboards, Alerts und Kapazitätslimits nach Router, Prefill, Transfer und Decode auf.
- Kontrollierte Last: Vergleichen Sie PD mit der Baseline nach Prompt-Längen- und Ausgabelängen-Bucket, nicht nur anhand eines Durchschnitts.
- Jeweils eine Einschränkung skalieren: Passen Sie Pool-Größe, GPU-Form, Parallelität oder Transferkonfiguration in getrennten Experimenten an.
- Canary und Rollback: Leiten Sie einen begrenzten Teil des Traffics weiter, definieren Sie eine Rollback-Schwelle für Latenz und Fehler und bewahren Sie die letzte fehlerfreie Konfiguration auf.
Diese Abfolge macht aus SGLang PD disaggregation prefill decode ein operativ testbares Change-Vorhaben statt eines vielversprechenden Architekturdiagramms.
Häufig gestellte Fragen
Erhöht die PD-Disaggregation immer den Durchsatz?
Nein. Sie kann einen Workload verbessern, bei dem die Konkurrenz zwischen Prefill und Decode den Engpass darstellt, führt jedoch auch KV-Transfer, Router-Scheduling und operativen Overhead ein. Testen Sie sie im Vergleich zu einer einheitlichen Baseline mit demselben Traffic-Mix und Kapazitätsbudget.
Läuft Prefill auf einem anderen Modell als Decode?
Nein. Die Rollen setzen eine logische Anfrage fort. Halten Sie das getestete Modell, den Tokenizer, die Revision, die Quantisierung und die Serving-Konfiguration im Paar aufeinander abgestimmt, sofern die Upstream-Dokumentation nicht ausdrücklich eine andere Anordnung unterstützt.
Welches Transfer-Backend sollte ich verwenden?
Verwenden Sie ein Backend, das von Ihrer festgelegten SGLang-Version unterstützt wird und für Ihre tatsächliche Fabric validiert ist. Die aktuelle SGLang-Dokumentation beschreibt Mooncake und NIXL, aber die richtige Wahl hängt von der Plattform, dem Container-Image, den Geräten und dem von Ihnen verifizierten operativen Support ab.
Kann ich die SGLang-Prefill-Decode-Disaggregation mit jeder erweiterten Funktion kombinieren?
Nein. Die PD-Unterstützung ist funktions- und versionsabhängig. Prüfen Sie die aktuellen Upstream-Kompatibilitätshinweise, bevor Sie sie mit zustandsbehafteten Antworten, Tool-Ausführung, Cache-Funktionen, Spekulationsmodi oder nicht standardisiertem Rollenverhalten kombinieren.
Der praktische nächste Schritt
Beginnen Sie mit einer Abnahmeumgebung mit einem Paar, dokumentieren Sie die TTFT-/ITL-/Fehlerschwellenwerte, die die Architektur rechtfertigen, und führen Sie die Lösung erst hoch, wenn die Transfer- und Fehlerpfade beobachtbar sind. Vergleichen Sie für angrenzende Serving-Entscheidungen vLLM mit SGLang, lesen Sie den Leitfaden zu spekulativem Decoding für LLM-Inferenz und planen Sie den zugrunde liegenden Kubernetes-GPU-Cluster getrennt vom PD-Rollout.