
Disagregasi Prefill Decode SGLang: Panduan Arsitektur dan Deployment
Terakhir diverifikasi: 16 Oktober 2026. Flag SGLang dan kombinasi fitur yang didukung berubah dengan cepat; gunakan image atau commit SGLang yang telah diuji sebelum menerapkan panduan ini di produksi.
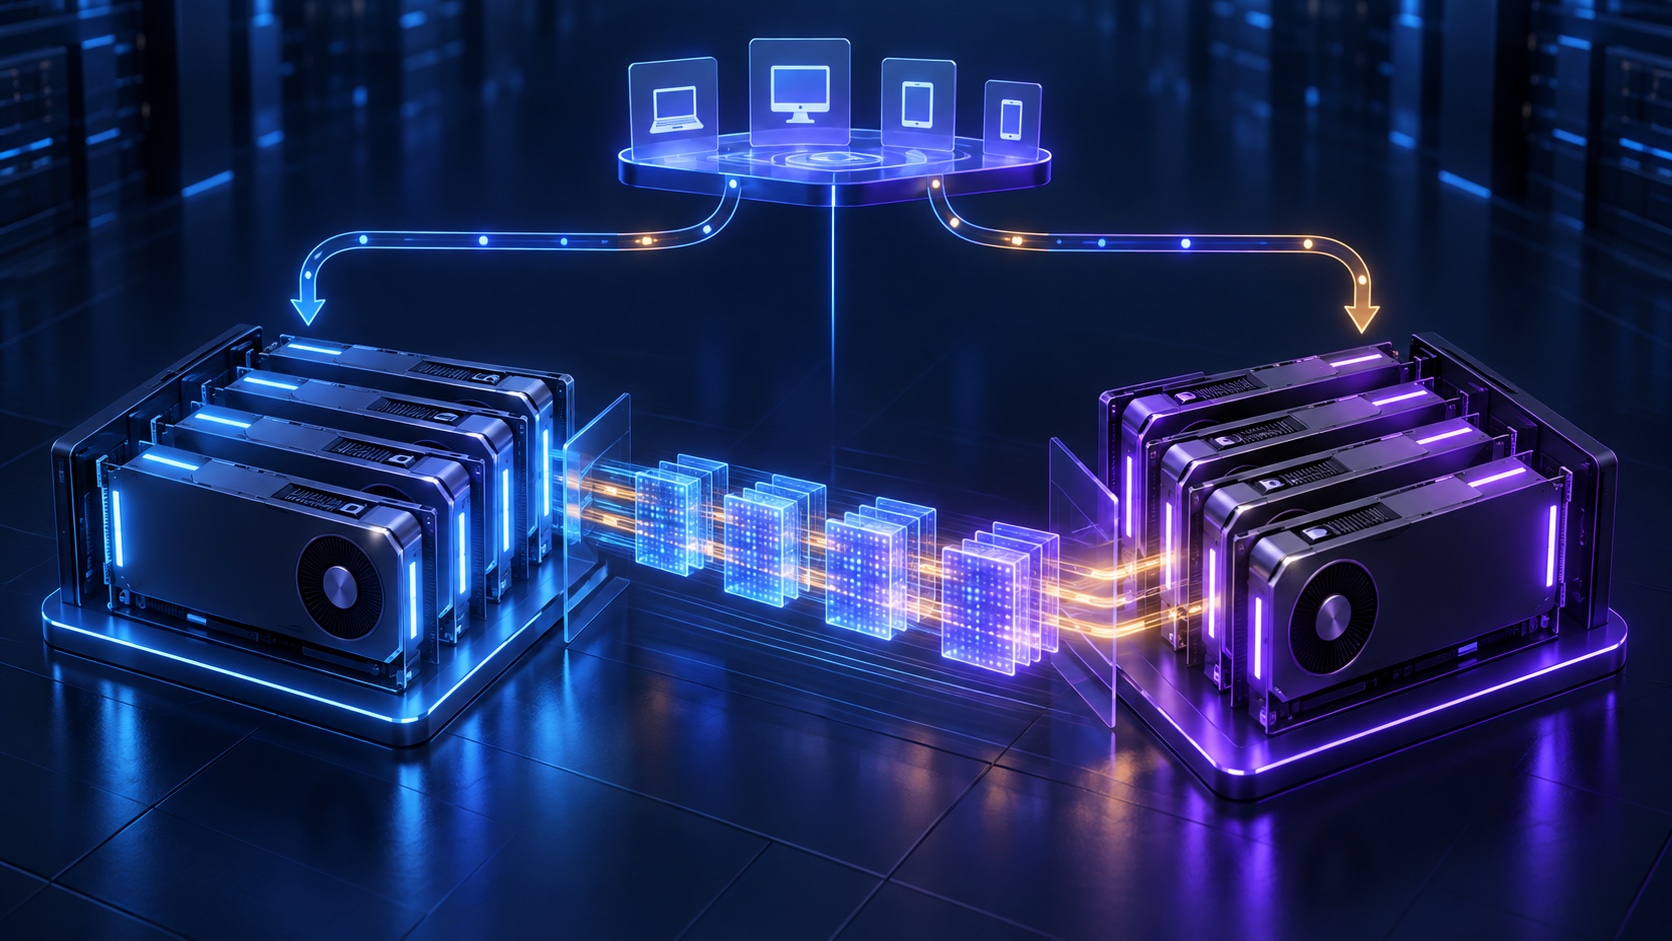
Disagregasi prefill decode SGLang memisahkan dua pekerjaan yang sangat berbeda dalam serving LLM: pemrosesan prompt berjalan pada pool prefill, sedangkan pembuatan token berjalan pada pool decode. Pool tersebut bertukar cache KV permintaan, dan router menyajikan satu endpoint inferensi kepada klien.
Pemisahan tersebut dapat melindungi latensi antar-token ketika prompt panjang masuk, serta memungkinkan Anda menskalakan kapasitas prefill yang berat komputasi secara berbeda dari kapasitas decode yang dibatasi memori. Namun, pemisahan ini juga menambahkan jalur transfer, batas scheduler tambahan, dan permukaan kompatibilitas yang lebih luas. Perlakukan ini sebagai arsitektur serving yang terukur—bukan sebagai sakelar yang otomatis membuat setiap workload lebih cepat.
Panduan ini menjelaskan arsitektur disagregasi prefill decode SGLang, bentuk deployment minimal, hal yang perlu diukur, serta kondisi yang seharusnya menghentikan rollout.
Jawaban singkat: kapan disagregasi PD sepadan dengan kompleksitasnya
Dokumentasi upstream SGLang menjelaskan prefill sebagai intensif komputasi dan decode sebagai intensif cache KV serta memori. Dalam scheduler terpadu, pekerjaan prefill yang masuk dapat menginterupsi pekerjaan decode; dengan attention data-paralel, worker yang berbeda juga dapat menjadi tidak seimbang di antara kedua fase tersebut. Disagregasi PD memisahkan fase-fase itu sehingga masing-masing dapat dijadwalkan dan diprovisikan secara independen. Dokumentasi PD SGLang adalah sumber kebenaran untuk kombinasi yang saat ini didukung.
| Sinyal workload | Apakah disagregasi prefill decode SGLang merupakan kandidat yang baik? | Mengapa |
|---|---|---|
| Prompt panjang atau sangat bervariasi, dengan pengguna yang sensitif terhadap kelancaran streaming | Sering kali | Prefill panjang cenderung tidak menginterupsi pool decode yang aktif. |
| Tekanan memori decode sangat berbeda dari tekanan komputasi prompt | Sering kali | Anda dapat menentukan ukuran pool dan batas konkurensi berdasarkan bottleneck aktualnya. |
| Deployment GPU multi-node sudah memiliki fabric transfer KV berlatensi rendah yang tervalidasi | Sering kali | Batas transfer tambahan tersebut realistis secara operasional. |
| Satu server GPU kecil, prompt pendek yang seragam, atau traffic rendah | Biasanya bukan pilihan pertama | Server terpadu lebih sederhana dan dapat menghindari overhead transfer. |
| Workload yang bergantung pada riwayat respons lokal proses atau tool server bawaan | Tidak, hingga tervalidasi | Dokumentasi PD upstream saat ini mencantumkan workflow Response API stateful dan tool bawaan sebagai workflow yang tidak didukung. |
Keputusannya bukan “prefill cepat, decode lambat.” Pertanyaannya adalah apakah mengisolasi antrean dan batas hardware keduanya meningkatkan sasaran yang terlihat oleh pengguna dan Anda pedulikan—biasanya waktu hingga token pertama (TTFT), latensi antar-token (ITL), latensi ekor, atau permintaan yang selesai dalam anggaran kapasitas tetap.
Cara kerja disagregasi prefill decode di SGLang
Topologi PD SGLang memiliki tiga peran logis:
- Router: menerima permintaan klien, memilih jalur prefill dan decode, lalu melakukan streaming respons yang telah digabungkan kembali ke klien.
- Worker prefill: melakukan tokenisasi dan memproses prompt lengkap, lalu menghasilkan state cache KV yang diperlukan untuk melanjutkan pembuatan.
- Worker decode: menerima state KV tersebut dan menghasilkan token output hingga permintaan selesai.
Handoff adalah bagian pentingnya. Worker prefill tidak mengirim teks ke decoder baru dan membuatnya mengulangi prompt. Worker tersebut mentransfer state cache KV agar decode dapat melanjutkan dari konteks attention yang sama. SGLang saat ini mendokumentasikan Mooncake dan NIXL sebagai engine transfer PD; pilih transport dan jalur jaringan yang benar-benar didukung oleh versi dan hardware yang Anda pin.
klien
  │
  ▼
Router PD ──► pool prefill ──► transfer cache KV ──► pool decode ──► token yang di-stream
                 berat komputasi          fabric            sensitif terhadap memori
Dalam cluster multi-node, setiap peran dapat memiliki jumlah replika, konfigurasi GPU, batas antrean, kebijakan autoscaling, dan anggaran kegagalannya sendiri. Hal itu hanya berguna jika router dan fabric transfer KV diperlakukan sebagai dependensi produksi, bukan sebagai perekat yang tak terlihat.
Sebelum melakukan deployment: lima pemeriksaan yang mencegah hasil menyesatkan
1. Pin rilis SGLang dan konfigurasi model yang tepat
Jalankan image atau commit SGLang yang sama dan telah diuji pada router, worker prefill, dan worker decode. Cantumkan revisi model, tokenizer, kuantisasi, backend attention, strategi paralelisme, dan flag khusus model secara eksplisit dalam manifest Anda. Perintah yang berfungsi pada satu versi dapat tidak valid atau memiliki semantik berbeda pada versi lain.
2. Buktikan jalur transfer KV sebelum meningkatkan traffic
PD adalah arsitektur data-plane. Validasi pemetaan NIC atau interkoneksi, eksposur perangkat kontainer, batas host, dan backend transfer sebelum menafsirkan latensi model. Deployment khusus Mooncake dapat memerlukan konfigurasi InfiniBand/RDMA; dokumentasi SGLang juga mendokumentasikan pemilihan backend NIXL untuk infrastruktur yang kompatibel. Jangan menyimpulkan bahwa jalur komunikasi kolektif yang cepat secara otomatis membuktikan jalur transfer KV yang sehat.
3. Tetapkan baseline server terpadu
Gunakan model, prompt, panjang generasi, campuran konkurensi, pengaturan sampling, dan anggaran perangkat keras yang sama untuk baseline dan pengujian PD. Ukur setidaknya TTFT p50/p95, ITL p50/p95, throughput permintaan, perilaku pembatalan, dan tingkat kesalahan. Angka utilisasi GPU yang lebih tinggi saja bukanlah hasil serving.
4. Tentukan batas peran dalam scheduler Anda
Pertahankan agar pod, layanan, log, dan peringatan prefill serta decode dapat dialamatkan secara terpisah. Jika Anda tidak dapat mengetahui peran mana yang sedang mengantre, kehabisan kapasitas KV, atau menunggu transfer, arsitektur tersebut akan lebih sulit dioperasikan daripada fleet terpadu.
5. Baca batasan kompatibilitas saat ini—bukan hanya blok quick-start
Dokumentasi disagregasi prefill decode SGLang mencakup pembatasan untuk kebijakan tertentu dan alur kerja stateful. Misalnya, kebijakan alokasi decode prefill_complete yang didokumentasikan memiliki cakupan dukungan yang lebih sempit daripada kebijakan default. Validasi setiap kombinasi fitur lanjutan dalam pengujian staging sebelum menjadikannya bagian dari janji ketersediaan.
Deployment disagregasi prefill decode SGLang minimal
Mulailah dengan satu worker prefill, satu worker decode, dan satu router pada host dua GPU. Ini adalah pengujian penerimaan fungsional, bukan klaim bahwa dua GPU merupakan konfigurasi produksi. Contoh NIXL berikut mengikuti pola single-node upstream saat ini; gunakan sintaks perintah yang tepat dari dokumentasi untuk versi SGLang yang Anda pin.
# GPU 0: prefill role
python -m sglang.launch_server \
  --model-path meta-llama/Llama-3.1-8B-Instruct \
  --disaggregation-mode prefill \
  --disaggregation-transfer-backend nixl \
  --port 30000

# GPU 1: decode role
python -m sglang.launch_server \
  --model-path meta-llama/Llama-3.1-8B-Instruct \
  --disaggregation-mode decode \
  --disaggregation-transfer-backend nixl \
  --base-gpu-id 1 \
  --port 30001

# Client-facing PD router
python -m sglang_router.launch_router \
  --pd-disaggregation \
  --prefill http://127.0.0.1:30000 \
  --decode http://127.0.0.1:30001 \
  --host 0.0.0.0 \
  --port 8000
Kirim permintaan singkat melalui router, bukan langsung ke salah satu worker:
curl http://127.0.0.1:8000/v1/completions \
  -H 'Content-Type: application/json' \
  -d '{
    "model": "meta-llama/Llama-3.1-8B-Instruct",
    "prompt": "Explain why KV-cache handoff matters in one sentence.",
    "max_tokens": 64
  }'
Keberhasilan berarti lebih dari sekadar menerima teks. Konfirmasikan bahwa router memilih kedua peran, transfer KV selesai, perilaku streaming tetap utuh, dan setiap proses melaporkan pengaturan model dan kompatibilitas yang diharapkan. Simpan deployment disagregasi prefill decode SGLang kecil ini dalam CI atau lingkungan praproduksi agar upgrade tidak secara diam-diam merusak jalur PD.
Untuk deployment Mooncake, gunakan panduan PD SGLang terkini untuk instalasi transfer-engine dan konfigurasi perangkat IB yang diperlukan. Jangan menyalin variabel lingkungan Mooncake dari transport, cloud, atau rilis SGLang yang berbeda.
Beralih dari satu pasangan ke topologi produksi
Ketika pasangan dasar sudah sehat, skalakan setiap peran berdasarkan data antrean dan sumber daya, bukan rasio 1:1 yang diasumsikan.
| Lapisan | Skalakan berdasarkan observasi ini | Kontrol praktis |
|---|---|---|
| Pool prefill | Antrean prompt bertambah, komputasi prefill jenuh, atau tail TTFT meningkat | Tambahkan replika prefill atau ubah konfigurasi GPU prefill setelah pengujian terkontrol. |
| Pool decode | Urutan aktif menghabiskan kapasitas KV, tail ITL meningkat, atau penerimaan decode menunggu | Tambahkan replika decode, turunkan konkurensi, atau tingkatkan memori per worker hanya setelah memvalidasi jejak model. |
| Fabric transfer KV | Waktu transfer atau kesalahan transfer mendominasi linimasa permintaan | Validasi pemetaan perangkat, backend, kesehatan fabric, dan lokalitas topologi sebelum menambahkan replika model. |
| Router | Terjadi churn worker tidak sehat, antrean tidak merata, atau penundaan routing | Gunakan topologi dan kebijakan router produksi yang didukung oleh rilis SGLang Anda. |
Untuk pola multi-node, SGLang menerbitkan contoh peluncuran prefill dan decode terpisah untuk deployment kelas DeepSeek, termasuk inisialisasi terdistribusi dan argumen paralelisme khusus peran. Contoh tersebut merupakan templat yang berguna, tetapi model, perangkat keras, dan versi SGLang tetap memerlukan pengujian penerimaan tersendiri. Lihat contoh PD multi-node upstream sebelum menyesuaikan manifest cluster.
Jika Kubernetes mengelola siklus hidup, berikan label, layanan, anggaran gangguan, dasbor, dan probe kesiapan terpisah untuk prefill dan decode. Prasyarat klaster yang lebih luas—eksposur GPU, antrean, penyimpanan, jaringan, dan observabilitas—dibahas dalam panduan klaster GPU Kubernetes kami.
Metrik untuk disagregasi prefill decode SGLang
Disagregasi prefill decode SGLang harus meningkatkan hasil beban kerja yang dipilih, bukan sekadar menghasilkan grafik sumber daya yang berbeda. Instrumentasikan linimasa permintaan dengan interval prefill, transfer, penerimaan decode, dan generasi yang terpisah.
| Metrik | Apa yang diungkapkannya | Baca bersama |
|---|---|---|
| TTFT, p50, dan p95 | Antrean prompt ditambah eksekusi dan handoff prefill | Bucket panjang prompt dan kedalaman antrean prefill |
| ITL, p50, dan p95 | Kadens token setelah generasi dimulai | Urutan decode aktif dan okupansi KV decode |
| Durasi dan kesalahan transfer KV | Apakah handoff menjadi bottleneck atau sumber kegagalan | Throughput fabric, percobaan ulang, kesehatan NIC, dan log backend |
| Usia antrean prefill/decode | Apakah rasio pool salah | Replika khusus peran dan batas konkurensi |
| Permintaan selesai per detik | Kapasitas yang berguna pada campuran aktual | Tingkat kesalahan, tingkat pembatalan, dan SLO latensi |
| Utilisasi komputasi GPU, HBM, dan CPU host | Mendukung diagnosis, bukan hasil akhir | Empat pengaturan waktu tahap permintaan di atas |
Jalankan dua set pengujian. Satu set harus menggunakan campuran traffic yang Anda harapkan saat ini; set lainnya harus sengaja berisi prompt panjang, panjang generasi yang bervariasi, pembatalan, dan lonjakan traffic. PD dapat terlihat sangat baik pada prompt sintetis rata-rata, tetapi gagal mencapai tujuan sebenarnya pada campuran produksi yang tidak merata.
Kebijakan alokasi decode: kontrol yang terarah, bukan trik penyesuaian default
Secara default, SGLang mendokumentasikan perilaku alokasi decode early: slot KV tujuan dicadangkan sebelum prefill selesai. Oleh karena itu, prefill panjang dapat menahan kapasitas decode saat sisi decode menunggu data KV.
Alternatif yang didokumentasikan adalah:
--disaggregation-decode-allocation-policy prefill_complete
Dengan prefill_complete, SGLang menunda alokasi tujuan hingga prefill siap. Ini dapat membantu ketika prompt panjang bersaing dengan traffic decode aktif untuk kapasitas KV tujuan, tetapi juga mengubah overlap dan cakupan dukungan. Dokumentasi upstream menyatakan untuk menetapkan kebijakan pada prefill dan decode serta mencantumkan beberapa kombinasi yang tidak kompatibel. Perlakukan ini sebagai eksperimen terkendali dengan kriteria rollback, bukan optimasi universal.
Mode kegagalan umum dan pemeriksaan lanjutan tercepat
| Gejala | Batas yang kemungkinan perlu diperiksa | Pemeriksaan lanjutan cepat |
|---|---|---|
| Router menerima permintaan tetapi tidak ada token yang kembali | Keterjangkauan worker atau handoff peran yang gagal | Periksa log router, kesehatan worker, dan satu trace yang mencakup prefill hingga decode. |
| Waktu tunggu decode bertambah sementara prefill sehat | Penerimaan decode atau tekanan KV tujuan | Periksa urutan aktif, okupansi KV, dan kebijakan alokasi sebelum menambahkan kapasitas prefill secara sembarang. |
| TTFT membaik tetapi ITL memburuk | Pool decode atau bottleneck transfer KV | Bandingkan usia antrean decode, durasi transfer, dan jumlah urutan aktif dengan baseline terpadu. |
| Traffic multi-node kadang hang atau mencoba ulang | Network fabric, pemetaan perangkat, atau konfigurasi worker yang tidak konsisten | Verifikasi build SGLang yang tepat, backend transfer, pemetaan NIC, dan manifes peran di setiap node. |
| Fitur lanjutan berfungsi dalam mode terpadu tetapi gagal dalam PD | Kombinasi fitur yang tidak didukung | Baca bagian kompatibilitas PD saat ini dan reproduksi dengan topologi didukung yang paling kecil. |
| Utilisasi GPU meningkat tetapi latensi pengguna tidak membaik | Optimasi menargetkan tahap yang salah | Kembali ke TTFT, ITL, usia antrean, kesalahan, dan throughput pekerjaan yang selesai. |
Rollout disagregasi prefill decode SGLang harus dapat dibalik. Pertahankan rute serving terpadu atau revisi deployment yang diketahui baik hingga konfigurasi PD memenuhi ambang batas latensi dan keandalan yang ditetapkan di seluruh campuran beban kerja yang penting.
Urutan rollout yang aman
- Baseline: Tangkap benchmark SGLang terpadu dengan prompt, output, konkurensi, dan kasus kegagalan yang menyerupai produksi.
- Satu pasangan: Luncurkan satu worker prefill, satu worker decode, dan sebuah router; luluskan pemeriksaan fungsional, streaming, pembatalan, dan restart.
- Visibilitas peran: Pisahkan log, dasbor, alert, dan batas kapasitas berdasarkan router, prefill, transfer, dan decode.
- Beban terkendali: Bandingkan PD dengan baseline berdasarkan bucket panjang prompt dan panjang output, bukan hanya berdasarkan rata-rata.
- Skalakan satu kendala pada satu waktu: Sesuaikan ukuran pool, bentuk GPU, konkurensi, atau konfigurasi transfer dalam eksperimen terpisah.
- Canary dan rollback: Arahkan sebagian traffic yang dibatasi, tetapkan ambang rollback latensi/kesalahan, dan pertahankan konfigurasi sehat terakhir.
Urutan ini mengubah disagregasi prefill decode SGLang PD dari diagram arsitektur yang menjanjikan menjadi perubahan yang dapat diuji secara operasional.
Pertanyaan yang sering diajukan
Apakah disagregasi PD selalu meningkatkan throughput?
Tidak. Ini dapat meningkatkan beban kerja ketika kontensi prefill dan decode menjadi kendala, tetapi juga menambahkan transfer KV, penjadwalan router, dan overhead operasional. Uji terhadap baseline terpadu dengan campuran trafik dan anggaran kapasitas yang sama.
Apakah prefill berjalan pada model yang berbeda dari decode?
Tidak. Peran-peran tersebut melanjutkan satu permintaan logis. Pastikan model, tokenizer, revisi, kuantisasi, dan konfigurasi serving yang telah diuji tetap selaras di seluruh pasangan, kecuali dokumentasi upstream secara eksplisit mendukung pengaturan yang berbeda.
Backend transfer mana yang sebaiknya saya gunakan?
Gunakan backend yang didukung oleh rilis SGLang yang Anda tetapkan dan telah divalidasi untuk fabric aktual Anda. Dokumentasi SGLang saat ini menjelaskan Mooncake dan NIXL, tetapi pilihan yang tepat bergantung pada platform, image container, perangkat, dan dukungan operasional yang telah Anda verifikasi.
Dapatkah saya menggabungkan disagregasi prefill decode SGLang dengan setiap fitur lanjutan?
Tidak. Dukungan PD sensitif terhadap fitur dan versi. Periksa catatan kompatibilitas upstream terbaru sebelum menggabungkannya dengan respons stateful, eksekusi tool, fitur cache, mode spekulasi, atau perilaku peran nonstandar.
Langkah praktis berikutnya
Mulailah dengan lingkungan penerimaan satu pasangan, catat ambang TTFT/ITL/error yang membenarkan arsitektur tersebut, dan promosikan hanya setelah jalur transfer dan kegagalan dapat diamati. Untuk keputusan serving terkait, bandingkan vLLM vs. SGLang, tinjau speculative decoding untuk inferensi LLM, dan rencanakan klaster GPU Kubernetes yang mendasarinya secara terpisah dari peluncuran PD.


