Desagregación de prefill y decode de SGLang: arquitectura y guía de implementación
Última verificación: 16 de octubre de 2026. Las opciones de SGLang y las combinaciones de funciones compatibles cambian rápidamente; fije una imagen o un commit de SGLang probado antes de aplicar esta guía en producción.
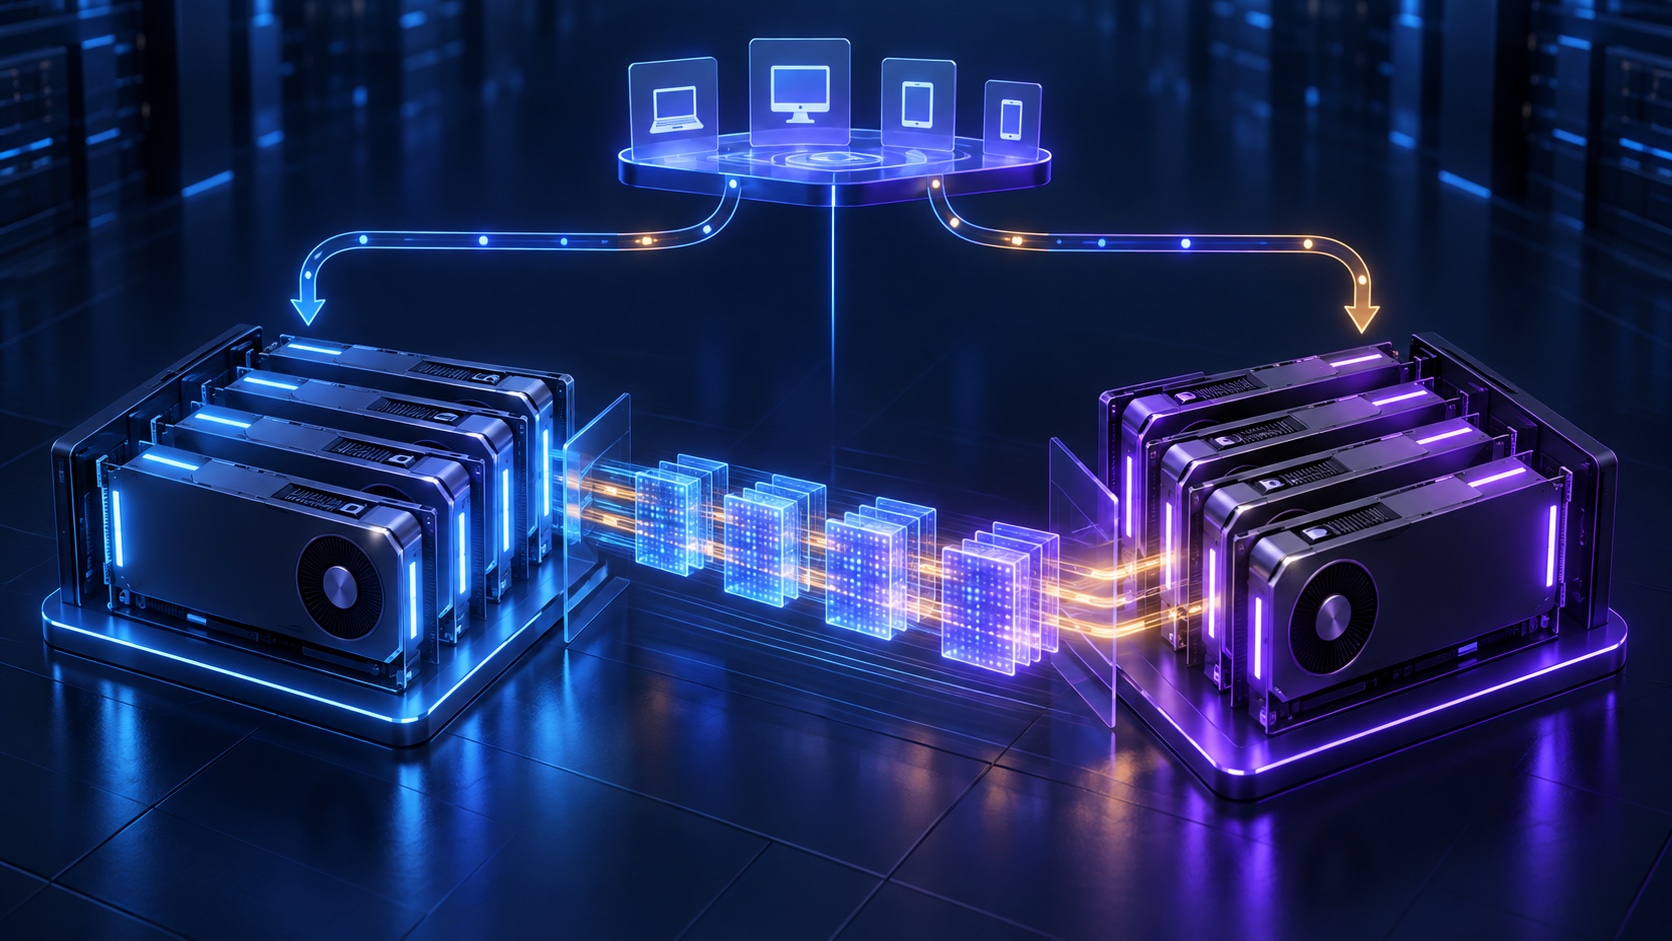
La desagregación de prefill y decode de SGLang separa las dos tareas muy diferentes dentro del servicio de LLM: el procesamiento de prompts se ejecuta en un grupo de prefill, mientras que la generación de tokens se ejecuta en un grupo de decode. Los grupos intercambian la caché KV de la solicitud, y un router presenta un único endpoint de inferencia al cliente.
Esta separación puede proteger la latencia entre tokens cuando llegan prompts largos y permite escalar la capacidad de prefill, intensiva en cómputo, de forma distinta de la capacidad de decode, limitada por memoria. También añade una ruta de transferencia, otro límite de planificación y una mayor superficie de compatibilidad. Trátela como una arquitectura de servicio medida, no como un interruptor que automáticamente hace más rápida cualquier carga de trabajo.
Esta guía explica la arquitectura de desagregación de prefill y decode de SGLang, una configuración mínima de implementación, qué medir y las condiciones que deberían detener un despliegue.
La respuesta rápida: cuándo la desagregación PD justifica su complejidad
La documentación oficial de SGLang describe el prefill como intensivo en cómputo y el decode como intensivo en caché KV y memoria. En un planificador unificado, el trabajo de prefill entrante puede interrumpir el trabajo de decode; con atención paralela de datos, distintos workers también pueden desequilibrarse entre las dos fases. La desagregación PD separa esas fases para que cada una pueda planificarse y aprovisionarse de forma independiente. La documentación de PD de SGLang es la fuente de referencia para las combinaciones compatibles actuales.
| Señal de la carga de trabajo | ¿Es la desagregación de prefill y decode de SGLang una buena candidata? | Por qué |
|---|---|---|
| Prompts largos o muy variables, con usuarios sensibles a la fluidez del streaming | A menudo | Es menos probable que los prefills largos interrumpan un grupo de decode activo. |
| La presión de memoria de decode difiere considerablemente de la presión de cómputo de los prompts | A menudo | Puede dimensionar los grupos y los límites de concurrencia según su cuello de botella real. |
| Una implementación de GPU multinodo ya cuenta con una infraestructura de transferencia KV de baja latencia validada | A menudo | El límite de transferencia adicional es operativamente viable. |
| Un servidor GPU pequeño, prompts cortos y uniformes, o poco tráfico | Por lo general, no como primera opción | Un servidor unificado es más sencillo y puede evitar la sobrecarga de transferencia. |
| Una carga de trabajo que depende del historial de respuestas local al proceso o de herramientas integradas del servidor | No, hasta validarlo | La documentación oficial actual de PD incluye los flujos de trabajo con estado de la Response API y las herramientas integradas entre los flujos de trabajo no compatibles. |
La decisión no es «prefill rápido, decode lento». Se trata de si aislar sus colas y límites de hardware mejora el objetivo visible para el usuario que le importa: normalmente el tiempo hasta el primer token (TTFT), la latencia entre tokens (ITL), la latencia de cola o las solicitudes completadas con un presupuesto de capacidad fijo.
Cómo funciona la desagregación de prefill y decode en SGLang
La topología PD de SGLang tiene tres roles lógicos:
- Router: recibe la solicitud del cliente, selecciona una ruta de prefill y decode, y transmite la respuesta combinada de vuelta al cliente.
- Workers de prefill: tokenizan y procesan el prompt completo, y luego producen el estado de caché KV necesario para continuar la generación.
- Workers de decode: reciben ese estado KV y generan tokens de salida hasta que se completa la solicitud.
La transferencia es la parte importante. El worker de prefill no envía texto a un decodificador nuevo para que repita el prompt. Transfiere el estado de caché KV para que decode pueda continuar desde el mismo contexto de atención. Actualmente, SGLang documenta Mooncake y NIXL como motores de transferencia PD; elija el transporte y la ruta de red que su versión fijada y su hardware realmente admitan.
cliente
  │
  ▼
Router PD ──► grupo de prefill ──► transferencia de caché KV ──► grupo de decode ──► tokens en streaming
                 intensivo en cómputo       infraestructura       sensible a la memoria
En un clúster multinodo, cada rol puede tener su propio número de réplicas, configuración de GPU, límite de cola, política de escalado automático y presupuesto de fallos. Esto solo es útil si el router y la infraestructura de transferencia KV se tratan como dependencias de producción en lugar de como pegamento invisible.
Antes de implementar: las cinco comprobaciones que evitan resultados engañosos
1. Fije la versión exacta de SGLang y la configuración del modelo
Ejecute la misma imagen o commit de SGLang probado en el router, los workers de prefill y los workers de decode. Mantenga explícitos en sus manifiestos la revisión del modelo, el tokenizador, la cuantización, el backend de atención, la estrategia de paralelismo y las opciones específicas del modelo. Un comando que funcionaba en una versión puede no ser válido o tener una semántica distinta en otra.
2. Demuestre la ruta de transferencia KV antes de escalar el tráfico
PD es una arquitectura de plano de datos. Valide la asignación de la NIC o la interconexión, la exposición de dispositivos del contenedor, los límites del host y el backend de transferencia antes de interpretar la latencia del modelo. Las implementaciones específicas de Mooncake pueden requerir configuración de InfiniBand/RDMA; la documentación de SGLang también documenta la selección del backend NIXL para infraestructura compatible. No infiera que una ruta rápida de comunicación colectiva demuestra automáticamente que la ruta de transferencia de KV está en buen estado.
3. Establezca una línea base de servidor unificado
Use el mismo modelo, prompts, longitudes de generación, combinación de concurrencia, ajustes de muestreo y presupuesto de hardware para la línea base y la prueba de PD. Mida al menos TTFT p50/p95, ITL p50/p95, rendimiento de solicitudes, comportamiento de cancelación y tasa de errores. Un número más alto de utilización de GPU por sí solo no es un resultado de serving.
4. Defina el límite de roles en su planificador
Mantenga los pods, servicios, registros y alertas de prefill y decode direccionables por separado. Si no puede determinar qué rol está en cola, sin capacidad de KV o esperando una transferencia, la arquitectura será más difícil de operar que una flota unificada.
5. Lea las restricciones de compatibilidad actuales, no solo el bloque de inicio rápido
La documentación de desagregación de prefill y decode de SGLang incluye restricciones para políticas específicas y flujos de trabajo con estado. Por ejemplo, la política documentada de asignación de decode prefill_complete tiene un ámbito de compatibilidad más limitado que la política predeterminada. Valide cada combinación de funciones avanzadas en una ejecución de staging antes de convertirla en parte de una promesa de disponibilidad.
Una implementación mínima de desagregación de prefill y decode de SGLang
Comience con un worker de prefill, un worker de decode y un router en un host con dos GPU. Esta es una prueba de aceptación funcional, no una afirmación de que dos GPU sean una configuración de producción. El siguiente ejemplo de NIXL sigue el patrón actual ascendente para un solo nodo; use la sintaxis exacta de los comandos de la documentación correspondiente a la versión fijada de SGLang.
# GPU 0: prefill role
python -m sglang.launch_server \
  --model-path meta-llama/Llama-3.1-8B-Instruct \
  --disaggregation-mode prefill \
  --disaggregation-transfer-backend nixl \
  --port 30000

# GPU 1: decode role
python -m sglang.launch_server \
  --model-path meta-llama/Llama-3.1-8B-Instruct \
  --disaggregation-mode decode \
  --disaggregation-transfer-backend nixl \
  --base-gpu-id 1 \
  --port 30001

# Client-facing PD router
python -m sglang_router.launch_router \
  --pd-disaggregation \
  --prefill http://127.0.0.1:30000 \
  --decode http://127.0.0.1:30001 \
  --host 0.0.0.0 \
  --port 8000
Envíe una solicitud corta a través del router en lugar de directamente a cualquiera de los workers:
curl http://127.0.0.1:8000/v1/completions \
  -H 'Content-Type: application/json' \
  -d '{
    "model": "meta-llama/Llama-3.1-8B-Instruct",
    "prompt": "Explain why KV-cache handoff matters in one sentence.",
    "max_tokens": 64
  }'
El éxito implica más que recibir texto. Confirme que el router seleccionó ambos roles, que la transferencia de KV se completó, que el comportamiento de streaming permanece intacto y que cada proceso informa la configuración esperada del modelo y de compatibilidad. Mantenga esta pequeña implementación de desagregación de prefill y decode de SGLang en CI o en un entorno de preproducción para que una actualización no interrumpa silenciosamente la ruta de PD.
Para una implementación de Mooncake, use la guía de PD de SGLang actual para la instalación requerida del motor de transferencia y la configuración de dispositivos IB. No copie variables de entorno de Mooncake de un transporte, nube o versión de SGLang diferentes.
Pasar de un par a una topología de producción
Cuando el par básico esté en buen estado, escale cada rol según los datos de cola y recursos, en lugar de asumir una proporción de 1:1.
| Capa | Escale a partir de esta observación | Control práctico |
|---|---|---|
| Pool de prefill | La cola de prompts crece, el cómputo de prefill se satura o aumentan las colas de TTFT | Agregue réplicas de prefill o cambie la configuración de GPU de prefill después de una prueba controlada. |
| Pool de decode | Las secuencias activas agotan la capacidad de KV, aumentan las colas de ITL o la admisión de decode espera | Agregue réplicas de decode, reduzca la concurrencia o aumente la memoria por worker solo después de validar la huella del modelo. |
| Tejido de transferencia de KV | El tiempo de transferencia o los errores de transferencia dominan la línea de tiempo de la solicitud | Valide la asignación de dispositivos, el backend, el estado del tejido y la localidad de la topología antes de agregar réplicas del modelo. |
| Router | Aparece rotación de workers no saludables, colas desiguales o retraso de enrutamiento | Use una topología y una política de router de producción compatibles con su versión de SGLang. |
Para patrones multinodo, SGLang publica ejemplos de inicio separados para prefill y decode en implementaciones de la clase DeepSeek, incluidos argumentos de inicialización distribuida y paralelismo específicos por rol. Esos ejemplos son una plantilla útil, pero el modelo, el hardware y la versión de SGLang aún necesitan su propia prueba de aceptación. Consulte los ejemplos ascendentes de PD multinodo antes de adaptar un manifiesto de clúster.
Si Kubernetes gestiona el ciclo de vida, asigne a prefill y decode etiquetas, servicios, presupuestos de interrupción, paneles y sondas de preparación independientes. Los requisitos previos más amplios del clúster —exposición de GPU, colas, almacenamiento, redes y observabilidad— se tratan en nuestra guía de clústeres GPU de Kubernetes.
Métricas para la desagregación de prefill y decode de SGLang
La desagregación de prefill y decode de SGLang debe mejorar un resultado elegido de la carga de trabajo, no limitarse a producir un gráfico de recursos diferente. Instrumente la cronología de las solicitudes con intervalos diferenciados de prefill, transferencia, admisión de decode y generación.
| Métrica | Qué revela | Interprétela junto con |
|---|---|---|
| TTFT, p50 y p95 | Colas de prompts más ejecución y transferencia de prefill | Grupos por longitud de prompt y profundidad de la cola de prefill |
| ITL, p50 y p95 | Cadencia de tokens después de que comienza la generación | Secuencias de decode activas y ocupación de KV de decode |
| Duración y errores de la transferencia de KV | Si la transferencia es un cuello de botella o una fuente de fallos | Rendimiento de la red, reintentos, estado de las NIC y registros del backend |
| Antigüedad de la cola de prefill/decode | Si la proporción de pools es incorrecta | Réplicas específicas por rol y límites de concurrencia |
| Solicitudes completadas por segundo | Capacidad útil con la mezcla real | Tasa de errores, tasa de cancelaciones y SLO de latencia |
| Utilización de cómputo de GPU, HBM y CPU del host | Diagnóstico de apoyo, no el resultado | Las cuatro mediciones de tiempos por etapa de solicitud anteriores |
Ejecute dos conjuntos de pruebas. Uno debe usar la mezcla de tráfico que espera hoy; el otro debe contener deliberadamente prompts largos, longitudes de generación variables, cancelaciones y ráfagas. PD puede parecer excelente con un prompt sintético promedio y, aun así, no cumplir su propósito real con una mezcla de producción sesgada.
Política de asignación de decode: un control específico, no un truco de ajuste predeterminado
De forma predeterminada, SGLang documenta un comportamiento de asignación de decode early: las ranuras KV de destino se reservan antes de que finalice el prefill. Por lo tanto, los prefills largos pueden retener capacidad de decode mientras el lado de decode espera los datos KV.
La alternativa documentada es:
--disaggregation-decode-allocation-policy prefill_complete
Con prefill_complete, SGLang retrasa la asignación de destino hasta que el prefill está listo. Esto puede ayudar cuando los prompts largos compiten con el tráfico de decode activo por la capacidad KV de destino, pero también cambia el solapamiento y el ámbito de soporte. La documentación upstream indica configurar la política tanto en prefill como en decode y enumera varias combinaciones incompatibles. Trátela como un experimento controlado con criterios de reversión, no como una optimización universal.
Modos de fallo comunes y la siguiente comprobación más rápida
| Síntoma | Límite probable que se debe inspeccionar | Siguiente comprobación rápida |
|---|---|---|
| El router acepta solicitudes, pero no se devuelven tokens | Conectividad de los workers o una transferencia de rol fallida | Revise los registros del router, el estado de los workers y una traza que abarque desde prefill hasta decode. |
| El tiempo de espera de decode crece mientras prefill está en buen estado | Admisión de decode o presión de KV de destino | Inspeccione las secuencias activas, la ocupación de KV y la política de asignación antes de añadir capacidad de prefill arbitrariamente. |
| TTFT mejora, pero ITL empeora | Cuello de botella del pool de decode o de la transferencia de KV | Compare la antigüedad de la cola de decode, la duración de la transferencia y el número de secuencias activas con la línea base unificada. |
| El tráfico multinodo se bloquea o reintenta de forma intermitente | Red, asignación de dispositivos o configuración incoherente de los workers | Verifique la compilación exacta de SGLang, el backend de transferencia, la asignación de NIC y los manifiestos de roles en cada nodo. |
| Una función avanzada funciona en modo unificado, pero falla en PD | Combinación de funciones no compatible | Lea la sección actual de compatibilidad de PD y reproduzca el problema con la topología compatible más pequeña. |
| La utilización de GPU aumenta, pero la latencia del usuario no mejora | La optimización se dirigió a la etapa equivocada | Vuelva a TTFT, ITL, antigüedad de cola, errores y rendimiento de trabajo completado. |
La implementación de la desagregación de prefill y decode de SGLang debe ser reversible. Mantenga una ruta de servicio unificada o una revisión de implementación conocida como válida hasta que la configuración de PD cumpla los umbrales de latencia y fiabilidad definidos para la mezcla de cargas de trabajo relevante.
Una secuencia de implementación segura
- Línea base: Capture una prueba de rendimiento de SGLang unificado con prompts, salidas, concurrencia y casos de fallo similares a producción.
- Un par: Inicie un worker de prefill, un worker de decode y un router; supere las comprobaciones funcionales, de streaming, cancelación y reinicio.
- Visibilidad por rol: Separe registros, paneles, alertas y límites de capacidad por router, prefill, transferencia y decode.
- Carga controlada: Compare PD con la línea base por grupos de longitud de prompt y de salida, no solo por un promedio.
- Escale una restricción a la vez: Ajuste el tamaño del pool, la configuración de GPU, la concurrencia o la configuración de transferencia en experimentos separados.
- Canary y reversión: Dirija una porción limitada del tráfico, defina un umbral de reversión por latencia/error y conserve la última configuración en buen estado.
Esta secuencia convierte la desagregación de prefill y decode de SGLang PD de un prometedor diagrama de arquitectura en un cambio que puede probarse operativamente.
Preguntas frecuentes
¿La desagregación de PD siempre aumenta el rendimiento?
No. Puede mejorar una carga de trabajo en la que la contención entre prefill y decode es la limitación, pero también introduce transferencia de KV, planificación del router y sobrecarga operativa. Pruébela frente a una referencia unificada utilizando la misma combinación de tráfico y el mismo presupuesto de capacidad.
¿Prefill se ejecuta en un modelo diferente de decode?
No. Los roles continúan una misma solicitud lógica. Mantenga alineados en el par el modelo, el tokenizador, la revisión, la cuantización y la configuración de serving probados, salvo que la documentación upstream admita explícitamente una disposición diferente.
¿Qué backend de transferencia debo usar?
Utilice un backend compatible con la versión fijada de SGLang y validado para su infraestructura real. La documentación actual de SGLang describe Mooncake y NIXL, pero la elección correcta depende de la plataforma, la imagen de contenedor, los dispositivos y el soporte operativo que haya verificado.
¿Puedo combinar la desagregación de prefill y decode de SGLang con todas las funciones avanzadas?
No. La compatibilidad con PD es sensible a las funciones y a la versión. Consulte las notas de compatibilidad upstream actuales antes de combinarla con respuestas con estado, ejecución de herramientas, funciones de caché, modos de especulación o comportamientos de roles no estándar.
El siguiente paso práctico
Comience con un entorno de aceptación de un solo par, documente los umbrales de TTFT/ITL/errores que justifican la arquitectura y promueva únicamente después de que las rutas de transferencia y de fallo sean observables. Para decisiones de serving relacionadas, compare vLLM frente a SGLang, revise la decodificación especulativa para la inferencia de LLM y planifique el clúster de GPU de Kubernetes subyacente por separado de la implementación de PD.