
Désagrégation du préremplissage et du décodage SGLang : architecture et guide de déploiement
Dernière vérification : 16 octobre 2026. Les indicateurs SGLang et les combinaisons de fonctionnalités prises en charge évoluent rapidement ; épinglez une image ou un commit SGLang testé avant d’appliquer ce guide en production.
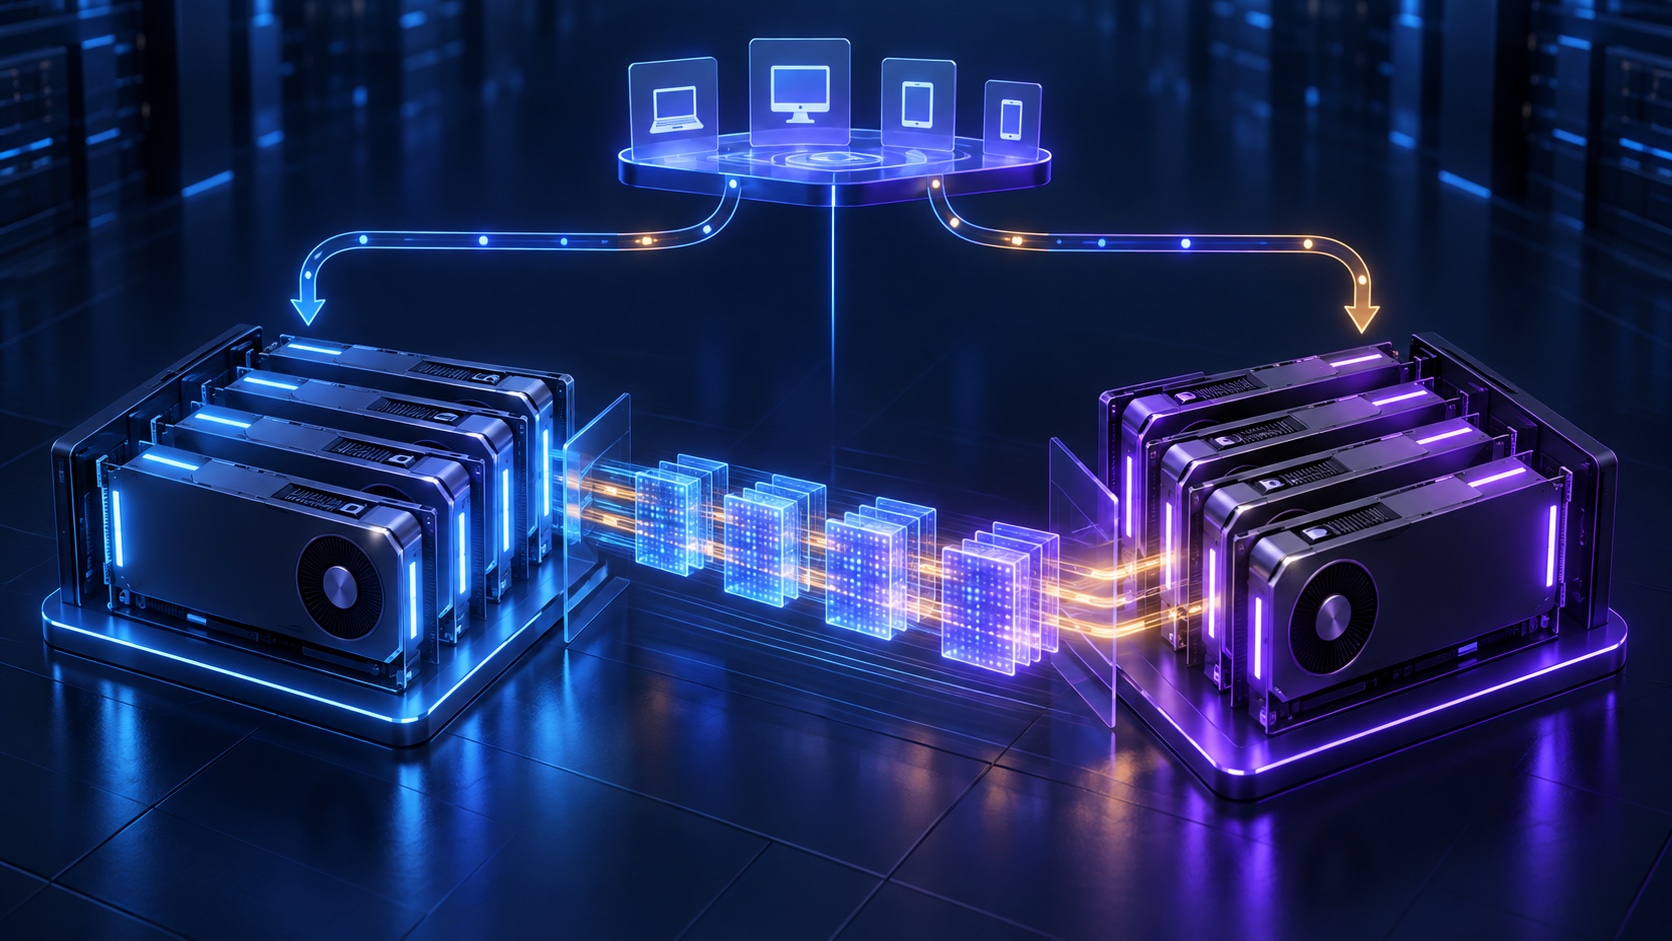
La désagrégation du préremplissage et du décodage SGLang sépare les deux tâches très différentes du service de LLM : le traitement des invites s’exécute sur un pool de préremplissage, tandis que la génération de jetons s’exécute sur un pool de décodage. Les pools échangent le cache KV de la requête, et un routeur présente un unique point de terminaison d’inférence au client.
Cette séparation peut préserver la latence inter-jetons lorsque de longues invites arrivent, et elle permet de dimensionner différemment la capacité de préremplissage gourmande en calcul et la capacité de décodage limitée par la mémoire. Elle ajoute également un chemin de transfert, une limite supplémentaire entre ordonnanceurs et une surface de compatibilité plus étendue. Considérez-la comme une architecture de service mesurée — et non comme un interrupteur qui accélère automatiquement toutes les charges de travail.
Ce guide explique l’architecture de désagrégation du préremplissage et du décodage SGLang, une forme de déploiement minimale, les éléments à mesurer et les conditions qui doivent interrompre un déploiement.
Réponse rapide : quand la désagrégation PD justifie sa complexité
La documentation amont de SGLang décrit le préremplissage comme intensif en calcul et le décodage comme intensif en cache KV et en mémoire. Dans un ordonnanceur unifié, le travail de préremplissage entrant peut interrompre le travail de décodage ; avec l’attention parallèle aux données, différents workers peuvent également se déséquilibrer entre les deux phases. La désagrégation PD sépare ces phases afin que chacune puisse être planifiée et provisionnée indépendamment. La documentation PD de SGLang fait foi pour les combinaisons actuellement prises en charge.
| Signal de charge de travail | La désagrégation du préremplissage et du décodage SGLang est-elle une bonne candidate ? | Pourquoi |
|---|---|---|
| Invites longues ou très variables, avec des utilisateurs sensibles à la fluidité du streaming | Souvent | Les longs préremplissages sont moins susceptibles d’interrompre un pool de décodage actif. |
| La pression mémoire du décodage diffère sensiblement de la pression de calcul des invites | Souvent | Vous pouvez dimensionner les pools et les limites de concurrence selon leur véritable goulot d’étranglement. |
| Un déploiement GPU multinœud possède déjà une infrastructure de transfert KV validée et à faible latence | Souvent | La limite de transfert supplémentaire est réaliste sur le plan opérationnel. |
| Un petit serveur GPU, des invites courtes et uniformes, ou un faible trafic | Généralement pas en premier choix | Un serveur unifié est plus simple et peut éviter la surcharge de transfert. |
| Une charge de travail qui dépend de l’historique des réponses local au processus ou des outils de serveur intégrés | Non, tant que cela n’est pas validé | La documentation PD amont actuelle répertorie les flux de travail Response API avec état et les outils intégrés parmi les flux non pris en charge. |
La décision n’est pas « préremplissage rapide, décodage lent ». Il s’agit de savoir si l’isolation de leurs files d’attente et de leurs limites matérielles améliore l’objectif visible par l’utilisateur qui vous importe — généralement le délai avant le premier jeton (TTFT), la latence inter-jetons (ITL), la latence de queue ou le nombre de requêtes terminées avec un budget de capacité fixe.
Fonctionnement de la désagrégation du préremplissage et du décodage dans SGLang
La topologie PD de SGLang comporte trois rôles logiques :
- Routeur : reçoit la requête client, sélectionne un chemin de préremplissage et de décodage, puis diffuse la réponse fusionnée au client.
- Workers de préremplissage : tokenisent et traitent l’intégralité de l’invite, puis produisent l’état du cache KV nécessaire pour poursuivre la génération.
- Workers de décodage : reçoivent cet état KV et génèrent les jetons de sortie jusqu’à la fin de la requête.
Le transfert est la partie importante. Le worker de préremplissage n’envoie pas de texte à un nouveau décodeur pour lui faire répéter l’invite. Il transfère l’état du cache KV afin que le décodage puisse continuer à partir du même contexte d’attention. SGLang documente actuellement Mooncake et NIXL comme moteurs de transfert PD ; choisissez le transport et le chemin réseau réellement pris en charge par votre version épinglée et votre matériel.
client
  │
  ▼
Routeur PD ──► pool de préremplissage ──► transfert du cache KV ──► pool de décodage ──► jetons diffusés
                 gourmand en calcul          infrastructure            sensible à la mémoire
Dans un cluster multinœud, chaque rôle peut avoir son propre nombre de réplicas, sa propre configuration GPU, sa propre limite de file d’attente, sa politique d’autoscaling et son budget de défaillance. Cela n’est utile que si le routeur et l’infrastructure de transfert KV sont traités comme des dépendances de production plutôt que comme une colle invisible.
Avant le déploiement : les cinq vérifications qui évitent des résultats trompeurs
1. Épinglez la version exacte de SGLang et la configuration du modèle
Exécutez la même image ou le même commit SGLang testé sur le routeur, les workers de préremplissage et les workers de décodage. Conservez explicitement dans vos manifestes la révision du modèle, le tokenizer, la quantification, le backend d’attention, la stratégie de parallélisme et les indicateurs propres au modèle. Une commande qui fonctionnait avec une version peut être invalide ou avoir une sémantique différente avec une autre.
2. Validez le chemin de transfert KV avant d’augmenter le trafic
La PD est une architecture de plan de données. Validez le mappage de la NIC ou de l’interconnexion, l’exposition des périphériques de conteneur, les limites de l’hôte et le backend de transfert avant d’interpréter la latence du modèle. Les déploiements spécifiques à Mooncake peuvent nécessiter une configuration InfiniBand/RDMA ; la documentation SGLang décrit également la sélection du backend NIXL pour les infrastructures compatibles. N’en déduisez pas qu’un chemin de communication collective rapide prouve automatiquement qu’un chemin de transfert KV est sain.
3. Établir une référence de serveur unifié
Utilisez le même modèle, les mêmes prompts, longueurs de génération, mélange de concurrence, paramètres d’échantillonnage et budget matériel pour la référence et le test PD. Mesurez au minimum les TTFT p50/p95, les ITL p50/p95, le débit des requêtes, le comportement d’annulation et le taux d’erreur. Un chiffre d’utilisation GPU plus élevé ne constitue pas à lui seul un résultat de serving.
4. Définir la frontière des rôles dans votre ordonnanceur
Conservez des pods, services, journaux et alertes de préremplissage et de décodage pouvant être adressés séparément. Si vous ne pouvez pas déterminer quel rôle est en file d’attente, manque de capacité KV ou attend un transfert, l’architecture sera plus difficile à exploiter qu’une flotte unifiée.
5. Lire les contraintes de compatibilité actuelles, et pas seulement le bloc de démarrage rapide
La documentation de désagrégation du préremplissage et du décodage SGLang inclut des restrictions pour certaines politiques et certains flux de travail avec état. Par exemple, la politique documentée d’allocation de décodage prefill_complete présente un périmètre de prise en charge plus restreint que la politique par défaut. Validez chaque combinaison de fonctionnalités avancées dans un test de préproduction avant de l’intégrer à une promesse de disponibilité.
Un déploiement minimal de désagrégation du préremplissage et du décodage SGLang
Commencez avec un worker de préremplissage, un worker de décodage et un routeur sur un hôte à deux GPU. Il s’agit d’un test d’acceptation fonctionnelle, et non d’une affirmation selon laquelle deux GPU constituent une configuration de production. L’exemple NIXL suivant suit le modèle actuel en amont pour un seul nœud ; utilisez la syntaxe de commande exacte de la documentation correspondant à votre version épinglée de SGLang.
# GPU 0: prefill role
python -m sglang.launch_server \
  --model-path meta-llama/Llama-3.1-8B-Instruct \
  --disaggregation-mode prefill \
  --disaggregation-transfer-backend nixl \
  --port 30000

# GPU 1: decode role
python -m sglang.launch_server \
  --model-path meta-llama/Llama-3.1-8B-Instruct \
  --disaggregation-mode decode \
  --disaggregation-transfer-backend nixl \
  --base-gpu-id 1 \
  --port 30001

# Client-facing PD router
python -m sglang_router.launch_router \
  --pd-disaggregation \
  --prefill http://127.0.0.1:30000 \
  --decode http://127.0.0.1:30001 \
  --host 0.0.0.0 \
  --port 8000
Envoyez une requête courte via le routeur plutôt que directement à l’un ou l’autre worker :
curl http://127.0.0.1:8000/v1/completions \
  -H 'Content-Type: application/json' \
  -d '{
    "model": "meta-llama/Llama-3.1-8B-Instruct",
    "prompt": "Explain why KV-cache handoff matters in one sentence.",
    "max_tokens": 64
  }'
La réussite signifie davantage que la réception de texte. Confirmez que le routeur a sélectionné les deux rôles, que le transfert KV s’est terminé, que le comportement de streaming est intact et que chaque processus indique les paramètres de modèle et de compatibilité attendus. Conservez ce petit déploiement de désagrégation du préremplissage et du décodage SGLang dans la CI ou dans un environnement de préproduction afin qu’une mise à niveau ne rompe pas discrètement le chemin PD.
Pour un déploiement Mooncake, utilisez le guide PD SGLang actuel pour l’installation requise du moteur de transfert et la configuration des périphériques IB. Ne copiez pas des variables d’environnement Mooncake depuis un autre transport, cloud ou une autre version de SGLang.
Passer d’une paire à une topologie de production
Lorsque la paire de base est saine, mettez chaque rôle à l’échelle en fonction des données de file d’attente et de ressources, plutôt que selon un ratio 1:1 supposé.
| Couche | Mettre à l’échelle selon cette observation | Contrôle pratique |
|---|---|---|
| Pool de préremplissage | La file de prompts augmente, le calcul de préremplissage sature ou les queues de TTFT augmentent | Ajoutez des répliques de préremplissage ou modifiez la configuration GPU de préremplissage après un test contrôlé. |
| Pool de décodage | Les séquences actives épuisent la capacité KV, les queues d’ITL augmentent ou l’admission au décodage attend | Ajoutez des répliques de décodage, réduisez la concurrence ou augmentez la mémoire par worker uniquement après avoir validé l’empreinte mémoire du modèle. |
| Infrastructure de transfert KV | Le temps de transfert ou les erreurs de transfert dominent la chronologie de la requête | Validez le mappage des périphériques, le backend, l’état de l’infrastructure et la localité de topologie avant d’ajouter des répliques de modèle. |
| Routeur | Un renouvellement des workers non sains, des files déséquilibrées ou un délai de routage apparaît | Utilisez une topologie et une politique de routeur de production prises en charge par votre version de SGLang. |
Pour les modèles multinœuds, SGLang publie des exemples de lancement distincts pour le préremplissage et le décodage dans les déploiements de classe DeepSeek, y compris des arguments d’initialisation distribuée et de parallélisme spécifiques aux rôles. Ces exemples constituent un modèle utile, mais le modèle, le matériel et la version de SGLang nécessitent toujours leur propre test d’acceptation. Consultez les exemples PD multinœuds en amont avant d’adapter un manifeste de cluster.
Si Kubernetes gère le cycle de vie, attribuez au préremplissage et au décodage des libellés, services, budgets de perturbation, tableaux de bord et sondes de disponibilité distincts. Les prérequis plus larges du cluster — exposition des GPU, mise en file d’attente, stockage, réseau et observabilité — sont couverts dans notre guide des clusters GPU Kubernetes.
Métriques pour la désagrégation du préremplissage et du décodage SGLang
La désagrégation du préremplissage et du décodage SGLang doit améliorer un résultat choisi pour la charge de travail, et non simplement produire un graphique de ressources différent. Instrumentez la chronologie des requêtes avec des intervalles distincts de préremplissage, transfert, admission au décodage et génération.
| Métrique | Ce qu’elle révèle | À lire avec |
|---|---|---|
| TTFT, p50 et p95 | Mise en file d’attente des prompts, exécution du préremplissage et transfert | Tranches de longueur de prompt et profondeur de la file de préremplissage |
| ITL, p50 et p95 | Cadence des jetons après le début de la génération | Séquences de décodage actives et occupation KV de décodage |
| Durée et erreurs du transfert KV | Si le transfert constitue un goulot d’étranglement ou une source de défaillance | Débit de la fabric, nouvelles tentatives, état des NIC et journaux du backend |
| Âge de la file de préremplissage/décodage | Si le ratio des pools est incorrect | Réplicas spécifiques au rôle et limites de concurrence |
| Requêtes terminées par seconde | Capacité utile avec le mix réel | Taux d’erreur, taux d’annulation et SLO de latence |
| Utilisation du calcul GPU, de la HBM et du CPU hôte | Éléments de diagnostic complémentaires, pas le résultat | Les quatre mesures de durée des étapes de requête ci-dessus |
Exécutez deux jeux de tests. L’un doit utiliser le mix de trafic que vous attendez aujourd’hui ; l’autre doit délibérément contenir des prompts longs, des longueurs de génération variables, des annulations et des rafales. La PD peut sembler excellente sur un prompt synthétique moyen tout en échouant à son véritable objectif avec un mix de production asymétrique.
Politique d’allocation du décodage : un contrôle ciblé, pas une astuce de réglage par défaut
Par défaut, SGLang documente un comportement d’allocation de décodage early : les emplacements KV de destination sont réservés avant la fin du préremplissage. Les préremplissages longs peuvent donc retenir de la capacité de décodage tandis que le côté décodage attend les données KV.
L’alternative documentée est :
--disaggregation-decode-allocation-policy prefill_complete
Avec prefill_complete, SGLang retarde l’allocation de destination jusqu’à ce que le préremplissage soit prêt. Cela peut aider lorsque de longs prompts rivalisent avec le trafic de décodage actif pour la capacité KV de destination, mais modifie également le chevauchement et le périmètre de prise en charge. La documentation amont indique de définir la politique à la fois sur le préremplissage et le décodage, et répertorie plusieurs combinaisons incompatibles. Traitez-la comme une expérience contrôlée avec des critères de retour en arrière, et non comme une optimisation universelle.
Modes de défaillance courants et vérification suivante la plus rapide
| Symptôme | Limite probable à inspecter | Vérification suivante rapide |
|---|---|---|
| Le routeur accepte les requêtes, mais aucun jeton ne revient | Accessibilité des workers ou transfert de rôle échoué | Vérifiez les journaux du routeur, l’état des workers et une trace couvrant le préremplissage jusqu’au décodage. |
| Le temps d’attente du décodage augmente alors que le préremplissage est sain | Admission au décodage ou pression sur le KV de destination | Inspectez les séquences actives, l’occupation KV et la politique d’allocation avant d’ajouter arbitrairement de la capacité de préremplissage. |
| Le TTFT s’améliore mais l’ITL se dégrade | Goulot d’étranglement du pool de décodage ou du transfert KV | Comparez l’âge de la file de décodage, la durée de transfert et le nombre de séquences actives avec la référence unifiée. |
| Le trafic multinœud se bloque ou effectue des nouvelles tentatives de manière intermittente | Fabric réseau, mappage des périphériques ou configuration incohérente des workers | Vérifiez la version exacte de SGLang, le backend de transfert, le mappage des NIC et les manifestes de rôles sur chaque nœud. |
| Une fonctionnalité avancée fonctionne en mode unifié mais échoue en PD | Combinaison de fonctionnalités non prise en charge | Lisez la section actuelle de compatibilité PD et reproduisez le problème avec la plus petite topologie prise en charge. |
| L’utilisation du GPU augmente mais la latence utilisateur ne s’améliore pas | L’optimisation visait la mauvaise étape | Revenez au TTFT, à l’ITL, à l’âge de la file, aux erreurs et au débit de travail terminé. |
Le déploiement de la désagrégation du préremplissage et du décodage SGLang doit être réversible. Conservez une route de service unifiée ou une révision de déploiement connue comme fonctionnelle jusqu’à ce que la configuration PD atteigne les seuils définis de latence et de fiabilité pour le mix de charges de travail qui compte.
Une séquence de déploiement sûre
- Référence : Capturez un benchmark SGLang unifié avec des prompts, sorties, niveaux de concurrence et cas de défaillance proches de la production.
- Une paire : Lancez un worker de préremplissage, un worker de décodage et un routeur ; validez les contrôles fonctionnels, de streaming, d’annulation et de redémarrage.
- Visibilité des rôles : Séparez les journaux, tableaux de bord, alertes et limites de capacité par routeur, préremplissage, transfert et décodage.
- Charge contrôlée : Comparez la PD à la référence par tranches de longueur de prompt et de longueur de sortie, et pas seulement selon une moyenne.
- Faites évoluer une contrainte à la fois : Ajustez la taille du pool, la configuration GPU, la concurrence ou la configuration de transfert dans des expériences distinctes.
- Canari et retour en arrière : Acheminez une portion limitée du trafic, définissez un seuil de retour en arrière pour la latence et les erreurs, et préservez la dernière configuration saine.
Cette séquence fait passer le préremplissage et décodage de la désagrégation PD SGLang d’un diagramme d’architecture prometteur à une modification testable en conditions opérationnelles.
Questions fréquentes
La désagrégation PD augmente-t-elle toujours le débit ?
Non. Elle peut améliorer une charge de travail pour laquelle la contention entre le préremplissage et le décodage constitue la contrainte, mais elle introduit également le transfert de KV, l’ordonnancement du routeur et une surcharge opérationnelle. Testez-la par rapport à une référence unifiée en utilisant le même mix de trafic et le même budget de capacité.
Le préremplissage s’exécute-t-il sur un modèle différent du décodage ?
Non. Les rôles poursuivent une même requête logique. Conservez le modèle, le tokenizer, la révision, la quantification et la configuration de serving testés alignés entre les deux, sauf si la documentation amont prend explicitement en charge une configuration différente.
Quel backend de transfert dois-je utiliser ?
Utilisez un backend pris en charge par votre version épinglée de SGLang et validé pour votre infrastructure réelle. La documentation actuelle de SGLang décrit Mooncake et NIXL, mais le bon choix dépend de la plateforme, de l’image de conteneur, des appareils et du support opérationnel que vous avez vérifiés.
Puis-je combiner la désagrégation du préremplissage et du décodage SGLang avec toutes les fonctionnalités avancées ?
Non. La prise en charge de PD est sensible aux fonctionnalités et aux versions. Consultez les notes de compatibilité amont actuelles avant de la combiner avec des réponses avec état, l’exécution d’outils, des fonctionnalités de cache, des modes de spéculation ou un comportement de rôle non standard.
La prochaine étape pratique
Commencez avec un environnement d’acceptation à une paire, consignez les seuils TTFT/ITL/erreurs qui justifient l’architecture, et ne promouvez qu’après avoir rendu observables les chemins de transfert et de défaillance. Pour les décisions de serving connexes, comparez vLLM et SGLang, examinez le décodage spéculatif pour l’inférence LLM et planifiez le cluster GPU Kubernetes sous-jacent séparément du déploiement PD.


