SGLangのPrefill/Decode分離:アーキテクチャとデプロイガイド
最終確認日:2026年10月16日。SGLangのフラグとサポートされる機能の組み合わせは急速に変化します。本ガイドを本番環境に適用する前に、テスト済みのSGLangイメージまたはコミットを固定してください。
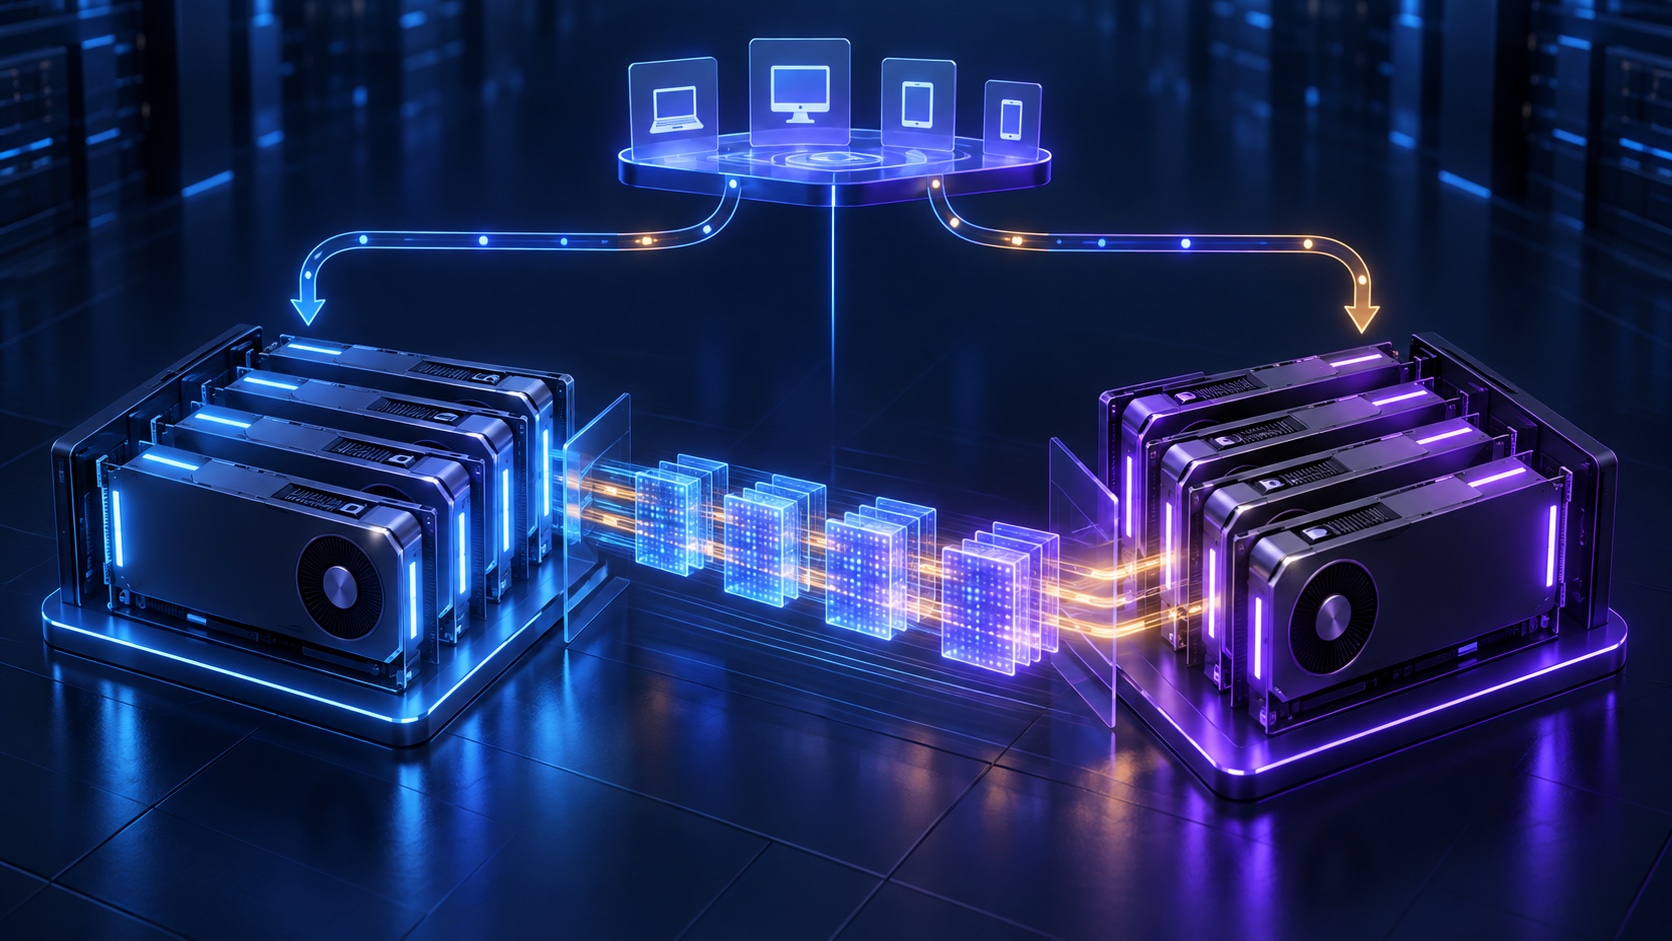
SGLangのPrefill/Decode分離は、LLMサービングにおける大きく異なる2つの処理を分けます。プロンプト処理はprefillプールで実行され、トークン生成はdecodeプールで実行されます。プール間でリクエストのKVキャッシュを交換し、ルーターがクライアントに単一の推論エンドポイントを提供します。
この分離により、長いプロンプトが到着した際のトークン間レイテンシを保護でき、計算負荷の高いprefill容量とメモリに制約されるdecode容量を異なる方法でスケールできます。一方で、転送経路、スケジューラの境界がもう1つ増え、互換性の対象範囲も広がります。これを、あらゆるワークロードを自動的に高速化するスイッチではなく、測定に基づくサービングアーキテクチャとして扱ってください。
本ガイドでは、SGLangのPrefill/Decode分離アーキテクチャ、最小限のデプロイ構成、測定すべき項目、およびロールアウトを中止すべき条件を説明します。
簡潔な結論:PD分離がその複雑さに見合う場合
SGLangのアップストリームドキュメントでは、prefillは計算集約型、decodeはKVキャッシュおよびメモリ集約型と説明されています。統合スケジューラでは、到着するprefill処理がdecode処理を中断する可能性があります。データ並列attentionでは、異なるワーカー間で2つのフェーズのバランスが崩れる場合もあります。PD分離ではこれらのフェーズを分離するため、それぞれを独立してスケジューリングおよびプロビジョニングできます。現在サポートされている組み合わせについては、SGLangのPDドキュメントが信頼できる情報源です。
| ワークロードの兆候 | SGLangのPrefill/Decode分離は有力な候補か? | 理由 |
|---|---|---|
| 長い、または変動が大きいプロンプトがあり、ユーザーがストリーミングの滑らかさを重視する | 多くの場合、適している | 長いprefillが稼働中のdecodeプールを中断しにくくなります。 |
| decodeのメモリ負荷が、プロンプト処理の計算負荷と大きく異なる | 多くの場合、適している | 実際のボトルネックに応じてプールのサイズと同時実行数の上限を設定できます。 |
| マルチノードGPUデプロイメントにおいて、低レイテンシのKV転送ファブリックがすでに検証済みである | 多くの場合、適している | 追加される転送境界を運用上現実的に扱えます。 |
| 小規模なGPUサーバー1台、短く均一なプロンプト、または低トラフィック | 通常、最初の選択肢ではない | 統合サーバーの方がシンプルであり、転送オーバーヘッドを回避できる場合があります。 |
| プロセスローカルの応答履歴または組み込みサーバーツールに依存するワークロード | 検証されるまでは不可 | 現在のアップストリームPDドキュメントでは、ステートフルなResponse APIワークフローと組み込みツールが、サポート対象外のワークフローとして挙げられています。 |
判断基準は「prefillは速く、decodeは遅い」ではありません。キューとハードウェアの制約を分離することで、重視するユーザー可視の目標、通常は最初のトークンまでの時間(TTFT)、トークン間レイテンシ(ITL)、テールレイテンシ、または固定容量予算内で完了するリクエスト数が改善するかどうかです。
SGLangにおけるPrefill/Decode分離の仕組み
SGLangのPDトポロジーには、3つの論理的な役割があります。
- ルーター:クライアントリクエストを受信し、prefillおよびdecodeの経路を選択して、統合した応答をクライアントへストリーミングで返します。
- Prefillワーカー:完全なプロンプトをトークン化して処理し、生成を継続するために必要なKVキャッシュ状態を生成します。
- Decodeワーカー:そのKV状態を受け取り、リクエストが完了するまで出力トークンを生成します。
重要なのはハンドオフです。prefillワーカーはテキストを新しいデコーダーに送って、プロンプトを繰り返し処理させるわけではありません。KVキャッシュ状態を転送することで、decodeが同じattentionコンテキストから継続できるようにします。SGLangは現在、MooncakeとNIXLをPD転送エンジンとして文書化しています。固定したバージョンとハードウェアで実際にサポートされるトランスポートおよびネットワーク経路を選択してください。
client
  │
  ▼
PD router ──► prefill pool ──► KV-cache transfer ──► decode pool ──► streamed tokens
                 compute-heavy          fabric            memory-sensitive
マルチノードクラスターでは、各役割に独自のレプリカ数、GPU構成、キュー上限、オートスケーリングポリシー、障害許容予算を設定できます。ただし、ルーターとKV転送ファブリックを見えない接着剤ではなく、本番環境の依存コンポーネントとして扱う場合にのみ有用です。
デプロイ前:誤解を招く結果を防ぐ5つのチェック
1. 正確なSGLangリリースとモデル構成を固定する
ルーター、prefillワーカー、decodeワーカー全体で、同じテスト済みのSGLangイメージまたはコミットを実行してください。モデルリビジョン、トークナイザー、量子化、attentionバックエンド、並列化戦略、モデル固有のフラグをマニフェストで明示的に指定してください。あるバージョンで動作したコマンドが、別のバージョンでは無効であったり、意味が異なったりする可能性があります。
2. トラフィックをスケールする前にKV転送経路を検証する
PDはデータプレーンのアーキテクチャです。モデルのレイテンシを解釈する前に、NICまたはインターコネクトのマッピング、コンテナへのデバイス公開、ホスト制限、転送バックエンドを検証してください。Mooncake固有のデプロイではInfiniBand/RDMAの構成が必要になる場合があります。SGLangのドキュメントには、互換性のあるインフラストラクチャ向けのNIXLバックエンド選択も記載されています。高速な集団通信パスがあるからといって、KV転送パスが正常であると自動的に判断してはいけません。
3. 統合サーバーのベースラインを確立する
ベースラインとPDテストでは、同じモデル、プロンプト、生成長、同時実行性の構成、サンプリング設定、ハードウェア予算を使用してください。少なくともp50/p95 TTFT、p50/p95 ITL、リクエストスループット、キャンセル動作、エラー率を測定します。GPU使用率の数値が高いだけでは、サービングの成果を示すものではありません。
4. スケジューラ内のロール境界を定義する
prefillとdecodeのPod、サービス、ログ、アラートを個別に参照できる状態にしてください。どのロールでキューイングが発生しているか、KV容量が不足しているか、転送待ちになっているかを判別できない場合、このアーキテクチャは統合フリートよりも運用が困難になります。
5. クイックスタートブロックだけでなく、現行の互換性制約を確認する
SGLang prefill decode disaggregationのドキュメントには、特定のポリシーおよびステートフルなワークフローに関する制限事項が記載されています。たとえば、文書化されているprefill_completeのdecode割り当てポリシーは、デフォルトポリシーよりもサポート範囲が限定されています。可用性の約束の一部にする前に、すべての高度な機能の組み合わせをステージング環境で検証してください。
最小構成のSGLang prefill decode disaggregationデプロイ
2 GPUホスト上で、prefillワーカー1台、decodeワーカー1台、ルーター1台から始めます。これは機能受け入れテストであり、2 GPUが本番向けの構成であるという主張ではありません。以下のNIXLの例は、現在のアップストリームの単一ノードパターンに従っています。固定したSGLangバージョンに対応する正確なコマンド構文は、ドキュメントを使用してください。
# GPU 0: prefill role
python -m sglang.launch_server \
  --model-path meta-llama/Llama-3.1-8B-Instruct \
  --disaggregation-mode prefill \
  --disaggregation-transfer-backend nixl \
  --port 30000

# GPU 1: decode role
python -m sglang.launch_server \
  --model-path meta-llama/Llama-3.1-8B-Instruct \
  --disaggregation-mode decode \
  --disaggregation-transfer-backend nixl \
  --base-gpu-id 1 \
  --port 30001

# Client-facing PD router
python -m sglang_router.launch_router \
  --pd-disaggregation \
  --prefill http://127.0.0.1:30000 \
  --decode http://127.0.0.1:30001 \
  --host 0.0.0.0 \
  --port 8000
いずれかのワーカーに直接送信するのではなく、ルーター経由で短いリクエストを送信してください。
curl http://127.0.0.1:8000/v1/completions \
  -H 'Content-Type: application/json' \
  -d '{
    "model": "meta-llama/Llama-3.1-8B-Instruct",
    "prompt": "Explain why KV-cache handoff matters in one sentence.",
    "max_tokens": 64
  }'
成功はテキストを受け取ること以上の意味を持ちます。ルーターが両方のロールを選択したこと、KV転送が完了したこと、ストリーミング動作が維持されていること、各プロセスが想定どおりのモデルおよび互換性設定を報告していることを確認してください。この小規模なSGLang prefill decode disaggregationデプロイをCIまたは本番前環境に維持し、アップグレードによってPDパスが気付かないうちに壊れないようにしてください。
Mooncakeのデプロイでは、必要な転送エンジンのインストールおよびIBデバイス構成について、最新のSGLang PDガイドを使用してください。別のトランスポート、クラウド、またはSGLangリリースのMooncake環境変数をコピーしないでください。
1組から本番トポロジーへ移行する
基本的な1組が正常に動作したら、想定された1:1比率ではなく、キューおよびリソースのデータに基づいて各ロールをスケールしてください。
| レイヤー | この観測結果に基づいてスケール | 実践的な制御 |
|---|---|---|
| Prefillプール | プロンプトキューが増大する、prefill計算が飽和する、またはTTFTのテールレイテンシが上昇する | 制御されたテストの後にprefillレプリカを追加するか、prefill GPU構成を変更します。 |
| Decodeプール | アクティブシーケンスがKV容量を使い切る、ITLのテールレイテンシが上昇する、またはdecodeの受付が待機する | モデルのメモリフットプリントを検証した後にのみ、decodeレプリカを追加する、同時実行性を下げる、またはワーカーあたりのメモリを増やします。 |
| KV転送ファブリック | 転送時間または転送エラーがリクエストタイムラインの大半を占める | モデルレプリカを追加する前に、デバイスマッピング、バックエンド、ファブリックの健全性、トポロジーの近接性を検証します。 |
| ルーター | 正常でないワーカーの入れ替わり、不均一なキュー、またはルーティング遅延が発生する | SGLangリリースでサポートされる本番用ルータートポロジーおよびポリシーを使用します。 |
マルチノードパターンについては、SGLangはDeepSeekクラスのデプロイ向けに、ロール固有の分散初期化および並列化引数を含む、prefillとdecodeを別々に起動する例を公開しています。これらの例は有用なテンプレートですが、モデル、ハードウェア、SGLangバージョンについては、依然として独自の受け入れテストが必要です。クラスターマニフェストを適応させる前に、アップストリームのマルチノードPDの例を確認してください。
Kubernetes がライフサイクルを管理する場合は、prefill と decode にそれぞれ別のラベル、サービス、中断予算、ダッシュボード、readiness probe を設定してください。GPU の公開、キューイング、ストレージ、ネットワーク、可観測性など、より広範なクラスターの前提条件については、Kubernetes GPU クラスターガイドで解説しています。
SGLang prefill/decode 分離の指標
SGLang prefill/decode 分離は、単にリソースチャートを変えるのではなく、選定したワークロードの成果を改善する必要があります。リクエストタイムラインを、prefill、転送、decode 受け入れ、生成の各区間に分けて計測してください。
| 指標 | 明らかになること | 併せて確認する項目 |
|---|---|---|
| TTFT、p50、p95 | プロンプトのキューイング、prefill 実行、引き渡し | プロンプト長のバケットと prefill キュー深度 |
| ITL、p50、p95 | 生成開始後のトークン出力ペース | アクティブな decode シーケンスと decode KV 使用率 |
| KV 転送時間とエラー | 引き渡しがボトルネックまたは障害原因になっているかどうか | ファブリックのスループット、リトライ、NIC の正常性、バックエンドログ |
| Prefill/decode キュー滞留時間 | プール比率が誤っているかどうか | ロール別レプリカ数と同時実行数の上限 |
| 1 秒あたりの完了リクエスト数 | 実際のワークロード構成における有効な処理能力 | エラー率、キャンセル率、レイテンシ SLO |
| GPU コンピュート、HBM、ホスト CPU の使用率 | 結果そのものではなく、診断を補助する情報 | 上記の 4 つのリクエストステージ時間 |
テストセットは 2 種類実行してください。一方は現在想定しているトラフィック構成を使用し、もう一方には長いプロンプト、可変の生成長、キャンセル、バーストを意図的に含めます。PD は平均的な合成プロンプトでは優れた結果に見える場合がありますが、偏りのある本番ワークロード構成では本来の目的を果たせないことがあります。
Decode 割り当てポリシー:デフォルトのチューニング手法ではなく、対象を絞った制御
デフォルトでは、SGLang は early の decode 割り当て動作を文書化しています。これは、prefill が完了する前に宛先 KV スロットを予約するものです。そのため、長い prefill が decode 側で KV データを待つ間、decode 容量を占有する可能性があります。
文書化されている代替手段は次のとおりです。
--disaggregation-decode-allocation-policy prefill_complete
prefill_complete では、SGLang は prefill の準備が整うまで宛先の割り当てを遅延させます。長いプロンプトが、アクティブな decode トラフィックと宛先 KV 容量を競合する場合に有効なことがありますが、オーバーラップとサポート範囲も変化します。アップストリームのドキュメントでは、prefill と decode の両方にポリシーを設定すること、および複数の互換性のない組み合わせがあることが示されています。これは普遍的な最適化ではなく、ロールバック基準を備えた管理された実験として扱ってください。
一般的な障害モードと最速の次の確認事項
| 症状 | 確認すべき可能性が高い境界 | 最速の次の確認 |
|---|---|---|
| ルーターはリクエストを受け付けるが、トークンが返らない | ワーカー到達性、またはロール間の引き渡し失敗 | ルーターログ、ワーカーの正常性、prefill から decode までをまたぐ 1 つのトレースを確認します。 |
| prefill は正常だが decode 待機時間が増加する | Decode の受け入れ処理、または宛先 KV の逼迫 | 任意に prefill 容量を追加する前に、アクティブなシーケンス、KV 使用率、割り当てポリシーを確認します。 |
| TTFT は改善するが ITL が悪化する | Decode プール、または KV 転送のボトルネック | 統合構成のベースラインと比較して、decode キュー滞留時間、転送時間、アクティブシーケンス数を比較します。 |
| マルチノードトラフィックが断続的にハングまたはリトライする | ネットワークファブリック、デバイスマッピング、または一貫しないワーカー設定 | すべてのノードで、正確な SGLang ビルド、転送バックエンド、NIC マッピング、ロールマニフェストを確認します。 |
| 高度な機能が統合モードでは動作するが PD では失敗する | サポートされていない機能の組み合わせ | 最新の PD 互換性セクションを読み、サポート対象の最小トポロジーで再現します。 |
| GPU 使用率は上がるがユーザーレイテンシは改善しない | 最適化の対象ステージが誤っている | TTFT、ITL、キュー滞留時間、エラー、完了ワークロードのスループットに戻って確認します。 |
SGLang prefill/decode 分離のロールアウトは可逆的であるべきです。重要なワークロード構成全体で PD 構成が定義済みのレイテンシおよび信頼性しきい値を満たすまで、統合サービングルートまたは既知の正常なデプロイメントリビジョンを維持してください。
安全なロールアウト手順
- ベースライン:本番に近いプロンプト、出力、同時実行性、障害ケースを用いて、統合 SGLang のベンチマークを取得します。
- 1 組:prefill ワーカー 1 台、decode ワーカー 1 台、ルーターを起動し、機能、ストリーミング、キャンセル、再起動のチェックを通過させます。
- ロールの可視性:ルーター、prefill、転送、decode ごとに、ログ、ダッシュボード、アラート、容量上限を分離します。
- 制御された負荷:平均値だけでなく、プロンプト長と出力長のバケット別に、PD をベースラインと比較します。
- 一度に 1 つの制約をスケール:プールサイズ、GPU 構成、同時実行性、転送構成を、それぞれ別の実験で調整します。
- カナリアとロールバック:限定したトラフィック割合をルーティングし、レイテンシおよびエラーのロールバックしきい値を定義し、最後に正常だった構成を保持します。
この手順により、SGLang PD disaggregation prefill decode は有望なアーキテクチャ図から、運用上テスト可能な変更へと変わります。
よくある質問
PD分離は常にスループットを向上させますか?
いいえ。prefillとdecodeの競合が制約となっているワークロードでは改善する可能性がありますが、KV転送、ルーターのスケジューリング、運用上のオーバーヘッドも導入されます。同じトラフィック構成と容量予算を使用して、統合型のベースラインと比較してテストしてください。
prefillはdecodeとは異なるモデルで実行されますか?
いいえ。これらのロールは1つの論理リクエストを継続します。アップストリームのドキュメントで異なる構成が明示的にサポートされている場合を除き、検証済みのモデル、トークナイザー、リビジョン、量子化、およびサービング構成をペア間で一致させてください。
どの転送バックエンドを使用すべきですか?
固定したSGLangリリースでサポートされ、実際のファブリックで検証済みのバックエンドを使用してください。現在のSGLangドキュメントではMooncakeとNIXLが説明されていますが、正しい選択は、検証済みのプラットフォーム、コンテナイメージ、デバイス、および運用サポートによって異なります。
SGLang prefill decode disaggregationはすべての高度な機能と組み合わせられますか?
いいえ。PDのサポートは機能とバージョンに依存します。ステートフル応答、ツール実行、キャッシュ機能、speculationモード、または標準外のロール動作と組み合わせる前に、最新のアップストリーム互換性に関する注記を確認してください。
実践的な次のステップ
まずは1ペアの受け入れ環境から始め、アーキテクチャを正当化するTTFT/ITL/エラーのしきい値を文書化し、転送パスと障害パスを可観測にしてから昇格してください。関連するサービングの判断については、vLLM vs. SGLangを比較し、LLM推論のためのspeculative decodingを確認し、PDのロールアウトとは別に基盤となるKubernetes GPU clusterを計画してください。