SGLang 预填充与解码分离:架构与部署指南
最后验证时间:2026 年 10 月 16 日。SGLang 的标志参数和支持的功能组合变化很快;在生产环境应用本指南之前,请固定已测试的 SGLang 镜像或提交版本。
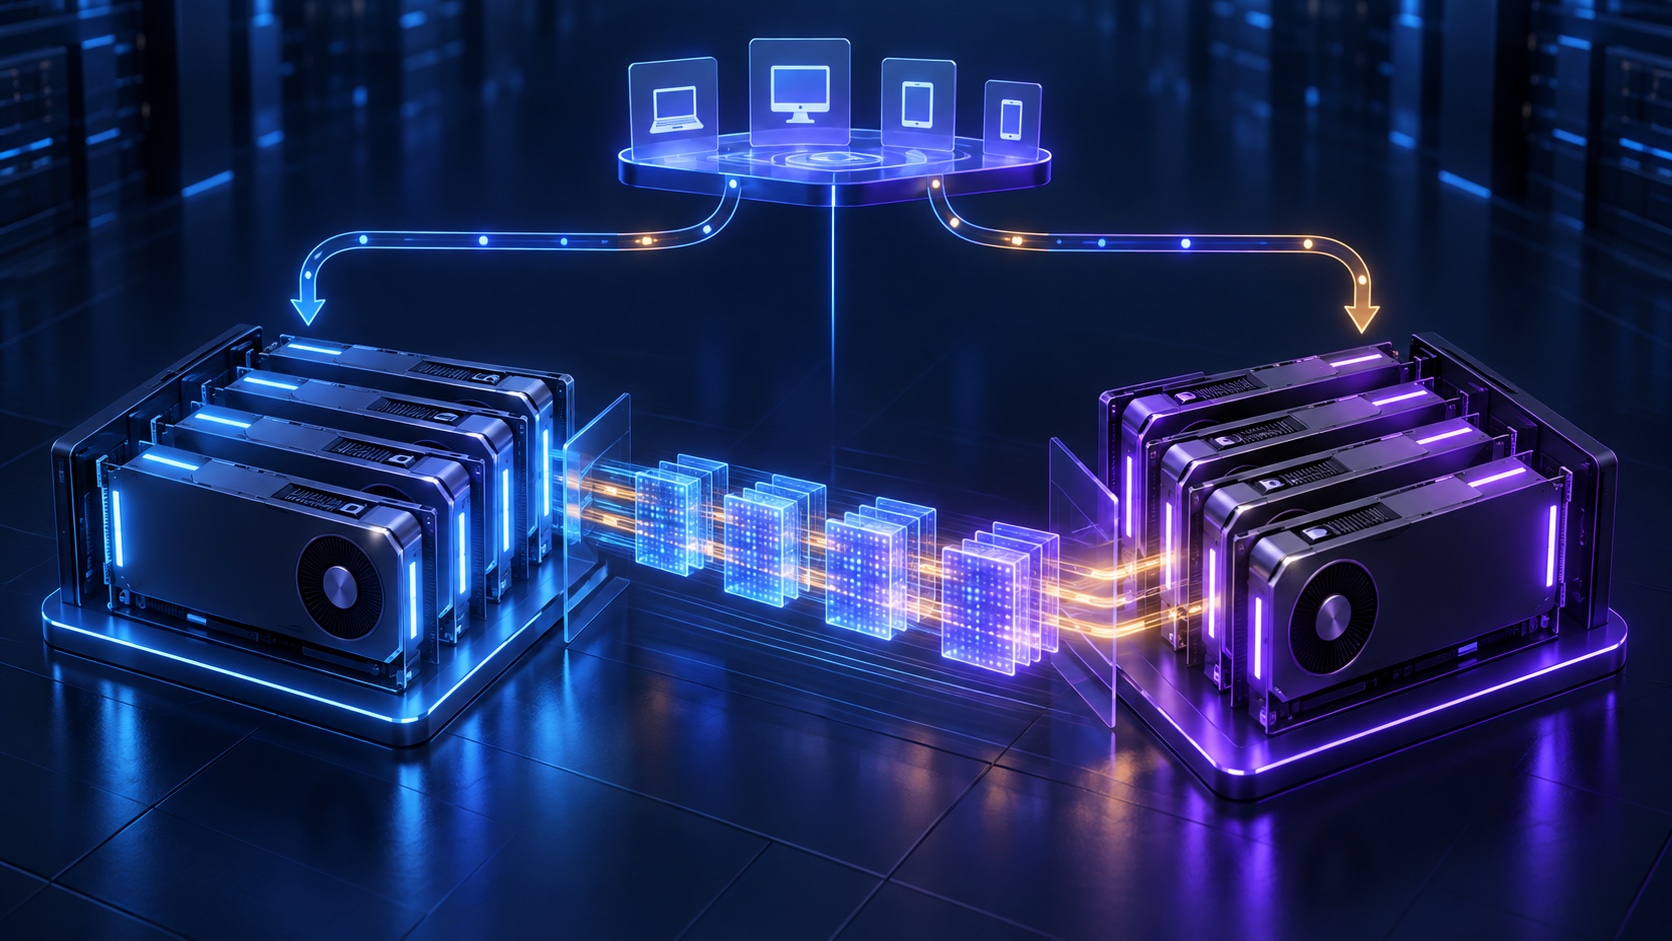
SGLang 预填充与解码分离将 LLM 服务中的两项截然不同的工作分开:提示词处理在预填充池中运行,而令牌生成在解码池中运行。这些池会交换请求的 KV 缓存,并由路由器向客户端提供一个推理端点。
当长提示词到达时,这种分离可以保护令牌间延迟;它还使你能够以不同方式扩展计算密集型的预填充容量和受内存限制的解码容量。不过,它也增加了一条传输路径、一个额外的调度器边界以及更大的兼容性范围。应将其视为一种经过测量的服务架构,而不是一个会自动让每种工作负载都变快的开关。
本指南说明 SGLang 预填充与解码分离的架构、最小部署形态、需要测量的指标,以及应停止推广部署的条件。
快速回答:何时 PD 分离值得其复杂性
SGLang 的上游文档将预填充描述为计算密集型,将解码描述为 KV 缓存和内存密集型。在统一调度器中,传入的预填充工作可能会中断解码工作;使用数据并行注意力时,不同工作器在这两个阶段之间也可能出现负载不均衡。PD 分离会将这些阶段分开,以便可以独立调度和配置各自的资源。SGLang 的 PD 文档是当前受支持组合的权威来源。
| 工作负载信号 | SGLang 预填充与解码分离是否是合适的候选方案? | 原因 |
|---|---|---|
| 提示词较长或变化很大,且用户对流式输出的平滑性敏感 | 通常是 | 长时间预填充较不容易中断活跃的解码池。 |
| 解码内存压力与提示词计算压力存在显著差异 | 通常是 | 你可以根据各自的实际瓶颈来确定池规模和并发限制。 |
| 多节点 GPU 部署已经具备经过验证的低延迟 KV 传输网络 | 通常是 | 新增的传输边界在运维上是现实可行的。 |
| 一台小型 GPU 服务器、简短且统一的提示词,或低流量 | 通常不是首选 | 统一服务器更简单,并且可能避免传输开销。 |
| 依赖进程本地响应历史或内置服务器工具的工作负载 | 否,除非已验证 | 当前上游 PD 文档将有状态的 Response API 工作流和内置工具列为不受支持的工作流。 |
决策不在于“预填充快、解码慢”。关键在于,隔离它们的队列和硬件限制是否能改善你关心的用户可见目标——通常是首个令牌时间(TTFT)、令牌间延迟(ITL)、尾延迟,或在固定容量预算下完成的请求数。
SGLang 中的预填充与解码分离如何工作
SGLang PD 拓扑包含三个逻辑角色:
- 路由器:接收客户端请求,选择预填充和解码路径,并将合并后的响应流式返回给客户端。
- 预填充工作器:对完整提示词进行分词和处理,然后生成继续生成所需的 KV 缓存状态。
- 解码工作器:接收该 KV 状态,并生成输出令牌,直到请求完成。
交接是关键部分。预填充工作器不会将文本发送给一个全新的解码器,再让它重复处理提示词。它会传输 KV 缓存状态,使解码能够从相同的注意力上下文继续进行。SGLang 当前将 Mooncake 和 NIXL 作为 PD 传输引擎进行说明;请选择你的固定版本和硬件实际支持的传输方式及网络路径。
客户端
  │
  ▼
PD 路由器 ──► 预填充池 ──► KV 缓存传输 ──► 解码池 ──► 流式令牌
                 计算密集型          网络             内存敏感型
在多节点集群中,每个角色都可以拥有自己的副本数量、GPU 规格、队列限制、自动扩缩容策略和故障预算。只有将路由器和 KV 传输网络视为生产依赖项而非隐形的黏合层时,这才有价值。
部署之前:避免误导性结果的五项检查
1. 固定确切的 SGLang 版本和模型配置
在路由器、预填充工作器和解码工作器之间运行同一个经过测试的 SGLang 镜像或提交版本。在清单中明确指定模型修订版本、分词器、量化方式、注意力后端、并行策略以及模型特定标志参数。在某个版本中可用的命令,在另一个版本中可能无效或具有不同语义。
2. 在扩展流量之前验证 KV 传输路径
PD 是一种数据平面架构。在解读模型延迟之前,请验证 NIC 或互连映射、容器设备暴露、主机限制以及传输后端。Mooncake 特定部署可能需要 InfiniBand/RDMA 配置;SGLang 文档还说明了如何为兼容基础设施选择 NIXL 后端。不要认为快速的集合通信路径自动证明 KV 传输路径正常。
3. 建立统一服务器基线
对基线和 PD 测试使用相同的模型、提示词、生成长度、并发组合、采样设置和硬件预算。至少测量 p50/p95 TTFT、p50/p95 ITL、请求吞吐量、取消行为和错误率。仅仅较高的 GPU 利用率数字并不代表服务效果。
4. 在调度器中定义角色边界
确保预填充和解码 Pod、服务、日志及告警可以分别寻址。如果无法确定哪个角色正在排队、KV 容量不足或等待传输,那么该架构的运维难度将高于统一集群。
5. 阅读当前兼容性约束——而不只是快速入门代码块
SGLang 预填充与解码分离文档包含针对特定策略和有状态工作流的限制。例如,文档中说明的 prefill_complete 解码分配策略的支持范围比默认策略更窄。在将每一种高级功能组合纳入可用性承诺之前,请先在预发布环境中验证。
最小化 SGLang 预填充与解码分离部署
从在一台双 GPU 主机上部署一个预填充工作进程、一个解码工作进程和一个路由器开始。这是一项功能验收测试,并不意味着两块 GPU 就是生产环境规格。以下 NIXL 示例遵循当前上游的单节点模式;请使用与所固定 SGLang 版本对应的文档中的准确命令语法。
# GPU 0: prefill role
python -m sglang.launch_server \
  --model-path meta-llama/Llama-3.1-8B-Instruct \
  --disaggregation-mode prefill \
  --disaggregation-transfer-backend nixl \
  --port 30000

# GPU 1: decode role
python -m sglang.launch_server \
  --model-path meta-llama/Llama-3.1-8B-Instruct \
  --disaggregation-mode decode \
  --disaggregation-transfer-backend nixl \
  --base-gpu-id 1 \
  --port 30001

# Client-facing PD router
python -m sglang_router.launch_router \
  --pd-disaggregation \
  --prefill http://127.0.0.1:30000 \
  --decode http://127.0.0.1:30001 \
  --host 0.0.0.0 \
  --port 8000
通过路由器发送一个简短请求,而不是直接发送给任一工作进程:
curl http://127.0.0.1:8000/v1/completions \
  -H 'Content-Type: application/json' \
  -d '{
    "model": "meta-llama/Llama-3.1-8B-Instruct",
    "prompt": "Explain why KV-cache handoff matters in one sentence.",
    "max_tokens": 64
  }'
成功不仅意味着收到了文本。请确认路由器选择了两个角色、KV 传输已完成、流式行为完好无损,并且每个进程均报告了预期的模型和兼容性设置。请将这一小型SGLang 预填充与解码分离部署保留在 CI 或预生产环境中,以便升级不会悄然破坏 PD 路径。
对于 Mooncake 部署,请使用当前的 SGLang PD 指南了解所需的传输引擎安装和 IB 设备配置。不要从不同传输方式、云环境或 SGLang 版本复制 Mooncake 环境变量。
从一组实例迁移到生产拓扑
当基础实例组运行正常后,应根据队列和资源数据扩展各个角色,而不是假定 1:1 比例。
| 层级 | 基于此观察进行扩展 | 实用控制措施 |
|---|---|---|
| 预填充池 | 提示词队列增长、预填充计算饱和,或 TTFT 尾延迟上升 | 在受控测试后增加预填充副本,或更改预填充 GPU 规格。 |
| 解码池 | 活动序列耗尽 KV 容量、ITL 尾延迟上升,或解码准入等待 | 增加解码副本、降低并发度,或仅在验证模型内存占用后增加每个工作进程的内存。 |
| KV 传输网络 | 传输时间或传输错误在请求时间线中占主导地位 | 在增加模型副本之前,验证设备映射、后端、网络健康状况和拓扑邻近性。 |
| 路由器 | 出现不健康工作进程频繁变动、队列不均衡或路由延迟 | 使用由您的 SGLang 版本支持的生产级路由器拓扑和策略。 |
对于多节点模式,SGLang 发布了适用于 DeepSeek 类部署的独立预填充和解码启动示例,其中包括角色特定的分布式初始化和并行度参数。这些示例是有用的模板,但模型、硬件和 SGLang 版本仍需要各自的验收测试。在调整集群清单之前,请参阅上游的多节点 PD 示例。
如果 Kubernetes 负责生命周期管理,请为预填充和解码分别设置标签、服务、中断预算、仪表板和就绪探针。更广泛的集群前提条件——GPU 暴露、排队、存储、网络和可观测性——请参阅我们的Kubernetes GPU 集群指南。
SGLang 预填充与解码分离的指标
SGLang 预填充与解码分离应改善选定的工作负载结果,而不只是生成不同的资源图表。对请求时间线进行埋点,分别记录预填充、传输、解码准入和生成的时间区间。
| 指标 | 揭示的信息 | 结合以下指标解读 |
|---|---|---|
| TTFT,p50 和 p95 | 提示词排队时间加上预填充执行和交接时间 | 提示词长度分桶和预填充队列深度 |
| ITL,p50 和 p95 | 生成开始后的 Token 输出节奏 | 活跃解码序列和解码 KV 占用率 |
| KV 传输时长和错误 | 交接是否是瓶颈或故障来源 | 网络吞吐量、重试、NIC 健康状况和后端日志 |
| 预填充/解码队列等待时长 | 资源池比例是否不合理 | 角色专属副本数和并发限制 |
| 每秒完成的请求数 | 实际流量组合下的有效容量 | 错误率、取消率和延迟 SLO |
| GPU 计算、HBM 和主机 CPU 利用率 | 用于辅助诊断,而非最终结果 | 上述四个请求阶段的耗时 |
运行两组测试。一组应使用您当前预期的流量组合;另一组应有意包含长提示词、可变的生成长度、取消操作和突发流量。PD 在平均合成提示词上可能看起来表现出色,但在存在偏斜的生产流量组合下却可能无法实现其真正目的。
解码分配策略:有针对性的控制,而非默认调优技巧
默认情况下,SGLang 文档说明了 early 解码分配行为:在预填充完成之前就预留目标 KV 槽位。因此,长预填充可能会占用解码容量,而解码端仍在等待 KV 数据。
文档中提供的替代方案是:
--disaggregation-decode-allocation-policy prefill_complete
使用 prefill_complete 时,SGLang 会将目标端分配延迟到预填充就绪后。这有助于解决长提示词与活跃解码流量争夺目标 KV 容量的问题,但也会改变重叠方式和支持范围。上游文档指出,应在预填充端和解码端都设置该策略,并列出了若干不兼容的组合。应将其视为带有回滚标准的受控实验,而非通用优化手段。
常见故障模式及最快的后续检查
| 症状 | 可能需要检查的边界 | 最快的后续检查 |
|---|---|---|
| 路由器接受请求,但没有返回 Token | 工作节点可达性或角色交接失败 | 检查路由器日志、工作节点健康状态,以及一条覆盖预填充到解码的追踪记录。 |
| 预填充正常,但解码等待时间持续增长 | 解码准入或目标 KV 压力 | 在随意增加预填充容量之前,检查活跃序列、KV 占用率和分配策略。 |
| TTFT 改善,但 ITL 变差 | 解码池或 KV 传输瓶颈 | 将解码队列等待时长、传输时长和活跃序列数与统一模式基线进行比较。 |
| 多节点流量间歇性挂起或重试 | 网络结构、设备映射或工作节点配置不一致 | 在每个节点上验证确切的 SGLang 构建版本、传输后端、NIC 映射和角色清单。 |
| 某项高级功能在统一模式下有效,但在 PD 中失败 | 不受支持的功能组合 | 阅读当前 PD 兼容性章节,并使用最小受支持拓扑进行复现。 |
| GPU 利用率上升,但用户延迟没有改善 | 优化针对了错误的阶段 | 回到 TTFT、ITL、队列等待时长、错误和已完成工作吞吐量。 |
SGLang 预填充与解码分离的上线应当可逆。在 PD 配置针对关键工作负载组合达到既定的延迟和可靠性阈值之前,请保留统一服务路由或已知正常的部署修订版本。
安全的上线顺序
- 基线:使用接近生产环境的提示词、输出、并发度和故障场景,采集统一 SGLang 的基准测试结果。
- 一组配对:启动一个预填充工作节点、一个解码工作节点和一个路由器;通过功能、流式传输、取消和重启检查。
- 角色可见性:按路由器、预填充、传输和解码拆分日志、仪表板、告警和容量限制。
- 受控负载:按提示词长度和输出长度分桶将 PD 与基线进行比较,而非仅比较平均值。
- 一次扩展一个约束:在独立实验中调整资源池大小、GPU 规格、并发度或传输配置。
- 金丝雀发布和回滚:将有限比例的流量导入新配置,定义延迟/错误回滚阈值,并保留最后一个健康配置。
这一流程将SGLang PD 预填充与解码分离从一个颇具前景的架构图转变为可在运营环境中测试的变更。
常见问题
PD 分离是否总能提高吞吐量?
不一定。它可能改善预填充与解码争用是瓶颈的工作负载,但也会引入 KV 传输、路由器调度和运维开销。请在相同流量组合和容量预算下,针对统一式基线进行测试。
预填充是否在与解码不同的模型上运行?
不是。这两个角色延续的是同一个逻辑请求。除非上游文档明确支持不同的配置,否则应确保该角色对中已测试的模型、分词器、版本、量化和服务配置保持一致。
我应该使用哪种传输后端?
请使用你的固定 SGLang 版本所支持、且已针对实际网络结构完成验证的后端。当前 SGLang 文档介绍了 Mooncake 和 NIXL,但正确选择取决于你已验证的平台、容器镜像、设备和运维支持。
我可以将 SGLang 预填充与解码分离和所有高级功能结合使用吗?
不可以。PD 支持对功能和版本较为敏感。在将其与有状态响应、工具执行、缓存功能、推测模式或非标准角色行为结合使用之前,请查阅当前上游兼容性说明。
实用的下一步
先从一个单对验收环境开始,明确记录能够证明该架构合理性的 TTFT/ITL/错误阈值,并且仅在传输和故障路径可观测后再进行推广。对于相邻的服务决策,可比较vLLM 与 SGLang,查阅用于 LLM 推理的推测解码,并将底层Kubernetes GPU 集群的规划与 PD 推广分开进行。