Was ist eine KI-API?
Eine KI-API ist eine dokumentierte Möglichkeit für Software, eine KI-Funktion von einem anderen Dienst anzufordern. Eine Anwendung sendet eine strukturierte Anfrage – häufig einen Prompt, ein Bild, eine Audiodatei oder ein Dokument – zusammen mit Zugangsdaten sowie einem Modell- oder Vorgangsnamen. Der Dienst gibt ein strukturiertes Ergebnis oder einen Ergebnisstrom zurück. Die Anwendung kann dann eine Antwort anzeigen, ein Ticket klassifizieren, Sprache transkribieren, ein Bild erstellen oder einen Workflow fortsetzen.
Die API ist die Schnittstelle, nicht das Modell selbst. Ein Modell führt die Inferenz durch; die API definiert, wie ein Client diese Arbeit anfordert, die Antwort empfängt und Fehler behandelt. Einige Anbieter hosten ihre eigenen Modelle. Andere bieten ein Gateway zu mehreren Modellen. Ein Entwickler kann auch ein offenes Modell hinter einer selbst gehosteten API betreiben. Die richtige Wahl hängt von der Aufgabe, den Datengrenzen, dem Nutzungsmuster und der Fähigkeit des Teams ab, Infrastruktur zu betreiben.
Wenn Ihnen der Begriff neu ist, beginnen Sie mit diesem mentalen Modell:
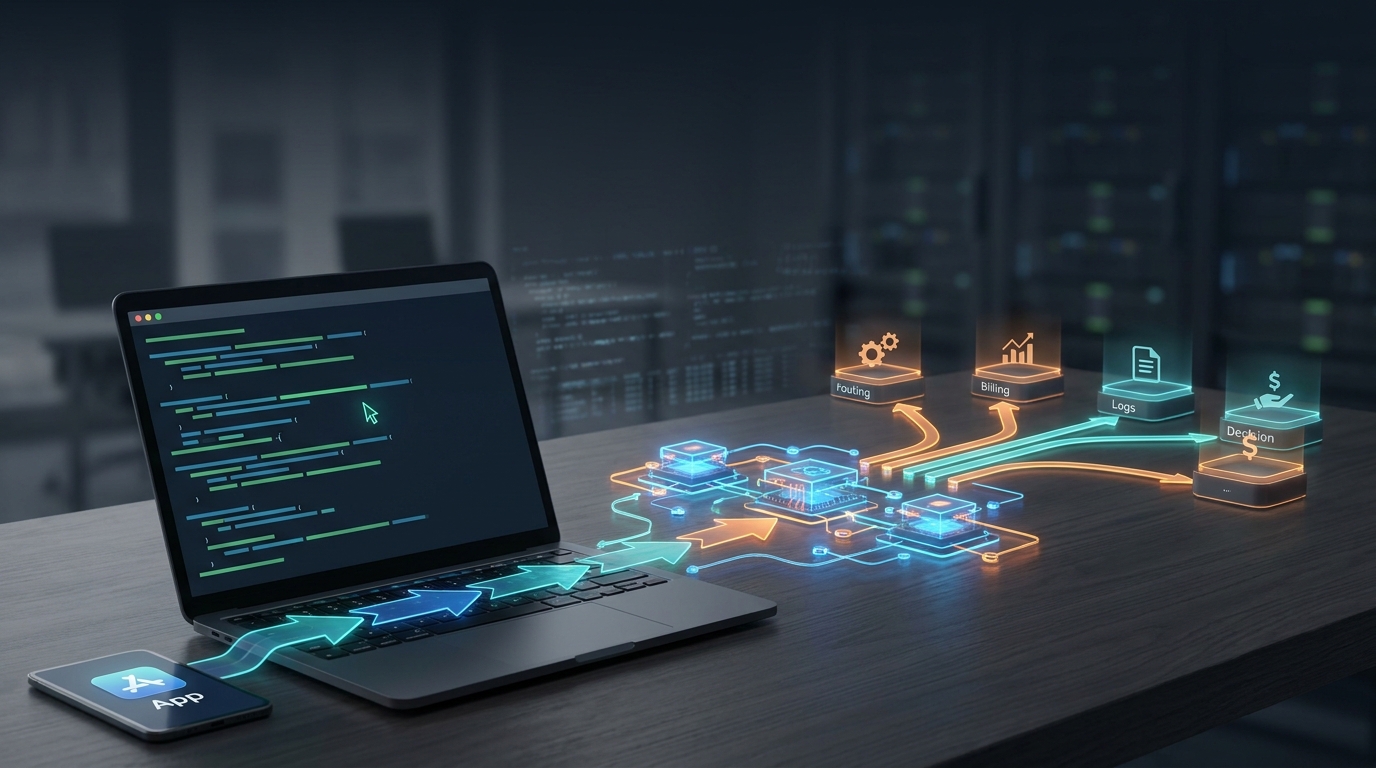
Ihre App → authentifizierte Anfrage → KI-API-Endpunkt → Modell oder Tool → strukturierte Antwort → Ihre App.
Eine allgemeine Definition einer API als Vertrag zwischen Software- komponenten finden Sie in der API-Erklärung von AWS. Der KI-spezifische Teil ist das Modell oder Tool, das die Anfrage verarbeitet.
Was kann eine KI-API leisten?
| Funktion | Typische Eingabe | Typische Ausgabe | Beispielanwendung |
|---|---|---|---|
| Textgenerierung | Prompt oder Konversationsnachrichten | Text oder strukturierte Daten | Eine Supportantwort zur menschlichen Prüfung entwerfen |
| Embeddings | Text oder andere unterstützte Inhalte | Numerischer Vektor | Semantisch ähnliche Dokumente finden |
| Bildgenerierung oder -bearbeitung | Prompt und optionales Bild | Bild-Asset | Ein Produktkonzeptbild erstellen |
| Sprache und Audio | Audio oder Text | Transkript oder synthetisiertes Audio | Ein Meeting transkribieren |
| Bild- und Dokumentanalyse | Bild, Dokument oder gemischte Eingabe | Beschreibung oder extrahierte Felder | Eine Rechnung mit Überprüfung auslesen |
| Tool- oder Datenzugriff | Abfrage- und Tool-Parameter | Suchergebnisse oder Aktionsergebnis | Aktuelle Fakten für einen Agenten abrufen |
Dies sind API-Familien, keine Garantie dafür, dass jedes Modell jeden Vorgang unterstützt. Ein reines Textmodell akzeptiert nicht automatisch Bilder, und ein Tool-Endpunkt ist nicht dasselbe wie ein Endpunkt für generative Modelle. Prüfen Sie den aktuellen Modellkatalog des Anbieters, die Endpunktdokumentation, Datei- limits und das Antwortschema, bevor Sie eine Funktion in Ihrem Produkt zusagen.
Wie eine KI-API-Anfrage funktioniert
Eine nützliche Anfrage besteht aus vier Teilen: einer Ziel-URL, Authentifizierung, einem Vorgang und einer Eingabe-Payload. Das Ziel identifiziert den Dienst und Endpunkt. Die Zugangsdaten identifizieren das Konto oder Projekt. Vorgang und Modell bestimmen, welche Arbeit angefordert wird. Die Payload liefert den Prompt oder die Medien sowie alle unterstützten Einstellungen.
Eine Produktionsanwendung sollte den Aufruf von ihrem Server aus durchführen, wo der API-Schlüssel geheim bleiben kann. Der Server validiert Benutzereingaben, setzt ein angemessenes Timeout, sendet die Anfrage und prüft die Antwort. Er sollte einen Authentifizierungsfehler von einem Ratenlimit, einem nicht verfügbaren Modell, einer ungültigen Payload oder einem Anbieterfehler unterscheiden. Die Benutzer- oberfläche sollte ein für die Anwendung sicheres Ergebnis statt roher Zugangsdaten oder ungefilterter Anbieterfehler erhalten.
Wenn der Vorgang Tokens oder Medien streamt, empfängt der Client Teile über die Zeit. Streaming kann die wahrgenommene Reaktionsfähigkeit verbessern, aber die Anwendung muss weiterhin Verbindungsabbrüche und unvollständige Ausgaben behandeln. Bei strukturierten Daten sollten Sie die zurückgegebene Struktur validieren, bevor Sie in eine Datenbank schreiben oder eine andere Aktion auslösen. Die überzeugende Antwort eines Modells ist kein Beweis dafür, dass eine angeforderte Tatsache korrekt ist.
Die Flatkey-Dokumentation beschreibt ihren aktuellen OpenAI-kompatiblen Router und unterstützte Workflows. Ein einheitlicher Router ermöglicht es einem Team, eine vertraute Client-Struktur beizubehalten und gleichzeitig Modell-IDs zu ändern; Sie sollten jedoch weiterhin modellspezifisches Verhalten und die Endpunktunterstützung testen. Die OpenAI- API-Plattform und die Claude-API- Dokumentation sind Beispiele für Schnittstellen direkter Anbieter mit ihren eigenen Anfrageverträgen.
KI- API im Vergleich zu einer KI-App, einem SDK, Gateway und selbst gehosteten Modell
Diese Begriffe überschneiden sich, lösen jedoch unterschiedliche Probleme:
- KI-App: das nutzerorientierte Produkt, etwa eine Chat- oberfläche oder ein Schreibwerkzeug. Es kann intern eine API aufrufen.
- KI-API: der programmatische Vertrag, der eine Anfrage akzeptiert und ein Ergebnis zurückgibt.
- SDK: eine Bibliothek, die Code beim Aufrufen einer API unterstützt. Ein SDK ist praktisch, aber der zugrunde liegende Endpunkt und die Kontoregeln sind weiterhin wichtig.
- API-Gateway oder Modellrouter: eine Schicht, die gemeinsame Authentifizierung, Routing, Kontingente, Aufzeichnungen und Richtlinien anwenden kann, bevor Datenverkehr einen oder mehrere Modellanbieter erreicht.
- Selbst gehosteter Inferenzserver: Software, die eine API für Modellgewichte bereitstellt, die auf Kapazitäten laufen, die Sie kontrollieren. Sie verantworten Verfügbarkeit, Skalierung, Patches und Kosten.
Ein Gateway ersetzt nicht die Auswahl eines geeigneten Modells. Ein selbst gehosteter Server ist nicht automatisch günstiger als eine API. Eine gehostete API ist nicht automatisch für jede Daten- oder Latenzanforderung geeignet. Zeichnen Sie den vollständigen Anfragepfad auf und entscheiden Sie, welche Komponente für jede Verantwortung zuständig ist.
Eine erste Integration, die Sie sicher testen können
Beginnen Sie mit einer eng umrissenen Aufgabe, etwa der Klassifizierung eines internen Support-Tickets in eine feste Reihe von Kategorien. Definieren Sie die akzeptierten Eingaben, das erwartete Ausgabeschema und was ein Mensch prüft. Dann:
- Wählen Sie einen Anbieter und ein Modell, die die Aufgabe unterstützen. Lesen Sie die aktuelle Endpunkt- und Modelldokumentation, statt ein altes Beispiel zu kopieren.
- Erstellen Sie einen Schlüssel mit eingeschränktem Geltungsbereich. Speichern Sie ihn in einem serverseitigen Secret Store oder einer geschützten Umgebungsvariable. Legen Sie ihn nicht in Browser-Code, einer mobilen Binärdatei, einem Screenshot oder einem öffentlichen Repository ab.
- Führen Sie eine Testanfrage durch. Verwenden Sie das dokumentierte SDK- oder HTTP-Beispiel des Anbieters und eine nicht sensible Beispieleingabe. Halten Sie die Anfrage-ID und die Form der Antwort fest.
- Validieren Sie Ausgabe- und Fehlerfälle. Testen Sie fehlerhafte Eingaben, fehlende Anmeldedaten, unzureichendes Kontingent, langsame Antworten und einen absichtlich nicht unterstützten Vorgang.
- Fügen Sie ein Budget und Monitoring hinzu. Verfolgen Sie Aufrufe, Tokens oder Einheiten, Fehler, Latenz und Ausgaben pro Funktion oder Kunde. Legen Sie Limits fest, bevor Sie die Funktion unkontrolliertem Traffic öffnen.
- Führen Sie eine kleine Evaluation durch. Vergleichen Sie Antworten mit Beispielen, deren akzeptable Ergebnisse bekannt sind. Prüfen Sie sowohl Qualität als auch Latenz und Kosten.
Diese Abfolge ist absichtlich klein gehalten. Eine „Hello World“-Antwort beweist den Zugriff, aber nicht, dass die API für einen Produktions-Workflow sicher oder wirtschaftlich ist.
Wie Preisgestaltung und Limits üblicherweise funktionieren
KI-APIs rechnen nicht alle in derselben Einheit ab. Textmodelle berechnen Eingabe- und Ausgabe-Tokens häufig getrennt; manche unterscheiden außerdem zwischengespeicherte Eingaben. Bild-, Video-, Audio- und Datentools können pro generiertem Asset, Dauer, Größe, Aufruf oder einer anderen Einheit abrechnen. Kostenlose Guthaben und Limits können sich ändern. Nutzen Sie daher die aktuelle Preisgestaltung des Anbieters statt einer Zahl aus einem älteren Blogbeitrag.
Berechnen Sie für eine realistische Kostenschätzung:
monatliche Kosten ≈ abrechenbare Anfragen × durchschnittliche abrechenbare Einheiten pro Anfrage × aktueller Preis pro Einheit.
Berücksichtigen Sie dann Wiederholungsversuche, länger als erwartete Ausgaben, Tool-Aufrufe und ein Szenario mit hoher Nutzung. Erfassen Sie das akzeptierte nützliche Ergebnis, nicht nur die Anzahl der versuchten Anfragen. Ein Workflow, der häufig Wiederholungsversuche benötigt oder unbrauchbare Antworten erzeugt, kann selbst bei einem niedrigen Preis pro Token teuer sein.
Ratenlimits sind von Preisen getrennt. Ein Schlüssel kann durch Anfragen pro Minute, Tokens pro Minute, Parallelität, Kontostufe oder Modellverfügbarkeit begrenzt sein. Eine Anwendung sollte die dokumentierten Limits und Wiederholungsrichtlinien des Anbieters einhalten, bei Bedarf das Tempo reduzieren und vermeiden, den Traffic während eines Ausfalls zu vervielfachen. Gehen Sie nicht davon aus, dass die Vorauszahlung von mehr Guthaben automatisch jedes Limit erhöht.
Die aktuelle Website von Flatkey beschreibt einen Schlüssel, ein gemeinsames Guthaben und nutzungsbezogene Datensätze auf Anfrageebene für unterstützte Modelle und Tools. Dies sind Betriebsfunktionen seines Routers; prüfen Sie vor der Schätzung eines Workloads das aktuelle Modellverzeichnis und die Preisseite für das genaue Modell und die Einheit.
Fragen zu Sicherheit, Datenschutz und Zuverlässigkeit
Eine KI-API sendet Daten über eine Dienstgrenze hinweg. Identifizieren Sie vor der Integration, welche Felder personenbezogene, regulierte oder vertrauliche Informationen enthalten können. Lesen Sie die aktuellen Aufbewahrungs- und Verarbeitungsbedingungen des Anbieters, wählen Sie die erforderliche Region oder Bereitstellungsoption und entscheiden Sie, was Ihre Anwendung protokolliert. Wenn Sie Eingaben schwärzen müssen, tun Sie dies vor dem Senden an das Modell und prüfen Sie, ob die Schwärzung für den Anwendungsfall ausreichend ist.
Behandeln Sie generierte Ausgaben als nicht vertrauenswürdige Daten. Wenn ein Modell eine Datenbankänderung, eine Zahlung oder eine Nachricht an einen Kunden vorschlägt, erzwingen Sie Berechtigungen und menschliche oder deterministische Prüfungen außerhalb des Modells. Validieren Sie bei Retrieval oder Tool-Nutzung die Quelle und die Aktionsargumente. Ein API-Schlüssel sollte nur den minimalen Zugriff haben, den der Workflow benötigt, und bei Offenlegung rotiert werden.
Zeichnen Sie für die Zuverlässigkeit Latenz, Fehlerrate, Anfrage-IDs und die verwendete Modellversion auf. Legen Sie fest, was geschieht, wenn ein Anbieter ein Ratenlimit zurückgibt, ein Timeout auftritt oder sich die Verfügbarkeit ändert. Eine Ausweichlösung kann helfen, aber sie kann Ausgabequalität und -format verändern; testen Sie sie, bevor Sie Kundentraffic darüber leiten. Wenn die Funktion wichtig ist, erstellen Sie einen Evaluationssatz, der nach einer Modell- oder Prompt-Änderung ausgeführt werden kann.
Wann eine direkte API, ein Router oder eigene GPUs verwendet werden sollten
Verwenden Sie eine direkte Anbieter-API, wenn die Modelle und Kontosteuerungen eines Anbieters die Anforderungen erfüllen und die Anwendung diese Abhängigkeit akzeptieren kann. Verwenden Sie einen Router, wenn Sie eine gemeinsame Schnittstelle oder einen gemeinsamen Betrieb über mehrere unterstützte Anbieter hinweg benötigen; prüfen Sie, ob jede benötigte Modellfunktion über diese Ebene funktioniert. Ziehen Sie Self-Hosting in Betracht, wenn Modellgewichte, dauerhafte Auslastung, Datenlokalität oder Kontrolle die Hardware- und Betriebsbelastung rechtfertigen.
Die Entscheidung ist messbar. Beginnen Sie mit der Erfolgsrate der Aufgabe, akzeptabler Latenz, prognostiziertem monatlichem nützlichen Volumen, Datenanforderungen und der Fähigkeit des Teams, Vorfälle zu bewältigen. Vergleichen Sie dieselben Prompts und Evaluationskriterien zwischen den Kandidaten. Wenn Sie dedizierte GPU-Kapazität gegen API-Aufrufe abwägen, zeigt der Flatkey-Leitfaden zu GPU-Cloud versus Modell-API, welche Annahmen zu Auslastung und Kosten Sie einem Stresstest unterziehen sollten.
Häufige Fragen
Ist eine KI-API dasselbe wie ChatGPT?
Nein. ChatGPT ist eine App. Eine KI-API ist eine programmatische Schnittstelle, die eine App aufrufen kann. Verschiedene Anbieter und selbst gehostete Systeme stellen unterschiedliche APIs und Modelle bereit.
Muss ich ein Modell trainieren, um eine KI-API zu verwenden?
In der Regel nicht. Viele gehostete APIs stellen sofort einsatzbereite Modelle bereit. Sie müssen weiterhin Prompts entwerfen, Ergebnisse validieren, die Nutzung überwachen und entscheiden, ob das Modell die Anforderungen Ihrer Aufgabe erfüllt. Fine-Tuning oder Training ist eine separate Entscheidung.
Kann ein API-Schlüssel auf jedes KI-Modell zugreifen?
Kein universeller Schlüssel deckt jeden Anbieter und jedes Modell ab. Ein Router kann einen Schlüssel für die von ihm unterstützten Modelle und Tools bereitstellen, vorbehaltlich seines Katalogs, der Kontorichtlinien und der Verfügbarkeit bei Upstream-Anbietern. Prüfen Sie die aktuelle Liste der unterstützten Modelle, bevor Sie eine Abhängigkeit aufbauen.
Was sollte ich vor dem Start testen?
Testen Sie die Ergebnisqualität anhand repräsentativer Beispiele, Eingabe- und Ausgabelimits, das Verhalten strukturierter Antworten, Streaming, falls verwendet, Fehlerbehandlung, Ratenlimits, Datenschutzkontrollen, Latenz unter Last und die Kosten pro akzeptiertem Ergebnis. Bewahren Sie die Modell-ID und die Anfrage-ID in Betriebsprotokollen auf, ohne sensible Eingaben unnötig aufzuzeichnen.