Was ist eine AI Factory? GPU-Cluster, Daten, Modelle und Betrieb
Was ist eine AI Factory? Eine AI Factory ist das Betriebssystem rund um Enterprise-KI: GPU-Kapazität, Datenpipelines, Modelltraining oder -Fine-Tuning, Inference-Serving, Evaluation, Governance und Kostenbetrieb, die als ein wiederholbarer Produktionszyklus zusammenarbeiten.
Die Metapher ist wichtig, weil KI nicht allein von GPUs erzeugt wird. Ein GPU-Cluster ist der Maschinenraum, aber eine AI Factory braucht außerdem kuratierte Daten, Scheduler, Speicher, Netzwerke, Modell-Registries, Bereitstellungs-Workflows, Observability, Sicherheitskontrollen und ein Finanzmodell, um zu entscheiden, wann GPUs gemietet, Cluster reserviert, verwaltete APIs genutzt oder alle drei kombiniert werden sollen.
NVIDIA hat den Begriff rund um Infrastruktur populär gemacht, die Daten in Intelligenz verwandelt, und Anbieter wie Dell Technologies und HPE verwenden heute "AI Factory", um Full-Stack-Enterprise-KI-Plattformen zu beschreiben. Für Builder ist die nützlichere Frage weniger "wem gehört der Begriff?" und vielmehr praktisch: Welche Bausteine müssen existieren, bevor Ihre KI-Workload zu einer Factory wird statt zu einem einmaligen Experiment?
Dieser Leitfaden definiert, was eine AI Factory ist, erklärt, wie eine AI Factory funktioniert, ordnet die zentralen Plattformschichten ein und zeigt, wo Flatkey passt, wenn ein Team Modell-/API-Zugriff möchte, ohne jede Ebene der GPU-Infrastruktur selbst zu betreiben.
Die Kurzdefinition: Was ist eine AI Factory?
Eine AI Factory ist eine Produktionsumgebung, die Rohdaten, Prompts, Modelle, Rechenleistung und operatives Feedback in nutzbare KI-Ergebnisse umwandelt. In geschäftlichen Begriffen ist es ein wiederholbares System zum Erstellen, Bereitstellen, Messen und Verbessern von KI-Fähigkeiten.
Eine einfache Denkweise dazu:
| Factory-Schicht | Was sie tut | Typischer Verantwortlicher |
|---|---|---|
| GPU- und Beschleunigerkapazität | Führt Trainings-, Fine-Tuning-, Batch-Inferenz- oder Echtzeit-Inferenz-Workloads aus | Infrastruktur, Plattform, ML-Systeme |
| Netzwerk und Speicher | Transportiert Datensätze, Checkpoints, Embeddings, Logs und Modell-Artefakte ohne Engpässe | Infrastruktur, SRE, Datenplattform |
| Datenpipelines | Erfasst, bereinigt, labelt, filtert und aktualisiert Daten, die von Modellen und Anwendungen verwendet werden | Data Engineering, ML-Plattform |
| Modell-Lebenszyklus | Wählt Basismodelle aus, fine-tuned sie, evaluiert, versioniert und rollt sie aus | ML Engineering, KI-Produkt |
| Serving und Routing | Liefert Modellausgaben über APIs, Batch-Jobs, Agents oder Anwendungen aus | Backend, Plattform, KI-Engineering |
| Betrieb | Überwacht Latenz, Fehler, Auslastung, Kosten, Sicherheit, Zugriff und Qualitätsdrift | SRE, FinOps, Sicherheit, Governance |
Wenn also jemand fragt "what is an AI factory?", ist die beste Antwort: Es ist der vollständige Produktions-Stack für KI, nicht nur ein Raum voller GPUs.
Wie funktioniert eine AI Factory?
Eine AI Factory funktioniert, indem sie vier Eingaben in einen verwalteten Ausgabekreislauf verwandelt:
- Daten gelangen über Kundenereignisse, Dokumente, Code, Logs, Medien, synthetische Daten, öffentliche Datensätze oder Tool-Aufrufe hinein.
- Compute verarbeitet die Daten über Trainingsjobs, Fine-Tuning-Läufe, Retrieval-Pipelines, Embedding-Jobs, Batch-Inferenz oder Echtzeit-Inferenz.
- Modelle erzeugen Ausgaben über Checkpoints, gehostete APIs, Model Router oder domänenspezifische Agents.
- Betrieb misst, ob die Ausgaben zuverlässig, bezahlbar, governancet und nützlich genug sind, um in Produktion zu bleiben.
Dieser Kreislauf wiederholt sich. Eine ausgereifte AI Factory sammelt Feedback von Nutzern und Systemen, wandelt dieses Feedback in Evaluationsdaten um, verbessert Prompts oder Modelle und stellt die nächste Version über eine kontrollierte Bereitstellung bereit.
Deshalb umfasst die AI-Factory-Diskussion sowohl Rechenzentrumsdesign als auch Produktbetrieb. Ein Cluster kann ein Modell trainieren oder bereitstellen, aber die Factory existiert erst, wenn das Team wiederholt beantworten kann:
- Welche Workloads erfordern direkte GPU-Kontrolle?
- Welche Workloads können eine verwaltete Modell-API nutzen?
- Welche Daten dürfen welches Modell erreichen?
- Welche Ausgaben bestehen die Evaluation?
- Welche Fehler sollten erneut versucht, auf ein anderes System umgeleitet oder gestoppt werden?
- Welches Team, welcher Kunde, welches Produkt oder welche Umgebung hat die Kosten verursacht?
AI Factory vs. GPU-Cluster
Ein GPU-Cluster ist eine Rechenressource. Eine AI Factory ist ein Produktionssystem, das Rechenressourcen nutzt.
Der Unterschied ist wichtig, weil viele teure KI-Programme auf der Ebene über dem Cluster scheitern. Das Team kauft Kapazität und stellt dann fest, dass Datenbewegung, Checkpoint-Speicher, Modell-Serving, Observability, Zugriffskontrolle und Kostenzuordnung die eigentlichen Blocker sind.
Verwenden Sie einen Leitfaden zur GPU-Cluster-Miete, wenn Sie Multi-Node-GPU-Kapazität, Topologie, Netzwerke und Abnahmetests vergleichen müssen. Verwenden Sie ein AI-Factory-Modell, wenn Sie entscheiden müssen, wie Compute, Daten, Modellbereitstellung und Betrieb zu einer dauerhaften KI-Fähigkeit werden.
| Frage | Antwort für GPU-Cluster | Antwort für AI Factory |
|---|---|---|
| Was kaufen wir? | Nodes, GPUs, Netzwerk-Fabric, Speicher, Support | Ein wiederholbares KI-Produktionssystem |
| Was wird optimiert? | Durchsatz, Auslastung, Verfügbarkeit, Job-Abschluss | Geschäftsergebnis, Qualität, Kosten, Governance, Iterationsgeschwindigkeit |
| Wer betreibt es? | Infra, Plattform, SRE, ML-Systeme | Infra plus Daten, ML, Produkt, Sicherheit, Finance |
| Was kann schiefgehen? | Überlastetes Netzwerk, fehlgeschlagene Jobs, untätige GPUs, Queue-Konflikte | Falsches Modell, schwache Daten, unsichere Ausgabe, aus dem Ruder laufende Kosten, fehlende Governance |
| Was ist die Frage zur Unit Economics? | Kosten pro GPU-Stunde oder Job | Kosten pro akzeptierter Ausgabe, Feature, Kunde oder Workflow |
Für das Kostenmodellierung sollte man diesen Artikel mit dem TCO-Arbeitsblatt für GPU-Cluster kombinieren. Ein AI-Factory-Budget sollte das Cluster enthalten, aber auch Speicher, Egress, Engineering-Zeit, Ausfälle, Evaluierung, Observability und Governance.
AI-Factory-Plattformschichten
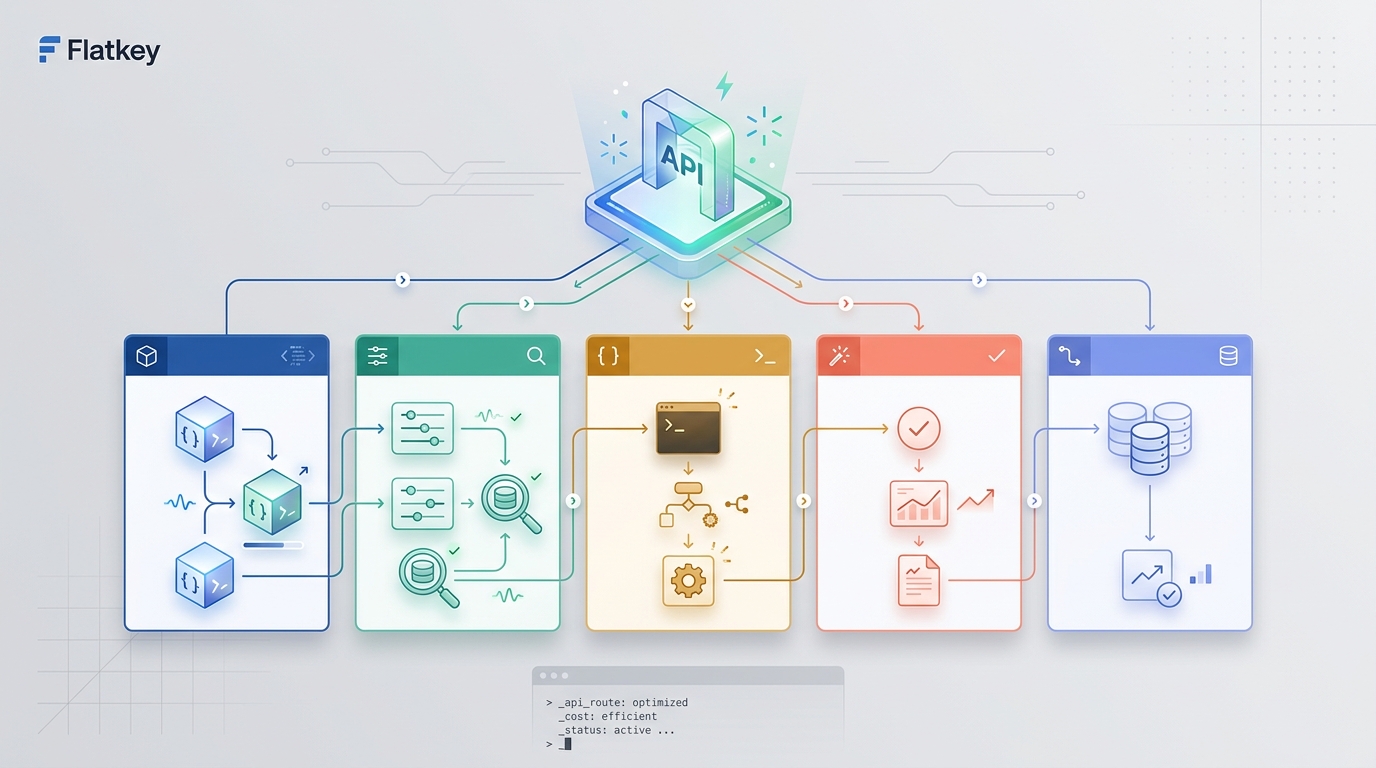
Was ist eine AI-Factory-Plattform? Es ist die Software- und Infrastrukturschicht, die es Teams ermöglicht, die Factory als Produkt zu betreiben und nicht als Sammlung von Skripten.
In der Praxis umfasst eine AI-Factory-Plattform normalerweise sieben Schichten.
1. Kapazität und Hardware
Diese Schicht umfasst GPUs oder Beschleuniger, CPU-Hosts, Speicher, lokalen Speicher, Rack-Design, Stromversorgung, Kühlung sowie das Rechenzentrum oder die Cloud-Region, in der die Workload läuft.
Für Training und große Batch-Inferenz achten Teams auf Multi-Node-Performance, Netzwerk-Fabric, Checkpoint-Geschwindigkeit und das Verhalten des Schedulers. Für Echtzeit-Inferenz achten Teams auf Queueing, Cold Starts, Latenz-Tails, Autoscaling und Uptime. Das richtige Kapazitätsmodell kann On-Demand-GPU-Miete, reservierte GPU-Kapazität, eine private GPU-Cloud, Serverless GPU, Colocation oder ein internes Cluster sein.
2. Netzwerk und Speicher
KI-Workloads werden oft durch Bewegung begrenzt, nicht durch reine Rechenleistung. Trainingsjobs verschieben Datensätze und Checkpoints. Retrieval-Systeme verschieben Embeddings und Quelldokumente. Mediengenerierung verschiebt große Dateien. Agenten-Workflows können Tools, Datenbanken und Browser aufrufen.
Das bedeutet, dass eine AI-Factory-Plattform vorhersehbare Speicher-Lokalität, Datenaufbewahrungsregeln, Backup-Pläne und Netzwerkpfade benötigt, die zur Workload passen. Ein Cluster mit schnellen GPUs und schwachem Speicher kann trotzdem unterdurchschnittlich sein.
3. Datenpipelines
Datenpipelines entscheiden, aus was die Factory lernen und womit sie antworten darf. Sie decken Ingestion, Filterung, Labeling, Deduplizierung, Datenschutzbehandlung, Berechtigungsgrenzen, Qualitätsprüfungen und Aktualisierungspläne ab.
Bei Retrieval-Augmented Generation kann die Datenpipeline wichtiger sein als die Modellwahl. Beim Fine-Tuning können kleine Qualitätsprobleme in wiederholte nachgelagerte Fehler umschlagen. Bei Agenten werden Datentools und Webtools Teil der Eingabefläche der Factory.
4. Modell-Lebenszyklus
Der Modell-Lebenszyklus umfasst Modellauswahl, Prompt-Design, Fine-Tuning, Evaluierung, Versionierung, Regressionstests, Rollbacks und Release Notes. Hier entscheidet ein Team, ob es eine Frontier-Model-API, ein Open-Weight-Modell auf gemieteten GPUs, ein spezialisiertes Bild-/Videomodell oder einen Hybridansatz verwendet.
Flatkey ist hier relevant, wenn ein Team Offizielle Model-APIs vergleichen und darüber routen möchte, ohne viele Anbieter-Schlüssel und separate Guthaben zu verwalten. Flatkey gibt Entwicklern einen Schlüssel, ein Guthaben und eine Rechnung über Hunderte von offiziellen Modellen und Pay-per-Call-Tools hinweg, was einfacher sein kann, als jede Workload in eigene Infrastruktur zu verwandeln.
5. Serving, Routing und Anwendungsintegration
Serving macht aus einem trainierten oder ausgewählten Modell einen zuverlässigen Endpunkt. Routing entscheidet, welches Modell, welcher Anbieter, welche Region oder welcher Fallback-Pfad jede Anfrage bearbeiten soll.
Hier trifft die AI Factory auf Anwendungen. Ein Coding-Agent, ein Customer-Support-Copilot, eine Bild-Pipeline, ein Video-Workflow oder ein internes Recherche-Tool sollte nicht jeden Infrastrukturdetaill kennen müssen. Es braucht eine stabile API, vorhersehbare Latenz, nachvollziehbare Kosten und wiederherstellbare Fehlermodi.
Wenn Ihr Team entscheidet, ob es die Serving-Schicht selbst betreiben soll, lesen Sie GPU-Cloud vs. Model API. Die Kurzfassung: GPU-Serving selbst betreiben, wenn Hardware-Kontrolle, eigene Modelle, Datenisolierung oder Unit Economics den operativen Aufwand rechtfertigen; Model-APIs nutzen, wenn Geschwindigkeit, Breite, Failover und geringere Plattformlast wichtiger sind.
6. Observability, Evaluierung und Governance
Eine AI Factory muss mehr als nur Uptime messen. Sie sollte Anfragevolumen, Latenz, Fehler, Retries, Kosten, Modellwahl, Prompt-Versionen, Datenquellen, Sicherheitsfilter, Evaluierungsscores und akzeptierte Ausgaben verfolgen.
Governance steht neben der Observability. Teams benötigen Zugriffskontrollen, Audit-Logs, Aufbewahrungsregeln, Anbieterfreigaben, Grenzen für Kundendaten und Eskalationspfade für unsichere oder qualitativ schlechte Ausgaben. Ohne diese Kontrollen kann die Factory Risiko schneller skalieren als Wert.
7. FinOps und Betriebsrhythmus
AI Factories verwandeln Compute in Ausgaben, aber Finanzteams müssen trotzdem wissen, was diese Ausgaben kosten. Das Betriebsmodell sollte Ausgaben nach Produkt, Umgebung, Kunde, Team oder Workflow zuordnen.
Nützliche Unit-Metriken sind:
- Kosten pro akzeptierter Ausgabe
- Kosten pro abgeschlossener Benutzeraktion
- Kosten pro erfolgreichem Tool-Call
- GPU-Auslastung nach Workload-Klasse
- Retry- und Fehlerverlust
- Cache-Trefferrate
- Wartezeit in der Queue
- Modell-Fallback-Rate
Der Wert von Flatkey ist am größten, wenn Teams die Nutzung von Modellen und Tools auf einem gemeinsamen Ledger statt über fragmentierte Anbieter-Accounts verwalten wollen. Das ersetzt kein GPU-Cluster für eine kundenspezifische Infrastruktur, kann aber die Komplexität für Modell-/API-Workloads verringern, die keine direkte Hardwarekontrolle erfordern.
Was ist eine AI Factory in NVIDIA-Begriffen?
Worum geht es in einer Diskussion über eine AI Factory nach NVIDIA meistens? NVIDIA verwendet den Begriff, um Infrastruktur zu beschreiben, die Unternehmensdaten mithilfe von GPUs, beschleunigtem Networking, Software und Bereitstellungsmustern gemeinsam in Intelligence umwandelt. Die Materialien zu NVIDIAs AI Factory und die Enterprise-Referenzarchitektur konzentrieren sich auf ein Full-Stack-Design, nicht nur auf einzelne Beschleuniger.
Diese Einordnung ist nützlich, kann Leser aber auch auf die Hardware-Perspektive festlegen. Der praktische Käufer sollte das NVIDIA-Konzept in eine operative Checkliste übersetzen:
- Welche Workloads benötigen direkt NVIDIA-GPUs?
- Welche Modelle werden auf diesen GPUs trainiert, feinabgestimmt oder bereitgestellt?
- Welche Datenquellen speisen die Modelle?
- Welcher Software-Stack plant und überwacht Jobs?
- Welche Anwendungen nutzen die Ausgaben?
- Welches Team trägt die Verantwortung für Zuverlässigkeit, Sicherheit und Kosten?
Jensen Huang beschreibt AI Factories oft als die nächste Generation von Rechenzentren, weil sie Tokens oder Intelligence aus Daten und Energie herstellen. Betrachten Sie das als die makroökonomische Erzählung. Ihre Implementierung braucht dennoch Workload-Dimensionierung, Governance, Service-Level-Design und ein Kostenmodell.
Was ist eine AI Factory im Geschäftskontext?
Im Geschäftskontext ist eine AI Factory eine organisatorische Fähigkeit. Sie gibt Teams eine wiederholbare Methode, um AI-Features, Agent-Workflows, interne Copilots, Datenprodukte und automatisierte Abläufe bereitzustellen.
Die Factory sollte Geschäftsfragen in operativen Begriffen beantworten:
| Geschäftsfrage | Übersetzung der AI Factory |
|---|---|
| Können wir dieses AI-Feature sicher einführen? | Datenberechtigungen, Model-Evaluation, Fallback, Audit-Logs |
| Können wir ohne Überraschungskosten skalieren? | Budgets, Rate Limits, Nutzungs-Ledger, Modell-Routing, GPU-Auslastung |
| Können wir die Qualität im Laufe der Zeit verbessern? | Feedback-Schleifen, Eval-Sets, Regressionstests, Prompt-/Modellversionierung |
| Können Teams die Plattform wiederverwenden? | Gemeinsame APIs, Vorlagen, Observability, Zugriffskontrollen |
| Können wir Modelle oder Anbieter wechseln? | Abstraktionsschicht, OpenAI-kompatible Routen, Modell-Benchmarks |
Das ist auch der Grund, warum eine AI Factory nicht automatisch für jedes Team die richtige Investition ist. Wenn das Produkt nur standardmäßige Text-, Bild-, Video-, Such-, Browser-, Enrichment- oder Agent-Tool-Aufrufe benötigt, kann ein verwaltetes Modell- und Tool-Gateway schneller in Produktion gehen. Wenn das Produkt benutzerdefinierte Modellgewichte, eine private Data Plane-Kontrolle, Inferenz mit hohem Volumen oder spezialisierte Medien-Pipelines benötigt, kann eine GPU-gestützte Factory gerechtfertigt sein.
Aufbauen, mieten oder Modell-APIs nutzen?
Die richtige AI-Factory-Strategie ist in der Regel hybrid.
Bauen oder reservieren Sie GPU-Kapazität, wenn:
- Sie kontinuierliche Inferenz mit hohem Volumen betreiben und GPUs gut auslasten können.
- Sie benutzerdefinierte Modellgewichte, private Modellbereitstellung oder spezialisierte Kernel benötigen.
- Sie Storage, Networking, Scheduling, Sicherheit und Incident Response betreiben können.
- Die Kosten pro akzeptierter Ausgabe nach Einbeziehung aller versteckten Kosten niedriger sind.
Mieten Sie GPU-Cluster, wenn:
- Sie Spitzenlasten für Training, Fine-Tuning, Evaluation oder Batch-Inferenz benötigen.
- Sie die Workload-Struktur validieren wollen, bevor Sie Kapazität kaufen oder reservieren.
- Sie bestimmte Beschleuniger, Regionen oder Topologien für ein definiertes Projekt benötigen.
- Sie Einrichtungs- und Abnahmetests tolerieren können.
Nutzen Sie Modell-APIs oder ein Gateway, wenn:
- Sie schnellen Zugriff auf viele Modelle und Modalitäten benötigen.
- Sich die Workload häufig ändert.
- Provider-Failover wichtiger ist als reine Hardwarekontrolle.
- Ihr Team einen API-Schlüssel, eine Rechnung und Nutzungssteuerungen statt verstreuter Anbieter-Accounts möchte.
- Sie Tools wie Suche, Browser-Automation, Data Enrichment oder Media-APIs im selben Workflow benötigen.
Für viele Teams ist die AI Factory kein einzelner Ort. Sie ist ein Betriebsmodell, das gemietete GPUs, verwaltete APIs, interne Services und Agent-Tools umfasst.
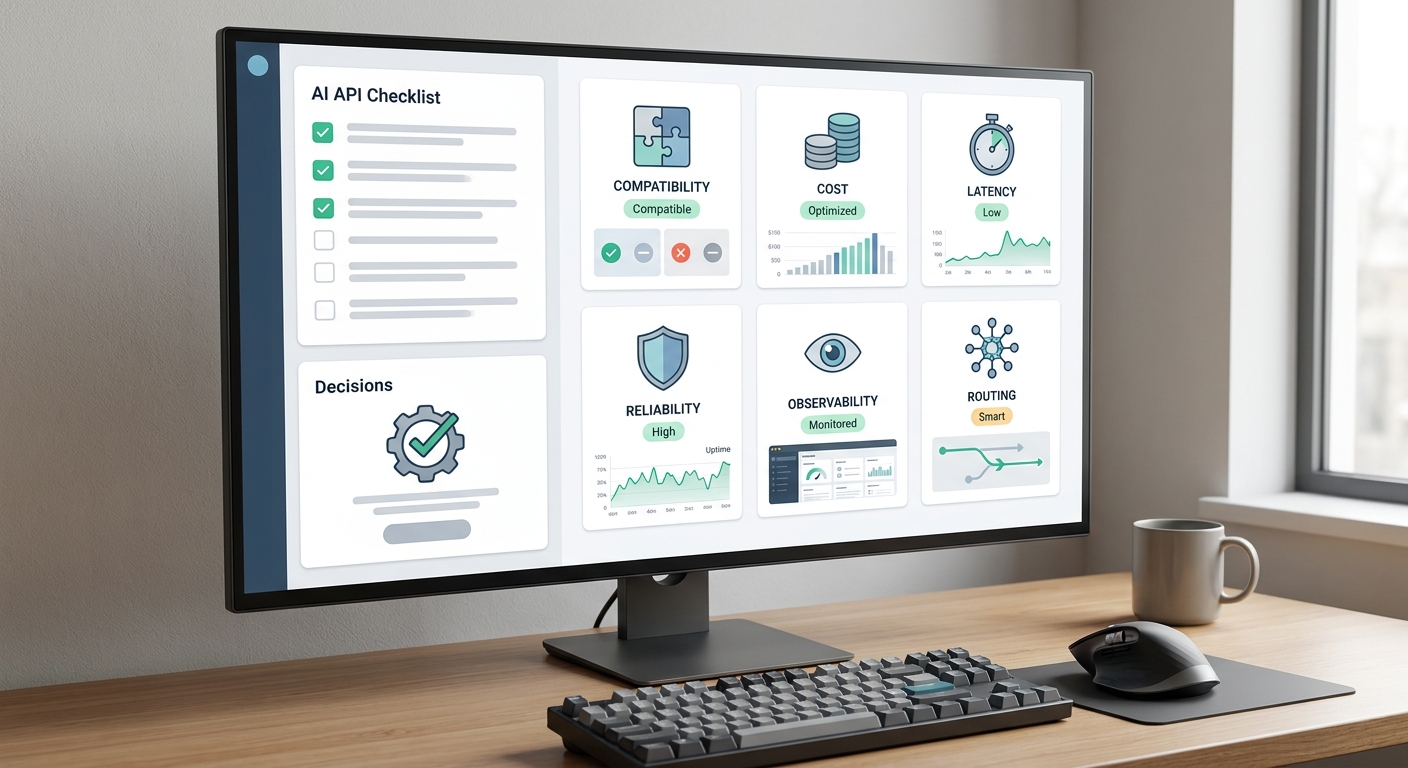
AI-Factory-Bewertungscheckliste
Bevor Sie in eine AI-Factory-Plattform investieren, stellen Sie diese Fragen:
- Workload: Trainieren, feinabstimmen, embeddieren, bereitstellen, Medien generieren, Agenten ausführen wir oder alles davon?
- Latenz: Welche Workloads sind Echtzeit, Batch, asynchron oder mit Human-in-the-Loop?
- Daten: Welche Datensätze, Dokumente, Logs und Tool-Ausgaben speisen das System, und wer kann darauf zugreifen?
- Modellstrategie: Welche Modelle sind selbst betrieben, gemietet, Open-Weight, Frontier-API, multimodal oder spezialisiert?
- Serving: Benötigen Anwendungen einen stabilen internen Endpunkt, eine OpenAI-kompatible API oder direkten Clusterzugriff?
- Zuverlässigkeit: Was passiert, wenn ein Modell, Anbieter, GPU-Node, Speicherpfad oder eine Queue ausfällt?
- Kosten: Wie hoch sind die Kosten pro akzeptierter Ausgabe nach Retries, Leerlaufzeit, Storage, Egress, Engineering und Support?
- Governance: Wie werden Prompts, Ausgaben, Datenquellen, Nutzer und Modellversionen geprüft?
- Portabilität: Kann die Workload zwischen Anbietern, Regionen, Modellfamilien oder GPU-Typen wechseln?
- Ownership: Welches Team trägt nach dem Launch die Verantwortung für die Factory?
Wenn Ihr Team diese Fragen nicht beantworten kann, fangen Sie kleiner an. Nutzen Sie verwaltete APIs für den ersten Produktionspfad, messen Sie die tatsächliche Nutzung und verlagern Sie dann die Workloads, die eindeutig direkte GPU-Kontrolle rechtfertigen, in eine formellere AI-Factory-Plattform.
Häufige Fehler
Der erste Fehler besteht darin, eine AI Factory als Beschaffungsprojekt zu behandeln. GPUs zu kaufen ist nicht dasselbe wie ein KI-Produktionssystem aufzubauen.
Der zweite Fehler besteht darin, den Datenbetrieb zu ignorieren. Schlechte Datenqualität, unklare Berechtigungen, schwache Retrieval-Pipelines und fehlende Evaluationsdatensätze verursachen auf dem weiteren Weg mehr Risiko als die Wahl des Modells allein.
Der dritte Fehler besteht darin, nur den GPU-Stundenpreis zu messen. Für produktive KI misst man abgeschlossene, nützliche Arbeit. GPU-Mietpreise sind nur ein Input; Warteschlangenzeit, Wiederholungen, fehlgeschlagene Jobs, Speicher, Datenbewegungen und Mitarbeiterzeit spielen ebenfalls eine Rolle.
Der vierte Fehler besteht darin, eine maßgeschneiderte Factory für Workloads zu bauen, die APIs nutzen sollten. Wenn ein verwalteter, offizieller Modellpfad gut genug ist, kann die Opportunitätskosten des Betriebs von Infrastruktur die Einsparungen übersteigen.
Der fünfte Fehler besteht darin, das Design für Ausfälle zu überspringen. KI-Systeme fallen durch Überlastung, Model Drift, Provider-Incidents, Richtlinienablehnungen, schlechte Retrievals, Tool-Fehler und außer Kontrolle geratene Wiederholungsversuche aus. Die Factory braucht Kontrollen, bevor der Traffic eintrifft.
Häufig gestellte Fragen
Was ist eine AI Factory und wie funktioniert sie?
Eine AI Factory ist ein Produktionssystem, das Daten, Modelle, Rechenleistung und operatives Feedback in KI-Ergebnisse umwandelt. Sie funktioniert, indem GPU- oder API-Kapazität, Datenpipelines, Modell-Lifecycle-Management, Bereitstellung, Observability, Governance und Kostenbetrieb in einem wiederholbaren Kreislauf zusammengeführt werden.
Was ist eine AI-Factory-Plattform?
Eine AI-Factory-Plattform ist die Infrastruktur- und Software-Stack, mit der dieser Kreislauf betrieben wird. Sie kann GPU-Cluster, Speicher, Netzwerke, Scheduler, Datenpipelines, Modell-Register, Serving-Endpunkte, Monitoring, Governance, Kostenkontrollen und Modell-/API-Gateways umfassen.
Was ist eine NVIDIA AI Factory?
In der Darstellung von NVIDIA ist eine AI Factory eine beschleunigte Infrastruktur, die Unternehmensdaten mithilfe von GPUs, Netzwerken, Software und Referenzarchitekturen in Intelligenz umwandelt. Die nützliche Erkenntnis ist, dass eine AI Factory einen vollständigen Stack rund um die GPUs braucht: Daten, Modelle, Bereitstellung, Observability und Betrieb.
Was ist eine AI Factory NVIDIA Jensen Huang?
Wenn Jensen Huang über AI Factories spricht, beschreibt er meist den Wandel von traditionellen Rechenzentren, die Informationen speichern und bereitstellen, hin zu beschleunigten Rechenzentren, die Tokens, Vorhersagen oder Intelligenz erzeugen. Für Betreiber muss diese Vision dennoch in Workload-Dimensionierung, Daten-Governance, Model Serving und Kostenkontrollen übersetzt werden.
Was ist eine AI Factory im Geschäftskontext?
Im Geschäftskontext ist eine AI Factory eine wiederholbare Fähigkeit, KI-Funktionen auszuliefern und zu verbessern. Sie gibt Teams einen kontrollierten Weg, Unternehmensdaten und externe Modellkapazitäten in nützliche Workflows umzuwandeln, während Qualität, Kosten, Risiko und Verantwortlichkeit nachverfolgt werden.
Fazit
Was ist eine AI Factory? Sie ist das Produktionssystem, das KI von isolierten Experimenten in eine operative Fähigkeit verwandelt. GPU-Cluster sind wichtig, aber sie sind nur eine Ebene. Die Factory braucht außerdem Datenpipelines, Modell-Lifecycle-Management, Serving, Routing, Evaluierung, Governance und finanzielle Kontrollen.
Für Workloads, die eigene Modelle oder direkte Hardwarekontrolle erfordern, sollte vor dem Kauf von Kapazität der vollständige AI-Factory-Stack geplant werden. Für Workloads, die offizielle Modell-APIs und Tools nutzen können, kann Flatkey einen einfacheren Weg bieten: ein Schlüssel, ein Guthaben, eine Rechnung und Routing über Modelle und Pay-per-Call-Tools hinweg, während Ihr Team lernt, welche Workloads wirklich ihre eigene Factory benötigen.
Quellen und weiterführende Literatur
- NVIDIA: AI Factory
- NVIDIA Docs: Überblick über das AI-Factory-Design
- Dell Technologies: Dell AI Factory mit NVIDIA
- HPE: Was ist eine AI Factory?
- Flatkey: TCO eines GPU-Clusters
- Flatkey: GPU-Cloud vs. Modell-API