O que é uma API de IA?
Uma API de IA é uma forma documentada de um software solicitar uma capacidade de IA de outro serviço. Uma aplicação envia uma solicitação estruturada — geralmente um prompt, uma imagem, um arquivo de áudio ou um documento — junto com credenciais e o nome de um modelo ou operação. O serviço retorna um resultado estruturado ou um fluxo de resultados. A aplicação pode então exibir uma resposta, classificar um ticket, transcrever fala, criar uma imagem ou dar continuidade a um fluxo de trabalho.
A API é a interface, não o próprio modelo. Um modelo realiza a inferência; a API define como um cliente solicita esse trabalho, recebe a resposta e trata erros. Alguns provedores hospedam seus próprios modelos. Outros fornecem um gateway para vários modelos. Um desenvolvedor também pode executar um modelo aberto por trás de uma API auto-hospedada. A escolha certa depende da tarefa, do limite dos dados, do padrão de uso e da capacidade da equipe de operar a infraestrutura.
Se você é novo no termo, comece com este modelo mental:
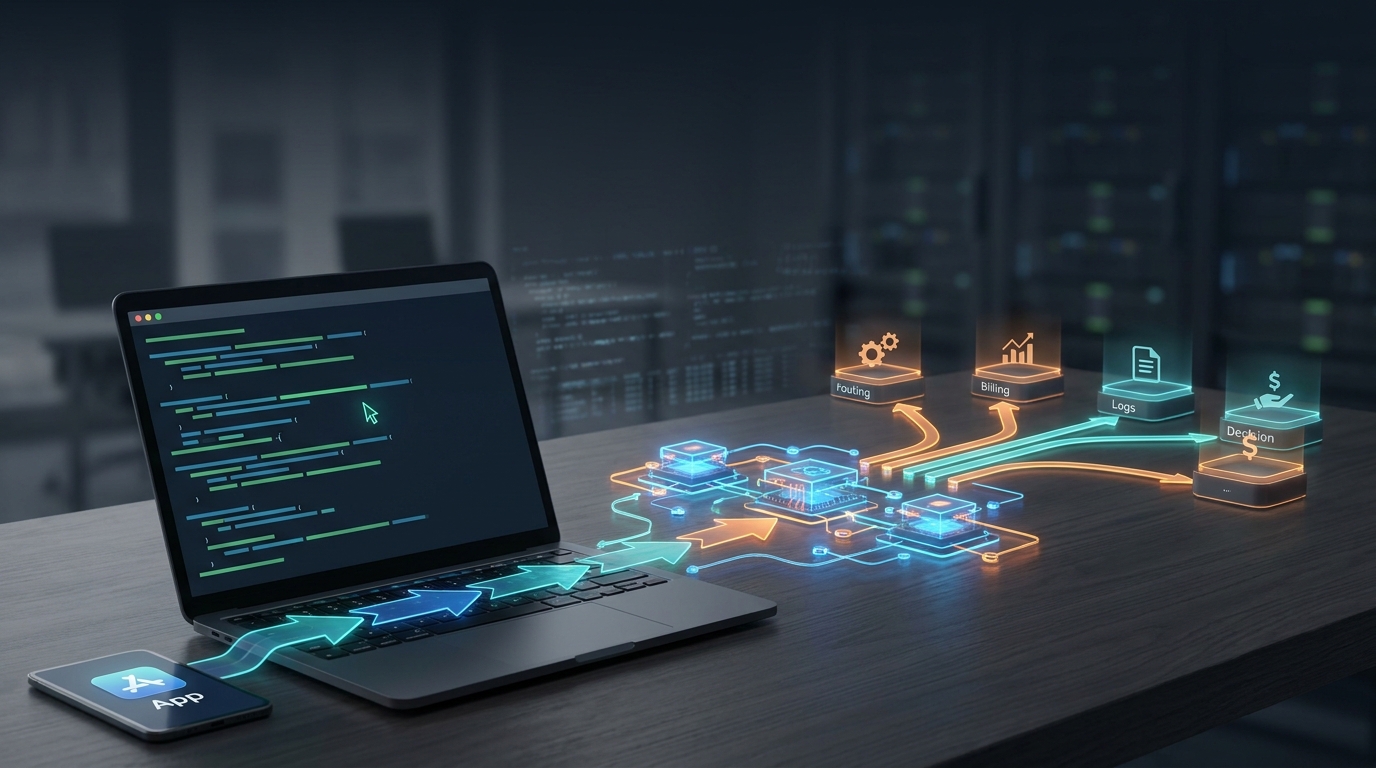
seu app → solicitação autenticada → endpoint da API de IA → modelo ou ferramenta → resposta estruturada → seu app.
Para uma definição geral de uma API como um contrato entre componentes de software, consulte a explicação da AWS sobre APIs. A parte específica de IA é o modelo ou a ferramenta que processa a solicitação.
O que uma API de IA pode fazer?
| Capacidade | Entrada típica | Saída típica | Exemplo de uso |
|---|---|---|---|
| Geração de texto | Prompt ou mensagens de conversa | Texto ou dados estruturados | Elaborar uma resposta de suporte para revisão humana |
| Embeddings | Texto ou outro conteúdo compatível | Vetor numérico | Encontrar documentos semanticamente semelhantes |
| Geração ou edição de imagens | Prompt e imagem opcional | Recurso de imagem | Criar uma imagem conceitual de produto |
| Fala e áudio | Áudio ou texto | Transcrição ou áudio sintetizado | Transcrever uma reunião |
| Visão e análise de documentos | Imagem, documento ou entrada mista | Descrição ou campos extraídos | Ler uma fatura com verificação |
| Acesso a ferramentas ou dados | Parâmetros de consulta e de ferramenta | Resultados de pesquisa ou resultado de ação | Recuperar informações em tempo real para um agente |
Essas são famílias de APIs, não garantias de que todo modelo oferece suporte a todas as operações. Um modelo somente de texto não aceita imagens automaticamente, e um endpoint de ferramenta não é o mesmo que um endpoint de modelo generativo. Verifique o catálogo atual de modelos do provedor, a documentação dos endpoints, os limites de arquivos e o esquema de resposta antes de prometer um recurso em seu produto.
Como funciona uma solicitação para uma API de IA
Uma solicitação útil tem quatro partes: uma URL de destino, autenticação, uma operação e uma carga de entrada. O destino identifica o serviço e o endpoint. A credencial identifica a conta ou o projeto. A operação e o modelo determinam qual trabalho é solicitado. A carga fornece o prompt ou a mídia e quaisquer configurações compatíveis.
Uma aplicação em produção deve fazer a chamada a partir de seu servidor, onde a chave de API pode permanecer secreta. O servidor valida a entrada do usuário, define um timeout razoável, envia a solicitação e verifica a resposta. Ele deve distinguir um erro de autenticação de um limite de taxa, um modelo indisponível, uma carga inválida ou uma falha do provedor. A interface do usuário deve receber um resultado seguro para a aplicação, em vez de credenciais brutas ou erros não filtrados do provedor.
Se a operação transmitir tokens ou mídia, o cliente receberá partes ao longo do tempo. A transmissão pode melhorar a percepção de responsividade, mas a aplicação ainda precisa lidar com desconexões e saída incompleta. Para dados estruturados, valide o formato retornado antes de gravar em um banco de dados ou acionar outra ação. A resposta fluente de um modelo não é prova de que um fato solicitado está correto.
A documentação do Flatkey descreve seu roteador atual compatível com OpenAI e os fluxos de trabalho compatíveis. Um roteador unificado permite que uma equipe mantenha um formato de cliente familiar enquanto altera IDs de modelos, mas você ainda deve testar o comportamento específico de cada modelo e o suporte a endpoints. A plataforma de API da OpenAI e a documentação da API do Claude são exemplos de interfaces de provedores diretos com seus próprios contratos de solicitação.
API de IA versus aplicativo de IA, SDK, gateway e modelo auto-hospedado
Esses termos se sobrepõem, mas resolvem problemas diferentes:
- Aplicativo de IA: o produto voltado ao usuário, como uma interface de chat ou ferramenta de escrita. Ele pode chamar uma API internamente.
- API de IA: o contrato programático que aceita uma solicitação e retorna um resultado.
- SDK: uma biblioteca que ajuda o código a chamar uma API. Um SDK é conveniente, mas o endpoint subjacente e as regras da conta ainda importam.
- Gateway de API ou roteador de modelos: uma camada que pode aplicar autenticação, roteamento, cotas, registros e políticas compartilhados antes que o tráfego chegue a um ou mais provedores de modelos.
- Servidor de inferência auto-hospedado: software que expõe uma API para pesos de modelo executados em capacidade que você controla. Você é responsável pela disponibilidade, escalabilidade, aplicação de patches e custos.
Um gateway não substitui a escolha de um modelo adequado. Um servidor auto-hospedado não é automaticamente mais barato do que uma API. Uma API hospedada não é automaticamente apropriada para todos os requisitos de dados ou latência. Desenhe o caminho completo da solicitação e decida qual componente assume cada responsabilidade.
Uma primeira integração que você pode testar com segurança
Comece com uma tarefa específica, como classificar um ticket interno de suporte em um conjunto fixo de categorias. Defina a entrada aceita, o esquema de saída esperado e o que um humano irá revisar. Em seguida:
- Escolha um provedor e um modelo que ofereçam suporte à tarefa. Leia a documentação atual do endpoint e do modelo, em vez de copiar um exemplo antigo.
- Crie uma chave com escopo limitado. Armazene-a em um repositório de segredos do lado do servidor ou em uma variável de ambiente protegida. Não a coloque em código de navegador, um binário móvel, uma captura de tela ou um repositório público.
- Faça uma solicitação de teste. Use o SDK documentado ou o exemplo HTTP do provedor e uma entrada de exemplo não sensível. Registre o ID da solicitação e o formato da resposta.
- Valide os casos de saída e de falha. Teste entrada malformada, credenciais ausentes, cota insuficiente, respostas lentas e uma operação deliberadamente não compatível.
- Adicione um orçamento e monitoramento. Acompanhe chamadas, tokens ou unidades, erros, latência e gastos por recurso ou cliente. Defina limites antes de abrir o recurso para tráfego não controlado.
- Execute uma pequena avaliação. Compare as respostas com exemplos que tenham resultados aceitáveis conhecidos. Avalie a qualidade, bem como a latência e o custo.
Essa sequência é intencionalmente pequena. Uma resposta de “hello world” comprova o acesso, mas não prova que a API seja segura ou econômica para um fluxo de trabalho de produção.
Como os preços e limites geralmente funcionam
Nem todas as APIs de IA cobram na mesma unidade. Os modelos de texto geralmente precificam separadamente os tokens de entrada e de saída; alguns também diferenciam a entrada em cache. Ferramentas de imagem, vídeo, áudio e dados podem cobrar por ativo gerado, duração, tamanho, chamada ou outra unidade. Créditos gratuitos e limites podem mudar, portanto use os preços atuais do provedor, em vez de um número copiado de uma publicação antiga de blog.
Para uma estimativa realista de custo, calcule:
custo mensal ≈ solicitações elegíveis × unidades faturáveis médias por solicitação × preço unitário atual.
Depois, adicione novas tentativas, saídas mais longas do que o esperado, chamadas de ferramentas e um cenário de alto uso. Registre o resultado útil aceito, não apenas o número de solicitações tentadas. Um fluxo de trabalho que tenta novamente com frequência ou produz respostas inutilizáveis pode ser caro, mesmo com uma tarifa baixa por token.
Os limites de taxa são separados do preço. Uma chave pode ser limitada por solicitações por minuto, tokens por minuto, simultaneidade, nível de conta ou disponibilidade do modelo. Um aplicativo deve respeitar o limite documentado e as orientações de novas tentativas do provedor, reduzir o ritmo quando apropriado e evitar multiplicar o tráfego durante uma interrupção. Não presuma que pagar antecipadamente por mais crédito aumenta automaticamente todos os limites.
O site atual da Flatkey descreve uma chave, saldo compartilhado e registros de uso no nível da solicitação entre modelos e ferramentas compatíveis. Esses são recursos operacionais de seu roteador; confirme o diretório de modelos ativo e a página de preços para o modelo e a unidade exatos antes de estimar uma carga de trabalho.
Questões de segurança, privacidade e confiabilidade
Uma API de IA envia dados para um limite de serviço. Antes de integrar uma, identifique quais campos podem conter informações pessoais, reguladas ou confidenciais. Leia os termos atuais de retenção e processamento do provedor, escolha a região ou opção de implantação necessária e decida o que seu aplicativo registra em logs. Se precisar ocultar informações na entrada, faça isso antes de enviá-la ao modelo e verifique se a ocultação é adequada para o caso de uso.
Trate a saída gerada como dados não confiáveis. Se um modelo sugerir uma alteração no banco de dados, um pagamento ou uma mensagem a um cliente, imponha permissões e verificações humanas ou determinísticas fora do modelo. Para recuperação ou uso de ferramentas, valide a fonte e os argumentos da ação. Uma chave de API deve ter o menor acesso de que o fluxo de trabalho precisa e deve ser rotacionada caso seja exposta.
Para confiabilidade, registre a latência, a taxa de erros, os IDs das solicitações e a versão do modelo usada. Especifique o que acontece quando um provedor retorna um limite de taxa, atinge o tempo limite ou altera a disponibilidade. Uma alternativa pode ajudar, mas pode alterar a qualidade e o formato da saída; teste-a antes de direcionar o tráfego de clientes. Se o recurso for importante, crie um conjunto de avaliação que possa ser executado após uma alteração no modelo ou no prompt.
Quando usar uma API direta, um roteador ou suas próprias GPUs
Use uma API direta do provedor quando os modelos e os controles de conta de um provedor atenderem ao requisito e o aplicativo puder aceitar essa dependência. Use um roteador quando precisar de uma interface ou operações compartilhadas entre vários provedores compatíveis; verifique se cada recurso de modelo necessário funciona por meio dessa camada. Considere a hospedagem própria quando os pesos do modelo, a utilização sustentada, a localização dos dados ou o controle justificarem a carga de hardware e operação.
A decisão é mensurável. Comece com a taxa de sucesso da tarefa, a latência aceitável, o volume útil mensal projetado, os requisitos de dados e a capacidade da equipe de lidar com incidentes. Compare os mesmos prompts e critérios de avaliação entre os candidatos. Se estiver comparando capacidade dedicada de GPU com chamadas de API, o guia da Flatkey sobre nuvem de GPU versus API de modelo mostra quais pressupostos de utilização e custo devem ser testados sob pressão.
Perguntas comuns
Uma API de IA é igual ao ChatGPT?
Não. O ChatGPT é um aplicativo. Uma API de IA é uma interface programática que um aplicativo pode chamar. Diferentes provedores e sistemas hospedados pelo próprio usuário expõem APIs e modelos diferentes.
Preciso treinar um modelo para usar uma API de IA?
Geralmente, não. Muitas APIs hospedadas fornecem modelos prontos para uso. Ainda é necessário criar prompts, validar resultados, monitorar o uso e decidir se o modelo atende aos requisitos da sua tarefa. O ajuste fino ou o treinamento é uma decisão separada.
Uma chave de API pode acessar todos os modelos de IA?
Nenhuma chave universal abrange todos os provedores e modelos. Um roteador pode apresentar uma única chave para os modelos e ferramentas que ele suporta, sujeito ao seu catálogo, à política da conta e à disponibilidade dos provedores upstream. Verifique a lista atual de modelos compatíveis antes de criar uma dependência.
O que devo testar antes do lançamento?
Teste a qualidade dos resultados em exemplos representativos, os limites de entrada e saída, o comportamento de respostas estruturadas, o streaming, se for utilizado, o tratamento de erros, os limites de taxa, os controles de privacidade, a latência sob carga e o custo por resultado aceito. Mantenha o ID do modelo e o ID da solicitação nos logs operacionais sem registrar desnecessariamente entradas sensíveis.