¿Qué es una API de IA?
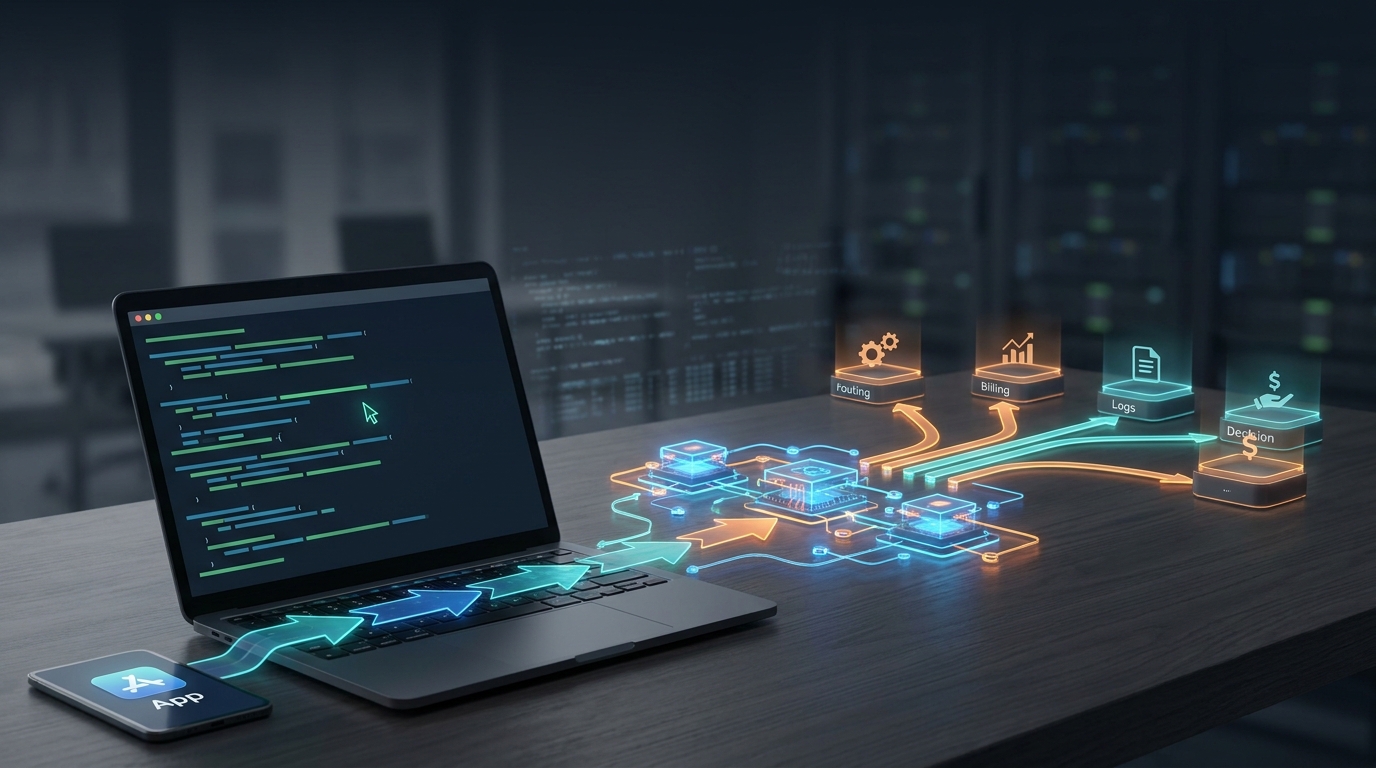
Una API de IA es una forma documentada para que el software solicite una capacidad de IA a otro servicio. Una aplicación envía una solicitud estructurada —a menudo un prompt, una imagen, un archivo de audio o un documento— junto con credenciales y el nombre de un modelo u operación. El servicio devuelve un resultado estructurado o un flujo de resultados. La aplicación puede entonces mostrar una respuesta, clasificar un ticket, transcribir voz, crear una imagen o continuar un flujo de trabajo.
La API es la interfaz, no el modelo en sí. Un modelo realiza la inferencia; la API define cómo un cliente solicita ese trabajo, recibe la respuesta y gestiona los errores. Algunos proveedores alojan sus propios modelos. Otros proporcionan una puerta de enlace a varios modelos. Un desarrollador también puede ejecutar un modelo abierto detrás de una API autoalojada. La elección adecuada depende de la tarea, el límite de los datos, el patrón de uso y la capacidad del equipo para operar la infraestructura.
Si el término es nuevo para ti, empieza con este modelo mental:
your app → authenticated request → AI API endpoint → model or tool → structured response → your app.
Para una definición general de una API como contrato entre componentes de software, consulta la explicación de API de AWS. La parte específica de la IA es el modelo o la herramienta que procesa la solicitud.
¿Qué puede hacer una API de IA?
| Capacidad | Entrada típica | Salida típica | Ejemplo de uso |
|---|---|---|---|
| Generación de texto | Prompt o mensajes de conversación | Texto o datos estructurados | Redactar una respuesta de soporte para revisión humana |
| Embeddings | Texto u otro contenido compatible | Vector numérico | Encontrar documentos semánticamente similares |
| Generación o edición de imágenes | Prompt e imagen opcional | Recurso de imagen | Crear una imagen conceptual de producto |
| Voz y audio | Audio o texto | Transcripción o audio sintetizado | Transcribir una reunión |
| Visión y análisis de documentos | Imagen, documento o entrada mixta | Descripción o campos extraídos | Leer una factura con verificación |
| Acceso a herramientas o datos | Consulta y parámetros de herramienta | Resultados de búsqueda o resultado de acción | Recuperar datos en tiempo real para un agente |
Estas son familias de API, no garantías de que todos los modelos admitan cada operación. Un modelo solo de texto no acepta imágenes automáticamente, y un endpoint de herramientas no es lo mismo que un endpoint de modelo generativo. Consulta el catálogo actual de modelos del proveedor, la documentación de endpoints, los límites de archivos y el esquema de respuesta antes de prometer una función en tu producto.
Cómo funciona una solicitud a una API de IA
Una solicitud útil tiene cuatro partes: una URL de destino, autenticación, una operación y una carga de entrada. El destino identifica el servicio y el endpoint. La credencial identifica la cuenta o el proyecto. La operación y el modelo determinan qué trabajo se solicita. La carga proporciona el prompt o los medios y cualquier configuración compatible.
Una aplicación de producción debe realizar la llamada desde su servidor, donde la clave de API puede mantenerse secreta. El servidor valida la entrada del usuario, establece un tiempo de espera razonable, envía la solicitud y comprueba la respuesta. Debe distinguir un error de autenticación de un límite de tasa, un modelo no disponible, una carga no válida o un fallo del proveedor. La interfaz de usuario debe recibir un resultado seguro para la aplicación en lugar de credenciales sin procesar o errores del proveedor sin filtrar.
Si la operación transmite tokens o medios, el cliente recibe partes a lo largo del tiempo. La transmisión puede mejorar la capacidad de respuesta percibida, pero la aplicación aún debe gestionar desconexiones y salidas incompletas. Para datos estructurados, valida la estructura devuelta antes de escribir en una base de datos o activar otra acción. La respuesta fluida de un modelo no es prueba de que un dato solicitado sea correcto.
La documentación de Flatkey describe su enrutador actual compatible con OpenAI y los flujos de trabajo compatibles. Un enrutador unificado permite a un equipo mantener una interfaz de cliente conocida mientras cambia los ID de modelo, pero aun así debes probar el comportamiento específico de cada modelo y la compatibilidad de endpoints. La plataforma de API de OpenAI y la documentación de la API de Claude son ejemplos de interfaces de proveedores directos con sus propios contratos de solicitud.
API de IA frente a una aplicación de IA, SDK, puerta de enlace y modelo autoalojado
Estos términos se solapan, pero resuelven problemas diferentes:
- Aplicación de IA: el producto orientado al usuario, como una interfaz de chat o una herramienta de escritura. Puede llamar internamente a una API.
- API de IA: el contrato programático que acepta una solicitud y devuelve un resultado.
- SDK: una biblioteca que ayuda al código a llamar a una API. Un SDK es práctico, pero el endpoint subyacente y las reglas de la cuenta siguen siendo importantes.
- Puerta de enlace de API o enrutador de modelos: una capa que puede aplicar autenticación compartida, enrutamiento, cuotas, registros y políticas antes de que el tráfico llegue a uno o varios proveedores de modelos.
- Servidor de inferencia autoalojado: software que expone una API para pesos de modelos que se ejecutan con capacidad que controlas. Eres responsable de la disponibilidad, el escalado, las actualizaciones y los costes.
Una puerta de enlace no sustituye la elección de un modelo adecuado. Un servidor autoalojado no es automáticamente más barato que una API. Una API alojada no es automáticamente adecuada para todos los requisitos de datos o latencia. Traza la ruta completa de la solicitud y decide qué componente asume cada responsabilidad.
Una primera integración que puedes probar de forma segura
Comience con una tarea específica, como clasificar un ticket de soporte interno en un conjunto fijo de categorías. Defina la entrada aceptada, el esquema de salida esperado y qué revisará una persona. Después:
- Elija un proveedor y un modelo que sean compatibles con la tarea. Lea la documentación actual del endpoint y del modelo en lugar de copiar un ejemplo antiguo.
- Cree una clave con alcance limitado. Guárdela en un almacén de secretos del lado del servidor o en una variable de entorno protegida. No la incluya en código de navegador, un binario móvil, una captura de pantalla ni un repositorio público.
- Realice una solicitud de prueba. Use el SDK documentado por el proveedor o un ejemplo HTTP y una entrada de muestra no sensible. Registre el ID de la solicitud y la estructura de la respuesta.
- Valide los casos de salida y de error. Pruebe entradas malformadas, credenciales ausentes, cuota insuficiente, respuestas lentas y una operación deliberadamente no compatible.
- Añada un presupuesto y monitorización. Realice un seguimiento de las llamadas, los tokens o unidades, los errores, la latencia y el gasto por funcionalidad o cliente. Establezca límites antes de abrir la funcionalidad a tráfico no controlado.
- Realice una evaluación pequeña. Compare las respuestas con ejemplos que tengan resultados aceptables conocidos. Revise la calidad, así como la latencia y el coste.
Esta secuencia es intencionadamente pequeña. Una respuesta de «hola mundo» demuestra el acceso, pero no demuestra que la API sea segura o rentable para un flujo de trabajo de producción.
Cómo suelen funcionar los precios y los límites
Las API de IA no facturan todas en la misma unidad. Los modelos de texto suelen cobrar por separado los tokens de entrada y de salida; algunos también distinguen la entrada almacenada en caché. Las herramientas de imagen, vídeo, audio y datos pueden facturar por recurso generado, duración, tamaño, llamada u otra unidad. Los créditos y límites gratuitos pueden cambiar, así que use los precios actuales del proveedor en lugar de una cifra copiada de una entrada de blog antigua.
Para obtener una estimación de costes realista, calcule:
coste mensual ≈ solicitudes elegibles × unidades facturables medias por solicitud × precio unitario actual.
Después añada reintentos, salidas más largas de lo previsto, llamadas a herramientas y un escenario de alto uso. Registre el resultado útil aceptado, no solo el número de solicitudes intentadas. Un flujo de trabajo que se reintenta con frecuencia o produce respuestas inutilizables puede resultar caro incluso con una tarifa baja por token.
Los límites de velocidad son independientes del precio. Una clave puede estar limitada por solicitudes por minuto, tokens por minuto, concurrencia, nivel de cuenta o disponibilidad del modelo. Una aplicación debe respetar el límite documentado por el proveedor y las indicaciones sobre reintentos, aplicar espera progresiva cuando corresponda y evitar multiplicar el tráfico durante una interrupción. No asuma que prepagar más crédito aumenta automáticamente todos los límites.
El sitio actual de Flatkey describe una clave, saldo compartido y registros de uso a nivel de solicitud en los modelos y herramientas compatibles. Estas son características operativas de su enrutador; confirme el directorio de modelos activo y la página de precios para el modelo y la unidad exactos antes de estimar una carga de trabajo.
Preguntas sobre seguridad, privacidad y fiabilidad
Una API de IA envía datos a un límite de servicio. Antes de integrar una, identifique qué campos pueden contener información personal, regulada o confidencial. Lea las condiciones actuales de retención y procesamiento del proveedor, elija la región o la opción de implementación requerida y decida qué registra su aplicación. Si necesita ocultar datos en la entrada, hágalo antes de enviarla al modelo y verifique que la ocultación sea suficiente para el caso de uso.
Trate la salida generada como datos no fiables. Si un modelo sugiere un cambio en la base de datos, un pago o un mensaje a un cliente, aplique permisos y comprobaciones humanas o deterministas fuera del modelo. Para la recuperación o el uso de herramientas, valide la fuente y los argumentos de la acción. Una clave de API debe tener el mínimo acceso que necesite el flujo de trabajo y debe rotarse si queda expuesta.
Para garantizar la fiabilidad, registre la latencia, la tasa de errores, los ID de solicitud y la versión del modelo utilizada. Especifique qué sucede cuando un proveedor devuelve un límite de velocidad, se agota el tiempo de espera o cambia la disponibilidad. Una alternativa puede ayudar, pero podría cambiar la calidad y el formato de la salida; pruébela antes de dirigir tráfico de clientes. Si la funcionalidad es importante, cree un conjunto de evaluación que pueda ejecutarse después de un cambio de modelo o de prompt.
Cuándo usar una API directa, un enrutador o sus propias GPU
Use una API directa del proveedor cuando los modelos y controles de cuenta de un proveedor cumplan el requisito y la aplicación pueda aceptar esa dependencia. Use un enrutador cuando necesite una interfaz u operaciones compartidas entre varios proveedores compatibles; verifique que cada característica del modelo que necesita funcione a través de esa capa. Considere el autoalojamiento cuando los pesos del modelo, la utilización sostenida, la localización de los datos o el control justifiquen la carga de hardware y operación.
La decisión es medible. Comience con la tasa de éxito de la tarea, la latencia aceptable, el volumen útil mensual proyectado, los requisitos de datos y la capacidad del equipo para atender incidencias. Compare los mismos prompts y criterios de evaluación entre las alternativas. Si está valorando capacidad de GPU dedicada frente a llamadas a API, la guía de Flatkey sobre nube de GPU frente a API de modelos muestra qué supuestos de utilización y coste deben someterse a pruebas de estrés.
Preguntas frecuentes
¿Una API de IA es lo mismo que ChatGPT?
No. ChatGPT es una aplicación. Una API de IA es una interfaz programática a la que una aplicación puede llamar. Los distintos proveedores y sistemas autoalojados exponen diferentes API y modelos.
¿Necesito entrenar un modelo para usar una API de IA?
Normalmente no. Muchas API alojadas ofrecen modelos listos para usar. Aun así, debes diseñar prompts, validar resultados, supervisar el uso y decidir si el modelo cumple los requisitos de tu tarea. El ajuste fino o el entrenamiento es una decisión aparte.
¿Puede una clave de API acceder a todos los modelos de IA?
Ninguna clave universal cubre todos los proveedores y modelos. Un router puede presentar una clave para los modelos y herramientas que admite, sujeto a su catálogo, política de cuenta y disponibilidad ascendente. Consulta la lista actual de modelos compatibles antes de crear una dependencia.
¿Qué debo probar antes del lanzamiento?
Prueba la calidad de los resultados con ejemplos representativos, los límites de entrada y salida, el comportamiento de las respuestas estructuradas, el streaming si se utiliza, la gestión de errores, los límites de tasa, los controles de privacidad, la latencia bajo carga y el coste por resultado aceptado. Conserva el ID del modelo y el ID de la solicitud en los registros operativos sin registrar innecesariamente entradas sensibles.