Was ist ein LLM-Gateway? Funktionsweise, wichtige Features und 7 Optionen im Vergleich (2026)
Ein LLM-Gateway ist eine einheitliche API-Schicht zwischen Ihrer Anwendung und einem oder mehreren Modellanbietern. Es übernimmt Authentifizierung, Routing, Fallback, Rate Limits, Kostenverfolgung und Logging, sodass Ihr Code einen einzigen Endpunkt aufruft, statt jeden Anbieter einzeln zu integrieren. Die meisten Gateways bieten eine OpenAI-kompatible API. Der Wechsel von GPT zu Claude, Gemini oder Qwen bedeutet dann, einen model-String zu ändern, statt eine neue SDK-Integration auszurollen.
Dieser Leitfaden erklärt Schritt für Schritt, wie ein LLM-Gateway funktioniert, welche neun Features zählen, wie es sich von einem API-Gateway, einem Modell-Router und einem MCP-Gateway unterscheidet, wann Sie eines brauchen und wann nicht, und wie sieben verbreitete Gateways abschneiden. Die Produktangaben wurden am 20. Oktober 2026 mit der offiziellen Dokumentation der jeweiligen Anbieter abgeglichen.
Definition: LLM-Gateway
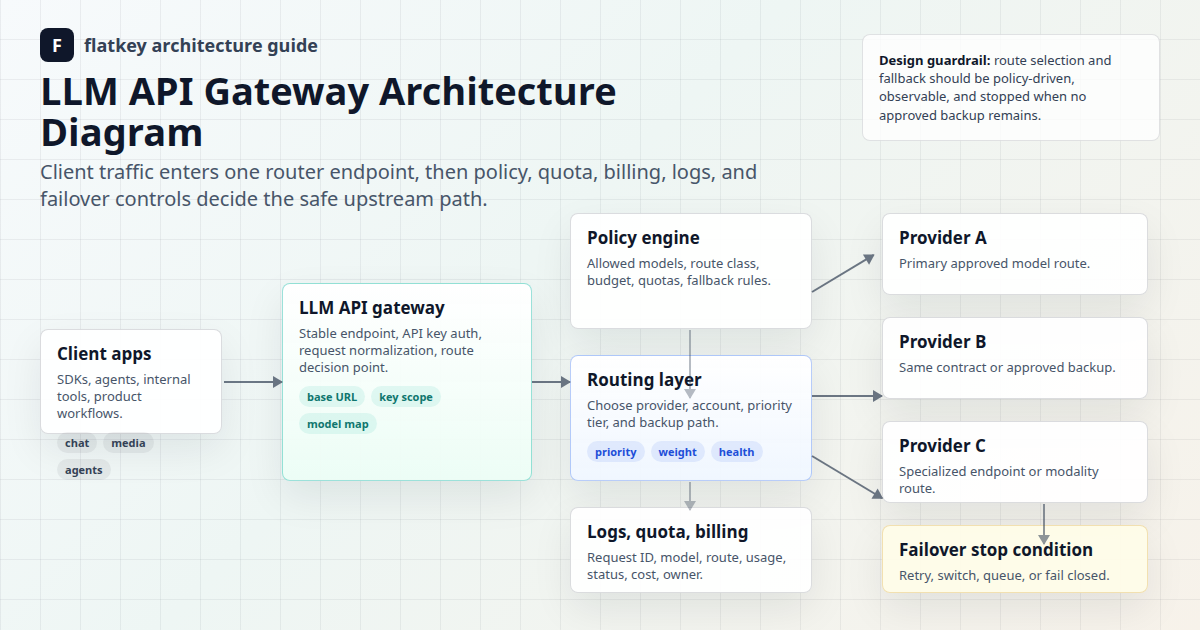
Ein LLM-Gateway (auch AI-Gateway oder LLM-API-Gateway genannt) nimmt Modellanfragen von Anwendungen entgegen, wendet gemeinsame Kontrollen an, leitet jede Anfrage an einen passenden Modell-Endpunkt weiter und gibt die Antwort in einem einheitlichen Format zurück.
Your apps ──► LLM gateway ──┬──► OpenAI
                            ├──► Anthropic
  one key                   ├──► Google
  one API shape             ├──► Alibaba (Qwen)
  one usage ledger          └──► fallback provider
Das Gateway hostet die Modelle nicht. Es steuert den Zugriff darauf.
Warum Teams ein LLM-Gateway einführen
Ohne Gateway speichert jeder Service eigene Anbieter-Keys, implementiert eigene Retries und protokolliert die Nutzung im eigenen Format. Mit jedem neuen Anbieter wachsen die Probleme:
| Ohne Gateway | Mit Gateway |
|---|---|
| Ein Key pro Anbieter und Service | Ein Gateway-Key pro Service, zentral rotiert (Leitfaden zur Key-Rotation) |
| Unterschiedliche SDKs und Fehlerformate | Ein API-Format, meist OpenAI-kompatibel |
| Ein Ausfall erfordert eine Code-Änderung | Fallback ist Konfiguration |
| Ausgaben über viele Rechnungen verteilt | Ein Nutzungsbuch pro Team, Key und Modell |
| Keine gemeinsamen Rate Limits | Kontingente und Budgets pro Key |
Auch die Preise der Anbieter liegen so weit auseinander, dass sich Routing lohnt. Am 20. Oktober 2026 reichten die Output-Listenpreise auf den Flatkey-Modellseiten von 0,47 $ pro 1 Mio. Tokens (qwen3.8-flash) über 10,00 $ (gpt-6-sol, claude-sonnet-5-5) bis 15,00 $ (kimi-k3). Mit einem Gateway nutzen Sie diese Spanne, ohne Code umzuschreiben.
So funktioniert ein LLM-Gateway Schritt für Schritt
- Die App sendet eine Anfrage mit einem Gateway-Key an die Base URL des Gateways.
- Authentifizierung: Das Gateway prüft den Key und lädt dessen Richtlinie (erlaubte Modelle, Budget, Rate Limit).
- Vorab-Richtlinien: Es prüft Kontingente, kann Inhalte schwärzen oder blockieren und hängt Metadaten wie Team, Umgebung oder Feature an.
- Routing: Es wählt den Anbieter-Endpunkt für das angefragte Modell oder die nächste funktionierende Route einer Fallback-Kette.
- Anbieteraufruf: Bei Bedarf übersetzt es die Anfrage ins Anbieterformat und streamt die Antwort zurück.
- Protokollierung: Es erfasst Modell, Latenz, Tokens, Kosten, Status und Request-ID für Observability und Abrechnung.
Die 9 wichtigsten Features eines LLM-Gateways
| Feature | Worauf Sie achten sollten |
|---|---|
| Einheitliche API | OpenAI-kompatibles /v1/chat/completions, dazu Responses oder Messages, falls Sie diese nutzen |
| Modellkatalog | Welche Modelle live sind und wie schnell neue Releases verfügbar werden |
| Fallback und Failover | Geordnete Ketten und ihre Auslöser (429, 5xx, Timeout) |
| Load Balancing | Über Keys, Regionen oder Anbieter hinweg |
| Rate Limits und Budgets | Pro Key, Team und Modell, mit harten Obergrenzen |
| Observability | Request-Logs, Token-Verbrauch, Latenz und Fehler, idealerweise exportierbar über die OpenTelemetry-GenAI-Konventionen |
| Kostenverfolgung | Pro Key, Team und Umgebung (Leitfaden zur Kostenzuordnung) |
| Caching | Exaktes oder semantisches Response-Caching sowie Durchreichen des Prompt-Cachings der Anbieter |
| Sicherheit und Richtlinien | Key-Scopes, Schwärzung personenbezogener Daten, Aufbewahrungsbedingungen, SOC-2- oder AVV/DPA-Nachweise |
LLM-Gateway vs. API-Gateway vs. Modell-Router vs. MCP-Gateway
| Ebene | Steuert | Versteht Tokens und Modelle? | Beispiel |
|---|---|---|---|
| API-Gateway | Allgemeine HTTP-APIs | Nein | Kong, AWS API Gateway |
| LLM-Gateway | Modell-Traffic über Anbieter hinweg | Ja | LiteLLM, Portkey, Flatkey |
| Modell-Router | Welches Modell welchen Prompt beantwortet | Ja | RouteLLM, eine Regel-Engine |
| MCP-Gateway | Tool-Aufrufe von Agenten über das Model Context Protocol | Auf Tool-Ebene | MCP-Proxys und -Registries |
Was ist der Unterschied zwischen einem MCP-Gateway und einem LLM-Gateway? Ein LLM-Gateway regelt Aufrufe an Modelle. Ein MCP-Gateway regelt Aufrufe von Agenten an Tools und Datenquellen über das Model Context Protocol. Agentenplattformen brauchen oft beides: ein LLM-Gateway für die Modellkosten und ein MCP-Gateway für Tool-Berechtigungen. Siehe Gateway-Kontrollen für KI-Agenten und AI-API-Gateway vs. API-Management.
7 LLM-Gateways im Vergleich (2026)
| Gateway | Bereitstellung | Open Source | Stärke | Zu beachten |
|---|---|---|---|---|
| LiteLLM | Selbst gehosteter Proxy oder SDK | Ja | 100+ Anbieter, Routing, Budgets | Betrieb, Skalierung und Patches liegen bei Ihnen |
| Portkey | Gehostet oder selbst gehostet | Gateway-Kern ist Open Source | Guardrails, Observability | Erweiterte Funktionen in Bezahlplänen |
| Cloudflare AI Gateway | Gehostet am Edge | Nein | Caching, Analytics, Rate Limiting | Anbieter-Keys verwalten Sie weiterhin selbst |
| Kong AI Gateway | Selbst gehostet oder Konnect | Kern ist Open Source | Passt zu bestehendem Kong-API-Management | Aufwendige Plugin-Konfiguration |
| Vercel AI Gateway | Gehostet | Nein | Enge Integration mit Vercel und AI SDK | Am besten im Vercel-Ökosystem |
| OpenRouter | Gehostet | Nein | Sehr breiter Modellkatalog, Credits | Geteiltes Marktplatz-Routing |
| Flatkey | Gehostet | Nein | Ein Key und ein Guthaben für GPT, Claude, Gemini, Qwen, DeepSeek, Kimi, GLM sowie Bild und Video | Katalog bei Nischenmodellen prüfen |
Ausführlichere Vergleiche: Leitfaden zur Wahl des besten LLM-Gateways, OpenRouter-Alternativen, Portkey-Alternativen, Vercel-AI-Gateway-Alternativen und Managed Gateway vs. selbst gehosteter Proxy.
So sieht ein LLM-Gateway im Code aus
Mit einem OpenAI-kompatiblen Gateway behält Ihre App das OpenAI-SDK und ändert nur zwei Werte: die Base URL und den Key. Ein Anbieterwechsel ist danach eine String-Änderung.
curl
curl https://router.flatkey.ai/v1/chat/completions \
  -H "Authorization: Bearer $FLATKEY_API_KEY" -H "Content-Type: application/json" \
  -d '{"model": "claude-sonnet-5-5", "messages": [{"role": "user", "content": "What is an LLM gateway?"}]}'
Python: ein Client, mehrere Anbieter, automatischer Fallback
import os
from openai import OpenAI, APIError

gw = OpenAI(api_key=os.environ["FLATKEY_API_KEY"], base_url="https://router.flatkey.ai/v1")

def complete(prompt, chain=("gpt-6-sol", "claude-sonnet-5-5", "gemini-3.5-flash")):
    for model in chain:
        try:
            r = gw.chat.completions.create(model=model, messages=[{"role": "user", "content": prompt}])
            return model, r.choices[0].message.content, r.usage.total_tokens
        except APIError as err:
            print(f"{model} -> {err.__class__.__name__}, trying next")
    raise RuntimeError("no route available")

print(complete("Give me one sentence on why gateways log token usage."))
Node.js
import OpenAI from "openai";
const gw = new OpenAI({ apiKey: process.env.FLATKEY_API_KEY, baseURL: "https://router.flatkey.ai/v1" });

const models = ["qwen3.8-max", "gpt-6-luna"];
const results = await Promise.all(models.map((model) =>
  gw.chat.completions.create({ model, messages: [{ role: "user", content: "Define 'fallback' in 8 words." }] })
));
results.forEach((r, i) => console.log(models[i], r.usage.total_tokens, r.choices[0].message.content));
Ohne Gateway bräuchten Sie dafür drei SDKs, drei Keys und drei Fehlerformate. Für den ersten Aufruf folgen Sie dem Flatkey-Quickstart.
OpenAI-Kompatibilität: was sie garantiert und was nicht
„OpenAI-kompatibel“ bedeutet, dass das Format von Anfrage und Antwort der Chat Completions API von OpenAI entspricht. Es garantiert nicht, dass jedes Modell jedes Feature unterstützt. Testen Sie vor der Migration pro Modell:
- Streaming-Chunks und
finish_reason-Werte - Tool- bzw. Function-Calling und parallele Tool-Calls
- Strukturierte Ausgabe oder JSON-Modus
- Bild- und Dateieingaben
usage-Felder, einschließlich gecachter Tokens- Fehlercodes bei Rate Limits und Kontextüberlauf (Fehler-Taxonomie)
Wann Sie ein LLM-Gateway brauchen (und wann nicht)
Sie brauchen wahrscheinlich eines, wenn: - Sie zwei oder mehr Modellanbieter nutzen oder das planen. - Mehrere Teams oder Services sich KI-Ausgaben teilen und Budgets pro Team brauchen. - Sie Failover bei Anbieterausfällen benötigen. - Die Finanzabteilung ein Nutzungsbuch statt fünf Rechnungen braucht.
Sie brauchen vielleicht noch keines, wenn: - Sie einen Prototyp auf einem Modell mit wenig Traffic betreiben. - Ihr Anbietervertrag direkten Zugriff ohne Zwischenschicht verlangt.
Ein LLM-Gateway an einem Nachmittag bewerten
- Vertragstest: Schicken Sie Ihre 20 häufigsten Anfragen (Streaming, Tools, JSON) hindurch.
- Fehlertest: Erzwingen Sie eine falsche Modell-ID und einen Timeout. Greift der Fallback, und ist der Fehler verständlich?
- Overhead-Test: Vergleichen Sie P50- und P95-Latenz mit dem direkten Anbieteraufruf.
- Buchungstest: Stimmen die protokollierten Tokens mit dem
usagedes Anbieters überein? Sind Kosten pro Key sichtbar? - Sicherheitsprüfung: Prüfen Sie Key-Scopes, Log-Aufbewahrung und Bedingungen zur Datenverarbeitung (DPA-Checkliste).
- Ausstiegstest: Kommen Sie wieder los, indem Sie einfach die Base URL zurücksetzen?
FAQ
Was ist ein LLM-Gateway?
Ein LLM-Gateway ist eine Middleware-API zwischen Anwendungen und Modellanbietern. Es bündelt Authentifizierung, Routing, Fallback, Rate Limits, Logging und Kostenverfolgung hinter einem einzigen, meist OpenAI-kompatiblen Endpunkt.
Welche LLM-Gateways sind am beliebtesten?
Verbreitete Optionen im Jahr 2026 sind LiteLLM (Open Source, selbst gehostet), Portkey, Cloudflare AI Gateway, Kong AI Gateway, Vercel AI Gateway, OpenRouter und gehostete Router wie Flatkey.
Ist ein LLM-Gateway kostenlos?
Open-Source-Gateways wie LiteLLM sind kostenlos nutzbar, aber Sie zahlen für Hosting und Betrieb. Gehostete Gateways verlangen entweder Plattformgebühren oder rechnen die Modellnutzung zu eigenen Preisen ab. So oder so kosten die Modell-Tokens weiterhin Geld.
Was ist der Unterschied zwischen einem MCP-Gateway und einem LLM-Gateway?
Ein LLM-Gateway verwaltet Anfragen an Sprachmodelle. Ein MCP-Gateway verwaltet Anfragen von Agenten an Tools und Datenquellen über das Model Context Protocol. Sie lösen unterschiedliche Probleme und werden oft gemeinsam eingesetzt.
Ist ein LLM-Gateway dasselbe wie ein AI-Gateway?
Meistens ja. „AI-Gateway“ ist der breitere Marketingbegriff und umfasst oft auch Bild-, Video- und Audiomodelle. „LLM-Gateway“ betont Textmodelle.
Erhöht ein LLM-Gateway die Latenz?
Ein wenig: einen zusätzlichen Netzwerk-Hop plus Richtlinienprüfungen. Messen Sie den P95-Overhead in Ihrer eigenen Region. Bei einem Ausfall spart der Failover meist weit mehr Zeit, als der Hop kostet.
Kann ein LLM-Gateway Kosten senken?
Ja, indirekt. Es erleichtert, Routing zu günstigeren Modellen, Caching und Budgetgrenzen konsequent anzuwenden. Die Tokens eines bestimmten Modells macht es nicht günstiger, es sei denn, das Gateway bietet selbst rabattierte Preise an.
Fazit
Ein LLM-Gateway macht aus vielen Anbieterintegrationen einen kontrollierten Endpunkt: ein Key, ein API-Format, ein Nutzungsbuch und Fallback als Konfiguration. Wählen Sie Self-Hosting (LiteLLM, Kong), wenn Sie volle Kontrolle wollen und den Betrieb stemmen können. Wählen Sie eine gehostete Lösung (Portkey, Cloudflare, Vercel, OpenRouter, Flatkey), wenn Sie keine Infrastruktur betreiben möchten. Um den gehosteten Weg auszuprobieren, sehen Sie sich das Flatkey-Modellverzeichnis und die Preisseite an.
Zuletzt aktualisiert: 20. Oktober 2026 · Flatkey Team. Die Produktangaben fassen die im Text verlinkte offizielle Dokumentation zusammen.