
flatkey.ai Blog
Einblicke, Produktnotizen und Implementierungsleitfäden für Teams, die mit KI-APIs entwickeln.
Architektur von KI-Gateways
Neueste Artikel in Architektur von KI-Gateways.
WeiterlesenMigration von Basis-URL und SDK
Neueste Artikel in Migration von Basis-URL und SDK.
WeiterlesenKosten, Abrechnung und Betrieb
Neueste Artikel in Kosten, Abrechnung und Betrieb.
WeiterlesenUnternehmenskontrollen und Vertrauen
Neueste Artikel in Unternehmenskontrollen und Vertrauen.
WeiterlesenGateway-Vergleiche
Neueste Artikel in Gateway-Vergleiche.
WeiterlesenLeitfäden für Modelle und Modalitäten
Neueste Artikel in Leitfäden für Modelle und Modalitäten.
WeiterlesenZuverlässigkeit und Routing
Neueste Artikel in Zuverlässigkeit und Routing.
WeiterlesenWerkzeugintegrationen
Neueste Artikel in Werkzeugintegrationen.
Weiterlesen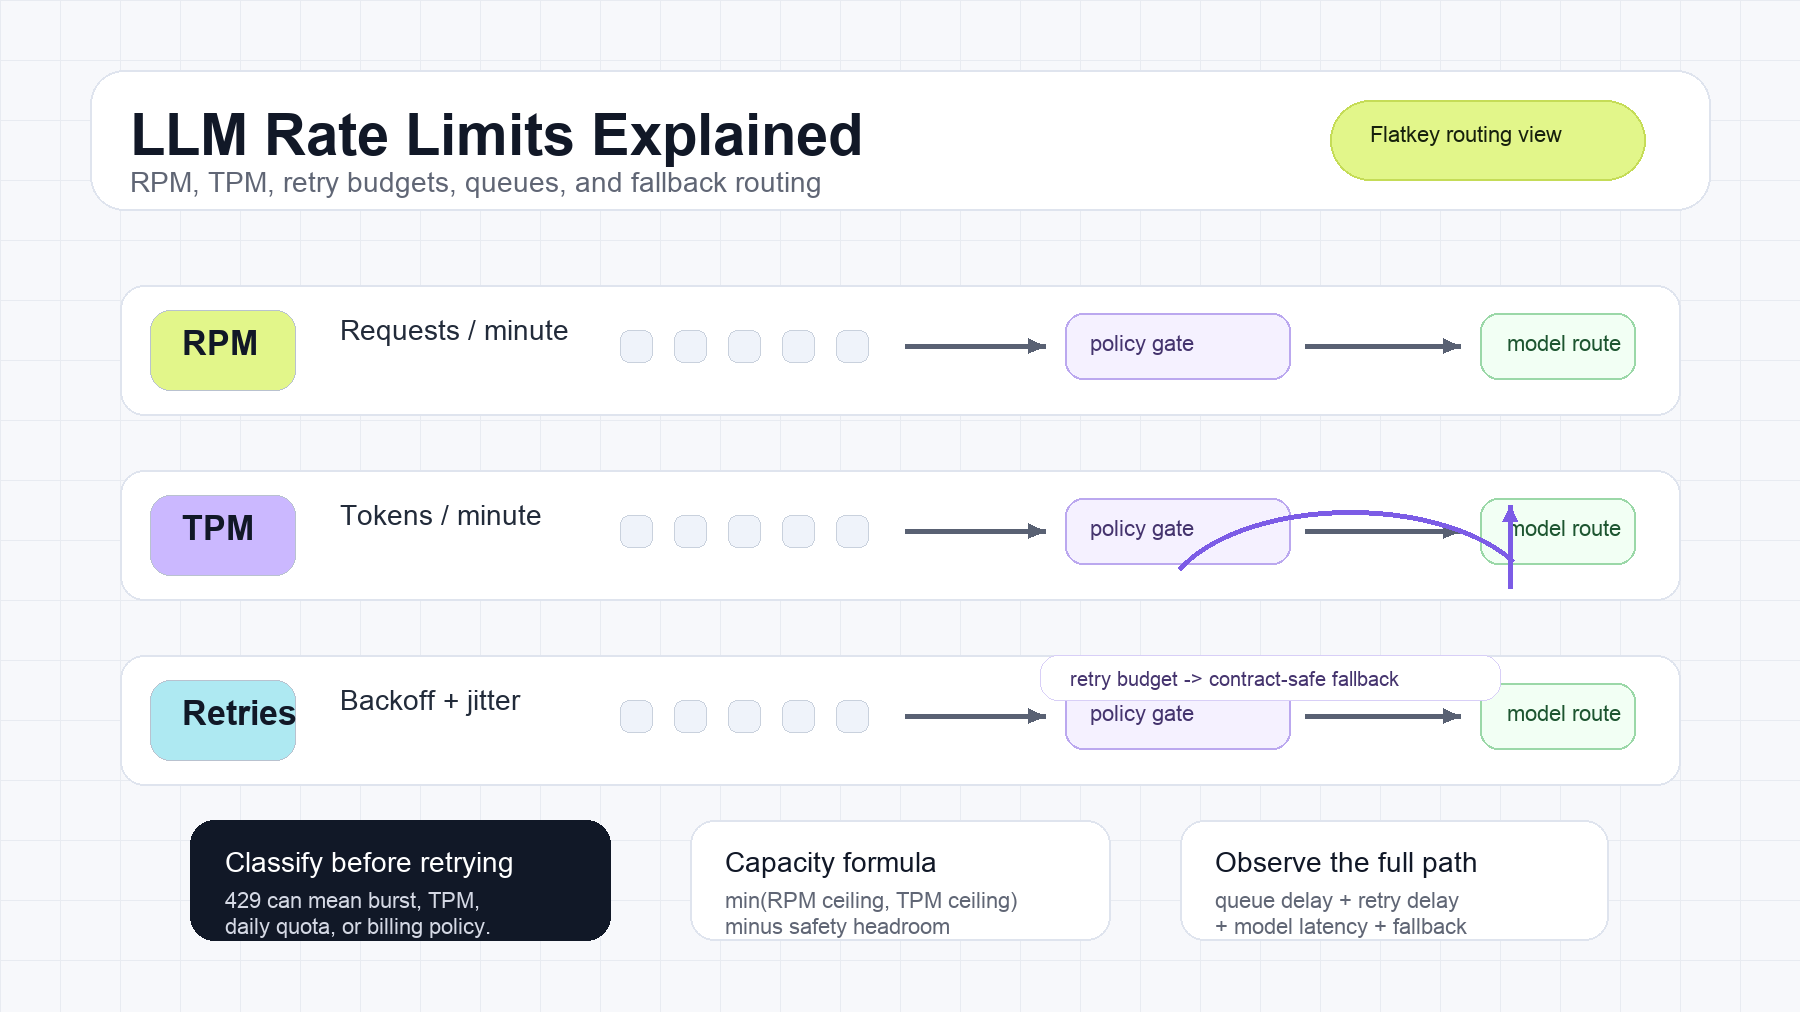
LLM-Rate-Limits erklärt: RPM, TPM und Retries
Verstehen Sie LLM-Rate-Limits, RPM, TPM, 429-Fehler, Retry-After, exponentiellen Backoff, Retry-Budgets, Queues und Fallback-Routing.
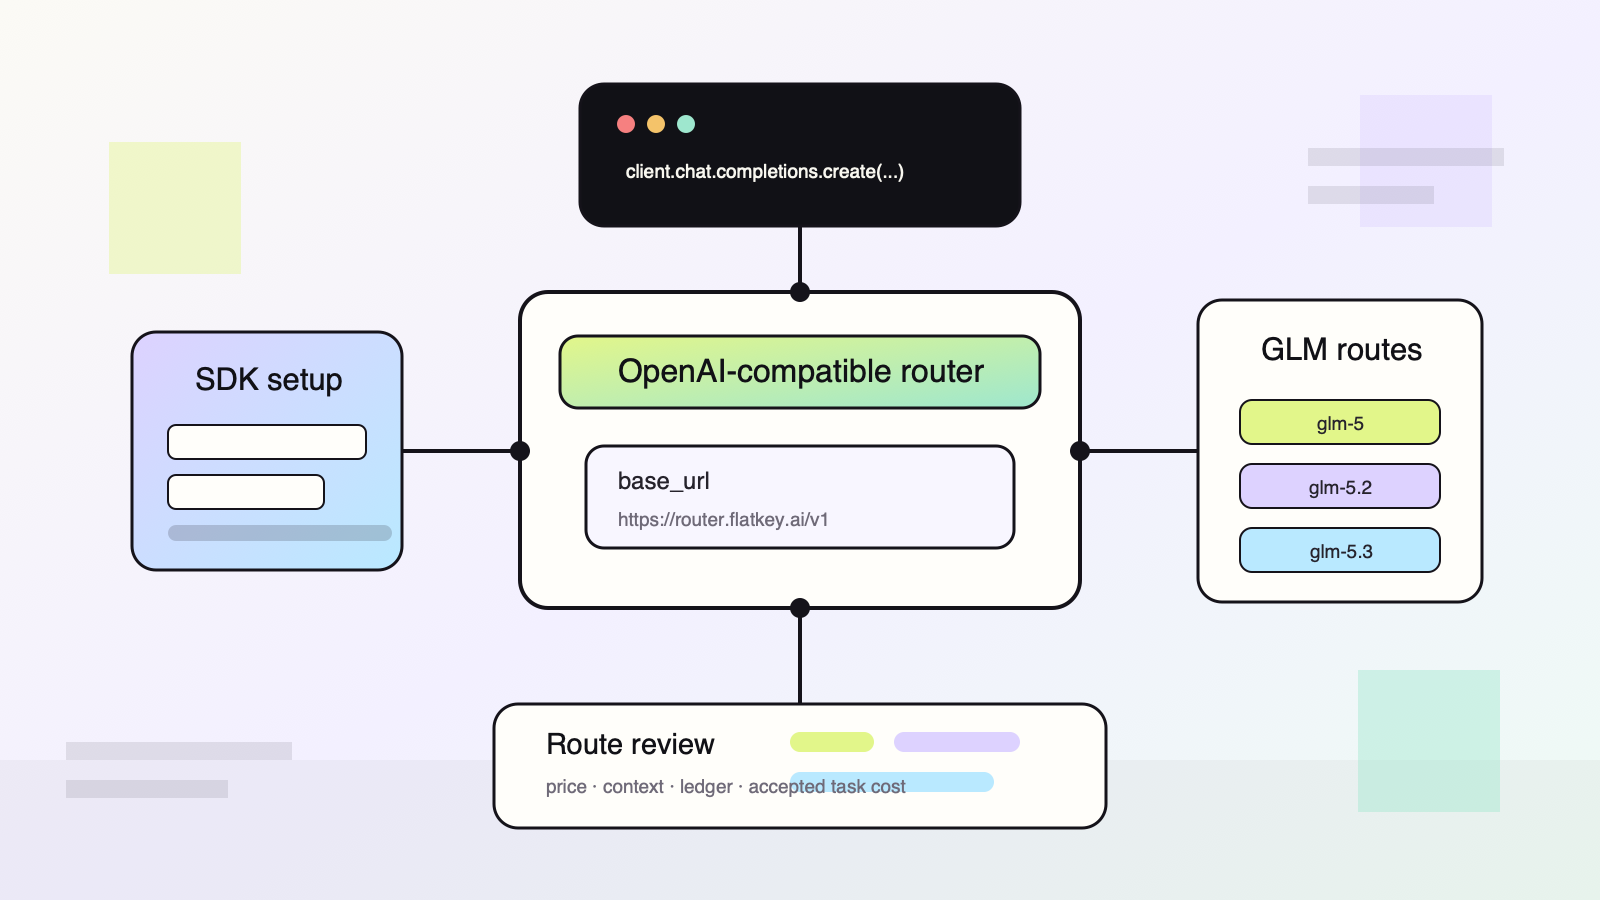
GLM-5 API-Zugriff: Preise und OpenAI-kompatibles Setup
Vergleichen Sie die API-Preise der GLM-5-Familie, Modell-IDs, Kontextfenster und OpenAI-kompatible Setup-Muster für Z.AI und Flatkey.
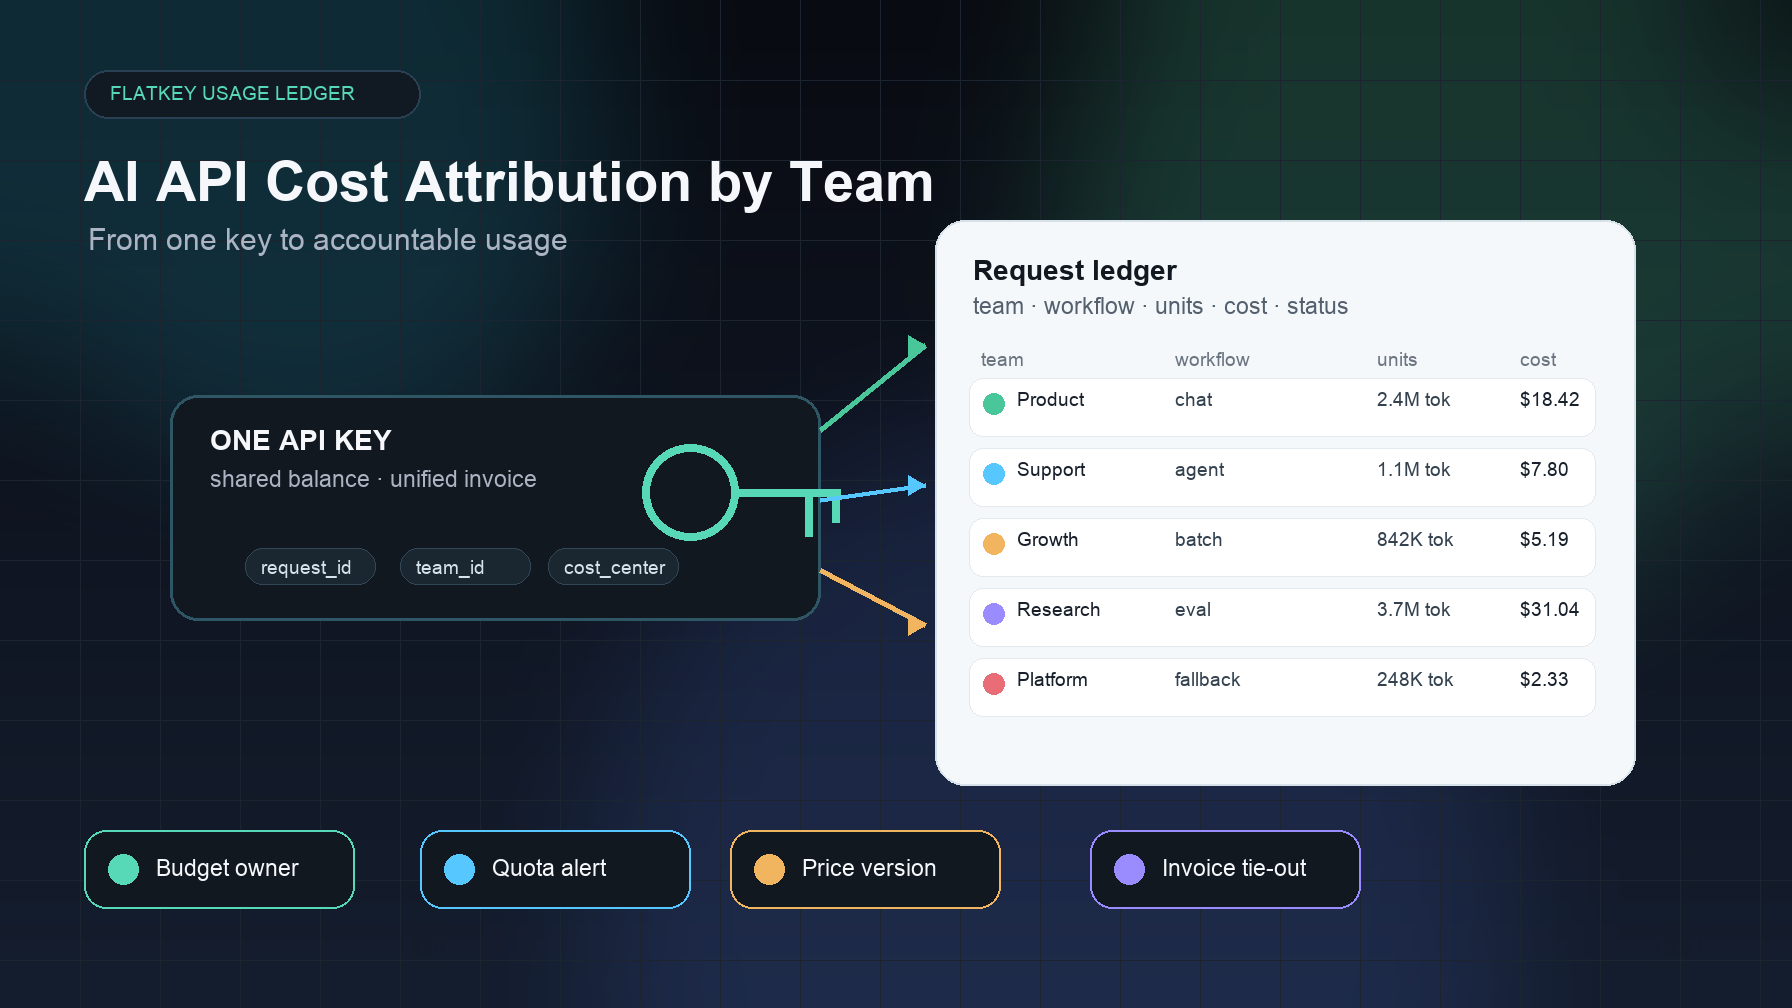
KI-API-Kostenverteilung nach Team: Von einem Schlüssel zu nachvollziehbarer Nutzung
Erstellen Sie eine KI-API-Kostenverteilung nach Team mit Request-Tags, Sub-Key-Grenzen, Nutzungsprotokollen, Kontingenten und monatlicher Finanzprüfung.
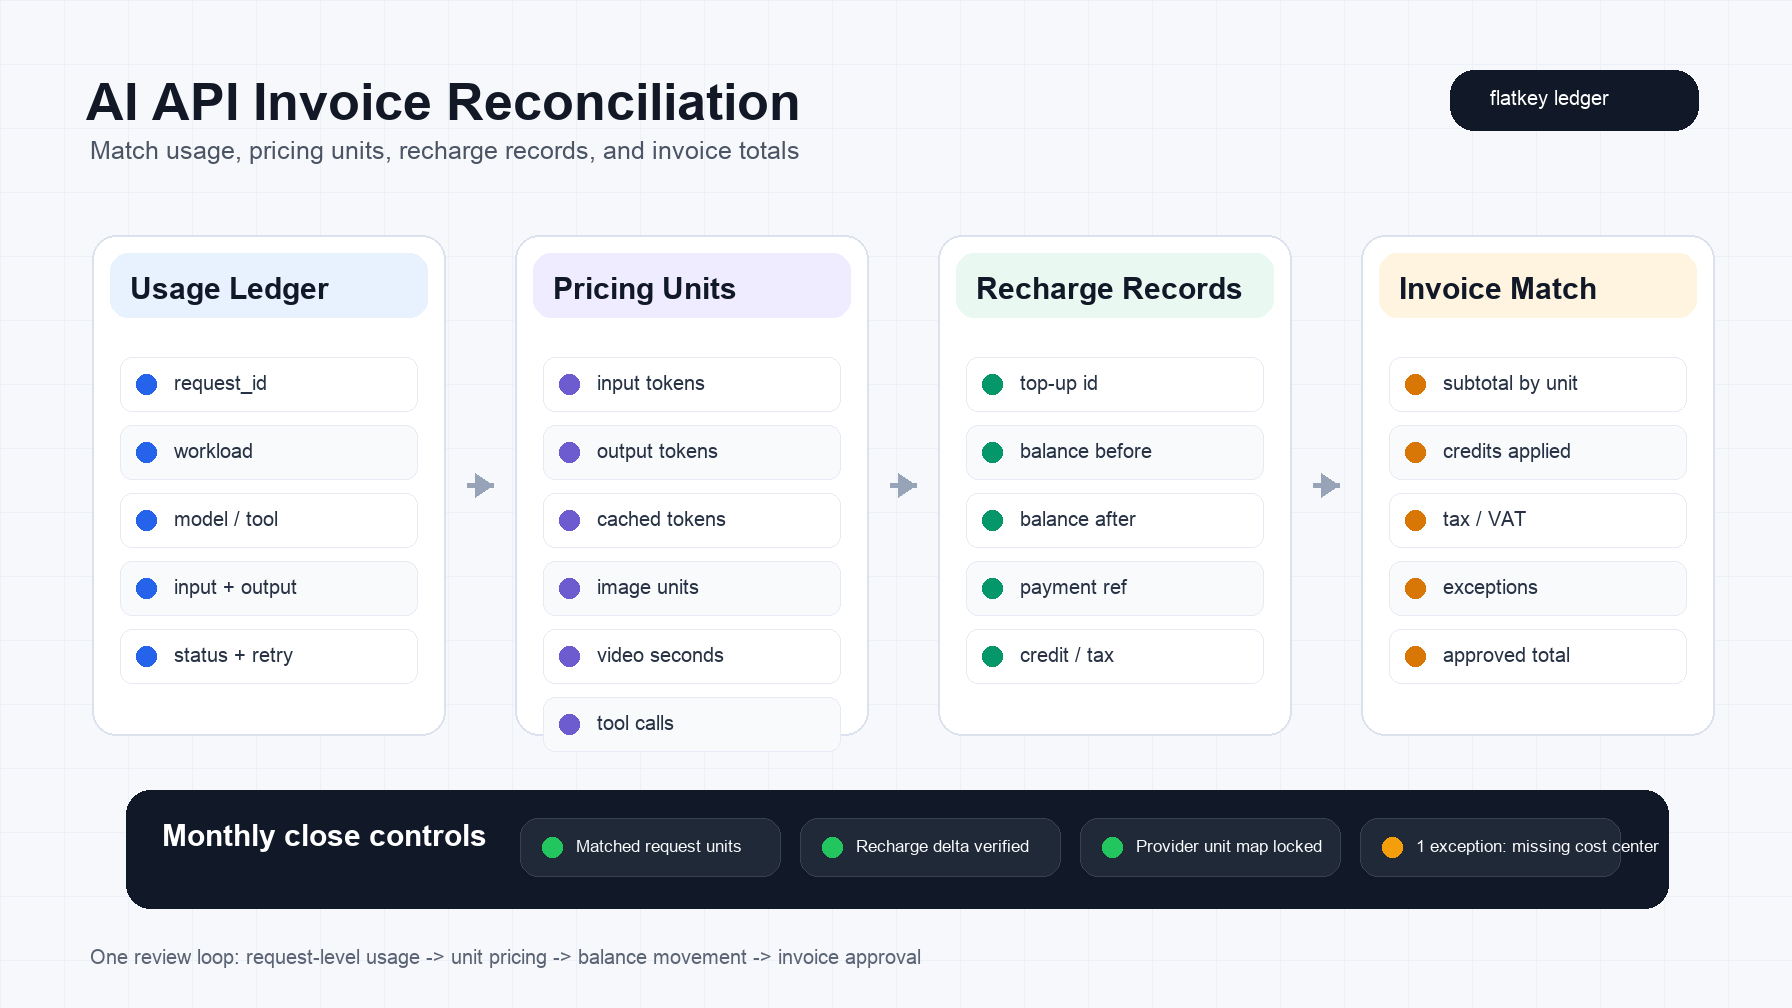
AI-API-Rechnungsabgleich: Nutzung, Preiseinheiten und Aufladebuchungen abgleichen
Stimmen Sie AI-API-Rechnungen ab, indem Sie Nutzungsprotokolle, Preiseinheiten, Aufladebuchungen, Kontobewegungen, Guthaben, Steuern und Rechnungssummen abgleichen.
Anthropic API-Preise (Oktober 2026): Alle Claude-Modelle, Caching, Batch und echte Kostenrechnung
Alle Anthropic-API-Preise im Oktober 2026, von Haiku 5.5 mit $0,10/$0,50 bis Fable 5.1 mit $10/$50, plus Caching, Batch API, Datenresidenz, Fast Mode, Ausgabenlimits und durchgerechnete Monatsbudgets.
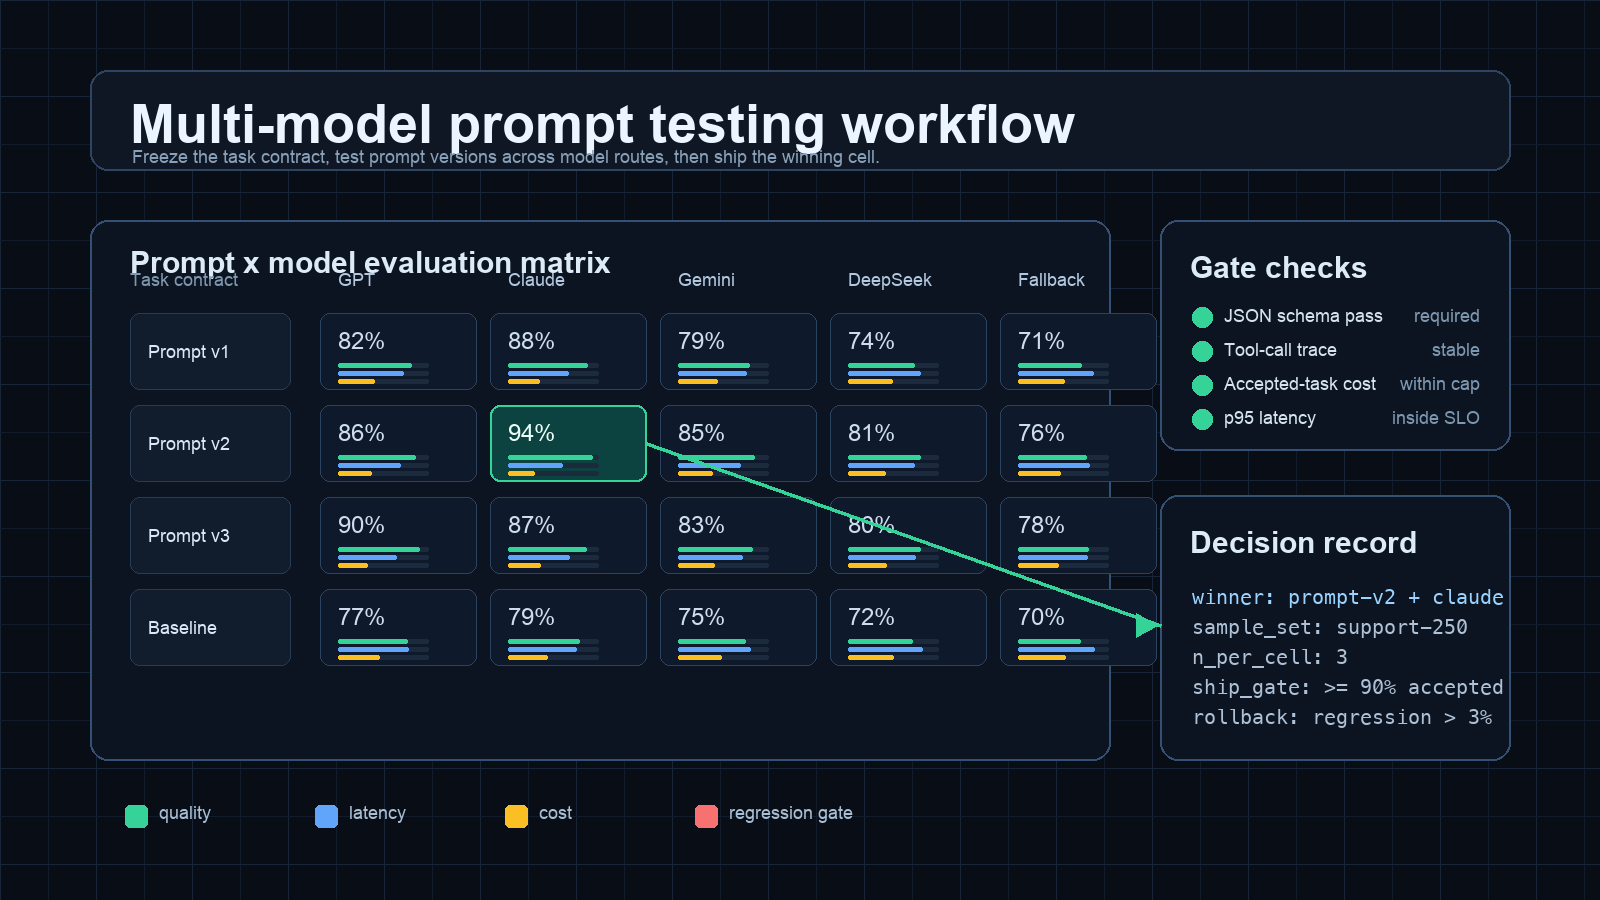
Multi-Model Prompt-Testing-Workflow: Bewertungsmatrix für KI-Produktteams
Führen Sie einen Multi-Model Prompt-Testing-Workflow mit Prompt-/Modell-Matrizen, Validatoren, Kosten pro akzeptierter Aufgabe, Latenz-Gates und Rollout-Protokollen durch.
Wie Sie die Preise von KI-Modellen vergleichen, bevor Sie den API-Anbieter wechseln
Vergleichen Sie die Preise von KI-Modellen anhand von Cache-Verhalten, Qualität der akzeptierten Ausgaben, Latenz, Retries und effektiven Kosten pro erfolgreicher Aufgabe, bevor Sie den API-Anbieter wechseln.
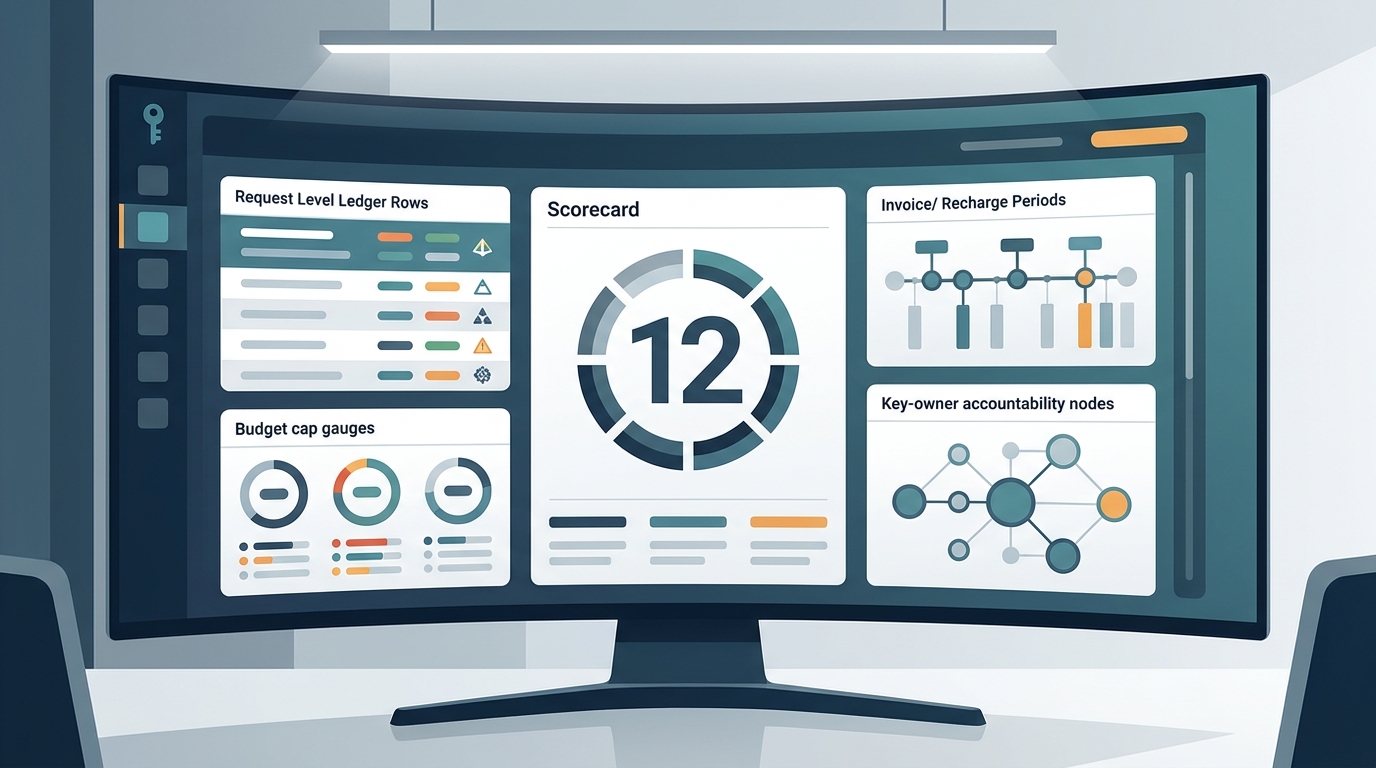
Einheitliches AI-Abrechnungsdashboard: 12 Fragen vor dem Kauf
Ein 12-Fragen-Käuferleitfaden zur Bewertung einheitlicher AI-Abrechnungsdashboards über Nutzungsprotokolle, API-Keys, Kontingente, Aufladungen, Exporte, Rechnungen und Nachvollziehbarkeit.
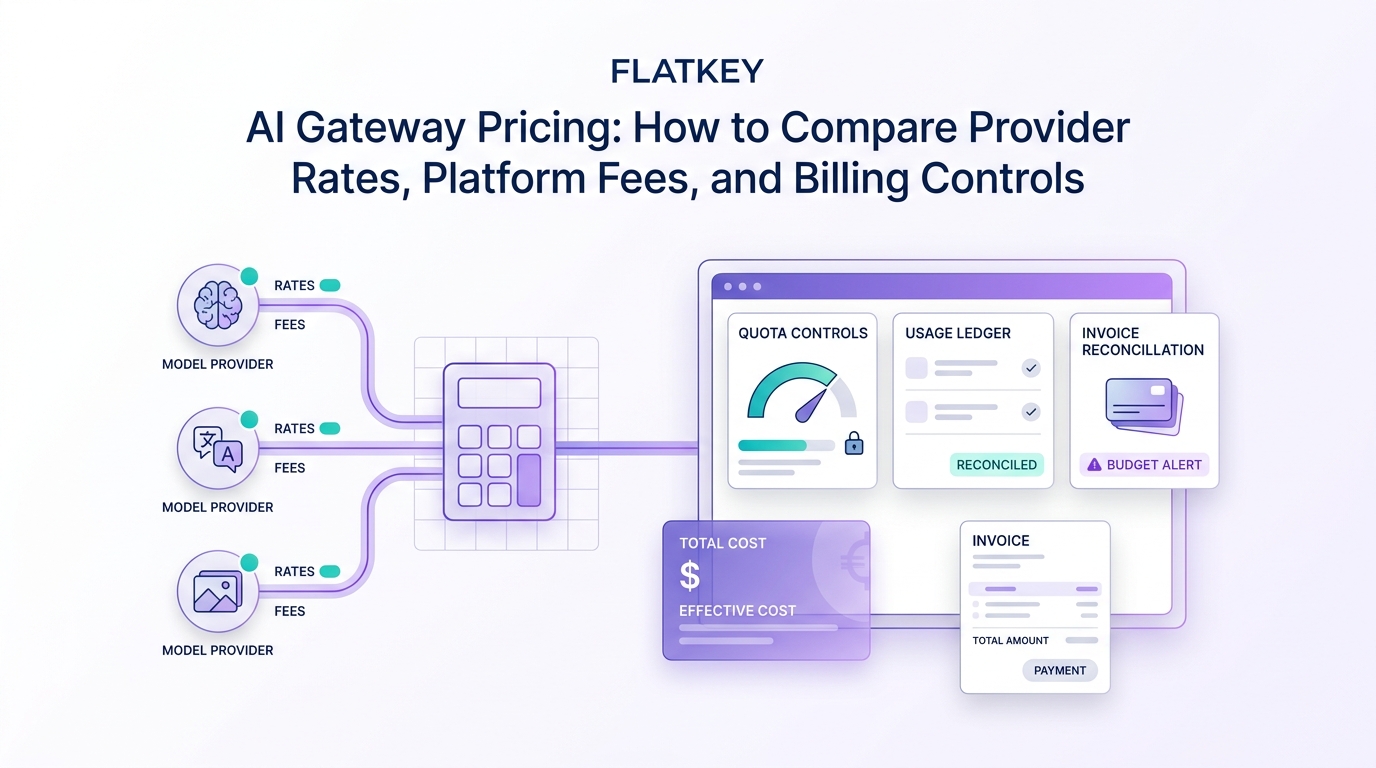
AI-Gateway-Preise (Oktober 2026): Vercel, Cloudflare, OpenRouter, Portkey, LiteLLM, Helicone und Flatkey im Vergleich
Was AI-Gateways im Oktober 2026 tatsächlich berechnen: Vercel AI Gateway ohne Preisaufschlag und mit Zusatzoptionen, Cloudflare Unified Billing, OpenRouter-Guthabengebühren, Portkey- und Helicone-Tarife, LiteLLM sowie Flatkey-Aufladungen, mit durchgerechneten Gesamtkosten.
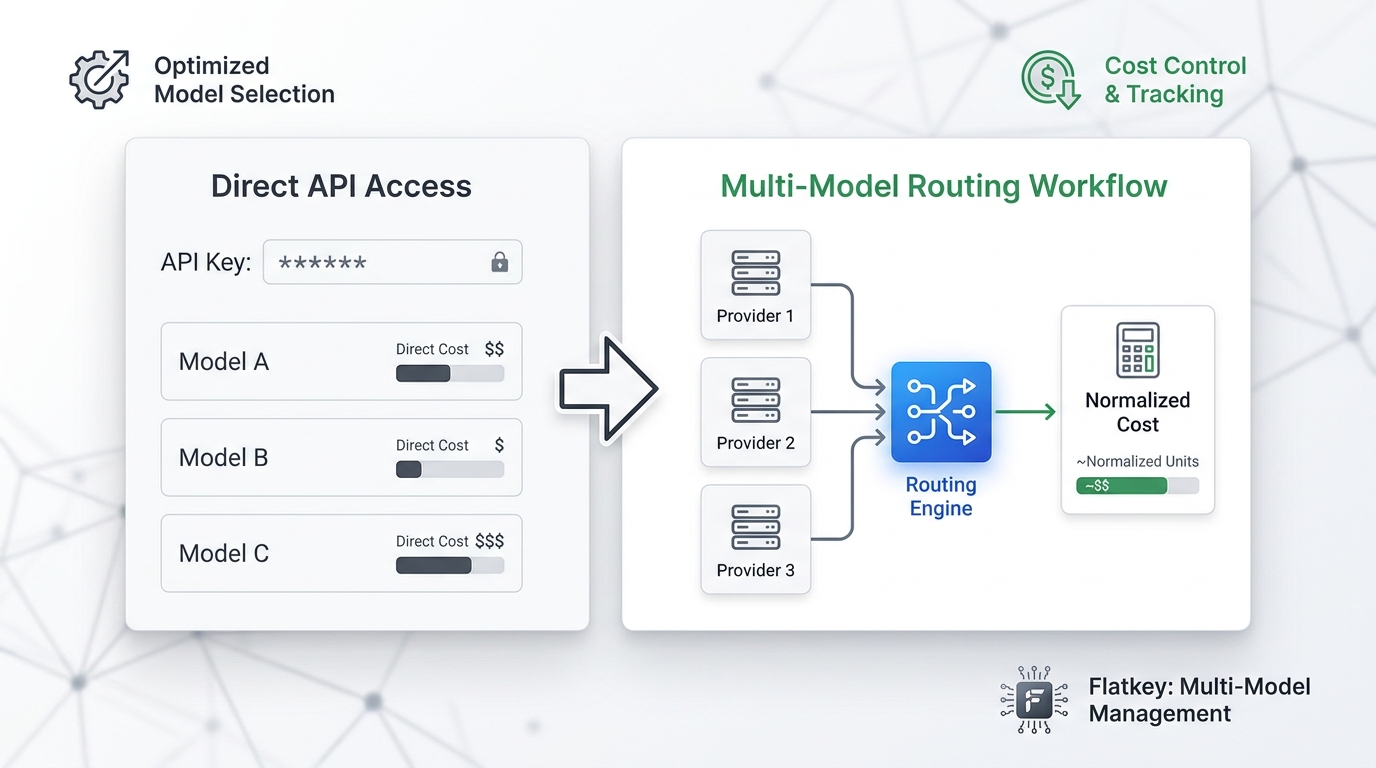
OpenAI-API-Preise (Oktober 2026): GPT-6, GPT-5.6 und alle Token-Tarife erklärt
Alle aktuellen Token-Tarife der OpenAI-API für GPT-6 und GPT-5.6, dazu Batch, Flex, gecachter Input, Regeln für langen Kontext, Kostenbeispiele und Code.
Gemini API Preise (Oktober 2026): alle Modelle, das Free Tier und echte Kostenbeispiele
Aktuelle Gemini-API-Preise für jedes Modell, welche Modelle kostenlos sind, Free-Tier-Limits und Datennutzung, Batch- und Cache-Rabatte sowie Kostenbeispiele.
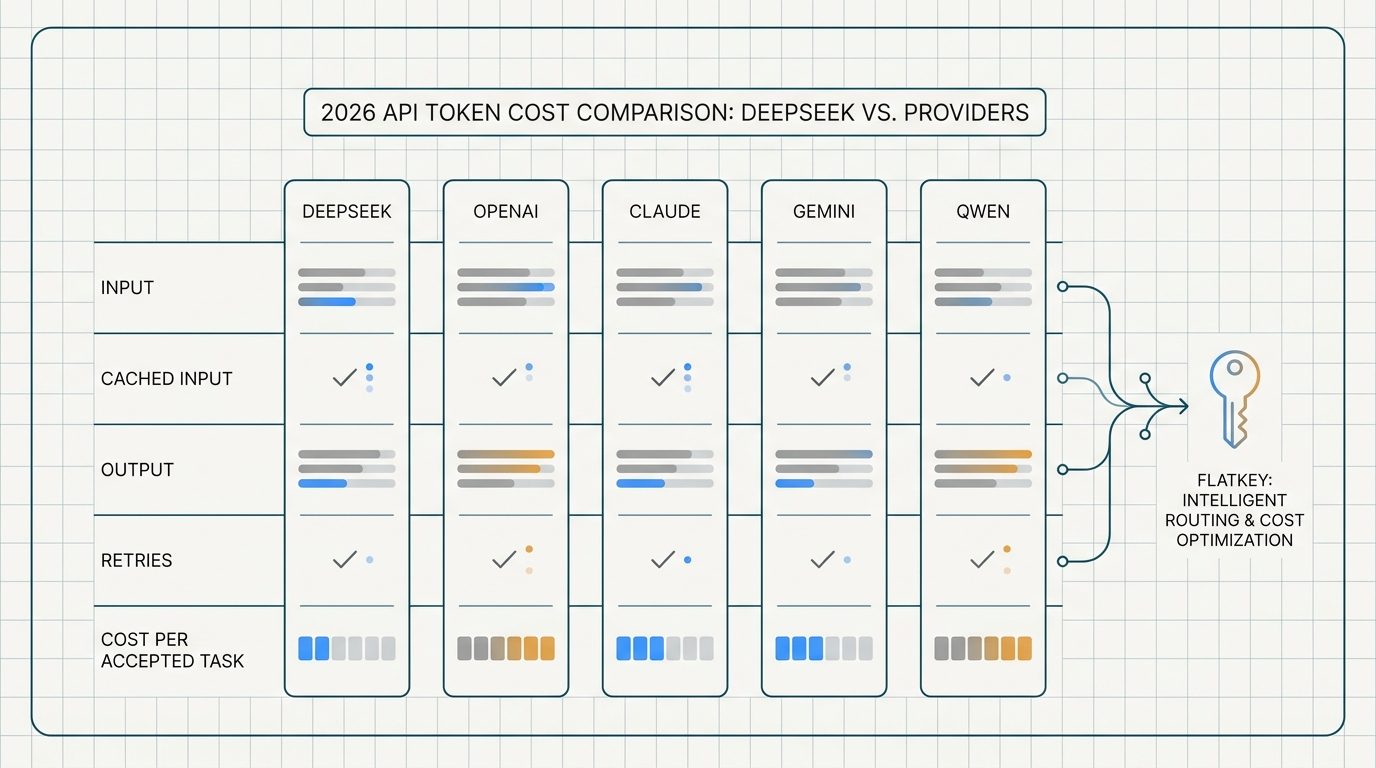
DeepSeek API Preise (Oktober 2026): Flash vs. V4 Pro, Spitzenzeiten und Cache-Rechnung
DeepSeek-Preise pro 1M Tokens für Flash und V4 Pro, Spitzen- und Nebenzeiten in US-Zeit, Cache-Hit-Rechnung, ein Kostenrechner und Code.
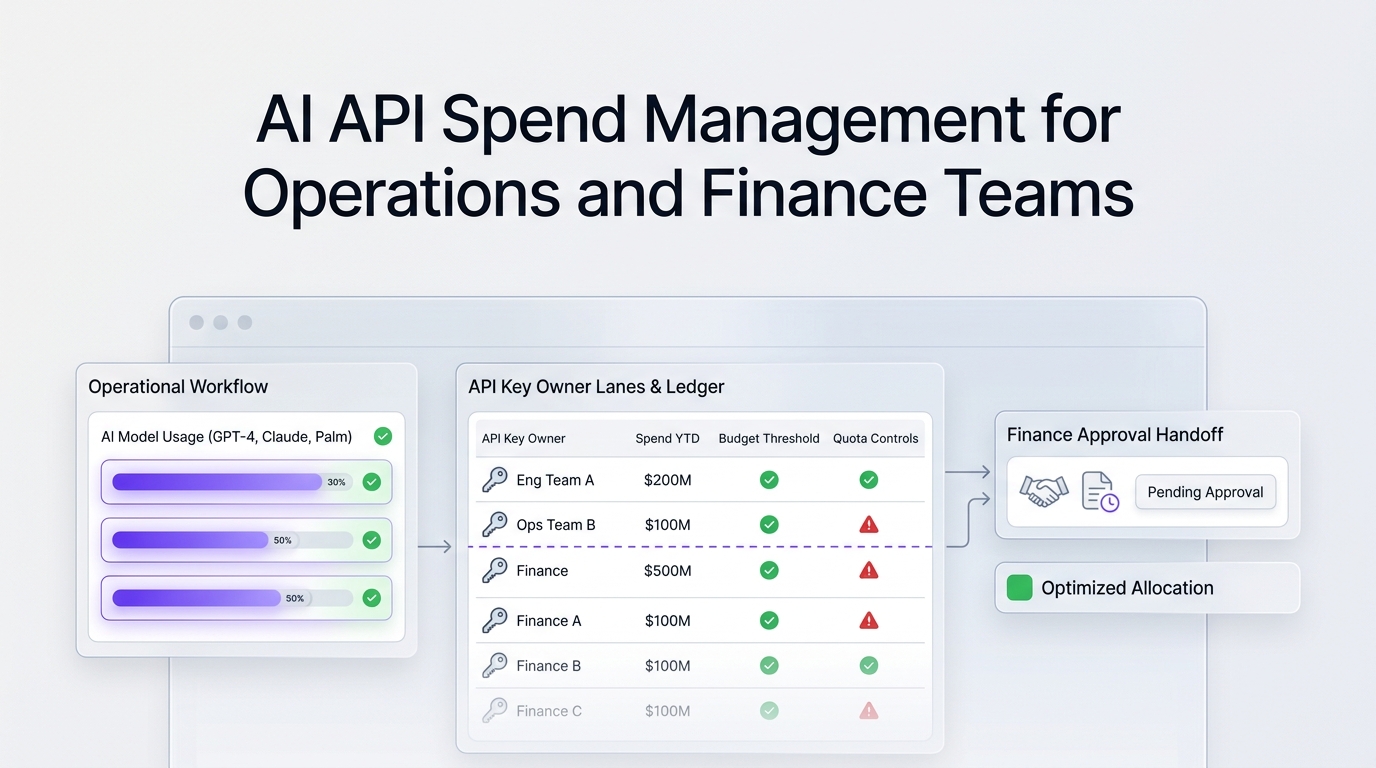
KI-API-Ausgabenmanagement für Operations- und Finance-Teams
Ein praxisnahes Playbook für das KI-API-Ausgabenmanagement für Operations- und Finance-Teams mit Verantwortlichen, Kontingenten, Hauptbüchern, Rechnungen, Salden und monatlichen Review-Workflows.
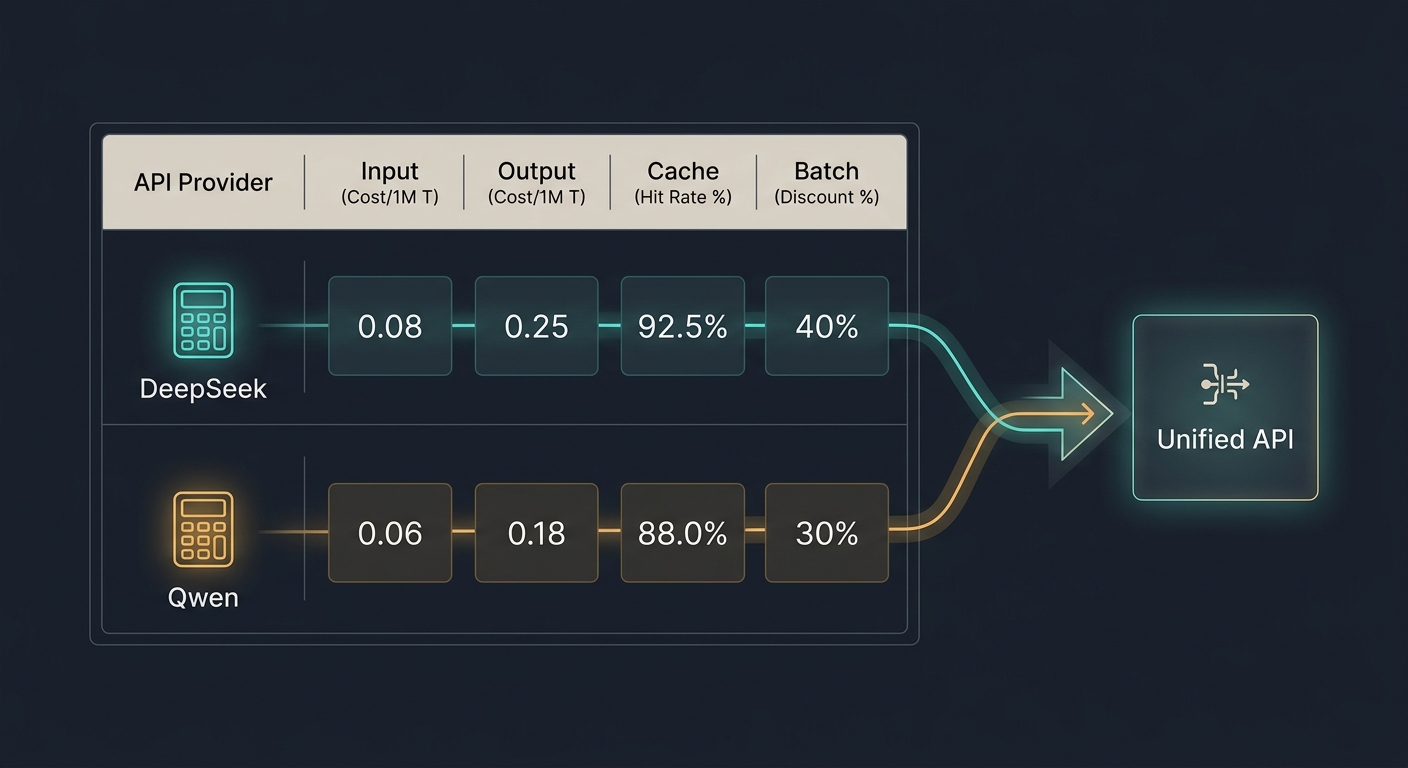
DeepSeek API vs Qwen API für kostensensible Workflows: Kostenleitfaden 2026
Vergleiche die Kosten der DeepSeek API und der Qwen API für cache-intensive, Batch- und Kurzchat-Workflows mit Preisprüfungen für 2026 und einem Rechner für die Kosten pro akzeptierter Aufgabe.
KI-Kosten optimieren (2026): 9 Wege, LLM-API-Kosten ohne Qualitätsverlust zu senken
KI-Kostenoptimierung senkt die Kosten pro erfolgreich erledigter Aufgabe. Neun Strategien mit Rechenbeispielen zu offiziellen Preisen vom Oktober 2026: Routing, Prompt-Caching, Batch, kürzere Prompts, Ausgabelimits, kontrollierte Wiederholungsversuche, Budgets, monatliche Preisprüfungen und Gateways.
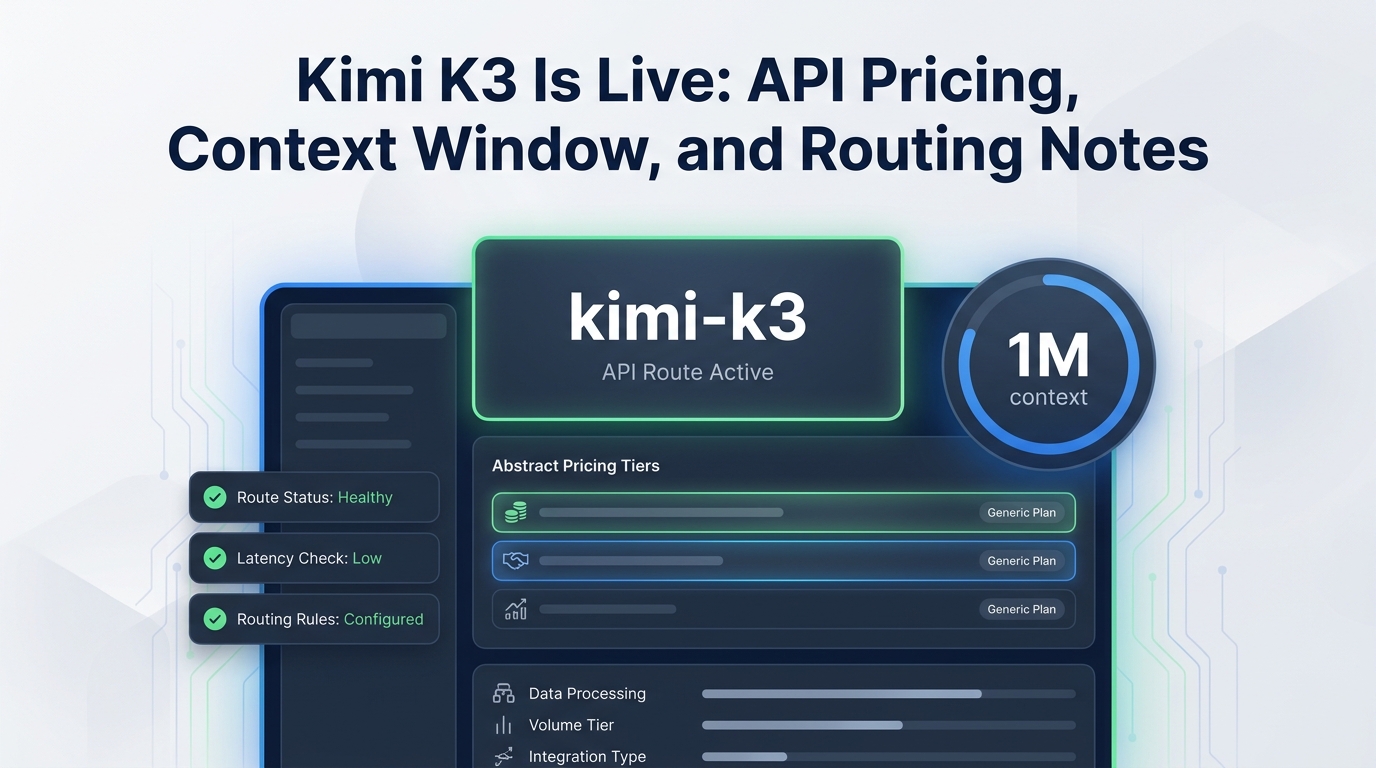
Kimi K3 ist live: API-Preise, Kontextfenster und Routing-Hinweise
Kimi K3 ist live. Prüfen Sie die direkten API-Preise, den 1M-Kontext, Reasoning-Steuerungen, Cache-Hinweise und Flatkey-Routing-Checks vor dem Produktions-Rollout.
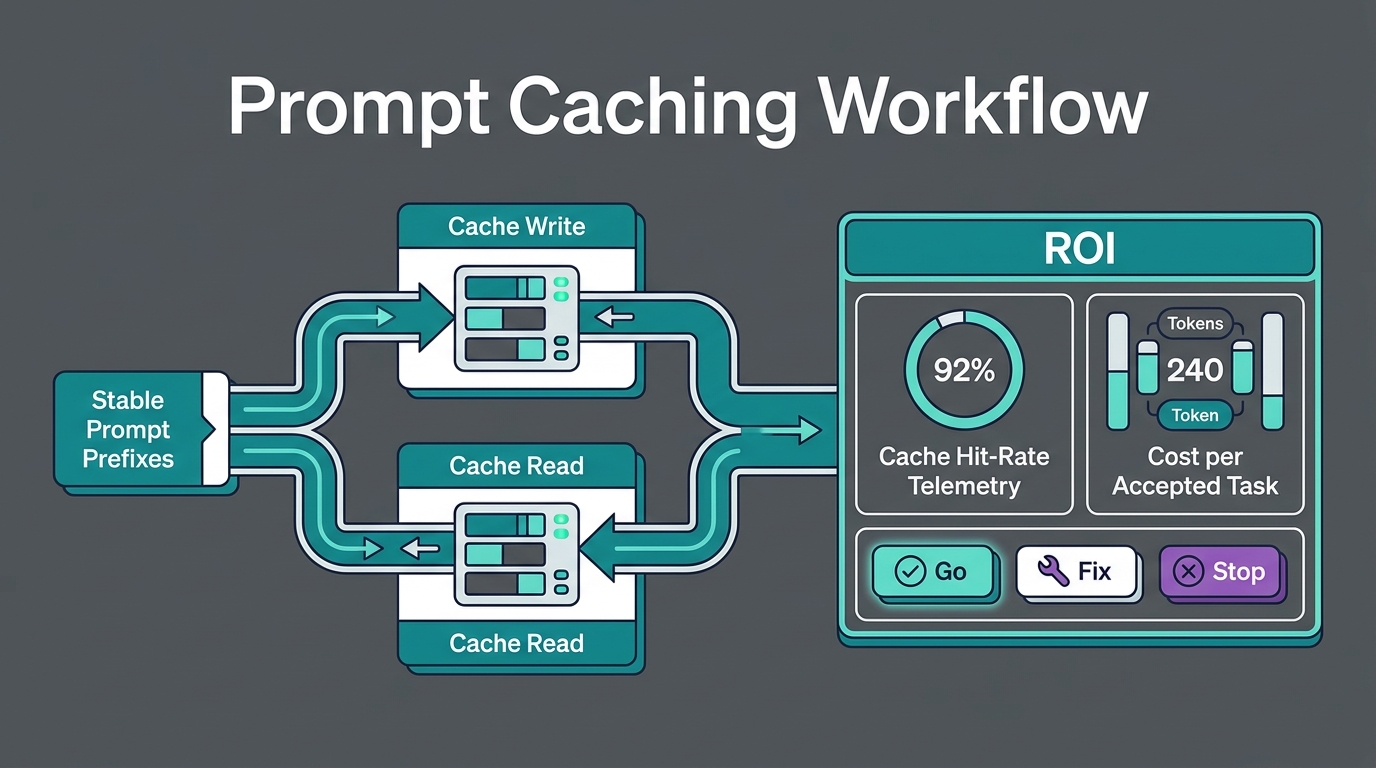
OpenAI Prompt Caching (Oktober 2026): Funktionsweise, Preise und ROI
OpenAI Prompt Caching ist automatisch aktiv und berechnet gecachten Input mit etwa dem 0,1-Fachen des normalen Preises. Hier finden Sie die Schreib- und Lesepreise vom Oktober 2026, TTLs von 30 Minuten und 12 Stunden, explizite Breakpoints, ein ROI-Beispiel und den Vergleich mit Claude und Gemini.
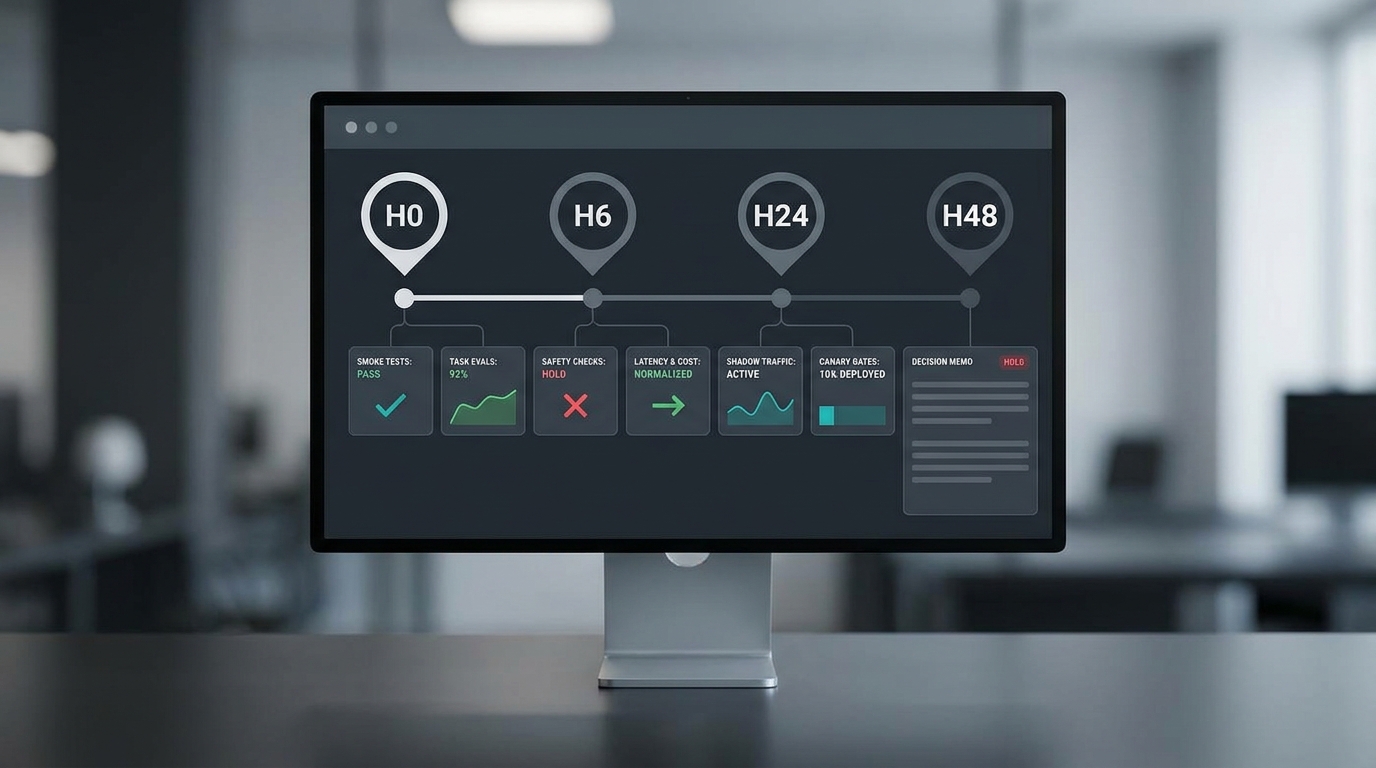
Wie man ein neues Modell in 48 Stunden bewertet: Eine Checkliste für den Veröffentlichungstag
Verwenden Sie diese 48-Stunden-Checkliste für den Veröffentlichungstag, um ein neues KI-Modell mit Smoke-Tests, Task-Evaluierungen, Sicherheitsprüfungen, Latenzchecks, Kosten pro akzeptierter Ausgabe und Canary-Regeln zu bewerten.
Schneller entwickeln mit einem KI-Gateway.
Nutze flatkey.ai, um Modelle, Schlüssel, Abrechnung und Observability über eine API-Plattform zu verwalten.
Loslegen