Wenn Ihr Team Prompts jeweils nur auf einem Modell testet, messen Sie wahrscheinlich das Falsche. Ein Prompt, der auf einem Route gut aussieht, kann auf einer anderen einen JSON-Contract nicht erfüllen, unter längerem Kontext zu langsam werden oder günstig wirken, bis Retries und abgelehnte Ausgaben einbezogen werden.
Dieser Leitfaden gibt KI-Produktteams einen praktischen Multi-Model Prompt-Testing-Workflow, um Prompt-Versionen vor dem Launch über verschiedene Modell-Routen hinweg zu vergleichen. Das Ziel ist nicht, einen universellen Sieger zu küren. Das Ziel ist, Prompt-Qualität, Model-Fit, Latenz und Kosten zu trennen, damit das Team eine Route evidenzbasiert auswählen kann statt mit Screenshots aus einer Playground-Umgebung.
Flatkey ist in diesem Workflow nützlich, weil dasselbe Konto viele Modell-Routen über eine OpenAI-kompatible API aufrufen kann, verfügbare Modelle über die Modellliste einsehen kann und Anfragen-Logs auf Request-Ebene mit Modellnamen, Token-Zahlen, Kosten pro Anfrage, Status und Zeitstempeln prüfen kann. Nutzen Sie diese gemeinsame Schicht, um den Test auszuführen, und speichern Sie dann die gewinnende Prompt/Model-Zelle als Regression-Baseline.
Die Kurzantwort
Ein zuverlässiger Multi-Model Prompt-Testing-Workflow hat acht Teile:
- Frieren Sie den Task-Contract ein, bevor Sie Modelleinstellungen ändern.
- Trennen Sie Prompt-Version und Modell-Route als separate Variablen.
- Verwenden Sie einen repräsentativen Datensatz, nicht drei Lieblingsbeispiele.
- Führen Sie wiederholte Samples aus, wenn Nichtdeterminismus relevant ist.
- Validieren Sie die Struktur per Code, bevor Sie einen Menschen die Qualität bewerten lassen.
- Verfolgen Sie die Kosten pro akzeptierter Aufgabe, nicht nur den Tokenpreis.
- Promoten Sie einen Sieger nur, wenn er Regression-Gates besteht.
- Speichern Sie den Entscheidungsdatensatz, damit der nächste Modelltest auf Evidenz aufbaut.
Das ist der Unterschied zwischen „Claude sah in einer Demo besser aus“ und „Prompt v2 auf Route B bestand 94 % unserer Contract-Tests, blieb unter unserem p95-Latenzziel und senkte die Kosten pro akzeptierter Aufgabe nach Retries.“
Wann du diesen Workflow brauchst
Verwenden Sie einen Multi-Model Prompt-Testing-Workflow, wenn eines davon zutrifft:
| Situation | Warum Tests mit nur einem Modell schwach sind |
|---|---|
| Sie wechseln von einem Anbieter zu einem anderen | Prompt-Wording, Tool-Call-Verhalten, Zuverlässigkeit strukturierter Ausgaben und Refusal-Stil können sich alle ändern. |
| Sie fügen eine günstigere Fallback-Route hinzu | Das günstigere Modell benötigt möglicherweise einen anderen Prompt oder einen strengeren Validator, um akzeptierte Ergebnisse zu liefern. |
| Sie testen Long-Context-Prompts | Die Kontextlänge verändert Kosten, Latenz, Cache-Verhalten und die Wahrscheinlichkeit von Instruktions-Drift. |
| Sie starten einen Produkt-Workflow | Interne Demos verbergen Retries, abgelehnte Ausgaben und Support-Eskalationen. |
| Sie brauchen Transparenz für Finance | Finance interessiert sich nicht nur für den Tokenpreis; es braucht Kosten pro akzeptierter Aufgabe und Budget-Guardrails. |
Wenn die Entscheidung das Produktionsverhalten beeinflusst, testen Sie nicht „Modell A vs. Modell B“ als Bauchgefühl-Check. Testen Sie Prompt-Version gegen Modell-Route als Matrix.
Schritt 1: Den Aufgabenvertrag fixieren
Bevor Sie Modelle vergleichen, schreiben Sie den Contract auf, den das Modell erfüllen muss. Ein Task-Contract sollte definieren:
| Feld | Beispiel |
|---|---|
| User-Job | Support-Tickets klassifizieren und eine sichere Antwort entwerfen. |
| Eingabeform | Tickettext, Kundentarif, Produktbereich, Anzahl früherer Antworten. |
| Erforderliche Ausgabe | JSON mit category, priority, reply, handoff_required und reason_codes. |
| Harte Fehler | Ungültiges JSON, fehlendes erforderliches Feld, nicht unterstütztes Versprechen, unsichere Refund-Sprache. |
| Qualitätskriterien | Richtige Kategorie, prägnante Antwort, keine erfundene Richtlinie, nützlicher Eskalationsgrund. |
| Betriebsgrenzen | p95-Latenz unter 4 Sekunden, Kosten pro akzeptierter Aufgabe unter dem Team-Limit. |
Mach das zuerst, weil der Vertrag den Multi-Model-Prompt-Testing-Workflow ehrlich hält. Ohne ihn optimieren Reviewer auf die Antwort, die in einem Beispiel am besten klingt, nicht auf den Weg, der in der Produktion Bestand hat.
Schritt 2: Die Prompt-x-Modell-Matrix erstellen
Trenne die Variablen. Prompt-Version und Modellroute sollten jeweils ihre eigene Achse bekommen.
| Testzelle | Prompt | Modellroute | Worauf es antwortet |
|---|---|---|---|
| A1 | Prompt v1 | Aktueller Standard | Ist die Baseline noch akzeptabel? |
| A2 | Prompt v1 | Kandidatenroute mit geringeren Kosten | Überträgt sich der aktuelle Prompt? |
| B1 | Prompt v2 | Aktueller Standard | Hat sich die Prompt-Qualität verbessert, ohne das Modell zu ändern? |
| B2 | Prompt v2 | Kandidatenroute mit geringeren Kosten | Gibt es ein besseres Prompt/Modell-Paar? |
| C1 | Prompt v3 | Aktueller Standard | Haben strengere Anweisungen Fehler reduziert? |
| C2 | Prompt v3 | Kandidaten-Premium-Route | Lohnt sich die Eskalation angesichts der zusätzlichen Kosten? |
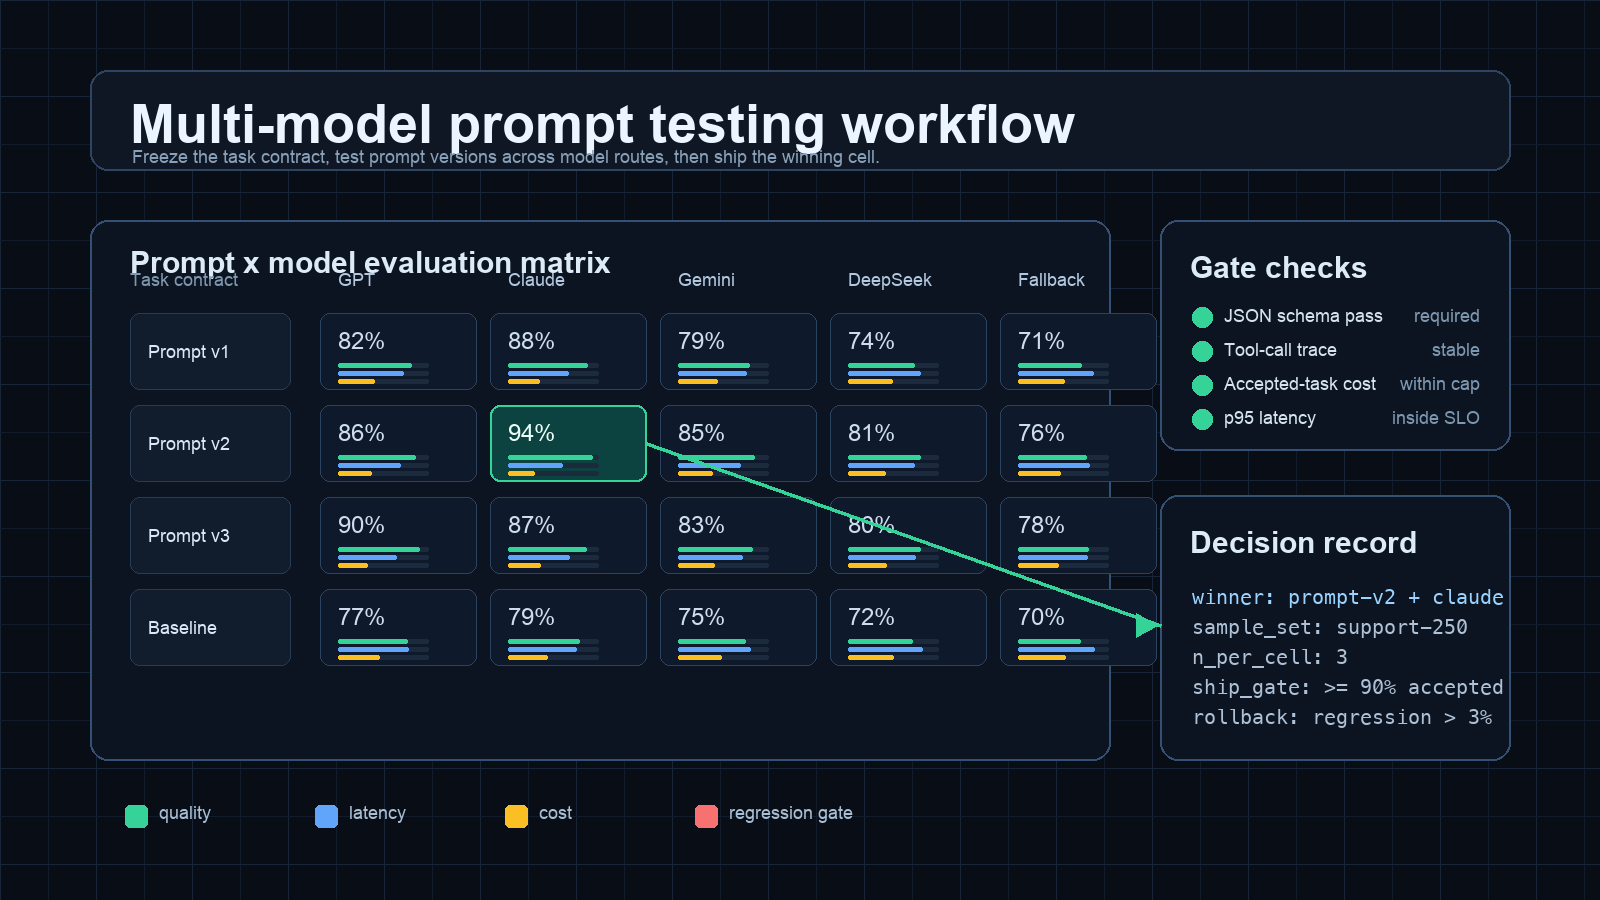
Diese Matrix ist das Herz des Multi-Model-Prompt-Testing-Workflows. Sie verhindert einen häufigen Fehler: dem Modell die Schuld zu geben, wenn der Prompt die eigentliche Variable ist, oder den Prompt zu loben, wenn das Modell schwache Anweisungen trägt.
Schritt 3: Einen repräsentativen Datensatz verwenden
Bewerte nicht anhand der Beispiele, die sich am leichtesten kopieren lassen. Erstelle einen kleinen Datensatz, der den realen Traffic widerspiegelt.
Für einen Support-Workflow solltest du Folgendes einschließen:
- Häufige Tickets, die einfach sein sollten.
- Grenzfälle, bei denen die Richtlinie streng ist.
- Kurze, mehrdeutige Tickets.
- Lange Tickets mit irrelevanten Details.
- Mehrsprachige oder gemischtsprachige Beispiele, falls sie in der Produktion vorkommen.
- Bekannte historische Fehler.
- Beispiele, die eine Übergabe auslösen sollten.
Halte für jede Zeile das erwartete Verhalten fest. Es braucht nicht immer eine perfekte Goldantwort, aber genug Ground Truth, damit ein Validator oder Reviewer entscheiden kann, ob das Ergebnis akzeptabel ist.
Ein guter erster Datensatz hat oft 50 bis 250 Zeilen. Das ist klein genug für wiederholte Läufe und groß genug, um mehr als Demo-Verhalten aufzudecken.
Schritt 4: Die Matrix mit wiederholten Stichproben ausführen
Für deterministische Extraktion oder Klassifikation kann ein Lauf pro Zelle für das frühe Screening ausreichen. Für Schreiben, Reasoning, Tool-Nutzung oder agentische Aufgaben solltest du mehrere Samples pro Zelle ausführen.
Verwende diese Ausgangsregel:
| Aufgabentyp | Beispiele pro Testzeile |
|---|---|
| Strikte Klassifizierung | 1 bis 2 |
| JSON-Extraktion | 2 |
| Kundennahe Texterstellung | 3 |
| Tool-Aufruf | 3 |
| Langkontext-Reasoning | 3 bis 5 |
| Agenten-Workflow | 5, wenn die Kosten es zulassen |
Wiederholte Beispiele zeigen Varianz. Ein Pfad, der einmal 94 % und beim nächsten Durchlauf 71 % erreicht, ist nicht produktionsreif, auch wenn das beste Beispiel beeindruckend aussieht.
Schritt 5: Struktur vor Qualität validieren
Jeder Multi-Model-Prompt-Testing-Workflow sollte die Struktur vor dem Geschmack bewerten. Führen Sie zuerst automatisierte Prüfungen aus:
| Validator | Was er erkennt |
|---|---|
| JSON-Parse | Ungültige strukturierte Ausgabe. |
| Schema-Validierung | Fehlende Felder, falsches Enum, falscher Typ. |
| Regex- oder Policy-Prüfungen | Nicht erlaubte Formulierungen, verbotene Behauptungen, fehlende Zitate. |
| Tool-Trace-Validator | Falsches Tool, fehlendes Argument, unsichere Nebenwirkung. |
| Deterministische Unit-Checks | Falsche Kategorie, falsche numerische Transformation, ungültige Datumsbehandlung. |
Nur akzeptierte strukturelle Ausgaben sollten in die menschliche oder modellgestützte Qualitätsprüfung gelangen. Das spart Prüferzeit und hält die Bewertung über alle Pfade hinweg fair.
Schritt 6: Kosten pro akzeptierter Aufgabe nachverfolgen
Vergleichen Sie Pfade nicht nur anhand des Listenpreises. Vergleichen Sie, was das Team tatsächlich für akzeptierte Ergebnisse bezahlt.
Verwenden Sie diese Kennzahl:
cost_per_accepted_task =
  total_cost_for_cell / accepted_outputs
Fügen Sie dann den Kontext hinzu:
accepted_output_rate =
  accepted_outputs / total_attempts

retry_adjusted_cost =
  total_cost_for_cell + retry_cost + reviewer_rerun_cost
Das ist wichtig, weil ein Pfad mit niedrigerem Tokenpreis teurer werden kann, wenn er mehr ungültiges JSON, längere Ausgaben, Tool-Call-Fehler oder manuelle Wiederholungen erzeugt. Flatkey Usage Logs sind für diese Art von Prüfung konzipiert: Jede Anfrage kann nach Modell, Input-Tokens, Output-Tokens, Kosten, Schlüssel, Status und Zeitstempel überprüft werden.
Wenn Ihr vorhandener Kostenleitfaden noch nur auf Token basiert, kombinieren Sie diesen Artikel mit dem internen Workflow aus Wie Sie Preise von KI-Modellen vergleichen, bevor Sie API-Anbieter wechseln. Der Prompt-Test sollte die nächste Frage beantworten: Welcher Pfad erzeugt akzeptierte Arbeit zu den niedrigsten Betriebskosten?
Schritt 7: Die Matrix bewerten
Verwenden Sie eine gewichtete Bewertungstabelle. Halten Sie die erste Version einfach genug, damit Produkt, Engineering und Finanzen sich darauf einigen können.
| Metrik | Gewichtung | Messung |
|---|---|---|
| Vertrags-Durchlaufquote | 30% | Erforderliche Schema- und Policy-Prüfungen bestanden. |
| Akzeptanz durch Menschen | 25% | Reviewer akzeptiert die Antwort für den Produktionseinsatz. |
| Kosten pro akzeptierter Aufgabe | 20% | Gesamtausgaben der Zelle geteilt durch akzeptierte Ausgaben. |
| p95-Latenz | 15% | Routenlatenz unter dem Workflow-Ziel. |
| Regressionssicherheit | 10% | Kein Rückgang bei historischen Fehlerfällen. |
Beispielentscheidung:
| Prompt-/Modellzelle | Vertrags-Durchlauf | Menschenakzeptanz | Kosten/Aufgabe | p95-Latenz | Endgültige Entscheidung |
|---|---|---|---|---|---|
| Prompt v1 + aktueller Pfad | 88% | 84% | 1.00x | Bestanden | Als Fallback-Baseline beibehalten |
| Prompt v2 + aktueller Pfad | 93% | 91% | 1.04x | Bestanden | Stark, aber nicht am günstigsten |
| Prompt v2 + günstigerer Pfad | 91% | 89% | 0.62x | Bestanden | Für den Standardverkehr ausrollen |
| Prompt v3 + günstigerer Pfad | 84% | 80% | 0.58x | Bestanden | Aufgrund von Qualitätsverlust ablehnen |
| Prompt v2 + Premium-Pfad | 96% | 94% | 2.30x | Grenzwertig | Nur für Eskalationen verwenden |
Die gewinnende Zelle ist nicht immer die mit der höchsten Qualitätsbewertung. Es ist die Zelle, die Qualitäts-, Latenz-, Zuverlässigkeits- und Kosten-Gates für den Auftrag erfüllt.
Schritt 8: Einen Entscheidungsdatensatz speichern
Ein Prompt-Test, der nicht wiederholt werden kann, ist kein Workflow. Speichern Sie den Entscheidungsdatensatz mit Prompt, Route, Datensatz, Scorecard und Rollback-Bedingungen.
workflow: support_reply_generation
decision_date: 2026-09-26
dataset: support-eval-250
winner:
  prompt_version: prompt-v2
  model_route: candidate-cheaper-route
  reason: "Passed quality gate with lower cost per accepted task"
baseline:
  prompt_version: prompt-v1
  model_route: current-default
metrics:
  accepted_output_rate: 0.91
  cost_per_accepted_task_index: 0.62
  p95_latency_status: pass
regression_gates:
  - invalid_json_rate <= 0.02
  - policy_failure_rate <= 0.01
  - historical_failure_pass_rate >= 0.95
rollback_if:
  - accepted_output_rate drops below 0.88 for two days
  - p95 latency misses target for one release window
  - cost per accepted task rises above budget cap
Dieser Datensatz ermöglicht es dem nächsten Evaluator zu fragen: Hat das neue Modell die aktuelle Produktionszelle geschlagen, oder hat es nur eine alte Erinnerung an das Produkt geschlagen?
Ein kopierbares Runner-Gerüst
Dieses TypeScript-artige Gerüst zeigt die Struktur der Testschleife. Passen Sie es an Ihren Stack an.
type PromptVersion = {
  id: string;
  system: string;
};

type ModelRoute = {
  id: string;
  model: string;
};

type EvalRow = {
  id: string;
  input: Record<string, unknown>;
  expected: Record<string, unknown>;
};

type EvalResult = {
  rowId: string;
  promptId: string;
  routeId: string;
  sample: number;
  outputText: string;
  validJson: boolean;
  schemaPass: boolean;
  accepted: boolean;
  latencyMs: number;
  costUsd?: number;
};

async function runCell(
  prompt: PromptVersion,
  route: ModelRoute,
  rows: EvalRow[],
  samplesPerRow: number
): Promise<EvalResult[]> {
  const results: EvalResult[] = [];

  for (const row of rows) {
    for (let sample = 0; sample < samplesPerRow; sample++) {
      const started = Date.now();

      const response = await callModel({
        model: route.model,
        system: prompt.system,
        input: row.input,
      });

      const latencyMs = Date.now() - started;
      const parsed = safeJsonParse(response.text);
      const schemaPass = parsed.ok && validateSchema(parsed.value);
      const accepted = schemaPass && validateExpected(parsed.value, row.expected);

      results.push({
        rowId: row.id,
        promptId: prompt.id,
        routeId: route.id,
        sample,
        outputText: response.text,
        validJson: parsed.ok,
        schemaPass,
        accepted,
        latencyMs,
        costUsd: response.usageCost,
      });
    }
  }

  return results;
}
Der wichtige Teil ist nicht die Sprache. Der wichtige Teil ist, dass jede Ergebniszeile Prompt-Version, Route, Stichprobennummer, Validator-Ergebnisse, Latenz und Kostenfelder enthält.
Was Sie nach dem Lauf in Flatkey überprüfen sollten
Nachdem die Matrix fertig ist, überprüfen Sie dasselbe Testfenster in Flatkey:
- Filtern Sie die Nutzungsprotokolle nach dem Test-API-Schlüssel.
- Gruppieren Sie nach Modellroute.
- Exportieren Sie die Request-Logs, wenn Finance oder Ops eine Tabellenkalkulationsprüfung benötigt.
- Vergleichen Sie Input-Token, Output-Token, Status und Kosten pro Route.
- Prüfen Sie, ob sich Fehler um eine Prompt-Version, ein Modell oder einen Datensatzabschnitt herum gehäuft haben.
Dann verbinden Sie das Ergebnis mit Ihrer Routing-Richtlinie. Wenn die Standardroute bei der Qualität gewinnt, aber eine günstigere Route bei den akzeptierten Task-Kosten für einfache Fälle gewinnt, brauchen Sie möglicherweise nicht einen einzigen Gewinner. Sie benötigen möglicherweise eine Standardroute, eine Eskalationsroute und eine Fallback-Route. Für diesen nächsten Schritt verwenden Sie die Routing-Logik im Model Fallback Strategy Workflow Playbook.
Häufige Fehler
| Fehler | Behebung |
|---|---|
| Nur den finalen Prompt an fünf Beispielen testen | Verwenden Sie einen repräsentativen Datensatz und mehrere Prompt-Versionen. |
| Modelle ohne Validatoren vergleichen | Parsen und Schema-Prüfen Sie zuerst jede strukturierte Ausgabe. |
| Nur für den Durchschnittswert optimieren | Verfolgen Sie die Varianz und historische Fehlerfälle. |
| Wiederholungen ignorieren | Verwenden Sie die Kosten pro akzeptierter Aufgabe, nicht die Kosten pro Rohaufruf. |
| Latenz vergessen | Eine hochwertige Route kann dennoch die Produkterfahrung verfehlen. |
| Die Entscheidung verlieren | Speichern Sie das Matrixergebnis als Regression-Baseline. |
Wie dies mit der Kostenprognose zusammenhängt
Die kanonische URL für diesen Artikel handelt von der Prognose der Ausgaben für AI-APIs, da Prompt-Tests einer der ersten Bereiche sind, in denen AI-Ausgaben unvorhersehbar werden. Der aktualisierte Multi-Model Prompt-Testing-Workflow macht Ausgaben prognostizierbar, indem er Evaluierung in eine wiederholbare Tabelle verwandelt:
| Forecast input | Kommt von |
|---|---|
| Test volume | Dataset rows x prompt versions x model routes x samples. |
| Retry rate | Failed validators and rejected outputs. |
| Cost per accepted task | Usage logs and accepted output count. |
| Launch buffer | Regression risk, fallback share, and expected growth. |
| Budget controls | Per-key quota, monthly cap, and usage review cadence. |
Für einen umsetzungsreifen Rollout-Plan für Finance verbinden Sie die Testmatrix mit AI API Spend Management for Operations and Finance Teams.
FAQ
Was ist ein Multi-Model Prompt-Testing-Workflow?
Ein Multi-Model Prompt-Testing-Workflow ist ein wiederholbarer Prozess zum Testen mehrerer Prompt-Versionen über mehrere Modellrouten hinweg, bei dem jede Zelle mit Validatoren, Qualitätsprüfung, Kosten, Latenz und Regression-Gates bewertet wird.
Wie viele Beispiele brauche ich?
Beginnen Sie mit 50 bis 250 repräsentativen Zeilen. Fügen Sie mehr Zeilen hinzu, wenn die Aufgabe risikoreich ist, der Traffic vielfältig ist oder die Route autonome Entscheidungen treffen wird.
Sollte ich einen LLM-Judge verwenden?
Sie können das, aber machen Sie ihn nicht zum ersten Gate. Verwenden Sie deterministische Validatoren für Schema, Richtlinien und exakte Anforderungen, bevor Sie modellgestützte Bewertung einsetzen. Menschliche Prüfung bleibt für Workflows, die für den Launch kritisch sind, wichtig.
Wie oft sollten wir den Workflow erneut ausführen?
Führen Sie ihn erneut aus, bevor Sie Standardmodelle wechseln, größere Prompts ändern, Fallback-Routen hinzufügen, Tool-Schemata ändern oder in ein neues Segment starten. Führen Sie außerdem nach Provider- oder Modellupdates einen kleineren Regression-Satz erneut aus.
Wo passt Flatkey hinein?
Flatkey gibt Teams einen API-Schlüssel und einen Modellkatalog für Multi-Route-Tests sowie Transparenz bei der Nutzung für Modellname, Token-Anzahlen, Anforderungskosten, Schlüssel, Status und Zeitstempel. Das macht den Multi-Model Prompt-Testing-Workflow einfacher durchzuführen und gegenüber Finance oder Operations leichter zu erklären.
Abschließende Erkenntnis
Der gewinnende Prompt ist kein Prompt. Es ist eine Prompt/Modell-Zelle, die den Aufgabenvertrag unter realistischen Traffic-, Budget- und Latenzbedingungen erfüllt. Verwenden Sie den obigen Multi-Model Prompt-Testing-Workflow, um die Modellauswahl von einer Debatte in eine Evidenzspur zu verwandeln: Datensatz, Matrix, Validatoren, Kosten pro akzeptierter Aufgabe, Regression-Gates und ein Entscheidungsprotokoll.
Wenn Ihr Team bereit ist, über eine einzige OpenAI-kompatible Oberfläche zu testen, beginnen Sie mit dem Flatkey quickstart, prüfen Sie verfügbare Routen mit der model list und sehen Sie sich die Ausgaben in Usage Logs an.