
flatkey.ai Blog
Einblicke, Produktnotizen und Implementierungsleitfäden für Teams, die mit KI-APIs entwickeln.
Architektur von KI-Gateways
Neueste Artikel in Architektur von KI-Gateways.
WeiterlesenMigration von Basis-URL und SDK
Neueste Artikel in Migration von Basis-URL und SDK.
WeiterlesenKosten, Abrechnung und Betrieb
Neueste Artikel in Kosten, Abrechnung und Betrieb.
WeiterlesenUnternehmenskontrollen und Vertrauen
Neueste Artikel in Unternehmenskontrollen und Vertrauen.
WeiterlesenGateway-Vergleiche
Neueste Artikel in Gateway-Vergleiche.
WeiterlesenLeitfäden für Modelle und Modalitäten
Neueste Artikel in Leitfäden für Modelle und Modalitäten.
WeiterlesenZuverlässigkeit und Routing
Neueste Artikel in Zuverlässigkeit und Routing.
WeiterlesenWerkzeugintegrationen
Neueste Artikel in Werkzeugintegrationen.
Weiterlesen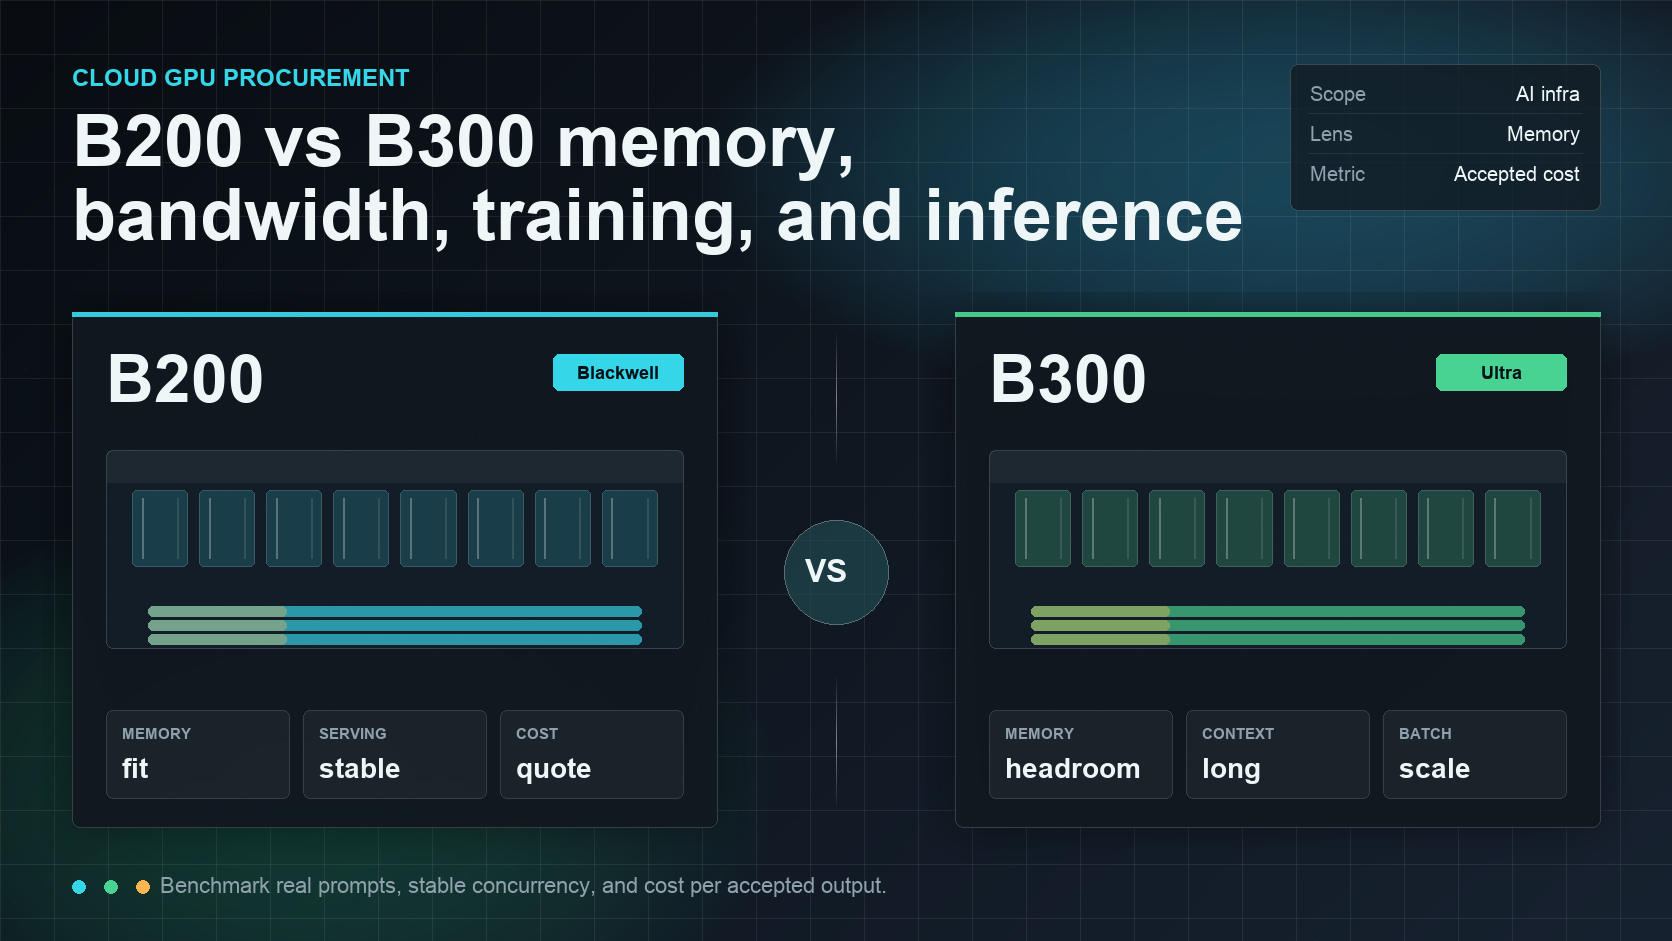
NVIDIA B300 vs B200: Speicher, Bandbreite, Training und Inferenz
Ein praxisnaher B200-vs-B300-Vergleich für ML-Infrastrukturteams, die NVIDIA-Blackwell-GPU-Speicher, Bandbreite, Training, Inferenz und Beschaffungsökonomie bewerten.
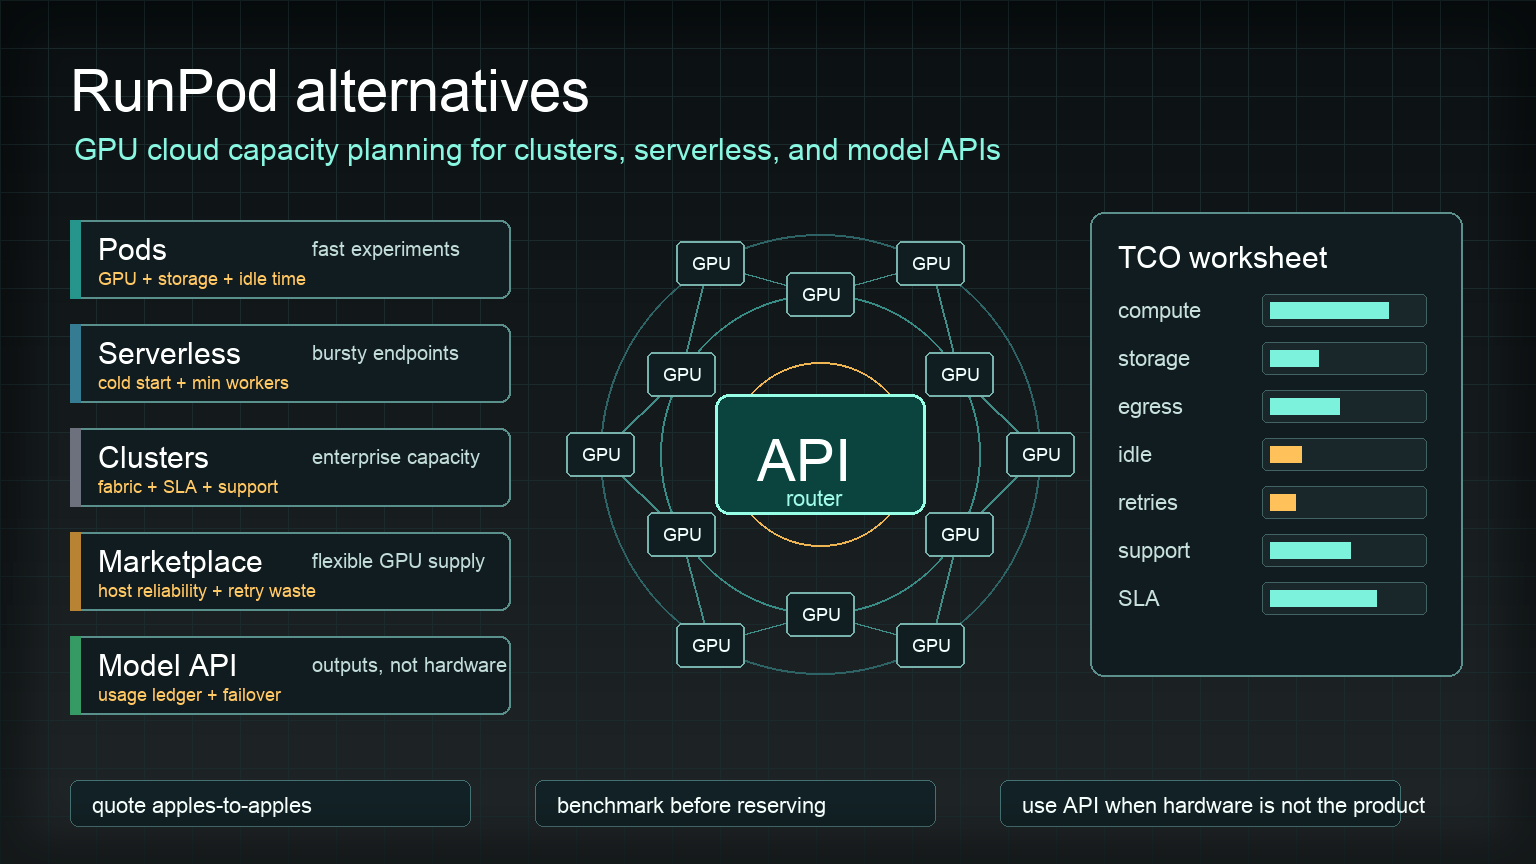
Die 10 besten RunPod-Alternativen 2026: Preise, Vorteile und die richtige Wahl
10 RunPod-Alternativen mit GPU-Preisen vom Oktober 2026 im Vergleich: günstige Marktplätze, stabile GPU-Clouds, Serverless-Plattformen und Modell-APIs, dazu Vast.ai vs. RunPod, Zuverlässigkeit und eine Checkliste für die Migration.
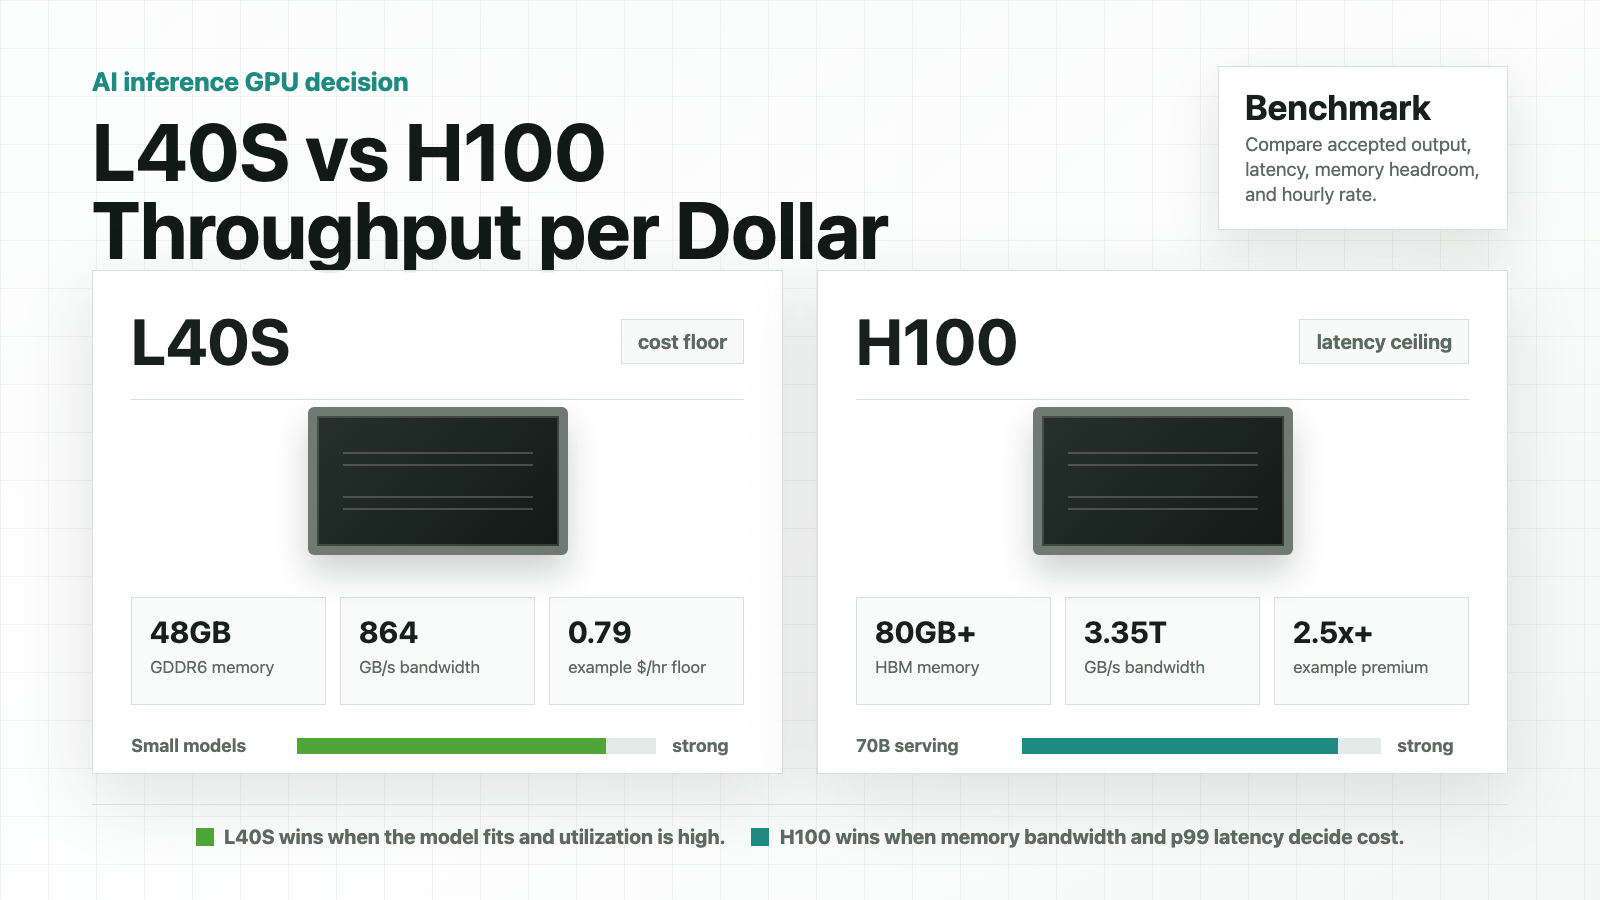
NVIDIA L40S vs H100 für AI-Inferenz: Durchsatz pro Dollar
Ein praktischer Vergleich von L40S und H100 für AI-Teams, die Inferenz-Durchsatz, Latenz, Speicherauslastung und Cloud-GPU-Kosten pro akzeptierter Ausgabe bewerten.
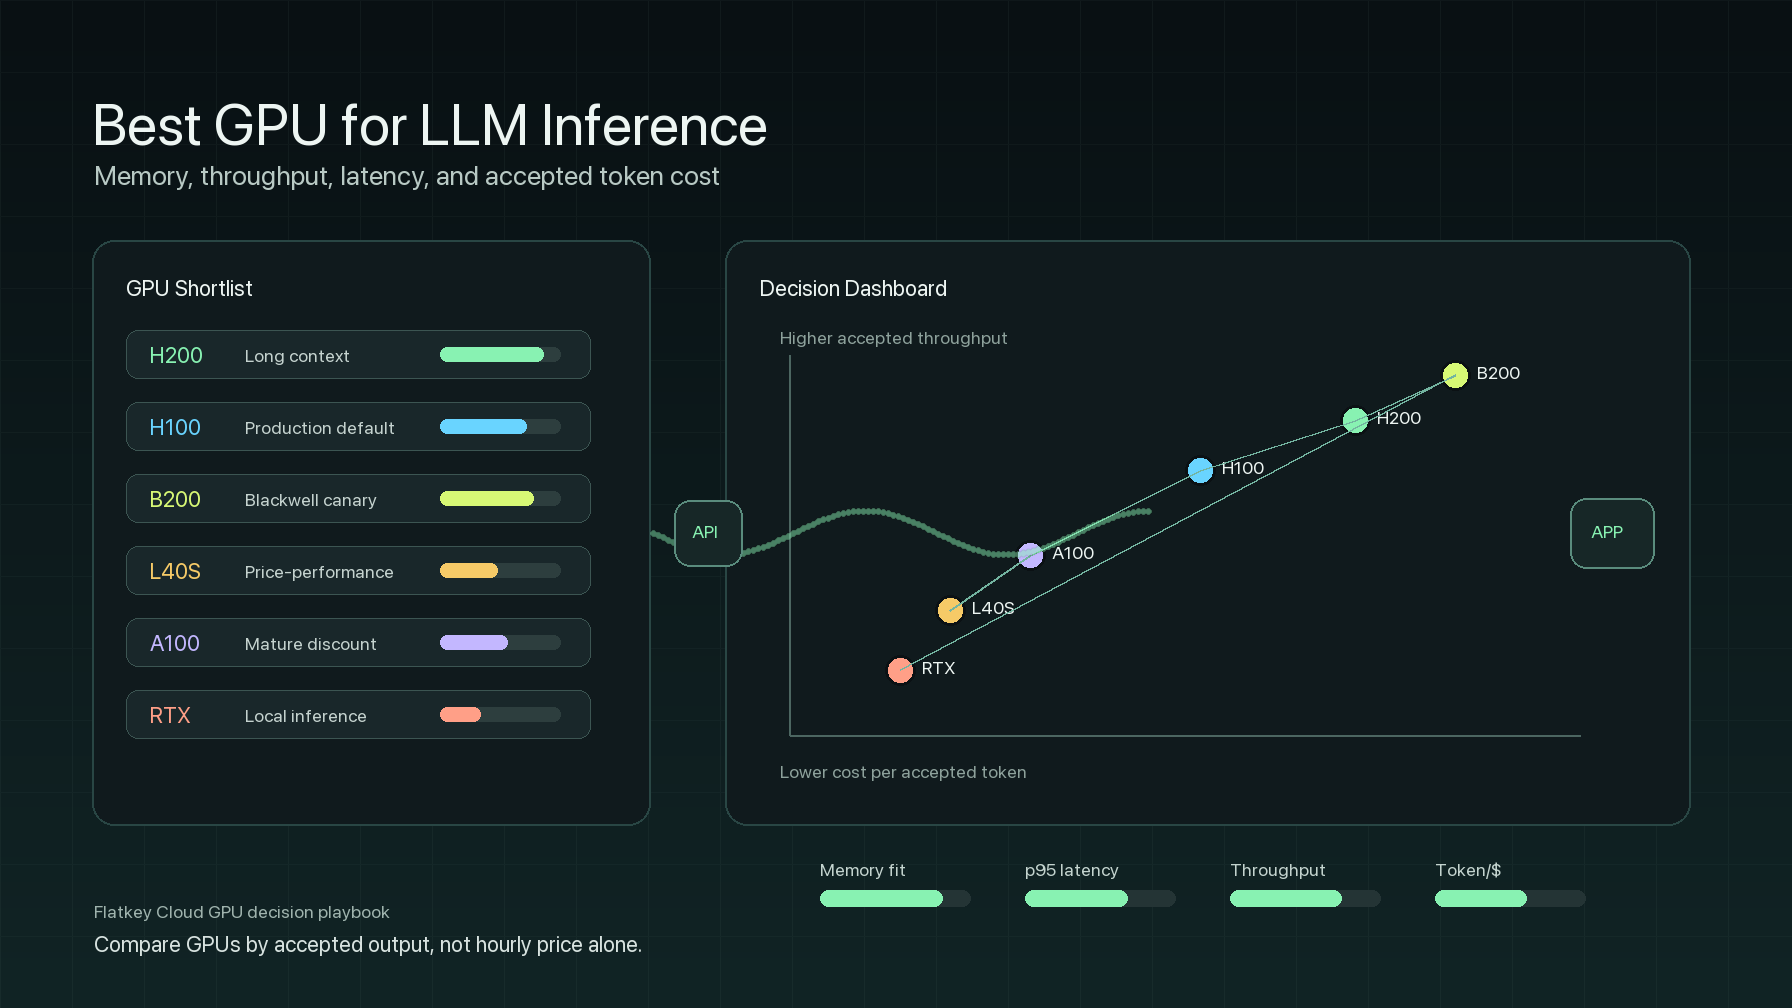
Die beste GPU für LLM-Inferenz: Speicher, Durchsatz, Latenz und Kosten
Ein praktischer Leitfaden zur GPU-Auswahl für Enterprise-Teams im Bereich LLM-Inferenz, mit Vergleich von H100, H200, B200, A100, L40S, lokalen GPUs der RTX-Klasse, Tokens pro Dollar, p95-Latenz, Speichereignung und Kosten pro akzeptiertem Token.
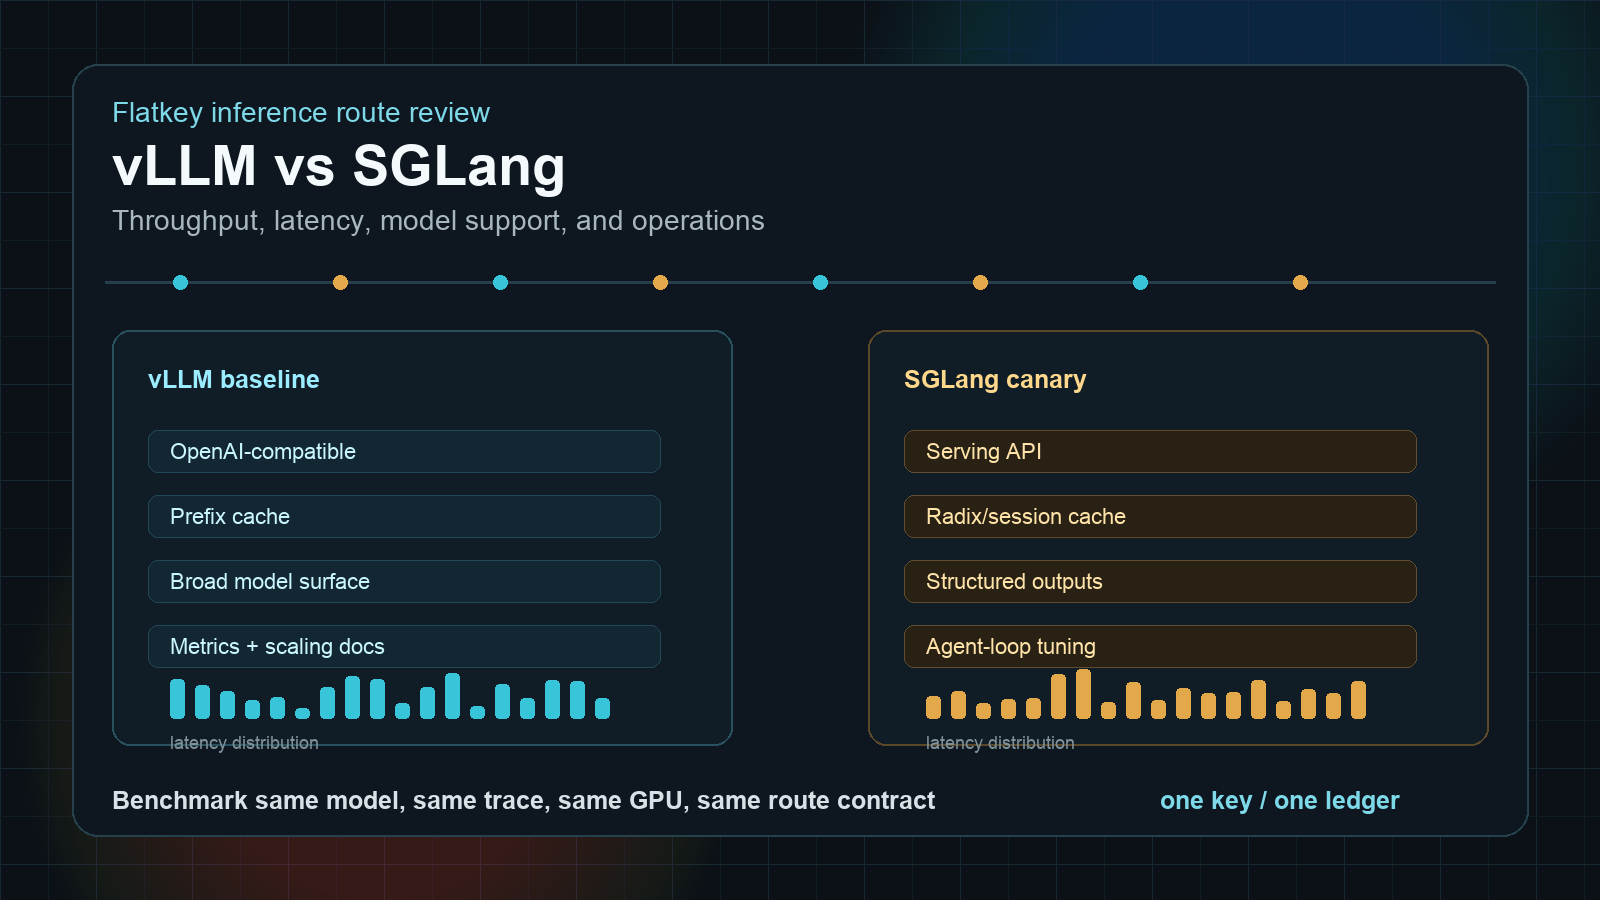
vLLM vs SGLang: Durchsatz, Latenz, Modellunterstützung und Betrieb
Vergleichen Sie SGLang und vLLM für Cloud-GPU-Inferenz: Durchsatz, Latenz, Modellunterstützung, Betrieb, Benchmarks und wann Ollama sich für lokale Tests eignet.
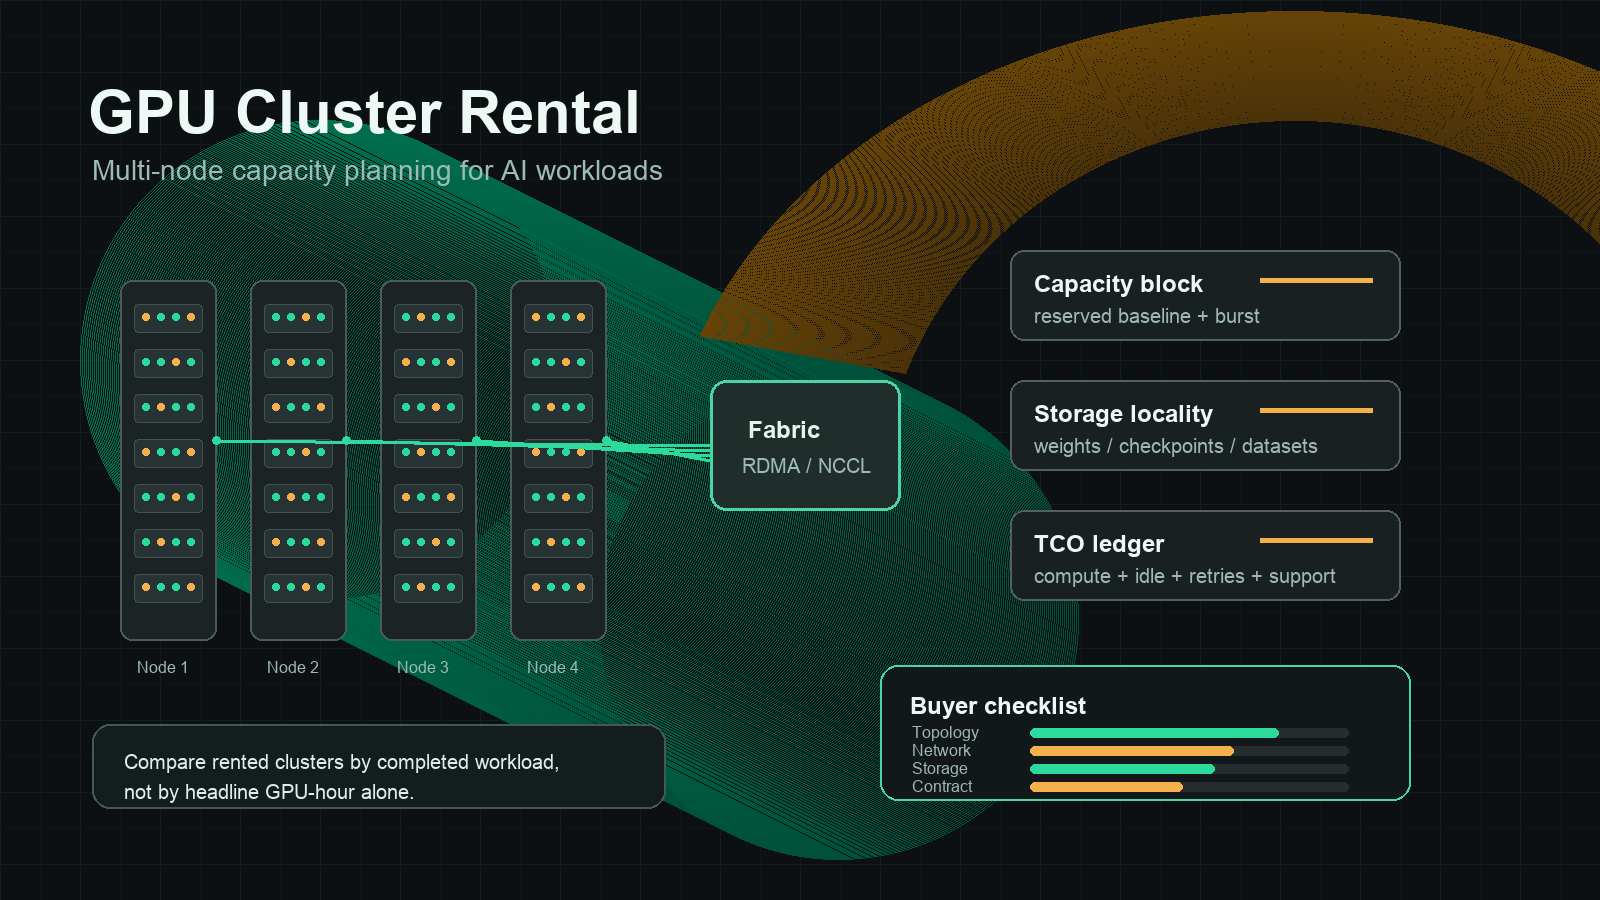
GPU-Cluster-Miete: Ein Kaufratgeber für Multi-Node-KI-Kapazitäten
Ein Kaufratgeber für Enterprise-KI-Teams zur Bewertung von GPU-Cluster-Miete mit mehreren Knoten, Cloud-Anbietern, reservierter Kapazität, Netzwerk-Fabric, Speicher und TCO.
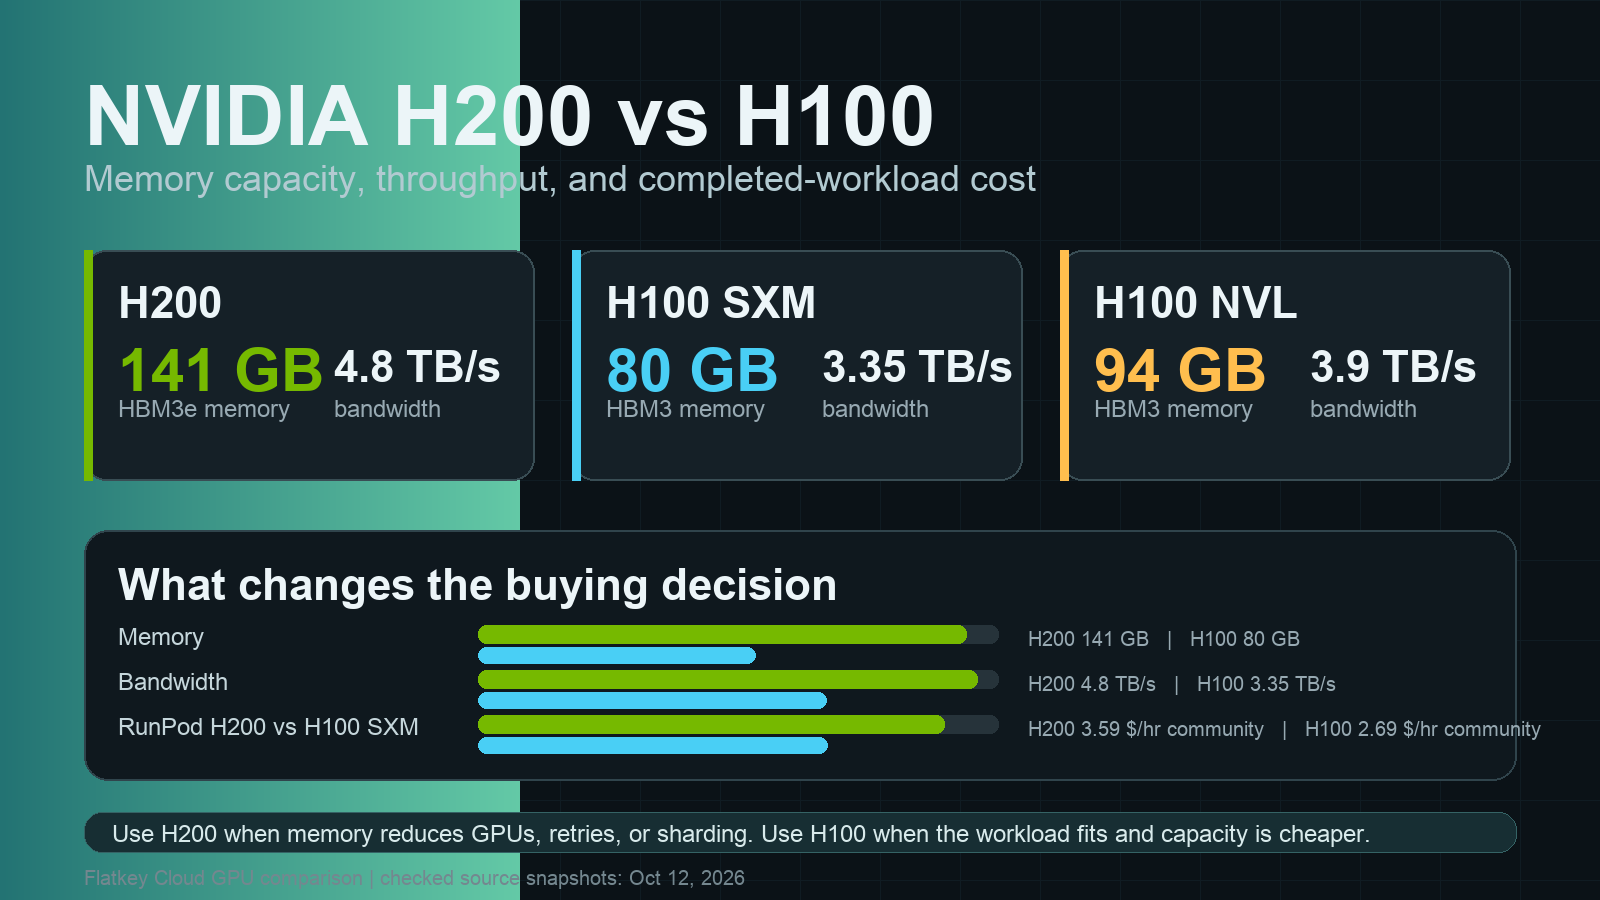
H200 vs H100 (2026): Technische Daten, Leistung in der Praxis, Stundenpreise und die richtige GPU zur Miete
NVIDIA H200 vs H100 im Jahr 2026: offizielle technische Daten, warum 141GB für 70B-Inferenz wichtig sind, tatsächliche Stundenpreise bei Flatkey Compute, RunPod und Lambda, Blackwell-Alternativen und die passende GPU für jeden Workload.
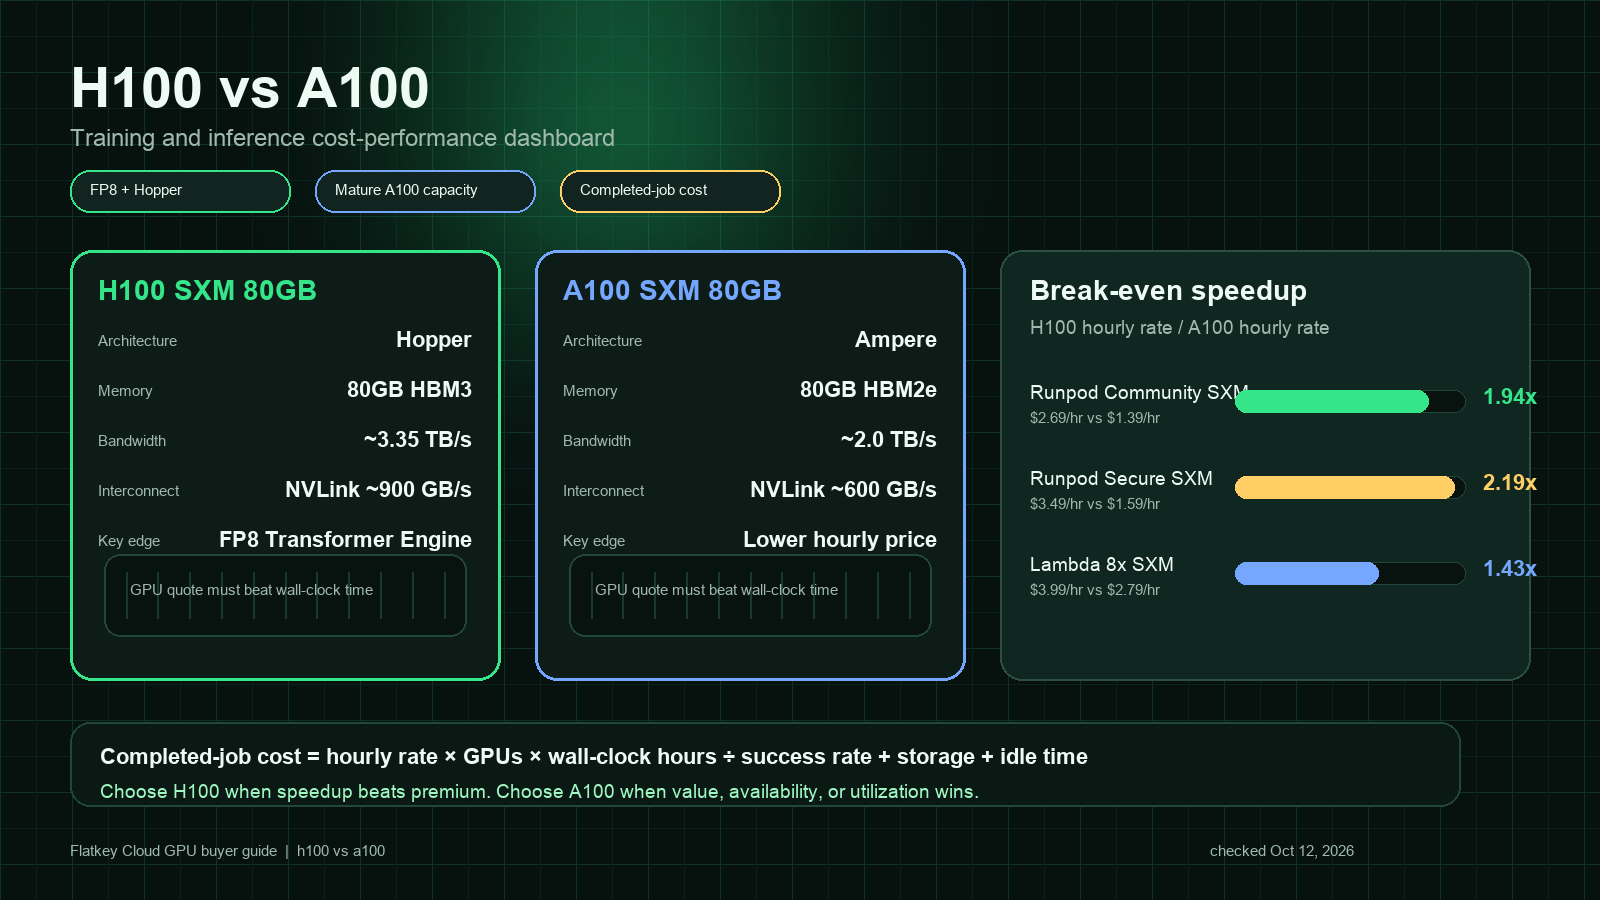
NVIDIA H100 vs. A100: Kosten-Leistung für Training und Inferenz
Ein praktischer Vergleich von H100 und A100 für KI-Teams, die zwischen Hopper-Performance und Ampere-Wert bei Training, Inferenz und Cloud-GPU-Miete entscheiden.
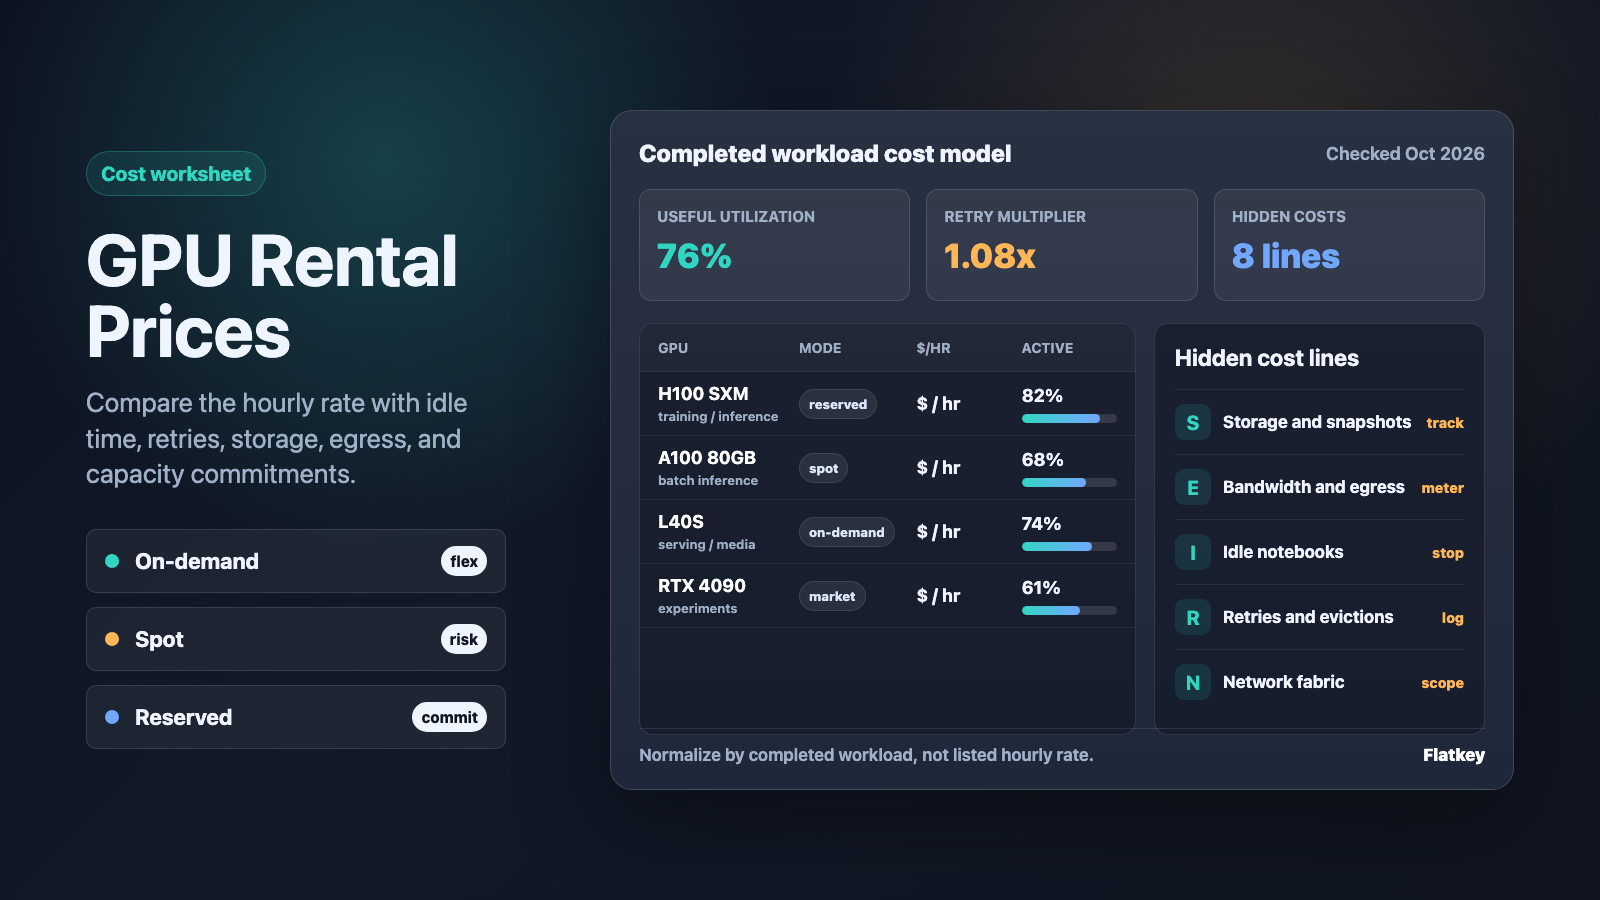
GPU-Mietpreise erklärt: On-Demand, Spot, Reserved und versteckte Kosten
Ein praktischer Leitfaden zum Vergleich von GPU-Mietpreisen anhand der Kosten pro abgeschlossenem Workload – nicht nur nach Stundensätzen – mit Quellenprüfungen für On-Demand-, Spot-, Reserved-, Marketplace- und Modelle mit versteckten Kosten.
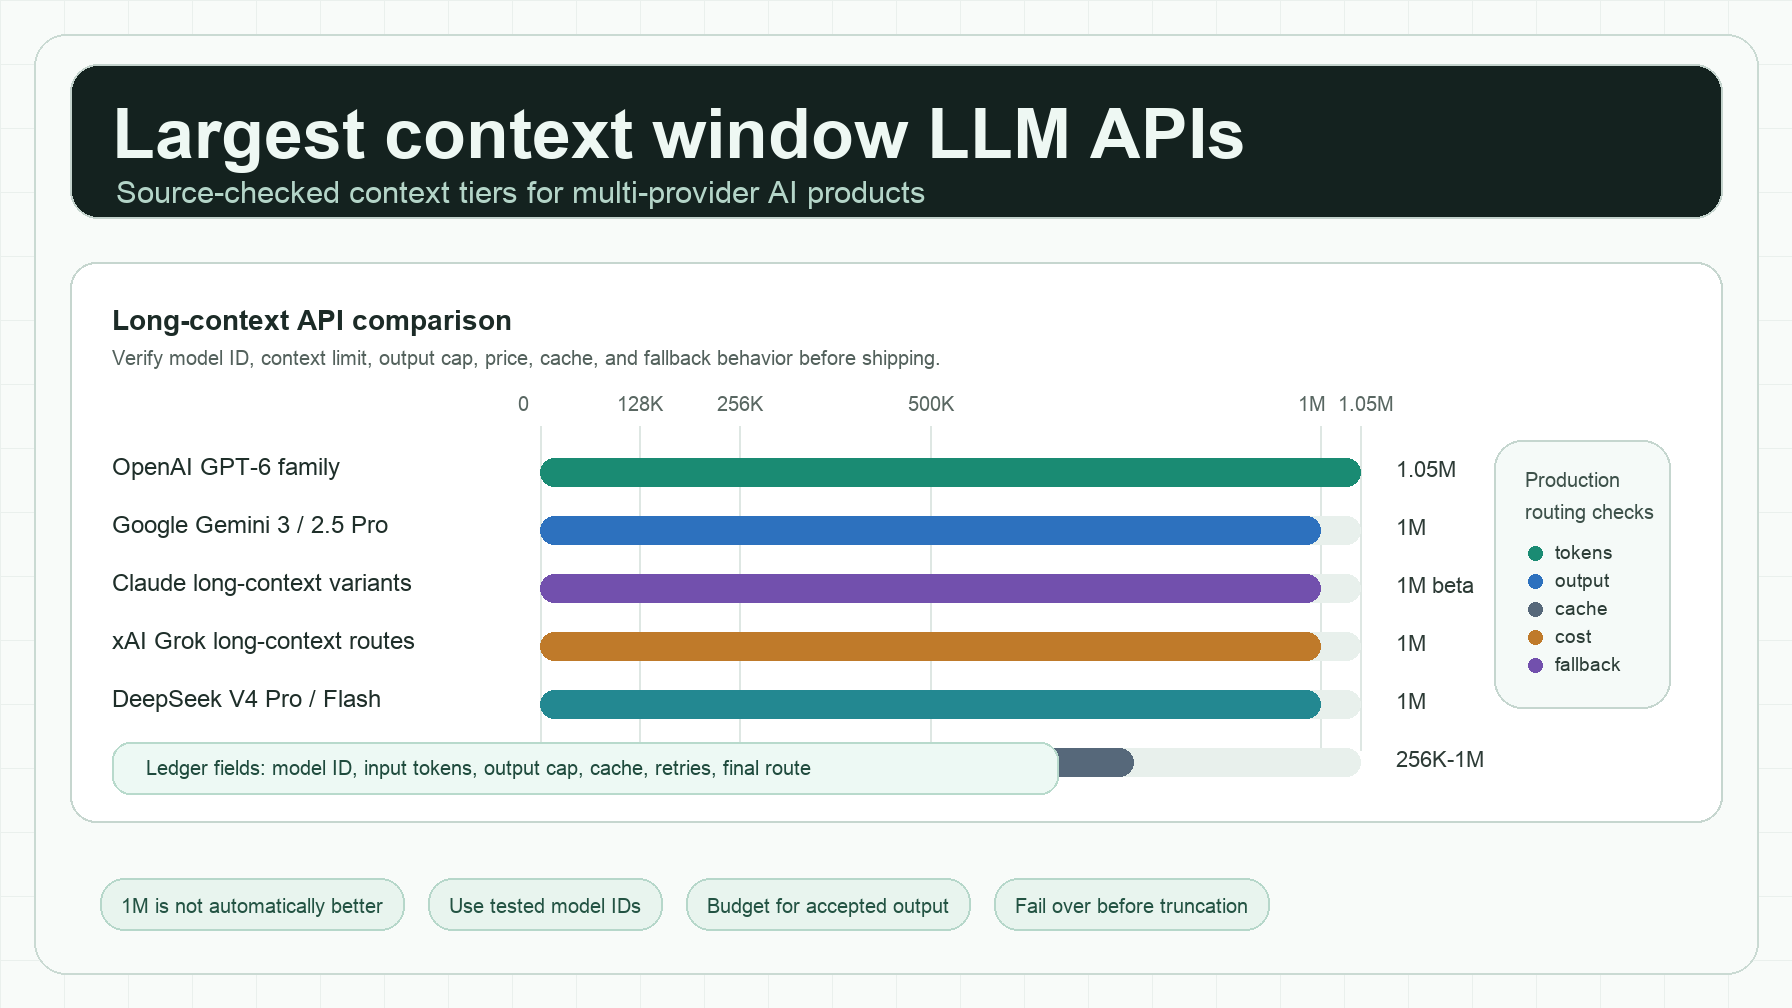
Das LLM-Kontextfenster erklärt: Bedeutung, Größen aller wichtigen Modelle und praktische Nutzung (Oktober 2026)
Das LLM-Kontextfenster ist der Arbeitsspeicher des Modells pro Anfrage. Hier erfährst du, was 128K, 200K und 1M Tokens bedeuten, welche Limits wichtige Modelle im Oktober 2026 haben, was langer Kontext kostet und wie du Tokens per Code zählst.
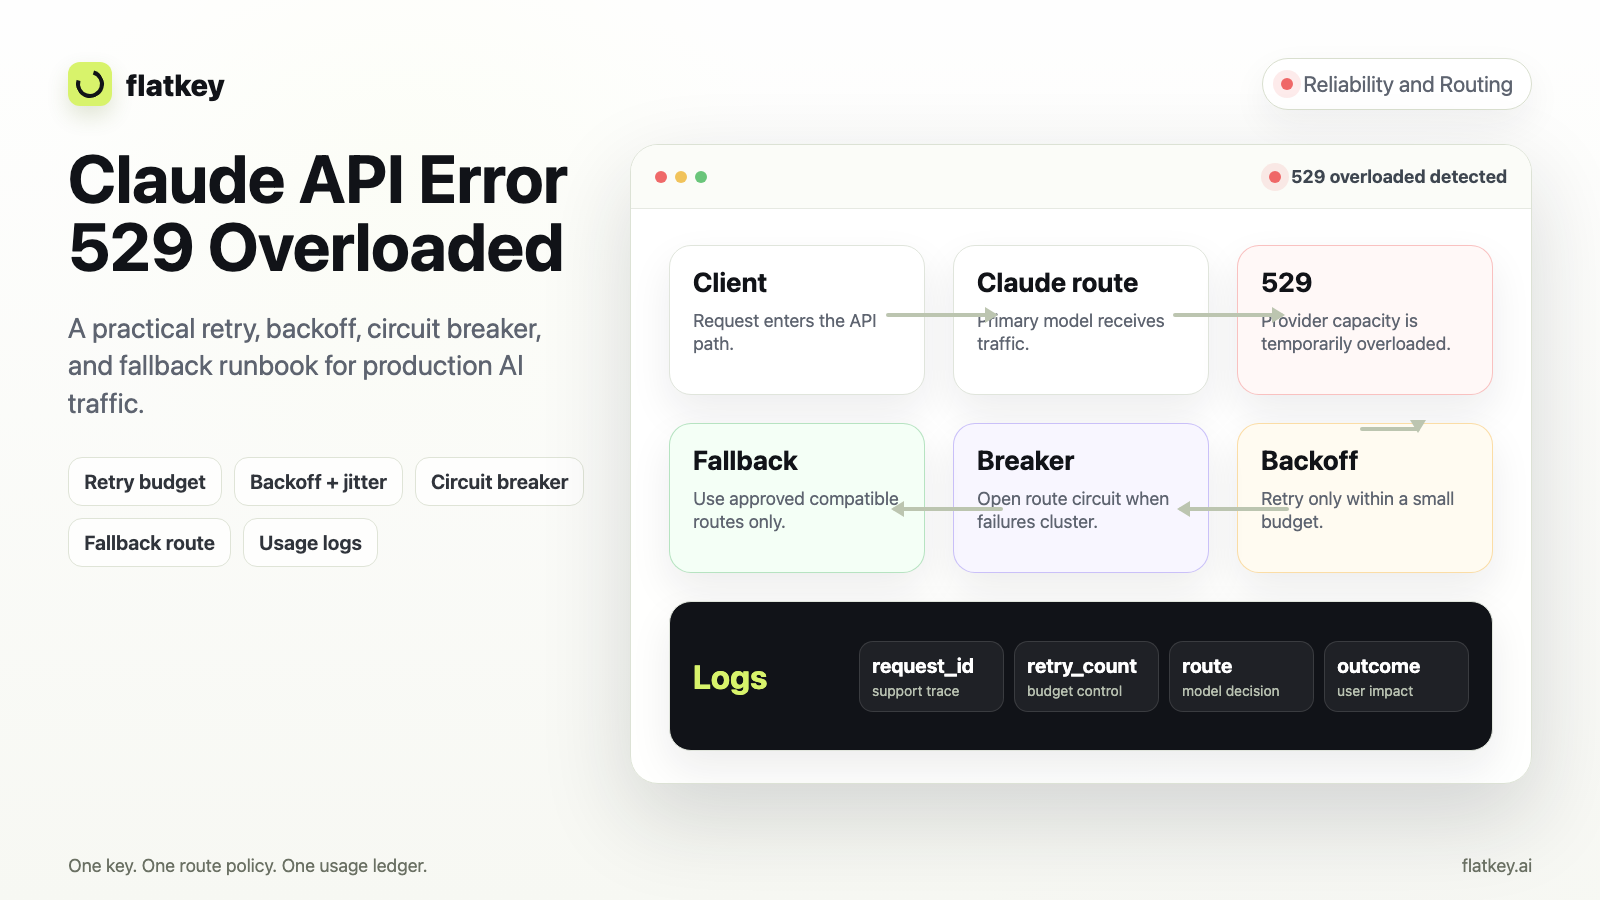
Claude API Fehler 529 Overloaded: Runbook für Retry, Backoff und Fallback
Ein Production-Runbook für Claude API 529 Overloaded-Fehler: den Fehler klassifizieren, Retry-Budgets festlegen, Backoff und Jitter hinzufügen, Side Effects schützen, wiederholte Overload-Fälle per Circuit Breaker abfangen und sichere Fallback-Pfade wählen.
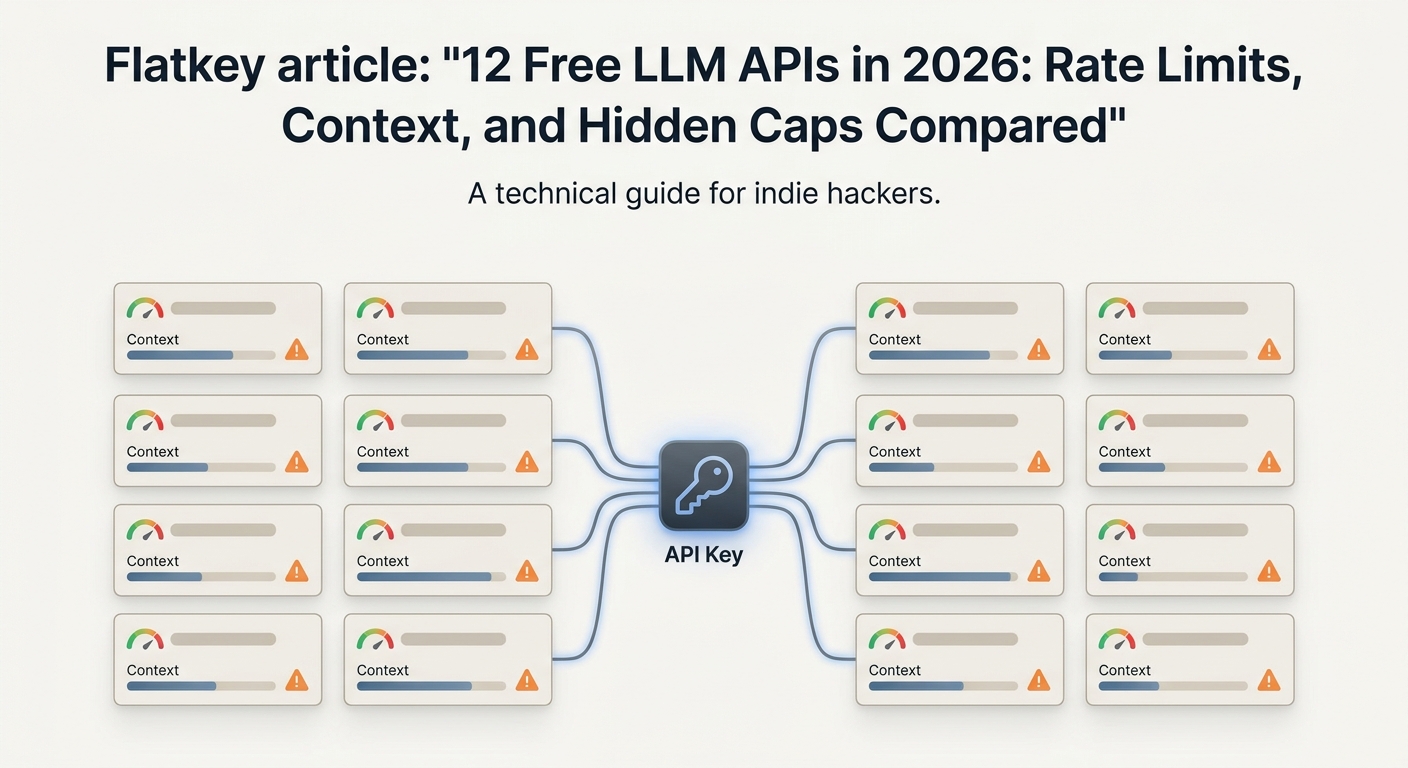
Kostenlose LLM-API (2026): 10 Optionen im Vergleich nach echten Limits, Modellen und Haken
Zehn kostenlose LLM-APIs, im Oktober 2026 anhand der offiziellen Dokumentation geprüft: was gratis ist, die genauen Limits, die versteckten Haken und Code für automatisches Umschalten.
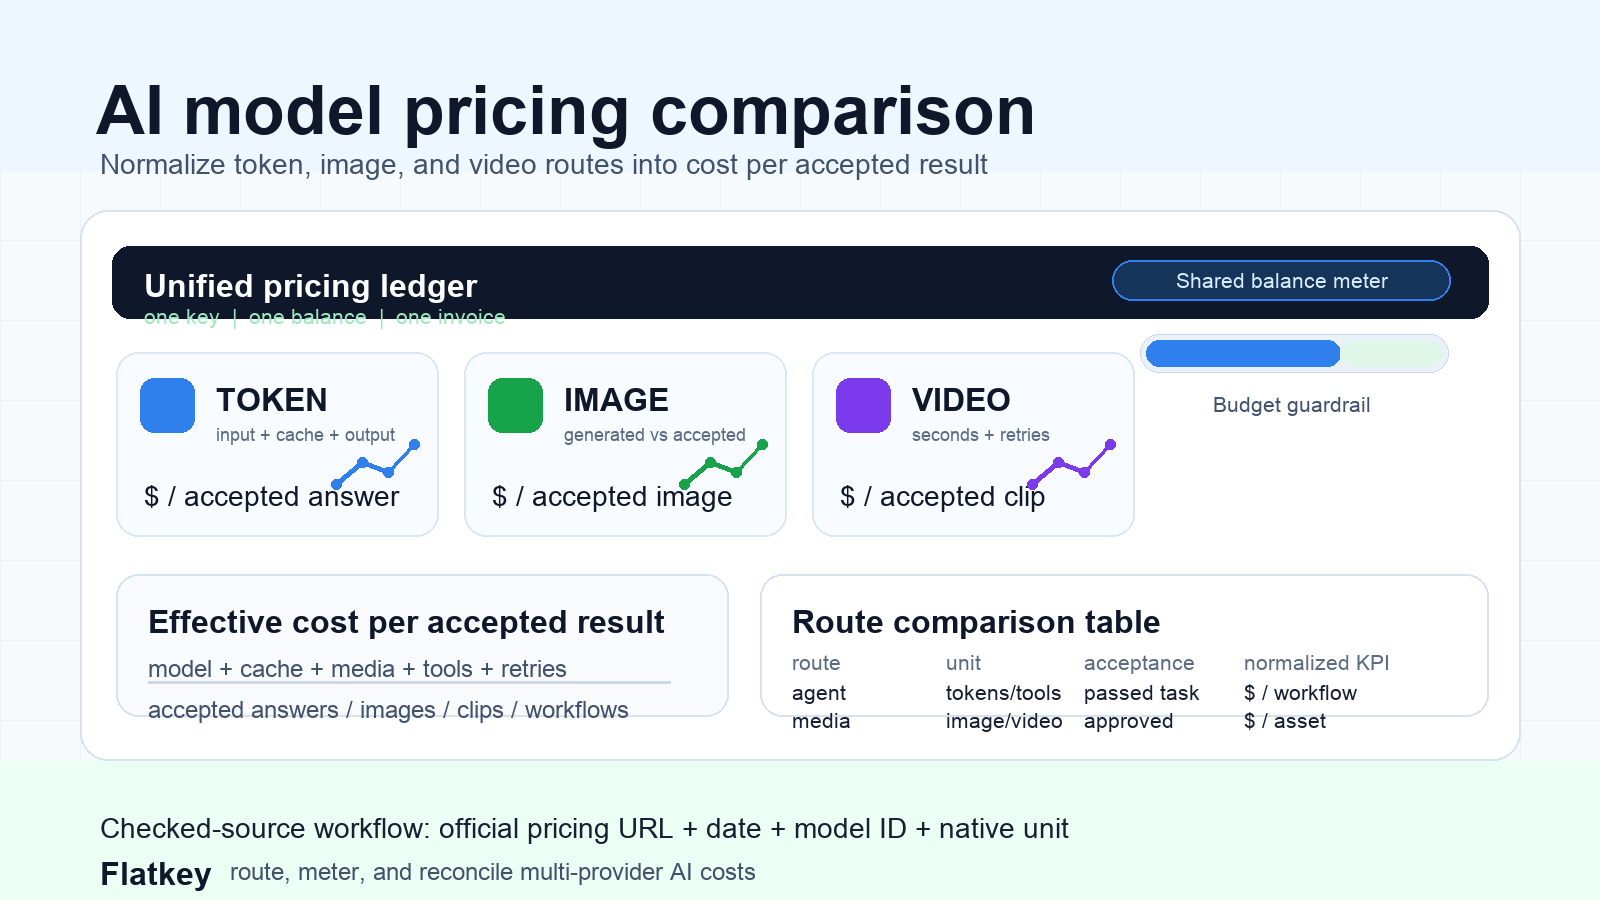
KI-Modell-Preisvergleich: Token-, Bild- und Videokosten in einem Dashboard
Vergleichen Sie die Preise von KI-Modellen über Text-, Bild-, Video- und Multi-Provider-API-Pfade mit einem Dashboard für die Kosten pro akzeptiertem Ergebnis.
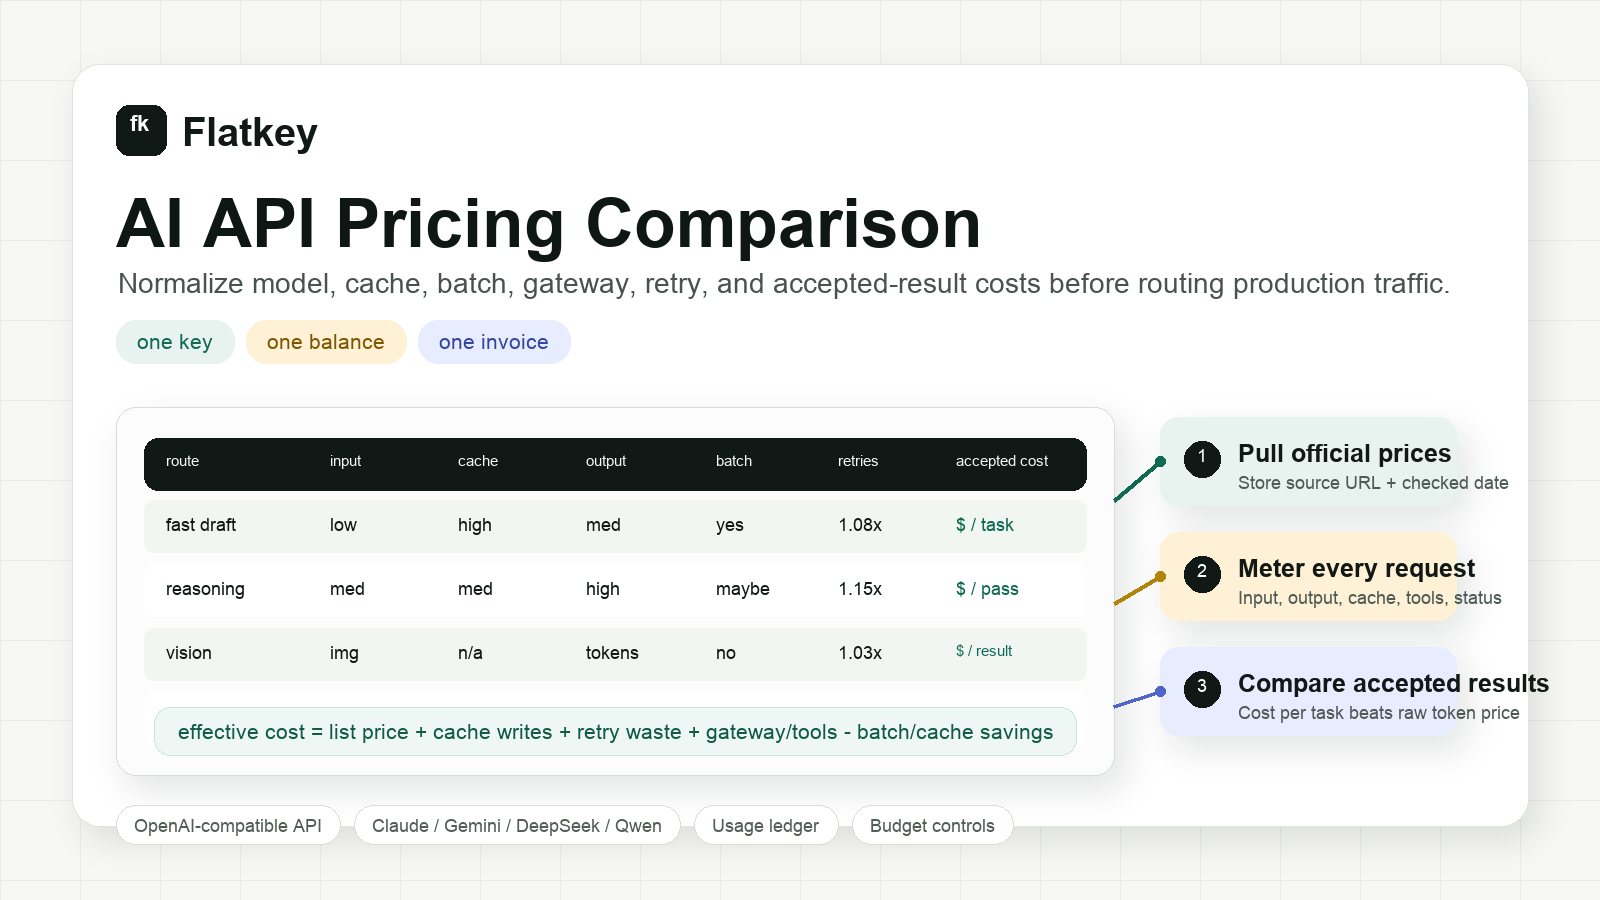
Vergleich der KI-API-Preise: Kosten für Modell, Cache, Batch und Gateway
Ein praktisches Framework für den Vergleich der KI-API-Preise für Entwickler, Produktteams und Einkaufsteams, das Kosten für Modell, Cache, Batch, Gateway, Retries und akzeptierte Ergebnisse gegenüberstellt.
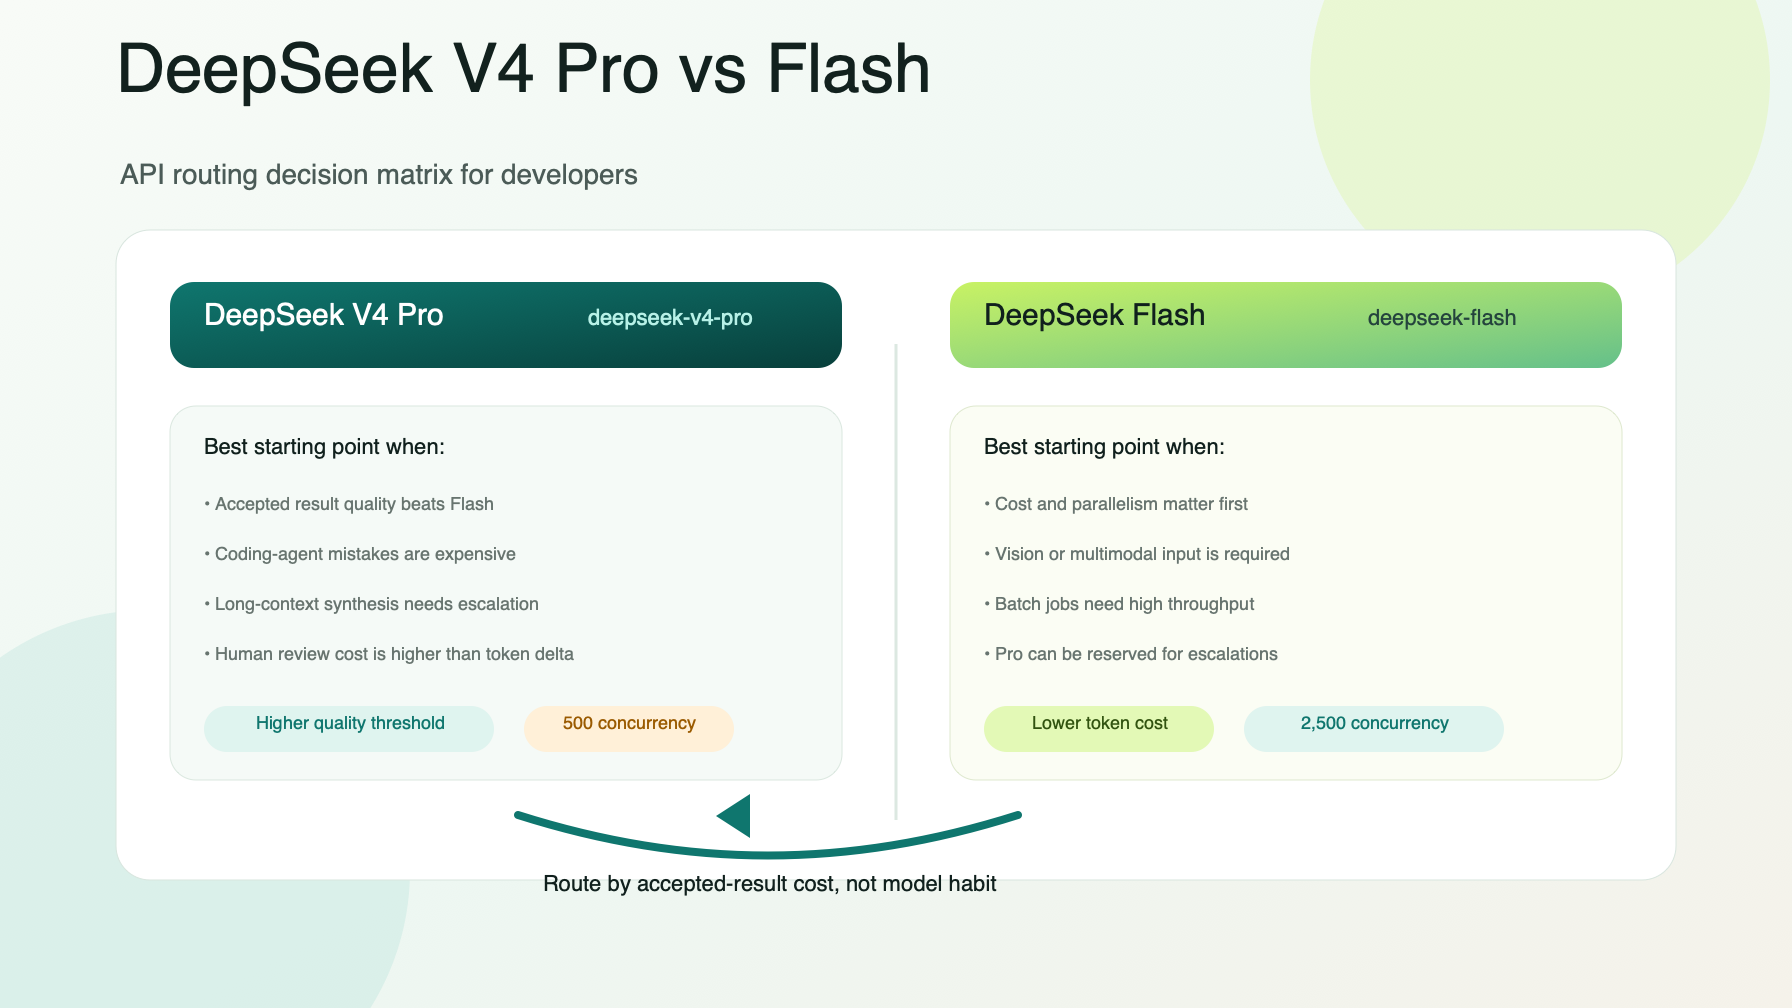
DeepSeek V4 Pro vs Flash: Welches Modell passt zu Ihrem API-Workflow?
Vergleichen Sie DeepSeek V4 Pro und Flash für API-Routing, Preise, Vision, Parallelität, Cache-Kosten und wann Pro oder Flash sinnvoll ist.
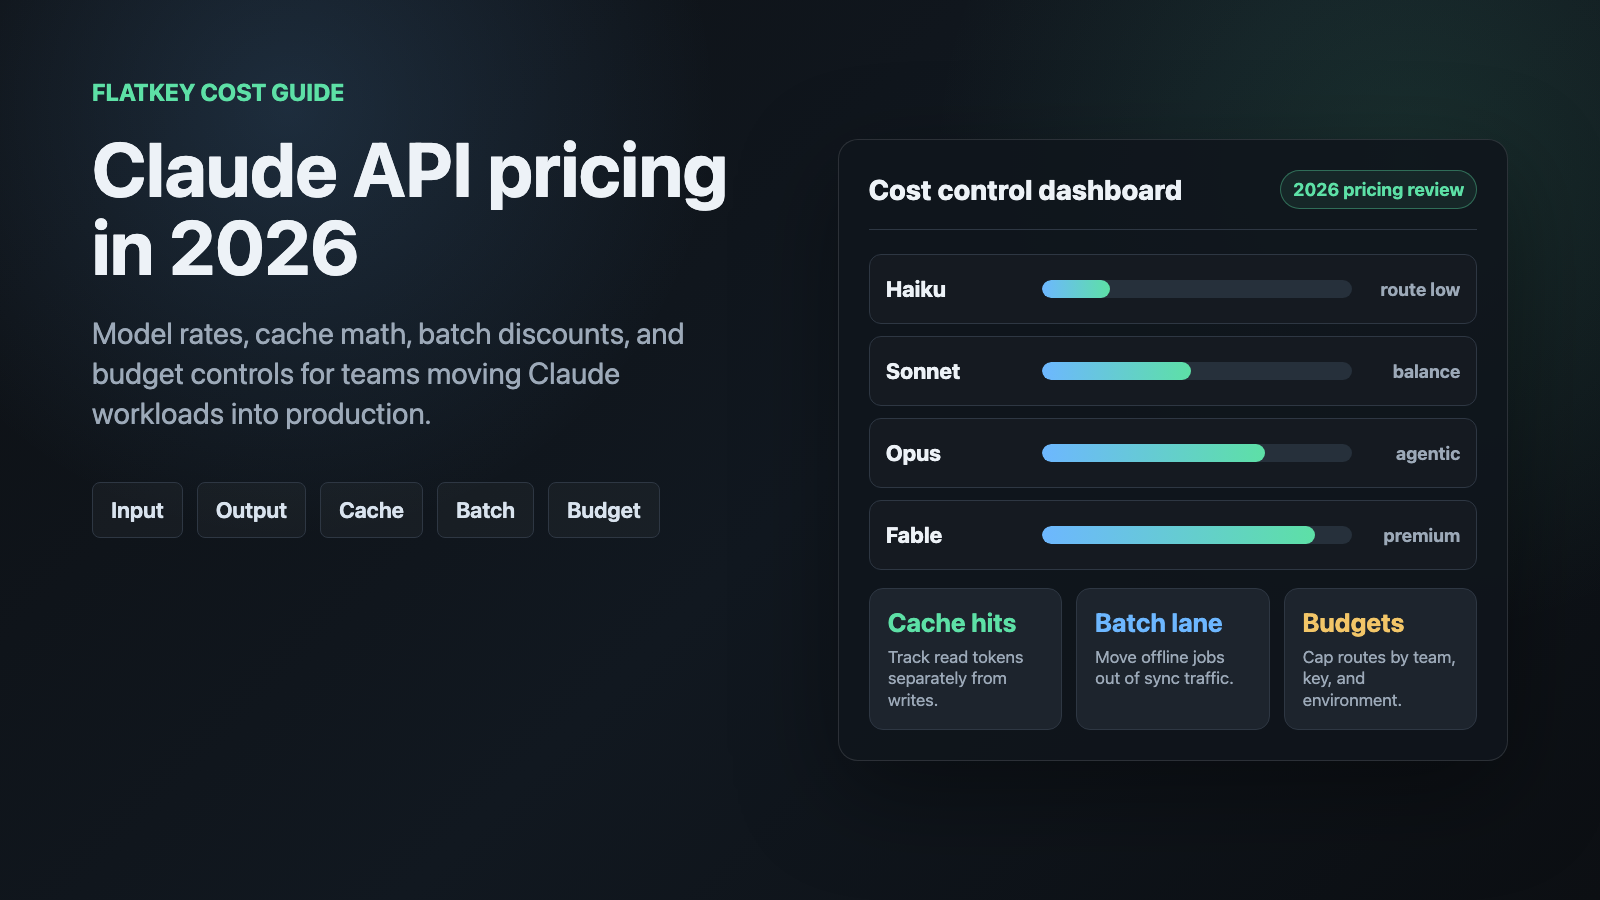
Welches Claude-Modell eignet sich am besten fürs Coding? Opus 5.5 vs Sonnet 5.5 vs Haiku 5.5 vs Fable 5.1 (2026)
Welches Claude-Modell sollten Sie 2026 fürs Coding nutzen? Ein Leitfaden nach Aufgabentyp für Opus 5.5, Sonnet 5.5, Haiku 5.5 und Fable 5.1, mit offiziellen Preisen, Kostenberechnungen für Sitzungen, Claude Code-Aliasen und ausführbaren API-Beispielen.
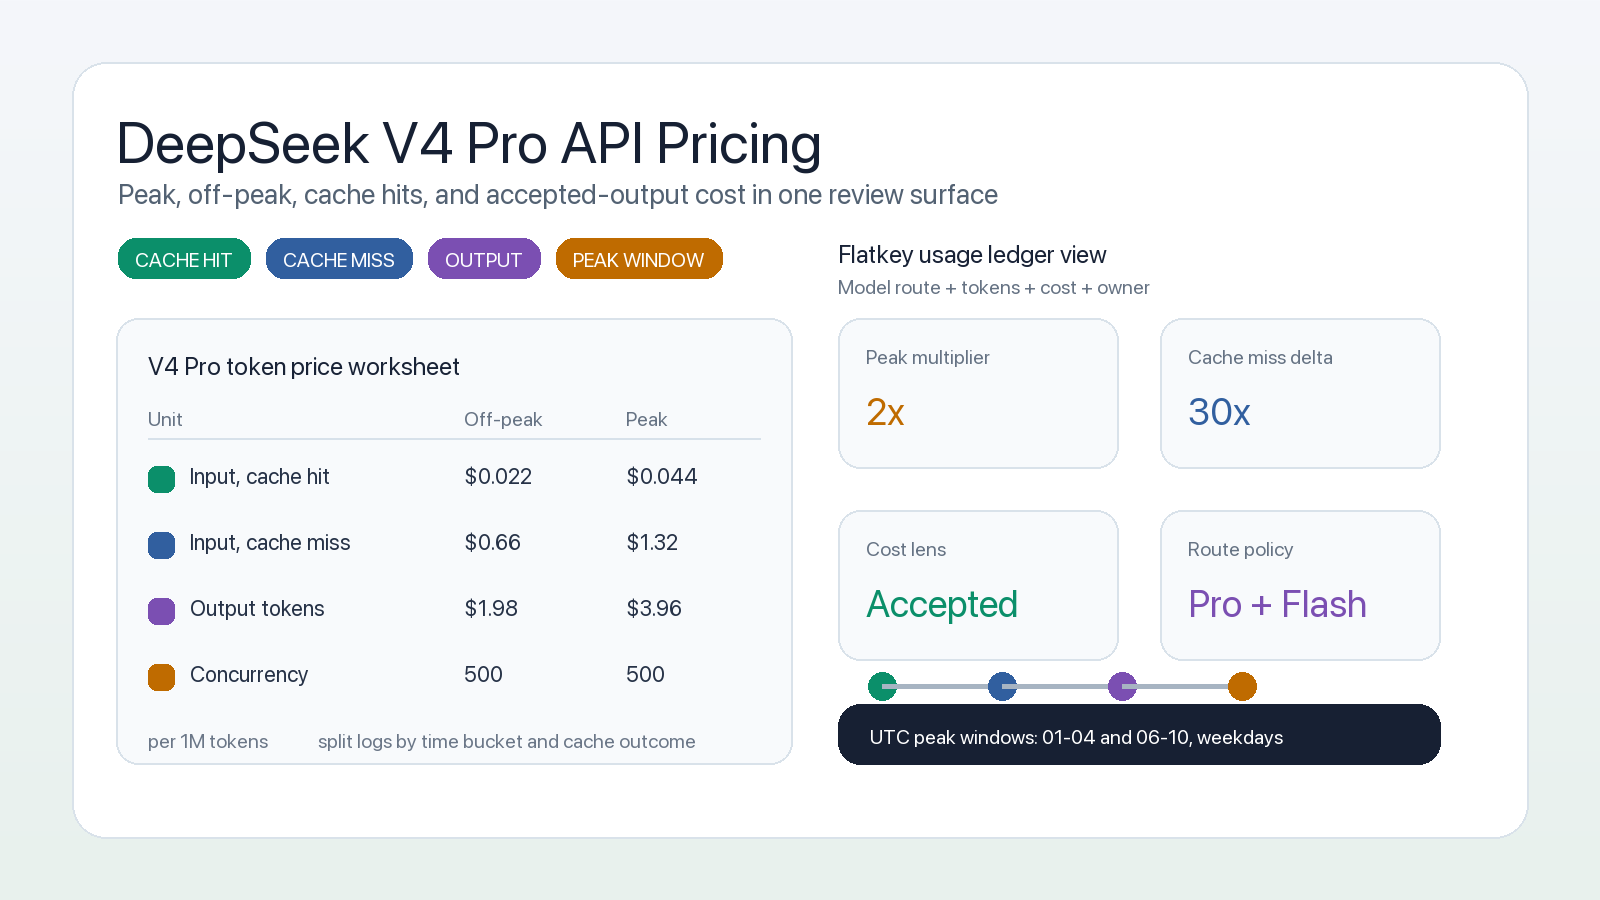
DeepSeek V4 Pro API-Preise: Spitzen-, Nebenzeiten- und Cache-Kosten
Aktuelle DeepSeek V4 Pro API-Preise mit Spitzen- und Nebenzeit-Tarifen, Cache-Hit-Berechnungen und einem Kostenkontroll-Worksheet für Entwickler- und Procurement-Teams.
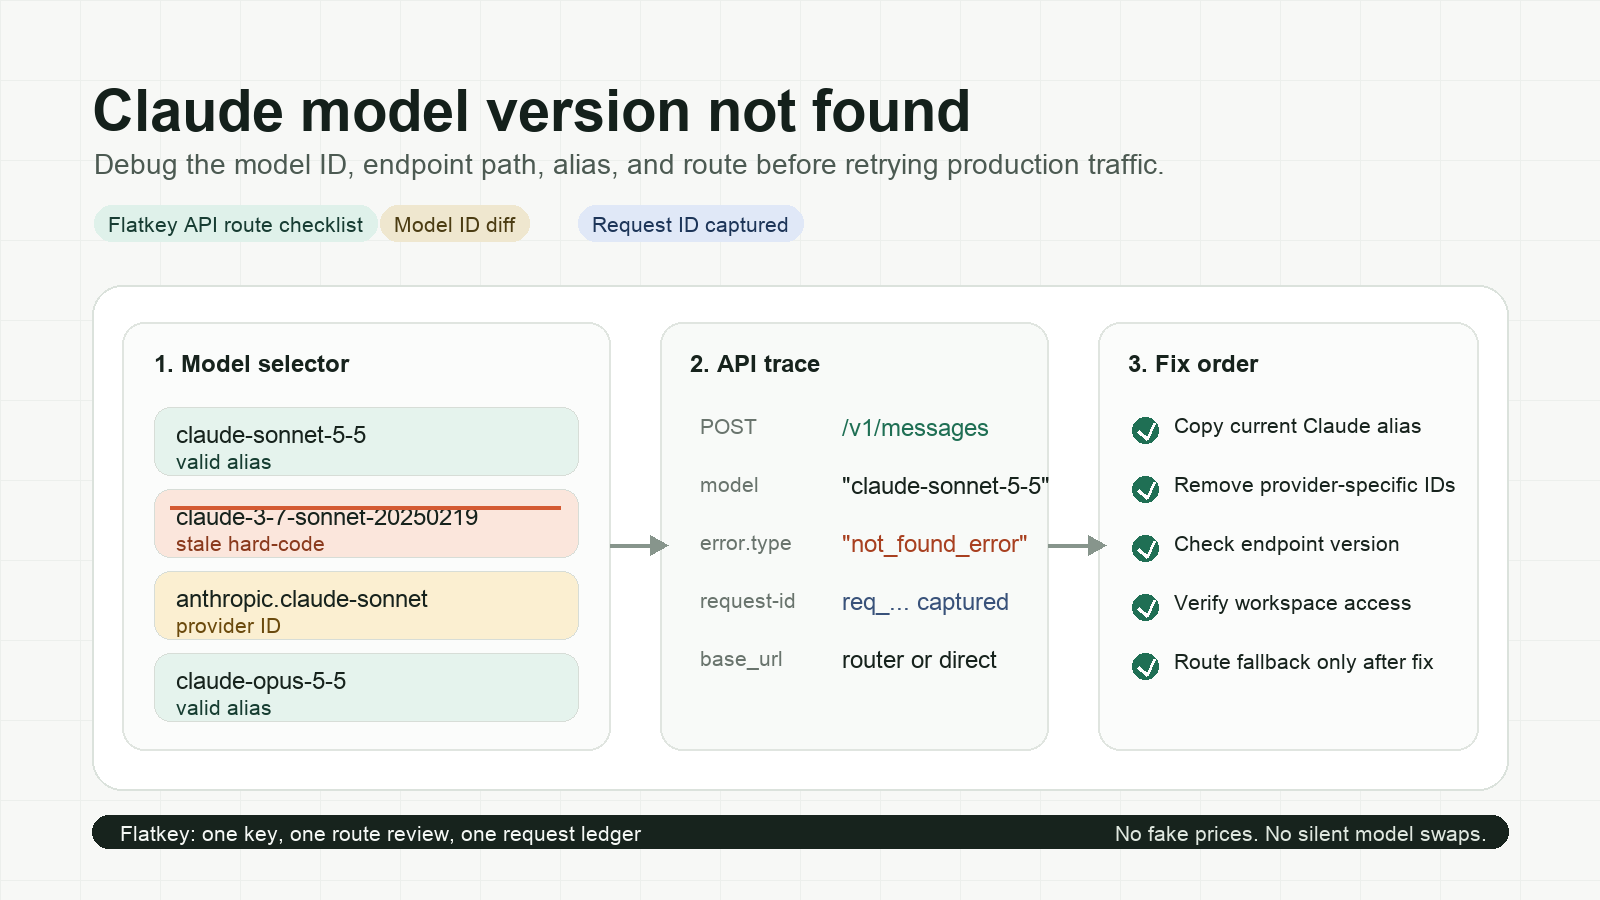
Claude Model Version Not Found: Falsche Model-IDs, Aliase und API-Routen beheben
Ein praktisches Debug-Runbook für Fehler vom Typ „Claude model version not found“ über Anthropic-native APIs, Router, Cloud-Provider-IDs, Agent-Konfigurationen und Produktions-Fallbacks.
Schneller entwickeln mit einem KI-Gateway.
Nutze flatkey.ai, um Modelle, Schlüssel, Abrechnung und Observability über eine API-Plattform zu verwalten.
Loslegen