
Atualizado: 14 de setembro de 2026
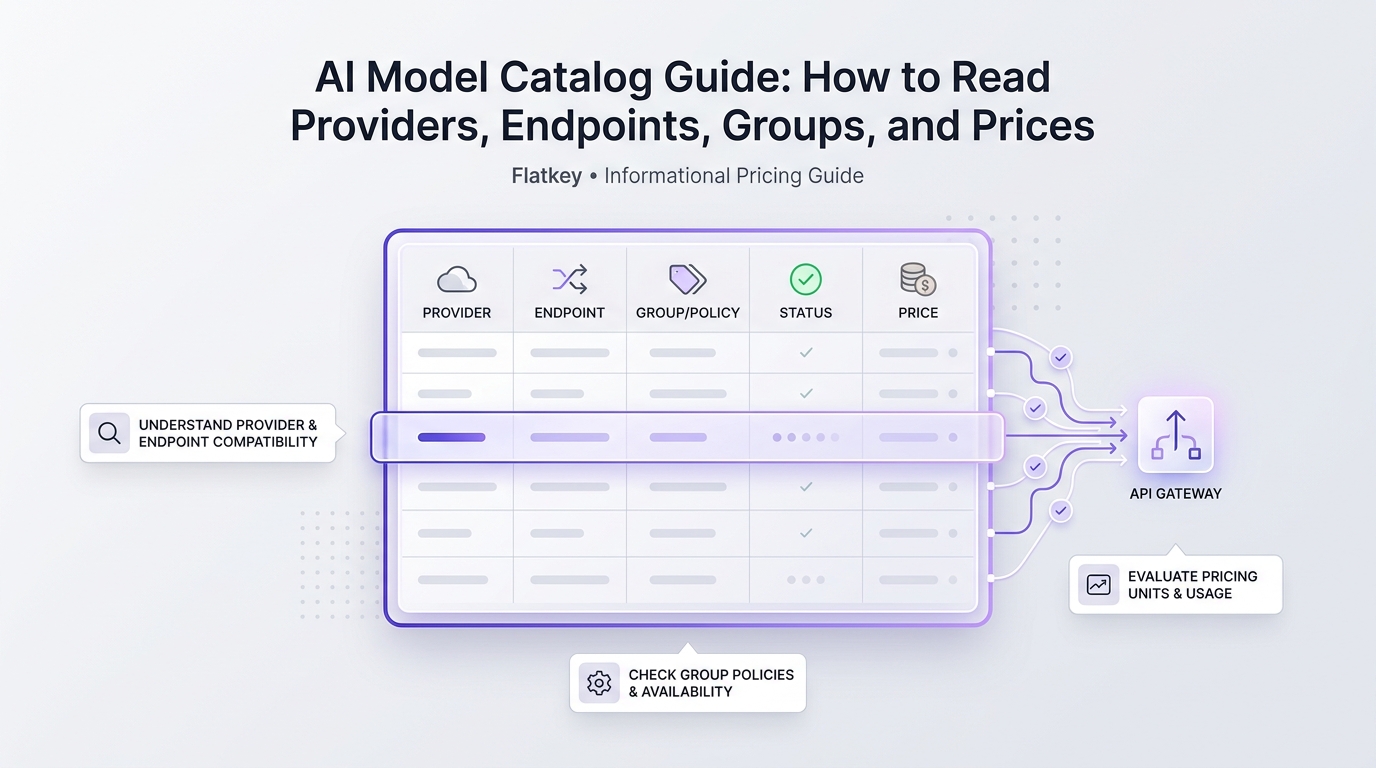
Um Guia do Catálogo de Modelos de IA: Como Ler Provedores, Endpoints, Grupos e Preços é útil porque os catálogos de modelos agora fazem mais do que listar nomes. Um catálogo de produção é uma superfície de roteamento. Ele informa aos times de produto, engenharia e finanças qual provedor é o proprietário da rota, qual formato de API é suportado, qual grupo ou plano pode chamá-lo, qual unidade é cobrada e se o modelo está saudável o suficiente para tráfego real.
O erro caro é ler um catálogo como se fosse um ranking. Uma linha com o nome de um modelo famoso ainda pode estar errada para sua carga de trabalho se o formato do endpoint não corresponder ao seu SDK, se a unidade de cobrança não for comparável, se a rota for limitada a um grupo que você não usa ou se o status de disponibilidade não estiver pronto para produção.
Este guia de catálogo de modelos de IA oferece às equipes de produto uma forma prática de ler um catálogo de modelos antes de selecionar, testar ou rotear tráfego por qualquer gateway de API de IA. Ele usa o diretório público de modelos e a documentação da Flatkey como exemplo de trabalho, mas a lista de verificação se aplica a catálogos diretos de provedores, catálogos de gateways e catálogos internos de plataformas.
Resposta Rápida: Como Ler Um Catálogo de Modelos de IA
Leia um catálogo de modelos de IA nesta ordem:
- Provedor: quem opera o modelo ou a rota upstream.
- ID do modelo: a string exata que sua aplicação deve enviar.
- Suporte a endpoint: qual formato de API a rota aceita, como chat compatível com OpenAI, Responses, Anthropic, Gemini, imagem, vídeo, embeddings ou uma rota nativa.
- Grupo ou plano: qual grupo de conta, grupo de rota, grupo de cota ou plano de cobrança pode usar a linha.
- Status de disponibilidade: se a rota está ativa, degradada, desconhecida, em prévia, acesso antecipado, descontinuada ou em breve.
- Unidade de preço: se a cobrança é por 1M de tokens de entrada/saída, tokens em cache, imagem, segundo, solicitação, caractere, minuto ou outra unidade.
- Evidência de uso: se sua solicitação de teste aparece nos logs com o modelo, status, contagem de tokens, rota, chave e custo esperados.
A resposta curta neste Guia do Catálogo de Modelos de IA: Como Ler Provedores, Endpoints, Grupos e Preços é: não escolha um modelo apenas pela coluna de preço. Escolha-o depois que o provedor, o endpoint, o grupo, o status, a unidade de preço e a evidência nos logs de uso estiverem todos de acordo com sua carga de trabalho.
Snapshot Atual do Catálogo de Modelos da Flatkey
A documentação atual da Flatkey descreve uma URL base compatível com OpenAI, https://router.flatkey.ai/v1, além de endpoints de API para conclusões de chat, Responses, embeddings, geração de imagens, tarefas de vídeo e listagem de modelos. O endpoint /v1/models retorna IDs de modelos e provedores em formato compatível com OpenAI, enquanto o Diretório de Modelos público é o local ao vivo para inspecionar preços, saúde, suporte a endpoints e páginas de detalhes dos modelos.
Em 14 de setembro de 2026, o diretório público de modelos da Flatkey expunha campos de linha que são diretamente relevantes para a revisão do catálogo:
| Campo do catálogo | O que ele informa | Exemplos de valores observados no diretório público |
|---|---|---|
model_name |
A string ou linha de modelo que você precisa testar. | gpt-5.6-sol, deepseek-v4-pro, seedance-2.5, gemini-3-flash-preview, claude-sonnet-5 |
vendor_name |
O provedor ou proprietário do catálogo por trás da rota. | OpenAI, DeepSeek, ByteDance, Google, Anthropic, catálogo Flatkey |
supported_endpoint_types |
Qual formato de requisição o modelo pode aceitar. | openai, openai-response, anthropic, gemini, openai-video, video |
availability_status |
Se a rota atualmente parece utilizável. | available, unknown_failure |
display_pricing.billing_kind |
A família da unidade de preço. | token, per_second, request |
enable_groups / group pricing |
Qual rota ou grupo comercial pode chamar a linha e como seu preço é ajustado. | Entradas de rotas agrupadas, como plg nos dados da página pública |
Trate esta captura como evidência de como o catálogo está estruturado, e não como uma tabela de preços permanente. A documentação de referência da Flatkey aponta explicitamente os leitores de volta para flatkey.ai/models, flatkey.ai/pricing e flatkey.ai/status, para que linhas de modelos, preços e integridade possam ser atualizados sem uma nova versão da documentação.
Leia os provedores antes de ler os nomes dos modelos
Provedor é o primeiro campo porque um nome de modelo sozinho não diz para onde o tráfego vai, qual contrato se aplica ou quais limites operacionais importam.
Use o campo de provedor para responder:
| Pergunta | Por que isso importa |
|---|---|
| Esta rota é operada pelo provedor original do modelo, por um gateway, por uma nuvem de inferência ou por um proxy interno? | Isso altera suporte, preços, logging, tratamento de dados e responsabilidade por incidentes. |
| A linha representa um endpoint oficial ou um modelo reexposto? | As equipes de produto precisam saber se o comportamento deve corresponder à API oficial do provedor. |
| Há várias linhas com nomes semelhantes de provedores diferentes? | Um rótulo qwen, deepseek, gemini ou claude pode ocultar diferenças regionais, de compatibilidade ou de plano. |
| Com qual provedor o financeiro deve fazer a conciliação? | A unidade de cobrança e a referência de preço de tabela podem vir do provedor, enquanto a fatura pode vir do gateway. |
Para a Flatkey, o posicionamento aprovado é uma chave, um saldo e acesso oficial a modelos entre provedores como OpenAI, Anthropic, Google, DeepSeek, Alibaba, Z.ai, Moonshot e ByteDance. Isso torna a transparência do provedor especialmente importante. Se uma linha do catálogo não deixar claros o provedor e a classe de rota, peça esclarecimento antes de aprovar a linha para produção.
Leia endpoints como contratos, não como rótulos
O suporte a endpoints é um contrato entre sua aplicação e a rota. Ele decide se o seu cliente atual, corpo da requisição, manipulador de streaming, parser de tool-call e lógica de contabilização de uso podem funcionar sem uma reescrita.
A documentação REST da Flatkey lista estes endpoints públicos da API:
| Endpoint | Uso típico |
|---|---|
/v1/chat/completions |
Chat e geração de texto compatíveis com OpenAI |
/v1/responses |
Fluxos de trabalho com estado ou com capacidade de ferramentas no estilo Responses para modelos compatíveis |
/v1/embeddings |
Embeddings vetoriais |
/v1/images/generations |
Geração de imagens |
/v1/videos |
Criação de tarefa de geração de vídeo |
/v1/videos/{task_id} |
Consulta de status da tarefa de vídeo |
/v1/videos/{task_id}/content |
Download do vídeo concluído |
/v1/models |
Lista de modelos disponíveis na conta |
Uma linha do catálogo que diz openai não é a mesma que uma linha que diz anthropic, gemini, openai-response, openai-video ou video. Um modelo pode suportar mais de uma família de endpoints, mas você ainda precisa testar o caminho exato que sua aplicação vai usar.
Para este guia de catálogo de modelos de IA, use o campo de endpoint para escrever um contrato curto de compatibilidade:
catalog_endpoint_contract:
  workload: support_ticket_summary
  model_id: selected-model-id
  provider: provider-name
  endpoint_type: openai
  base_url: https://router.flatkey.ai/v1
  endpoint_path: /v1/chat/completions
  required_features:
    - streaming
    - tool_calls
    - structured_json
    - usage_fields
  pass_condition:
    - existing_sdk_initializes
    - response_parser_accepts_output
    - usage_log_matches_model
    - fallback_policy_is_documented
Se um item nesse contrato falhar, o modelo ainda pode ser útil, mas não é uma rota plug-and-play para essa carga de trabalho.
Leia Os Grupos Como Política De Rota E De Custo
Os grupos são fáceis de ignorar porque parecem rótulos internos da plataforma. Não os ignore. Um grupo pode decidir quem pode usar uma rota, qual multiplicador de preço se aplica, qual chave é permitida, qual cota é consumida e qual pool de fallback está disponível.
Em um catálogo de gateway, os grupos geralmente representam uma ou mais destas políticas:
| Significado do grupo | O que verificar |
|---|---|
| Plano comercial | Esta conta ou equipe tem acesso ao preço exibido? |
| Pool de rota | Qual classe de canal upstream ou conta de provedor processa o tráfego? |
| Ambiente do produto | Esta rota está aprovada para dev, staging, produção ou um cliente específico? |
| Escopo de orçamento | Qual chave, equipe, workspace ou orçamento do cliente é cobrado? |
| Lista de अनुमति | O modelo é permitido para dados regulamentados, recursos públicos ou autonomia de agentes? |
| Família de fallback | Este grupo pode fazer fallback para outra rota sem quebrar a qualidade ou a política? |
O posicionamento de produto da Flatkey inclui governança de subchaves, orçamentos, listas de permissão de modelos, registros de uso e um saldo compartilhado. Isso significa que a linha do catálogo e o painel de uso devem concordar. Se um gerente de produto aprovar um modelo no catálogo, mas a chave de produção não estiver no grupo certo, a engenharia vai descobrir o problema como um 403, 429, falha de fallback ou surpresa de faturamento.
Leia os preços por unidade antes de comparar linhas
Preço é o campo mais mal interpretado de um catálogo de modelos. Um guia de catálogo de modelos de IA deve obrigar todo preço a ser convertido para sua unidade real antes que alguém o compare.
Não compare estas unidades como se fossem iguais:
| Unidade de preço | Carga de trabalho comum | Risco na análise do catálogo |
|---|---|---|
| Tokens de entrada | Chat com muito prompt, resumo, geração aumentada por recuperação | Prompts longos e contexto recuperado podem dominar o custo. |
| Tokens de saída | Raciocínio, redação, geração de código, extração | Conclusões longas podem dominar o custo mesmo quando a entrada parece barata. |
| Tokens de entrada em cache | Prompts de sistema reutilizados, cache de prompt, cache de contexto | As taxas de acerto e de erro de cache devem ser medidas separadamente. |
| Tokens de saída de imagem ou preço por imagem | Geração e edição de imagens | Resolução, qualidade, imagens de referência, retries e taxa de aceitação alteram o custo real. |
| Por segundo | Geração de vídeo e algumas rotas de mídia | Duração e clipes com falha/editados importam mais do que a contagem de solicitações. |
| Por solicitação | Busca, ferramentas, utilitários de imagem, enriquecimento, APIs personalizadas | A taxa de sucesso da solicitação e a política de retry decidem o custo final. |
| Por minuto ou caractere | Fala, transcrição, texto para fala, fluxos de trabalho semelhantes a OCR | Contagem de canais, idioma, add-ons e modo em lote podem alterar o custo. |
As páginas de preços dos provedores também usam nomenclaturas diferentes. OpenAI, Anthropic, Google Gemini e DeepSeek separam alguma combinação de preços de entrada, saída, entrada em cache, leitura/gravação de cache ou acerto/erro de cache em sua documentação pública atual de preços. Por isso, uma análise de catálogo deve armazenar a URL da fonte ao vivo e a data da revisão, em vez de copiar um único preço permanente para uma tarefa de roadmap.
Use esta fórmula normalizada:
accepted_workload_cost =
  (primary_attempt_cost
   + retry_cost
   + fallback_cost
   + cached_or_uncached_delta
   + media_or_tool_addons)
  / accepted_outputs
Depois adicione o contexto da decisão:
production_cost_decision =
  accepted_workload_cost
  + latency_penalty
  + manual_review_cost
  + incident_risk
  + data_policy_constraints
Essa segunda linha é por que a célula de preço mais barata raramente é a resposta final.
Leia o status antes do tráfego de produção
O status de disponibilidade deve ser uma barreira, não uma nota de rodapé. Um modelo pode parecer perfeito em provedor, endpoint e preço, mas ainda assim ser a escolha errada para produção se for apenas prévia, degradado, limitado por região, descontinuado, ausente da sua conta ou reprovando nas verificações de saúde.
Use estas classes de status:
| Classe de status | O que fazer |
|---|---|
| Disponível e testado | Elegível para implantação controlada após a verificação do log de uso. |
| Disponível, mas não testado | Execute um teste rápido antes de atribuir tráfego de produção. |
| Prévia, beta, acesso antecipado ou limitado | Use para experimentos, a menos que o produto aceite explicitamente o risco do ciclo de vida. |
| Degradado ou com alta latência | Mantenha como não padrão ou apenas como fallback, se a carga de trabalho tolerar. |
| Falha desconhecida | Trate como bloqueado até que a rota seja verificada. |
| Obsoleto ou com desligamento agendado | Não inicie novos trabalhos, a menos que haja um motivo de migração de curto prazo. |
| Em breve | Não inclua nos compromissos de lançamento. |
A documentação da Flatkey aponta as verificações de integridade do modelo para a página de status ao vivo. Para uma decisão de produção, o campo de status deve ser salvo com a data, o ID do modelo, o tipo de endpoint, a chave ou grupo e um ID de solicitação real.
Um fluxo de trabalho da Flatkey para revisão do catálogo
Use este fluxo de trabalho sempre que uma equipe de produto perguntar se um modelo do catálogo é seguro para uso.
- Abra o Diretório de Modelos da Flatkey.
- Pesquise o ID exato do modelo, não apenas o nome do provedor.
- Registre provedor, suporte a endpoint, status de disponibilidade, unidade de preço, acesso ao grupo e a data atual da revisão.
- Abra a precificação da Flatkey e a página de preços do provedor relevante.
- Escreva a unidade de custo normalizada: por 1 milhão de tokens de entrada, tokens de saída, tokens em cache, imagem, segundo, solicitação ou outra unidade.
- Execute um teste rápido de baixo risco pelo
base_urlpretendido, pelo caminho do endpoint e pelo ID do modelo. - Confirme que a solicitação aparece nos logs de uso da Flatkey com o modelo esperado, chave, status, contagens de tokens ou unidade de mídia e custo.
- Defina as regras de fallback antes de enviar usuários reais: gatilho, número de tentativas, modelos de fallback permitidos, critério de qualidade e campos de registro.
- Revise o registro do catálogo com produto, engenharia, finanças e segurança antes de tornar a rota padrão.
A parte importante é a etapa 7. Uma linha do catálogo é uma promessa. Uma linha do log de uso é a evidência de que a promessa correspondeu à sua conta, chave, grupo e carga de trabalho.
Modelo: registro de revisão do catálogo de modelos de IA
Copie este modelo para um documento interno de lançamento:
ai_model_catalog_review:
  review_date: 2026-09-14
  reviewer: product_owner_or_platform_owner
  workload: customer_support_summary
  business_owner: support_product
  environment: staging
  catalog:
    catalog_url: https://flatkey.ai/models
    model_id: selected-model-id
    provider: provider-name
    endpoint_types:
      - openai
    group_or_plan: approved-group
    availability_status: available
    pricing_unit: per_1m_input_and_output_tokens
  compatibility:
    base_url: https://router.flatkey.ai/v1
    endpoint_path: /v1/chat/completions
    sdk: openai-python
    streaming_required: true
    tool_calls_required: false
    structured_output_required: true
  cost:
    provider_pricing_url: provider-pricing-page
    flatkey_pricing_url: https://flatkey.ai/pricing
    cost_formula: accepted_workload_cost
    cache_assumption: measured_not_assumed
  evidence:
    smoke_test_request_id: req_example
    usage_log_verified: true
    output_parser_passed: true
    p95_latency_ms: measured
    fallback_tested: false
  decision:
    status: approve_for_limited_rollout
    rollout_limit: 5_percent_of_traffic
    fallback_route: selected-fallback-model
    next_review_date: 2026-09-21
Este modelo mantém o Guia do Catálogo de Modelos de IA: Como Ler Provedores, Endpoints, Grupos e Preços prático. O resultado não é uma lista de preferências. É um registro de decisão auditável.
Erros comuns no catálogo de modelos de IA
Erro 1: Tratando provider e family de modelo como o mesmo campo
Provider é o proprietário upstream ou o proprietário da rota. Family de modelo é um grupo de nomenclatura. Eles são relacionados, mas não são intercambiáveis. Registre ambos.
Erro 2: Assumir que compatível com OpenAI significa que todo endpoint funciona
A configuração compatível com OpenAI pode reduzir o trabalho de migração, mas não prova que todo endpoint, evento de streaming, formato de chamada de ferramenta, campo de uso ou parâmetro de mídia funcione para todo modelo. Teste a família exata de endpoint na linha do catálogo.
Erro 3: Comparar preço por token com preço de mídia
Faturamento por token, por imagem, por segundo e por requisição não deve ser consolidado em uma única coluna de preço. Normalize para custo por saída aceita para a carga de trabalho.
Erro 4: Ignorar grupos até o rollout
Se a chave de produção não tiver permissão para chamar o grupo que você aprovou, a decisão do catálogo está incompleta. Valide o acesso ao grupo com a chave que realmente será usada em produção.
Erro 5: Copiar uma linha de preço sem uma data de revisão
Os preços do provider e do gateway podem mudar. Salve a URL de origem, a data de revisão, o ID do modelo, a unidade de preço e a evidência do log de uso de uma solicitação de teste.
Erro 6: Fazer o deploy apenas com base no status do catálogo
O status do catálogo deve acionar o smoke test. Ele não deve substituir o smoke test. A aprovação em produção precisa de pelo menos uma solicitação passando pela mesma chave, endpoint, modelo e grupo.
Quando um catálogo unificado de modelos de IA ajuda mais
Um catálogo unificado de modelos ajuda mais quando uma equipe tem mais de um destes problemas:
- Várias chaves de provedor estão espalhadas por serviços, agentes e ambientes.
- O produto quer comparar rotas de texto, imagem, vídeo, embedding e ferramentas em um único fluxo de trabalho.
- As finanças querem evidências de custo em nível de requisição em vez de faturas separadas de provedores.
- A engenharia de plataforma precisa de regras de fallback, verificações de saúde e allowlists de modelos.
- A segurança precisa saber qual rota processou qual carga de trabalho.
- As equipes precisam migrar de um modelo para outro sem reescrever cada cliente.
O Flatkey está posicionado para esse padrão: uma chave de API, um roteador compatível com OpenAI, um diretório de modelos em tempo real, logs de uso, acesso a modelos/ferramentas por meio de um único saldo e controles operacionais para equipes. Isso não elimina a due diligence. Ele dá à equipe um único lugar para realizá-la.
FAQ
O que é um catálogo de modelos de IA?
Um catálogo de modelos de IA é uma lista pesquisável de rotas de modelos e seus metadados: ID do modelo, provedor, endpoints compatíveis, unidade de preço, disponibilidade, grupos ou planos e, às vezes, janela de contexto, modalidade, saúde, limites e links de uso.
Por que o campo provedor importa?
O campo provedor informa quem é o proprietário do modelo ou da rota upstream. Isso afeta suporte, referências de preços, limites, avisos de ciclo de vida, comportamento regional, tratamento de dados e resposta a incidentes.
O que significa suporte a endpoint em um catálogo de modelos?
O suporte a endpoint informa qual formato de API uma linha de modelo aceita. Por exemplo, uma linha pode oferecer suporte a chat compatível com OpenAI, Responses, requisições compatíveis com Anthropic, requisições nativas do Gemini, geração de imagens, geração de vídeo ou embeddings. Seu SDK e parser devem corresponder ao endpoint que você escolher.
Os grupos são iguais a faixas de preço?
Às vezes, mas nem sempre. Os grupos podem representar planos comerciais, pools de rotas, políticas de acesso, escopos de chave, escopos de orçamento ou famílias de fallback. Trate grupos como política de rota até que o proprietário da plataforma confirme o significado exato.
Como as equipes devem comparar preços de modelos?
Compare os preços dos modelos por carga de trabalho, não pela linha bruta do catálogo. Normalize tokens de entrada, tokens de saída, tokens em cache, imagens, segundos, requisições, retries, tentativas de fallback e saídas aceitas em uma única fórmula de custo.
Devo confiar em uma linha do catálogo de modelos sem testar?
Não. Uma linha do catálogo é um ponto de partida útil, mas a aprovação para produção deve incluir um teste de fumaça com a chave exata, URL base, endpoint, ID do modelo e grupo que você planeja usar.
Como o Flatkey ajuda na revisão do catálogo de modelos?
O Flatkey dá às equipes um único lugar para inspecionar linhas de modelos, rotear por meio de uma URL base compatível com OpenAI, comparar superfícies de preços em tempo real, verificar a saúde do modelo e revisar logs de uso. Isso facilita auditar decisões de catálogo entre produto, engenharia e finanças.
Etapa Final de Revisão do Catálogo
A etapa final em um Guia do Catálogo de Modelos de IA: Como Ler Provedores, Endpoints, Grupos e Preços não é escolher um modelo. É provar a rota.
Antes do lançamento, sua equipe deve ser capaz de mostrar:
- O ID exato do modelo e o provedor.
- O tipo de endpoint e o caminho do SDK.
- O grupo ou plano que concede acesso.
- A unidade de preço atual e a URL de origem.
- O status de disponibilidade e a data de revisão.
- Um ID de requisição do teste de fumaça.
- Uma linha de log de uso mostrando modelo, chave, status, tokens ou unidade de mídia e custo.
- Uma regra de fallback e rollback.
Se esses campos estiverem completos, o catálogo está cumprindo sua função. Se estiverem ausentes, a decisão sobre o modelo ainda é um palpite.
Fontes verificadas
- Visão geral da API REST da Flatkey
- endpoint List Models da Flatkey
- guia do SDK OpenAI da Flatkey
- documentação do painel de uso e custos da Flatkey
- diretório de modelos em tempo real da Flatkey
- preços da Flatkey
- status de saúde dos modelos da Flatkey
- preços da API da OpenAI
- preços da Anthropic
- preços da API do Google Gemini
- preços da API da DeepSeek


