Comparação de Preços de Modelos de IA: Custos de Tokens, Imagens e Vídeos em um Só Painel
Uma comparação de preços de modelos de IA só é útil se corresponder à forma como o seu produto realmente gasta dinheiro. Uma tabela estática de preços de tokens é um ponto de partida. O custo real de inferência muda com tokens de entrada, entrada em cache, tokens de saída, unidades de saída de imagem, segundos de vídeo, chamadas de ferramentas, novas tentativas, fallbacks, trabalhos com falha e a শতাংশagem de resultados gerados que os usuários realmente aceitam.
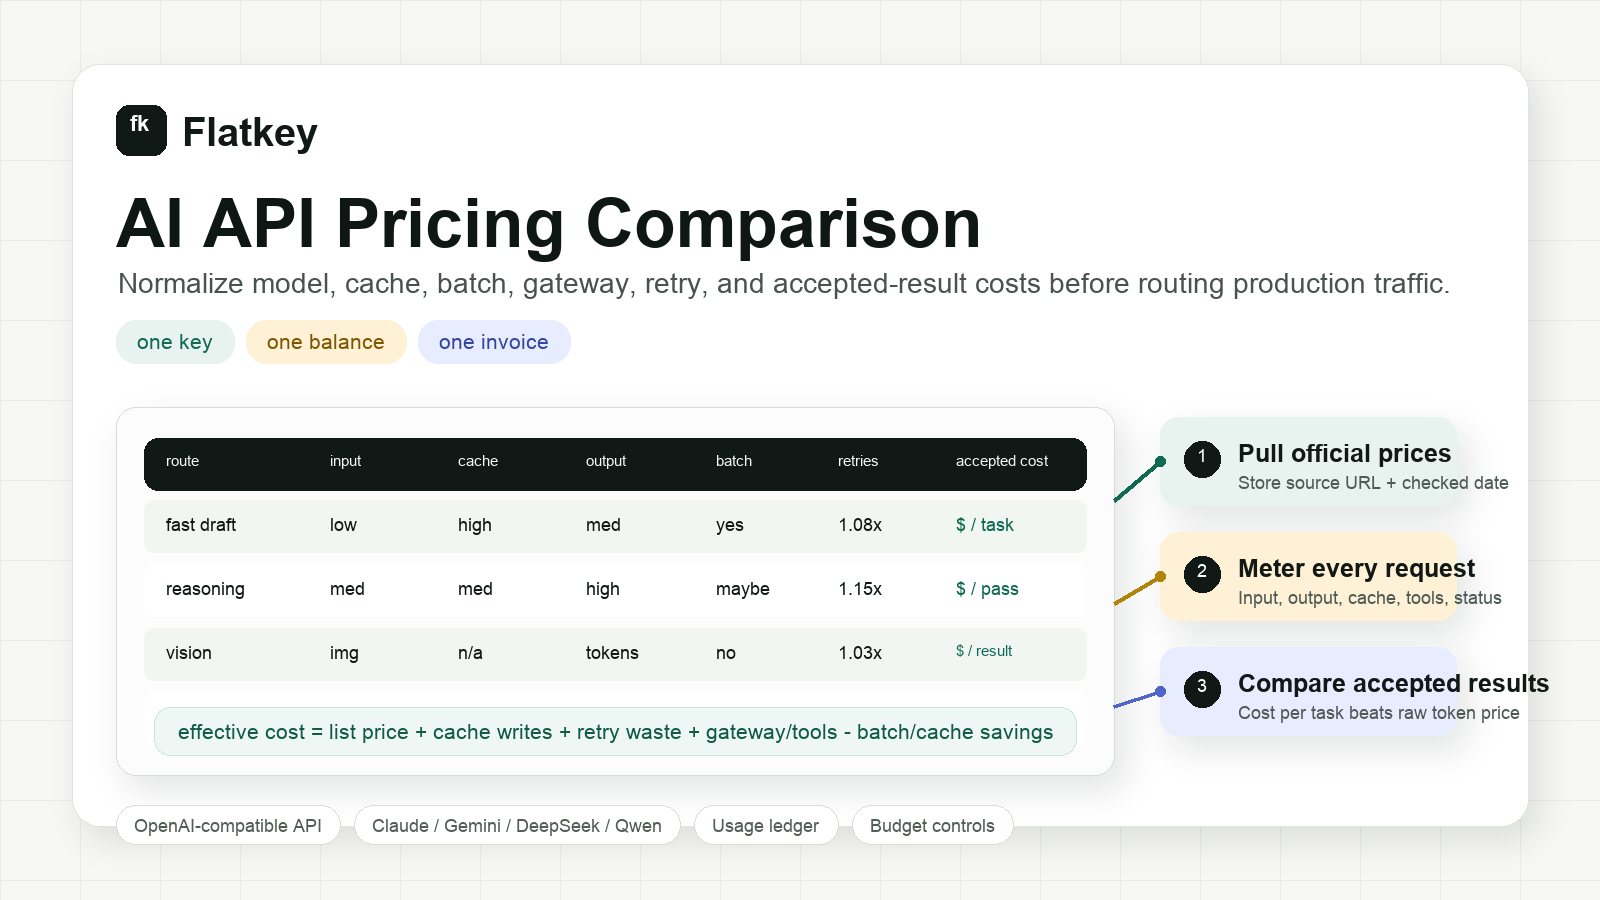
Este guia oferece a desenvolvedores, equipes de produto e equipes de compras um painel prático para comparar preços de modelos de IA em rotas de texto, imagem, vídeo e APIs de múltiplos provedores. A métrica durável não é a solicitação listada mais barata. É o custo por resultado aceito.
A Flatkey se encaixa nesse fluxo de trabalho porque oferece às equipes uma API key, um saldo pré-pago, uma fatura e um livro-razão de uso compartilhado em mais de 300 modelos oficiais e mais de 1.000 ferramentas pay-per-call. Você ainda precisa verificar os preços oficiais dos provedores, mas não precisa reconciliar cada experimento de contas separadas de fornecedores antes de tomar uma decisão de rota.
Estrutura rápida de comparação de preços de modelos de IA
Use esta estrutura antes de trocar de provedor, aprovar um orçamento maior para um modelo ou direcionar tráfego de produção por meio de um novo modelo.
| Camada de custo | Unidade de preço nativa | Normalizar para | Campo do painel |
|---|---|---|---|
| Chamadas de texto e agentes | Tokens de entrada, entrada em cache, tokens de saída, gravações de cache, trabalhos em lote, chamadas de ferramentas | Custo por resposta aceita ou tarefa concluída | accepted_task_cost_usd |
| Geração de imagens | Tokens do prompt, entrada de imagem, tokens de imagem de saída, imagens geradas, resolução, imagens aceitas | Custo por imagem aceita | accepted_image_cost_usd |
| Geração de vídeo | Segundos, clipes, resolução, tentativas na fila, trabalhos assíncronos com falha | Custo por clipe aceito ou por segundo de clipe aceito | accepted_clip_cost_usd |
| Fluxos de trabalho multimodais | Texto misto, arquivos, imagens, vídeo, ferramentas, novas tentativas, fallbacks | Custo por fluxo de trabalho concluído | workflow_cost_usd |
| Compras e governança | Chaves, faturas, exportações, orçamentos, listas de अनुमति, necessidades de auditoria | Custo para operar a rota com segurança | operating_cost_note |
A métrica executiva pode ser simples: custo por resultado aceito. O livro-razão de engenharia deve permanecer detalhado, porque a razão pela qual o custo mudou pode ser uma falha de cache, uma mudança no comprimento da saída, um aumento nas novas tentativas, um fallback de modelo ou uma menor taxa de aceitação do usuário.
Por que o preço de tabela é uma resposta incompleta
A linha mais barata de tokens pode se tornar a rota mais cara após o lançamento. Um modelo com preço baixo por token de entrada ainda pode perder se precisar de prompts mais longos, produzir respostas mais longas, perder oportunidades de cache, repetir tentativas com mais frequência ou fazer fallback para uma rota mais cara durante sobrecarga.
Os custos de mídia tornam o problema mais evidente:
- Um modelo de imagens pode parecer barato por geração e caro por imagem aceita se os usuários rejeitarem muitas saídas.
- Um modelo de vídeo pode parecer acessível por segundo e caro quando os usuários solicitam várias prévias antes de salvar um clipe.
- Um agente de programação ou pesquisa pode ter um modelo de chat barato, mas chamadas laterais caras de ferramentas, navegador, imagem ou enriquecimento.
- Uma conta direta de provedor pode ter um preço bruto do modelo mais baixo, mas um custo operacional maior se as compras precisarem de chaves separadas, faturas, exportações de uso e controles de orçamento.
É por isso que uma comparação de preços de modelos de IA deve preservar as unidades de preço nativas e depois normalizar cada rota para a economia de resultados aceitos.
Fontes de preços atuais para verificar
Os preços dos provedores mudam com frequência. Não copie uma tabela de tarifas uma vez e a trate como durável. Mantenha uma tabela de fontes com a URL oficial, a data de verificação, o ID do modelo ou da rota, a unidade e as observações.
| Fornecedor ou rota | Fonte oficial para consultar | Dimensões de preços a capturar | Observação no painel |
|---|---|---|---|
| OpenAI API | Preços da API da OpenAI | Entrada, entrada em cache, saída, modo em lote, fine-tuning, imagem, áudio, vídeo, processamento regional | Confirme o ID exato do modelo, o modo de atendimento e se o preço de lote se aplica. |
| Anthropic Claude API | Preços do Claude | Entrada, saída, cache de prompt, preço em lote, família de modelo, janela de contexto | O comportamento de gravação em cache e acerto de cache pode mudar materialmente a economia de agentes repetidos. |
| Google Gemini API | Preços da API Gemini | Camada gratuita ou paga, entrada, saída, cache, modo em lote, opções prioridade/flex, grounding de busca, mídia | Capture a família do modelo e o modo de atendimento, especialmente quando busca ou grounding estiver habilitado. |
| DeepSeek API | Preços da API DeepSeek | Falha no cache de entrada, acerto no cache de entrada, saída, horário de pico ou fora de pico, alias do modelo | Os logs de solicitação precisam de carimbo de data/hora e status de cache se os preços variarem por janela de tempo ou acerto de cache. |
| Alibaba Model Studio / Qwen | Modelos do Alibaba Model Studio | Família do modelo, modalidade, região, token ou unidade de mídia, ID do modelo no console | Verifique a página exata de detalhes do modelo e a região antes de colocar rotas Qwen em um orçamento. |
| Flatkey multi-provider API | Preços da Flatkey e Modelos da Flatkey | Rotas unificadas de modelo, um saldo, razão por solicitação, chamadas de ferramenta, faturas, orçamentos de subchave | Use para disponibilidade de rotas, governança multi-provider e comparação baseada em razão. |
Para cada linha de preços, armazene três campos obrigatórios: data verificada, ID do modelo ou rota e unidade. Um valor de dólar por token não é diretamente comparável a um dólar por imagem, dólar por segundo de vídeo ou valor pago por chamada de ferramenta.
O esquema do painel
Comece com um único razão de solicitações. Não divida o uso de texto, imagem, vídeo e ferramentas em sistemas financeiros desconectados.
{
  "request_id": "req_01j...",
  "workspace_id": "wk_product",
  "environment": "production",
  "feature": "creative_generator",
  "customer_id": "cus_123",
  "provider": "flatkey",
  "model_or_route": "example-route",
  "route_type": "image",
  "billing_unit": "output_image",
  "input_tokens": 1240,
  "output_tokens": 0,
  "cache_read_tokens": 0,
  "cache_write_tokens": 0,
  "tool_calls": 0,
  "images_generated": 4,
  "images_accepted": 1,
  "video_seconds_generated": 0,
  "video_seconds_accepted": 0,
  "retry_count": 1,
  "fallback_count": 0,
  "provider_cost_usd": 0.16,
  "gateway_or_platform_cost_usd": 0.00,
  "total_cost_usd": 0.16,
  "accepted_result": true,
  "latency_ms": 11800,
  "pricing_source_url": "https://provider.example/pricing",
  "pricing_checked_at": "2026-10-12"
}
Este esquema dá às finanças um número que elas podem reconciliar e dá à engenharia os campos necessários para explicar por que uma rota de modelo ficou mais barata ou mais cara.
Fórmulas de custo a usar
Chamadas de texto e de agente
Para rotas de texto, calcule primeiro o custo bruto da solicitação:
raw_text_cost =
  input_tokens * input_rate
+ output_tokens * output_rate
+ cache_write_tokens * cache_write_rate
+ cache_read_tokens * cache_read_rate
+ tool_call_costs
+ retry_and_fallback_costs
Depois normalize-o:
accepted_task_cost =
  sum(raw_text_cost for all attempts, retries, and fallbacks)
/ accepted_tasks
Se uma solicitação falhar e o usuário nunca receber uma resposta, não esconda isso. Acompanhe o custo de chamadas falhadas separadamente. Um painel de preços se torna útil quando torna visível o tráfego falho, repetido e com fallback.
Geração de imagens
O preço da API de imagem não é uma unidade universal. Alguns modelos expõem tokens de prompt e tokens de saída de imagem. Outros expõem por imagem, resolução, edição ou unidades específicas do provedor. Preserve a unidade nativa e normalize para imagens aceitas:
accepted_image_cost =
  (prompt_cost + input_image_cost + output_image_cost + retry_cost)
/ accepted_images
Acompanhe images_generated e images_accepted separadamente. Uma rota que gera quatro imagens para cada imagem aceita não deve ser comparada diretamente com uma rota em que os usuários aceitam uma de uma.
Geração de vídeo
O preço de vídeo precisa de duração, resolução e estado assíncrono do trabalho. Uma chamada de vídeo pode ficar na fila, falhar, ser cancelada, ser regenerada ou ser aceita mais tarde.
accepted_clip_cost =
  sum(video_seconds_generated * per_second_rate by resolution)
+ retry_cost
+ fallback_cost
+ storage_or_tool_costs
Para decisões de produto, acompanhe também:
accepted_clip_secondspreview_countregeneration_countfailed_job_counttime_to_first_preview_mstime_to_accepted_clip_ms
Um modelo de vídeo pode ser mais barato por unidade listada e ainda assim ser pior para o produto se os usuários gerarem novamente com o dobro da frequência.
Compare contas diretas de provedores com uma API multi-provedor
Contas diretas de provedores são suficientes quando uma família de modelos atende à maior parte da sua carga de trabalho e a cobrança separada é fácil de gerenciar. Uma API multi-provedor torna-se mais útil quando você precisa de comparação contínua de modelos, roteamento de fallback ou um único livro-razão entre vários provedores.
| Ponto de decisão | Contas diretas de provedores podem ser suficientes quando... | Uma API multi-provedor ajuda quando... |
|---|---|---|
| Escolha de modelo | Um provedor vence na maioria das tarefas. | Diferentes cargas de trabalho precisam de OpenAI, Claude, Gemini, DeepSeek, Qwen, rotas de imagem, vídeo e ferramentas. |
| Esforço de engenharia | Seu código já chama um provedor e raramente muda. | Você quer roteamento compatível com OpenAI e menos reescritas de integração. |
| Controle de custos | Uma fatura e um painel são aceitáveis. | Você precisa de orçamentos por subchave, listas de अनुमति de modelos e exportações de uso por requisição. |
| Compras | Contratos separados são administráveis. | Contratos duplicados, assentos ociosos e chaves de provedor espalhadas atrasam a equipe. |
| Confiabilidade | Quedas ocasionais do provedor são aceitáveis. | Você precisa de política de fallback e de um livro-razão compartilhado para o custo de retry e fallback. |
| Fluxos de trabalho de agentes | O app chama apenas modelos de texto. | Agentes chamam modelos, busca na web, ações no navegador, ferramentas de enriquecimento, imagens e vídeo. |
A Flatkey foi construída para a segunda coluna: uma chave de API, um saldo, uma fatura e um livro-razão de requisições entre várias rotas oficiais de modelos e ferramentas. Isso não substitui os preços oficiais dos provedores. Ele oferece à sua equipe um único lugar para roteirizar, medir, governar e reconciliar esses custos. Para a ótica de taxa de gateway e custo operacional, veja preços de gateway de IA.
Cinco exemplos de cargas de trabalho
1. Chat de suporte
O chat de suporte normalmente tem entrada moderada, saída curta e alto volume. Compare:
- Taxa de acerto do cache de prompt para prompts do sistema e texto de política.
- Orçamento de tokens de saída por tipo de პასუხa.
- Taxa de escalonamento para um modelo mais forte.
- Custo por conversa resolvida, não apenas custo por mensagem.
Para essa carga de trabalho, um modelo rápido mais barato pode vencer se mantiver a qualidade da resolução alta. Se o modelo mais barato aumentar a taxa de transferência ou de edição, a economia aparente de tokens desaparece.
2. Agente de codificação
Agentes de codificação geralmente têm grande contexto, chamadas de ferramentas, saída longa e múltiplas tentativas. Compare:
- Tamanho do contexto após busca no repositório ou leitura de arquivos.
- Instruções de projeto passíveis de cache.
- Número de chamadas de ferramentas por tarefa aceita.
- Desperdício de retries em rotas sobrecarregadas.
- Custo por alteração mesclada ou patch aceito.
É aqui que uma comparação de preços de modelos de IA precisa de um livro-razão. Uma única execução de agente pode incluir chamadas de modelo, chamadas de ferramentas, chamadas de fallback e tentativas falhadas.
3. Geração de respostas RAG
As cargas de trabalho RAG são dominadas pelo contexto recuperado e pelo comprimento da resposta. Compare:
- Número médio de tokens recuperados.
- Participação do prefixo estável do prompt.
- Comportamento de cache para documentos repetidos.
- Custos de citação ou grounding.
- Taxa de aprovação do avaliador para factualidade.
Não escolha um modelo apenas porque os tokens de entrada dele são baratos. Se ele precisar do dobro de contexto ou produzir respostas que falhem na avaliação, o custo da resposta aceita pode ser maior. Se esta for a principal questão de migração, use a planilha mais detalhada em como comparar preços de modelos de IA.
4. Classificação em lote
A classificação em lote muitas vezes pode tolerar resultados atrasados. Compare:
- Se o provedor tem um nível de batch, flex ou processamento atrasado.
- Tamanho máximo do lote e janela de conclusão.
- Custo de repetição de erro.
- Taxa de aprovação da validação do esquema de saída.
- Custo total por linha aceita.
Se um provedor oferece preço em lote mais baixo, a economia só se aplica quando seu fluxo de trabalho pode esperar e seu processo de retry é limpo.
5. Geração de imagens e vídeos
APIs de imagem e vídeo raramente se encaixam em uma planilha apenas de tokens. Compare:
- Unidade de saída: imagem, segundo, clipe, resolução, token ou crédito.
- Regras de cobrança por geração falhada.
- Taxa de edição e regeneração.
- Taxa de aprovação humana.
- Custo por ativo criativo aceito.
Para pipelines de mídia, mantenha modelos de tokens e modelos de geração em abas separadas da planilha e depois consolide-os no custo do fluxo de trabalho aceito. A economia unitária é diferente demais para uma única linha combinada.
Fluxo de trabalho de comparação de preços em sete etapas
- Congelar a carga de trabalho. Escolha uma família de tarefas real, como respostas de suporte, patches de agentes de codificação, respostas RAG, classificação em lote, geração de imagens ou geração de vídeos.
- Coletar preços oficiais atuais. Use páginas de preços dos fornecedores, páginas de modelos da Flatkey e uma data verificada. Evite tabelas de tarifas copiadas sem URLs de origem.
- Reproduzir o tráfego representativo. Use os mesmos prompts, entradas, limites de saída, política de ferramentas e validadores em todas as rotas.
- Registrar cada unidade faturável. Capture tokens de entrada, tokens em cache, tokens de saída, unidades de mídia, chamadas de ferramentas, tentativas de repetição, erros e status.
- Classificar os resultados aceitos. Use revisão humana, validadores automatizados ou verificações de aprovação/reprovação específicas da tarefa.
- Calcular o custo efetivo. Divida o custo total da rota pelos resultados aceitos, não pelo total de solicitações.
- Adicionar controles operacionais. Decida se a rota vencedora também atende aos limites de orçamento, necessidades de faturamento, governança de chaves, retenção de dados e fallback de incidentes.
O resultado é uma decisão de precificação que engenharia, produto e compras podem defender.
Visões mínimas do painel
Comparação de rotas
Mostre rotas de texto, imagem e vídeo em uma única tabela.
| Rota | Unidade nativa | Campo de custo nativo | Campo de aceitação | KPI normalizado |
|---|---|---|---|---|
| Modelo de texto | Tokens | Tokens de entrada, saída e cache | Resposta aceita | Custo por resposta aceita |
| Agente de codificação | Tokens mais ferramentas | Custos de tokens e ferramentas | PR mesclado, ticket resolvido, tarefa concluída | Custo por fluxo de trabalho concluído |
| Modelo de imagem | Unidades de imagem ou token | Imagens geradas, tokens de imagem de saída | Imagem aceita | Custo por imagem aceita |
| Modelo de vídeo | Segundos, clipes ou unidades do fornecedor | Segundos gerados por resolução | Clipe aceito | Custo por clipe aceito |
Orçamento por funcionalidade
Agrupe por funcionalidade, não apenas por fornecedor. Para equipes de produto, isso é mais útil do que uma fatura de fornecedor porque mostra se onboarding, chat, geração criativa, busca ou exportação está impulsionando os gastos.
Colunas sugeridas:
featureroute_typerequestsaccepted_resultsacceptance_ratetotal_cost_usdcost_per_accepted_resultp95_latency_msfallback_rateretry_rate
Desvio do fornecedor e do modelo
Todo fornecedor altera a disponibilidade do modelo, os preços e o status do ciclo de vida. Armazene:
- URL da fonte de preços.
- Data em que o preço foi verificado.
- Versão do modelo ou ID da rota.
- Tipo de unidade.
- Política de cache.
- Política de desconto em lote, se usada.
- Notas de descontinuação ou de ciclo de vida.
Isso mantém uma comparação de preços de modelos de IA útil após o lançamento, não apenas durante a seleção inicial do modelo.
Barreiras de margem
Adicione uma regra simples de margem a cada funcionalidade de IA:
max_ai_cost_per_customer_action =
  expected_revenue_per_action * target_ai_cost_percentage
Exemplo:
Se uma ação do cliente gera US$ 0,40 de margem bruta
e o custo de IA deve ficar abaixo de 20%,
então o orçamento da rota é de US$ 0,08 por resultado aceito.
Isso mantém a seleção do modelo vinculada ao negócio, e não a pontuações abstratas de benchmark.
Erros comuns
| Erro | O que fazer em vez disso |
|---|---|
| Comparar apenas taxas de tokens de entrada | Compare entrada, entrada em cache, saída, mídia, ferramentas, repetições e resultados aceitos. |
| Juntar texto, imagem, vídeo e ferramentas em uma única unidade | Preserve as unidades nativas e, em seguida, normalize cada rota para o custo por resultado aceito. |
| Ignorar o cache de prompts | Meça prefixes estáveis de prompt e a taxa de acerto do cache. |
| Ignorar a elegibilidade para processamento em lote | Separe cargas de trabalho sensíveis à latência e offline. |
| Confiar em tabelas de preços copiadas e desatualizadas | Armazene URLs oficiais de origem e datas verificadas. |
| Tratar o custo da gateway apenas como margem | Inclua governança, failover, exportações de uso, faturas e tempo de engenharia. |
| Escolher a solicitação mais barata | Escolha o resultado aceito mais barato que atenda aos requisitos de qualidade e confiabilidade. |
Perguntas frequentes
Qual é a melhor maneira de comparar preços de modelos de IA?
A melhor maneira de comparar preços de modelos de IA é preservar a unidade nativa de faturamento de cada fornecedor e, em seguida, normalizar cada rota para custo por resultado aceito. Para texto, isso pode ser custo por resposta aceita. Para imagens, use custo por imagem aceita. Para vídeo, use custo por clipe aceito ou por segundo de clipe aceito.
O que um gráfico de comparação de modelos de IA deve incluir?
Um gráfico de comparação de modelos de IA deve incluir o modelo ou ID da rota, o fornecedor, a URL da fonte de preços, a data verificada, tokens de entrada, entrada em cache, tokens de saída, unidades de mídia, chamadas de ferramentas, taxa de repetição, taxa de fallback, taxa de aceitação, latência e custo por resultado aceito.
As tabelas de preços devem incluir os preços exatos do fornecedor?
Use preços exatos na sua planilha interna, mas armazene a URL de origem e a data da verificação ao lado de cada linha. Artigos públicos estáticos devem evitar tabelas de tarifas copiadas sem fonte, porque os preços dos provedores, nomes de modelos, descontos e status de ciclo de vida podem mudar rapidamente.
Como você compara custos de tokens com custos de imagens e vídeos?
Não force todos os fluxos para tokens. Mantenha as unidades nativas no livro-razão e, em seguida, adicione campos normalizados como accepted_task_cost_usd, accepted_image_cost_usd e accepted_clip_cost_usd.
Onde a Flatkey ajuda na comparação de preços de modelos de IA?
A Flatkey ajuda quando você quer uma chave, um saldo, uma fatura e um livro-razão de uso para vários fluxos de modelos e ferramentas. Isso facilita a comparação de custos de texto, imagem, vídeo e agentes sem precisar conciliar primeiro contas separadas de provedores.
Com que frequência os preços devem ser verificados novamente?
Verifique os preços novamente antes de cada grande mudança de roteamento, revisão contratual ou previsão de orçamento. Para cargas de trabalho de produção em rápida mudança, atualize os preços dos fluxos críticos semanalmente e imediatamente após um provedor lançar, renomear, descontinuar ou reajustar o preço de um modelo que você usa.
Conclusão final
Uma comparação de preços de modelos de IA não é apenas uma tabela de preços mais bonita. É um sistema operacional para seleção de modelos.
Mantenha as unidades do provedor. Adicione rastreamento de aceitação. Normalize cada fluxo para custo por resultado aceito. Então escolha o fluxo que melhora a margem do produto, a confiabilidade e a governança, e não o fluxo que parece mais barato isoladamente.
Com a Flatkey, essa comparação pode viver em cima de uma chave, um saldo e um livro-razão, para que desenvolvedores, equipes de produto e equipes de compras possam sair de faturas dispersas de provedores para decisões de custo em nível de fluxo.