
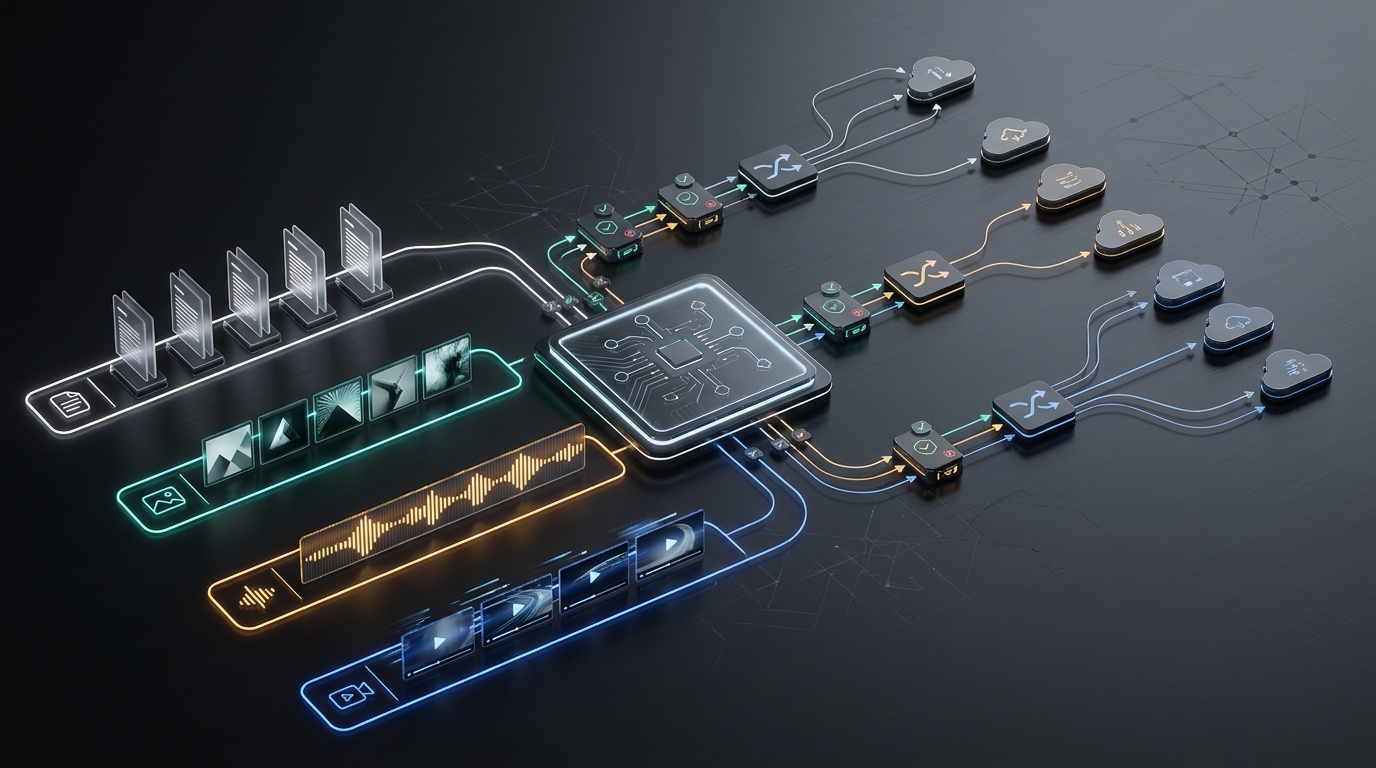
O roteamento de fallback para APIs de LLM é simples quando cada solicitação retorna texto. Se a rota principal expira, você tenta novamente uma vez, muda para um modelo de backup, valida o esquema e registra o motivo.
Essa lógica se desmancha quando o mesmo produto também roteia geração de imagens, transcrição de áudio, saída de fala e geração de vídeo. Um backup que é seguro para extração de JSON não é automaticamente seguro para imagens de marca. Um fallback de fala para texto não é a mesma coisa que um fallback de texto para fala. Um fallback de vídeo pode gerar gasto duplicado, confusão na fila ou uma saída que ainda precise de aprovação humana.
Este guia transforma Fallback Routing for LLM APIs: Multimodal Agent Routing for Text, Image, Audio, and Video em um playbook de implementação para equipes de produto de IA. O objetivo não é escolher um único modelo universal. O objetivo é tornar explícitos a escolha de rota, a verificação, o fallback e a análise de custo para cada modalidade com a qual seu agente interage.
Em 12 de setembro de 2026, as páginas públicas ao vivo da Flatkey enquadram o produto em torno de uma chave, um saldo, uma fatura, mais de 100 modelos oficiais de IA, mais de 1.000 ferramentas, configuração compatível com OpenAI, logs de uso e failover automático. As superfícies públicas de modelos e preços da Flatkey também expõem rotas de modelo voltadas para texto, imagem, áudio e vídeo. Considere essas páginas ao vivo como o checkpoint comercial atual antes da implementação, porque a disponibilidade dos modelos, os preços e a saúde das rotas podem mudar.
Resposta rápida: o que muda no roteamento de fallback multimodal?
Em sistemas somente de texto, o fallback normalmente faz uma pergunta: "Outra rota consegue produzir uma resposta equivalente?"
Em sistemas multimodais, o roteamento de fallback para APIs de LLM precisa fazer quatro perguntas:
- Qual artefato está sendo produzido? Texto, imagem, áudio e vídeo não compartilham um único padrão de qualidade.
- Como o artefato é verificado? Um analisador de JSON, um revisor visual, um verificador de transcrição e uma fila de aprovação de vídeo são sistemas de verificação diferentes.
- Qual falha é realmente recuperável? Limites de taxa, timeouts, entradas inválidas, rejeições de segurança e saídas de baixa qualidade exigem ações diferentes.
- O backup consegue preservar o contrato? Uma rota de fallback só é segura quando preserva a modalidade, a forma da saída, o orçamento de latência, o teto de custo e o caminho de revisão.
A regra prática é simples: o fallback permanece dentro da classe de fluxo de trabalho, a menos que uma camada humana ou de política aprove explicitamente a mudança.
Por que tentativas genéricas falham para texto, imagem, áudio e vídeo
Retries genéricos tratam toda solicitação com falha como um problema de transporte. Isso é superficial demais para o roteamento de agentes multimodais.
| Modalidade | Forma comum de falha | Por que a nova tentativa genérica é arriscada |
|---|---|---|
| Texto | Timeout, limite de taxa, falha do parser, incompatibilidade na chamada de ferramenta, resposta fraca | Tentar novamente pode ser seguro, mas trocar de modelo pode quebrar esquemas, citações, ferramentas ou tom. |
| Imagem | Bloqueio de segurança, proporção incorreta, incompatibilidade de marca, baixa fidelidade, baixa aderência à edição | Outro modelo de imagem pode retornar um arquivo válido que ainda assim falhe na revisão criativa. |
| Áudio | Formato não suportado, transcrição ruim, idioma incorreto, incompatibilidade de voz, pico de latência | Transcrição, tradução e saída de fala são tarefas separadas com regras de fallback separadas. |
| Vídeo | Fila longa, tarefa falhada, ativo expirado, movimento inconsistente, saída rejeitada e cara | Reenviar às cegas pode criar tarefas duplicadas, gasto duplicado e mais ativos para revisar. |
O roteador precisa saber se uma falha é um evento de serviço passível de nova tentativa, uma solicitação inválida, um resultado de segurança ou política, ou uma falha de qualidade. Essas categorias levam a ações diferentes.
Comece com classes de rota, não com nomes de modelo
O roteamento de fallback mais seguro para APIs de LLM começa com classes de rota. Os modelos podem entrar e sair de uma classe à medida que a disponibilidade e a qualidade mudam; a política do fluxo de trabalho deve permanecer estável.
| Classe de rota | Tarefas principais | Classe de verificação | Comportamento padrão de fallback |
|---|---|---|---|
| Raciocínio de texto | Extração, classificação, sumarização, programação, saída estruturada, chamadas de ferramenta | Verificações de esquema, testes do parser, amostragem por rubrica, sucesso da ferramenta | O fallback automático pode ser permitido quando a alternativa preserva a forma da resposta e o comportamento da ferramenta. |
| Compreensão visual | Análise de imagem, revisão de documentos, interpretação de captura de tela | Verificações de saída em texto mais cobertura da entrada visual | Fazer fallback para outra rota de raciocínio com capacidade visual, não para uma rota de geração de imagens. |
| Geração ou edição de imagens | Novas imagens, edições, variações de produtos, rascunhos criativos | QA visual, verificações de marca, revisão de modelo de prompt | Fazer fallback apenas para uma rota de imagem aprovada com proporção, estilo e regras de revisão correspondentes. |
| Entrada de áudio | Transcrição, tradução, resumos de reuniões, QA de chamadas | Verificações de precisão da transcrição, verificações de idioma, revisão de timestamps | Fazer fallback para outra rota de transcrição ou compreensão de áudio com os mesmos limites de entrada. |
| Saída de áudio | Síntese de fala, resposta de agente de voz, narração | QA de reprodução, política de voz, orçamento de latência | Fazer fallback para uma rota de voz aprovada; mantê-la separada do fallback de transcrição. |
| Geração de vídeo | Texto para vídeo, imagem para vídeo, clipes de pré-visualização, ativos criativos | Aprovação humana, verificações de duração/fidelidade, monitoramento da fila | Manter o fallback restrito; muitas vezes, falhar para revisão manual em vez de criar automaticamente outra tarefa. |
Este mapa de classes de rota evita um erro comum: tratar "modelo multimodal" como um único bloco de capacidades. Um modelo que aceita imagens para análise não gera necessariamente imagens. Um modelo que entende áudio não é automaticamente um modelo de voz de produção. Um modelo que consegue produzir um vídeo em uma demo não é automaticamente seguro para automação voltada ao cliente.
Use uma matriz de decisão de fallback antes de escrever código
Uma matriz de decisão oferece a produto, engenharia e operações uma política compartilhada. Comece com a matriz abaixo e substitua os exemplos pelos seus próprios modelos, provedores e regras de aprovação.
| Condição | Ação de texto | Ação de imagem | Ação de áudio | Ação de vídeo |
|---|---|---|---|---|
| Timeout da rota primária antes do início da saída | Repetir dentro do orçamento e, em seguida, fazer fallback para a rota de texto aprovada | Repetir uma vez se nenhum asset tiver sido criado e, em seguida, fazer fallback para a rota de imagem aprovada | Repetir ou fazer fallback dentro do mesmo tipo de job de áudio | Verifique primeiro o estado da tarefa; não crie um job duplicado até que o estado original seja conhecido. |
| Erro de limite de taxa ou capacidade | Fazer fallback quando o backup atender aos limites de esquema e custo | Fazer fallback quando o backup atender aos limites de prompt, tamanho e revisão | Fazer fallback quando o backup suportar o mesmo formato de arquivo e idioma | Fazer fallback somente se o custo duplicado e o comportamento da fila forem aceitáveis. |
| Solicitação inválida ou entrada sem suporte | Pare e corrija a solicitação | Pare e corrija o prompt, o tipo de entrada, o tamanho ou o aspecto | Pare e corrija o formato de mídia, a duração, o idioma ou a taxa de amostragem | Pare e corrija a duração, a mídia de referência, o prompt ou os campos do endpoint. |
| Rejeição por segurança ou política | Não esconda a rejeição com fallback | Não contorne a política com outro modelo | Não contorne a política com outro provedor de áudio | Não contorne a política com outro provedor de vídeo. |
| A saída falha na verificação automatizada | Fazer fallback se o contrato puder ser verificado por máquina | Enviar para revisão visual ou regenerar sob a política de rota aprovada | Enviar para revisão de transcrição/reprodução ou fazer fallback dentro do mesmo tipo de job | Enviar para revisão humana; use regras de regeneração, não failover cego. |
| A saída de streaming parcial já chegou ao usuário | Normalmente pare e reconcilie; evite troca transparente de modelo | Não se aplica à maioria das rotas de imagem | Pare e reconcilie o estado visível ao usuário | Não troque de forma invisível depois que existir um estado de job visível. |
| Uma chamada de ferramenta pode ter criado efeitos colaterais | Reconcilie a idempotência antes de repetir ou fazer fallback | Reconcilie quaisquer gravações de asset/storage | Reconcilie o estado de transcrição, chamada ou sessão de voz | Reconcilie primeiro o ID da tarefa, o armazenamento, o faturamento e o estado de aprovação. |
Esta matriz é o principal ativo de valor do artigo. Ela transforma o roteamento de fallback para APIs de LLM de uma reflexão tardia de engenharia em uma política que pode ser revisada antes que o tráfego de produção seja movido.
Uma arquitetura de referência para roteamento de agentes multimodais
Um roteador de produção não precisa ser complicado, mas precisa ter limites claros.
flowchart LR
    A[Solicitação do agente] --> B[Classificar fluxo de trabalho]
    B --> C[Selecionar rota primária]
    C --> D[Chamar provedor ou gateway]
    D --> E[Verificar artefato]
    E -->|pass| F[Retornar e registrar]
    E -->|retryable failure| G[Política de fallback]
    E -->|policy or invalid input| H[Parar com erro acionável]
    G --> I[Rota de backup aprovada]
    I --> D
    G --> J[Revisão humana ou fila manual]
As partes principais são:
- Classificador de fluxo de trabalho: identifica a tarefa como texto, visão, geração de imagem, entrada de áudio, saída de áudio ou geração de vídeo antes da seleção da rota.
- Registro de capacidades: registra quais rotas suportam cada modalidade, endpoint, formato de entrada, formato de saída, contexto máximo, comportamento de streaming e classe de custo.
- Política de fallback: define erros recuperáveis, backups permitidos, regras anti-bypass e número máximo de tentativas.
- Camada de verificação: verifica o artefato antes de devolvê-lo ao usuário ou encaminhá-lo adiante.
- Livro-razão e observabilidade: registra modelo, rota, proprietário, status, motivo do fallback, latência, uso, custo e resultado da revisão.
O Flatkey pode ficar na camada de provedor ou gateway quando uma equipe quer um roteador compatível com OpenAI, um saldo compartilhado e um único lugar para revisar as rotas de modelos suportadas. Sua aplicação ainda é responsável pela política: qual classe de modalidade pode fazer fallback, quando parar e quando um humano deve decidir.
Defina a política como dados
Mantenha a política de roteamento fora de instruções if espalhadas. Um pequeno objeto de dados é mais fácil de revisar e mais seguro de alterar.
{
  "workflow": "support_ticket_with_screenshot",
  "route_class": "vision_understanding",
  "primary_model": "primary-vision-reasoning-route",
  "fallback_models": ["backup-vision-reasoning-route"],
  "fallback_on": ["timeout_before_output", "rate_limit", "upstream_5xx"],
  "do_not_fallback_on": ["safety_rejection", "invalid_input", "partial_stream_sent"],
  "verification": {
    "type": "structured_text",
    "required_fields": ["summary", "severity", "evidence"]
  },
  "max_attempts": 2,
  "max_incremental_cost_usd": 0.05,
  "log_fields": [
    "request_id",
    "workspace_id",
    "route_class",
    "model",
    "fallback_reason",
    "latency_ms",
    "cost_usd",
    "verification_status"
  ]
}
A mesma estrutura pode representar fluxos de trabalho de mídia:
{
  "workflow": "product_video_preview",
  "route_class": "video_generation",
  "primary_model": "primary-video-route",
  "fallback_models": ["approved-video-preview-route"],
  "fallback_on": ["provider_5xx", "capacity_unavailable"],
  "do_not_fallback_on": ["client_timeout_without_task_state", "safety_rejection", "asset_created"],
  "verification": {
    "type": "human_review",
    "checks": ["duration", "motion", "brand_safety", "reference_consistency"]
  },
  "max_attempts": 1,
  "manual_queue_after_failure": true
}
Observe a diferença: a política de texto frequentemente pode fazer fallback automaticamente porque o resultado pode ser verificado por máquina. A política de vídeo é mais restrita porque uma segunda geração não é apenas uma nova tentativa; é outro artefato e outro evento de custo.
Regras de fallback por modalidade
Texto: preserve o contrato de resposta
Texto é o ponto mais fácil para começar porque a verificação pode ser automatizada. Para roteamento de fallback para APIs de LLM, um backup de texto deve preservar:
- estrutura do endpoint;
- estrutura do evento de streaming, se usado;
- comportamento de JSON ou de saída estruturada;
- comportamento de chamadas de ferramenta;
- requisitos de citação ou recuperação;
- teto de latência;
- teto de custo.
O erro é fazer fallback de uma rota previsível de saída estruturada para um modelo mais criativo que soa melhor, mas quebra o parsing downstream. Se a rota atende automação de produto, a estabilidade do parser importa mais do que o estilo da prosa.
Visão: separe compreensão de imagem de geração de imagem
Trabalhos de visão frequentemente produzem texto sobre uma imagem. Trabalhos de geração de imagem produzem um novo artefato visual. Eles não devem compartilhar o mesmo bucket de fallback.
OpenAI, Google Gemini e Anthropic documentam capacidades de API de compreensão de imagem ou relacionadas a imagem, mas essas documentações descrevem superfícies de solicitação e comportamentos de modelo diferentes. Para roteamento de agentes multimodais, a questão de política não é simplesmente "esta rota consegue lidar com imagens?" É "esta rota lida com este trabalho de imagem com as mesmas restrições de entrada e o mesmo contrato de saída?"
Por exemplo, um fluxo de triagem de capturas de tela pode precisar de uma rota de raciocínio com capacidade de visão que retorne texto estruturado. Um fluxo criativo de marca precisa de uma rota de geração de imagem que retorne um arquivo e passe por revisão visual. Essas são classes de rota separadas.
Geração de imagem: não contorne a revisão criativa
O fallback de imagem deve proteger o contrato criativo:
- proporção;
- resolução ou classe de tamanho;
- edição versus geração totalmente nova;
- compatibilidade com template de prompt;
- revisão de marca e conformidade;
- armazenamento e ciclo de vida do asset;
- custo por asset aceito.
Se a rota primária de imagem falhar porque a entrada é inválida, fallback é a decisão errada. Corrija a solicitação. Se falhar porque o provedor está temporariamente indisponível antes de qualquer asset ser criado, o fallback pode ser razoável quando a rota de backup já tiver passado pela QA visual.
Áudio: separe transcrição, compreensão e fala
O roteamento de áudio frequentemente esconde três trabalhos diferentes:
- Speech-to-text: converter áudio em transcrição.
- Audio understanding: raciocinar sobre o conteúdo do áudio, a intenção do locutor ou o contexto da reunião.
- Text-to-speech: gerar saída falada.
Essas tarefas têm diferentes modos de falha. Um fluxo de transcrição pode ser avaliado por taxa de erro de palavras, vocabulário do domínio, etiquetas de locutor, timestamps e latência. Um fluxo de fala é avaliado por qualidade de voz, pronúncia, latência, política de vozes permitidas e experiência de reprodução.
O fallback deve permanecer dentro do tipo específico de tarefa de áudio. Não use "capaz de áudio" como um único rótulo de política.
Vídeo: trate o fallback como outro evento de produção
Vídeo geralmente é a modalidade de maior risco para fallback automático porque uma solicitação com falha ou lenta talvez já tenha criado uma tarefa do lado do provedor. Antes de criar outra tarefa, seu sistema deve saber:
- se a tarefa original existe;
- se ela está na fila, em processamento, concluída com sucesso, com falha ou expirada;
- se uma URL de saída foi criada;
- se algum uso ou custo foi registrado;
- se um revisor já viu o ativo;
- se uma segunda geração violaria o orçamento ou o fluxo de aprovação.
Para geração de vídeo, um padrão seguro é: tentar novamente apenas o transporte antes de uma tarefa existir, consultar a tarefa existente até o estado terminal e, então, usar um caminho de regeneração manual ou estritamente aprovado.
O que registrar quando o fallback acontece
Fallback que fica invisível nos logs se torna impossível de melhorar. No mínimo, cada solicitação deve registrar:
| Campo | Por que importa |
|---|---|
request_id |
Vincula o comportamento visível ao usuário às evidências do provedor e do gateway. |
route_class |
Mostra se a tarefa era de texto, visão, imagem, áudio ou vídeo. |
primary_model e final_model |
Revela qual rota respondeu ou produziu o artefato. |
fallback_reason |
Distingue timeout, limite de taxa, erro upstream, falha de verificação ou override manual. |
attempt_count |
Evita loops de repetição sem limite. |
latency_ms |
Mostra se o fallback ajudou ou prejudicou a experiência do usuário. |
usage e cost |
Torna visível a economia da rota de backup. |
verification_status |
Conecta o fallback à qualidade da saída, não apenas ao sucesso da API. |
reviewer_outcome |
Necessário para o acompanhamento de aprovação de imagem, áudio e vídeo. |
Para equipes de produto de IA, a métrica mais útil muitas vezes não é o uptime bruto. É a taxa de saída aceita após o fallback. Uma rota de backup que responde rapidamente, mas produz ativos rejeitados, não é confiável em termos de produto.
Onde a Flatkey se encaixa
Flatkey é relevante para o roteamento de fallback para APIs de LLM porque a dor operacional é maior do que uma única chamada de API. Produtos multimodais frequentemente acumulam chaves específicas de provedores, contas de faturamento diretas, IDs de modelos dispersos, tratamento inconsistente de erros e painéis separados para experimentos de texto, imagem, áudio e vídeo.
Os documentos públicos e o site da Flatkey oferecem às equipas um único URL de router compatível com OpenAI para chamadas de modelos suportados, um catálogo de modelos, registos de utilização, um saldo único e uma superfície única de faturação. O site em tempo real também enquadra a fiabilidade em torno de failover automático e superfícies públicas de estado/SLA. Isso não elimina a necessidade da sua própria política de modalidade. Dá à política um único local para operar, em vez de espalhar a escolha de rota pelo código das funcionalidades.
Use a Flatkey quando quiser:
- um único endpoint de router ao comparar rotas de modelos suportados;
- um único local para verificar a disponibilidade do modelo e o contexto comercial;
- um único saldo e fatura em vez de contas de fornecedores dispersas;
- registos de utilização para modelo, tokens, custo, latência e revisão do proprietário;
- governação de rotas à medida que mais agentes e fluxos de trabalho adotam APIs de IA.
Use contas diretas de fornecedores quando um único fornecedor for o único requisito, a carga de trabalho não precisar de fallback e a via mais simples do fornecedor for mais importante do que o controlo entre modelos.
Lista de verificação de implementação para roteamento de fallback para APIs de LLM
Antes de ativar o fallback automático num produto multimodal, conclua esta lista de verificação:
- Inventarie as modalidades. Liste cada fluxo de trabalho que gera texto, analisa imagens, gera imagens, aceita áudio, fala ou gera vídeo.
- Atribua classes de rota. Não deixe que um único rótulo "multimodal" cubra diferentes tipos de artefactos.
- Defina a verificação. Cada classe de rota precisa de um método de aprovado/reprovado antes de o fallback poder ser considerado fiável.
- Separe retry de fallback. Retry repete a mesma rota. Fallback muda a rota. A regeneração cria um novo artefacto.
- Escreva regras anti-bypass. Rejeições de segurança, entradas inválidas, efeitos colaterais e saídas parciais visíveis não devem fazer fallback silenciosamente.
- Defina tetos de custo. Um fallback que salva a solicitação, mas rompe o orçamento, ainda assim falhou para o produto.
- Registe a decisão de rota. Armazene a rota primária, a rota final, o motivo da falha, o custo, a latência e o resultado da verificação.
- Teste a injeção de falhas. Simule timeouts, limites de taxa, erros 5xx, entradas inválidas, falhas de parsing, imagens rejeitadas, transcrições incorretas e trabalhos de vídeo lentos.
- Comece com um fluxo de trabalho de baixo risco. Não ative fallback entre modalidades em todo o produto de uma só vez.
- Revise semanalmente a taxa de saídas aceites. Otimize para resultados utilizáveis, não apenas para respostas HTTP bem-sucedidas.
Esta é a diferença entre roteamento de fallback fiável para APIs de LLM e novas tentativas cegas entre rotas incompatíveis.
Perguntas frequentes
O que é roteamento de fallback para APIs de LLM?
Roteamento de fallback para APIs de LLM é a política que decide quando uma rota de modelo falhada, degradada ou indisponível deve tentar novamente, mudar para uma reserva aprovada, parar com um erro acionável ou passar para revisão humana.
Porque é que o roteamento de agentes multimodais é mais difícil do que o roteamento apenas de texto?
O roteamento de agentes multimodais é mais difícil porque as saídas de texto, imagem, áudio e vídeo têm métodos de verificação, curvas de custo, expectativas de latência e riscos de revisão diferentes. Uma regra genérica de fallback não consegue cobrir com segurança os quatro casos.
Uma única API gateway pode tratar texto, imagem, áudio e vídeo?
Sim, um único gateway pode centralizar o acesso e a revisão de uso em todas as rotas suportadas. A aplicação ainda precisa de classes de rota separadas e políticas de fallback para cada modalidade e fluxo de trabalho.
Quando o fallback deve ser automático?
O fallback automático é mais seguro quando o contrato de saída pode ser verificado por máquina, a rota de backup já foi testada, nenhuma saída parcial chegou ao usuário, não há efeitos colaterais incertos e o backup permanece dentro dos limites de latência e custo.
Quando o fallback deve permanecer manual?
O fallback deve permanecer manual quando o artefato exigir revisão subjetiva, a solicitação possa ter criado efeitos colaterais, o custo de trabalho duplicado for alto ou tenha ocorrido uma rejeição por política/segurança. A geração de vídeo e a geração de imagens sensíveis à marca muitas vezes pertencem a essa categoria.
Repetir é o mesmo que fazer fallback?
Não. Retry envia a mesma solicitação para a mesma rota novamente. O fallback muda a rota. A regeneração cria um novo artefato. Trate esses casos como ações de política separadas, porque têm implicações diferentes de custo e qualidade.
Como as equipes devem medir a qualidade do fallback?
Meça taxa de sucesso, taxa de fallback, latência, custo incremental, falhas de parser, aceitação do revisor, taxa de saída rejeitada e taxa de saída aceita após o fallback. HTTP 200 é apenas o começo da medição.
Construa a política de roteamento antes da próxima mudança de modelo
O motivo mais forte para formalizar o roteamento de fallback para APIs de LLM é que o acesso aos modelos muda mais rápido do que a arquitetura da aplicação. Novas rotas de texto, imagem, áudio e vídeo continuarão surgindo. Algumas desaparecerão, ficarão mais lentas, mudarão de preço ou se comportarão de forma diferente sob carga.
Se o seu produto tiver classes de rota, regras de verificação, limites de custo e decisões de fallback observáveis, adicionar ou remover um modelo é uma atualização controlada de política. Se a sua lógica de roteamento estiver escondida no código de funcionalidades, cada mudança de modelo se torna um risco de migração.
Comece com um fluxo de trabalho contido, defina sua modalidade e classe de verificação, teste backups aprovados e então expanda. Quando estiver pronto para centralizar o acesso e a cobrança em todas as rotas suportadas, use o quickstart da API Flatkey, revise o fluxo de trabalho da API unificada de IA e compare a disponibilidade atual dos modelos no diretório de modelos da Flatkey.


