
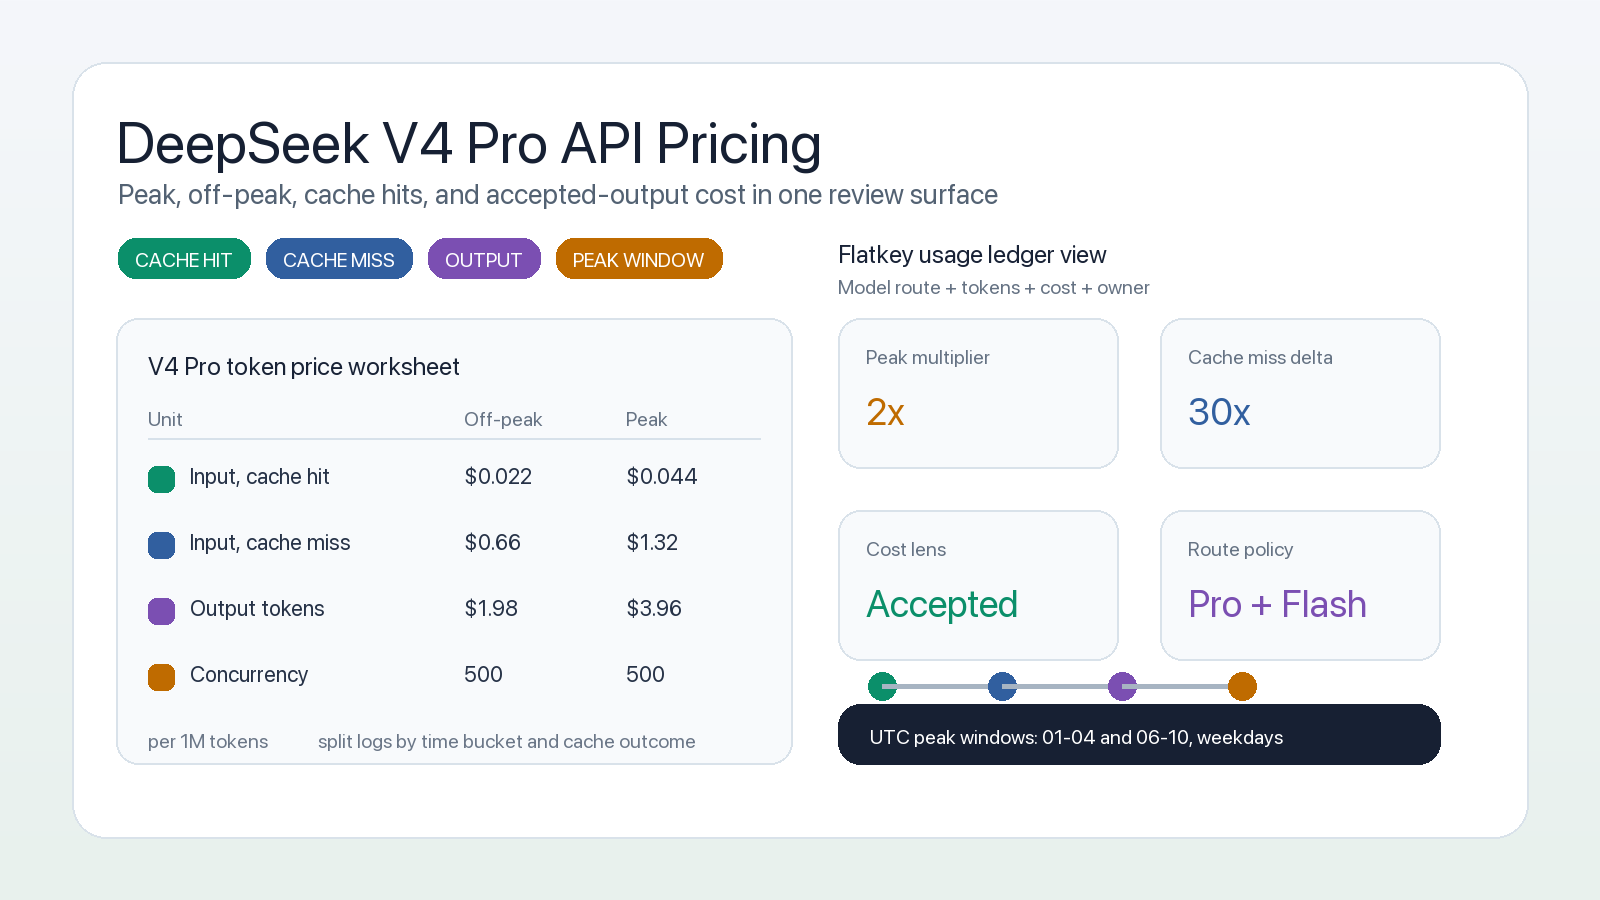
Wenn Sie die deepseek v4 pro api pricing für ein Produktbudget prüfen, bleiben Sie nicht beim beworbenen Output-Token-Preis stehen. Die Preise für DeepSeek V4 Pro ändern sich durch drei Variablen, die die Rechnung stärker beeinflussen, als die meisten Teams erwarten: ob die Anfrage in Spitzen- oder Nebenzeiten landet, ob Eingabe-Tokens Cache-Hits oder Cache-Misses sind und wie viel Output Ihr Workflow tatsächlich akzeptiert.
Stand der offiziellen DeepSeek-Preisseite, geprüft am 11. Oktober 2026, wird deepseek-v4-pro als DeepSeek-V4-Pro-0813 mit einem Kontextfenster von 1 Mio. Tokens, einem maximalen Output von 384K, API-Unterstützung im OpenAI-Format und Anthropic-Format sowie separaten Preisen für Cache-Hit-Input, Cache-Miss-Input und Output-Tokens aufgeführt. Auf der Update-Seite von DeepSeek steht außerdem, dass der V4-Pro-API-Dienst nach dem 14. September 2026 mit unverändertem Abrechnungsmodell weiterläuft, daher sollten Teams die aktuelle Pro-Tabelle als aktiv und nicht als nur vorübergehenden Übergangsweg behandeln.
Die praktische Konsequenz: deepseek v4 pro api pricing ist nur dann vorhersehbar, wenn Ihr Spreadsheet Spitzenverkehr, Nebenverkehr, Cache-Hit-Rate, Output-Länge, Retries und akzeptierte Ergebnisse getrennt erfasst. Dieser Leitfaden liefert Ihnen die aktuelle Preistabelle, die Kostenformel und die Stellschrauben, mit denen die Ausgaben für DeepSeek V4 Pro sichtbar bleiben, bevor sie zu einer Überraschung für die Finanzabteilung werden.
DeepSeek V4 Pro API-Preise in einer Tabelle
DeepSeek berechnet seine API in Einheiten von 1 Million Tokens. Die aktuelle Tabelle weist diese DeepSeek-V4-Pro-Tarife aus:
| Preis-Einheit | Nebenzeitpreis pro 1 Mio. Tokens | Spitzenpreis pro 1 Mio. Tokens | Was zu verfolgen ist |
|---|---|---|---|
| Input-Tokens, Cache-Hit | $0.022 | $0.044 | Wiederverwendete Prompt-Präfixe, die DeepSeek-Kontext-Caching treffen |
| Input-Tokens, Cache-Miss | $0.66 | $1.32 | Neuer oder nicht wiederverwendeter Prompt-Kontext |
| Output-Tokens | $1.98 | $3.96 | Modellantworten, reasoning-lastige Antworten, generierter Code und Agentenpläne |
| Parallelitätsgrenze | 500 | 500 | Planung paralleler Anfragen und Backpressure |
DeepSeek definiert Spitzenzeiten als 01:00–04:00 und 06:00–10:00 UTC, Montag bis Freitag, unter Ausschluss chinesischer Feiertage. Alle anderen Zeiten sind Nebenzeiten, einschließlich Wochenenden und vollständiger chinesischer Feiertage. Das bedeutet, dass derselbe Workload in einem Spitzenfenster doppelt so viel kosten kann.
Zum Vergleich: Die aktuelle Flash-Tabelle von DeepSeek ist günstiger:
| Modell | Cache-Hit-Input, Nebenzeit/Spitze | Cache-Miss-Input, Nebenzeit/Spitze | Output, Nebenzeit/Spitze | Parallelität |
|---|---|---|---|---|
deepseek-v4-pro |
$0.022 / $0.044 | $0.66 / $1.32 | $1.98 / $3.96 | 500 |
deepseek-flash |
$0.003 / $0.006 | $0.15 / $0.30 | $0.60 / $1.20 | 2500 |
Das bedeutet nicht, dass jedes Team alles auf Flash umleiten sollte. Es bedeutet, dass DeepSeek V4 Pro API pricing eine Entscheidung auf Workload-Ebene erfordert. Verwenden Sie Pro dort, wo Qualität, Langkontext-Verhalten oder komplexe Ausgaben von Coding-Agents den Preis rechtfertigen. Verwenden Sie Flash dort, wo Latenz, Parallelität, Vision-Support oder einfache Kostenkontrolle wichtiger sind.
Für den breiteren Anbieter-Vergleich halten Sie den kanonischen Leitfaden zu DeepSeek API pricing neben diesem Pro-spezifischen Arbeitsblatt geöffnet.
Die Kostenformel, die der Einkauf tatsächlich verwenden sollte
Die einfache Formel lautet:
request_cost =
  cache_hit_input_tokens / 1,000,000 * cache_hit_price
+ cache_miss_input_tokens / 1,000,000 * cache_miss_price
+ output_tokens / 1,000,000 * output_price
Für die monatliche Planung teilen Sie diese Formel in Spitzen- und Nebenzeit-Blöcke auf:
monthly_cost =
  off_peak_cache_hits * 0.022 / 1,000,000
+ off_peak_cache_misses * 0.66 / 1,000,000
+ off_peak_output_tokens * 1.98 / 1,000,000
+ peak_cache_hits * 0.044 / 1,000,000
+ peak_cache_misses * 1.32 / 1,000,000
+ peak_output_tokens * 3.96 / 1,000,000
Hier ist die nützliche Version als Arbeitsblatt:
| Feld | Beispielwert zum Erfassen | Warum sich die Rechnung ändert |
|---|---|---|
| Workload-Name | Coding-Agent, RAG-Antwort, Batch-Review | Unterschiedliche Jobs haben unterschiedliche Output-Längen und Retry-Verhalten |
| Zeitslot | Spitze oder Nebenzeit | Spitzenpreise sind doppelt so hoch wie Nebenzeitpreise |
| Input-Tokens | 80.000 pro Anfrage | Großer Kontext verstärkt die Kosten von Cache-Misses |
| Cache-Hit-Rate | 60 % der Input-Tokens | Cache-Hits sind deutlich günstiger als Cache-Misses |
| Output-Tokens | 12.000 pro akzeptiertem Ergebnis | Pro-Output ist in vielen Agent-Workflows der dominierende Kostenfaktor |
| Retry-Rate | 8 % | Retries vervielfachen sowohl Input- als auch Output-Kosten |
| Akzeptanzrate | 70 % | Abgelehnte oder ungenutzte Generierungen kosten trotzdem Geld |
| Fallback-Pfad | Flash, Qwen, Claude, GPT oder keiner | Fallback kann Vorfälle abfedern, aber zusätzliche Aufrufe verursachen |
| Verantwortlicher | Team, Produkt, Kunde oder Umgebung | Wird für Showback, Chargeback und Kontingentpolitik benötigt |
Hier kommt auch Flatkey in den Workflow. Flatkey gibt Teams einen API-Schlüssel, ein Guthaben, eine Rechnung und ein Nutzungsprotokoll über offizielle Modellrouten hinweg, sodass Engineering und Finance die Kosten für DeepSeek V4 Pro neben anderen Modellausgaben prüfen können, statt jedes Anbieter-Konto separat abzugleichen.
Warum Cache-Hits wichtiger sind als der beworbene Preis
DeepSeek-Kontext-Caching ist für API-Nutzer standardmäßig aktiviert. Eine spätere Anfrage kann Cache-Hit-Preise erhalten, wenn sie vollständig mit einer gespeicherten Cache-Prefix-Einheit übereinstimmt. DeepSeek beschreibt Prefix-Einheiten als an Anfragegrenzen, aus erkannten gemeinsamen Präfixen sowie in festen Token-Intervallen für lange Eingaben oder Ausgaben persistiert.
Das ist wichtig, weil die DeepSeek V4 Pro Cache-Hit-Eingabe deutlich günstiger ist als die Cache-Miss-Eingabe:
| Zeitscheibe | Cache-Hit-Eingabe | Cache-Miss-Eingabe | Unterschied |
|---|---|---|---|
| Nebenzeiten | $0.022 / 1M | $0.66 / 1M | Cache-Miss ist 30x höher |
| Spitzenzeiten | $0.044 / 1M | $1.32 / 1M | Cache-Miss ist 30x höher |
Wenn sich Ihre Prompts mit stabilen Systemanweisungen, Tool-Manifests, Schema-Definitionen, Codebasis-Zusammenfassungen oder Retrieval-Preambles wiederholen, kann die Cache-Hit-Rate wichtiger sein als eine kleine Änderung der Ausgabelänge. Wenn jede Anfrage mit einem anderen Präfix ankommt, sollte Ihr Plan von Cache-Miss-Preisen ausgehen, bis Logs das Gegenteil belegen.
Für Teams, die Agents betreiben, ist die Best Practice einfach:
- Stabile System-Prompts und Tool-Schemata am Anfang des Kontexts halten.
- Lange, wiederverwendbare Instruktionsblöcke versionieren, statt sie bei jedem Lauf neu zu schreiben.
- Cache-Hit- und Cache-Miss-Eingabetokens separat verfolgen.
- Die DeepSeek V4 Pro API-Preise nach akzeptierter Aufgabe vergleichen, nicht nur nach rohem Token.
- Die offizielle Preisseite erneut prüfen, bevor eine Route mit hohem Volumen geändert wird.
Für verwandte Methoden lesen Sie den Leitfaden zum Prompt-Caching-Workflow und den Leitfaden zum AI-API-Ausgabenmanagement.
Spitzenzeiten versus Nebenzeiten planen
DeepSeeks Nebenzeiten-Richtlinie schafft einen einfachen Hebel für die Planung. Interaktiver Produktverkehr muss dann laufen, wenn Nutzer ihn benötigen. Batch-Auswertungen, Repository-Scans, Data-Label-Reviews und nächtliche Agent-Jobs können oft verschoben werden.
Verwenden Sie diese Routing-Regel:
| Workload-Typ | Empfohlene Kostenrichtlinie |
|---|---|
| Chat oder Coding-Assistent mit Nutzerkontakt | Latenz priorisieren, aber maximale Ausgabe und Anzahl der Wiederholungen begrenzen |
| Hintergrund-Evals | In Nebenzeiten planen, sofern der Release-Zeitpunkt keine Ausführung in Spitzenzeiten erfordert |
| Dokumentenanalyse mit langem Kontext | In Nebenzeiten verlagern und Cache-Wiederverwendung maximieren |
| CI-Agent-Review | Nur geänderte Dateien über Pro laufen lassen; einfache Prüfungen an Flash routen |
| Procurement-Benchmark | Eine repräsentative Mischung in sowohl Spitzen- als auch Nebenzeiten-Buckets ausführen |
Das geht nicht nur darum, den Token-Preis zu halbieren. Der größere Vorteil ist die Vorhersagbarkeit. Wenn Teams wissen, welche DeepSeek V4 Pro Jobs in Spitzenzeiten laufen dürfen, kann Finance die Worst-Case-Rechnung prognostizieren und Engineering Pro für Arbeiten reservieren, die ihn wirklich brauchen.
Flatkey kann dieses Betriebsmodell unterstützen, indem die Routing-Entscheidung, die Modellrichtlinie und die Nutzungsprüfung an einem Ort gehalten werden, statt Umgebungsvariablen über Repos zu verteilen.
Wann DeepSeek V4 Pro den höheren Preis wert ist
Die DeepSeek V4 Pro API-Preisgestaltung ergibt Sinn, wenn der Workload wertvoll genug ist, um die Pro-Route zu rechtfertigen. Typische Kandidaten sind:
- Coding-Agent-Aufgaben, bei denen eine falsche Antwort Engineering-Zeit kostet.
- Analysen mit langem Kontext, bei denen Abschneidung oder oberflächliche Synthese teurer ist als die Token-Rechnung.
- Procurement-, Finance- oder Compliance-Prüfungen, die vor der menschlichen Freigabe ein stärkeres Modell benötigen.
- Benchmark-Suiten, die Pro mit Flash und anderen Frontier-Modellen vor dem Rollout vergleichen.
- Hochwertige Produktabläufe, bei denen die Rate akzeptierter Antworten wichtiger ist als der günstigste erzeugte Token.
DeepSeek Flash ist für viele günstigere oder stärker parallele Aufgaben die bessere Standardwahl. Die aktuelle Flash-Route hat niedrigere Token-Raten, eine höhere angegebene Parallelität und Vision-Support in der Preistabelle. Wenn Sie sich noch zwischen beiden entscheiden, nutzen Sie DeepSeek V4 Pro vs Flash als Begleiter zur Modellauswahl und bringen Sie den finalen Kandidaten dann zurück in dieses Kostenblatt.
Kontrollen, um ein Ausufern der DeepSeek V4 Pro-Ausgaben zu verhindern
Ein Preisleitfaden sollte mit Kontrollen enden, nicht nur mit Tabellen. Für DeepSeek V4 Pro sollten Sie mit diesen beginnen:
| Kontrolle | Verantwortliche Stelle | Was sie verhindert |
|---|---|---|
| Modell-Allowlist | Plattform-Engineering | Unbeabsichtigte Pro-Nutzung durch Experimente oder kopierte Konfigurationen |
| Richtlinie für Spitzenzeiten | Produkt und Finance | Ungeplante Batch-Jobs mit doppelten Raten |
| Maximale Output-Tokens | Anwendungsteam | Agent-Antworten, die weit über den akzeptierten Ausgabebedarf hinauslaufen |
| Retry-Budget | Verantwortliche für Zuverlässigkeit | Stille Vervielfachung teurer Aufrufe |
| Quoten pro Schlüssel | Plattform-Engineering | Eine App, ein Kunde oder ein Agent, der das gemeinsame Guthaben verbraucht |
| Prüfung des Usage-Ledgers | Finance und Engineering | Streitigkeiten über Team-, Kunden- oder Umgebungs-Kosten |
| Route-Canary | Plattform-Engineering | Modell-ID-, Preis- oder Verhaltensänderungen, die unbemerkt in die Produktion gelangen |
Wenn Ihr Team bereits Anbieter vergleicht, fügen Sie diesen Artikel dem umfassenderen Workflow Wie man KI-Modellpreise vergleicht und der Checkliste zu AI-Gateway-Preisen hinzu.
OpenAI-kompatibles Setup über Flatkey
Wenn Ihre Anwendung bereits die OpenAI-SDK-Struktur verwendet, halten Sie den Codepfad stabil und verlagern Sie die Anbieterauswahl in die Konfiguration.
import OpenAI from "openai";

const client = new OpenAI({
  apiKey: process.env.FLATKEY_API_KEY,
  baseURL: "https://router.flatkey.ai/v1",
});

const response = await client.chat.completions.create({
  model: process.env.DEEPSEEK_PRO_MODEL || "deepseek-v4-pro",
  messages: [
    {
      role: "user",
      content: "Überprüfen Sie diese Zusammenfassung der Release-Risiken und geben Sie die drei Änderungen mit dem höchsten Risiko zurück.",
    },
  ],
  max_tokens: 4000,
});
Bevor Sie dies in der Produktion einsetzen, überprüfen Sie die genaue Modell-ID, die für Ihr Konto verfügbar ist, führen Sie einen Route-Canary aus und vergleichen Sie die resultierenden Ledger-Zeilen mit der offiziellen DeepSeek-Preisseite. Für Setup-Details verwenden Sie DeepSeek API-Zugang und den Leitfaden zum AI-Modellkatalog.
Checkliste für die Preisgestaltung der DeepSeek V4 Pro API
Verwenden Sie diese Checkliste, bevor Sie Pro für eine Arbeitslast freigeben:
- Bestätigen Sie die offizielle Preistabelle für
deepseek-v4-proam Tag der Freigabe. - Trennen Sie Schätzungen für Token in Spitzen- und Nebenzeiten.
- Schätzen Sie Cache-Hit- und Cache-Miss-Input-Tokens separat.
- Begrenzen Sie die maximalen Output-Tokens pro Workflow.
- Verfolgen Sie akzeptierte Ergebnisse, nicht nur generierte Antworten.
- Legen Sie Budgets für Wiederholungsversuche und Fallbacks fest.
- Weisen Sie jedem Schlüssel oder jeder Anfrage ein Team-, Umgebungs- und Kunden-Tag zu.
- Vergleichen Sie Pro mit Flash für dieselben Prompts.
- Überprüfen Sie während der Einführung wöchentlich das Flatkey-Nutzungs-Ledger.
- Preisen Sie die Route nach jeder DeepSeek-Modell-, Alias- oder Abrechnungsaktualisierung neu ein.
Die Preisgestaltung der DeepSeek V4 Pro API ist attraktiv, wenn die Pro-Qualität das akzeptierte Ergebnis so weit verbessert, dass der höhere Token-Preis gerechtfertigt ist. Sie wird riskant, wenn das Modell als uneingeschränkte Standardroute behandelt wird.
FAQ
Was ist die aktuelle Preisgestaltung der DeepSeek V4 Pro API?
Stand 11. Oktober 2026 listet DeepSeek deepseek-v4-pro mit $0.022 pro 1 Mio. Cache-Hit-Input-Tokens außerhalb der Spitzenzeiten und $0.044 in Spitzenzeiten, $0.66 pro 1 Mio. Cache-Miss-Input-Tokens außerhalb der Spitzenzeiten und $1.32 in Spitzenzeiten sowie $1.98 pro 1 Mio. Output-Tokens außerhalb der Spitzenzeiten und $3.96 in Spitzenzeiten.
Unterscheiden sich die Spitzenpreise von DeepSeek V4 Pro von den Preisen außerhalb der Spitzenzeiten?
Ja. DeepSeek sagt, dass die Tarife außerhalb der Spitzenzeiten halb so hoch sind wie die Spitzenpreise. Die Spitzenzeiten sind 01:00-04:00 und 06:00-10:00 UTC, Montag bis Freitag, ausgenommen chinesische Feiertage. Alle anderen Zeiten sind Nebenzeiten.
Ist DeepSeek V4 Pro nach dem 14. September 2026 noch verfügbar?
Die Aktualisierungsseite von DeepSeek sagt, dass die API-Dienste für DeepSeek V4 Pro auf Nutzerwunsch auch nach dem 14. September 2026 fortgeführt werden, wobei die Abrechnungsmethode unverändert bleibt, und dass DeepSeek eine Benachrichtigung bereitstellen wird, falls es weitere Änderungen gibt.
Warum ist die Cache-Hit-Preisgestaltung für DeepSeek V4 Pro so wichtig?
Der Cache-Hit-Input von DeepSeek V4 Pro ist in beiden Kategorien, Spitzen- und Nebenzeiten, 30-mal günstiger als Cache-Miss-Input. Bei langen Prompts, wiederholten Systemanweisungen und Agent-Tool-Manifests kann die Cache-Hit-Rate die monatliche Rechnung erheblich verändern.
Sollte ich DeepSeek V4 Pro oder DeepSeek Flash verwenden?
Verwenden Sie DeepSeek V4 Pro für Workloads, bei denen Qualität, Langkontext-Verhalten oder die Rate der akzeptierten Ergebnisse den höheren Token-Preis rechtfertigen. Verwenden Sie DeepSeek Flash für günstigere Workloads mit hohem Volumen, Vision-Workloads und Jobs, bei denen das aktuelle Flash-Modell gut genug ist.
Wie kann Flatkey helfen, die Preisgestaltung der DeepSeek V4 Pro API zu kontrollieren?
Flatkey bietet Teams einen API-Schlüssel, ein Guthaben, eine Rechnung, Routing-Steuerungen und Transparenz im Nutzungs-Ledger über offizielle Modellrouten hinweg. So können Teams die Ausgaben für DeepSeek V4 Pro neben anderen Modellkosten überprüfen und Kontingente, Modell-Allowlists und Fallback-Regeln in einer einzigen Control Plane festlegen.


