
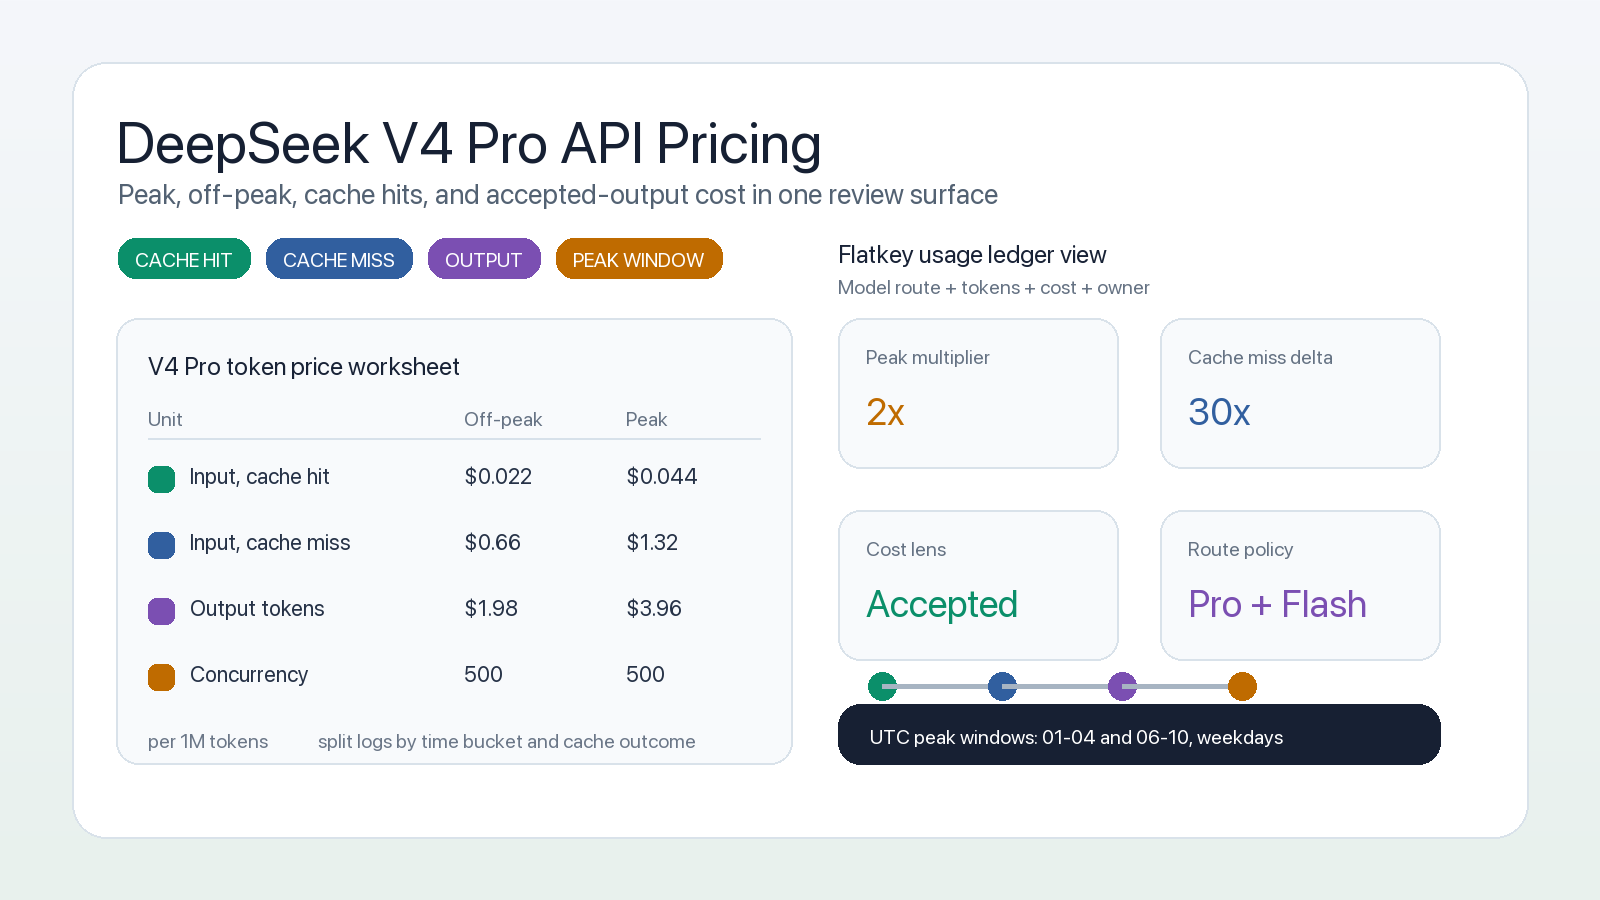
Si está comprobando los precios de la API de DeepSeek V4 Pro para el presupuesto de un producto, no se detenga en la tarifa principal por token de salida. Los precios de DeepSeek V4 Pro cambian según tres variables que afectan a la factura más de lo que la mayoría de los equipos espera: si la solicitud cae en horas pico o valle, si los tokens de entrada son aciertos de caché o fallos de caché, y cuánto resultado acepta realmente su flujo de trabajo.
A fecha de la página oficial de precios de DeepSeek consultada el 11 de octubre de 2026, deepseek-v4-pro figura como DeepSeek-V4-Pro-0813 con una ventana de contexto de 1M tokens, una salida máxima de 384K, compatibilidad de API en formato OpenAI y formato Anthropic, y precios separados para entrada con acierto de caché, entrada con fallo de caché y tokens de salida. La página de actualizaciones de DeepSeek también indica que el servicio de la API V4 Pro continúa después del 14 de septiembre de 2026 con el método de facturación sin cambios, por lo que los equipos deberían tratar la tabla Pro actual como activa, no como una ruta de transición ya retirada.
La conclusión práctica: los precios de la API de DeepSeek V4 Pro solo son previsibles si su hoja de cálculo separa el tráfico en pico y valle, la tasa de aciertos de caché, la longitud de salida, los reintentos y los resultados aceptados. Esta guía le ofrece la tabla de precios actual, la fórmula de coste y los controles para mantener visible el gasto de DeepSeek V4 Pro antes de que se convierta en una sorpresa financiera.
Precios de la API de DeepSeek V4 Pro en una sola tabla
DeepSeek fija el precio de su API en unidades de 1 millón de tokens. La tabla actual muestra estas tarifas de DeepSeek V4 Pro:
| Unidad de precio | Precio valle por 1M tokens | Precio pico por 1M tokens | Qué vigilar |
|---|---|---|---|
| Tokens de entrada, acierto de caché | $0.022 | $0.044 | Prefijos de prompt reutilizados que aciertan en la caché de contexto de DeepSeek |
| Tokens de entrada, fallo de caché | $0.66 | $1.32 | Contexto de prompt nuevo o no reutilizado |
| Tokens de salida | $1.98 | $3.96 | Respuestas del modelo, respuestas con mucho razonamiento, código generado y planes de agentes |
| Límite de concurrencia | 500 | 500 | Planificación de solicitudes paralelas y backpressure |
DeepSeek define las horas pico como 01:00-04:00 y 06:00-10:00 UTC, de lunes a viernes, excluyendo los festivos públicos de China. Todas las demás horas son valle, incluidos los fines de semana y los festivos públicos completos de China. Eso significa que la misma carga de trabajo puede costar el doble cuando se ejecuta en una ventana pico.
En comparación, la tabla actual de Flash de DeepSeek es más barata:
| Modelo | Entrada con acierto de caché, valle/pico | Entrada con fallo de caché, valle/pico | Salida, valle/pico | Concurrencia |
|---|---|---|---|---|
deepseek-v4-pro |
$0.022 / $0.044 | $0.66 / $1.32 | $1.98 / $3.96 | 500 |
deepseek-flash |
$0.003 / $0.006 | $0.15 / $0.30 | $0.60 / $1.20 | 2500 |
Eso no significa que todos los equipos deban enviar todo a Flash. Significa que los precios de la API de DeepSeek V4 Pro requieren una decisión a nivel de carga de trabajo. Use Pro donde la calidad, el comportamiento con contexto largo o la salida compleja de un agente de código lo justifiquen. Use Flash donde la latencia, la concurrencia, la compatibilidad con visión o el control simple de costes importen más.
Para la comparación más amplia entre proveedores, mantenga abierta junto a esta hoja de trabajo específica de Pro la guía canónica de precios de la API de DeepSeek.
La fórmula de coste que de verdad debería usar compras
La fórmula sencilla es:
request_cost =
  cache_hit_input_tokens / 1,000,000 * cache_hit_price
+ cache_miss_input_tokens / 1,000,000 * cache_miss_price
+ output_tokens / 1,000,000 * output_price
Para la planificación mensual, divida esa fórmula en bloques de pico y valle:
monthly_cost =
  off_peak_cache_hits * 0.022 / 1,000,000
+ off_peak_cache_misses * 0.66 / 1,000,000
+ off_peak_output_tokens * 1.98 / 1,000,000
+ peak_cache_hits * 0.044 / 1,000,000
+ peak_cache_misses * 1.32 / 1,000,000
+ peak_output_tokens * 3.96 / 1,000,000
Aquí está la versión útil como hoja de cálculo:
| Campo | Valor de ejemplo a recopilar | Por qué cambia la factura |
|---|---|---|
| Nombre de la carga de trabajo | Agente de código, respuesta RAG, revisión por lotes | Los distintos trabajos tienen distinta longitud de salida y comportamiento de reintentos |
| Bloque horario | Pico o valle | Las tarifas pico duplican las tarifas valle |
| Tokens de entrada | 80,000 por solicitud | Un contexto grande magnifica el coste del fallo de caché |
| Tasa de acierto de caché | 60% de los tokens de entrada | Los aciertos de caché son mucho más baratos que los fallos de caché |
| Tokens de salida | 12,000 por resultado aceptado | La salida Pro es el coste dominante en muchos flujos de trabajo de agentes |
| Tasa de reintento | 8% | Los reintentos multiplican tanto el coste de entrada como el de salida |
| Tasa de aceptación | 70% | Las generaciones rechazadas o no usadas siguen costando dinero |
| Ruta de respaldo | Flash, Qwen, Claude, GPT o ninguna | El respaldo puede ahorrar incidencias, pero también puede añadir llamadas duplicadas |
| Responsable | Equipo, producto, cliente o entorno | Necesario para showback, chargeback y política de cuotas |
Aquí también encaja Flatkey en el flujo de trabajo. Flatkey ofrece a los equipos una clave de API, un saldo, una factura y un libro de uso en todas las rutas oficiales de modelos, de modo que ingeniería y finanzas puedan revisar el coste de DeepSeek V4 Pro junto con el gasto de otros modelos en lugar de conciliar cada cuenta de proveedor por separado.
Por qué los aciertos de caché importan más que el precio principal
La caché de contexto de DeepSeek está habilitada por defecto para los usuarios de la API. Una solicitud posterior puede recibir precios de acierto de caché cuando coincide completamente con una unidad de prefijo de caché persistida. DeepSeek describe las unidades de prefijo como persistidas en los límites de la solicitud, a partir de prefijos comunes detectados y a intervalos fijos de tokens para entradas o salidas largas.
Eso importa porque la entrada con acierto de caché de DeepSeek V4 Pro es drásticamente más barata que la entrada sin acierto de caché:
| Franja horaria | Entrada con acierto de caché | Entrada sin acierto de caché | Diferencia |
|---|---|---|---|
| Valle | $0.022 / 1M | $0.66 / 1M | El fallo de caché es 30x superior |
| Pico | $0.044 / 1M | $1.32 / 1M | El fallo de caché es 30x superior |
Si tus prompts repiten instrucciones del sistema estables, manifiestos de herramientas, definiciones de esquemas, resúmenes de la base de código o preámbulos de recuperación, la tasa de acierto de caché puede importar más que un pequeño cambio en la longitud de la salida. Si cada solicitud llega con un prefijo diferente, tu plan debería asumir precios de fallo de caché hasta que los registros demuestren lo contrario.
Para los equipos que ejecutan agentes, la mejor práctica es simple:
- Mantén los prompts de sistema estables y los esquemas de herramientas al principio del contexto.
- Versiona bloques largos de instrucciones reutilizables en lugar de reescribirlos en cada ejecución.
- Supervisa por separado los tokens de entrada con acierto de caché y sin acierto de caché.
- Compara los precios de la API de DeepSeek V4 Pro por tarea aceptada, no solo por token bruto.
- Vuelve a comprobar la página oficial de precios antes de cambiar una ruta de alto volumen.
Para métodos relacionados, lee la guía de flujo de trabajo de caché de prompts y la guía de gestión del gasto en API de IA.
Programación en pico frente a valle
La política de valle de DeepSeek crea una palanca de programación sencilla. El tráfico interactivo del producto debe ejecutarse cuando los usuarios lo necesitan. Las evaluaciones por lotes, los análisis de repositorios, la revisión de etiquetado de datos y los trabajos nocturnos de agentes pueden, a menudo, desplazarse.
Usa esta regla de enrutamiento:
| Tipo de carga de trabajo | Política de coste recomendada |
|---|---|
| Chat orientado al usuario o asistente de programación | Prioriza la latencia, pero limita la salida máxima y el número de reintentos |
| Evaluaciones en segundo plano | Programa en valle salvo que el momento del lanzamiento requiera ejecución en pico |
| Análisis de documentos de contexto largo | Muévelo a valle y maximiza la reutilización de caché |
| Revisión por agente en CI | Ejecuta solo los archivos modificados a través de Pro; deriva las comprobaciones simples a Flash |
| Benchmark de adquisiciones | Ejecuta una mezcla representativa en franjas de pico y de valle |
Esto no trata solo de ahorrar la mitad de la tarifa por token. El beneficio mayor es la previsibilidad. Cuando los equipos saben qué trabajos de DeepSeek V4 Pro pueden ejecutarse durante horas punta, finanzas puede prever una factura en el peor caso e ingeniería puede reservar Pro para el trabajo que realmente lo necesita.
Flatkey puede respaldar ese modelo operativo manteniendo la decisión de enrutamiento, la política del modelo y la revisión de uso en un solo lugar, en lugar de dispersar variables de entorno por los repositorios.
Cuándo DeepSeek V4 Pro merece la tarifa más alta
Los precios de la API de DeepSeek V4 Pro tienen sentido cuando la carga de trabajo es lo bastante valiosa como para justificar la ruta Pro. Los candidatos típicos incluyen:
- Tareas de agentes de programación en las que una respuesta errónea consume tiempo de ingeniería.
- Análisis de contexto largo en el que el truncamiento o una síntesis superficial resulta más costoso que la factura de tokens.
- Revisiones de compras, finanzas o cumplimiento normativo que requieren un modelo más potente antes de la aprobación humana.
- Suites de benchmark que comparan Pro con Flash y otros modelos de frontera antes del despliegue.
- Flujos de producto de alto valor en los que la tasa de respuesta aceptada importa más que el token generado más barato.
DeepSeek Flash es la mejor opción por defecto para muchas tareas más baratas o más paralelizables. La ruta actual de Flash tiene tarifas por token más bajas, mayor concurrencia indicada y soporte de visión en la tabla de precios. Si aún estás decidiendo entre ambos, usa DeepSeek V4 Pro vs Flash como complemento para la selección del modelo y luego trae el candidato final de vuelta a esta hoja de costes.
Controles para evitar la deriva del gasto en DeepSeek V4 Pro
Una guía de precios debería terminar en controles, no solo en tablas. Para DeepSeek V4 Pro, empieza con estos:
| Control | Responsable | Qué previene |
|---|---|---|
| Lista de अनुमति de modelos | Ingeniería de plataforma | Uso accidental de Pro por experimentos o configuraciones copiadas |
| Política de horas punta | Producto y finanzas | Trabajos por lotes no planificados al doble de tarifa |
| Máximo de tokens de salida | Equipo de aplicación | Respuestas de agentes que superan con creces las necesidades de salida aceptadas |
| Presupuesto de reintentos | Responsable de fiabilidad | Multiplicación silenciosa de llamadas costosas |
| Cuotas por clave | Ingeniería de plataforma | Que una app, cliente o agente consuma el saldo compartido |
| Revisión del libro de uso | Finanzas e ingeniería | Disputas sobre el coste de equipo, cliente o entorno |
| Canario de rutas | Ingeniería de plataforma | Cambios en el ID del modelo, los precios o el comportamiento que lleguen a producción sin ser detectados |
Si tu equipo ya está comparando proveedores, añade este artículo al flujo de trabajo más amplio de cómo comparar precios de modelos de IA y a la lista de comprobación de precios de pasarela de IA.
Configuración compatible con OpenAI a través de Flatkey
Si tu aplicación ya usa la estructura del SDK de OpenAI, mantén estable la ruta de código y traslada la selección del proveedor a la configuración.
import OpenAI from "openai";

const client = new OpenAI({
  apiKey: process.env.FLATKEY_API_KEY,
  baseURL: "https://router.flatkey.ai/v1",
});

const response = await client.chat.completions.create({
  model: process.env.DEEPSEEK_PRO_MODEL || "deepseek-v4-pro",
  messages: [
    {
      role: "user",
      content: "Revisa este resumen de riesgo de lanzamiento y devuelve los tres cambios de mayor riesgo.",
    },
  ],
  max_tokens: 4000,
});
Antes de poner esto en producción, verifica el ID exacto del modelo disponible para tu cuenta, ejecuta un canary de ruta y compara las filas resultantes del libro mayor con la página oficial de precios de DeepSeek. Para detalles de configuración, usa acceso a la API de DeepSeek y la guía del catálogo de modelos de IA.
Lista de verificación de precios de la API de DeepSeek V4 Pro
Usa esta lista de verificación antes de aprobar Pro para una carga de trabajo:
- Confirma la tabla oficial de precios de
deepseek-v4-proel día de la aprobación. - Separa las estimaciones de tokens de pico y de valle.
- Estima por separado los tokens de entrada con acierto de caché y con fallo de caché.
- Limita los tokens máximos de salida por flujo de trabajo.
- Haz seguimiento de los resultados aceptados, no solo de las respuestas generadas.
- Establece presupuestos de reintentos y de respaldo.
- Asigna una etiqueta de equipo, entorno y cliente a cada clave o solicitud.
- Compara Pro con Flash para los mismos prompts.
- Revisa semanalmente el libro mayor de uso de Flatkey durante el despliegue.
- Recalcula el precio de la ruta después de cualquier actualización del modelo, alias o facturación de DeepSeek.
Los precios de la API de DeepSeek V4 Pro son atractivos cuando la calidad de Pro mejora lo suficiente el resultado aceptado como para justificar la mayor tarifa por token. Se vuelve arriesgado cuando el modelo se trata como una ruta predeterminada sin límite.
Preguntas frecuentes
¿Cuál es el precio actual de la API de DeepSeek V4 Pro?
A fecha de 11 de octubre de 2026, DeepSeek fija deepseek-v4-pro en $0.022 por 1M de tokens de entrada con acierto de caché en valle y $0.044 en pico, $0.66 por 1M de tokens de entrada con fallo de caché en valle y $1.32 en pico, y $1.98 por 1M de tokens de salida en valle y $3.96 en pico.
¿Los precios pico de DeepSeek V4 Pro son diferentes de los precios de valle?
Sí. DeepSeek indica que las tarifas de valle son la mitad de las tarifas de pico. Las horas pico son de 01:00 a 04:00 y de 06:00 a 10:00 UTC, de lunes a viernes, excluyendo los días festivos públicos chinos. Todas las demás horas son de valle.
¿Sigue disponible DeepSeek V4 Pro después del 14 de septiembre de 2026?
La página de actualización de DeepSeek dice que, en respuesta a la demanda de los usuarios, los servicios de API para DeepSeek V4 Pro continúan después del 14 de septiembre de 2026, con el método de facturación sin cambios, y que DeepSeek avisará si hay más cambios.
¿Por qué es tan importante el precio de acierto de caché para DeepSeek V4 Pro?
La entrada con acierto de caché de DeepSeek V4 Pro es 30 veces más barata que la entrada con fallo de caché tanto en los tramos de pico como de valle. Para prompts largos, instrucciones de sistema repetidas y manifiestos de herramientas de agentes, la tarifa de acierto de caché puede cambiar de forma material la factura mensual.
¿Debería usar DeepSeek V4 Pro o DeepSeek Flash?
Usa DeepSeek V4 Pro para cargas de trabajo en las que la calidad, el comportamiento de contexto largo o la tasa de resultado aceptado justifiquen la mayor tarifa por token. Usa DeepSeek Flash para trabajo de alto volumen y menor coste, cargas de trabajo de visión y tareas en las que el modelo Flash actual sea suficiente.
¿Cómo puede ayudar Flatkey a controlar los precios de la API de DeepSeek V4 Pro?
Flatkey proporciona a los equipos una clave de API, un saldo, una factura, controles de enrutamiento y visibilidad del libro mayor de uso en las rutas oficiales de modelos. Eso permite a los equipos revisar el gasto de DeepSeek V4 Pro junto con otros costes de modelos y establecer cuotas, listas de अनुमतिidos de modelos y reglas de respaldo en un único plano de control.


