
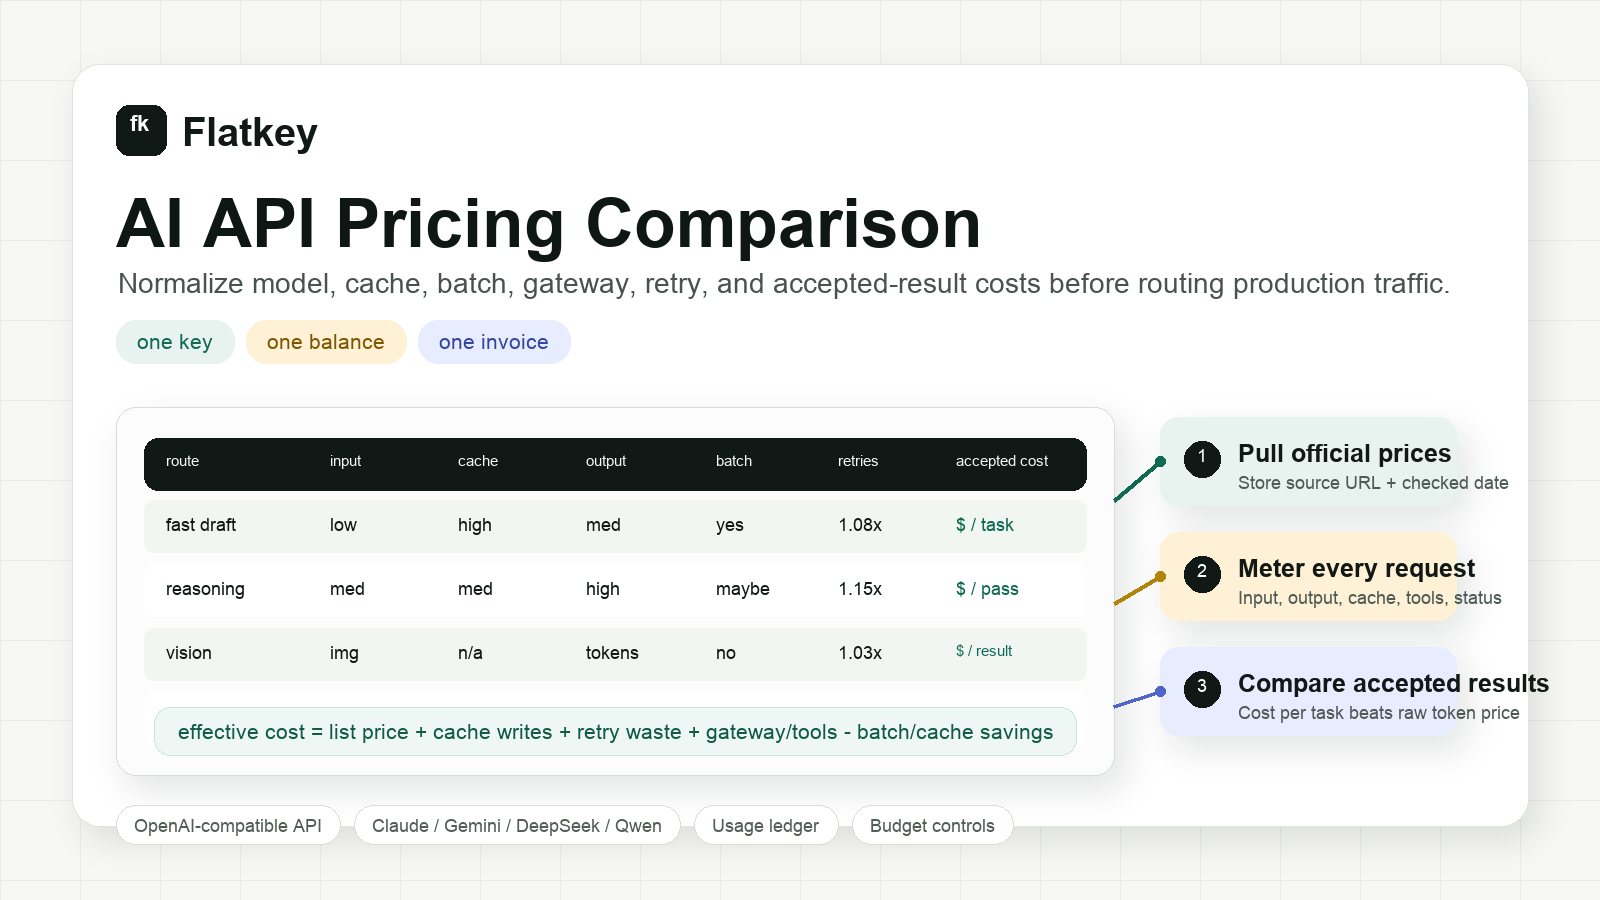
Vergleich der KI-API-Preise: Kosten für Modell, Cache, Batch und Gateway
Ein Preisvergleich für KI-APIs ist nur dann wirklich nützlich, wenn er zu der Art und Weise passt, wie Ihr Produkt tatsächlich Anfragen sendet. Eine Tabelle mit Eingabe- und Ausgabe-Tokenpreisen ist ein Ausgangspunkt, kein Budget. Die tatsächlichen Ausgaben ändern sich durch gecachte Eingaben, Reasoning-Tokens, Wiederholungsversuche, Batch-Rabatte, Tool-Aufrufe, Mediengenerierung, Gateway-Gebühren und den Anteil der Ausgaben, den Ihre Nutzer akzeptieren.
Dieser Leitfaden bietet Entwicklern, Produktteams und Einkaufsteams ein praktisches Arbeitsblatt zum Vergleich von KI-API-Preisen über OpenAI, Anthropic Claude, Google Gemini, DeepSeek, Alibaba Model Studio/Qwen und eine Multi-Provider-API wie Flatkey hinweg.
Die Kurzfassung: Vergleichen Sie die Kosten pro akzeptiertem Ergebnis, nicht nur den Listenpreis pro Million Tokens.
Das schnelle Framework für den Vergleich von KI-API-Preisen
Nutzen Sie diesen normalisierten Vergleich, bevor Sie den Anbieter wechseln, ein größeres Budget genehmigen oder einen Agenten-Workflow in die Produktion überführen.
| Ebene | Was verglichen werden sollte | Warum sich Ihre Rechnung ändert |
|---|---|---|
| Listenpreis des Modells | Eingabe-, gecachte Eingabe-, Ausgabe-, Bild-, Audio-, Video- und Tool-Call-Tarife | Die sichtbare Preisliste kann einen Anbieter für Prompts und einen anderen für Abschlüsse begünstigen. |
| Arbeitslastprofil | Durchschnittliche Eingabe-Tokens, Ausgabe-Tokens, cachebarer Präfix, Mediengröße und Tool-Aufrufe | Ein günstiges Ausgabemodell kann teuer werden, wenn es lange Prompts oder wiederholte Wiederholungsversuche benötigt. |
| Rabatte und Modi | Batch-API, Flex-/Prioritätsstufen, Cache-Treffer, Nebenzeiten-Fenster, zugesicherte Nutzung oder Volumenvereinbarungen | Dasselbe Modell kann je nach Zeitplanung und Latenztoleranz eine andere Wirtschaftlichkeit haben. |
| Zuverlässigkeitskosten | Retry-Rate, Fallback-Rate, Timeout-Rate und Richtlinie für fehlgeschlagene Aufrufe | Retry-Verschwendung kann den Vorteil eines niedrigeren Listenpreises zunichtemachen. |
| Betriebskosten | API-Keys, Rechnungen, Nutzungs-Exporte, Budgetkontrollen, Datenaufbewahrung und Beschaffungsaufwand | Finanz- und Plattformteams brauchen Governance, nicht nur günstigere Tokens. |
| Akzeptiertes Ergebnis | Akzeptanzrate, Rate der menschlichen Nachbearbeitung, Bestehensrate von Evaluatoren oder Erfolgsrate der Aufgabe | Die günstigste Anfrage ist nicht das günstigste Ergebnis, wenn die Qualität sinkt. |
Für jeden Vergleich der KI-API-Preise beginnen Sie mit dieser Formel:
effektive Kosten pro akzeptiertem Ergebnis =
  (Eingabekosten + Kosten für gecachte Eingaben + Ausgabekosten + Medien-/Tool-Kosten + Gateway-Kosten + Retry-Verschwendung)
  / Anzahl akzeptierter Ergebnisse
Wenn Sie nur die Listenpreise für Eingabe- und Ausgabe-Tokens vergleichen, übersehen Sie die Kosten, die normalerweise nach dem Start auftauchen: Cache-Verhalten, Wiederholungsversuche, Tool-Aufrufe und die Finanzabstimmung.
Aktuelle Quellentabelle für Preise
Die Preise der Anbieter ändern sich häufig. Anstatt eine große, veraltete Preisliste in Ihr Planungsdokument zu kopieren, pflegen Sie eine Live-Quellentabelle mit der offiziellen URL, dem Prüfdatum und den Preisdimensionen, die Sie normalisieren müssen.
| Anbieter oder Route | Zu prüfende offizielle Preisquelle | Zu erfassende Preisdimensionen | Hinweise für den Vergleich |
|---|---|---|---|
| OpenAI API | OpenAI API pricing | Eingabe, gecachte Eingabe, Ausgabe, Batch-Modus, Fine-Tuning, Medien, regionale Verarbeitung | Nützlich für Produkte, die bereits um OpenAI-kompatible Anfrage-Muster herum aufgebaut sind. Bestätigen Sie die Modell-IDs und ob Sie Standard- oder Batch-Preise verwenden. |
| Anthropic Claude API | Claude pricing | Eingabe, Ausgabe, Prompt-Caching, Batch-Preisgestaltung, Modellfamilie, Kontextfenster | Stark für Coding-, Reasoning- und Agent-Aufgaben; das Verhalten von Cache-Write und Cache-Hit ist für wiederholte Prompts wichtig. |
| Google Gemini API | Gemini API pricing | Gratis-/Bezahl-Tarif, Eingabe, Ausgabe, Caching, Batch-Modus, Prioritäts-/Flex-Optionen, Such-Grounding | Die Gemini-Preise können je nach Modellfamilie und Bereitstellungsmodus variieren. Erfassen Sie, ob Such- oder Grounding-Gebühren anfallen. |
| DeepSeek API | DeepSeek API pricing | Eingabe-Cache-Miss, Eingabe-Cache-Hit, Ausgabe, Peak-/Off-Peak-Zeitfenster, Modellalias | DeepSeek-ähnliche Cache-Hit- und Zeitfenster-Preise erfordern Request-Logs mit Zeitstempel und Cache-Status. |
| Alibaba Model Studio / Qwen | Alibaba Model Studio models | Modellfamilie, Modalität, Region, Token- oder Medieneinheit, Console-Modell-ID | Nützlich für Qwen und den Zugriff auf Modelle in der China-Region. Prüfen Sie die genaue Modell-Detailseite auf die abrechenbare Einheit. |
| Flatkey multi-provider API | Flatkey pricing und Flatkey models | Einheitliche Modellrouten, ein Guthaben, Protokoll pro Anfrage, Tool-Aufrufe, Rechnungen, Unter-Schlüssel-Budgets | Nützlich, wenn Sie einen Schlüssel, ein Guthaben und ein Nutzungsprotokoll über viele offizielle Modelle und Tools hinweg benötigen. |
Fügen Sie jeder Zeile drei Pflichtfelder hinzu: Prüfdatum, Modell-ID und Einheit. „$ pro 1 Mio. Tokens“ ist nicht vergleichbar mit „$ pro Bild“, „$ pro Videosekunde“, „$ pro Tool-Aufruf“ oder „Prioritätsstufe“.
Erstellen Sie das Arbeitsblatt, bevor Sie verhandeln
Ein belastbares Arbeitsblatt zum Vergleich der KI-API-Preise benötigt Spalten, die den Produktionsverkehr widerspiegeln.
| Spalte | Beispielwert | Warum das wichtig ist |
|---|---|---|
| Anbieter | Anthropic, OpenAI, Google, DeepSeek, Alibaba, Flatkey-Route | Hält direkte Anbieter- und Gateway-Routen getrennt. |
| Modell- oder Routen-ID | claude-*, gpt-*, gemini-*, deepseek-*, qwen-* |
Verhindert stillschweigende Vergleiche zwischen unterschiedlichen Modellstufen. |
| URL der Preisquelle | Offizielle Anbieterseite oder Flatkey-Modellseite | Macht die Beschaffungsprüfung nachvollziehbar. |
| Prüfdatum | 2026-10-12 |
Preise können sich schneller ändern als Vertragsprüfungen. |
| Eingabetokens pro Aufgabe | 8,000 |
Lange Prompts verändern die Wirtschaftlichkeit schnell. |
| Anteil cache-fähiger Eingaben | 65% |
Stabile System-Prompts und Retrieval-Präfixe können günstiger werden. |
| Ausgabetokens pro Aufgabe | 1,200 |
Begründungen und ausführliche Antworten erhöhen die Ausgabekosten. |
| Batch geeignet | ja/nein | Offline-Jobs können für niedrigere Batch-Raten infrage kommen. |
| Tool-/Medienaufrufe | Suche, Browser, Bild, Video, Anreicherung | Agenten-Workflows sind nicht nur textbasiert. |
| Wiederholungsmultiplikator | 1.08x |
Zeitüberschreitungen und Fallback-Versuche verursachen versteckte Kosten. |
| Annahmequote | 82% |
Niedrige Ausgabequalität erhöht die Kosten pro akzeptiertem Ergebnis. |
| Governance-Kosten | Rechnung, Budgetobergrenze, Export, Audit-Bedarf | Beschaffungskosten sind real, selbst wenn die Token-Preise niedrig sind. |
Mitteln Sie nicht jedes Modell in eine einzige Zeile. Trennen Sie nach Workload: Chat, RAG, Coding-Agent, Datenextraktion, Batch-Klassifizierung, Bildgenerierung, Videogenerierung und toolintensive Agentenläufe.
Vergleichen Sie die direkte Anbieterpreisgestaltung mit einer Multi-Provider-API
Direkte Anbieter-Konten sind am einfachsten, wenn eine Modellfamilie den Großteil Ihrer Arbeit abdeckt und Ihr Finanzteam mit separaten Anbietern zurechtkommt. Eine Multi-Provider-API wird nützlicher, wenn Sie Modelle fortlaufend vergleichen, nach Workload routen oder viele Schlüssel und Rechnungen verwalten müssen.
| Entscheidungspunkt | Direkte Anbieter-Konten können ausreichen, wenn ... | Eine Multi-Provider-API hilft, wenn ... |
|---|---|---|
| Modellwahl | Ein Anbieter gewinnt die meisten Aufgaben. | Unterschiedliche Workloads benötigen OpenAI-, Claude-, Gemini-, DeepSeek-, Qwen-, Bild-, Video- und Tool-Routen. |
| Engineering-Aufwand | Ihr Code ruft bereits einen Anbieter auf und ändert sich selten. | Sie möchten OpenAI-kompatibles Routing und weniger Integrations-Neuschreibungen. |
| Kostenkontrolle | Eine Rechnung und ein Dashboard sind akzeptabel. | Sie benötigen Budgets auf Sub-Key-Ebene, Modell-Allowlists und Nutzungs-Exporte pro Anfrage. |
| Beschaffung | Getrennte Verträge sind beherrschbar. | Doppelte Verträge, ungenutzte Kontingente und verstreute Anbieter-Schlüssel bremsen das Team aus. |
| Zuverlässigkeit | Gelegentliche Ausfälle von Anbietern sind akzeptabel. | Sie benötigen Fallback-Richtlinien und ein gemeinsames Ledger für Wiederholungs-/Fallback-Kosten. |
| Agenten-Workflows | Die App ruft nur Textmodelle auf. | Agenten rufen Modelle, Websuche, Browser-Aktionen, Anreicherungstools, Bilder und Video auf. |
Flatkey ist für die zweite Spalte gebaut: ein API-Schlüssel, ein Guthaben, eine Rechnung und ein Anfrage-Ledger über 300+ offizielle Modelle und 1.000+ Pay-per-Call-Tools. Das ersetzt nicht die Notwendigkeit, die offiziellen Modellpreise zu prüfen. Es gibt Ihrem Team einen einzigen Ort, um diese Kosten zu routen, zu messen und abzugleichen. Eine verwandte Aufschlüsselung der Gateway-Gebühren finden Sie unter AI gateway pricing.
Fünf Workload-Beispiele
1. Support-Chat
Support-Chat hat in der Regel moderate Eingaben, kurze Ausgaben und hohes Volumen. Vergleichen Sie:
- Trefferquote des Prompt-Caches für den System-Prompt und den Richtlinientext.
- Budget für Ausgabetokens nach Antworttyp.
- Eskalationsrate zu einem stärkeren Modell.
- Kosten pro gelöster Konversation, nicht nur Kosten pro Nachricht.
Für diesen Workload kann ein günstigeres, schnelles Modell gewinnen, wenn es die Lösungsqualität hoch hält. Wenn das günstigere Modell die Übergabe- oder Bearbeitungsrate erhöht, verschwinden die scheinbaren Token-Einsparungen.
2. Coding-Agent
Coding-Agenten haben oft großen Kontext, Tool-Aufrufe, lange Ausgaben und mehrere Wiederholungen. Vergleichen Sie:
- Kontextgröße nach Repository-Suche oder Dateilesen.
- Cache-fähige Projektanweisungen.
- Anzahl der Tool-Aufrufe pro akzeptierter Aufgabe.
- Wiederholungsverlust durch überlastete Routen.
- Kosten pro zusammengeführter Änderung oder akzeptiertem Patch.
Hier braucht ein Vergleich der KI-API-Preise ein Ledger. Ein einzelner Agentenlauf kann Modellaufrufe, Tool-Aufrufe, Fallback-Aufrufe und fehlgeschlagene Versuche umfassen.
3. RAG-Antwortgenerierung
RAG-Workloads werden von abgerufenem Kontext und der Antwortlänge dominiert. Vergleichen Sie:
- Durchschnittliche Anzahl abgerufener Tokens.
- Anteil des stabilen Prompt-Präfixes.
- Cache-Verhalten bei wiederholten Dokumenten.
- Kosten für Zitate und Grounding.
- Erfolgsquote des Evaluators für Faktentreue.
Wählen Sie ein Modell nicht nur deshalb aus, weil seine Eingabetokens günstig sind. Wenn es doppelt so viel Kontext benötigt oder Antworten erzeugt, die die Bewertung nicht bestehen, können die Kosten pro akzeptierter Antwort höher sein. Wenn dies die zentrale Migrationsfrage ist, nutzen Sie das ausführlichere Arbeitsblatt in how to compare AI model prices.
4. Batch-Klassifizierung
Batch-Klassifizierung kann oft verzögerte Ergebnisse tolerieren. Vergleichen Sie:
- Ob der Anbieter eine Batch- oder Flex-Stufe hat.
- Maximale Batch-Größe und Abschlussfenster.
- Kosten für die Wiederholung von Fehlern.
- Erfolgsquote der Validierung des Ausgabe-Schemas.
- Gesamtkosten pro akzeptierter Zeile.
Wenn ein Anbieter niedrigere Batch-Preise bietet, gelten die Einsparungen nur, wenn Ihr Workflow warten kann und Ihr Wiederholungsprozess sauber ist.
5. Bild- und Videogenerierung
Bild- und Video-APIs passen selten in eine reine Token-Tabelle. Vergleichen Sie:
- Ausgabeeinheit: Bild, Sekunde, Clip, Auflösung oder Guthaben.
- Abrechnungsregeln bei fehlgeschlagener Generierung.
- Rate für Bearbeitung/Neugenerierung.
- Quote der menschlichen Freigabe.
- Kosten pro akzeptiertem kreativen Asset.
Für Medien-Pipelines sollten Sie Token-Modelle und Generierungsmodelle in getrennte Tabellenblätter aufteilen. Die Unit Economics sind zu unterschiedlich für eine einzige gemischte Zeile.
Ein siebenstufiger Workflow zum Vergleich von KI-API-Preisen
- Den Workload einfrieren. Wählen Sie eine echte Aufgabenfamilie aus, z. B. Support-Antworten, Patches von Coding-Agents, RAG-Antworten, Batch-Klassifizierung, Bildgenerierung oder Videogenerierung.
- Aktuelle offizielle Preise erfassen. Nutzen Sie Preis-Seiten der Anbieter, Flatkey-Modellseiten und ein geprüftes Datum. Vermeiden Sie kopierte Preistabellen ohne Quell-URLs.
- Repräsentativen Traffic erneut abspielen. Verwenden Sie dieselben Prompts, Eingaben, Ausgabegrenzen, Tool-Richtlinien und Validatoren über alle Routen hinweg.
- Jede abrechenbare Einheit protokollieren. Erfassen Sie Eingabe-Tokens, zwischengespeicherte Tokens, Ausgabe-Tokens, Medieneinheiten, Tool-Aufrufe, Wiederholungsversuche, Fehler und Status.
- Akzeptierte Ergebnisse bewerten. Verwenden Sie manuelle Prüfung, automatisierte Validatoren oder aufgabenspezifische Bestehen/Nichtbestehen-Prüfungen.
- Effektive Kosten berechnen. Teilen Sie die Gesamtkosten der Route durch die akzeptierten Ergebnisse, nicht durch die Gesamtzahl der Anfragen.
- Betriebliche Kontrollen hinzufügen. Legen Sie fest, ob die siegreiche Route auch Budgetobergrenzen, Rechnungsanforderungen, Schlüssel-Governance, Datenaufbewahrung und Incident-Fallback erfüllt.
Das Ergebnis ist eine Preisentscheidung, die Sie gegenüber Engineering und Finance vertreten können.
Wo Flatkey passt
Flatkey ist keine statische Preistabelle. Es ist die Routing- und Abrechnungsebene für Teams, die einen realen Vergleich von KI-API-Preisen in Produktion durchführen müssen. Für die breitere Modellperspektive über Token-, Bild- und Videokosten hinweg beginnen Sie mit dem AI model pricing comparison.
Verwenden Sie Flatkey, wenn Sie:
- Viele offizielle Modelle über einen API-Schlüssel aufrufen möchten.
- Modell- und Tool-Nutzung auf einem Guthaben halten möchten.
- Routen vergleichen möchten, ohne Provider-Schlüssel über Agents und Repositories zu verteilen.
- Eingaben, Ausgaben, zwischengespeicherte Tokens, Tool-Aufrufe, Status und Kosten in einem Ledger nachverfolgen möchten.
- Teams Unter-Schlüssel-Budgets und Modell-Allowlists geben möchten.
- Eine einzige Rechnung statt vieler Provider-Dashboards abgleichen möchten.
Beginnen Sie mit Flatkey, wenn der Vergleich selbst zu einem operativen Problem geworden ist. Wenn Ihr Team bereits genau weiß, welcher Anbieter gewinnt, und kein providerübergreifendes Routing benötigt, kann ein Direktkonto ausreichen. Wenn Finance Verantwortlichkeit für Owner, Schlüssel und Budget benötigt, kombinieren Sie dieses Arbeitsblatt mit AI API spend management und AI API quota controls.
Häufige Fehler beim Vergleich von KI-API-Preisen
| Fehler | Was stattdessen zu tun ist |
|---|---|
| Nur Eingabe-Token-Raten vergleichen | Vergleichen Sie Eingabe, zwischengespeicherte Eingabe, Ausgabe, Wiederholungen und akzeptierte Ergebnisse. |
| Text, Bild, Video und Tools in eine Einheit mischen | Normalisieren Sie jede Modalität separat und summieren Sie dann die Kosten des akzeptierten Workflows. |
| Prompt-Caching ignorieren | Messen Sie stabile Prompt-Präfixe und Cache-Hitrate. |
| Batch-Berechtigung ignorieren | Trennen Sie latenzkritische und Offline-Jobs. |
| Veralteten kopierten Preistabellen vertrauen | Speichern Sie offizielle Quell-URLs und geprüfte Daten. |
| Gateways nur als Aufschlag betrachten | Berücksichtigen Sie Governance, Failover, Nutzungs-Exporte, Rechnungen und Engineering-Zeit. |
| Die günstigste Anfrage wählen | Wählen Sie das günstigste akzeptierte Ergebnis, das Qualitäts- und Zuverlässigkeitsanforderungen erfüllt. |
Häufig gestellte Fragen
Was ist der beste Weg, KI-API-Preise zu vergleichen?
Der beste Weg, KI-API-Preise zu vergleichen, besteht darin, jede Route auf Kosten pro akzeptiertem Ergebnis zu normalisieren. Berücksichtigen Sie Eingabe-Tokens, zwischengespeicherte Eingaben, Ausgabe-Tokens, Medieneinheiten, Tool-Aufrufe, Wiederholungen, Gateway-Gebühren und die Akzeptanzrate für den Workload.
Warum unterscheiden sich KI-API-Preise so stark?
KI-API-Preise unterscheiden sich, weil Anbieter unterschiedliche Modellarchitekturen, Serving-Stufen, Kontextfenster, Cache-Regeln, Batch-Rabatte, Medieneinheiten sowie regionale oder priorisierte Optionen verwenden. Ein niedriger Eingabepreis bedeutet nicht automatisch, dass die Route für Ihren Workload günstiger ist.
Sollte ich einen Anbieter oder eine Multi-Provider-API verwenden?
Verwenden Sie einen Anbieter, wenn eine einzige Modellfamilie die Arbeitslast abdeckt und eine separate Abrechnung leicht zu verwalten ist. Verwenden Sie eine Multi-Provider-API, wenn Sie Routen kontinuierlich vergleichen, viele Schlüssel verwalten, über Text- und Medienmodelle hinweg routen oder die Nutzung in einem einzigen Hauptbuch abgleichen müssen.
Wie oft sollte die Preisgestaltung erneut geprüft werden?
Prüfen Sie die Preise vor jeder größeren Routing-Änderung, Vertragsprüfung oder Budgetprognose erneut. Bei schnelllebigen produktiven Arbeitslasten sollten Sie die Preisquelle und das Prüfdatum in Ihrem Kostenarbeitsblatt speichern, damit Finance und Engineering sehen können, wann Zahlen veraltet sein könnten.
Senkt ein niedrigerer Token-Preis immer die gesamten KI-Ausgaben?
Nein. Ein niedrigerer Token-Preis kann sich als nachteilig erweisen, sobald längere Prompts, längere Ausgaben, eine niedrigere Annahmerate, erneute Versuche, Fallback-Aufrufe, Tool-Nutzung und zusätzlicher Governance-Overhead berücksichtigt werden. Die belastbare Kennzahl sind die effektiven Kosten pro akzeptiertem Ergebnis.
End-Checkliste
Bevor Sie sich für einen Weg entscheiden, bestätigen Sie:
- Die Modell-ID, die Preisquelle und das Prüfdatum sind dokumentiert.
- Input, zwischengespeicherter Input, Output, Medien und Tool-Einheiten sind getrennt.
- Batch- oder Prioritätsmodus ist ausdrücklich gekennzeichnet.
- Retry- und Fallback-Kosten sind enthalten.
- Die Annahmerate wird mit realen Aufgaben gemessen.
- Der Einkauf kann die Rechnung abgleichen und das Nutzungsprotokoll exportieren.
- Die endgültige Entscheidung basiert auf den Kosten pro akzeptiertem Ergebnis und nicht nur auf dem Listenpreis.
Das ist der praktische Vergleich der KI-API-Preise: aktuelle Quellpreise, produktionsähnlicher Traffic und ein Hauptbuch, dem sowohl Finance als auch Engineering vertrauen können.


