
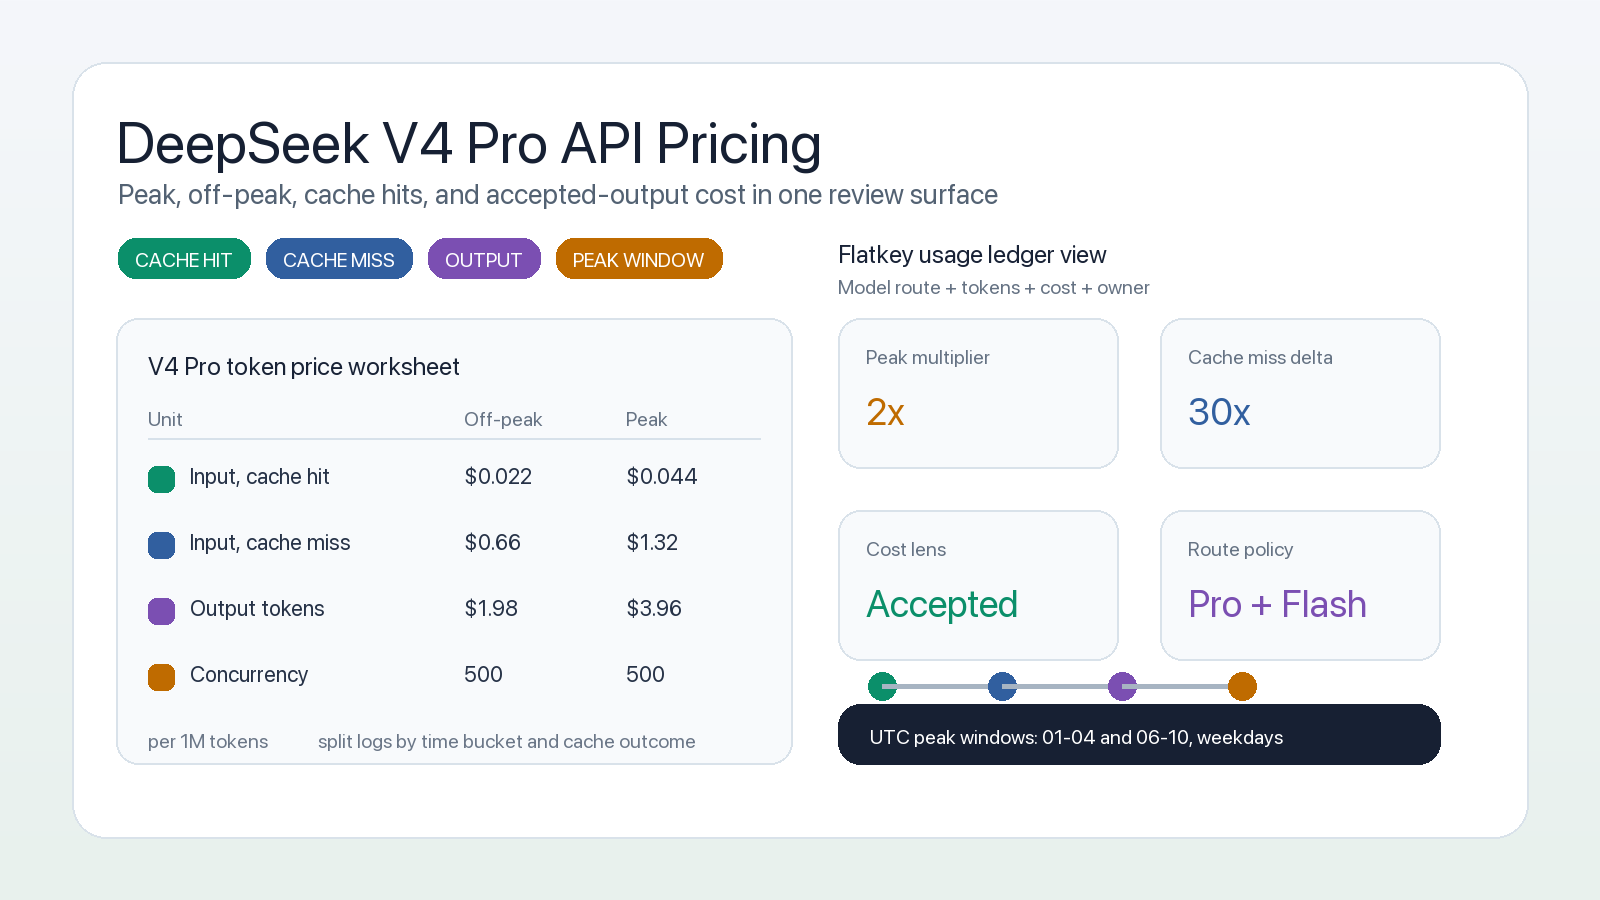
如果你正在为产品预算查看 deepseek v4 pro api pricing,就不要只盯着标题里的输出 token 费率。DeepSeek V4 Pro pricing 会随三个变量变化,而这些变量对账单的影响往往比大多数团队预期的更大:请求落在峰值还是非峰值时段、输入 token 是 cache hit 还是 cache miss,以及你的工作流实际接受了多少输出。
截至 2026 年 10 月 11 日核对的 DeepSeek 官方定价页面,deepseek-v4-pro 列示为 DeepSeek-V4-Pro-0813,具有 1M token 上下文窗口、384K 最大输出、OpenAI-format 和 Anthropic-format API 支持,并且对 cache-hit input、cache-miss input 和 output tokens 采用独立定价。DeepSeek 的更新页面还说明,V4 Pro API 服务在 2026 年 9 月 14 日之后仍会继续,计费方式不变,因此团队应将当前 Pro 表视为仍在生效,而不是仅用于过渡的已退役路径。
实际结论是:deepseek v4 pro api pricing 只有在你的工作表把峰值流量、非峰值流量、cache hit rate、输出长度、重试次数和已接受结果分开统计时,才算可预测。本指南会给你当前定价表、成本公式,以及在 DeepSeek V4 Pro 花费变成财务惊喜之前保持可见性的控制方法。
DeepSeek V4 Pro API pricing 一览表
DeepSeek 按每 100 万 token 为单位为其 API 定价。当前表列出了以下 DeepSeek V4 Pro rates:
| Pricing unit | Off-peak price per 1M tokens | Peak price per 1M tokens | What to track |
|---|---|---|---|
| Input tokens, cache hit | $0.022 | $0.044 | 命中 DeepSeek 上下文缓存的可复用 prompt 前缀 |
| Input tokens, cache miss | $0.66 | $1.32 | 新的或未复用的 prompt 上下文 |
| Output tokens | $1.98 | $3.96 | 模型回复、推理密集型答案、生成代码和 agent 计划 |
| Concurrency limit | 500 | 500 | 并行请求规划和背压 |
DeepSeek 将峰值时段定义为 UTC 时间周一至周五 01:00-04:00 和 06:00-10:00,不包括中国法定节假日。其他所有时段都属于非峰值,包括周末和整个中国法定节假日。这意味着同一工作负载在峰值窗口运行时,成本可能会翻倍。
作为对比,DeepSeek 当前的 Flash 表更便宜:
| Model | Cache-hit input, off-peak/peak | Cache-miss input, off-peak/peak | Output, off-peak/peak | Concurrency |
|---|---|---|---|---|
deepseek-v4-pro |
$0.022 / $0.044 | $0.66 / $1.32 | $1.98 / $3.96 | 500 |
deepseek-flash |
$0.003 / $0.006 | $0.15 / $0.30 | $0.60 / $1.20 | 2500 |
这并不意味着每个团队都应该把所有请求都路由到 Flash。它的意思是,DeepSeek V4 Pro API pricing 需要按工作负载来决策。对于质量、长上下文行为或复杂 coding-agent 输出足以证明其价值的场景,使用 Pro。对于延迟、并发、视觉支持或更简单的成本控制更重要的场景,使用 Flash。
如需更广泛的提供商对比,请将权威的 DeepSeek API pricing 指南与这份 Pro 专用工作表并排打开。
采购团队实际应该使用的成本公式
简单公式如下:
request_cost =
  cache_hit_input_tokens / 1,000,000 * cache_hit_price
+ cache_miss_input_tokens / 1,000,000 * cache_miss_price
+ output_tokens / 1,000,000 * output_price
用于月度规划时,将该公式拆分为峰值和非峰值两个桶:
monthly_cost =
  off_peak_cache_hits * 0.022 / 1,000,000
+ off_peak_cache_misses * 0.66 / 1,000,000
+ off_peak_output_tokens * 1.98 / 1,000,000
+ peak_cache_hits * 0.044 / 1,000,000
+ peak_cache_misses * 1.32 / 1,000,000
+ peak_output_tokens * 3.96 / 1,000,000
下面是适合作为工作表的实用版本:
| Field | Example value to collect | Why it changes the bill |
|---|---|---|
| Workload name | Coding agent, RAG answer, batch review | 不同任务的输出长度和重试行为不同 |
| Time bucket | Peak or off-peak | 峰值费率是非峰值费率的两倍 |
| Input tokens | 80,000 per request | 大上下文会放大 cache-miss 成本 |
| Cache-hit rate | 60% of input tokens | cache hit 的费用远低于 cache miss |
| Output tokens | 12,000 per accepted result | 在许多 agent 工作流中,Pro 输出是主要成本 |
| Retry rate | 8% | 重试会同时放大输入和输出成本 |
| Acceptance rate | 70% | 被拒绝或未使用的生成内容仍然会产生费用 |
| Fallback route | Flash, Qwen, Claude, GPT, or none | 回退可以避免事故,但也可能增加重复调用 |
| Owner | Team, product, customer, or environment | 用于 showback、chargeback 和配额策略 |
这也是 Flatkey 在工作流中发挥作用的地方。Flatkey 为团队提供一个 API key、一个余额、一张发票,以及覆盖官方模型路由的用量账本,因此工程和财务可以把 DeepSeek V4 Pro 成本与其他模型支出放在一起审查,而不是分别对每个提供商账户进行核对。
为什么 cache hits 比标题价格更重要
DeepSeek 上下文缓存对 API 用户默认启用。当后续请求与已持久化的缓存前缀单元完全匹配时,可以按缓存命中价格计费。DeepSeek 将前缀单元描述为在请求边界、从检测到的公共前缀,以及针对长输入或输出的固定 token 间隔处进行持久化。
这很重要,因为 DeepSeek V4 Pro 的缓存命中输入价格远低于缓存未命中输入价格:
| 时间段 | 缓存命中输入 | 缓存未命中输入 | 差异 |
|---|---|---|---|
| 非峰值 | $0.022 / 1M | $0.66 / 1M | 缓存未命中高 30 倍 |
| 峰值 | $0.044 / 1M | $1.32 / 1M | 缓存未命中高 30 倍 |
如果你的提示会重复稳定的系统指令、工具清单、schema 定义、代码库摘要或检索前导词,那么缓存命中率的重要性可能超过输出长度的小幅变化。如果每个请求都带着不同的前缀到来,在日志证明相反之前,你的方案应按缓存未命中价格来假设。
对于运行代理的团队,最佳实践很简单:
- 将稳定的系统提示和工具 schema 放在上下文前部。
- 对可复用的长指令块进行版本管理,而不是每次运行都重写。
- 分别跟踪缓存命中和缓存未命中的输入 token。
- 按已接受任务而非仅按原始 token 来比较 DeepSeek V4 Pro API 定价。
- 在更改高流量路径之前,重新查看官方定价页面。
关于相邻方法,请阅读 提示缓存工作流 指南和 AI API 支出管理 指南。
峰值与非峰值调度
DeepSeek 的非峰值政策提供了一个直接的调度杠杆。交互式产品流量必须在用户需要时运行。批量评测、仓库扫描、数据标注复审以及夜间代理任务通常可以调整时间。
使用以下路由规则:
| 工作负载类型 | 推荐成本策略 |
|---|---|
| 面向用户的聊天或编程助手 | 优先保证延迟,但限制最大输出和重试次数 |
| 后台评测 | 安排在非峰值,除非发布时间要求在峰值执行 |
| 长上下文文档分析 | 移至非峰值并最大化缓存复用 |
| CI 代理审查 | 仅将变更文件通过 Pro 运行;简单检查路由到 Flash |
| 采购基准测试 | 在峰值和非峰值时段都运行具有代表性的混合负载 |
这不仅仅是为了节省一半的 token 费率。更大的好处是可预测性。当团队知道哪些 DeepSeek V4 Pro 任务允许在峰值时段运行时,财务可以预测最坏情况账单,工程则可以为真正需要它的工作预留 Pro。
Flatkey 可以通过将路由决策、模型策略和使用审查集中在一个地方来支持这种运营模式,而不是把环境变量分散在各个仓库中。
什么时候 DeepSeek V4 Pro 值得更高费率
当工作负载足够有价值,足以证明使用 Pro 路由是合理的时候,DeepSeek V4 Pro API 定价就说得通。典型候选包括:
- 错误答案会浪费工程时间的编程代理任务。
- 截断或浅层综合的成本高于 token 账单的长上下文分析。
- 在人工签字前需要更强模型的采购、财务或合规审查。
- 在上线前将 Pro 与 Flash 及其他前沿模型进行比较的基准测试套件。
- 已接受答案率比最便宜的生成 token 更重要的高价值产品流程。
对于许多更便宜或更并行的任务,DeepSeek Flash 是更好的默认选择。当前的 Flash 路由在定价表中具有更低的 token 费率、更高的列出并发数以及视觉支持。如果你仍在两者之间犹豫,请将 DeepSeek V4 Pro vs Flash 作为模型选择的配套阅读,然后再把最终候选带回这份成本工作表。
防止 DeepSeek V4 Pro 支出漂移的控制措施
定价指南应该以控制措施收尾,而不仅仅是表格。对于 DeepSeek V4 Pro,可以从以下内容开始:
| 控制措施 | 负责人 | 可防止的问题 |
|---|---|---|
| 模型允许列表 | 平台工程 | 实验或复制配置导致的意外 Pro 使用 |
| 峰值时段策略 | 产品和财务 | 未经计划的双倍费率批处理作业 |
| 最大输出 token | 应用团队 | 远超可接受输出需求的代理响应 |
| 重试预算 | 可靠性负责人 | 昂贵调用被无声地成倍放大 |
| 按 key 配额 | 平台工程 | 单个应用、客户或代理消耗共享余额 |
| 使用账本审查 | 财务和工程 | 关于团队、客户或环境成本的争议 |
| 路由金丝雀 | 平台工程 | 模型 ID、定价或行为变化未被察觉地进入生产 |
如果你的团队已经在比较不同提供商,可以将本文加入更广泛的 如何比较 AI 模型价格 工作流以及 AI 网关定价 清单中。
通过 Flatkey 进行 OpenAI 兼容设置
如果你的应用已经使用 OpenAI SDK 的结构,请保持代码路径稳定,并将提供商选择移到配置中。
import OpenAI from "openai";

const client = new OpenAI({
  apiKey: process.env.FLATKEY_API_KEY,
  baseURL: "https://router.flatkey.ai/v1",
});

const response = await client.chat.completions.create({
  model: process.env.DEEPSEEK_PRO_MODEL || "deepseek-v4-pro",
  messages: [
    {
      role: "user",
      content: "Review this release-risk summary and return the three highest-risk changes.",
    },
  ],
  max_tokens: 4000,
});
在将其投入生产之前,请核实与你账户可用的确切模型 ID,运行一次路由金丝雀测试,并将生成的账本行与 DeepSeek 官方定价页面进行比对。有关设置详情,请参阅 DeepSeek API 访问 和 AI 模型目录指南。
DeepSeek V4 Pro API 定价检查清单
在批准某个工作负载使用 Pro 之前,请使用此检查清单:
- 在批准当天确认官方
deepseek-v4-pro价格表。 - 分别估算峰值和非峰值令牌。
- 分别估算缓存命中和缓存未命中输入令牌。
- 为每个工作流设置最大输出令牌上限。
- 跟踪被接受的结果,而不只是生成的响应。
- 设置重试和回退预算。
- 为每个密钥或请求分配团队、环境和客户标签。
- 将 Pro 与 Flash 用于相同提示词时进行比较。
- 在推广期间每周查看 Flatkey 使用账本。
- 在任何 DeepSeek 模型、别名或计费更新后重新为该路由定价。
当 Pro 的质量提升足以抵消更高的令牌费率时,DeepSeek V4 Pro API 定价就很有吸引力。当该模型被当作无限制的默认路由使用时,它就会变得有风险。
常见问题解答
当前的 DeepSeek V4 Pro API 定价是多少?
截至 2026 年 10 月 11 日,DeepSeek 将 deepseek-v4-pro 的价格列为:非峰值每 100 万缓存命中输入令牌 $0.022、峰值 $0.044;非峰值每 100 万缓存未命中输入令牌 $0.66、峰值 $1.32;非峰值每 100 万输出令牌 $1.98、峰值 $3.96。
DeepSeek V4 Pro 的峰值价格与非峰值价格不同吗?
是的。DeepSeek 表示,非峰值费率是峰值费率的一半。峰值时段为 UTC 周一至周五 01:00-04:00 和 06:00-10:00,不包括中国法定节假日。其他所有时段均为非峰值。
2026 年 9 月 14 日之后 DeepSeek V4 Pro 还可用吗?
DeepSeek 的更新页面表示,基于用户需求,DeepSeek V4 Pro 的 API 服务在 2026 年 9 月 14 日之后将继续提供,计费方式保持不变;如果有进一步变更,DeepSeek 将提前通知。
为什么缓存命中定价对 DeepSeek V4 Pro 如此重要?
在峰值和非峰值两个桶中,DeepSeek V4 Pro 的缓存命中输入都比缓存未命中输入便宜 30 倍。对于长提示词、重复的系统指令以及代理工具清单,缓存命中费率会实质性地改变月度账单。
我应该使用 DeepSeek V4 Pro 还是 DeepSeek Flash?
对于质量、长上下文表现或被接受结果率足以证明更高令牌费率合理的工作负载,请使用 DeepSeek V4 Pro。对于更便宜的高吞吐工作、视觉工作负载,以及当前 Flash 模型已经足够好的任务,请使用 DeepSeek Flash。
Flatkey 如何帮助控制 DeepSeek V4 Pro API 定价?
Flatkey 为团队提供一个 API 密钥、一个余额、一张发票、路由控制,以及跨官方模型路由的使用账本可见性。这样,团队就可以将 DeepSeek V4 Pro 的支出与其他模型成本放在一起审查,并在一个控制平面中设置配额、模型允许列表和回退规则。


