
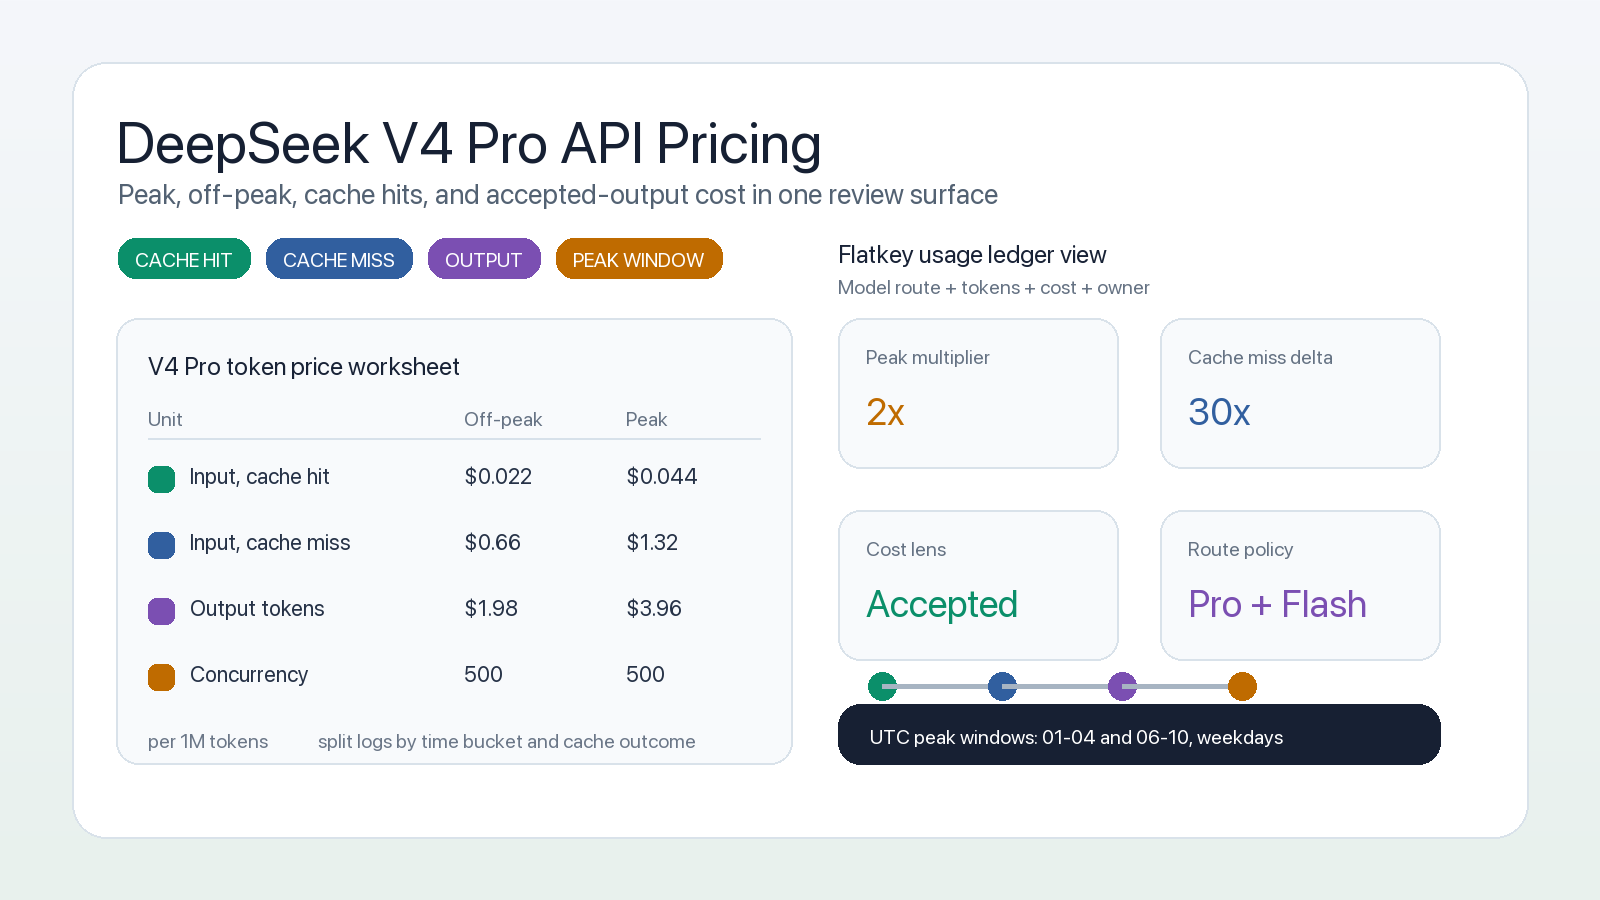
Si vous vérifiez la tarification de l’API DeepSeek V4 Pro pour un budget produit, ne vous arrêtez pas au taux affiché pour les jetons de sortie. La tarification de DeepSeek V4 Pro varie selon trois paramètres qui influencent la facture bien plus que la plupart des équipes ne l’anticipent : si la requête arrive en heures de pointe ou hors pointe, si les jetons d’entrée correspondent à des cache hits ou à des cache misses, et combien de sortie votre flux de travail accepte réellement.
À la date du 11 octobre 2026, d’après la page tarifaire officielle de DeepSeek consultée ce jour-là, deepseek-v4-pro est सूचीé comme DeepSeek-V4-Pro-0813 avec une fenêtre de contexte de 1M jetons, une sortie maximale de 384K, la prise en charge des API au format OpenAI et au format Anthropic, ainsi que des tarifs distincts pour les jetons d’entrée en cache hit, les jetons d’entrée en cache miss et les jetons de sortie. La page de mise à jour de DeepSeek indique également que le service API V4 Pro se poursuit après le 14 septembre 2026 avec une méthode de facturation inchangée, de sorte que les équipes doivent considérer le tableau Pro actuel comme actif, et non comme une simple voie de transition retirée.
En pratique : la tarification de l’API DeepSeek V4 Pro n’est prévisible que si votre feuille de calcul sépare le trafic de pointe, le trafic hors pointe, le taux de cache hit, la longueur des sorties, les retries et les résultats acceptés. Ce guide vous donne le tableau tarifaire actuel, la formule de coût et les leviers pour garder les dépenses DeepSeek V4 Pro visibles avant qu’elles ne deviennent une surprise pour la finance.
Tarification de l’API DeepSeek V4 Pro en un tableau
DeepSeek facture son API par unités de 1 million de jetons. Le tableau actuel indique les tarifs suivants pour DeepSeek V4 Pro :
| Unité tarifaire | Prix hors pointe par 1M jetons | Prix en pointe par 1M jetons | À suivre |
|---|---|---|---|
| Jetons d’entrée, cache hit | $0.022 | $0.044 | Préfixes de prompt réutilisés qui déclenchent le cache de contexte DeepSeek |
| Jetons d’entrée, cache miss | $0.66 | $1.32 | Contexte de prompt nouveau ou non réutilisé |
| Jetons de sortie | $1.98 | $3.96 | Réponses du modèle, réponses à forte composante de raisonnement, code généré et plans d’agent |
| Limite de concurrence | 500 | 500 | Planification des requêtes parallèles et backpressure |
DeepSeek définit les heures de pointe comme 01:00-04:00 et 06:00-10:00 UTC, du lundi au vendredi, hors jours fériés publics chinois. Toutes les autres heures sont hors pointe, y compris les week-ends et les jours fériés chinois complets. Cela signifie que la même charge de travail peut coûter deux fois plus cher lorsqu’elle s’exécute pendant une fenêtre de pointe.
À titre de comparaison, le tableau Flash actuel de DeepSeek est moins cher :
| Modèle | Jetons d’entrée cache hit, hors pointe/pointe | Jetons d’entrée cache miss, hors pointe/pointe | Sortie, hors pointe/pointe | Concurrence |
|---|---|---|---|---|
deepseek-v4-pro |
$0.022 / $0.044 | $0.66 / $1.32 | $1.98 / $3.96 | 500 |
deepseek-flash |
$0.003 / $0.006 | $0.15 / $0.30 | $0.60 / $1.20 | 2500 |
Cela ne signifie pas que toutes les équipes doivent tout acheminer vers Flash. Cela signifie que la tarification de l’API DeepSeek V4 Pro nécessite une décision au niveau de la charge de travail. Utilisez Pro là où la qualité, le comportement sur long contexte ou la sortie d’un agent de codage complexe le justifient. Utilisez Flash lorsque la latence, la concurrence, la prise en charge de la vision ou un simple contrôle des coûts sont plus importants.
Pour la comparaison plus large entre fournisseurs, gardez le guide canonique DeepSeek API pricing ouvert à côté de cette feuille de calcul spécifique à Pro.
La formule de coût que les achats devraient réellement utiliser
La formule simple est :
request_cost =
  cache_hit_input_tokens / 1,000,000 * cache_hit_price
+ cache_miss_input_tokens / 1,000,000 * cache_miss_price
+ output_tokens / 1,000,000 * output_price
Pour la planification mensuelle, répartissez cette formule en catégories pointe et hors pointe :
monthly_cost =
  off_peak_cache_hits * 0.022 / 1,000,000
+ off_peak_cache_misses * 0.66 / 1,000,000
+ off_peak_output_tokens * 1.98 / 1,000,000
+ peak_cache_hits * 0.044 / 1,000,000
+ peak_cache_misses * 1.32 / 1,000,000
+ peak_output_tokens * 3.96 / 1,000,000
Voici la version utile sous forme de feuille de calcul :
| Champ | Valeur d’exemple à collecter | Pourquoi cela modifie la facture |
|---|---|---|
| Nom de la charge de travail | Agent de codage, réponse RAG, revue par lot | Des tâches différentes ont des longueurs de sortie et des comportements de retry différents |
| Tranche horaire | Pointe ou hors pointe | Les tarifs en pointe sont le double des tarifs hors pointe |
| Jetons d’entrée | 80,000 par requête | Un contexte volumineux amplifie le coût des cache misses |
| Taux de cache hit | 60% des jetons d’entrée | Les cache hits sont beaucoup moins chers que les cache misses |
| Jetons de sortie | 12,000 par résultat accepté | La sortie Pro est le coût dominant dans de nombreux flux d’agents |
| Taux de retry | 8% | Les retries multiplient les coûts d’entrée et de sortie |
| Taux d’acceptation | 70% | Les générations rejetées ou inutilisées coûtent quand même de l’argent |
| Route de secours | Flash, Qwen, Claude, GPT, ou aucune | Un fallback peut réduire les incidents mais peut ajouter des appels en double |
| Responsable | Équipe, produit, client ou environnement | Nécessaire pour le showback, le chargeback et la politique de quota |
C’est aussi là qu’intervient Flatkey dans le flux de travail. Flatkey donne aux équipes une clé API, un solde, une facture et un registre d’utilisation uniques sur les routes officielles des modèles, afin que l’ingénierie et la finance puissent examiner le coût de DeepSeek V4 Pro à côté des autres dépenses en modèles, au lieu de rapprocher séparément chaque compte fournisseur.
Pourquoi les cache hits comptent plus que le prix affiché
La mise en cache du contexte DeepSeek est activée par défaut pour les utilisateurs de l’API. Une requête ultérieure peut bénéficier d’une tarification au cache-hit lorsqu’elle correspond entièrement à une unité de préfixe de cache persistée. DeepSeek décrit les unités de préfixe comme étant persistées aux frontières de requête, à partir de préfixes communs détectés, et à des intervalles fixes de tokens pour les longues entrées ou sorties.
Cela importe parce que l’entrée au cache-hit de DeepSeek V4 Pro est beaucoup moins chère que l’entrée au cache-miss :
| Créneau horaire | Entrée au cache-hit | Entrée au cache-miss | Différence |
|---|---|---|---|
| Hors pointe | 0,022 $ / 1M | 0,66 $ / 1M | Le cache-miss est 30x plus élevé |
| Pointe | 0,044 $ / 1M | 1,32 $ / 1M | Le cache-miss est 30x plus élevé |
Si vos prompts répètent des instructions système stables, des manifests d’outils, des définitions de schémas, des résumés de base de code ou des préambules de récupération, le taux de cache-hit peut compter davantage qu’un léger changement de la longueur de sortie. Si chaque requête arrive avec un préfixe différent, votre plan doit supposer une tarification au cache-miss jusqu’à ce que les journaux prouvent le contraire.
Pour les équipes qui exécutent des agents, la meilleure pratique est simple :
- Conservez les prompts système stables et les schémas d’outils au début du contexte.
- Versionnez les longs blocs d’instructions réutilisables au lieu de les réécrire à chaque exécution.
- Suivez séparément les tokens d’entrée cache-hit et cache-miss.
- Comparez la tarification de l’API DeepSeek V4 Pro par tâche acceptée, et pas seulement par token brut.
- Revérifiez la page de tarification officielle avant de modifier un chemin à fort volume.
Pour des méthodes adjacentes, lisez le guide workflow de mise en cache des prompts et le guide gestion des dépenses d’API IA.
Planification en pointe versus hors pointe
La politique hors pointe de DeepSeek crée un levier de planification simple. Le trafic produit interactif doit s’exécuter quand les utilisateurs en ont besoin. Les évaluations batch, les scans de dépôt, la revue d’annotations de données et les tâches nocturnes des agents peuvent souvent être déplacés.
Utilisez cette règle de routage :
| Type de charge de travail | Politique de coût recommandée |
|---|---|
| Chat orienté utilisateur ou assistant de codage | Gardez la latence prioritaire, mais limitez la sortie maximale et le nombre de tentatives |
| Évaluations en arrière-plan | Planifiez hors pointe, sauf si le calendrier de publication impose une exécution en pointe |
| Analyse de documents à long contexte | Déplacez en hors pointe et maximisez la réutilisation du cache |
| Revue par agent en CI | Faites passer uniquement les fichiers modifiés par Pro ; redirigez les vérifications simples vers Flash |
| Benchmark d’approvisionnement | Exécutez un mélange représentatif dans les créneaux de pointe et hors pointe |
Il ne s’agit pas seulement d’économiser la moitié du tarif token. Le plus grand bénéfice est la prévisibilité. Lorsque les équipes savent quels jobs DeepSeek V4 Pro sont autorisés à s’exécuter pendant les heures de pointe, la finance peut prévoir une facture au pire cas et l’ingénierie peut réserver Pro aux tâches qui en ont réellement besoin.
Flatkey peut prendre en charge ce modèle opérationnel en gardant la décision de routage, la politique de modèle et la revue d’utilisation au même endroit, au lieu de disperser des variables d’environnement dans les dépôts.
Quand DeepSeek V4 Pro vaut le tarif plus élevé
La tarification de l’API DeepSeek V4 Pro a du sens lorsque la charge de travail a suffisamment de valeur pour justifier le routage Pro. Les candidats typiques incluent :
- Des tâches d’agent de codage où une mauvaise réponse fait perdre du temps d’ingénierie.
- Une analyse à long contexte où la troncature ou une synthèse superficielle coûte plus cher que la facture token.
- Des revues d’approvisionnement, financières ou de conformité qui nécessitent un modèle plus robuste avant validation humaine.
- Des suites de benchmark qui comparent Pro à Flash et à d’autres modèles de pointe avant le déploiement.
- Des parcours produit à forte valeur où le taux de réponse acceptée compte davantage que le token généré le moins cher.
DeepSeek Flash est le meilleur choix par défaut pour de nombreuses tâches moins coûteuses ou plus parallélisables. Le routeur Flash actuel présente des tarifs token plus bas, une concurrence indiquée plus élevée et la prise en charge de la vision dans le tableau de tarification. Si vous hésitez encore entre les deux, utilisez DeepSeek V4 Pro vs Flash comme guide de sélection du modèle, puis ramenez le candidat final à cette feuille de calcul des coûts.
Contrôles pour empêcher la dérive des dépenses DeepSeek V4 Pro
Un guide de tarification doit se terminer par des contrôles, pas seulement par des tableaux. Pour DeepSeek V4 Pro, commencez par ceux-ci :
| Contrôle | Responsable | Ce que cela empêche |
|---|---|---|
| Liste d’autorisation des modèles | Ingénierie de plateforme | Utilisation accidentelle de Pro par des expériences ou des configurations copiées |
| Politique des heures de pointe | Produit et finance | Tâches batch non planifiées au tarif doublé |
| Nombre maximal de tokens de sortie | Équipe applicative | Réponses d’agent qui dépassent largement les besoins de sortie acceptés |
| Budget de retry | Responsable de la fiabilité | Multiplication silencieuse d’appels coûteux |
| Quotas par clé | Ingénierie de plateforme | Une application, un client ou un agent consommant le solde partagé |
| Revue du registre d’utilisation | Finance et ingénierie | Litiges sur le coût d’une équipe, d’un client ou d’un environnement |
| Canari de routage | Ingénierie de plateforme | Changements d’ID de modèle, de tarification ou de comportement introduits en production sans être remarqués |
Si votre équipe compare déjà des fournisseurs, ajoutez cet article au workflow plus large comment comparer les prix des modèles d’IA et à la checklist de tarification des passerelles IA.
Configuration compatible OpenAI via Flatkey
Si votre application utilise déjà la forme du SDK OpenAI, gardez le chemin de code stable et déplacez la sélection du fournisseur dans la configuration.
import OpenAI from "openai";

const client = new OpenAI({
  apiKey: process.env.FLATKEY_API_KEY,
  baseURL: "https://router.flatkey.ai/v1",
});

const response = await client.chat.completions.create({
  model: process.env.DEEPSEEK_PRO_MODEL || "deepseek-v4-pro",
  messages: [
    {
      role: "user",
      content: "Passe en revue ce résumé des risques liés à la mise en production et renvoie les trois changements présentant le risque le plus élevé.",
    },
  ],
  max_tokens: 4000,
});
Avant de mettre cela en production, vérifiez l’identifiant exact du modèle disponible pour votre compte, exécutez un canary de routage et comparez les lignes du registre obtenues avec la page officielle de tarification DeepSeek. Pour les détails de configuration, utilisez l’accès à l’API DeepSeek et le guide du catalogue des modèles d’IA.
Checklist de tarification de l’API DeepSeek V4 Pro
Utilisez cette checklist avant d’approuver Pro pour une charge de travail :
- Confirmez le tableau tarifaire officiel de
deepseek-v4-prole jour de l’approbation. - Séparez les estimations de jetons en heures de pointe et hors pointe.
- Estimez séparément les jetons d’entrée en cas de cache hit et de cache miss.
- Définissez une limite maximale de jetons de sortie par workflow.
- Suivez les résultats acceptés, pas seulement les réponses générées.
- Définissez des budgets de reprise sur erreur et de repli.
- Affectez une équipe, un environnement et une balise client à chaque clé ou requête.
- Comparez Pro à Flash pour les mêmes prompts.
- Examinez chaque semaine le registre d’utilisation Flatkey pendant le déploiement.
- Recalculez le prix de la route après toute mise à jour du modèle, de l’alias ou de la facturation DeepSeek.
La tarification de l’API DeepSeek V4 Pro est attractive lorsque la qualité de Pro améliore suffisamment le résultat accepté pour justifier le tarif plus élevé des jetons. Elle devient risquée lorsque le modèle est traité comme une route par défaut sans plafond.
FAQ
Quelle est la tarification actuelle de l’API DeepSeek V4 Pro ?
Au 11 octobre 2026, DeepSeek affiche deepseek-v4-pro à 0,022 $ par 1 M de jetons d’entrée en cache hit hors pointe et 0,044 $ en pointe, 0,66 $ par 1 M de jetons d’entrée en cache miss hors pointe et 1,32 $ en pointe, et 1,98 $ par 1 M de jetons de sortie hors pointe et 3,96 $ en pointe.
Les prix de pointe de DeepSeek V4 Pro sont-ils différents des prix hors pointe ?
Oui. DeepSeek indique que les tarifs hors pointe sont la moitié des tarifs de pointe. Les heures de pointe sont de 01:00 à 04:00 et de 06:00 à 10:00 UTC, du lundi au vendredi, hors jours fériés chinois. Toutes les autres heures sont hors pointe.
DeepSeek V4 Pro est-il toujours disponible après le 14 septembre 2026 ?
La page de mise à jour de DeepSeek indique qu’en réponse à la demande des utilisateurs, les services API pour DeepSeek V4 Pro se poursuivent après le 14 septembre 2026, le mode de facturation restant inchangé, et que DeepSeek fournira un préavis en cas de nouveaux changements.
Pourquoi la tarification des cache hits est-elle si importante pour DeepSeek V4 Pro ?
L’entrée en cache hit de DeepSeek V4 Pro est 30 fois moins chère que l’entrée en cache miss, aussi bien dans les tranches de pointe que hors pointe. Pour les prompts longs, les instructions système répétées et les manifestes d’outils d’agent, le taux de cache hit peut modifier sensiblement la facture mensuelle.
Dois-je utiliser DeepSeek V4 Pro ou DeepSeek Flash ?
Utilisez DeepSeek V4 Pro pour les charges de travail où la qualité, le comportement sur long contexte ou le taux de résultat accepté justifient le tarif plus élevé des jetons. Utilisez DeepSeek Flash pour les tâches à fort volume moins coûteuses, les charges de travail de vision et les jobs pour lesquels le modèle Flash actuel est suffisamment bon.
Comment Flatkey peut-il aider à contrôler la tarification de l’API DeepSeek V4 Pro ?
Flatkey offre aux équipes une clé API, un solde, une facture, des contrôles de routage et une visibilité sur le registre d’utilisation à travers les routes de modèles officielles. Cela permet aux équipes de consulter les dépenses DeepSeek V4 Pro à côté des autres coûts de modèles et de définir des quotas, des listes d’autorisation de modèles et des règles de repli dans un seul plan de contrôle.


