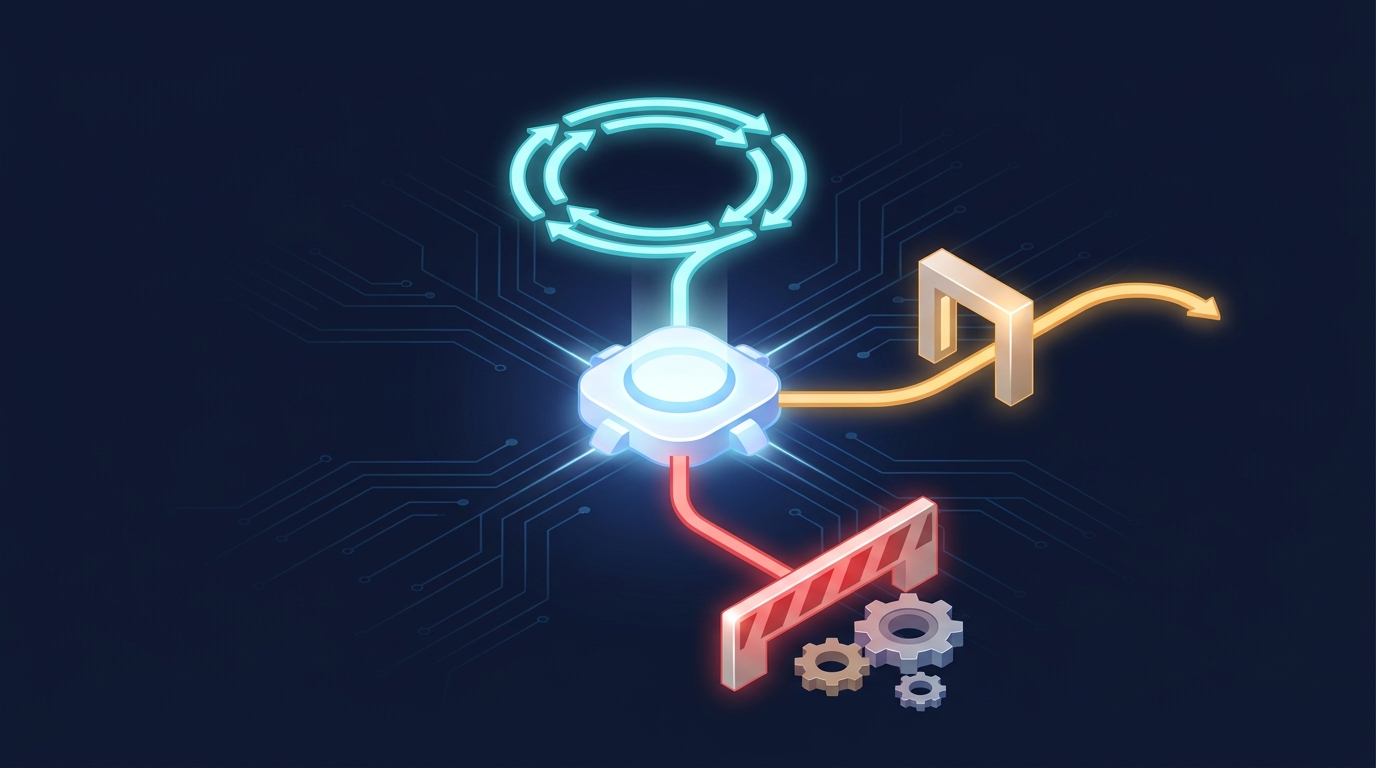
Model-Fallback ist kein einzelnes Verhalten. Es ist eine Reihe von Wiederherstellungsentscheidungen mit unterschiedlichen Sicherheitsgrenzen.
Eine produktive Model-Fallback-Strategie sollte drei Workflows trennen:
- Wiederholen oder gleichwertiges Failover, wenn die Anfrage noch sicher erneut ausgeführt werden kann.
- Cross-Model-Fallback, wenn ein anderes Modell dieselbe Fähigkeit und denselben Qualitätsvertrag erfüllen kann.
- Stoppen, abgleichen oder eskalieren, wenn die Ausgabe den Nutzer bereits erreicht hat oder ein Tool-Nebeneffekt möglicherweise bereits eingetreten ist.
Diese Trennung ist wichtig, weil die schnellste Wiederherstellungsaktion nicht immer die sicherste ist. Eine fehlgeschlagene Klassifizierungsanfrage erneut auszuführen, ist in der Regel wenig riskant. Mitten in einer gestreamten Antwort stillschweigend auf ein anderes Modell zu wechseln oder nach einem unsicheren Payment-Tool-Call ist es nicht.
Dieses Playbook macht aus der Fallback-Richtlinie drei operative Workflows, die Ihr Team implementieren, testen, beobachten und über einen kontrollierten Produktionsrollout freigeben kann.
Die Model-Fallback-Entscheidung in einer Tabelle
Beginnen Sie mit dem Anfragestatus, nicht mit dem Anbieternamen.
| Anfragestatus | Bevorzugter Workflow | Typische Aktion | Nicht tun |
|---|---|---|---|
| Keine Antwortbytes, vorübergehender Transportfehler | Workflow 1 | Begrenzte Wiederholung, dann Failover auf einen gleichwertigen Endpunkt | Ohne Deadline oder Budget erneut versuchen |
| Keine Antwortbytes, Rate Limit oder Überlastung | Workflow 1 | Retry-Hinweise befolgen, Jitter anwenden, dann zu gleichwertiger Kapazität wechseln | Einen synchronisierten Retry-Sturm erzeugen |
| Primäres Ziel nicht verfügbar, kompatibles Modell vorhanden | Workflow 2 | Den Fallback-Vertrag prüfen, dann auf das freigegebene Alternativmodell routen | Annehmen, dass jedes Modell dieselben Tools, dasselbe Schema oder denselben Kontext unterstützt |
| Strukturierte Antwort schlägt Validierung fehl | Workflow 2 | Einmal reparieren oder ein freigegebenes Modell versuchen, das den Schema-Vertrag erfüllt | HTTP 200 als Aufgabenerfolg behandeln |
| Teil-Stream bereits ausgeliefert | Workflow 3 | Stoppen, als teilweise markieren, einen expliziten Neustart anbieten | Ein zweites Modell unsichtbar in dieselbe Antwort einfügen |
| Write-Side-Tool könnte ausgeführt worden sein | Workflow 3 | Tool-Status mithilfe eines Idempotenz-Eintrags abgleichen | Den gesamten Modell-und-Tool-Workflow automatisch erneut abspielen |
| Sicherheits- oder Policy-Klassifizierung ist unklar | Workflow 3 | Gemäß Produktpolicy eskalieren oder fail closed | Die Sicherheitsanforderungen senken, um Verfügbarkeit zu erhalten |
Die Kernregel ist einfach: Wiederholen erhält das Ziel, gleichwertiges Failover erhält den Modellvertrag, und Cross-Model-Fallback verändert das Vertragsrisiko. Jeder Schritt benötigt eine strengere Berechtigungsprüfung.
Für eine vertiefte Betrachtung von Circuit Breakern, Fehler-Normalisierung und einem anbieterneutralen Controller siehe das LLM-API-Fallback-Routing-Playbook.
Vor den Workflows: einen Fallback-Envelope definieren
Jede Anfrage sollte mit einem begrenzten Envelope in die Routing-Schicht eintreten. Der Envelope teilt dem System mit, wie viel Wiederherstellung erlaubt ist, bevor die Anfrage gestoppt werden muss.
type FallbackEnvelope = {
  requestId: string;
  deadlineMs: number;
  maxAttempts: number;
  maxAddedLatencyMs: number;
  maxCostUsd?: number;
  allowEquivalentFailover: boolean;
  allowCrossModelFallback: boolean;
  allowAfterPartialOutput: false;
  sideEffectMode: "none" | "read_only" | "write_possible";
  requiredCapabilities: string[];
  requiredSchemaVersion?: string;
};
Die Werte sollten aus dem Produkt-Workflow stammen, nicht aus einem globalen Standard. Ein Hintergrundauftrag zur Zusammenfassung kann mehr Latenz tolerieren als ein interaktiver Coding-Assistent. Eine Chat-Antwort ohne Tools kann ein anderes Wiederherstellungsverhalten tolerieren als ein Agent, der Code bereitstellen oder E-Mails senden kann.
Der Envelope verhindert außerdem verschachtelte Wiederholungen. Wenn SDK, Anwendung, Gateway und Provider-Adapter alle unabhängig wiederholen, kann ein kleiner Vorfall in eine große Anstiegswelle von Versuchen münden. Wähle eine Ebene, die das gesamte Versuchskontingent verwaltet, und fordere von jeder darunterliegenden Ebene, zu melden, was sie bereits verbraucht hat.
Wandle den Fallback-Envelope in Policy as Code um
Eine Typdefinition dokumentiert die Absicht, aber das Produktionsrouting benötigt eine versionierte Policy, die Betreiber überprüfen können, ohne den Anwendungscode zu ändern. Halte die Policy klein genug für Audits und spezifisch genug, um zu verhindern, dass eine generische Fallback-Kette in Workflows mit hohem Risiko hineinleckt.
Diese Startkonfiguration trennt drei gängige Routenkategorien:
policy_version: 2026-08-02

routes:
  interactive_chat:
    deadline_ms: 12000
    max_attempts: 2
    max_added_latency_ms: 2500
    allow_equivalent_failover: true
    allow_cross_model_fallback: true
    allow_after_partial_output: false
    side_effect_mode: none
    required_capabilities: [streaming]

  structured_extraction:
    deadline_ms: 30000
    max_attempts: 3
    max_added_latency_ms: 8000
    allow_equivalent_failover: true
    allow_cross_model_fallback: true
    allow_after_partial_output: false
    side_effect_mode: none
    required_capabilities: [structured_output]
    required_schema_version: invoice-v4

  tool_agent_write:
    deadline_ms: 45000
    max_attempts: 2
    max_added_latency_ms: 5000
    allow_equivalent_failover: true
    allow_cross_model_fallback: false
    allow_after_partial_output: false
    side_effect_mode: write_possible
    required_capabilities: [tool_use]
Die obigen Werte sind Beispiele, keine universellen Schwellenwerte. Leite sie aus deinem nutzerseitigen Latenzziel, der Task-Ökonomie, Evaluierungsergebnissen und dem Risiko von Seiteneffekten ab. Die wichtige Designentscheidung ist, dass der Agent mit Schreibrechten nicht stillschweigend auf ein verhaltensmäßig anderes Modell wechseln kann.
Zur Laufzeit sollte der Router die Policy mit dem Request-Status und dem beobachteten Fehlerstatus kombinieren. Eine kompakte Entscheidungsfunktion kann die Grenze testbar machen:
type RecoveryAction =
  | "retry_same_target"
  | "failover_equivalent"
  | "fallback_approved_model"
  | "reconcile_side_effect"
  | "restart_required"
  | "stop";

function chooseRecovery(input: {
  errorClass: string;
  attemptsUsed: number;
  deadlineRemainingMs: number;
  partialOutput: boolean;
  sideEffectState: "none" | "safe" | "uncertain";
  equivalentAvailable: boolean;
  approvedAlternateAvailable: boolean;
  policy: FallbackEnvelope;
}): RecoveryAction {
  if (input.sideEffectState === "uncertain") return "reconcile_side_effect";
  if (input.partialOutput) return "restart_required";
  if (input.attemptsUsed >= input.policy.maxAttempts) return "stop";
  if (input.deadlineRemainingMs <= 0) return "stop";

  const transient = [
    "transport_transient",
    "rate_limited",
    "provider_overloaded",
    "provider_server_error",
  ].includes(input.errorClass);

  if (transient && input.attemptsUsed === 0) return "retry_same_target";
  if (transient && input.equivalentAvailable) return "failover_equivalent";

  if (
    input.policy.allowCrossModelFallback &&
    input.approvedAlternateAvailable
  ) {
    return "fallback_approved_model";
  }

  return "stop";
}
Halten Sie die Auswahl der Kandidaten getrennt von der Wiederherstellungsentscheidung. chooseRecovery entscheidet, welcher Workflow zulässig ist; ein Kandidaten-Selektor filtert dann Ziele nach Fähigkeiten, Kontext, Region, Kosten und Qualitätsrichtlinie. Diese Trennung erleichtert die Incident-Analyse, weil das Team unterscheiden kann zwischen „wir haben den falschen Recovery-Workflow gewählt“ und „wir haben das falsche alternative Modell gewählt“.
Versionieren Sie die Richtlinie und hängen Sie diese Version an jeden Attempt-Trace an. Wenn eine Fallback-Regressionsstörung auftritt, sollten Betreiber beantworten können, welche Richtlinie die Entscheidung getroffen hat, welche Kandidaten zulässig waren und welches Budget in diesem Moment noch verblieben war.
Workflow 1: erneut versuchen, dann auf äquivalentes Failover
Verwenden Sie diesen Workflow, wenn die Operation wiederholbar ist und das System weder teilweise Ausgaben offengelegt noch einen unsicheren Side-Effect-Zustand erreicht hat.
Ein äquivalentes Ziel ist ein anderer Pfad, der den wichtigen Vertrag beibehält: dieselbe Modellverhaltensklasse, erforderliche Fähigkeiten, Schema-Erwartungen, Sicherheitskonfiguration und kompatible Kontextgrenzen. Es kann eine andere Region, Bereitstellung, Provider-Endpunkt oder Kapazitäts-Pool sein.
Schritt 1: den Fehler normalisieren
Ordnen Sie provider-spezifische Antworten einer kleinen internen Taxonomie zu:
transport_transientrate_limitedprovider_overloadedprovider_server_errorauthentication_or_permissioninvalid_requestdeadline_exhaustedcontract_failurepartial_outputside_effect_uncertain
Nur die ersten vier qualifizieren sich normalerweise für automatisches Replaying. Authentifizierungs-, Berechtigungs- und ungültige Anforderungsfehler sollten stoppen, weil ein anderer Endpunkt die Anfrage wahrscheinlich nicht repariert. Vertragsfehler gehören in Workflow 2. Teilweise Ausgaben und unsichere Side Effects gehören in Workflow 3.
Schritt 2: das verbleibende Budget berechnen
Vor jedem Versuch prüfen:
verbleibende Zeit > geschätzte Latenz des nächsten Versuchs + Sicherheitspuffer für die Antwort
verbleibende Versuche > 0
verbleibende zusätzliche Latenz > 0
verbleibendes Kostenbudget > geschätzte Versuchskosten, wenn eine Kostengrenze existiert
Wenn ein erforderliches Budget erschöpft ist, beenden statt noch einen weiteren Anbieter zu versuchen.
Schritt 3: mit Backoff und Jitter erneut versuchen
Nutzen Sie nach Möglichkeit die Retry-Hinweise des Anbieters. Andernfalls wenden Sie exponentielles Backoff mit Jitter an und halten Sie die Verzögerung innerhalb der Request-Deadline.
function retryDelayMs(attempt: number, retryAfterMs?: number): number {
  if (retryAfterMs !== undefined) return retryAfterMs;

  const base = Math.min(250 * 2 ** attempt, 4_000);
  const jitter = Math.random() * base * 0.3;
  return Math.round(base + jitter);
}
Jitter ist wichtig, weil viele gleichzeitige Clients sonst im selben Takt erneut versuchen könnten und ein Überlastungsereignis verlängern. Ihr Leitfaden zu LLM-Rate-Limits sollte definieren, wie RPM, TPM, Queues, Parallelität und Retry-Budgets zusammenwirken.
Schritt 4: auf gleichwertige Kapazität umschalten
Wenn dasselbe Ziel weiterhin fehlerhaft ist, leiten Sie nur dann zu einem gleichwertigen Endpunkt um, nachdem Sie Folgendes geprüft haben:
- Der Circuit ist geschlossen oder halb offen für einen Probeversuch.
- Das Ziel unterstützt die erforderlichen Ein- und Ausgabe-Modi.
- Das Ziel kann die Anfrage innerhalb seines Kontextlimits verarbeiten.
- Das Ziel verwendet die erwartete Sicherheits- und Datenverarbeitungskonfiguration.
- Der Versuch passt weiterhin in das Deadline- und Kostenfenster.
Gleichwertiges Failover ist normalerweise weniger riskant als ein Modellwechsel, weil es darauf abzielt, den Antwortvertrag beizubehalten.
Schritt 5: den Wiederherstellungsgrund protokollieren
Geben Sie ein Route-Ergebnis zurück wie:
{
  "workflow": "retry_equivalent_failover",
  "primary_attempts": 2,
  "equivalent_failover_attempts": 1,
  "recovered": true,
  "recovery_reason": "provider_overloaded",
  "added_latency_ms": 684
}
Interne Anbieterdetails sollten Endnutzern nicht offengelegt werden, sofern Ihr Produkt diese Transparenz nicht ausdrücklich verspricht. Bewahren Sie sie jedoch in Traces und operativen Logs auf.
Workflow 2: kontrollierter plattformübergreifender Model-Fallback
Plattformübergreifender Model-Fallback ist nur dann angemessen, wenn das alternative Modell für die Aufgabe vorab freigegeben wurde. Ein Modell, das Text zurückgibt, reicht nicht aus; es muss den Workflow-Vertrag erfüllen.
Schritt 1: einen Fähigkeitsvertrag erstellen
Definieren Sie die unverhandelbaren Anforderungen für jede Routenkategorie.
{
  "route_class": "support_ticket_triage_v3",
  "required": {
    "input": ["text"],
    "output": ["json_schema"],
    "tools": [],
    "minimum_context_tokens": 24000,
    "schema": "triage-result-v3",
    "languages": ["en", "es", "de"],
    "safety_profile": "customer-support-standard"
  },
  "fallback_models": [
    "approved-model-b",
    "approved-model-c"
  ]
}
Für tool-basierte Pfade sollten Sie das Verhalten bei der Tool-Auswahl, die Unterstützung paralleler Tools, den Umgang mit Argument-Schemata und die Frage berücksichtigen, ob das Modell Bedingungen wie „do not call“ zuverlässig einhält. Bei strukturierten Ausgaben validieren Sie nach jedem Versuch die tatsächliche Antwort gegen das Schema.
Step 2: Transporterfolg von Aufgabenerfolg trennen
Eine HTTP-Erfolgsantwort kann den Produkt-Workflow dennoch fehlschlagen lassen. Bewerten Sie mindestens drei Ebenen:
- Transporterfolg: Der Anbieter hat eine vollständige Antwort zurückgegeben.
- Vertragserfolg: Die Antwort ließ sich parsen, entsprach dem Schema und verwendete unterstützte Tools korrekt.
- Aufgabenerfolg: Die Ausgabe hat die Aufgabe des Nutzers tatsächlich in einer akzeptablen Qualitätsstufe abgeschlossen.
Diese Unterscheidung ist beim Vergleich von Fallback-Kandidaten entscheidend. Ein Modell mit hoher Antwortrate, aber häufigen Schema- oder Tool-Fehlern ist kein zuverlässiger Fallback.
Step 3: Genehmigte Kandidaten nach Richtlinie ranken
Ein Produktions-Router kann geeignete Ziele anhand operativer Signale bewerten, ohne so zu tun, als sei ein Modell universell das beste.
type Candidate = {
  id: string;
  capabilitiesPass: boolean;
  circuitOpen: boolean;
  estimatedLatencyMs: number;
  estimatedCostUsd: number;
  recentContractSuccess: number;
  recentTaskSuccess: number;
};

function eligible(candidate: Candidate, envelope: FallbackEnvelope): boolean {
  return (
    candidate.capabilitiesPass &&
    !candidate.circuitOpen &&
    candidate.estimatedLatencyMs <= envelope.maxAddedLatencyMs &&
    (envelope.maxCostUsd === undefined ||
      candidate.estimatedCostUsd <= envelope.maxCostUsd)
  );
}
Vermeiden Sie für jede Aufgabe eine statische Liste aus „primary, backup, backup“. Das beste Fallback-Set für Code-Generierung kann sich von dem für Extraktion, Übersetzung, Vision oder Tool-Ausführung unterscheiden.
Step 4: Fallback-Ausgabe validieren
Wenden Sie zuerst deterministische Prüfungen an:
- JSON- oder Schema-Validierung
- Prüfung erforderlicher Felder
- Validierung von Tool-Argumenten
- Prüfungen für Zitations- oder URL-Formate
- Längen- und Sprachbeschränkungen
- Verbotene Ausgabe-Muster
Ergänzen Sie dann auf den Workflow abgestimmte Qualitätsprüfungen. Das können leichte Regeln, ein Task-Evaluator, stichprobenartige menschliche Prüfung oder ein validiertes Judge-Modell sein. Wenn das Qualitäts-Gate fehlschlägt, kennzeichnen Sie den Fallback nicht als wiederhergestellt.
Step 5: Canary-Richtlinienänderungen
Bevor Sie ein neues Fallback-Modell breiter ausrollen:
- Führen Sie ein offline evaluiertes Set erneut aus.
- Nutzen Sie Shadow Traffic, wo die Richtlinie dies zulässt.
- Aktivieren Sie den Kandidaten für einen kleinen Prozentsatz der geeigneten Fehlerfälle.
- Vergleichen Sie Vertragserfolg, Aufgabenerfolg, Latenz und Kosten.
- Erweitern Sie nur dann, wenn der Recovery-Wert das Regressionsrisiko überwiegt.
Verfolgen Sie diese Messwerte mit einem LLM API observability-Schema, das pro Versuch eine Route und einen Span erfasst.
Workflow 3: stoppen, abgleichen oder eskalieren
Manche Fehler sollten keinen weiteren Modellaufruf auslösen. Der richtige Fallback ist ein kontrollierter Stopp.
Fall 1: partieller Streaming-Output
Sobald Antwort-Tokens den Nutzer erreicht haben, kann ein stiller Modellwechsel Widersprüche, doppelte Inhalte, defekte Codeblöcke oder einen plötzlichen Stilwechsel erzeugen. Außerdem wird die finale Antwort dadurch schwer zuzuordnen und zu debuggen.
Verwenden Sie stattdessen eine dieser expliziten Ausgaben:
- Beenden Sie den Stream mit einem wiederherstellbaren Fehler und einer „Wiederholen“-Aktion.
- Bieten Sie an, die Antwort von Anfang an neu zu starten.
- Fahren Sie nur fort, wenn die Anwendung über ein vorgesehenes Resume-Protokoll verfügt und das neue Modell genau das akzeptierte Präfix erhält.
Der Standard sollte allowAfterPartialOutput: false sein.
Fall 2: unklare Tool-Nebenwirkungen
Angenommen, ein Modell hat ein Zahlungs-, E-Mail-, Bereitstellungs-, Ticket- oder Datenbank-Schreib-Tool ausgewählt. Das Tool kann erfolgreich gewesen sein, selbst wenn die Verbindung fehlgeschlagen ist, bevor Ihr Orchestrator das Ergebnis aufgezeichnet hat. Das erneute Ausführen des vollständigen Workflows kann die Nebenwirkung duplizieren.
Schützen Sie schreibende Tools mit:
- Einem Idempotenzschlüssel, der auf der Benutzeraktion basiert, nicht auf dem Anbieter-Versuch.
- Einem dauerhaften Ausführungsprotokoll mit den Zuständen
planned,started,succeeded,failedundunknown. - Entdoppelung an der Tool-Grenze.
- Eine Abgleichabfrage vor jedem erneuten Ausführen.
- Eine manuelle Prüfung für wirkungsstarke Aktionen, die weiterhin unklar bleiben.
type ToolExecution = {
  operationId: string;
  toolName: string;
  state: "planned" | "started" | "succeeded" | "failed" | "unknown";
  externalReference?: string;
};

function nextAction(execution: ToolExecution): "continue" | "reconcile" | "stop" {
  if (execution.state === "succeeded") return "continue";
  if (execution.state === "failed") return "stop";
  return "reconcile";
}
Halten Sie Anbieter-Anmeldedaten und Tool-Anmeldedaten getrennt. Der Leitfaden zur sicheren Verwaltung von API-Schlüsseln behandelt das umgebende Geheimnis- und Zugriffskontrollmodell.
Fall 3: Unsicherheit bei Sicherheit, Berechtigung oder Richtlinie
Verfügbarkeit sollte eine Sicherheits- oder Autorisierungsentscheidung nicht abschwächen. Wenn der Fallback-Kandidat die erforderlichen Richtlinienkontrollen nicht unterstützt, ist der Pfad nicht zulässig. Wenn das System nicht feststellen kann, ob eine Aktion erlaubt ist, schlagen Sie geschlossen fehl oder eskalieren Sie gemäß dem Risikomodell des Produkts.
Fall 4: Kein Kandidat erfüllt den Vertrag
Geben Sie einen typisierten Fehler zurück, den die Anwendung verarbeiten kann:
{
  "status": "unavailable",
  "reason": "no_eligible_fallback",
  "retryable": true,
  "retry_after_ms": 30000,
  "request_id": "req_123"
}
Eine klare degradierte Antwort ist besser als eine scheinbar erfolgreiche Antwort, die das Schema verletzt, die falschen Tools verwendet oder die falsche Nebenwirkung ausführt.
Bringen Sie die drei Workflows in eine einzige Zustandsmaschine
Die Orchestrierungsebene sollte den Übergang explizit machen.
START
  -> PRIMARY_ATTEMPT
     -> SUCCESS: validieren und zurückgeben
     -> TRANSIENT + wiederholbar: WORKFLOW_1
     -> CONTRACT_FAILURE + genehmigtes Alternativmodell: WORKFLOW_2
     -> PARTIAL_OUTPUT or SIDE_EFFECT_UNCERTAIN: WORKFLOW_3

WORKFLOW_1
  -> erneut innerhalb des Budgets versuchen
  -> gleichwertiges Failover innerhalb des Budgets
  -> wenn kompatibles Alternativmodell erlaubt ist: WORKFLOW_2
  -> andernfalls: STOP

WORKFLOW_2
  -> Fähigkeitsprüfung
  -> Alternativversuch
  -> Vertrags- und Aufgabenvalidierung
  -> nur bei validiertem Erfolg zurückgeben
  -> andernfalls: STOP

WORKFLOW_3
  -> partiellen oder unsicheren Zustand markieren
  -> externe Seiteneffekte nach Möglichkeit abgleichen
  -> expliziten Neustart oder menschliche Eskalation anbieten
  -> unsichere Arbeit niemals stillschweigend erneut ausführen
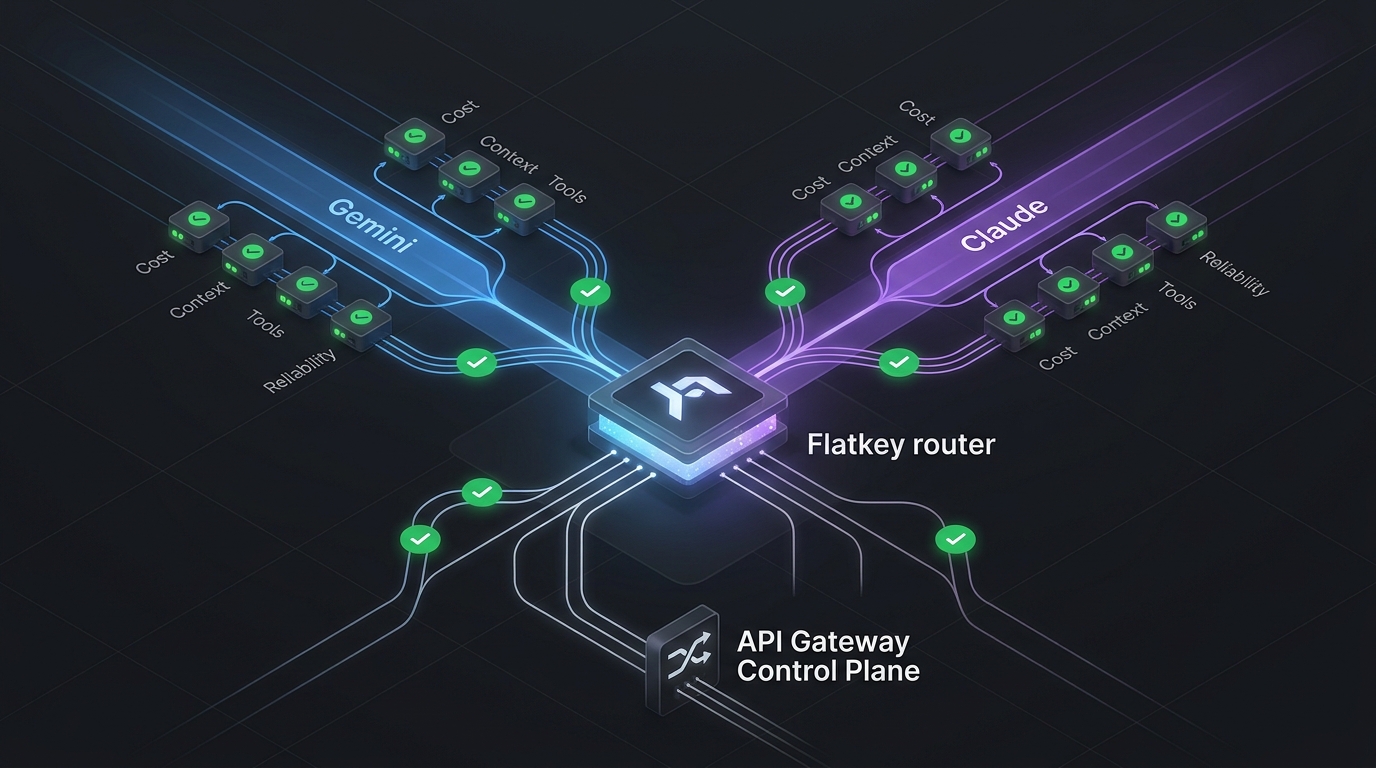
Dies ist auch die richtige Grenze für ein Multi-Model-Gateway. Die Zentralisierung des Modellzugriffs hinter einem OpenAI-kompatiblen Endpunkt kann die Integrationsduplizierung reduzieren, aber die Anwendung muss weiterhin die Workflow-Absicht bereitstellen: Fristen, Seiteneffektmodus, erforderliche Tools, Schema-Version und ob ein modellübergreifendes Fallback erlaubt ist. Flatkey bietet eine einheitliche API-Zugriffsschicht für Teams, die einen Schlüssel und eine Integrationsoberfläche für mehrere Modellanbieter möchten; die sicherste Routing-Policy beginnt dennoch mit expliziten Anwendungsvereinbarungen.
Führen Sie fünf Ausfall-Drills durch, bevor Sie automatisches Fallback aktivieren
Ein Fallback-Pfad, der nie einen kontrollierten Ausfall behandelt hat, ist nur ein Diagramm. Testen Sie jede Routenkategorie gegen Ausfälle, die eine andere Sicherheitsgrenze auslösen.
| Drill | Eingeführte Bedingung | Erwartetes Verhalten | Zu dokumentierende Belege |
|---|---|---|---|
| 1. Primäres Timeout | Verzögern Sie das Primärmodell über das Timeout pro Versuch hinaus | Nur erneut versuchen, wenn die Gesamtfrist und das Versuchslimit verbleiben | Zeitstempel der Versuche, Budget vor und nachher, endgültiger Routing-Grund |
| 2. Burst durch Ratenbegrenzung | Geben Sie eine begrenzte Serie von Rate-Limit-Antworten zurück | Jitter anwenden, Retry-Hinweise beachten und synchronisierte Retries vermeiden | Backoff-Verteilung, Warteschlangentiefe, Anzahl wiederhergestellter und fristüberschrittener Fälle |
| 3. Ungültige strukturierte Ausgabe | Geben Sie HTTP-Erfolg mit einem schema-ungültigen Body zurück | Vertragsfehler markieren, nur ein genehmigtes schemafähiges Alternativmodell versuchen, erneut validieren | Validierungsfehler, Datensatz zur Kandidatenberechtigung, Ergebnis der akzeptierten Aufgabe |
| 4. Verbindungsabbruch während des Streams | Beenden Sie die Verbindung nach nutzer sichtbaren Tokens | Den Stream stoppen und einen expliziten Neustart verlangen | Flag für partiellen Output, benutzerseitiger Zustand, Bestätigung, dass kein stiller Schnitt eingefügt wurde |
| 5. Mehrdeutiges Tool-Ergebnis | Verwerfen Sie die Antwort, nachdem ein Schreib-Tool möglicherweise ausgeführt wurde | Vor jeder Wiederholung über die Operations-ID abgleichen | Idempotenz-Datensatz, Abfrage des externen Zustands, Anzahl doppelter Seiteneffekte |
Führen Sie die Drills zunächst in einer lokalen oder Staging-Umgebung aus, dann an einem eng begrenzten Production Game Day. Das Ziel ist nicht zu beweisen, dass jede Anfrage überlebt. Es geht darum zu beweisen, dass das System in dem beabsichtigten Zustand fehlschlägt, genügend Belege zur Diagnose des Vorfalls liefert und nicht mehr Latenz, Kosten oder Seiteneffekt-Risiko verbraucht, als die Policy erlaubt.
Überprüfen Sie für jeden Drill vier Ebenen unabhängig voneinander:
- Entscheidungskorrektheit: Der Router wählte den vorgesehenen Workflow aus.
- Budgetkorrektheit: Alle Versuche blieben innerhalb der gemeinsamen Frist, der Versuchslimits und des Kostenrahmens.
- Ausgabekorrektheit: Das Endergebnis bestand die Vertrags- und Task-Validierung oder gab einen expliziten degradierten Status zurück.
- Audit-Korrektheit: Traces erfassten die Richtlinienversion, die Fehlerklasse, die Kandidatenberechtigung, den Routing-Grund und das für Benutzer sichtbare Ergebnis.
Wiederholen Sie den Drill immer dann, wenn Sie einen Provider-Adapter, den Retry-Owner, einen Modellkandidaten, die Schema-Version, den Tool-Vertrag oder die Streaming-Implementierung ändern. Diese Änderungen können die Replay-Sicherheit beeinflussen, selbst wenn die öffentliche API-Struktur unverändert erscheint.
Verwenden Sie vor der Produktion eine Scorecard zur Fallback-Bereitschaft
Einige Happy-Path-Tests zu bestehen, reicht nicht aus, um automatisches Fallback zu aktivieren. Ein Routing sollte sich die Automatisierung verdienen, indem es fünf unabhängige Release-Gates besteht.
| Gate | Bestandene Bedingung | Nachweis | Automatisches Fallback blockieren, wenn |
|---|---|---|---|
| Replay-Sicherheit | Das Team kann nachweisen, ob die Anfrage an jeder Versuchsschranke sicher wiederholt werden kann | Klassifizierung von Seiteneffekten, Idempotenz-Design, Regeln für Teil-Ausgaben | Es hätte ein Schreibvorgang ohne einen Reconciliation-Key stattgefunden haben können |
| Vertragskompatibilität | Jeder Kandidat unterstützt den erforderlichen Kontext, die Tools, das Schema, die Modalitäten und die Richtlinienkontrollen | Versionierte Fähigkeitsmatrix und Vertragstests | Kompatibilität wird aus der Modellfamilie oder Marketingbezeichnungen abgeleitet |
| Task-Qualität | Die Alternative liefert für die tatsächliche Arbeitslast des Routings akzeptable Ergebnisse | Route-spezifischer Evaluierungsdatensatz und geprüfte Fehlerfälle | Nur Transporterfolg oder generische Benchmark-Scores sind verfügbar |
| Budgetkontrolle | Retries und Fallbacks teilen sich eine Frist, ein Versuchslimit und eine Kostenobergrenze | Failure-Drill-Traces, die den Budgetverbrauch zeigen | Mehrere Ebenen können unabhängig voneinander erneut versuchen oder die Deadline des Aufrufers überschreiten |
| Operative Kontrolle | On-Call-Ingenieure können eine Fallback-Entscheidung identifizieren, deaktivieren und erklären | Richtlinienversion, Routing-Grund, Kill-Switch, Dashboard, Runbook | Der Wiederherstellungspfad kann nicht isoliert werden, ohne ein vollständiges Anwendungs-Deployment |
Behandeln Sie die Scorecard als Release-Artefakt. Erfassen Sie die Route-Klasse, die Richtlinienversion, freigegebene Kandidaten, die Evaluator-Version, die Drill-Ergebnisse, den Owner und das Review-Datum. Ein einzelner globaler Schalter „Fallback aktiviert“ verdeckt zu viel Risiko; die Freigabe sollte pro Workflow-Klasse erfolgen.
Kopierbarer Bereitschaftseintrag
fallback_readiness:
  route_class: support_ticket_extraction
  policy_version: fallback-v4
  owner: ai-platform
  primary_target: primary-model
  approved_candidates:
    - equivalent-deployment
    - alternate-model

  gates:
    replay_safety: pass
    contract_compatibility: pass
    task_quality: pass
    budget_control: pass
    operational_control: pass

  evidence:
    capability_matrix: contracts/support-ticket-v3.yaml
    evaluation_set: evals/support-ticket-2026-08.jsonl
    failure_drill_run: drills/2026-08-03.json
    dashboard: ai-routing/support-ticket
    runbook: runbooks/support-ticket-fallback.md

  release:
    mode: canary
    rollback_owner: oncall-ai-platform
    next_review_at: 2026-09-03
Die Datei muss nicht in genau diesem Format vorliegen. Entscheidend ist, dass die Freigabeentscheidung überprüfbar ist und an dieselbe Policy-Version gebunden ist, die in den Produktions-Traces aufgezeichnet wird.
Roll outen Sie eine Model-Fallback-Strategie in vier Phasen
Automatisches Fallback sollte nicht von einem Offline-Test direkt auf jede Produktionsanfrage springen. Verwenden Sie vier Phasen, die Entscheidungsfehler sichtbar machen, bevor sie für Nutzer sichtbar werden.
Phase 1: die Entscheidung shadown
Führen Sie den Fallback-Controller im Nur-Observationsmodus aus. Der primäre Pfad bestimmt weiterhin die Nutzerantwort, während der Controller aufzeichnet, was er getan hätte.
Prüfen Sie:
- Wie oft die Policy einen Fehler als erneut versuchbar einstuft.
- Wie oft ein Kandidat zulässig ist.
- Welches Budget die Wiederherstellung gestoppt hätte.
- Ob die Policy ein Fallback nach teilweise ausgegebenem Inhalt oder unsicheren Side Effects vorschlägt.
- Ob provider-normalisierte Fehler genügend Details für die Vorfallsdiagnose erhalten.
Der Shadow-Modus ist besonders nützlich, um zu breite Regeln zu finden, wie etwa „Fallback bei jedem 429“ oder „nach jedem Schemafehler ein anderes Modell versuchen“. Solche Regeln können im Code-Review vernünftig wirken, verhalten sich aber bei realen Request-States schlecht.
Phase 2: Low-Risk-Workflows als Canary ausrollen
Aktivieren Sie Fallback für einen kleinen Anteil an replay-sicheren Traffic, etwa für schreibgeschützte Klassifizierung, Extraktion oder Hintergrund-Zusammenfassungen. Schließen Sie Schreib-Tools, sicherheitssensitive Entscheidungen und Routen mit für Nutzer sichtbarem Streaming aus.
Vergleichen Sie den Canary mit dem Pfad nur mit Primärmodell anhand von Routenergebnissen:
- Rate der akzeptierten Aufgaben, nicht nur HTTP-Erfolg.
- Zusätzliche Latenz durch Wiederherstellung.
- Kostendifferenz pro akzeptierter Aufgabe.
- Fehler bei der Vertragsvalidierung nach Kandidat.
- Ausschöpfung der Deadline und Rate ohne zulässiges Fallback.
- Abbruch durch den Nutzer oder explizite Neustart-Rate.
Weiten Sie den Canary nicht allein deshalb aus, weil die Fehlerquote des Providers gesunken ist. Weiten Sie ihn nur aus, wenn das endgültige Nutzerergebnis akzeptabel bleibt und der Wiederherstellungspfad innerhalb seines Rahmens bleibt.
Phase 3: automatische Wiederherstellung nach Risikoklasse einschränken
Erweitern Sie nur die Workflow-Klassen, die den Readiness-Scorecard bestanden haben. Halten Sie die Policy-Unterschiede explizit:
| Risikoklasse | Standardautomatisierung | Erforderliche Schutzmaßnahme |
|---|---|---|
| Nur lesen, keine gestreamte Ausgabe | Wiederholen, gleichwertiges Failover, genehmigter modellübergreifender Fallback | Vertrags- und Aufgabenvalidierung |
| Nur lesen mit gestreamter Ausgabe | Wiederherstellung nur vor dem ersten für den Nutzer sichtbaren Byte | Zustand für Teil-Ausgaben und expliziter Neustart |
| Tool-Nutzung mit Nur-Lese-Tools | Wiederholen vor der Tool-Ausführung; alternativen Tool-Vertrag validieren | Tool-Schema- und Tool-Auswahl-Tests |
| Tool-Nutzung mit Schreibzugriff | Nach unklarer Ausführung stoppen und abgleichen | Persistente Operations-ID und externe Zustandsabfrage |
| Sicherheits-, Berechtigungs- oder Compliance-Entscheidung | Gemäß der genehmigten Richtlinie des Produkts fehlschlagen | Kein richtliniengetriebener Abbau der Verfügbarkeit |
In dieser Phase treffen Gateway und Anwendungs-Vertrag aufeinander. Das Gateway kann Fehler normalisieren, Budgets durchsetzen und berechtigte Kapazitäten auswählen. Die Anwendung muss dennoch angeben, ob Ausgabe entkommen ist, ob ein Nebeneffekt möglich ist und welche Qualitäts- oder Richtlinienprüfungen zwingend erforderlich sind.
Phase 4: schrittweise erweitern und Änderungen neu zertifizieren
Erhöhe den Traffic in begrenzten Schritten. Behalte bei jedem Schritt die Möglichkeit, eine Richtlinienversion, eine Routenkategorie, einen Provider-Adapter oder einen Kandidaten zu deaktivieren, ohne die gesamte Routing-Schicht abzuschalten.
Führe die relevanten Scorecard-Gates erneut aus, wenn sich eines der folgenden Dinge ändert:
- Modell oder Modellversion.
- Provider-Adapter oder Endpunkt.
- Prompt-Vorlage oder Systemanweisung.
- Tool-Definition oder Berechtigungsscope.
- Schema für strukturierte Ausgaben.
- Verantwortung für Wiederholungen oder Timeout-Konfiguration.
- Streaming-Transport oder Client-Verhalten.
- Sicherheitsrichtlinie oder Qualitätsbewertung.
Die Fallback-Bereitschaft verfällt, wenn sich ihre Annahmen ändern. Ein für einen früheren Prompt, ein früheres Schema oder einen früheren Tool-Satz genehmigter Kandidat sollte nicht aus Trägheit automatisch weiter berechtigt bleiben.
Definiere Rollback-Trigger, bevor du das Canary freischaltest
Ein Canary ist nur dann sicher, wenn das Team im Voraus vereinbart, was es stoppt. Verwende routenspezifische Trigger, statt auf einen breit angelegten Vorfall zu warten.
Rollback oder Deaktivierung der betroffenen Richtlinie, wenn du Folgendes beobachtest:
- Doppelte oder unklare Schreib-Nebeneffekte.
- Erfolg des modellübergreifenden Vertrags ohne akzeptablen Aufgabenerfolg.
- Einen Anstieg von Teil-Stream-Fehlern oder unsichtbarem Response-Splicing.
- Wiederholte Erschöpfung von Fristen durch Wiederherstellungsversuche.
- Überschrittene oder ignorierte Budgetobergrenzen.
- Kandidatenauswahl, die eine erforderliche Fähigkeit oder Sicherheitsrichtlinie verletzt.
- Eine unerklärliche Änderung der Verteilung der Fallback-Gründe nach einem Deploy.
- Fehlende Richtlinienversions- oder Versuchsebene-Trace-Daten während eines Vorfalls.
Die Rollback-Aktion sollte so eng gefasst sein wie der Fehler. Je nach Ereignis kann das bedeuten, einen einzelnen Kandidaten zu deaktivieren, eine Route nur auf gleichwertiges Failover zu erzwingen, allowCrossModelFallback auf false zu setzen, einen Circuit für einen Provider zu öffnen oder den Workflow wieder in den Nur-Primärmodus zurückzuversetzen.
Vermeiden Sie einen Rollback-Mechanismus, der einen Neuaufbau der Anwendung erfordert. Richtlinien für die Wiederherstellung ändern sich während Incidents häufig, und die sicherste Reaktion ist oft eine Konfigurationsänderung mit einer revisionssicheren Version statt eines Notfall-Code-Patches.
Verwenden Sie für jedes Fallback-Ereignis ein einziges Incident-Worksheet
Fallback-Incidents werden schwer zu diagnostizieren, wenn jeder Provider eine andere Fehlerform und jede Anwendung einen anderen Request-Status protokolliert. Erfassen Sie ein providerneutrales Worksheet.
fallback_incident:
  incident_id: inc-2026-08-03-001
  route_class: support_ticket_extraction
  request_id: req_123
  policy_version: fallback-v4

  request_state:
    output_started: false
    side_effect_mode: none
    tool_execution_state: not_started
    deadline_remaining_ms: 1820
    attempts_remaining: 1

  primary_failure:
    normalized_class: overloaded
    provider_status: 529
    retry_guidance_present: true

  recovery_decision:
    workflow: cross_model_fallback
    candidate: alternate-model
    reason: equivalent_capacity_unavailable

  validation:
    transport_success: true
    contract_success: true
    task_success: false
    failure_reason: required_field_omitted

  user_outcome:
    state: explicit_failure
    partial_output: false
    duplicate_side_effect: false

  containment:
    action: disable_candidate_for_route
    owner: oncall-ai-platform
Der wichtigste Unterschied ist der zwischen Recovery-Erfolg und User-Erfolg. Eine Fallback-Anfrage kann eine gültige HTTP-Antwort zurückgeben und dennoch das Schema verfehlen, das falsche Tool auswählen, eine erforderliche Information auslassen oder den Qualitätsschwellenwert der Route verletzen. Die Incident-Bewertung sollte das Ergebnis bis zur für den Nutzer sichtbaren Aufgabe vollständig nachverfolgen.
Führen Sie einen 60-minütigen Model-Fallback-Game-Day durch
Unit-Tests beweisen, dass einzelne Zweige ausgeführt werden. Ein Fallback-Game-Day beweist, dass das gesamte Wiederherstellungssystem korrekt funktioniert, während Deadlines, Retries, Streams, Validierung, Tools, Telemetrie und Operator-Steuerungen zusammenwirken.
Führen Sie die Übung jeweils nur für eine Workflow-Klasse durch. Beginnen Sie nicht mit einer globalen Simulation eines Provider-Ausfalls. Eine eng umrissene Route wie read-only Extraktion oder interne Zusammenfassung liefert klarere Belege und begrenzt den Blast Radius, falls die Policy falsch ist.
Definieren Sie die Game-Day-Charta
Schreiben Sie vor dem Einspielen eines Fehlers eine einseitige Charta. Die Charta verhindert, dass die Übung zu einem improvisierten Ausfall wird.
game_day:
  id: fallback-gd-2026-08-04-extraction
  route_class: structured_extraction
  policy_version: fallback-v4
  environment: staging
  exercise_owner: ai-platform
  incident_commander: reliability

  primary_target: primary-model
  approved_fallbacks:
    - equivalent-deployment
    - alternate-schema-capable-model

  traffic_scope:
    synthetic_requests: 100
    production_percentage: 0

  safety_limits:
    stop_after_minutes: 60
    max_error_rate_percent: 5
    max_duplicate_side_effects: 0
    max_unexplained_route_decisions: 0

  success_definition:
    - every request ends accepted, explicitly degraded, or safely stopped
    - no request exceeds the shared attempt budget
    - no partial stream is silently continued by another model
    - every fallback decision includes a policy version and route reason
Verwenden Sie zunächst synthetischen oder replay-sicheren Traffic. Wenn die Route Schreibvorgänge auslösen kann, ersetzen Sie das Tool durch ein kontrolliertes Testdouble oder eine Sandbox, die eine Idempotenzsuche unterstützt. Ein Game Day sollte Wiederherstellungssteuerungen testen und nicht mit dem Zustand von Kundendaten zocken.
Vier Rollen zuweisen
Halten Sie das Team klein genug, um schnell Entscheidungen zu treffen, aber trennen Sie Beobachtung von Ausführung.
| Rolle | Verantwortung während der Übung | Darfs nicht tun |
|---|---|---|
| Leiter der Übung | Startet Szenarien, steuert den Zeitplan und löst Stop-Bedingungen aus | Die Fallback-Richtlinie mitten im Szenario ändern, ohne dies zu protokollieren |
| Operator | Beobachtet den Zustand der Route, deaktiviert Kandidaten und verwendet den Kill-Switch | Fehler einbringen oder Belege bearbeiten |
| Beobachter | Protokolliert Zeitstempel, Screenshots, Traces und für Benutzer sichtbare Ergebnisse | Dem Router helfen, „zu bestehen“, indem Anfragen manuell korrigiert werden |
| Anwendungsinhaber | Beurteilt die Aufgabenqualität und die workflowspezifische Verschlechterung | Ein Ergebnis nur auf Basis von HTTP-Erfolg freigeben |
Für ein sehr kleines Team kann eine Person zwei Rollen übernehmen, aber die Person, die den Fehler einbringt, sollte nicht die einzige sein, die bewertet, ob das System korrekt reagiert hat.
Eine Szenario-Leiter aufbauen
Beginnen Sie mit dem am wenigsten mehrdeutigen Fehler und erhöhen Sie das Risiko erst, nachdem die Route die vorherige Stufe bestanden hat.
| Stufe | Einbringung | Was der Router nachweisen sollte | Voraussetzung für die Freigabe |
|---|---|---|---|
| 1. Sauberes gleichwertiges Failover | Den primären Endpunkt vor den Response-Bytes nicht verfügbar machen | Es kann auf gleichwertige Kapazität wechseln, ohne den Anwendungskontrakt zu ändern | Akzeptiertes Ergebnis, ein Routen-Grund, gemeinsames Budget eingehalten |
| 2. Retry-Druck | Einen begrenzten Burst aus wiederholbaren Fehlern zurückgeben | Backoff und Jitter funktionieren ohne Vervielfachung der Versuche | Keine verstärkte Wiederholungs-Explosion; Deadline bleibt maßgeblich |
| 3. Semantischer Vertragsfehler | Ein transportseitig erfolgreiches, aber ungültiges strukturiertes Ergebnis zurückgeben | Validierung, nicht der Statuscode, steuert die Annahme | Die Alternative ist zulässig und ihr Ergebnis besteht denselben Validator |
| 4. Teilweiser Stream | Nach sichtbarer Ausgabe die Verbindung trennen | Das System stoppt und markiert die Antwort als teilweise | Kein stilles Model-Splicing; Neustart ist explizit |
| 5. Ungewisse Tool-Abschlusserfüllung | Die Modellantwort verlieren, nachdem ein Write ausgeführt worden sein könnte | Der Workflow gleicht den externen Zustand vor dem Replay ab | Operation-ID-Lookup wird abgeschlossen; doppelte Writes bleiben bei null |
| 6. Fallback-Degradation | Die freigegebene Alternative langsamer oder qualitativ schlechter machen | Stop-Loss- und Rollback-Regeln setzen sich über den Verfügbarkeitsdruck hinweg durch | Kandidat wird entfernt oder die Automatisierung wird beim vordefinierten Schwellenwert deaktiviert |
Springen Sie nicht direkt zu einem komplizierten Cross-Model-Szenario. Wenn ein gleichwertiges Failover Budget und Trace-Vertrag nicht bewahren kann, wird das Hinzufügen eines verhaltensseitig anderen Modells die Diagnose erschweren, nicht realistischer machen.
Fehler an expliziten Grenzen einbringen
Beschriften Sie die genaue Grenze, an der der Fehler in den Request-Lebenszyklus eintritt. „Provider failed“ ist für einen nützlichen Testbericht zu vage.
type InjectionPoint =
  | "before_connect"
  | "after_connect_before_headers"
  | "after_headers_before_body"
  | "after_partial_stream"
  | "after_tool_dispatch_before_ack"
  | "after_tool_ack_before_model_response"
  | "after_transport_success_before_validation";
Die Grenze bestimmt, welche Wiederherstellungsmaßnahmen sicher sind. Ein Timeout vor der Verbindung kann oft erneut versucht werden. Eine Trennung, nachdem ein Nutzer Ausgaben gesehen hat, erfordert einen expliziten Neustart. Eine verlorene Bestätigung nach einem Tool-Aufruf auf der Schreibseite erfordert eine Abstimmung. Alle drei als dieselbe Timeout-Klasse zu behandeln, ist der Weg, auf dem doppelte Aktionen und inkohärente Antworten in die Produktion gelangen.
Wenn deine Fault-Injection-Schicht diese Grenzen nicht anvisieren kann, füge den Grenzmarker vor der Übung zum Provider-Adapter oder zur Orchestrierungsschicht hinzu. Grobe Failure-Toggles sind nützlich für Verfügbarkeitstests, aber unzureichend für Replay-Safety-Tests.
Erfasse eine Evidenzzeile pro Anfrage
Der Game Day sollte ein Protokoll auf Anfragenebene erzeugen, nicht nur Dashboard-Screenshots. Eine kompakte Zeile macht ungeklärte Entscheidungen sichtbar.
| Feld | Beispiel | Warum es wichtig ist |
|---|---|---|
request_id |
req_01J... |
Verknüpft Gateway-, Modell-, Validator- und Tool-Evidenz |
scenario_id |
partial-stream-01 |
Verbindet das Ergebnis mit der injizierten Bedingung |
policy_version |
fallback-v4 |
Belegt, welche Routing-Regeln die Entscheidung getroffen haben |
failure_class |
stream_interrupted |
Trennt Transport-, Vertrags-, Policy- und Tool-Unsicherheit |
injection_point |
after_partial_stream |
Stellt Replay-Sicherheit her |
attempts_used |
1/2 |
Erkennt Retry-Verstärkung |
elapsed_ms |
4830/12000 |
Zeigt das verbleibende Deadline-Budget |
cost_budget_state |
within |
Verhindert, dass die Wiederherstellung die Stückkosten ignoriert |
selected_action |
restart_required |
Dokumentiert die Entscheidung des Routers |
candidate_id |
none |
Zeigt, ob ein anderes Modell berücksichtigt wurde |
validator_result |
not_run |
Trennt Transport-Wiederherstellung von der Aufgabenannahme |
side_effect_state |
none |
Macht Anforderungen an die Abstimmung explizit |
user_outcome |
partial_marked |
Erfasst, was der Kunde erlebt hat |
operator_action |
none |
Unterscheidet automatische Wiederherstellung von manueller Eindämmung |
Speichere das Protokoll neben dem Policy-Snapshot, der Validator-Version, der Fehlkonfiguration und dem Dashboard-Export. Ohne diese Versionen kann eine bestandene Übung nach der nächsten Adapter- oder Modelländerung nicht reproduziert werden.
Bewerte die Übung mit Beförderungsregeln
Verwenden Sie drei mögliche Entscheidungen: freigeben, beheben und erneut ausführen oder Automatisierung stoppen. Vermeiden Sie ein vages Ergebnis wie „größtenteils bestanden“.
Geben Sie die Route nur frei, wenn alle folgenden Punkte zutreffen:
- Jede Anfrage hat einen erklärten Endzustand.
- Keine Versuchskette überschreitet die gemeinsame Frist, die Anzahl der Versuche oder die konfigurierte Kostengrenze.
- Jede akzeptierte Ausgabe besteht den Validator oder die Bewertungsregel der Route.
- Teilweise Ausgabe und unklare Seiteneffekte münden in explizite Stopp- oder Abstimmungszustände.
- Betreiber können einen Kandidaten oder die gesamte Richtlinie deaktivieren, ohne Anwendungscode bereitzustellen.
- Das Alerting identifiziert sowohl Wiederherstellungsfehler als auch schädliche Wiederherstellungen, etwa einen Fallback-Erfolg mit inakzeptabler Aufgabenqualität.
Wählen Sie beheben und erneut ausführen, wenn das Sicherheitsmodell korrekt ist, aber Nachweise oder Implementierung unvollständig sind. Beispiele sind ein fehlender Routen-Grund, ein Alert, der zu spät auslöst, oder ein Kandidat, der den Vertrag erfüllt, aber das Latenzziel verfehlt.
Wählen Sie Automatisierung stoppen, wenn der Test Mehrdeutigkeiten bei der Wiedergabe, doppelte Seiteneffekte, stilles Stream-Splicing, nicht erklärte Weiterleitung, Umgehung von Richtlinien oder einen Fehlermodus aufdeckt, den der aktuelle Zustandsautomat nicht abbilden kann. Das sind Designlücken, keine Tuning-Probleme.
Verwenden Sie eine kopierbare Game-Day-Scorecard
game_day_result:
  game_day_id: fallback-gd-2026-08-04-extraction
  route_class: structured_extraction
  policy_version: fallback-v4
  evaluator_version: extraction-eval-v7
  started_at: 2026-08-04T09:00:00Z
  completed_at: 2026-08-04T10:00:00Z

  scenarios:
    equivalent_failover: pass
    retry_pressure: pass
    semantic_contract_failure: pass
    partial_stream: pass
    uncertain_tool_completion: not_applicable
    fallback_degradation: fix

  totals:
    requests: 100
    accepted: 94
    explicitly_degraded: 6
    unsafe_or_unexplained: 0
    duplicate_side_effects: 0
    deadline_violations: 0

  decision: fix_and_rerun
  blockers:
    - alternate p95 latency exceeded the route objective during degradation
  owner: ai-platform
  rerun_due: 2026-08-11
Die Beispielwerte sind illustrativ. Verwenden Sie Ihre eigenen Routen-Ziele und Bewertungsschwellen. Entscheidend ist, dass die endgültige Entscheidung auf erhaltene Nachweise und einen benannten Verantwortlichen verweist.
Verwandeln Sie Erkenntnisse in Release-Kontrollen
Beenden Sie den Game Day, indem Sie jede Erkenntnis in eine von vier dauerhaften Kontrollen überführen:
- Richtlinienänderung: Berechtigungen für Kandidaten, Versuchsbudget, Frist oder Regel der Routenklasse.
- Vertragstest: Prüfung auf Kompatibilität von Fähigkeit, Schema, Tool, Streaming oder Sicherheit.
- Operative Kontrolle: Alert, Dashboard, Kill Switch, Kandidaten-Quarantäne oder Incident-Verfahren.
- Produktverhalten: expliziter Neustart, Meldung über einen degradierten Zustand, manuelle Bestätigung oder Abstimmungsbildschirm.
Schließen Sie den Test nicht mit einer Liste von Beobachtungen ab. Eine Erkenntnis ohne Verantwortlichen, Kontrollyp und erneute Ausführungsbedingung wird bei einem echten Vorfall wieder auftauchen.
Für die Telemetrieebene hinter diesen Übungen verwenden Sie den LLM-API-Observability-Guide. Für die Verantwortung bei Retries und das Verhalten bei Ratenlimits kombinieren Sie den Game Day mit dem LLM rate limits and retry strategy. Wenn Ihr Team die Gateway-Grenze noch definiert, beginnen Sie mit dem LLM gateway beginner guide.
A seven-day implementation sequence
Teams können diese Reihenfolge nutzen, um von einer ad-hoc-Modellliste zu einem kontrollierten Workflow-Playbook zu gelangen:
- Tag 1 — Routen inventarisieren: klassifizieren Sie Ausgabeart, Risiko von Nebenwirkungen, Tools, Schemas, Deadlines und die aktuellen Retry-Verantwortlichen.
- Tag 2 — Umschläge definieren: legen Sie Versuchs-, Latenz-, Kosten-, Fähigkeits- und Wiederholungsgrenzen pro Routenkategorie fest.
- Tag 3 — Verträge erstellen: dokumentieren Sie freigegebene Kandidaten und testen Sie Tool-, Schema-, Kontext-, Modalitäts- und Richtlinienkompatibilität.
- Tag 4 — Entscheidungen instrumentieren: erfassen Sie normalisierte Fehler, Request-Status, Richtlinienversion, Kandidatenberechtigung, Budget, Validierung und Benutzerergebnis.
- Tag 5 — Fehlerszenarien durchspielen: injizieren Sie Timeouts, Ratenlimit-Bursts, ungültige Ausgaben, Verbindungsabbrüche während des Streams und unklare Tool-Ausführung.
- Tag 6 — Shadow und Canary: beobachten Sie zunächst die Entscheidungen und aktivieren Sie dann eine enge Route mit geringem Risiko und vordefinierten Rollback-Triggern.
- Tag 7 — Überprüfen und ausweiten: prüfen Sie die Rate akzeptierter Aufgaben, zusätzliche Latenz, Kostendifferenz, unsichere Wiederholungs-Signale und Ereignisse ohne geeigneten Fallback, bevor Sie erweitern.
Die Reihenfolge ist bewusst workflow-first ausgerichtet. Die Wahl einer sortierten Modellauswahl ist nur ein kleiner Schritt. Die eigentliche Produktionsarbeit besteht darin nachzuweisen, wann das System fortfahren darf, wann es validieren muss und wann es stoppen muss.
Model fallback strategy rollout checklist
Policy
- Jede Routenkategorie hat einen Fallback-Rahmen.
- Die Fallback-Richtlinie ist versioniert und als Konfiguration überprüfbar.
- Wiederholbare Fehler werden über Anbieter hinweg normalisiert.
- Das gesamte Retry-Budget hat genau einen Verantwortlichen.
- Gleichwertige Endpunkte werden von alternativen Modellen unterschieden.
- Kandidaten für modellübergreifende Nutzung haben versionierte Fähigkeitsverträge.
- Teilweise Ausgaben deaktivieren transparenten Fallback standardmäßig.
- Tools auf der Write-Seite verwenden dauerhafte Idempotenz-Records.
Validation
- Transport-, Vertrags- und Task-Erfolg werden separat gemessen.
- Strukturierte Ausgaben werden nach dem Fallback validiert.
- Tool-Argumente und das Verhalten bei der Tool-Auswahl werden pro Modell getestet.
- Fallback-Bewertungssets repräsentieren reale Routenkategorien.
- Neue Kandidaten bestehen eine Offline-Evaluierung und ein Production-Canary.
- Alle fünf Fehlerszenarien werden für jede anwendbare Routenkategorie bestanden.
Operations
- Jeder Versuch protokolliert Routing-Grund, Ziel, Latenz und Ergebnis.
- Dashboards zeigen Primary-, Retry-, Equivalent-Failover- und Cross-Model-Recovery getrennt an.
- Warnmeldungen umfassen Deadline-Erschöpfung und No-Eligible-Fallback-Raten.
- Circuit Breaker verwenden kontrollierte Half-Open-Probes.
- Die Incident-Analyse umfasst die für Nutzer sichtbare Qualität und das Risiko doppelter Seiteneffekte.
- Jeder Attempt-Trace protokolliert die aktive Version der Fallback-Richtlinie.
- Jeder Route ist ein vollständiges Readiness-Scorecard und ein benannter Owner zugeordnet.
- Canary-Rollback-Trigger und schmale Kill Switches werden getestet.
- Incident-Workflows erfassen Request-Status, Validierung und Nutzerergebnis.
Metriken, die belegen, dass Fallback hilft
Optimieren Sie nicht nur auf die Fehlerrate des Anbieters. Verfolgen Sie das Nutzerergebnis.
| Metrik | Beantwortete Frage |
|---|---|
| Retry-Recovery-Rate | Lohnen sich Wiederholungen gegen dasselbe Ziel trotz ihrer Latenz? |
| Equivalent-Failover-Recovery-Rate | Stellt redundante Kapazität den Dienst sicher wieder her? |
| Cross-Model-Contract-Erfolg | Erfüllt die alternative Antwort die erforderliche Schnittstelle? |
| Cross-Model-Task-Erfolg | Schließt der Nutzer die beabsichtigte Aufgabe weiterhin ab? |
| Zusätzliche Fallback-Latenz | Wie viel Verzögerung fügt die Wiederherstellung hinzu? |
| Fallback-Kosten-Delta | Wie hoch sind die Kosten des Wiederherstellungswegs? |
| Partial-Stream-Fehlerrate | Wie oft erreicht das System einen nicht wiederherstellbaren Darstellungszustand? |
| Side-Effect-Reconciliation-Rate | Wie oft muss das System vor dem Fortfahren externen Zustand verifizieren? |
| Vorfälle mit doppelten Seiteneffekten | Ist der Schutz vor Wiederholungen fehlgeschlagen? |
| No-Eligible-Fallback-Rate | Sind die Route-Verträge zu strikt, oder reicht die Kapazität nicht aus? |
Segmentieren Sie diese Metriken nach Routenkategorie. Eine aggregierte Recovery-Rate kann verschleiern, dass Fallback für Extraktion gut funktioniert, aber für Codegenerierung oder Tool-Nutzung schlecht.
Vergleichen Sie diese Metriken während der Einführung nach Richtlinienversion und Release-Phase. So lässt sich ein Vorfall beim Anbieter von einer Controller-Änderung, einer Kandidatenänderung oder einer erweiterten Canary-Phase trennen.
Häufig gestellte Fragen
Was ist eine Model-Fallback-Strategie?
Eine Model-Fallback-Strategie ist eine Richtlinie dafür, wann eine KI-Anfrage das gleiche Ziel erneut versuchen, auf gleichwertige Kapazität ausweichen, auf ein genehmigtes alternatives Modell wechseln oder stoppen sollte, weil ein Replay unsicher wäre.
Was ist der Unterschied zwischen Retry und Fallback?
Ein Retry wiederholt die Anfrage gegen dasselbe Ziel oder denselbe Deployment. Equivalent Failover verschiebt die Anfrage auf Kapazität, die denselben Model-Contract beibehalten soll. Cross-Model-Fallback wechselt das Modell und erfordert daher eine Validierung von Fähigkeiten und Qualität.
Sollte jeder 429-Fehler ein anderes Modell auslösen?
Nein. Klassifizieren Sie zuerst die Begrenzung, beachten Sie die Retry-Hinweise, prüfen Sie die verbleibende Deadline und verwenden Sie einen begrenzten Retry oder eine Warteschlange. Das Wechseln des Modells kann helfen, wenn genehmigte alternative Kapazität vorhanden ist, aber es kann auch Ausgabequalität, Tool-Verhalten oder Kosten verändern.
Kann eine gestreamte Antwort mitten im Antworttext auf Fallback wechseln?
Es ist in der Regel sicherer, nicht transparent umzuschalten, nachdem Tokens den Nutzer erreicht haben. Beenden Sie den Stream und bieten Sie einen expliziten Neustart an, sofern die Anwendung nicht über ein getestetes Resume-Protokoll verfügt.
Wie viele Fallback-Modelle sollte eine Route haben?
Verwenden Sie die kleinste freigegebene Menge, die eine sinnvolle Wiederherstellung ermöglicht. Jeder Kandidat erhöht den Aufwand für Evaluation, Monitoring und Incident Response. Eine lange, ungetestete Liste ist keine Resilienz.
Wo sollte die Fallback-Logik leben?
Zentralisieren Sie Provider-Normalisierung, Routing, Versuchsbudgets und Observability in einem Gateway oder einer Orchestrierungsschicht. Halten Sie workflow-spezifische Aspekte – Risiko von Side Effects, Schema-Anforderungen, Sicherheitsrichtlinien und Qualitätsgrenzen – nah an der Anwendung.
Wie sollte ein Team automatisches Model-Fallback einführen?
Beginnen Sie im Shadow-Modus, führen Sie Canary-Tests nur für replay-sichere Workflows durch, definieren Sie Rollback-Trigger, bevor Sie den Traffic ausweiten, und zertifizieren Sie die Fallback-Policy erneut, sobald sich Modelle, Prompts, Tools, Schemas, Retry-Verantwortung oder Sicherheitsanforderungen ändern.
Fallback am Workflow-Risiko ausrichten
Die beste Model-Fallback-Strategie lautet nicht „probier das nächste Modell“. Sie ist ein begrenztes Entscheidungssystem:
- Workflow 1 stellt wiederholbare Anfragen mit Retries und gleichwertiger Kapazität wieder her.
- Workflow 2 wechselt Modelle erst nach Capability- und Qualitätsprüfungen.
- Workflow 3 stoppt die automatische Wiederholung, wenn Ausgabe oder Side Effects eine Wiederherstellung unsicher machen.
Dieses Design verbessert die Verfügbarkeit, ohne Vertragsfehler zu verbergen oder Benutzeraktionen zu duplizieren. Wenn Ihr Team den Zugriff über Modellanbieter hinweg standardisiert, nutzen Sie die einheitliche, OpenAI-kompatible API-Schicht von Flatkey als Integrationsoberfläche und hängen Sie dann diese workflow-spezifischen Hüllen an jede Produktionsroute an.