El fallback de modelos no es un único comportamiento. Es un conjunto de decisiones de recuperación con distintos límites de seguridad.
Una estrategia de fallback de modelos en producción debe separar tres flujos de trabajo:
- Reintento o failover equivalente cuando la solicitud sigue siendo segura para reenviarse.
- Fallback entre modelos cuando otro modelo puede satisfacer la misma capacidad y el mismo contrato de calidad.
- Detener, conciliar o escalar cuando la salida ya ha llegado al usuario o puede haber ocurrido un efecto secundario de una herramienta.
Esa separación importa porque la acción de recuperación más rápida no siempre es la más segura. Reenviar una solicitud de clasificación fallida suele tener poco riesgo. Cambiar silenciosamente de modelo a mitad de una respuesta transmitida o después de una llamada incierta a una herramienta de pago no lo es.
Este playbook convierte la política de fallback en tres flujos de trabajo operativos que su equipo puede implementar, probar, observar y liberar mediante una implementación controlada en producción.
La decisión de fallback de modelos en una tabla
Empiece por el estado de la solicitud, no por el nombre del proveedor.
| Estado de la solicitud | Flujo de trabajo preferido | Acción típica | No hacer |
|---|---|---|---|
| Sin bytes de respuesta, error transitorio de transporte | Flujo de trabajo 1 | Reintento acotado, luego failover a un endpoint equivalente | Reintentar sin un plazo límite ni presupuesto |
| Sin bytes de respuesta, límite de tasa o sobrecarga | Flujo de trabajo 1 | Respetar la guía de reintento, aplicar jitter y luego pasar a capacidad equivalente | Crear una tormenta de reintentos sincronizada |
| El objetivo principal no está disponible, existe un modelo compatible | Flujo de trabajo 2 | Verificar el contrato de fallback y luego enrutar al alternativo aprobado | Asumir que todos los modelos admiten las mismas herramientas, esquema o contexto |
| La respuesta estructurada falla la validación | Flujo de trabajo 2 | Reparar una vez o probar un modelo aprobado que cumpla el contrato de esquema | Tratar HTTP 200 como éxito de la tarea |
| Ya se ha entregado una transmisión parcial | Flujo de trabajo 3 | Detener, marcar como parcial, ofrecer un reinicio explícito | Empalmar un segundo modelo en la misma respuesta de forma invisible |
| Es posible que se haya ejecutado una herramienta de escritura | Flujo de trabajo 3 | Conciliar el estado de la herramienta usando un registro de idempotencia | Repetir automáticamente todo el flujo de trabajo de modelo y herramienta |
| La clasificación de seguridad o de política es incierta | Flujo de trabajo 3 | Escalar o fallar cerrado según la política del producto | Bajar el listón de seguridad para preservar la disponibilidad |
La regla central es simple: el reintento preserva el objetivo, el failover equivalente preserva el contrato del modelo y el fallback entre modelos cambia el riesgo del contrato. Cada paso necesita una comprobación de elegibilidad más estricta.
Para un tratamiento más profundo de circuit breakers, normalización de errores y un controlador agnóstico al proveedor, consulte el playbook de enrutamiento de fallback para API de LLM.
Antes de los flujos de trabajo: defina un envelope de fallback
Toda solicitud debe entrar en la capa de enrutamiento con un envelope acotado. El envelope le indica al sistema cuánta recuperación se permite antes de que la solicitud deba detenerse.
type FallbackEnvelope = {
  requestId: string;
  deadlineMs: number;
  maxAttempts: number;
  maxAddedLatencyMs: number;
  maxCostUsd?: number;
  allowEquivalentFailover: boolean;
  allowCrossModelFallback: boolean;
  allowAfterPartialOutput: false;
  sideEffectMode: "none" | "read_only" | "write_possible";
  requiredCapabilities: string[];
  requiredSchemaVersion?: string;
};
Los valores deben provenir del flujo de trabajo del producto, no de un valor predeterminado global. Un trabajo de resumido en segundo plano puede tolerar más latencia que un asistente de programación interactivo. Una respuesta de chat sin herramientas puede tolerar un comportamiento de recuperación distinto al de un agente que puede desplegar código o enviar correo electrónico.
El sobre también evita reintentos anidados. Si el SDK, la aplicación, la pasarela y el adaptador del proveedor reintentan de forma independiente, un incidente pequeño puede multiplicarse en una gran ráfaga de intentos. Elige una capa para que sea responsable del presupuesto total de intentos y exige que cada capa inferior informe de lo que ya consumió.
Convierte el sobre de fallback en política como código
Una definición de tipo documenta la intención, pero el enrutamiento en producción necesita una política versionada que los operadores puedan revisar sin cambiar el código de la aplicación. Mantén la política lo bastante pequeña para poder auditarla y lo bastante específica para evitar que una cadena de fallback genérica se filtre en flujos de trabajo de alto riesgo.
Esta configuración inicial separa tres clases de ruta comunes:
policy_version: 2026-08-02

routes:
  interactive_chat:
    deadline_ms: 12000
    max_attempts: 2
    max_added_latency_ms: 2500
    allow_equivalent_failover: true
    allow_cross_model_fallback: true
    allow_after_partial_output: false
    side_effect_mode: none
    required_capabilities: [streaming]

  structured_extraction:
    deadline_ms: 30000
    max_attempts: 3
    max_added_latency_ms: 8000
    allow_equivalent_failover: true
    allow_cross_model_fallback: true
    allow_after_partial_output: false
    side_effect_mode: none
    required_capabilities: [structured_output]
    required_schema_version: invoice-v4

  tool_agent_write:
    deadline_ms: 45000
    max_attempts: 2
    max_added_latency_ms: 5000
    allow_equivalent_failover: true
    allow_cross_model_fallback: false
    allow_after_partial_output: false
    side_effect_mode: write_possible
    required_capabilities: [tool_use]
Los valores anteriores son ejemplos, no umbrales universales. Defínelos a partir de tu objetivo de latencia orientado al usuario, la economía de la tarea, los resultados de evaluación y el riesgo de efectos secundarios. La decisión de diseño importante es que el agente con capacidad de escritura no pueda cambiar silenciosamente a un modelo con un comportamiento diferente.
En tiempo de ejecución, el enrutador debe combinar la política con el estado de la solicitud y el estado de fallo observado. Una función de decisión compacta puede hacer que el límite sea comprobable:
type RecoveryAction =
  | "retry_same_target"
  | "failover_equivalent"
  | "fallback_approved_model"
  | "reconcile_side_effect"
  | "restart_required"
  | "stop";

function chooseRecovery(input: {
  errorClass: string;
  attemptsUsed: number;
  deadlineRemainingMs: number;
  partialOutput: boolean;
  sideEffectState: "none" | "safe" | "uncertain";
  equivalentAvailable: boolean;
  approvedAlternateAvailable: boolean;
  policy: FallbackEnvelope;
}): RecoveryAction {
  if (input.sideEffectState === "uncertain") return "reconcile_side_effect";
  if (input.partialOutput) return "restart_required";
  if (input.attemptsUsed >= input.policy.maxAttempts) return "stop";
  if (input.deadlineRemainingMs <= 0) return "stop";

  const transient = [
    "transport_transient",
    "rate_limited",
    "provider_overloaded",
    "provider_server_error",
  ].includes(input.errorClass);

  if (transient && input.attemptsUsed === 0) return "retry_same_target";
  if (transient && input.equivalentAvailable) return "failover_equivalent";

  if (
    input.policy.allowCrossModelFallback &&
    input.approvedAlternateAvailable
  ) {
    return "fallback_approved_model";
  }

  return "stop";
}
Mantén la selección de candidatos separada de la decisión de recuperación. chooseRecovery decide qué flujo de trabajo está permitido; luego, un selector de candidatos filtra los destinos por capacidad, contexto, región, coste y política de calidad. Esta separación facilita la revisión de incidentes porque el equipo puede distinguir entre “elegimos el flujo de recuperación incorrecto” y “elegimos el modelo alternativo incorrecto”.
Versiona la política y adjunta esa versión a cada traza de intento. Cuando aparezca una regresión de fallback, los operadores deberían poder responder qué política tomó la decisión, qué candidatos eran elegibles y qué presupuesto quedaba en ese momento.
Flujo de trabajo 1: reintento, luego failover equivalente
Usa este flujo de trabajo cuando la operación se puede reproducir y el sistema no ha expuesto salida parcial ni ha entrado en un estado incierto de efectos secundarios.
Un destino equivalente es otra ruta que preserva el contrato importante: la misma clase de comportamiento del modelo, las capacidades requeridas, las expectativas de esquema, la configuración de seguridad y límites de contexto compatibles. Puede ser una región, despliegue, endpoint de proveedor o grupo de capacidad distintos.
Paso 1: normalizar el fallo
Mapea las respuestas específicas del proveedor a una pequeña taxonomía interna:
transport_transientrate_limitedprovider_overloadedprovider_server_errorauthentication_or_permissioninvalid_requestdeadline_exhaustedcontract_failurepartial_outputside_effect_uncertain
Normalmente, solo los cuatro primeros califican para una repetición automática. Los errores de autenticación, permiso y solicitud inválida deben detenerse porque es poco probable que un endpoint diferente repare la solicitud. Los fallos de contrato pertenecen al Flujo de trabajo 2. La salida parcial y los efectos secundarios inciertos pertenecen al Flujo de trabajo 3.
Paso 2: calcular el presupuesto restante
Antes de cada intento, comprueba:
remaining time > estimated next-attempt latency + response safety margin
remaining attempts > 0
remaining added latency > 0
remaining cost budget > estimated attempt cost, when a cost ceiling exists
Si se agota algún presupuesto requerido, sal antes de intentar con otro proveedor.
Paso 3: reintentar con backoff y jitter
Usa la guía de reintentos del proveedor cuando esté disponible. Si no, aplica backoff exponencial con jitter y mantén el retraso dentro del plazo de la solicitud.
function retryDelayMs(attempt: number, retryAfterMs?: number): number {
  if (retryAfterMs !== undefined) return retryAfterMs;

  const base = Math.min(250 * 2 ** attempt, 4_000);
  const jitter = Math.random() * base * 0.3;
  return Math.round(base + jitter);
}
El jitter importa porque, de lo contrario, muchos clientes simultáneos pueden reintentar según el mismo calendario y prolongar un evento de sobrecarga. Tu guía de límites de tasa de LLM debe definir cómo interactúan RPM, TPM, colas, concurrencia y presupuestos de reintentos.
Paso 4: pasar a capacidad equivalente
Si el mismo destino sigue en mal estado, enruta a un endpoint equivalente solo después de comprobar:
- El circuito está cerrado o en half-open para una prueba.
- El destino admite los modos de entrada y salida requeridos.
- El destino puede aceptar la solicitud dentro de su límite de contexto.
- El destino usa la configuración esperada de seguridad y de tratamiento de datos.
- El intento aún encaja en el plazo y el margen de costo.
El failover equivalente suele ser menos arriesgado que cambiar de modelo porque busca preservar el contrato de respuesta.
Paso 5: registra el motivo de la recuperación
Devuelve un resultado de ruta como:
{
  "workflow": "retry_equivalent_failover",
  "primary_attempts": 2,
  "equivalent_failover_attempts": 1,
  "recovered": true,
  "recovery_reason": "provider_overloaded",
  "added_latency_ms": 684
}
No expongas los detalles internos del proveedor a los usuarios finales, salvo que tu producto prometa esa transparencia. Sí debes conservarlos en trazas y registros operativos.
Flujo de trabajo 2: fallback controlado entre modelos
El fallback entre modelos solo es apropiado cuando el modelo alternativo ha sido preaprobado para la tarea. Que un modelo devuelva texto no basta; debe cumplir el contrato del flujo de trabajo.
Paso 1: crea un contrato de capacidades
Define los requisitos no negociables para cada clase de ruta.
{
  "route_class": "support_ticket_triage_v3",
  "required": {
    "input": ["text"],
    "output": ["json_schema"],
    "tools": [],
    "minimum_context_tokens": 24000,
    "schema": "triage-result-v3",
    "languages": ["en", "es", "de"],
    "safety_profile": "customer-support-standard"
  },
  "fallback_models": [
    "approved-model-b",
    "approved-model-c"
  ]
}
Para rutas que usan herramientas, incluya el comportamiento de elección de herramienta, soporte para herramientas en paralelo, manejo del esquema de argumentos y si el modelo sigue de forma fiable las condiciones de “no llamar”. Para salidas estructuradas, valide la respuesta real frente al esquema después de cada intento.
Paso 2: separe el éxito del transporte del éxito de la tarea
Una respuesta HTTP exitosa aún puede fallar en el flujo de trabajo del producto. Evalúe al menos tres capas:
- Éxito del transporte: el proveedor devolvió una respuesta completa.
- Éxito del contrato: la respuesta se analizó, coincidió con el esquema y usó correctamente las herramientas compatibles.
- Éxito de la tarea: la salida realmente completó el trabajo del usuario con un nivel de calidad aceptable.
Esta distinción es esencial al comparar candidatos de fallback. Un modelo con una alta tasa de respuesta pero con fallos frecuentes de esquema o de herramientas no es un fallback fiable.
Paso 3: clasifique los candidatos aprobados por política
Un enrutador de producción puede puntuar los destinos elegibles usando señales operativas sin fingir que un modelo sea universalmente el mejor.
type Candidate = {
  id: string;
  capabilitiesPass: boolean;
  circuitOpen: boolean;
  estimatedLatencyMs: number;
  estimatedCostUsd: number;
  recentContractSuccess: number;
  recentTaskSuccess: number;
};

function eligible(candidate: Candidate, envelope: FallbackEnvelope): boolean {
  return (
    candidate.capabilitiesPass &&
    !candidate.circuitOpen &&
    candidate.estimatedLatencyMs <= envelope.maxAddedLatencyMs &&
    (envelope.maxCostUsd === undefined ||
      candidate.estimatedCostUsd <= envelope.maxCostUsd)
  );
}
Evite una lista estática de “primario, respaldo, respaldo” para cada tarea. El mejor conjunto de fallback para generación de código puede diferir del mejor conjunto para extracción, traducción, visión o ejecución de herramientas.
Paso 4: valide la salida de fallback
Primero aplique comprobaciones deterministas:
- Validación de JSON o del esquema
- Comprobaciones de campos obligatorios
- Validación de argumentos de herramientas
- Comprobaciones del formato de citas o URL
- Restricciones de longitud e idioma
- Patrones de salida prohibidos
Después añada comprobaciones de calidad específicas del flujo de trabajo. Estas pueden ser reglas ligeras, un evaluador de tareas, revisión humana por muestreo o un modelo juez validado. Si la puerta de calidad falla, no etiquete el fallback como recuperado.
Paso 5: cambios de política en canary
Antes de ampliar un nuevo modelo de fallback:
- Reproduzca un conjunto de evaluación offline.
- Ejecute tráfico sombra donde la política lo permita.
- Habilite el candidato para un pequeño porcentaje de fallos elegibles.
- Compare el éxito del contrato, el éxito de la tarea, la latencia y el coste.
- Amplíe solo si el valor de recuperación supera el riesgo de regresión.
Haga seguimiento de estas mediciones con un esquema de observabilidad de la API de LLM que registre una ruta y un span por intento.
Flujo de trabajo 3: detener, reconciliar o escalar
Algunos fallos no deberían desencadenar otra llamada al modelo. El fallback correcto es una detención controlada.
Caso 1: salida parcial en streaming
Una vez que los tokens de respuesta han llegado al usuario, cambiar de modelo en silencio puede crear contradicciones, contenido duplicado, bloques de código rotos o un cambio repentino de estilo. Además, dificulta atribuir y depurar la respuesta final.
Utiliza una de estas salidas explícitas en su lugar:
- Termina el flujo con un error recuperable y una acción de “reintentar”.
- Ofrece reiniciar la respuesta desde el principio.
- Continúa solo si la aplicación tiene un protocolo de reanudación diseñado y el nuevo modelo recibe exactamente el prefijo aceptado.
El valor predeterminado debería ser allowAfterPartialOutput: false.
Case 2: uncertain tool side effects
Supongamos que un modelo seleccionó una herramienta de pago, correo electrónico, despliegue, tickets o escritura en base de datos. Es posible que la herramienta haya tenido éxito incluso si la conexión falló antes de que tu orquestador registrara el resultado. Reproducir todo el flujo de trabajo puede duplicar el efecto secundario.
Protege las herramientas de escritura con:
- Una clave de idempotencia basada en la operación del usuario, no en el intento del proveedor.
- Un registro duradero de ejecución con estados
planned,started,succeeded,failedyunknown. - Deduplicación en el límite de la herramienta.
- Una consulta de conciliación antes de cualquier repetición.
- Revisión humana para acciones de alto impacto que sigan siendo inciertas.
type ToolExecution = {
  operationId: string;
  toolName: string;
  state: "planned" | "started" | "succeeded" | "failed" | "unknown";
  externalReference?: string;
};

function nextAction(execution: ToolExecution): "continue" | "reconcile" | "stop" {
  if (execution.state === "succeeded") return "continue";
  if (execution.state === "failed") return "stop";
  return "reconcile";
}
Separa las credenciales del proveedor y las credenciales de la herramienta. La guía de gestión segura de claves API cubre el modelo circundante de secretos y control de acceso.
Case 3: safety, permission, or policy uncertainty
La disponibilidad no debe debilitar una decisión de seguridad o autorización. Si el candidato de fallback no admite los controles de política requeridos, la ruta no es elegible. Si el sistema no puede determinar si una operación está permitida, falla de forma cerrada o escala según el modelo de riesgo del producto.
Case 4: no candidate satisfies the contract
Devuelve un fallo tipado que la aplicación pueda manejar:
{
  "status": "unavailable",
  "reason": "no_eligible_fallback",
  "retryable": true,
  "retry_after_ms": 30000,
  "request_id": "req_123"
}
Una respuesta degradada clara es mejor que una respuesta aparentemente exitosa que viole el esquema, use las herramientas equivocadas o produzca el efecto secundario incorrecto.
Coloca los tres flujos de trabajo en una sola máquina de estados
La capa de orquestación debería hacer explícita la transición.
INICIO
  -> PRIMARY_ATTEMPT
     -> SUCCESS: validar y devolver
     -> TRANSIENT + replayable: WORKFLOW_1
     -> CONTRACT_FAILURE + alternate approved: WORKFLOW_2
     -> PARTIAL_OUTPUT or SIDE_EFFECT_UNCERTAIN: WORKFLOW_3

WORKFLOW_1
  -> reintentar dentro del presupuesto
  -> failover equivalente dentro del presupuesto
  -> si se permite un alternativo compatible: WORKFLOW_2
  -> de lo contrario: STOP

WORKFLOW_2
  -> comprobación de capacidad
  -> intento alternativo
  -> validación del contrato y de la tarea
  -> devolver solo tras una validación exitosa
  -> de lo contrario: STOP

WORKFLOW_3
  -> marcar estado parcial o incierto
  -> reconciliar efectos secundarios externos cuando sea posible
  -> ofrecer reinicio explícito o escalado a un humano
  -> nunca reintentar silenciosamente trabajo inseguro
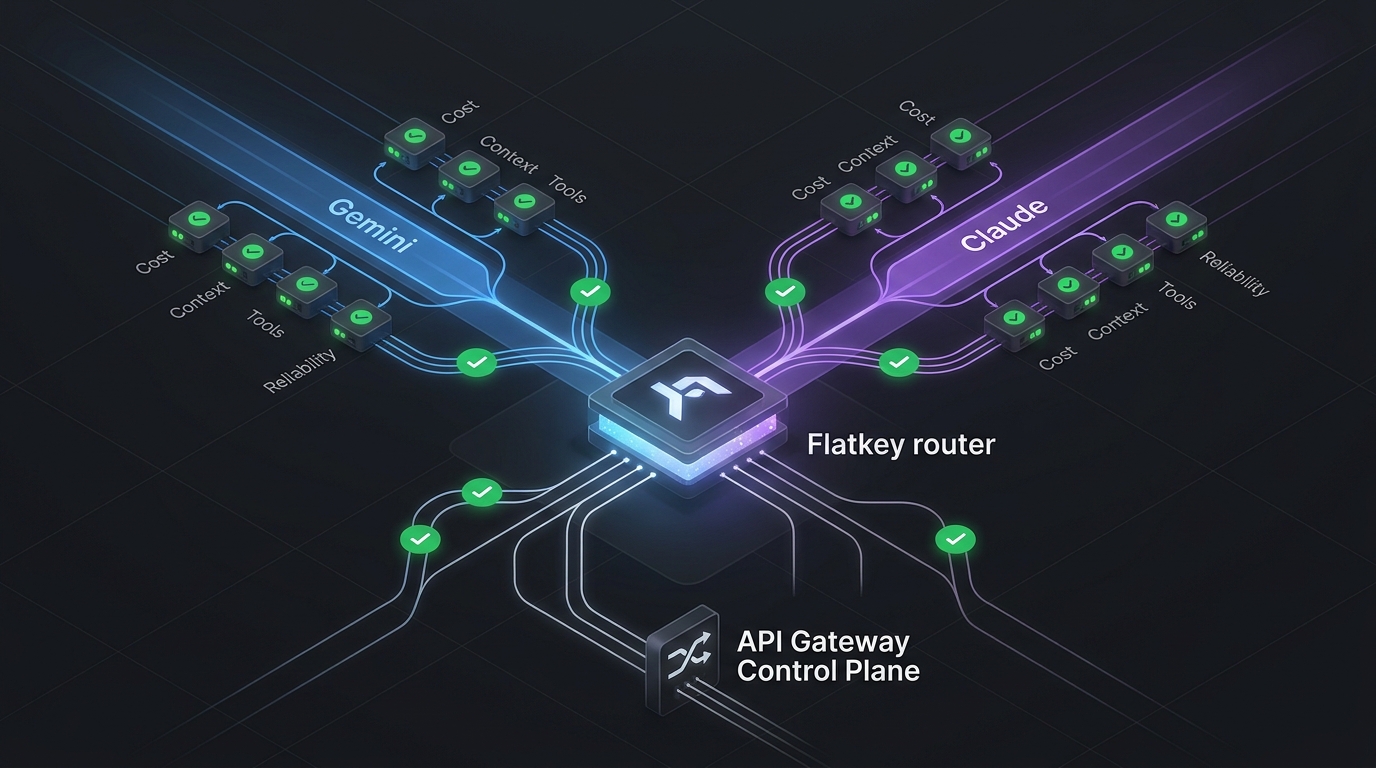
Este también es el límite adecuado para una pasarela multimodelo. Centralizar el acceso a los modelos detrás de un endpoint compatible con OpenAI puede reducir la duplicación de integraciones, pero la aplicación sigue necesitando proporcionar la intención del flujo de trabajo: plazos, modo de efectos secundarios, herramientas requeridas, versión del esquema y si se permite el fallback entre modelos. Flatkey ofrece una capa unificada de acceso a la API para equipos que quieren una sola clave y una sola superficie de integración entre proveedores de modelos; la política de enrutamiento más segura sigue comenzando con contratos explícitos de la aplicación.
Ejecuta cinco simulacros de fallo antes de habilitar el fallback automático
Una ruta de fallback que nunca ha manejado un fallo controlado es solo un diagrama. Prueba cada clase de ruta frente a fallos que ejerciten un límite de seguridad distinto.
| Simulacro | Condición inyectada | Comportamiento esperado | Evidencia que conservar |
|---|---|---|---|
| 1. Timeout del primario | Retrasar el primario más allá del timeout por intento | Reintentar solo si el plazo total y el presupuesto de intentos se mantienen | Marcas temporales de los intentos, presupuesto antes y después, motivo final de la ruta |
| 2. Ráfaga de limitación de tasa | Devolver una serie acotada de respuestas de rate-limit | Aplicar jitter, respetar la guía de reintento y evitar reintentos sincronizados | Distribución del backoff, profundidad de la cola, recuentos de recuperados y de plazo agotado |
| 3. Salida estructurada inválida | Devolver éxito HTTP con un cuerpo inválido para el esquema | Marcar fallo de contrato, probar solo un alternativo aprobado capaz de manejar el esquema, validar de nuevo | Errores de validación, registro de elegibilidad del candidato, resultado de la tarea aceptada |
| 4. Desconexión a mitad de stream | Terminar la conexión después de tokens visibles para el usuario | Detener el stream y requerir un reinicio explícito | Marca de salida parcial, estado visible para el usuario, confirmación de que no hubo empalme silencioso |
| 5. Resultado ambiguo de herramienta | Descartar la respuesta después de que una herramienta de escritura pueda haberse ejecutado | Reconciliar por ID de operación antes de cualquier repetición | Registro de idempotencia, consulta del estado externo, recuento de efectos secundarios duplicados |
Ejecuta primero los simulacros en un entorno local o de staging, y después en un game day de producción estrictamente acotado. El objetivo no es demostrar que cada solicitud sobrevive. Es demostrar que el sistema falla en el estado previsto, expone suficientes evidencias para diagnosticar el evento y no gasta más latencia, dinero o riesgo de efectos secundarios de lo que permite la política.
Para cada simulacro, verifica de forma independiente cuatro capas:
- Corrección de la decisión: el enrutador eligió el flujo de trabajo previsto.
- Corrección del presupuesto: todos los intentos permanecieron dentro del plazo compartido, el límite de intentos y el margen de costo.
- Corrección del resultado: el resultado final pasó la validación del contrato y de la tarea, o devolvió un estado degradado explícito.
- Corrección de auditoría: los rastros capturaron la versión de la política, la clase de fallo, la elegibilidad del candidato, el motivo de la ruta y el resultado visible para el usuario.
Repite el ejercicio siempre que cambies un adaptador de proveedor, el responsable de reintentos, un candidato de modelo, la versión del esquema, el contrato de una herramienta o la implementación de streaming. Esos cambios pueden alterar la seguridad de la reproducción incluso cuando la forma de la API pública parezca no haber cambiado.
Usa una tarjeta de puntuación de preparación para fallback antes de producción
Superar unas pocas pruebas de camino feliz no es suficiente para habilitar el fallback automático. Una ruta debe ganarse la automatización pasando cinco puertas de lanzamiento independientes.
| Puerta | Condición de aprobación | Evidencia | Bloquear el fallback automático cuando |
|---|---|---|---|
| Seguridad de reproducción | El equipo puede demostrar si la solicitud es segura de repetir en cada límite de intento | Clasificación de efectos secundarios, diseño de idempotencia, reglas de salida parcial | Es posible que haya ocurrido una escritura sin una clave de reconciliación |
| Compatibilidad de contrato | Todos los candidatos admiten el contexto, las herramientas, el esquema, las modalidades y los controles de política requeridos | Matriz de capacidades versionada y pruebas de contrato | La compatibilidad se asume a partir de la familia del modelo o de etiquetas de marketing |
| Calidad de la tarea | La alternativa produce resultados aceptables para la carga de trabajo real de la ruta | Conjunto de evaluación específico de la ruta y casos de fallo revisados | Solo hay éxito de transporte o puntuaciones genéricas de benchmark disponibles |
| Control del presupuesto | Los reintentos y fallbacks comparten un solo plazo, límite de intentos y techo de costos | Trazas del ejercicio de fallo que muestran el consumo de presupuesto | Múltiples capas pueden reintentar de forma independiente o superar el plazo del llamador |
| Control operativo | Los ingenieros de guardia pueden identificar, desactivar y explicar una decisión de fallback | Versión de la política, motivo de la ruta, interruptor de emergencia, panel, runbook | La ruta de recuperación no puede aislarse sin un despliegue completo de la aplicación |
Trata la tarjeta de puntuación como un artefacto de lanzamiento. Registra la clase de ruta, la versión de la política, los candidatos aprobados, la versión del evaluador, los resultados del ejercicio, el propietario y la fecha de revisión. Un único indicador global de “fallback habilitado” oculta demasiado riesgo; la aprobación debe producirse por clase de flujo de trabajo.
Registro de preparación copiable
fallback_readiness:
  route_class: support_ticket_extraction
  policy_version: fallback-v4
  owner: ai-platform
  primary_target: primary-model
  approved_candidates:
    - equivalent-deployment
    - alternate-model

  gates:
    replay_safety: pass
    contract_compatibility: pass
    task_quality: pass
    budget_control: pass
    operational_control: pass

  evidence:
    capability_matrix: contracts/support-ticket-v3.yaml
    evaluation_set: evals/support-ticket-2026-08.jsonl
    failure_drill_run: drills/2026-08-03.json
    dashboard: ai-routing/support-ticket
    runbook: runbooks/support-ticket-fallback.md

  release:
    mode: canary
    rollback_owner: oncall-ai-platform
    next_review_at: 2026-09-03
El archivo no necesita vivir en este formato exacto. Lo que importa es que la decisión de lanzamiento sea revisable y esté vinculada a la misma versión de política registrada en las trazas de producción.
Implementa una estrategia de fallback de modelos en cuatro etapas
El fallback automático no debe pasar de una prueba offline a cada solicitud de producción. Usa cuatro etapas que expongan errores de decisión antes de que se vuelvan visibles para el usuario.
Etapa 1: sombrea la decisión
Ejecuta el controlador de fallback en modo solo observación. La ruta primaria sigue determinando la respuesta del usuario, mientras que el controlador registra lo que habría hecho.
Revisa:
- Con qué frecuencia la política clasifica un fallo como recuperable mediante reintento.
- Con qué frecuencia un candidato es elegible.
- Qué presupuesto habría detenido la recuperación.
- Si la política propone fallback después de una salida parcial o de efectos secundarios inciertos.
- Si los errores normalizados por el proveedor preservan suficiente detalle para el diagnóstico del incidente.
El modo sombra es especialmente útil para encontrar reglas demasiado amplias, como “hacer fallback ante cada 429” o “probar otro modelo después de cualquier error de esquema”. Esas reglas pueden parecer razonables en una revisión de código, pero comportarse mal frente a estados reales de la solicitud.
Etapa 2: canario en flujos de trabajo de bajo riesgo
Habilita el fallback para una porción pequeña de tráfico seguro para replay, como clasificación de solo lectura, extracción o resumido en segundo plano. Excluye herramientas de escritura, decisiones sensibles a la seguridad y rutas con streaming visible para el usuario.
Compara el canario con la ruta de solo primario usando resultados a nivel de ruta:
- Tasa de tareas aceptadas, no solo éxito HTTP.
- Latencia añadida por la recuperación.
- Diferencia de coste por tarea aceptada.
- Fallos de validación de contrato por candidato.
- Agotamiento del plazo y tasa de no fallback elegible.
- Cancelación del usuario o tasa explícita de reinicio.
No amplíes el canario porque la tasa de error del proveedor haya bajado. Amplíalo solo cuando el resultado final para el usuario siga siendo aceptable y la ruta de recuperación permanezca dentro de su margen.
Etapa 3: limita la recuperación automática por clase de riesgo
Expande solo las clases de flujo de trabajo que aprobaron la tarjeta de puntuación de preparación. Mantén explícitas las diferencias de política:
| Clase de riesgo | Automatización predeterminada | Salvaguarda requerida |
|---|---|---|
| Solo lectura, sin salida en streaming | Reintento, failover equivalente, fallback entre modelos aprobado | Validación de contrato y de tarea |
| Solo lectura con salida en streaming | Recuperación solo antes del primer byte visible para el usuario | Estado de salida parcial y reinicio explícito |
| Uso de herramientas con herramientas de solo lectura | Reintento antes de la ejecución de la herramienta; validar el contrato alternativo de la herramienta | Esquema de la herramienta y pruebas de elección de herramienta |
| Uso de herramientas con escrituras | Detener y reconciliar tras una ejecución ambigua | ID de operación duradero y consulta de estado externo |
| Decisión de seguridad, permisos o cumplimiento | Fallar según la política aprobada del producto | Sin degradación de la política impulsada por la disponibilidad |
Esta etapa es donde se encuentran una pasarela y un contrato de aplicación. La pasarela puede normalizar errores, imponer presupuestos y seleccionar capacidad elegible. La aplicación aún debe indicar si la salida se ha escapado, si es posible un efecto secundario y qué comprobaciones de calidad o de política son obligatorias.
Etapa 4: ampliar gradualmente y recertificar los cambios
Aumente el tráfico en pasos acotados. En cada paso, conserve la capacidad de deshabilitar una versión de política, una clase de ruta, un adaptador de proveedor o un candidato sin apagar toda la capa de enrutamiento.
Vuelva a ejecutar los gates relevantes de la tarjeta de puntuación cuando cambie cualquiera de estos elementos:
- Modelo o versión del modelo.
- Adaptador del proveedor o endpoint.
- Plantilla de prompt o instrucción del sistema.
- Definición de herramienta o ámbito de permisos.
- Esquema de salida estructurada.
- Propiedad del reintento o configuración de timeout.
- Transporte de streaming o comportamiento del cliente.
- Política de seguridad o evaluador de calidad.
La preparación del fallback caduca cuando cambian sus supuestos. Un candidato aprobado para un prompt, esquema o conjunto de herramientas anterior no debe seguir siendo elegible automáticamente por inercia.
Defina los disparadores de rollback antes de habilitar el canary
Un canary solo es seguro cuando el equipo acuerda de antemano qué lo detiene. Use disparadores específicos por ruta en lugar de esperar a un incidente amplio.
Haga rollback o deshabilite la política afectada cuando observe:
- Efectos secundarios de escritura duplicados o inciertos.
- Éxito del contrato entre modelos sin éxito aceptable de la tarea.
- Un aumento en fallos de stream parcial o en empalmes de respuesta invisibles.
- Agotamiento repetido de los plazos causado por intentos de recuperación.
- Que se superen o se ignoren los límites de presupuesto.
- Selección de candidato que viole una capacidad requerida o una política de seguridad.
- Un cambio inexplicado en la distribución de motivos de fallback después de un despliegue.
- Faltan datos de trazabilidad a nivel de versión de política o de intento durante un incidente.
La acción de rollback debe ser tan específica como el fallo. Según el evento, eso puede significar deshabilitar un solo candidato, forzar una ruta a solo failover equivalente, establecer allowCrossModelFallback en false, abrir un circuito para un proveedor o devolver el flujo de trabajo al modo solo primario.
Evite un mecanismo de rollback que requiera reconstruir la aplicación. Los cambios en la política de recuperación son frecuentes durante los incidentes, y a menudo la respuesta más segura es un cambio de configuración con una versión auditable en lugar de un parche de código de emergencia.
Use una hoja de trabajo de incidentes para cada evento de fallback
Los incidentes de fallback se vuelven difíciles de diagnosticar cuando cada proveedor expone una forma de error distinta y cada aplicación registra un estado de solicitud diferente. Capture una sola hoja de trabajo neutral al proveedor.
fallback_incident:
  incident_id: inc-2026-08-03-001
  route_class: support_ticket_extraction
  request_id: req_123
  policy_version: fallback-v4

  request_state:
    output_started: false
    side_effect_mode: none
    tool_execution_state: not_started
    deadline_remaining_ms: 1820
    attempts_remaining: 1

  primary_failure:
    normalized_class: overloaded
    provider_status: 529
    retry_guidance_present: true

  recovery_decision:
    workflow: cross_model_fallback
    candidate: alternate-model
    reason: equivalent_capacity_unavailable

  validation:
    transport_success: true
    contract_success: true
    task_success: false
    failure_reason: required_field_omitted

  user_outcome:
    state: explicit_failure
    partial_output: false
    duplicate_side_effect: false

  containment:
    action: disable_candidate_for_route
    owner: oncall-ai-platform
La distinción más importante es entre éxito de recuperación y éxito del usuario. Una solicitud de fallback puede devolver una respuesta HTTP válida y aun así fallar el esquema, elegir la herramienta equivocada, omitir un dato requerido o violar el umbral de calidad de la ruta. La revisión del incidente debe seguir el resultado hasta la tarea visible para el usuario.
Ejecute un game day de fallback de modelo de 60 minutos
Las pruebas unitarias demuestran que se ejecutan ramas individuales. Un game day de fallback demuestra que todo el sistema de recuperación se comporta correctamente mientras interactúan los plazos, reintentos, flujos, validación, herramientas, telemetría y controles del operador.
Ejecute el ejercicio contra una clase de flujo de trabajo a la vez. No comience con una simulación global de indisponibilidad del proveedor. Una ruta estrecha, como la extracción de solo lectura o el resumen interno, produce evidencia más clara y limita el radio de impacto si la política es incorrecta.
Defina el plan del game day
Escriba un plan de una página antes de que alguien inyecte un fallo. El plan evita que el ejercicio se convierta en una caída improvisada.
game_day:
  id: fallback-gd-2026-08-04-extraction
  route_class: structured_extraction
  policy_version: fallback-v4
  environment: staging
  exercise_owner: ai-platform
  incident_commander: reliability

  primary_target: primary-model
  approved_fallbacks:
    - equivalent-deployment
    - alternate-schema-capable-model

  traffic_scope:
    synthetic_requests: 100
    production_percentage: 0

  safety_limits:
    stop_after_minutes: 60
    max_error_rate_percent: 5
    max_duplicate_side_effects: 0
    max_unexplained_route_decisions: 0

  success_definition:
    - every request ends accepted, explicitly degraded, or safely stopped
    - no request exceeds the shared attempt budget
    - no partial stream is silently continued by another model
    - every fallback decision includes a policy version and route reason
Utiliza primero tráfico sintético o seguro para replay. Si la ruta puede activar escrituras, reemplaza la herramienta con un doble de prueba controlado o un sandbox que admita búsqueda de idempotencia. Un game day debe poner a prueba los controles de recuperación, no apostar con el estado del cliente.
Assign four roles
Mantén al equipo lo bastante pequeño para tomar decisiones con rapidez, pero separa la observación de la ejecución.
| Role | Responsibility during the exercise | Must not do |
|---|---|---|
| Exercise lead | Starts scenarios, controls the timeline, and calls stop conditions | Change the fallback policy mid-scenario without recording it |
| Operator | Watches route health, disables candidates, and uses the kill switch | Inject failures or edit evidence |
| Observer | Records timestamps, screenshots, traces, and user-visible outcomes | Help the router “pass” by correcting requests manually |
| Application owner | Judges task quality and workflow-specific degradation | Approve a result based only on HTTP success |
Para un equipo muy pequeño, una persona puede cubrir dos roles, pero la persona que inyecta la falla no debería ser la única que evalúe si el sistema respondió correctamente.
Build a scenario ladder
Empieza con la falla menos ambigua y añade riesgo solo después de que la ruta supere el peldaño anterior.
| Rung | Injection | What the router should prove | Promotion requirement |
|---|---|---|---|
| 1. Clean equivalent failover | Make the primary endpoint unavailable before response bytes | It can move to equivalent capacity without changing the application contract | Accepted result, one route reason, shared budget respected |
| 2. Retry pressure | Return a bounded burst of retryable errors | Backoff and jitter work without attempt multiplication | No nested retry amplification; deadline remains authoritative |
| 3. Semantic contract failure | Return a transport-successful but invalid structured result | Validation, not status code, controls acceptance | Alternate is eligible and its result passes the same validator |
| 4. Partial stream | Disconnect after visible output | The system stops and marks the answer partial | No silent model splice; restart is explicit |
| 5. Uncertain tool completion | Lose the model response after a write may have executed | The workflow reconciles external state before replay | Operation ID lookup completes; duplicate writes remain zero |
| 6. Fallback degradation | Make the approved alternate slower or lower quality | Stop-loss and rollback rules override availability pressure | Candidate is removed or automation is disabled at the predefined threshold |
No saltes directamente a un escenario complejo entre modelos. Si el failover equivalente no puede preservar el presupuesto y el contrato de trazas, añadir un modelo de comportamiento diferente hará el diagnóstico más difícil, no más realista.
Inject faults at explicit boundaries
Etiqueta el límite exacto donde la falla entra en el ciclo de vida de la solicitud. “Provider failed” es demasiado vago para un registro de prueba útil.
type InjectionPoint =
  | "before_connect"
  | "after_connect_before_headers"
  | "after_headers_before_body"
  | "after_partial_stream"
  | "after_tool_dispatch_before_ack"
  | "after_tool_ack_before_model_response"
  | "after_transport_success_before_validation";
El límite determina qué acciones de recuperación son seguras. Un timeout antes de la conexión a menudo puede reintentarse. Una desconexión después de que un usuario ha visto una salida requiere un reinicio explícito. Un acuse de recibo perdido después de una llamada a una herramienta del lado de escritura requiere conciliación. Tratar las tres como la misma clase de timeout es cómo entran en producción acciones duplicadas y respuestas incoherentes.
Si tu capa de inyección de fallos no puede apuntar a esos límites, añade el marcador de límite al adaptador del proveedor o a la capa de orquestación antes del ejercicio. Los interruptores de fallo gruesos son útiles para pruebas de disponibilidad, pero insuficientes para pruebas de seguridad ante reintentos.
Captura una fila de evidencia por solicitud
El game day debe producir un libro mayor a nivel de solicitud, no solo capturas de pantalla del panel. Una fila compacta hace visibles las decisiones inexplicadas.
| Campo | Ejemplo | Por qué importa |
|---|---|---|
request_id |
req_01J... |
Une la evidencia de la pasarela, el modelo, el validador y la herramienta |
scenario_id |
partial-stream-01 |
Conecta el resultado con la condición inyectada |
policy_version |
fallback-v4 |
Demuestra qué reglas de enrutamiento tomaron la decisión |
failure_class |
stream_interrupted |
Separa la incertidumbre de transporte, contrato, política y herramienta |
injection_point |
after_partial_stream |
Establece la seguridad para reintentos |
attempts_used |
1/2 |
Detecta la amplificación por reintentos |
elapsed_ms |
4830/12000 |
Muestra el presupuesto de tiempo restante |
cost_budget_state |
within |
Evita que la recuperación ignore la economía unitaria |
selected_action |
restart_required |
Registra la decisión del enrutador |
candidate_id |
none |
Muestra si se consideró otro modelo |
validator_result |
not_run |
Separa la recuperación de transporte de la aceptación de la tarea |
side_effect_state |
none |
Hace explícitos los requisitos de conciliación |
user_outcome |
partial_marked |
Captura lo que experimentó el cliente |
operator_action |
none |
Distingue la recuperación automática de la contención manual |
Guarda el libro mayor junto con la instantánea de la política, la versión del validador, la configuración de fallos y la exportación del panel. Sin esas versiones, un ejercicio aprobado no puede reproducirse después del siguiente cambio en el adaptador o en el modelo.
Evalúa el ejercicio con reglas de promoción
Use tres decisiones posibles: promover, corregir y volver a ejecutar o detener la automatización. Evite un resultado vago de “casi aprobado”.
Promueva la ruta solo cuando todo lo siguiente sea verdadero:
- Cada solicitud tiene un estado terminal explicado.
- Ninguna cadena de intentos supera el plazo compartido, el recuento de intentos o el techo de costo configurado.
- Cada salida aceptada pasa el validador o la regla de evaluación de la ruta.
- La salida parcial y los efectos secundarios inciertos entran en estados explícitos de detención o reconciliación.
- Los operadores pueden deshabilitar un candidato o toda la política sin desplegar código de la aplicación.
- La monitorización identifica tanto los fallos de recuperación como las recuperaciones perjudiciales, como un fallback exitoso con una calidad de tarea inaceptable.
Elija corregir y volver a ejecutar cuando el modelo de seguridad es correcto pero la evidencia o la implementación están incompletas. Algunos ejemplos incluyen un motivo de ruta ausente, una alerta que se dispara demasiado tarde o un candidato que cumple el contrato pero no alcanza el objetivo de latencia.
Elija detener la automatización cuando el ejercicio detecte ambigüedad en la reproducción, efectos secundarios duplicados, división silenciosa del flujo, enrutamiento sin explicación, omisión de la política o un modo de fallo que la máquina de estados actual no pueda representar. Esos son vacíos de diseño, no problemas de ajuste.
Use una tarjeta de puntuación de game day que se pueda copiar
game_day_result:
  game_day_id: fallback-gd-2026-08-04-extraction
  route_class: structured_extraction
  policy_version: fallback-v4
  evaluator_version: extraction-eval-v7
  started_at: 2026-08-04T09:00:00Z
  completed_at: 2026-08-04T10:00:00Z

  scenarios:
    equivalent_failover: pass
    retry_pressure: pass
    semantic_contract_failure: pass
    partial_stream: pass
    uncertain_tool_completion: not_applicable
    fallback_degradation: fix

  totals:
    requests: 100
    accepted: 94
    explicitly_degraded: 6
    unsafe_or_unexplained: 0
    duplicate_side_effects: 0
    deadline_violations: 0

  decision: fix_and_rerun
  blockers:
    - alternate p95 latency exceeded the route objective during degradation
  owner: ai-platform
  rerun_due: 2026-08-11
Los valores de ejemplo son ilustrativos. Use sus propios objetivos de ruta y umbrales de evaluación. Lo importante es que la decisión final apunte a la evidencia retenida y a un responsable nombrado.
Convierta los hallazgos en controles de lanzamiento
Termine el game day convirtiendo cada hallazgo en uno de estos cuatro controles duraderos:
- Cambio de política: elegibilidad del candidato, presupuesto de intentos, plazo o regla de clase de ruta.
- Prueba de contrato: comprobación de compatibilidad de capacidad, esquema, herramienta, streaming o seguridad.
- Control operativo: alerta, panel, interruptor de apagado, cuarentena del candidato o procedimiento de incidente.
- Comportamiento del producto: reinicio explícito, mensaje de estado degradado, confirmación manual o pantalla de reconciliación.
No cierre el ejercicio con una lista de observaciones. Un hallazgo sin responsable, tipo de control y condición de nueva ejecución reaparecerá durante un incidente real.
Para la capa de telemetría detrás de estos ejercicios, usa la guía de observabilidad de la API de LLM. Para la responsabilidad de los reintentos y el comportamiento frente a límites de tasa, combina la jornada de pruebas con el artículo sobre límites de tasa y estrategia de reintentos en LLM. Si tu equipo aún está definiendo el límite del gateway, comienza con la guía para principiantes de LLM gateway.
Una secuencia de implementación de siete días
Los equipos pueden usar este orden para pasar de una lista ad hoc de modelos a un playbook de flujo de trabajo controlado:
- Día 1 — Inventariar rutas: clasifica el modo de salida, el riesgo de efectos secundarios, las herramientas, los esquemas, los plazos y los responsables actuales de reintentos.
- Día 2 — Definir envolventes: establece límites de intentos, latencia, costo, capacidad y reproducción por clase de ruta.
- Día 3 — Construir contratos: documenta los candidatos aprobados y prueba la compatibilidad con herramientas, esquemas, contexto, modalidad y políticas.
- Día 4 — Instrumentar decisiones: registra fallo normalizado, estado de la solicitud, versión de la política, elegibilidad del candidato, presupuesto, validación y resultado del usuario.
- Día 5 — Ejecutar simulacros de fallo: inyecta timeout, ráfaga de límite de tasa, salida inválida, desconexión a mitad de flujo y ejecución ambigua de herramientas.
- Día 6 — Shadow y canary: observa primero las decisiones, luego habilita una ruta estrecha de bajo riesgo con disparadores de rollback predefinidos.
- Día 7 — Revisar y ampliar: inspecciona la tasa de tareas aceptadas, la latencia añadida, el delta de costo, las señales de reproducción no segura y los eventos sin fallback elegible antes de expandir.
La secuencia está intencionalmente centrada primero en el flujo de trabajo. Elegir una lista ordenada de modelos es solo un pequeño paso. El trabajo en producción consiste en demostrar cuándo el sistema puede continuar, cuándo debe validar y cuándo debe detenerse.
Lista de verificación de despliegue de la estrategia de fallback de modelos
Política
- Cada clase de ruta tiene una envolvente de fallback.
- La política de fallback está versionada y puede revisarse como configuración.
- Los errores reintentables se normalizan entre proveedores.
- El presupuesto total de reintentos tiene un único responsable.
- Los endpoints equivalentes se distinguen de los modelos alternativos.
- Los candidatos entre modelos tienen contratos de capacidad versionados.
- La salida parcial desactiva de forma predeterminada el fallback transparente.
- Las herramientas de escritura usan registros duraderos de idempotencia.
Validación
- El transporte, el contrato y el éxito de la tarea se miden por separado.
- Las salidas estructuradas se validan después del fallback.
- Los argumentos de herramientas y el comportamiento de elección de herramientas se prueban por modelo.
- Los conjuntos de evaluación de fallback representan clases de ruta reales.
- Los nuevos candidatos pasan evaluación offline y un canary en producción.
- Los cinco simulacros de fallo pasan para cada clase de ruta aplicable.
Operaciones
- Cada intento registra el motivo de la ruta, el destino, la latencia y el resultado.
- Los paneles muestran por separado el primario, el reintento, el failover equivalente y la recuperación entre modelos.
- Las alertas incluyen el agotamiento del plazo y las tasas de fallback no elegibles.
- Los circuit breakers utilizan sondeos controlados en estado half-open.
- La revisión de incidentes incluye la calidad visible para el usuario y el riesgo de efectos secundarios duplicados.
- Cada registro de trazas de intento captura la versión activa de la política de fallback.
- Cada ruta tiene una scorecard de readiness completada y un propietario designado.
- Se prueban los desencadenantes de rollback canary y los interruptores de corte limitados.
- Las hojas de trabajo de incidentes recopilan el estado de la solicitud, la validación y el resultado para el usuario.
Metrics that prove fallback is helping
No optimice solo para la tasa de error del proveedor. Siga el resultado para el usuario.
| Metric | Question answered |
|---|---|
| Retry recovery rate | Are same-target retries worth their latency? |
| Equivalent failover recovery rate | Does redundant capacity restore service safely? |
| Cross-model contract success | Does the alternate response satisfy the required interface? |
| Cross-model task success | Does the user still complete the intended job? |
| Added fallback latency | How much delay does recovery add? |
| Fallback cost delta | What is the cost of the recovery path? |
| Partial-stream failure rate | How often does the system reach an unrecoverable presentation state? |
| Side-effect reconciliation rate | How often must the system verify external state before continuing? |
| Duplicate-side-effect incidents | Did replay protection fail? |
| No-eligible-fallback rate | Are route contracts too strict, or is capacity insufficient? |
Segment these metrics by route class. An aggregate recovery rate can hide that fallback works well for extraction but poorly for code generation or tool use.
During rollout, compare these metrics by policy version and release stage. That makes it possible to separate a provider incident from a controller change, candidate change, or widened canary.
Frequently asked questions
What is a model fallback strategy?
A model fallback strategy is a policy for deciding when an AI request should retry the same target, fail over to equivalent capacity, switch to an approved alternate model, or stop because replay would be unsafe.
What is the difference between retry and fallback?
A retry repeats the request against the same target or deployment. Equivalent failover moves the request to capacity intended to preserve the same model contract. Cross-model fallback changes the model and therefore requires capability and quality validation.
Should every 429 error trigger another model?
No. First classify the limit, honor retry guidance, check the remaining deadline, and use a bounded retry or queue. Switching models may help when approved alternate capacity exists, but it can also change output quality, tool behavior, or cost.
Can a streamed response fall back mid-answer?
Por lo general, es más seguro no cambiar de forma transparente después de que los tokens hayan llegado al usuario. Detén el flujo y ofrece un reinicio explícito, a menos que la aplicación tenga un protocolo de reanudación probado.
¿Cuántos modelos de fallback debería tener una ruta?
Utiliza el conjunto aprobado más pequeño que proporcione una recuperación significativa. Cada candidato añade trabajo de evaluación, monitoreo y respuesta a incidentes. Una lista larga y no probada no es resiliencia.
¿Dónde debería vivir la lógica de fallback?
Centraliza la normalización del proveedor, el enrutamiento, los presupuestos de intentos y la observabilidad en una gateway o capa de orquestación. Mantén cerca de la aplicación la intención específica del flujo de trabajo —riesgo de efectos secundarios, requisitos de esquema, política de seguridad y umbrales de calidad—.
¿Cómo debería un equipo implementar el fallback automático de modelos?
Empieza en modo sombra, haz canary solo en flujos de trabajo seguros para repetición, define los disparadores de reversión antes de ampliar el tráfico y recertifica la política de fallback cada vez que cambien los modelos, los prompts, las herramientas, los esquemas, la propiedad de los reintentos o los requisitos de seguridad.
Construye el fallback en torno al riesgo del flujo de trabajo
La mejor estrategia de fallback de modelos no es “probar el siguiente modelo”. Es un sistema de decisión acotado:
- Flujo de trabajo 1 recupera solicitudes repetibles con reintentos y capacidad equivalente.
- Flujo de trabajo 2 cambia de modelo solo después de comprobaciones de capacidad y calidad.
- Flujo de trabajo 3 detiene la repetición automática cuando la salida o los efectos secundarios hacen que la recuperación sea insegura.
Ese diseño mejora la disponibilidad sin ocultar fallos de contrato ni duplicar acciones del usuario. Si tu equipo está estandarizando el acceso entre proveedores de modelos, usa la capa de API unificada compatible con OpenAI de Flatkey como superficie de integración y luego adjunta estos envoltorios específicos de cada flujo de trabajo a cada ruta de producción.