Резервное переключение модели — это не одно поведение. Это набор решений по восстановлению с разными пределами безопасности.
В production стратегия резервного переключения моделей должна разделять три рабочих процесса:
- Повторная попытка или эквивалентный failover, когда запрос все еще безопасно повторить.
- Резервирование на другую модель, когда другая модель может обеспечить ту же функциональность и тот же контракт качества.
- Остановка, сверка или эскалация, когда результат уже дошел до пользователя или могло произойти побочное действие инструмента.
Это разделение важно, потому что самое быстрое действие по восстановлению не всегда самое безопасное. Повторная отправка неудачного запроса на классификацию обычно несет низкий риск. Невидимо переключать модели в середине потокового ответа или после неясного вызова платежного инструмента — нет.
Этот playbook превращает политику fallback в три операционных рабочих процесса, которые ваша команда может реализовать, тестировать, наблюдать и выпускать через контролируемый production rollout.
Решение о резервном переключении модели в одной таблице
Начинайте со состояния запроса, а не с имени провайдера.
| Состояние запроса | Предпочтительный рабочий процесс | Типичное действие | Не делать |
|---|---|---|---|
| Нет байтов ответа, временная ошибка транспорта | Рабочий процесс 1 | Ограниченная повторная попытка, затем failover на эквивалентную конечную точку | Повторять без дедлайна или бюджета |
| Нет байтов ответа, rate limit или перегрузка | Рабочий процесс 1 | Соблюдать рекомендации по повтору, применять jitter, затем перейти к эквивалентной мощности | Создавать синхронизированный шторм повторных попыток |
| Основная цель недоступна, но есть совместимая модель | Рабочий процесс 2 | Проверить fallback-контракт, затем направить на утвержденную альтернативу | Предполагать, что каждая модель поддерживает одни и те же инструменты, схему или контекст |
| Структурированный ответ не проходит валидацию | Рабочий процесс 2 | Исправить один раз или попробовать утвержденную модель, которая соответствует контракту схемы | Считать HTTP 200 успешным выполнением задачи |
| Частичный поток уже доставлен | Рабочий процесс 3 | Остановить, пометить как частичный, предложить явный перезапуск | Незаметно сшивать вторую модель в тот же ответ |
| Инструмент на стороне записи мог быть выполнен | Рабочий процесс 3 | Сверить состояние инструмента с использованием записи об idempotency | Автоматически повторять весь рабочий процесс модели и инструмента |
| Классификация по безопасности или политике неясна | Рабочий процесс 3 | Эскалировать или завершать с fail closed согласно политике продукта | Снижать планку безопасности ради сохранения доступности |
Основное правило простое: повторная попытка сохраняет целевую модель, эквивалентный failover сохраняет контракт модели, а резервирование на другую модель меняет риск контракта. Каждому шагу нужна более строгая проверка допустимости.
Для более глубокого рассмотрения circuit breakers, нормализации ошибок и нейтрального к провайдерам контроллера см. playbook по маршрутизации fallback для LLM API.
До рабочих процессов: определите один fallback envelope
Каждый запрос должен попадать в routing layer с ограниченным envelope. Envelope сообщает системе, сколько восстановления разрешено, прежде чем запрос должен быть остановлен.
type FallbackEnvelope = {
  requestId: string;
  deadlineMs: number;
  maxAttempts: number;
  maxAddedLatencyMs: number;
  maxCostUsd?: number;
  allowEquivalentFailover: boolean;
  allowCrossModelFallback: boolean;
  allowAfterPartialOutput: false;
  sideEffectMode: "none" | "read_only" | "write_possible";
  requiredCapabilities: string[];
  requiredSchemaVersion?: string;
};
Значения должны поступать из продуктового workflow, а не из глобального значения по умолчанию. Фоновая задача суммаризации может допускать большую задержку, чем интерактивный помощник для кодинга. Ответ в чате без инструментов может допускать иное поведение при восстановлении, чем агент, который может разворачивать код или отправлять письма.
Envelope также предотвращает вложенные повторные попытки. Если SDK, приложение, gateway и адаптер провайдера все повторяют попытки независимо, небольшой инцидент может превратиться в большой всплеск попыток. Выберите один уровень, который будет владеть общим бюджетом попыток, и требуйте, чтобы каждый нижележащий уровень сообщал, что уже было израсходовано.
Превратите fallback envelope в policy as code
Определение типа документирует намерение, но production routing нужен версионированный policy, который операторы могут проверять без изменения кода приложения. Делайте policy достаточно небольшим для аудита и достаточно конкретным, чтобы не допустить утечки универсальной цепочки fallback в high-risk workflows.
Эта стартовая конфигурация разделяет три распространенных класса маршрутов:
policy_version: 2026-08-02

routes:
  interactive_chat:
    deadline_ms: 12000
    max_attempts: 2
    max_added_latency_ms: 2500
    allow_equivalent_failover: true
    allow_cross_model_fallback: true
    allow_after_partial_output: false
    side_effect_mode: none
    required_capabilities: [streaming]

  structured_extraction:
    deadline_ms: 30000
    max_attempts: 3
    max_added_latency_ms: 8000
    allow_equivalent_failover: true
    allow_cross_model_fallback: true
    allow_after_partial_output: false
    side_effect_mode: none
    required_capabilities: [structured_output]
    required_schema_version: invoice-v4

  tool_agent_write:
    deadline_ms: 45000
    max_attempts: 2
    max_added_latency_ms: 5000
    allow_equivalent_failover: true
    allow_cross_model_fallback: false
    allow_after_partial_output: false
    side_effect_mode: write_possible
    required_capabilities: [tool_use]
Приведенные выше значения — это примеры, а не универсальные пороговые значения. Задавайте их на основе пользовательской цели по задержке, экономики задачи, результатов оценивания и риска побочных эффектов. Важный архитектурный выбор состоит в том, что агент, способный выполнять записи, не может незаметно переключиться на модель с другим поведением.
Во время выполнения router должен объединять policy с состоянием запроса и наблюдаемым состоянием отказа. Компактная функция принятия решения может сделать границу тестируемой:
type RecoveryAction =
  | "retry_same_target"
  | "failover_equivalent"
  | "fallback_approved_model"
  | "reconcile_side_effect"
  | "restart_required"
  | "stop";

function chooseRecovery(input: {
  errorClass: string;
  attemptsUsed: number;
  deadlineRemainingMs: number;
  partialOutput: boolean;
  sideEffectState: "none" | "safe" | "uncertain";
  equivalentAvailable: boolean;
  approvedAlternateAvailable: boolean;
  policy: FallbackEnvelope;
}): RecoveryAction {
  if (input.sideEffectState === "uncertain") return "reconcile_side_effect";
  if (input.partialOutput) return "restart_required";
  if (input.attemptsUsed >= input.policy.maxAttempts) return "stop";
  if (input.deadlineRemainingMs <= 0) return "stop";

  const transient = [
    "transport_transient",
    "rate_limited",
    "provider_overloaded",
    "provider_server_error",
  ].includes(input.errorClass);

  if (transient && input.attemptsUsed === 0) return "retry_same_target";
  if (transient && input.equivalentAvailable) return "failover_equivalent";

  if (
    input.policy.allowCrossModelFallback &&
    input.approvedAlternateAvailable
  ) {
    return "fallback_approved_model";
  }

  return "stop";
}
Держите выбор кандидата отдельно от решения о восстановлении. chooseRecovery определяет, какой рабочий процесс допустим; затем селектор кандидатов фильтрует цели по возможностям, контексту, региону, стоимости и политике качества. Такое разделение упрощает разбор инцидентов, потому что команда может отличить «мы выбрали не тот рабочий процесс восстановления» от «мы выбрали не ту альтернативную модель».
Версионируйте политику и прикрепляйте эту версию к каждому трассировочному следу попытки. Когда появляется регрессия fallback, операторы должны иметь возможность ответить, какая политика приняла решение, какие кандидаты были допустимы и какой бюджет оставался в тот момент.
Рабочий процесс 1: повторная попытка, затем эквивалентный failover
Используйте этот рабочий процесс, когда операция допускает повторный запуск и система не выдала частичный результат и не перешла в неопределенное состояние побочного эффекта.
Эквивалентная цель — это другой маршрут, который сохраняет важный контракт: тот же класс поведения модели, необходимые возможности, ожидания по схеме, конфигурацию безопасности и совместимые ограничения контекста. Это может быть другой регион, развертывание, конечная точка провайдера или пул емкости.
Шаг 1: нормализуйте сбой
Сопоставляйте ответы, специфичные для провайдера, с небольшой внутренней таксономией:
transport_transientrate_limitedprovider_overloadedprovider_server_errorauthentication_or_permissioninvalid_requestdeadline_exhaustedcontract_failurepartial_outputside_effect_uncertain
Обычно только первые четыре подходят для автоматического повтора. Ошибки аутентификации, разрешений и некорректного запроса следует останавливать, потому что другой конечной точке вряд ли удастся исправить запрос. Сбои контракта относятся к Рабочему процессу 2. Частичный вывод и неопределенные побочные эффекты относятся к Рабочему процессу 3.
Шаг 2: рассчитайте оставшийся бюджет
Перед каждой попыткой проверяйте:
remaining time > estimated next-attempt latency + response safety margin
remaining attempts > 0
remaining added latency > 0
remaining cost budget > estimated attempt cost, when a cost ceiling exists
Если любой из необходимых бюджетов исчерпан, выходите, а не пытайтесь обратиться к ещё одному провайдеру.
Шаг 3: повторите с backoff и jitter
Используйте рекомендации провайдера по повторным попыткам, если они доступны. В противном случае применяйте экспоненциальный backoff с jitter и удерживайте задержку внутри дедлайна запроса.
function retryDelayMs(attempt: number, retryAfterMs?: number): number {
  if (retryAfterMs !== undefined) return retryAfterMs;

  const base = Math.min(250 * 2 ** attempt, 4_000);
  const jitter = Math.random() * base * 0.3;
  return Math.round(base + jitter);
}
Jitter важен, потому что многие одновременные клиенты иначе могут повторять попытку по одному и тому же расписанию и продлевать событие перегрузки. Ваше руководство по лимитам скорости LLM должно определять, как взаимодействуют RPM, TPM, очереди, параллелизм и бюджеты на повторы.
Шаг 4: перейдите на эквивалентную мощность
Если тот же целевой endpoint по-прежнему нездоров, направляйте запрос на эквивалентный endpoint только после проверки:
- Цепь разомкнута или находится в состоянии half-open для probe.
- Цель поддерживает необходимые режимы входа и выхода.
- Цель может принять запрос в пределах своего лимита контекста.
- Цель использует ожидаемую конфигурацию безопасности и обработки данных.
- Попытка по-прежнему укладывается в дедлайн и бюджет по стоимости.
Эквивалентный failover обычно менее рискован, чем смена моделей, потому что он направлен на сохранение контракта ответа.
Шаг 5: зафиксируйте причину восстановления
Возвращайте результат маршрутизации, например:
{
  "workflow": "retry_equivalent_failover",
  "primary_attempts": 2,
  "equivalent_failover_attempts": 1,
  "recovered": true,
  "recovery_reason": "provider_overloaded",
  "added_latency_ms": 684
}
Не раскрывайте внутренние детали провайдера конечным пользователям, если только ваш продукт не обещает такую прозрачность. Однако сохраняйте их в трассировках и операционных логах.
Рабочий процесс 2: контролируемый кросс-модельный fallback
Кросс-модельный fallback уместен только тогда, когда альтернативная модель заранее одобрена для этой задачи. Модель, которая возвращает текст, — этого недостаточно; она должна соответствовать контракту рабочего процесса.
Шаг 1: создайте контракт возможностей
Определите обязательные, не подлежащие компромиссу требования для каждого класса маршрута.
{
  "route_class": "support_ticket_triage_v3",
  "required": {
    "input": ["text"],
    "output": ["json_schema"],
    "tools": [],
    "minimum_context_tokens": 24000,
    "schema": "triage-result-v3",
    "languages": ["en", "es", "de"],
    "safety_profile": "customer-support-standard"
  },
  "fallback_models": [
    "approved-model-b",
    "approved-model-c"
  ]
}
Для маршрутов с использованием инструментов включите поведение выбора инструмента, поддержку параллельных инструментов, обработку схемы аргументов и то, надежно ли модель соблюдает условия «не вызывать». Для структурированных ответов проверяйте фактический ответ по схеме после каждой попытки.
Шаг 2: отделяйте успешную передачу от успешного выполнения задачи
HTTP-ответ с успехом все еще может провалить рабочий процесс продукта. Оценивайте как минимум три уровня:
- Успешная передача: провайдер вернул полный ответ.
- Успех по контракту: ответ был разобран, соответствовал схеме и корректно использовал поддерживаемые инструменты.
- Успех задачи: результат действительно завершил работу пользователя на приемлемом уровне качества.
Это различие имеет решающее значение при сравнении кандидатов на резервное переключение. Модель с высокой долей ответов, но частыми ошибками схемы или инструментов — ненадежный резерв.
Шаг 3: ранжируйте одобренных кандидатов по политике
Продакшн-маршрутизатор может оценивать подходящие цели, используя операционные сигналы, не делая вид, что какая-то одна модель универсально лучшая.
type Candidate = {
  id: string;
  capabilitiesPass: boolean;
  circuitOpen: boolean;
  estimatedLatencyMs: number;
  estimatedCostUsd: number;
  recentContractSuccess: number;
  recentTaskSuccess: number;
};

function eligible(candidate: Candidate, envelope: FallbackEnvelope): boolean {
  return (
    candidate.capabilitiesPass &&
    !candidate.circuitOpen &&
    candidate.estimatedLatencyMs <= envelope.maxAddedLatencyMs &&
    (envelope.maxCostUsd === undefined ||
      candidate.estimatedCostUsd <= envelope.maxCostUsd)
  );
}
Не используйте статический список «основная, резервная, резервная» для каждой задачи. Лучший набор резервных моделей для генерации кода может отличаться от лучшего набора для извлечения, перевода, зрения или выполнения инструментов.
Шаг 4: проверяйте резервный результат
Сначала применяйте детерминированные проверки:
- Проверка JSON или схемы
- Проверка обязательных полей
- Проверка аргументов инструментов
- Проверка формата цитат или URL
- Проверки длины и языковых ограничений
- Запрещенные шаблоны вывода
Затем добавьте проверки качества, специфичные для рабочего процесса. Это могут быть легковесные правила, оценщик задачи, выборочная проверка человеком или валидированная модель-арбитр. Если контроль качества не пройден, не помечайте резервное переключение как успешное восстановление.
Шаг 5: канареечные изменения политики
Перед расширением на новую резервную модель:
- Воспроизведите офлайн-набор для оценки.
- Запустите теневой трафик там, где политика это позволяет.
- Включите кандидата для небольшого процента подходящих сбоев.
- Сравните успех по контракту, успех задачи, задержку и стоимость.
- Расширяйте только если ценность восстановления перевешивает риск регрессии.
Отслеживайте эти измерения с помощью схемы наблюдаемости LLM API, которая записывает один маршрут и один span на каждую попытку.
Рабочий процесс 3: остановить, согласовать или эскалировать
Некоторые сбои не должны запускать еще один вызов модели. Правильное резервное действие — контролируемая остановка.
Случай 1: частичный потоковый вывод
Как только токены ответа достигли пользователя, незаметное переключение моделей может создать противоречия, дублирование контента, сломанные блоки кода или внезапное изменение стиля. Это также затрудняет атрибуцию и отладку итогового ответа.
Вместо этого используйте один из этих явных исходов:
- Завершите поток с восстанавливаемой ошибкой и действием «retry».
- Предложите перезапустить ответ с самого начала.
- Продолжайте только если в приложении предусмотрен протокол возобновления и новая модель получает точный принятый префикс.
По умолчанию должно быть allowAfterPartialOutput: false.
Case 2: uncertain tool side effects
Предположим, модель выбрала инструмент для платежа, email, деплоя, тикета или записи в базу данных. Инструмент мог успешно отработать, даже если соединение оборвалось до того, как ваш оркестратор зафиксировал результат. Повторный запуск всего рабочего процесса может дублировать побочный эффект.
Защитите инструменты записи с помощью:
- Идемпотентного ключа, основанного на пользовательской операции, а не на попытке провайдера.
- Надёжной записи выполнения со состояниями
planned,started,succeeded,failedиunknown. - Дедупликации на границе инструмента.
- Запроса на сверку перед любым повторным запуском.
- Проверки человеком для действий с высоким воздействием, по которым сохраняется неопределённость.
type ToolExecution = {
  operationId: string;
  toolName: string;
  state: "planned" | "started" | "succeeded" | "failed" | "unknown";
  externalReference?: string;
};

function nextAction(execution: ToolExecution): "continue" | "reconcile" | "stop" {
  if (execution.state === "succeeded") return "continue";
  if (execution.state === "failed") return "stop";
  return "reconcile";
}
Разделяйте учётные данные провайдера и учётные данные инструментов. Руководство по безопасному управлению API-ключами охватывает связанную модель секретов и контроля доступа.
Case 3: safety, permission, or policy uncertainty
Доступность не должна ослаблять решение по безопасности или авторизации. Если кандидат для fallback не поддерживает необходимые политики контроля, этот маршрут недопустим. Если система не может определить, разрешена ли операция, завершайте с отказом по умолчанию или эскалируйте согласно модели рисков продукта.
Case 4: no candidate satisfies the contract
Возвращайте типизированный сбой, с которым приложение может работать:
{
  "status": "unavailable",
  "reason": "no_eligible_fallback",
  "retryable": true,
  "retry_after_ms": 30000,
  "request_id": "req_123"
}
Явный деградированный ответ лучше, чем ответ, который выглядит успешным, но нарушает схему, использует неверные инструменты или выполняет неправильный побочный эффект.
Put the three workflows into one state machine
Слой оркестрации должен явно задавать этот переход.
START
  -> PRIMARY_ATTEMPT
     -> SUCCESS: validate and return
     -> TRANSIENT + replayable: WORKFLOW_1
     -> CONTRACT_FAILURE + approved alternate: WORKFLOW_2
     -> PARTIAL_OUTPUT or SIDE_EFFECT_UNCERTAIN: WORKFLOW_3

WORKFLOW_1
  -> retry inside budget
  -> equivalent failover inside budget
  -> if compatible alternate allowed: WORKFLOW_2
  -> otherwise: STOP

WORKFLOW_2
  -> capability check
  -> alternate attempt
  -> contract and task validation
  -> return only on validated success
  -> otherwise: STOP

WORKFLOW_3
  -> mark partial or uncertain state
  -> reconcile external side effects when possible
  -> offer explicit restart or human escalation
  -> never silently replay unsafe work
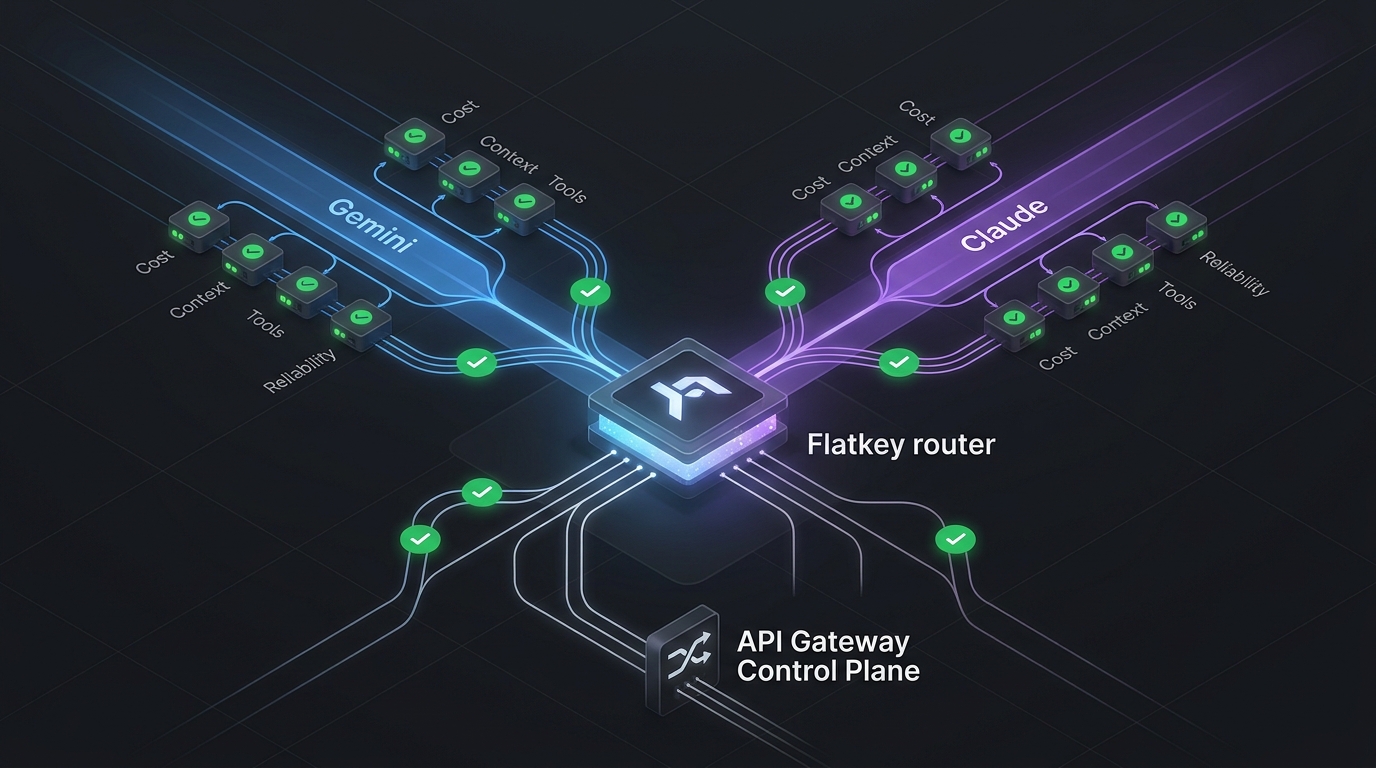
Это также правильная граница для мульти-модельного gateway. Централизация доступа к моделям за OpenAI-совместимой конечной точкой может снизить дублирование интеграции, но приложению по-прежнему нужно задавать намерение рабочего процесса: дедлайны, режим побочных эффектов, необходимые инструменты, версию схемы и разрешен ли кросс-модельный fallback. Flatkey предоставляет унифицированный слой API-доступа для команд, которым нужен один ключ и одна точка интеграции для разных провайдеров моделей; наиболее безопасная политика маршрутизации по-прежнему начинается с явных контрактов приложения.
Выполните пять проверок отказоустойчивости перед включением автоматического fallback
Путь fallback, который ни разу не проходил контролируемый сбой, — это всего лишь схема. Проверяйте каждый класс маршрута на сбоях, которые затрагивают разные границы безопасности.
| Проверка | Внедренное условие | Ожидаемое поведение | Сохраняемые доказательства |
|---|---|---|---|
| 1. Таймаут primary | Задержать primary дольше его таймаута для одной попытки | Повторять только если общий дедлайн и бюджет попыток еще не исчерпаны | Временные метки попыток, бюджет до и после, итоговая причина маршрутизации |
| 2. Всплеск rate-limit | Возвращать ограниченную серию ответов rate-limit | Применять jitter, учитывать рекомендации по повтору и избегать синхронизированных повторов | Распределение backoff, глубина очереди, количество восстановленных запросов и исчерпавших дедлайн |
| 3. Неверный структурированный вывод | Возвратить HTTP-успех с телом, не соответствующим схеме | Пометить как сбой контракта, попробовать только одобренный альтернативный вариант с поддержкой схемы, снова выполнить валидацию | Ошибки валидации, запись о допустимости кандидата, результат принятия задачи |
| 4. Обрыв в середине потока | Завершить соединение после токенов, видимых пользователю | Остановить поток и потребовать явного перезапуска | Флаг частичного вывода, состояние для пользователя, подтверждение отсутствия незаметного склеивания |
| 5. Неоднозначный результат инструмента | Отбросить ответ после того, как write-side-инструмент, возможно, уже был выполнен | Сверить по ID операции до любого повторного воспроизведения | Запись идемпотентности, поиск внешнего состояния, число дублирующих побочных эффектов |
Сначала запускайте проверки в локальной среде или staging, затем — в узко ограниченном production game day. Цель не в том, чтобы доказать, что каждый запрос переживет сбой. Цель в том, чтобы доказать, что система завершается в ожидаемом состоянии, предоставляет достаточно доказательств для диагностики события и не тратит больше задержки, денег или риска побочных эффектов, чем разрешает политика.
Для каждой проверки отдельно убедитесь в четырех уровнях:
- Корректность решения: маршрутизатор выбрал предполагаемый рабочий процесс.
- Корректность бюджета: все попытки укладывались в общий дедлайн, лимит попыток и бюджет затрат.
- Корректность вывода: итоговый результат прошел проверку контракта и задачи либо вернул явное состояние деградации.
- Корректность аудита: трассировки зафиксировали версию политики, класс сбоя, допустимость кандидата, причину маршрутизации и видимый пользователю результат.
Повторяйте этот тест каждый раз, когда вы меняете адаптер провайдера, владельца повторной попытки, модель-кандидата, версию схемы, контракт инструмента или реализацию потоковой передачи. Эти изменения могут повлиять на безопасность воспроизведения, даже если внешний вид публичного API кажется неизменным.
Используйте оценочную карту готовности к fallback перед продакшеном
Пройти несколько тестов на счастливом пути недостаточно, чтобы включить автоматический fallback. Маршрут должен заслужить автоматизацию, пройдя пять независимых выпускных проверок.
| Проверка | Условие прохождения | Подтверждение | Блокировать автоматический fallback, когда |
|---|---|---|---|
| Безопасность воспроизведения | Команда может доказать, безопасно ли повторять запрос на каждой границе попытки | Классификация побочных эффектов, проектирование идемпотентности, правила частичного вывода | Могла произойти запись без ключа согласования |
| Совместимость контракта | Каждый кандидат поддерживает требуемый контекст, инструменты, схему, модальности и элементы управления политиками | Матрица возможностей с версионированием и тесты контракта | Совместимость предполагается на основании семейства моделей или маркетинговых ярлыков |
| Качество задачи | Альтернативный вариант дает приемлемые результаты для реальной нагрузки маршрута | Набор оценки, специфичный для маршрута, и рассмотренные случаи отказов | Доступны только успешная передача или общие результаты бенчмарков |
| Контроль бюджета | Повторные попытки и fallback используют один дедлайн, лимит попыток и потолок затрат | Трассировки теста на сбой, показывающие расход бюджета | Несколько уровней могут повторять попытки независимо или превысить дедлайн вызывающей стороны |
| Операционный контроль | Инженеры дежурной смены могут определить, отключить и объяснить решение о fallback | Версия политики, причина маршрута, аварийный переключатель, дашборд, runbook | Путь восстановления нельзя изолировать без полного развертывания приложения |
Рассматривайте оценочную карту как артефакт релиза. Фиксируйте класс маршрута, версию политики, утвержденных кандидатов, версию оценщика, результаты теста, владельца и дату ревью. Один глобальный флаг «fallback включен» скрывает слишком много рисков; утверждение должно происходить для каждого класса рабочего процесса отдельно.
Копируемая запись готовности
fallback_readiness:
  route_class: support_ticket_extraction
  policy_version: fallback-v4
  owner: ai-platform
  primary_target: primary-model
  approved_candidates:
    - equivalent-deployment
    - alternate-model

  gates:
    replay_safety: pass
    contract_compatibility: pass
    task_quality: pass
    budget_control: pass
    operational_control: pass

  evidence:
    capability_matrix: contracts/support-ticket-v3.yaml
    evaluation_set: evals/support-ticket-2026-08.jsonl
    failure_drill_run: drills/2026-08-03.json
    dashboard: ai-routing/support-ticket
    runbook: runbooks/support-ticket-fallback.md

  release:
    mode: canary
    rollback_owner: oncall-ai-platform
    next_review_at: 2026-09-03
Файл не обязательно должен существовать именно в таком формате. Важно, чтобы решение о выпуске можно было проверить и чтобы оно было связано с той же версией политики, которая зафиксирована в production traces.
Разверните стратегию резервного переключения моделей в четыре этапа
Автоматический fallback не должен сразу переходить от офлайн-теста ко всем production-запросам. Используйте четыре этапа, которые выявляют ошибки принятия решений до того, как они станут видны пользователю.
Этап 1: затените решение
Запустите контроллер fallback в режиме только наблюдения. Основной путь по-прежнему определяет ответ пользователю, а контроллер записывает, что он бы сделал.
Проверьте:
- Как часто политика классифицирует сбой как допускающий повторную попытку.
- Как часто кандидат подходит для использования.
- Какой бюджет остановил бы восстановление.
- Предлагает ли политика fallback после частичного вывода или при неопределенных побочных эффектах.
- Сохраняют ли нормализованные ошибки провайдера достаточно деталей для диагностики инцидента.
Режим shadow особенно полезен для выявления слишком широких правил, таких как «fallback на каждый 429» или «попробовать другую модель после любой ошибки схемы». В код-ревью такие правила могут выглядеть разумно, но на реальных состояниях запросов они ведут себя плохо.
Этап 2: включите canary для низкорисковых workflows
Включите fallback для небольшой доли трафика, безопасного для повторного воспроизведения, такого как только для чтения классификация, извлечение или фоновые суммаризации. Исключите инструменты для записи, решения, чувствительные к безопасности, и маршруты с потоковой передачей, видимой пользователю.
Сравните canary с путем только с primary, используя результаты на уровне маршрута:
- Доля принятых задач, а не только HTTP success.
- Дополнительная задержка из-за восстановления.
- Разница в стоимости на одну принятую задачу.
- Сбои валидации контракта по каждому кандидату.
- Истощение дедлайна и частота отсутствия подходящего fallback.
- Отмена пользователем или явная частота перезапуска.
Не расширяйте canary только потому, что снизилась частота ошибок провайдера. Расширяйте его только тогда, когда итоговый пользовательский результат остается приемлемым и путь восстановления укладывается в свои рамки.
Этап 3: ограничьте автоматическое восстановление по классу риска
Расширяйте только те классы workflows, которые прошли scorecard готовности. Держите различия в политике явными:
| Класс риска | Автоматизация по умолчанию | Требуемая защита |
|---|---|---|
| Только чтение, без потоковой выдачи | Повторная попытка, эквивалентный failover, одобренный межмодельный fallback | Валидация контракта и задачи |
| Только чтение с потоковой выдачей | Восстановление только до первого видимого пользователю байта | Состояние частичного вывода и явный перезапуск |
| Использование инструментов с инструментами только для чтения | Повторная попытка до выполнения инструмента; валидация альтернативного контракта инструмента | Схема инструмента и тесты выбора инструмента |
| Использование инструментов с записью | Остановиться и выполнить сверку после неоднозначного выполнения | Устойчивый ID операции и внешний поиск состояния |
| Решение по безопасности, разрешениям или соответствию | Завершить с ошибкой в соответствии с утвержденной политикой продукта | Никакого понижения политики из соображений доступности |
На этом этапе gateway и контракт приложения сходятся. Gateway может нормализовать ошибки, обеспечивать соблюдение бюджетов и выбирать допустимую емкость. Приложение по-прежнему должно указывать, ушел ли вывод наружу, возможен ли побочный эффект и какие проверки качества или политики обязательны.
Этап 4: постепенно расширяйте и повторно сертифицируйте изменения
Увеличивайте трафик по ограниченным шагам. На каждом шаге сохраняйте возможность отключить одну версию политики, один класс маршрута, один адаптер провайдера или одного кандидата, не отключая весь слой маршрутизации.
Повторно запускайте соответствующие проверки scorecard, когда меняется что-либо из следующего:
- Модель или версия модели.
- Адаптер провайдера или endpoint.
- Шаблон prompt или системная инструкция.
- Определение инструмента или область разрешений.
- Схема структурированного вывода.
- Владение retry или конфигурация timeout.
- Транспорт стриминга или поведение клиента.
- Политика безопасности или evaluator качества.
Готовность к fallback истекает, когда меняются ее допущения. Кандидат, одобренный для предыдущего prompt, схемы или набора инструментов, не должен автоматически оставаться допустимым по инерции.
Определите триггеры отката до включения canary
Canary безопасен только тогда, когда команда заранее согласовала, что его остановит. Используйте триггеры, специфичные для маршрута, вместо того чтобы ждать крупный инцидент.
Откатите или отключите затронутую политику, если наблюдаете:
- Дублирующиеся или неопределенные побочные эффекты на стороне записи.
- Успех межмодельного контракта без приемлемого успеха задачи.
- Рост числа сбоев частичного потока или незаметного сращивания ответа.
- Повторное исчерпание дедлайна из-за попыток восстановления.
- Превышение или игнорирование бюджетных лимитов.
- Выбор кандидата, нарушающий требуемую возможность или политику безопасности.
- Необъяснимое изменение распределения причин fallback после разворачивания.
- Отсутствие данных трассировки по версии политики или попытке во время инцидента.
Действие по откату должно быть настолько же точечным, насколько точечен сбой. В зависимости от события это может означать отключение одного кандидата, принудительный перевод маршрута только на equivalent failover, установку allowCrossModelFallback в false, открытие circuit для одного провайдера или возврат workflow в режим только primary.
Избегайте механизма отката, который требует пересборки приложения. Политики восстановления часто меняются во время инцидентов, и самым безопасным ответом нередко становится изменение конфигурации с возможностью аудита версии, а не экстренный патч кода.
Используйте один рабочий лист инцидента для каждого события резервного переключения
Инциденты резервного переключения трудно диагностировать, когда каждый провайдер возвращает разную форму ошибки, а каждое приложение логирует разное состояние запроса. Зафиксируйте один нейтральный к провайдеру рабочий лист.
fallback_incident:
  incident_id: inc-2026-08-03-001
  route_class: support_ticket_extraction
  request_id: req_123
  policy_version: fallback-v4

  request_state:
    output_started: false
    side_effect_mode: none
    tool_execution_state: not_started
    deadline_remaining_ms: 1820
    attempts_remaining: 1

  primary_failure:
    normalized_class: overloaded
    provider_status: 529
    retry_guidance_present: true

  recovery_decision:
    workflow: cross_model_fallback
    candidate: alternate-model
    reason: equivalent_capacity_unavailable

  validation:
    transport_success: true
    contract_success: true
    task_success: false
    failure_reason: required_field_omitted

  user_outcome:
    state: explicit_failure
    partial_output: false
    duplicate_side_effect: false

  containment:
    action: disable_candidate_for_route
    owner: oncall-ai-platform
Самое важное различие — между успехом восстановления и успехом для пользователя. Запрос резервного переключения может вернуть корректный HTTP-ответ и при этом провалить схему, выбрать неверный инструмент, опустить обязательный факт или нарушить порог качества маршрута. Разбор инцидента должен проследить результат до задачи, видимой пользователю.
Проведите 60-минутный game day для резервного переключения моделей
Модульные тесты доказывают, что отдельные ветки выполняются. Game day для резервного переключения доказывает, что вся система восстановления работает корректно, пока взаимодействуют дедлайны, повторы, потоки, валидация, инструменты, телеметрия и средства управления оператором.
Проводите упражнение по одному классу рабочих процессов за раз. Не начинайте с моделирования глобального отказа провайдера. Узкий маршрут, такой как извлечение только для чтения или внутреннее суммаризирование, дает более ясные доказательства и ограничивает радиус поражения, если политика неверна.
Определите устав game day
Напишите одностраничный устав до того, как кто-либо создаст сбой. Устав не позволяет превратить упражнение в импровизированный простой.
game_day:
  id: fallback-gd-2026-08-04-extraction
  route_class: structured_extraction
  policy_version: fallback-v4
  environment: staging
  exercise_owner: ai-platform
  incident_commander: reliability

  primary_target: primary-model
  approved_fallbacks:
    - equivalent-deployment
    - alternate-schema-capable-model

  traffic_scope:
    synthetic_requests: 100
    production_percentage: 0

  safety_limits:
    stop_after_minutes: 60
    max_error_rate_percent: 5
    max_duplicate_side_effects: 0
    max_unexplained_route_decisions: 0

  success_definition:
    - every request ends accepted, explicitly degraded, or safely stopped
    - no request exceeds the shared attempt budget
    - no partial stream is silently continued by another model
    - every fallback decision includes a policy version and route reason
Сначала используйте синтетический трафик или replay-safe трафик. Если маршрут может инициировать записи, замените инструмент управляемой тестовой заглушкой или песочницей, поддерживающей поиск по idempotency. Game day должен тестировать механизмы восстановления, а не ставить под угрозу состояние клиента.
Назначьте четыре роли
Сделайте команду достаточно небольшой, чтобы быстро принимать решения, но разделите наблюдение и выполнение.
| Role | Responsibility during the exercise | Must not do |
|---|---|---|
| Exercise lead | Запускает сценарии, контролирует таймлайн и объявляет условия остановки | Менять политику fallback в середине сценария без фиксации этого факта |
| Operator | Следит за состоянием маршрута, отключает кандидатов и использует kill switch | Вносить сбои или редактировать доказательства |
| Observer | Фиксирует метки времени, скриншоты, трассировки и пользовательские результаты | Помогать router «пройти» тест, вручную исправляя запросы |
| Application owner | Оценивает качество задачи и специфичную для workflow деградацию | Одобрять результат только на основе HTTP success |
Для очень маленькой команды один человек может выполнять две роли, но человек, который вносит сбой, не должен быть единственным, кто оценивает, корректно ли система отреагировала.
Постройте лестницу сценариев
Начинайте с наименее двусмысленного сбоя и добавляйте риск только после того, как маршрут проходит предыдущую ступень.
| Rung | Injection | What the router should prove | Promotion requirement |
|---|---|---|---|
| 1. Clean equivalent failover | Сделайте основной endpoint недоступным до получения response bytes | Он может перейти на эквивалентную capacity без изменения application contract | Принятый результат, одна причина маршрута, соблюден shared budget |
| 2. Retry pressure | Верните ограниченный всплеск ошибок, допускающих повторную попытку | Backoff и jitter работают без multiplication попыток | Нет каскадного усиления retry; deadline по-прежнему является авторитетным |
| 3. Semantic contract failure | Верните структурированный результат, который прошел transport-successful, но является некорректным | Проверка validation, а не status code, определяет принятие | Альтернатива допустима, и ее результат проходит тот же validator |
| 4. Partial stream | Отключите соединение после видимого вывода | Система останавливается и помечает ответ как partial | Никакого silent model splice; restart выполняется явно |
| 5. Uncertain tool completion | Потеряйте ответ модели после того, как write мог быть выполнен | Workflow сверяет внешнее состояние перед replay | Operation ID lookup завершается; duplicate writes остаются на нуле |
| 6. Fallback degradation | Сделайте одобренную альтернативу медленнее или ниже по качеству | Правила stop-loss и rollback имеют приоритет над давлением доступности | Кандидат удаляется или automation отключается при заранее определенном пороге |
Не переходите сразу к сложному межмодельному сценарию. Если equivalent failover не может сохранить budget и trace contract, добавление поведенчески отличающейся модели усложнит диагностику, а не сделает ее более реалистичной.
Внедряйте сбои на явных границах
Пометьте точную границу, на которой сбой входит в жизненный цикл запроса. «Provider failed» — слишком расплывчато для полезного тестового отчета.
type InjectionPoint =
  | "before_connect"
  | "after_connect_before_headers"
  | "after_headers_before_body"
  | "after_partial_stream"
  | "after_tool_dispatch_before_ack"
  | "after_tool_ack_before_model_response"
  | "after_transport_success_before_validation";
Граница определяет, какие действия по восстановлению безопасны. Тайм-аут до установления соединения часто можно повторить. Разрыв после того, как пользователь уже увидел вывод, требует явного перезапуска. Потерянное подтверждение после вызова инструмента на стороне записи требует согласования. Если относить все три случая к одной и той же категории тайм-аута, в продакшн попадают дублирующиеся действия и несогласованные ответы.
Если ваш слой fault-injection не может нацеливаться на эти границы, добавьте маркер границы в адаптер провайдера или слой оркестрации до проведения упражнения. Грубые переключатели отказов полезны для тестов доступности, но недостаточны для тестов безопасности повторного воспроизведения.
Собирайте одну строку доказательств на каждый запрос
Game day должен формировать журнал на уровне запроса, а не только скриншоты дашборда. Компактная строка делает необъясненные решения видимыми.
| Поле | Пример | Почему это важно |
|---|---|---|
request_id |
req_01J... |
Объединяет доказательства от gateway, модели, валидатора и инструмента |
scenario_id |
partial-stream-01 |
Связывает результат с внедренным условием |
policy_version |
fallback-v4 |
Подтверждает, какие правила маршрутизации приняли решение |
failure_class |
stream_interrupted |
Разделяет неопределенность транспорта, контракта, политики и инструмента |
injection_point |
after_partial_stream |
Устанавливает безопасность повторного воспроизведения |
attempts_used |
1/2 |
Выявляет усиление из-за повторных попыток |
elapsed_ms |
4830/12000 |
Показывает оставшийся бюджет дедлайна |
cost_budget_state |
within |
Не позволяет восстановлению игнорировать экономику на единицу |
selected_action |
restart_required |
Фиксирует решение маршрутизатора |
candidate_id |
none |
Показывает, рассматривалась ли другая модель |
validator_result |
not_run |
Отделяет восстановление транспорта от принятия задачи |
side_effect_state |
none |
Явно показывает требования к согласованию |
user_outcome |
partial_marked |
Фиксирует то, что увидел клиент |
operator_action |
none |
Различает автоматическое восстановление и ручную локализацию |
Храните журнал рядом со снимком политики, версией валидатора, конфигурацией сбоев и экспортом дашборда. Без этих версий успешно пройденное упражнение нельзя воспроизвести после следующего изменения адаптера или модели.
Оценивайте упражнение с помощью правил продвижения
Используйте три возможных решения: promote, fix and rerun или stop automation. Избегайте расплывчатого результата «в основном прошло».
Promote маршрут только если все условия ниже выполняются:
- У каждого запроса есть объясненное конечное состояние.
- Ни одна цепочка попыток не превышает общий дедлайн, число попыток или настроенный лимит затрат.
- Каждый принятый результат проходит валидатор или правило оценки маршрута.
- Частичный вывод и неопределенные побочные эффекты переходят в явные состояния stop или reconciliation.
- Операторы могут отключить один кандидат или всю политику без развертывания кода приложения.
- Система оповещений выявляет как ошибки восстановления, так и вредные восстановления, например успешный fallback при неприемлемом качестве задачи.
Выбирайте fix and rerun, когда модель безопасности верна, но доказательства или реализация неполны. Примеры: отсутствует причина маршрута, оповещение срабатывает слишком поздно или кандидат проходит контракт, но не достигает целевого показателя задержки.
Выбирайте stop automation, когда упражнение выявляет неоднозначность воспроизведения, дублирование побочных эффектов, бесшумное сращивание потока, необъяснимую маршрутизацию, обход политики или режим отказа, который текущий конечный автомат не может представить. Это пробелы в проектировании, а не проблемы настройки.
Используйте scorecard для game-day, который можно скопировать
game_day_result:
  game_day_id: fallback-gd-2026-08-04-extraction
  route_class: structured_extraction
  policy_version: fallback-v4
  evaluator_version: extraction-eval-v7
  started_at: 2026-08-04T09:00:00Z
  completed_at: 2026-08-04T10:00:00Z

  scenarios:
    equivalent_failover: pass
    retry_pressure: pass
    semantic_contract_failure: pass
    partial_stream: pass
    uncertain_tool_completion: not_applicable
    fallback_degradation: fix

  totals:
    requests: 100
    accepted: 94
    explicitly_degraded: 6
    unsafe_or_unexplained: 0
    duplicate_side_effects: 0
    deadline_violations: 0

  decision: fix_and_rerun
  blockers:
    - alternate p95 latency exceeded the route objective during degradation
  owner: ai-platform
  rerun_due: 2026-08-11
Приведенные значения приведены для примера. Используйте собственные целевые показатели маршрута и пороги оценки. Важно, чтобы итоговое решение указывало на сохраненные доказательства и названного владельца.
Превратите выводы в release controls
Завершите game day, преобразовав каждый вывод в один из четырех устойчивых controls:
- Policy change: критерий допустимости кандидата, бюджет попыток, дедлайн или правило класса маршрута.
- Contract test: проверка совместимости capability, schema, tool, streaming или safety.
- Operational control: alert, dashboard, kill switch, карантин кандидата или процедура инцидента.
- Product behavior: явный restart, сообщение о degraded-state, ручное подтверждение или экран reconciliation.
Не завершайте упражнение списком наблюдений. Вывод без владельца, типа control и условия повторного запуска снова появится во время реального инцидента.
Для слоя телеметрии, лежащего в основе этих упражнений, используйте руководство по наблюдаемости LLM API. Для распределения ответственности за повторные попытки и поведения при ограничении скорости подключите к game day ограничения скорости LLM и стратегию повторных попыток. Если ваша команда все еще определяет границу gateway, начните с руководства для начинающих по LLM gateway.
A seven-day implementation sequence
Команды могут использовать этот порядок, чтобы перейти от спонтанного списка моделей к контролируемому playbook рабочих процессов:
- Day 1 — Inventory routes: классифицируйте режим вывода, риск побочных эффектов, инструменты, схемы, сроки и текущих владельцев повторных попыток.
- Day 2 — Define envelopes: задайте лимиты на попытки, задержку, стоимость, возможности и повторное воспроизведение для каждого класса маршрута.
- Day 3 — Build contracts: документируйте одобренные кандидаты и проверяйте совместимость с инструментами, схемами, контекстом, модальностью и политиками.
- Day 4 — Instrument decisions: фиксируйте нормализованный сбой, состояние запроса, версию политики, допустимость кандидата, бюджет, валидацию и результат для пользователя.
- Day 5 — Run failure drills: моделируйте timeout, всплеск rate-limit, некорректный вывод, разрыв mid-stream и неоднозначное выполнение инструмента.
- Day 6 — Shadow and canary: сначала наблюдайте за решениями, затем включите узкий маршрут с низким риском и заранее определенными триггерами отката.
- Day 7 — Review and widen: до расширения проверьте долю принятых задач, добавленную задержку, разницу в стоимости, сигналы небезопасного повторного воспроизведения и события отсутствия допустимого fallback.
Последовательность намеренно ориентирована прежде всего на workflow. Выбор ранжированного списка моделей — лишь небольшой шаг. Производственная работа заключается в том, чтобы доказать, когда система может продолжать, когда она должна выполнять валидацию и когда она должна остановиться.
Model fallback strategy rollout checklist
Policy
- У каждого класса маршрута есть fallback envelope.
- Политика fallback имеет версию и может быть проверена как конфигурация.
- Ошибки, допускающие повторную попытку, нормализованы между провайдерами.
- Общий бюджет на повторные попытки имеет одного владельца.
- Эквивалентные endpoints отличаются от альтернативных моделей.
- Кандидаты между моделями имеют версионируемые контракты возможностей.
- Частичный вывод по умолчанию отключает прозрачный fallback.
- Инструменты write-side используют устойчивые записи idempotency.
Validation
- Транспорт, контракт и успешность задачи измеряются отдельно.
- Структурированные результаты валидируются после fallback.
- Аргументы инструментов и поведение выбора инструмента тестируются для каждой модели.
- Наборы для оценки fallback отражают реальные классы маршрутов.
- Новые кандидаты проходят офлайн-оценку и production canary.
- Все пять test failure drills проходят для каждого применимого класса маршрута.
Operations
- Каждая попытка фиксирует причину маршрутизации, цель, задержку и результат.
- Панели мониторинга отдельно показывают основной маршрут, повторную попытку, эквивалентный failover и кросс-модельное восстановление.
- Оповещения включают исчерпание дедлайна и долю отсутствия подходящего резервного варианта.
- Прерыватели цепи используют контролируемые проверки в состоянии half-open.
- Анализ инцидента включает видимое пользователю качество и риск дублирования побочных эффектов.
- Трассировка каждой попытки записывает активную версию политики резервного переключения.
- Для каждого маршрута заполнена карта готовности с оценкой и указанным владельцем.
- Тестируются триггеры отката canary и узкие аварийные выключатели.
- Рабочие листы по инцидентам фиксируют состояние запроса, проверку и результат для пользователя.
Метрики, которые доказывают, что резервное переключение помогает
Не оптимизируйте только под частоту ошибок провайдера. Отслеживайте пользовательский результат.
| Метрика | На какой вопрос отвечает |
|---|---|
| Коэффициент восстановления после повтора | Оправдана ли задержка при повторных попытках к той же цели? |
| Коэффициент восстановления при эквивалентном failover | Восстанавливает ли резервная мощность сервис безопасно? |
| Успешность кросс-модельного контракта | Соответствует ли альтернативный ответ требуемому интерфейсу? |
| Успешность кросс-модельной задачи | Завершает ли пользователь по-прежнему нужную работу? |
| Дополнительная задержка резервного переключения | Сколько задержки добавляет восстановление? |
| Дельта стоимости резервного переключения | Какова стоимость пути восстановления? |
| Частота сбоев частичного потока | Как часто система достигает невосстановимого состояния представления? |
| Коэффициент согласования побочных эффектов | Как часто система должна проверять внешнее состояние перед продолжением? |
| Инциденты дублирования побочных эффектов | Сработала ли защита от повторного воспроизведения? |
| Доля отсутствия подходящего резервного варианта | Слишком ли строги контракты маршрутизации или недостаточна емкость? |
Сегментируйте эти метрики по классу маршрута. Агрегированный коэффициент восстановления может скрывать, что резервное переключение хорошо работает для извлечения, но плохо — для генерации кода или использования инструментов.
Во время поэтапного внедрения сравнивайте эти метрики по версии политики и стадии релиза. Это позволяет отделить инцидент у провайдера от изменения контроллера, изменения кандидата или расширенного canary.
Часто задаваемые вопросы
Что такое стратегия резервного переключения моделей?
Стратегия резервного переключения моделей — это политика, определяющая, когда AI-запрос должен повториться к той же цели, перейти на эквивалентную мощность, переключиться на одобренную альтернативную модель или остановиться, потому что повторное воспроизведение будет небезопасным.
В чем разница между повторной попыткой и резервным переключением?
Повторная попытка повторяет запрос к той же цели или развертыванию. Эквивалентный failover переводит запрос на мощность, предназначенную для сохранения того же контракта модели. Кросс-модельное резервное переключение меняет модель и, следовательно, требует проверки возможностей и качества.
Должна ли каждая ошибка 429 запускать другую модель?
Нет. Сначала классифицируйте ограничение, соблюдайте рекомендации по повтору, проверьте оставшийся дедлайн и используйте ограниченную повторную попытку или очередь. Переключение моделей может помочь, когда есть одобренная альтернативная мощность, но оно также может изменить качество вывода, поведение инструментов или стоимость.
Может ли потоковый ответ переключиться на резервный вариант в середине ответа?
Обычно безопаснее не переключаться прозрачно после того, как токены уже дошли до пользователя. Остановите поток и предложите явный перезапуск, если только в приложении не реализован и не протестирован протокол возобновления.
Сколько резервных моделей должно быть у маршрута?
Используйте минимальный утверждённый набор, который обеспечивает значимое восстановление. Каждый кандидат добавляет работу по оценке, мониторингу и реагированию на инциденты. Длинный непроверенный список — это не отказоустойчивость.
Где должна находиться логика резервного переключения?
Централизуйте нормализацию провайдеров, маршрутизацию, бюджеты попыток и наблюдаемость в gateway или orchestration layer. Держите специфичное для рабочего процесса намерение — риск побочных эффектов, требования к схеме, политику безопасности и пороги качества — ближе к приложению.
Как команде внедрять автоматический fallback модели?
Начните в shadow mode, проводите canary только для потоков, безопасных для повторного воспроизведения, определите триггеры отката до расширения трафика и повторно сертифицируйте политику fallback всякий раз, когда меняются модели, промпты, инструменты, схемы, ответственность за повторные попытки или требования безопасности.
Стройте fallback с учётом риска рабочего процесса
Лучшая стратегия резервного переключения моделей — это не «попробовать следующую модель». Это ограниченная система принятия решений:
- Рабочий процесс 1 восстанавливает запросы, которые можно воспроизвести, с помощью повторных попыток и эквивалентной мощности.
- Рабочий процесс 2 переключает модели только после проверок возможностей и качества.
- Рабочий процесс 3 останавливает автоматическое повторное воспроизведение, когда выходные данные или побочные эффекты делают восстановление небезопасным.
Такой подход повышает доступность, не скрывая сбои контракта и не дублируя действия пользователя. Если ваша команда стандартизирует доступ между провайдерами моделей, используйте унифицированный OpenAI-compatible API layer от Flatkey как поверхность интеграции, а затем добавляйте эти специфичные для рабочих процессов оболочки к каждому production route.